
Nota: Este artículo fue traducido automáticamente con OpenAI gpt-6.1-sol mediante Codex CLI; la calidad puede verse degradada, especialmente en la terminología técnica.
Noticias
Solución de la hipótesis de Riemann
Tras la solución de Navier-Stokes por parte de OpenAI, Levent Alpoge, investigador de Anthropic, ha demostrado uno de los problemas más famosos de las matemáticas: la hipótesis de Riemann. Hace 35 días, Terrance Tao, considerado por muchos el mejor matemático vivo, dijo que esperaba que la hipótesis de Riemann quizá se resolviera para 2050. Parece que se equivocó por un poquito.
Levent presentó un texto de 4 páginas, junto con una formalización del problema en Lean de 17 millones de líneas, que más de una docena de personas de las comunidades de matemáticas y Lean han ejecutado de forma independiente y confirmado como correcta.
Se esperaba que la demostración necesitara un montón de técnicas nuevas, pero en su lugar recorrió muchos campos de las matemáticas aparentemente sin relación entre sí. Levent le pidió a Claude que redactara una exposición convencional, pero superó el cuarto de millón de páginas, así que decidió publicar solo la formalización en Lean por ahora, en vez de una «monstruosidad inmensa e ilegible de contenido basura».
Con esto, por si aún no estaba claro, hemos alcanzado la inteligencia artificial general en matemáticas. Se consideraba que Navier-Stokes estaba más o menos al alcance de los humanos, pero la opinión generalizada era que resolver la hipótesis de Riemann resultaba imposible con las herramientas que tenemos ahora.
Las matemáticas son el campo más puro para entrenar modelos (es muy claro y evidente si algo es correcto), y por eso han sido las primeras en caer. No tengo tanta confianza en que los LLM puedan resolver problemas de otros campos con la misma facilidad, pero esto ha demostrado que podemos crear modelos mejores que prácticamente todos los humanos en un campo determinado, usando solo los datos generados por humanos.
Lanzamientos
Gemini 4 Neon
No puedo creer que esté diciendo esto, pero Google por fin lo ha conseguido y ha lanzado un LLM de primer nivel. Gemini 4 Neon es el último de la avalancha de lanzamientos de Google del último mes, y con diferencia el mejor.
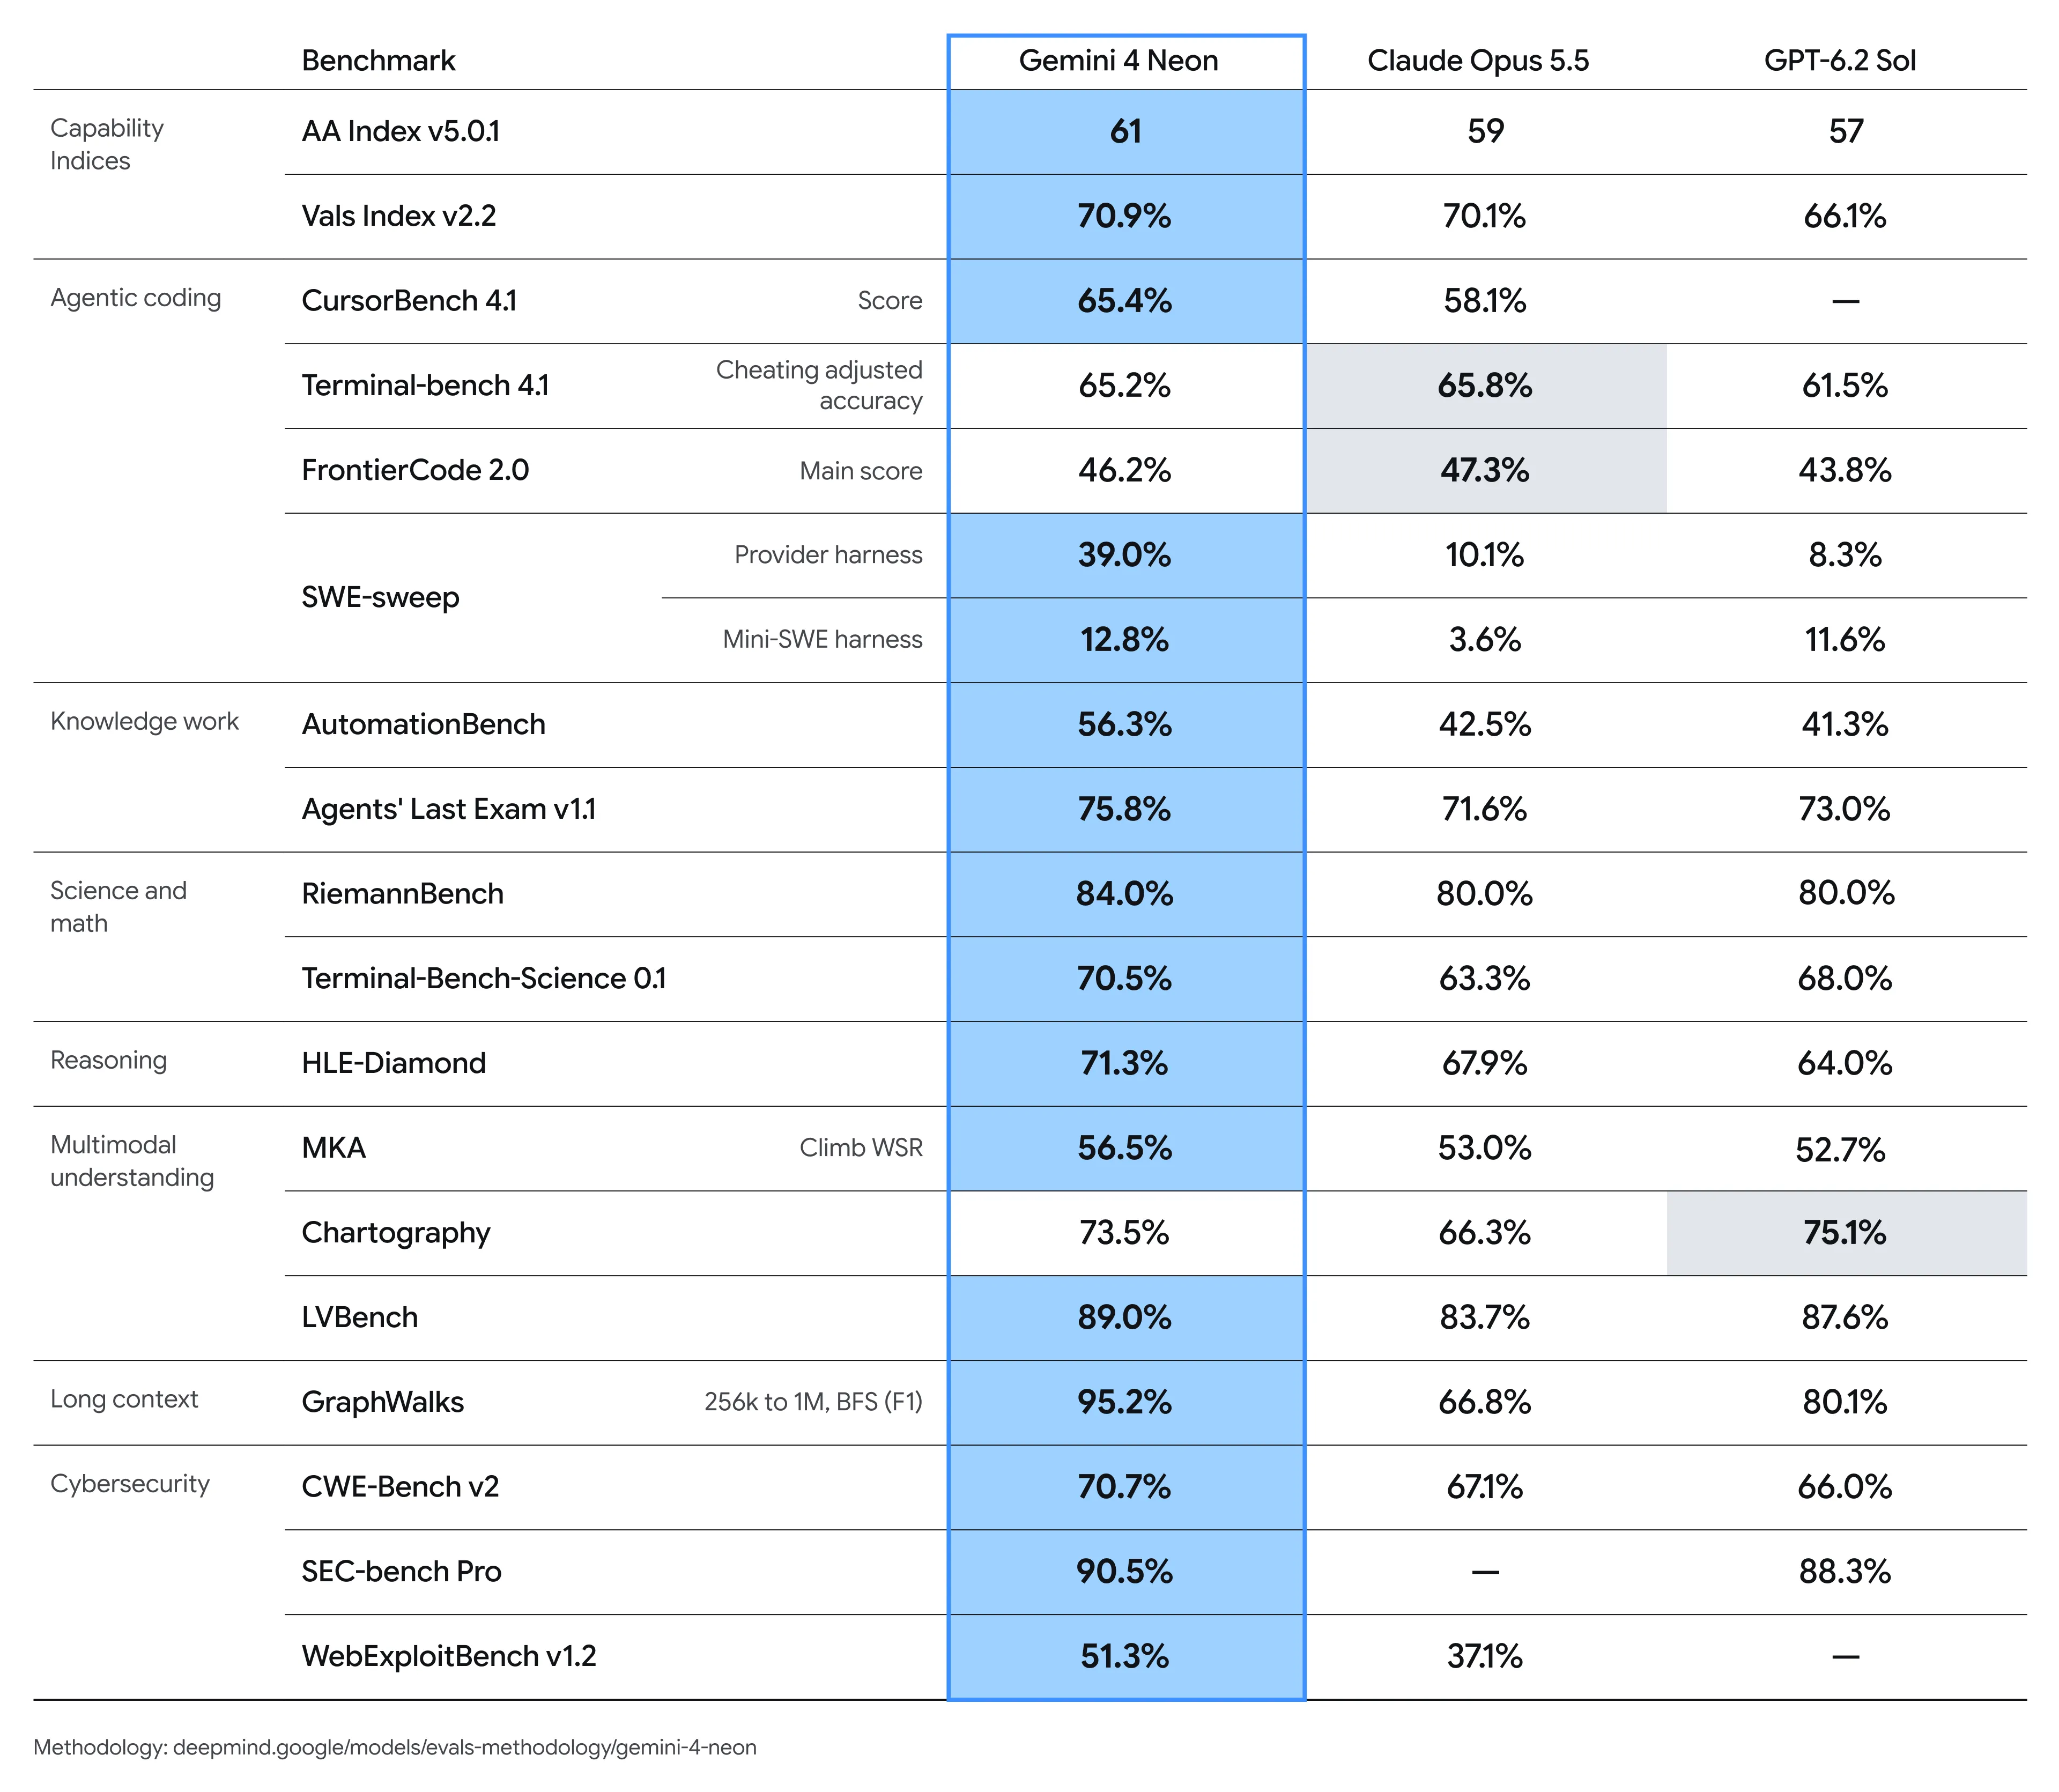
El modelo deja atrás la falta de fiabilidad y las alucinaciones que habían plagado los modelos Gemini anteriores, lo que permite que brille su inteligencia pura. Lo primero que notarás es que el modelo destaca especialmente en la comunicación y tiene un estilo de escritura muy fácil de leer, mejor que el de Opus y Fable, y a años luz de los modelos GPT 6.x. También interpreta bien la intención (la capacidad del modelo para entender tu prompt), al tiempo que sabe cuándo cuestionar tus ideas o señalar problemas de antemano, algo que a la mayoría de los demás modelos les cuesta.
Neon también es extremadamente capaz: puede completar tareas de programación que les cuestan a Astra y Fable, y además escribe código de gran calidad (del tipo que aprobaría un ingeniero de software sénior).
El modelo también es rentable: se sitúa entre Opus 5.5 y Sol 6.2 tanto en precio como en consumo de tokens, y los planes de suscripción de Google subvencionan bastante su uso, lo que lo convierte en un gran modelo para el trabajo diario (a diferencia de Astra y Fable, que son demasiado caros para la mejora de rendimiento que ofrecen).
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| Gemini 4 Neon | $3 | $15 | 81 |
| GPT 6.2 Sol | $2 | $10 | 55 |
| Claude Opus 5.5 | $4 | $20 | 86 |
El modelo sigue teniendo a veces una personalidad peculiar y un poco desquiciada (se entusiasma mucho), pero esto no parece afectar a su rendimiento, y todavía no lo he visto perder los papeles.
A diferencia de los lanzamientos anteriores de Gemini, prácticamente no he visto ninguna opinión negativa sobre el modelo. Google también ha hecho un buen trabajo al reducir la latencia del modelo (el primer token antes tardaba más de 10 segundos en llegar en Antigravity) y mejorar la tasa de aciertos de la caché de tokens de entrada (la mayoría de los tokens que usas son tokens de entrada en caché, y cuestan una décima parte que los tokens de entrada normales).
El único punto negativo de Neon es que está encerrado en Antigravity, el mediocre entorno de agentes de Google, que carece de muchas de las funciones y capacidades de entornos más modernos como Claude Code, Codex, OpenCode o Pi. Google también es estricto con el uso de su plan de suscripción en otros entornos, así que estás atrapado usando el modelo en un entorno que lo limita un poco, aunque Neon suele ser lo bastante inteligente como para detectar estas limitaciones y sortearlas. Google ha adelantado que abrirá más su ecosistema a principios de diciembre.
Yo pondría este modelo al mismo nivel que Opus 5.5, y por delante de cualquiera de los modelos de OpenAI. Es más que suficientemente inteligente y tiene el mejor gusto y estilo de escritura de todos los modelos.
A medida que resulta más difícil distinguir las capacidades de los modelos, su capacidad para comunicarse con el usuario cobra cada vez más importancia, y ahora mismo Neon es el mejor modelo en ese aspecto. Por primera vez, me han convencido de pagar una suscripción a Gemini. Google ha vuelto.
GPT 6.2
Con la salida a bolsa de Anthropic esta semana, OpenAI quería aguarle la fiesta y lanzar algo que hiciera bajar la valoración de Anthropic, y los modelos elegidos para esa tarea fueron GPT 6.2 Astra y Sol.
Decir que las cosas no le salieron bien a OpenAI sería quedarse corto.
Inmediatamente después del lanzamiento de GPT 6.2, muchos de los usuarios que pudieron probar la versión beta salieron a decir que el modelo era horrible. Era la primera vez que veía una reacción tan negativa justo después del lanzamiento de un modelo.
Resulta que OpenAI había corregido un montón de problemas a última hora antes del lanzamiento, y no les dio a quienes probaron la beta tiempo alguno para volver a probar el modelo. Pero, después de más pruebas, el modelo sigue pareciendo tener problemas.
Todos los problemas se reducen a la capacidad del modelo para seguir instrucciones. OpenAI siempre ha tenido modelos que siguen las instrucciones de forma bastante literal (en comparación con Claude), y GPT 6.2 lleva eso hasta un extremo que lo hace casi inutilizable. 6.2 no puede manejar ningún grado de ambigüedad. Toma lo que dices y lo ejecuta de forma muy literal, hasta el punto de actuar en contra de tu intención, como la pata de mono de los deseos.
Esto hace que al modelo los árboles no le dejen ver el bosque: se atasca en los detalles, a menudo hasta quedarse paralizado.
Esto puede ser una ventaja si estás metido hasta el fondo en un campo concreto, por ejemplo, si eres ingeniero de sistemas sénior o estudiante de doctorado, y buscas y agradeces esa atención al detalle. Si no eres una de esas personas, su estilo de escritura te VA a resultar casi incomprensible.
Parece lo opuesto a Gemini 4 Neon, que ofrece explicaciones muy claras y bien redactadas, mientras que GPT 6.2 produce una mezcla confusa de jerga que tienes que leer 3 veces para entender qué está pasando.
Esto ha provocado una de las mayores divisiones de opinión que hemos visto sobre un modelo.
Revisión de código: genial
Explicaciones rápidas: terrible
Programación de sistemas de bajo nivel: uno de los mejores
Creación de aplicaciones (vibe coding): horrible
Según cómo le des instrucciones al modelo y para qué lo uses, puedes tener una experiencia muy distinta.
También le falta diversidad en sus respuestas. Quienes lo han probado han observado que, al crear juegos, sin importar el género, llama al nivel Bellweather y lo construye en torno al agua y la música. Esto afecta a los casos de uso de investigación automatizada, en los que el modelo debe tener un conjunto diverso de ideas para seguir mejorando con el tiempo.
Para muchas personas, GPT 6.2 es un paso atrás, y muchos seguidores de OpenAI están volviendo a Sol 6.1. Si estás entre los mejores de tu campo y tienes prompts profundos y técnicos que darle, GPT 6.2 puede ser el mejor modelo para ti.
Para el usuario medio, esto es un paso atrás respecto a 6.1 Sol y 6 Astra, y no recomendaría cambiarse a él. En mi caso, voy a pasar a usar Opus 5.5 como modelo principal de ahora en adelante, con algo de Gemini 4 Neon de vez en cuando, y voy a dejar atrás los modelos GPT después de usarlos como modelo principal durante casi todo el año.
Noticias breves
Inkling 2 Mini
El lanzamiento de Inkling 2 Small de Thinking Machines devolvió al código abierto estadounidense un lugar relevante en el panorama, y ahora su lanzamiento Mini busca disputarle a Qwen el puesto del mejor LLM que puedes ejecutar en tu propio hardware.
Inkling 2 Mini es un modelo de mezcla de expertos (MoE) de 26 mil millones de parámetros, con capacidades que rivalizan con las de Qwen 3.8 27B, que lleva mucho tiempo siendo el mejor LLM «pequeño», pero es más de 5 veces más rápido gracias a su arquitectura MoE.
Compite de tú a tú con Qwen en pruebas de agentes y programación, con mejor gusto y estilo. Sí tiene algunas carencias, sobre todo en el rendimiento de las conversaciones de varios turnos y en el consumo de tokens: usa un 38 % más de tokens que Qwen, que tampoco destacaba por ser especialmente conciso al razonar.
Creo que merece la pena tenerlo en cuenta si te gusta la IA local. Qwen 27B era especialmente difícil de ejecutar en los Mac por la gran capacidad de cómputo necesaria para ejecutar ese modelo denso, mientras que Inkling es mucho más ligero en comparación.
Los LLM locales todavía están lejos de poder competir con cualquiera de los modelos más grandes, así que solo recomendaría plantearse ejecutarlos si te tomas muy en serio la privacidad o simplemente disfrutas haciéndolo.
Cierre
Espero que hayas disfrutado de las noticias de esta semana. Si quieres recibir las noticias cada semana, no olvides suscribirte a nuestra lista de correo a continuación.