
Nota: Este artigo foi traduzido automaticamente com OpenAI gpt-6.1-sol por meio do Codex CLI; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Notícias
Solução da Hipótese de Riemann
Depois da solução de Navier-Stokes pela OpenAI, o pesquisador da Anthropic Levent Alpoge demonstrou um dos problemas mais famosos da matemática, a Hipótese de Riemann. Há 35 dias, Terrance Tao, amplamente considerado o maior matemático vivo, disse que esperava que a Hipótese de Riemann talvez fosse resolvida até 2050. Parece que ele errou por um pouquinho.
Levent apresentou um texto de 4 páginas, junto com uma formalização do problema em Lean com 17 milhões de linhas, que foi executada de forma independente e confirmada como correta por mais de uma dúzia de pessoas das comunidades de matemática e Lean.
Esperava-se que a demonstração exigisse várias técnicas novas, mas ela acabou percorrendo diversas áreas da matemática aparentemente sem relação entre si. Levent pediu ao Claude que escrevesse uma apresentação convencional da demonstração, mas ela passou de 250 mil páginas. Então ele decidiu publicar apenas a formalização em Lean por enquanto, em vez de uma “aberração gigantesca e ilegível de conteúdo de baixa qualidade”.
Com isso, se ainda não estava claro, chegamos à AGI na matemática. Navier-Stokes era considerado um problema relativamente ao alcance dos humanos, mas a Hipótese de Riemann era amplamente considerada impossível com as ferramentas que temos hoje.
A matemática é a área mais pura para treinar modelos (é muito claro e evidente se algo está correto), e por isso foi a primeira a cair. Não tenho tanta confiança de que os LLMs conseguirão resolver problemas de outras áreas com a mesma facilidade, mas isso mostrou que conseguimos criar modelos melhores do que praticamente todos os humanos em uma determinada área, usando apenas dados gerados por humanos.
Lançamentos
Gemini 4 Neon
Não acredito que estou dizendo isso, mas o Google finalmente conseguiu e lançou um LLM de ponta. O Gemini 4 Neon é o mais recente da enxurrada de lançamentos do Google no último mês, e de longe o melhor.
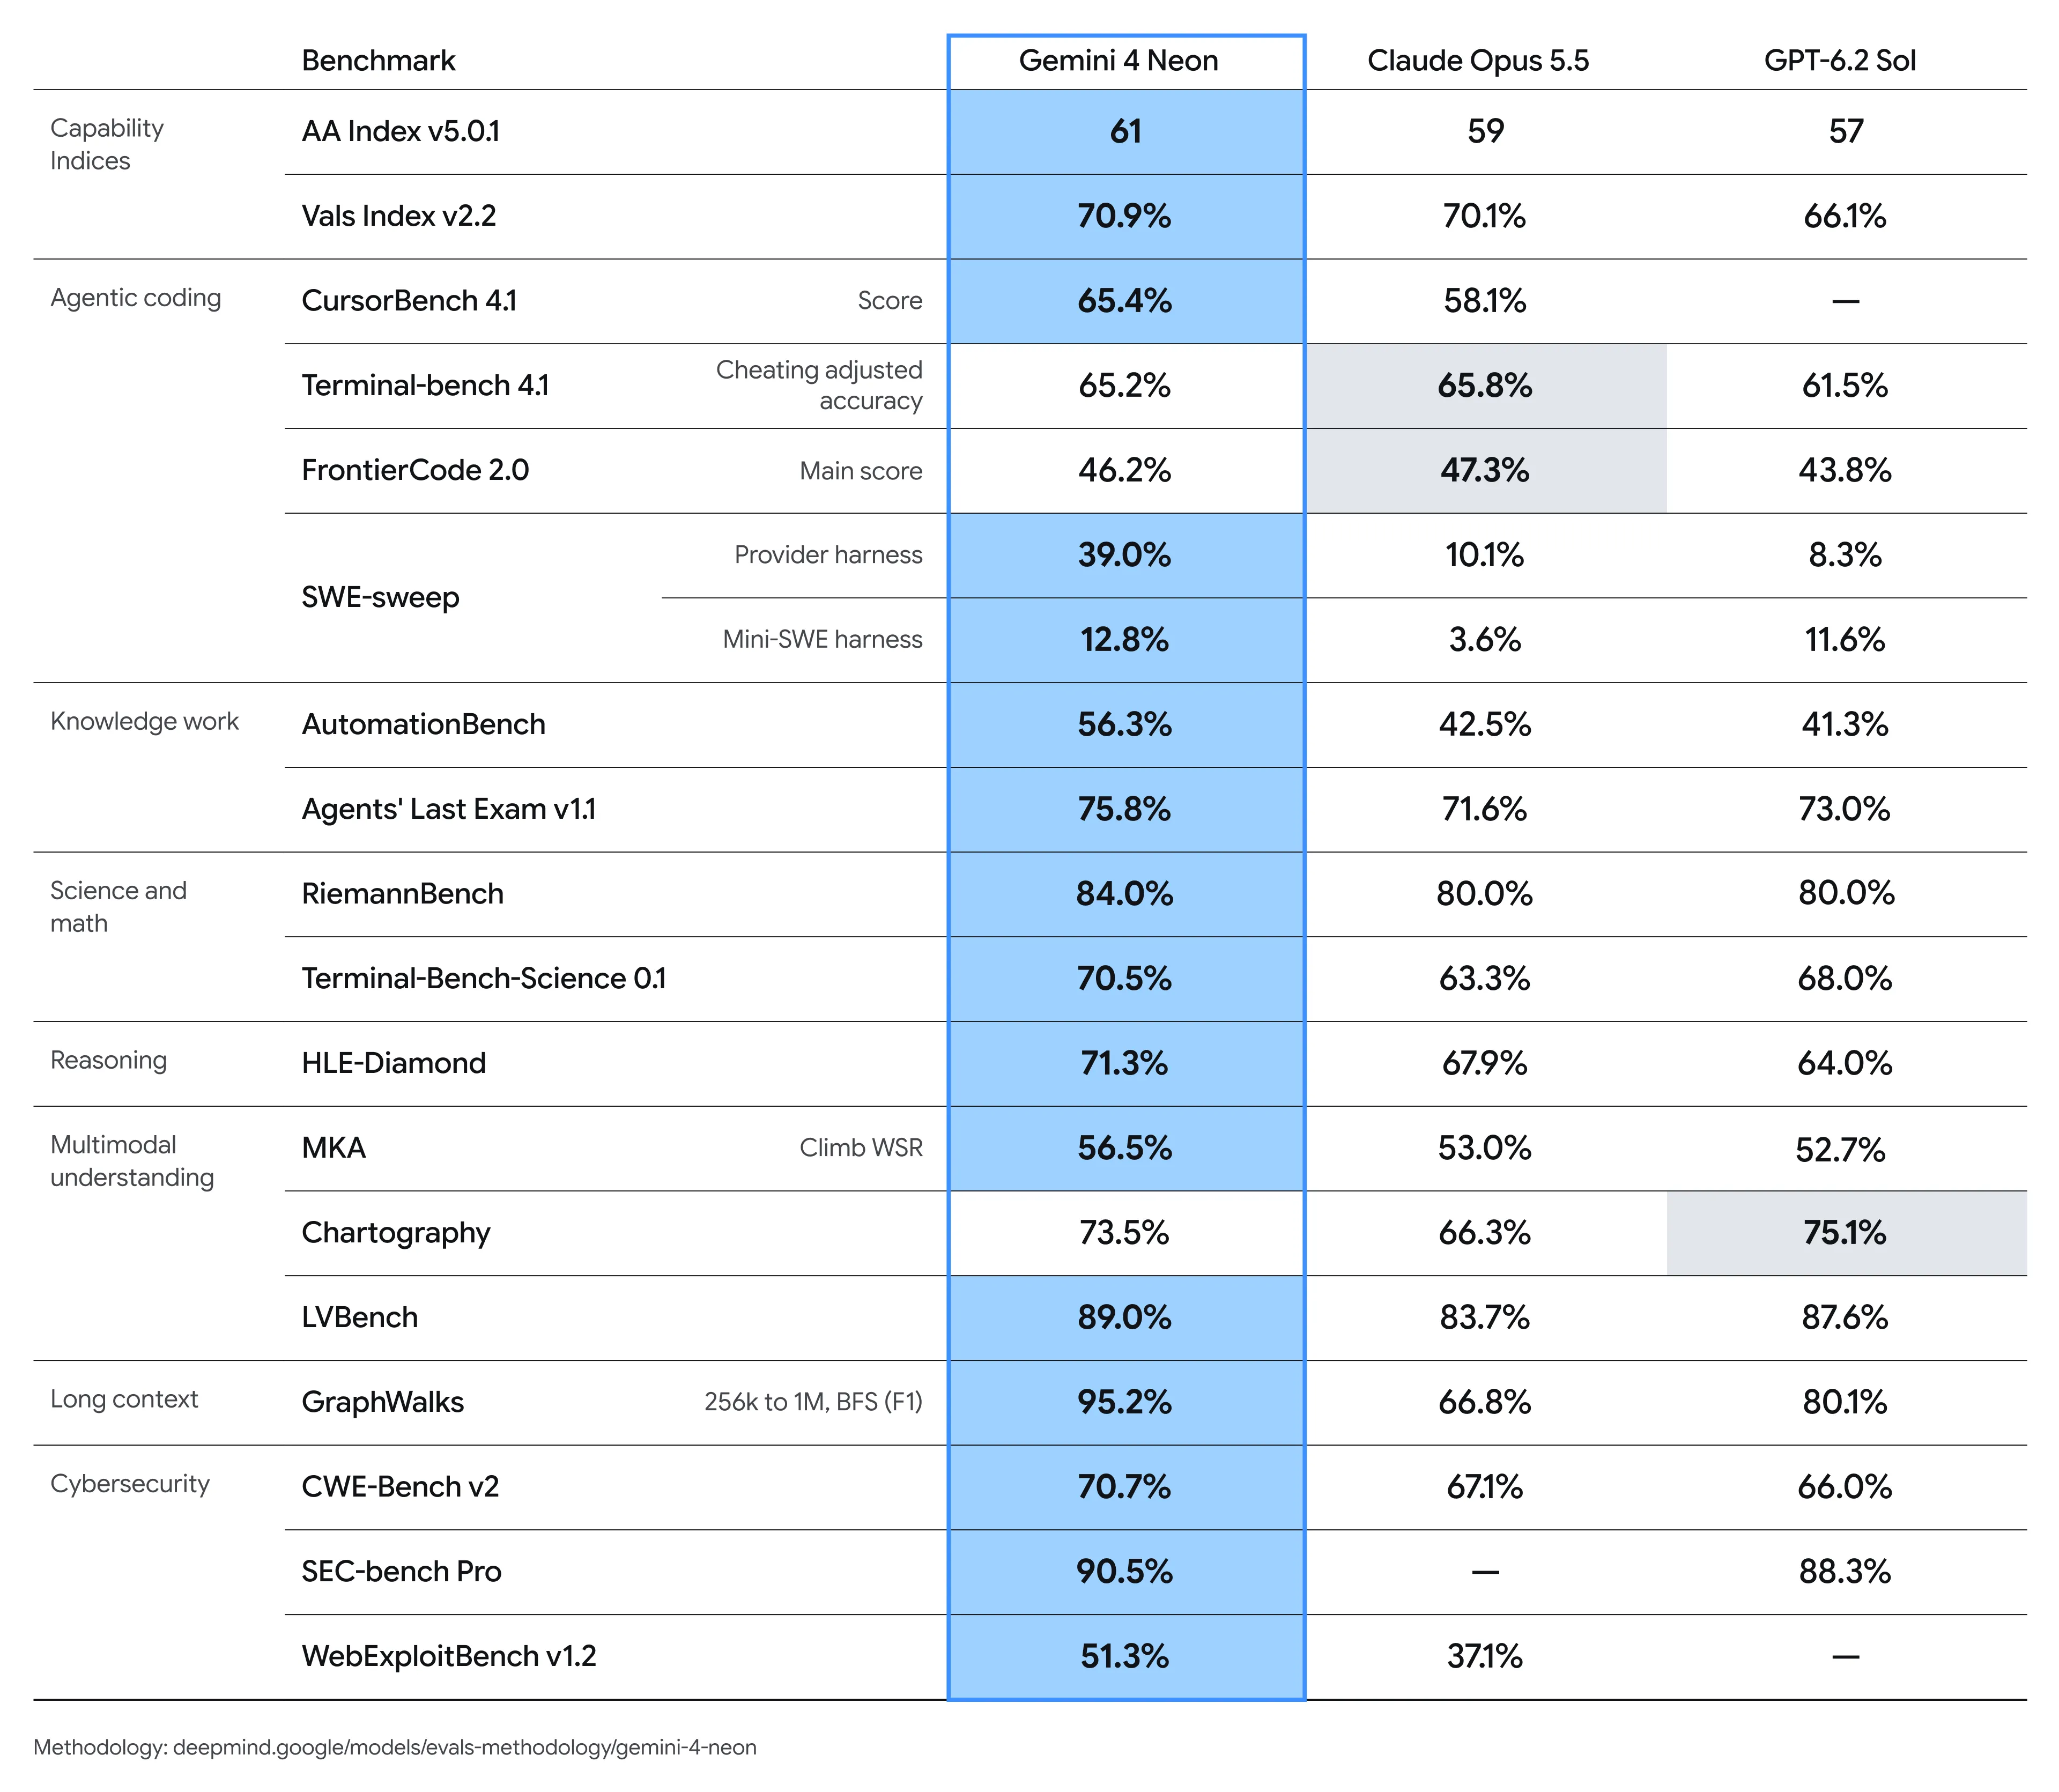
O modelo elimina a falta de confiabilidade e as alucinações que prejudicavam os modelos Gemini anteriores, deixando sua inteligência bruta aparecer. A primeira coisa que você vai notar é que o modelo se sai particularmente bem na comunicação e tem um estilo de escrita muito fácil de ler, melhor que o do Opus e do Fable, e muito à frente dos modelos GPT 6.x. Ele também é bom em inferir intenções (a capacidade do modelo de entender seu prompt), além de saber quando contestar suas ideias ou apontar problemas com antecedência, algo que a maioria dos outros modelos tem dificuldade em fazer.
O Neon também é extremamente capaz, conseguindo concluir tarefas de programação com as quais o Astra e o Fable têm dificuldade, enquanto escreve código de alta qualidade (do tipo que um engenheiro de software sênior aprovaria).
O modelo também tem boa relação entre custo e desempenho, ficando entre o Opus 5.5 e o Sol 6.2 tanto no preço quanto no uso de tokens. Além disso, os planos de assinatura do Google subsidiam bem seu uso, o que faz dele um ótimo modelo para o trabalho do dia a dia (ao contrário do Astra e do Fable, que custam caro demais para o ganho de desempenho que oferecem).
| Modelo | US$ por milhão (entrada) | US$ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| Gemini 4 Neon | $3 | $15 | 81 |
| GPT 6.2 Sol | $2 | $10 | 55 |
| Claude Opus 5.5 | $4 | $20 | 86 |
O modelo ainda tem uma personalidade distinta e meio doida às vezes (ele se empolga bastante), mas isso não parece afetar o desempenho, e ainda não vi nenhum surto dele.
Ao contrário dos lançamentos anteriores do Gemini, praticamente não vi comentários negativos sobre o modelo. O Google também fez um bom trabalho ao melhorar a latência do modelo (o tempo até o primeiro token costumava passar de 10 segundos no Antigravity) e aumentar a taxa de acertos do cache de tokens de entrada (a maioria dos tokens que você usa são tokens de entrada em cache, que custam um décimo do preço dos tokens de entrada normais).
O único ponto negativo do Neon é que ele fica preso ao Antigravity, o ambiente de agentes inferior do Google, que não tem muitos dos recursos e capacidades de ambientes mais modernos, como Claude Code, Codex, OpenCode ou Pi. O Google também é rígido quanto ao uso do plano de assinatura em outros ambientes, então você fica preso a usar o modelo em um ambiente que limita um pouco suas capacidades, embora o Neon geralmente seja inteligente o bastante para perceber essas limitações e contorná-las. O Google deu a entender que abrirá mais seu ecossistema no início de dezembro.
Eu colocaria esse modelo no mesmo nível do Opus 5.5 e à frente de qualquer modelo da OpenAI. Ele é inteligente de sobra e tem o melhor bom gosto e estilo de escrita entre todos os modelos.
À medida que fica mais difícil diferenciar as capacidades dos modelos, a capacidade de se comunicar com o usuário se torna cada vez mais importante, e hoje o Neon é o melhor modelo nisso. Pela primeira vez, eles me convenceram a pagar por uma assinatura do Gemini. O Google está de volta.
GPT 6.2
Com o IPO da Anthropic nesta semana, a OpenAI quis estragar a festa e lançar algo que fizesse a avaliação da Anthropic cair. Os modelos escolhidos para essa missão foram o GPT 6.2 Astra e o Sol.
Dizer que as coisas não deram certo para a OpenAI seria pouco.
Logo depois do lançamento do GPT 6.2, muitos dos usuários que participaram dos testes beta vieram a público dizer que o modelo era péssimo. Foi a primeira vez que vi uma reação tão negativa imediatamente após o lançamento de um modelo.
Acontece que a OpenAI havia corrigido vários problemas na última hora antes do lançamento e não deu tempo algum para os participantes do beta testarem o modelo de novo. Mas, depois de mais testes, o modelo ainda parece ter problemas.
Todos os problemas se resumem à capacidade do modelo de seguir instruções. A OpenAI sempre teve modelos que seguem instruções de forma bastante literal (em comparação com o Claude), e o GPT 6.2 leva isso a um nível que o torna quase inutilizável. O 6.2 não consegue lidar com nenhum grau de ambiguidade. Ele pega o que você diz e executa ao pé da letra, a ponto de contrariar sua intenção, como no conto da pata do macaco.
Isso faz o modelo perder a visão do todo, ficando preso nos detalhes, muitas vezes a ponto de paralisar.
Isso pode ser uma vantagem se você estiver profundamente envolvido nos detalhes de uma área específica, como um engenheiro de sistemas sênior ou um doutorando, em que essa atenção aos detalhes é desejada e valorizada. Se você não se encaixa em um desses perfis, VAI achar o estilo de escrita dele quase incompreensível.
Ele parece o oposto do Gemini 4 Neon, que tem explicações muito claras e bem escritas, enquanto o GPT 6.2 é uma mistura confusa de jargões que você precisa ler 3 vezes para entender o que está acontecendo.
Isso causou uma das maiores divisões de opinião que já vimos sobre um modelo.
Revisão de código - ótimo
Explicações rápidas - péssimo
Programação de sistemas de baixo nível - um dos melhores
Criação de aplicativos (vibe coding) - horrível
Dependendo de como você escreve os prompts e para que usa o modelo, a experiência pode ser muito diferente.
Também falta diversidade nas respostas. Os participantes dos testes perceberam que, ao criar jogos, independentemente do gênero, ele dá à fase o nome de Bellweather e a constrói em torno de temas de água e música. Isso afeta casos de uso de pesquisa automatizada, nos quais o modelo precisa de um conjunto variado de ideias para continuar melhorando ao longo do tempo.
Para muita gente, o GPT 6.2 é um retrocesso, e muitos fãs da OpenAI estão voltando ao Sol 6.1. Se você está entre os melhores da sua área e tem prompts profundos e técnicos para fornecer, o GPT 6.2 pode ser a melhor opção para você.
Para o usuário comum, ele é um retrocesso em relação ao 6.1 Sol e ao 6 Astra, e eu não recomendaria a troca. Pessoalmente, vou passar a usar o Opus 5.5 como meu modelo principal daqui para a frente, com um pouco de Gemini 4 Neon também, e me afastar dos modelos GPT depois de usá-los como minha principal opção durante quase o ano inteiro.
Notas rápidas
Inkling 2 Mini
O lançamento do Inkling 2 Small, da Thinking Machines, colocou os modelos de código aberto dos EUA de volta no jogo de forma significativa. Agora, o lançamento do Mini parece querer disputar com o Qwen o posto de melhor LLM que você pode executar em hardware próprio.
O Inkling 2 Mini é um modelo de mistura de especialistas (MoE) com 26 bilhões de parâmetros e capacidades que rivalizam com as do Qwen 3.8 27B, há muito tempo o melhor LLM “pequeno”, sendo mais de 5 vezes mais rápido por ser um modelo MoE.
Ele compete de igual para igual com o Qwen nos benchmarks de agentes e programação, com mais bom gosto e um estilo melhor. Mas tem algumas deficiências, principalmente no desempenho em conversas com várias interações e no uso de tokens: ele usa 38% mais tokens que o Qwen, que já não era conhecido por raciocinar de forma particularmente sucinta.
Acho que vale considerar esse modelo se você gosta de IA local. O Qwen 27B era particularmente difícil de executar em Macs por causa da grande quantidade de processamento necessária para rodar o modelo denso, enquanto o Inkling é muito mais leve em comparação.
Os LLMs locais ainda estão longe de competir com qualquer um dos modelos maiores, então eu só recomendaria explorar seu uso se você dá muita importância à privacidade ou simplesmente gosta de fazer isso.
Encerramento
Espero que você tenha gostado das notícias desta semana. Se quiser receber as notícias toda semana, não deixe de se inscrever na nossa lista de e-mails abaixo.