
注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新闻
黎曼猜想获解
继 OpenAI 解决了 Navier–Stokes 方程问题之后,Anthropic 研究员 Levent Alpoge 证明了数学界最著名的难题之一——黎曼猜想。 35 天前,被广泛认为是当今最伟大数学家的 Terrance Tao 表示,他预计黎曼猜想或许能在 2050 年前得到解决。 看来他的预测稍微偏了一点。
Levent 给出了一份 4 页的说明,以及一份长达 1700 万行的 Lean 形式化证明。数学和 Lean 社区已有十几个人独立运行了这份证明,并确认其正确无误。
人们原本以为,这个证明需要一大批新方法,结果它却串起了许多看似毫不相关的数学领域。 Levent 让 Claude 写了一份常规形式的证明,结果篇幅超过了 25 万页。因此,他决定暂时只发布 Lean 形式化证明,而不是放出“一大堆根本读不下去的垃圾”。
到这里,如果之前还不够明确的话,现在我们已经在数学领域实现了 AGI。 人们认为,人类解决 Navier–Stokes 方程问题还有一定希望,但普遍认为,凭我们现有的工具,黎曼猜想是不可能解决的。
数学是最纯粹的训练领域,答案是否正确非常明确,所以它最先被攻克了。 我不太确定 LLM 能否同样轻松地攻克其他领域,但这已经表明,仅靠人类产生的数据,我们就能训练出在某个领域胜过几乎所有人类的模型。
新品发布
Gemini 4 Neon
真不敢相信我会说出这句话,但 Google 终于做到了,发布了一个前沿水平的 LLM。 Gemini 4 Neon 是 Google 过去一个月密集发布的众多产品中最新的一款,也是其中表现最好的一款,远胜其他产品。
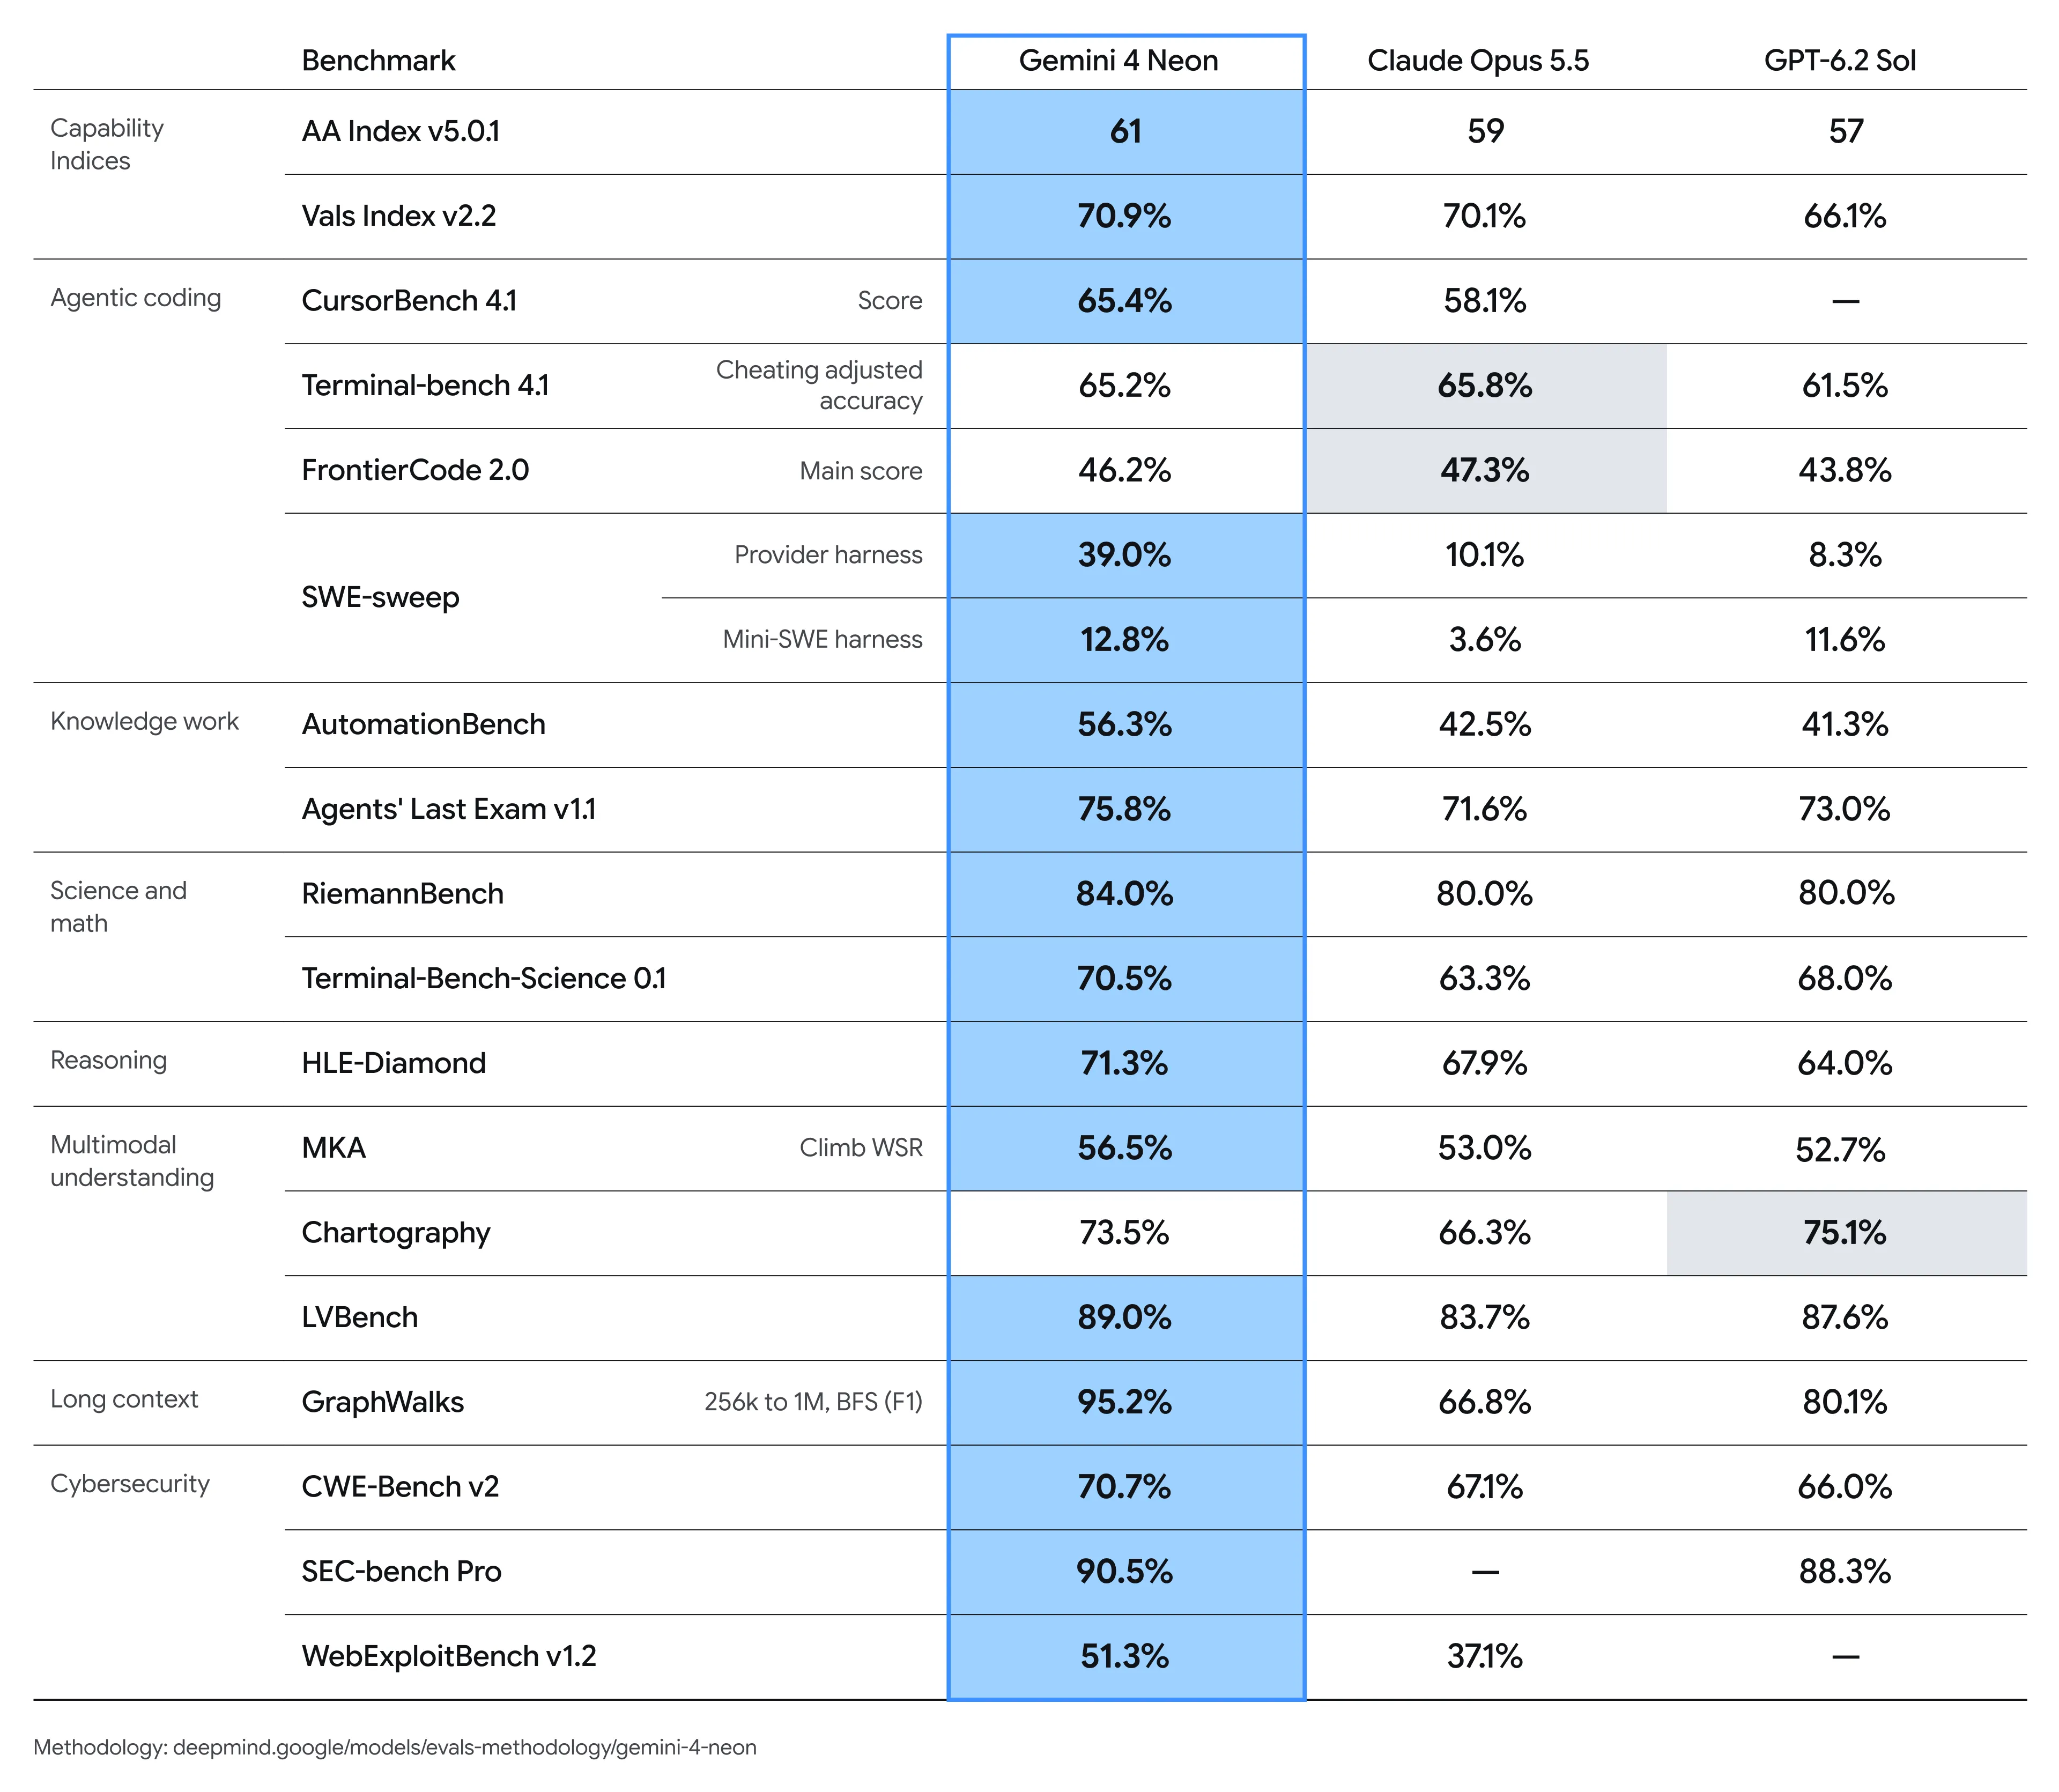
这个模型摆脱了困扰此前 Gemini 模型的可靠性问题和幻觉,让它本身的智能终于得以充分发挥。 你首先会注意到,它特别擅长沟通,文风非常易读,胜过 Opus 和 Fable,更是把 GPT 6.x 系列甩出了几条街。 它也很擅长推断意图,也就是理解你的提示词。同时,它知道什么时候该反驳你的想法,或者提前指出问题,而大多数其他模型都不太擅长这些。
Neon 的能力也非常强,能完成 Astra 和 Fable 都觉得棘手的编程任务,而且写出的代码质量很高,属于资深软件工程师也会认可的那种。
这个模型的性价比也不错,价格和 token 用量都介于 Opus 5.5 和 Sol 6.2 之间。Google 的订阅套餐也给了它很大的补贴,因此很适合当日常主力模型。相比之下,Astra 和 Fable 的性能提升就对不起它们的价格了。
| 模型 | 每百万输入 token 的价格 | 每百万输出 token 的价格 | 每秒 token 数 |
|---|---|---|---|
| Gemini 4 Neon | $3 | $15 | 81 |
| GPT 6.2 Sol | $2 | $10 | 55 |
| Claude Opus 5.5 | $4 | $20 | 86 |
这个模型有时仍会表现出鲜明、略显癫狂的个性,经常特别兴奋。不过,这似乎没有影响它的表现,而且我还没见过它情绪失控。
与此前的 Gemini 版本不同,我几乎没看到任何关于这个模型的负面反馈。 Google 在降低模型延迟方面也做得不错,以前在 Antigravity 中,首个 token 的等待时间要超过 10 秒。此外,他们还提高了输入 token 的缓存命中率。你使用的大部分 token 都是缓存输入 token,其价格只有普通输入 token 的十分之一。
Neon 唯一的缺点,是它被锁在 Google 表现平平的 Antigravity 智能体运行环境里。相比 Claude Code、Codex、OpenCode 或 Pi 等更现代的运行环境,Antigravity 缺少许多功能和能力。 Google 对在其他运行环境中使用其订阅套餐也限制得很严,所以你只能在一个让模型有些施展不开的环境里使用它。不过,Neon 通常足够聪明,能发现这些限制并设法绕过去。 Google 已经暗示,他们将在 12 月初进一步开放自己的生态系统。
我会把这个模型放在与 Opus 5.5 相同的档次,高于 OpenAI 的所有模型。它足够聪明,而且在所有模型中,它的审美和文风都是最好的。
随着模型能力越来越难分出高下,模型与用户沟通的能力也变得越来越重要。目前,Neon 是这方面最好的模型。 这是 Google 第一次说服我付费订阅 Gemini。 Google 回来了。
GPT 6.2
Anthropic 本周 IPO,OpenAI 想来搅局,发布点东西来压低 Anthropic 的估值。它们派来完成这项任务的模型,就是 GPT 6.2 Astra 和 Sol。
说 OpenAI 这次不太顺利,都算客气了。
GPT 6.2 刚发布,许多参与过模型内测的用户就站出来说,这个模型糟透了。我还是第一次看到,一个模型刚发布就收到如此负面的反馈。
原来,OpenAI 在发布前的最后一刻修复了一堆问题,却完全没有给内测用户重新测试的时间。 但经过更多测试之后,这个模型似乎仍然存在问题。
这些问题归根结底都出在模型的指令遵循能力上。 与 Claude 相比,OpenAI 的模型一直都比较倾向于按字面意思执行指令,而 GPT 6.2 把这一点推到了几乎没法用的程度。 6.2 完全应付不了任何模糊之处。 它会极其字面化地执行你说的话,甚至偏离你的真实意图,就像“猴爪”许愿故事里那样。
这会让模型只见树木,不见森林,深陷细节之中,甚至经常因此停滞不前。
如果你在某个领域钻研得很深,比如资深系统工程师或博士生,那么这可能是个优点,因为你需要并欣赏模型对细节的关注。 如果你不属于这类人,你肯定会觉得它的文风几乎让人看不懂。
它给人的感觉与 Gemini 4 Neon 完全相反。Neon 的解释清晰、措辞得当,而 GPT 6.2 则是把各种术语搅在一起,你得读上三遍才能明白它在说什么。
这让它成为我们见过的用户评价分歧最大的模型之一。
代码审查——很棒
快速讲解——糟透了
底层系统编程——最好的模型之一
应用开发(氛围编程)——烂透了
你怎么写提示词,以及用它做什么,会让你的体验天差地别。
它的输出也缺乏多样性。 测试者发现,让它制作游戏时,不管是什么类型,它都会把关卡命名为 Bellweather,并围绕水和音乐这两个主题来设计。 这会影响自动研究类的应用场景,因为在这些场景中,模型需要不断提出多样化的想法,才能持续改进。
对很多人来说,GPT 6.2 是一次退步,许多 OpenAI 的支持者都换回了 Sol 6.1。 如果你是所在领域的顶尖人士,能给它深入且技术性很强的提示词,那么 GPT 6.2 可能是最适合你的模型。
对普通人来说,它比 6.1 Sol 和 6 Astra 都退步了,我不建议换用它。 就我个人而言,接下来我会把 Opus 5.5 作为主力模型,偶尔搭配使用 Gemini 4 Neon。在今年几乎一直把 GPT 系列作为主力模型之后,我要逐渐告别它们了。
简讯
Inkling 2 Mini
Thinking Machines 发布的 Inkling 2 Small,让美国开源模型重新有了一席之地。现在,他们发布的 Mini 看起来要挑战 Qwen,争夺自有硬件上能运行的最佳 LLM 这个位置。
Inkling 2 Mini 是一个拥有 260 亿参数的混合专家(MoE)模型,能力可与长期占据最佳“小型”LLM 位置的 Qwen 3.8 27B 媲美。同时,由于采用了 MoE 架构,它的速度是后者的 5 倍以上。
在智能体和编程基准测试中,它与 Qwen 不相上下,审美和风格则更胜一筹。 它也有一些短板,尤其是多轮对话表现和 token 用量。它使用的 token 比 Qwen 多 38%,而 Qwen 本来就不是以推理简洁著称的。
如果你喜欢在本地运行 AI,我觉得它值得考虑。 Qwen 27B 是稠密模型,运行时需要大量算力,因此在 Mac 上尤其难跑。相比之下,Inkling 的资源需求要低得多。
本地 LLM 目前仍远远无法挑战那些更大的模型,所以只有在你非常重视隐私,或者单纯喜欢折腾的情况下,我才建议你考虑在本地运行它们。
结语
希望你喜欢本周的新闻。如果你想每周都收到新闻,记得在下方订阅我们的邮件列表。