Nota: Este artículo fue traducido automáticamente con OpenAI GPT-5.5 mediante Codex CLI; la calidad puede verse degradada, especialmente en la terminología técnica.
Noticias
La decadencia de Google
El equipo de IA de Google ha estado teniendo dificultades últimamente. Sus modelos Gemini 3.1 Pro y Flash 3.5 no han logrado impresionar, sacándolos de la conversación como laboratorio de frontera. Con el auge de los laboratorios chinos de IA, que tienen órdenes de magnitud menos cómputo y aun así siguen siendo competitivos, si no mejores que los modelos Gemini, las cosas no han pintado bien para Google, que parece no haber sido capaz de resolver el post-entrenamiento de sus modelos.
Incluso han perdido su puesto como reyes multimodales, ya que OpenAI se ha centrado más en estas capacidades y ha logrado superar a Gemini.
Debido a este bajo rendimiento, están empezando a perder a sus investigadores estrella. El primero en irse esta semana fue Noah Shazeer.
Aunque no conozcas a Noam Shazeer, sí conoces su trabajo. Probablemente sea la figura más importante de la IA moderna, ya que se le atribuye haber ideado el mecanismo de atención moderno que usamos en los transformers (el avance principal del artículo Attention is All you Need) y también ser uno de los creadores de los modelos sparse mixture of experts, lo que nos ha permitido escalar eficientemente los LLMs hasta su tamaño actual.
Llamarlo el Kobe o el Messi de la IA se queda corto; es más bien el Jesús de la IA. Sin él, el campo no estaría donde está hoy.
Originalmente dejó Google en 2022 para fundar una startup llamada Character.ai, pero Google lo readquirió mediante acquihire en 2024 por 2.700 millones de dólares.
Solo 18 meses después, vuelve a abandonar el barco, esta vez rumbo a OpenAI, por lo que solo puedo asumir que es una cantidad ridícula de dinero.
La otra gran salida de esta semana fue John Jumper, el líder del proyecto del equipo de AlphaFold ganador del premio Nobel, quien anunció que se irá a Anthropic.
AlphaFold probablemente pasará a la historia como el mayor logro de Demis Hassabis y DeepMind (hay una razón por la que ganaron un Nobel por ello), así que perder a la persona que lideró ese proyecto es otro gran golpe para la organización.
Debido a los logros de estos investigadores, imagino que Google les ofreció el mundo, pero por la dirección o la cultura de la organización Google DeepMind decidieron abandonar el barco. También es interesante que se fueran a competidores diferentes, lo que muestra que Anthropic y OpenAI son considerados laboratorios de primer nivel por los mejores del campo, y que cuál es el mejor depende de tus propias opiniones; no hay un mejor definitivo al que todo el mundo vaya.
En cuanto a Google, no los veo recuperándose de esto. Sus modelos han ido empeorando en relación con la competencia (y ellos lo saben), y ahora perder a dos de sus investigadores más respetados provocará un éxodo aún mayor, similar a Meta tras el lanzamiento de Llama 4, cuando supuestamente perdieron el 80% de su equipo de IA debido a lo mal que rindió su modelo.
Todo esto a pesar de que Google tiene más cómputo que cualquiera de los grandes laboratorios de IA, lo que muestra que tu cómputo solo es tan bueno como las personas que lo usan, y que escalar no es todo lo que necesitas.
Lanzamientos
GLM 5.2
Mientras un gigante muere, otro emerge, ya que Z.ai ha lanzado GLM 5.2, que es competitivo con GPT 5.5 y Opus 4.8.
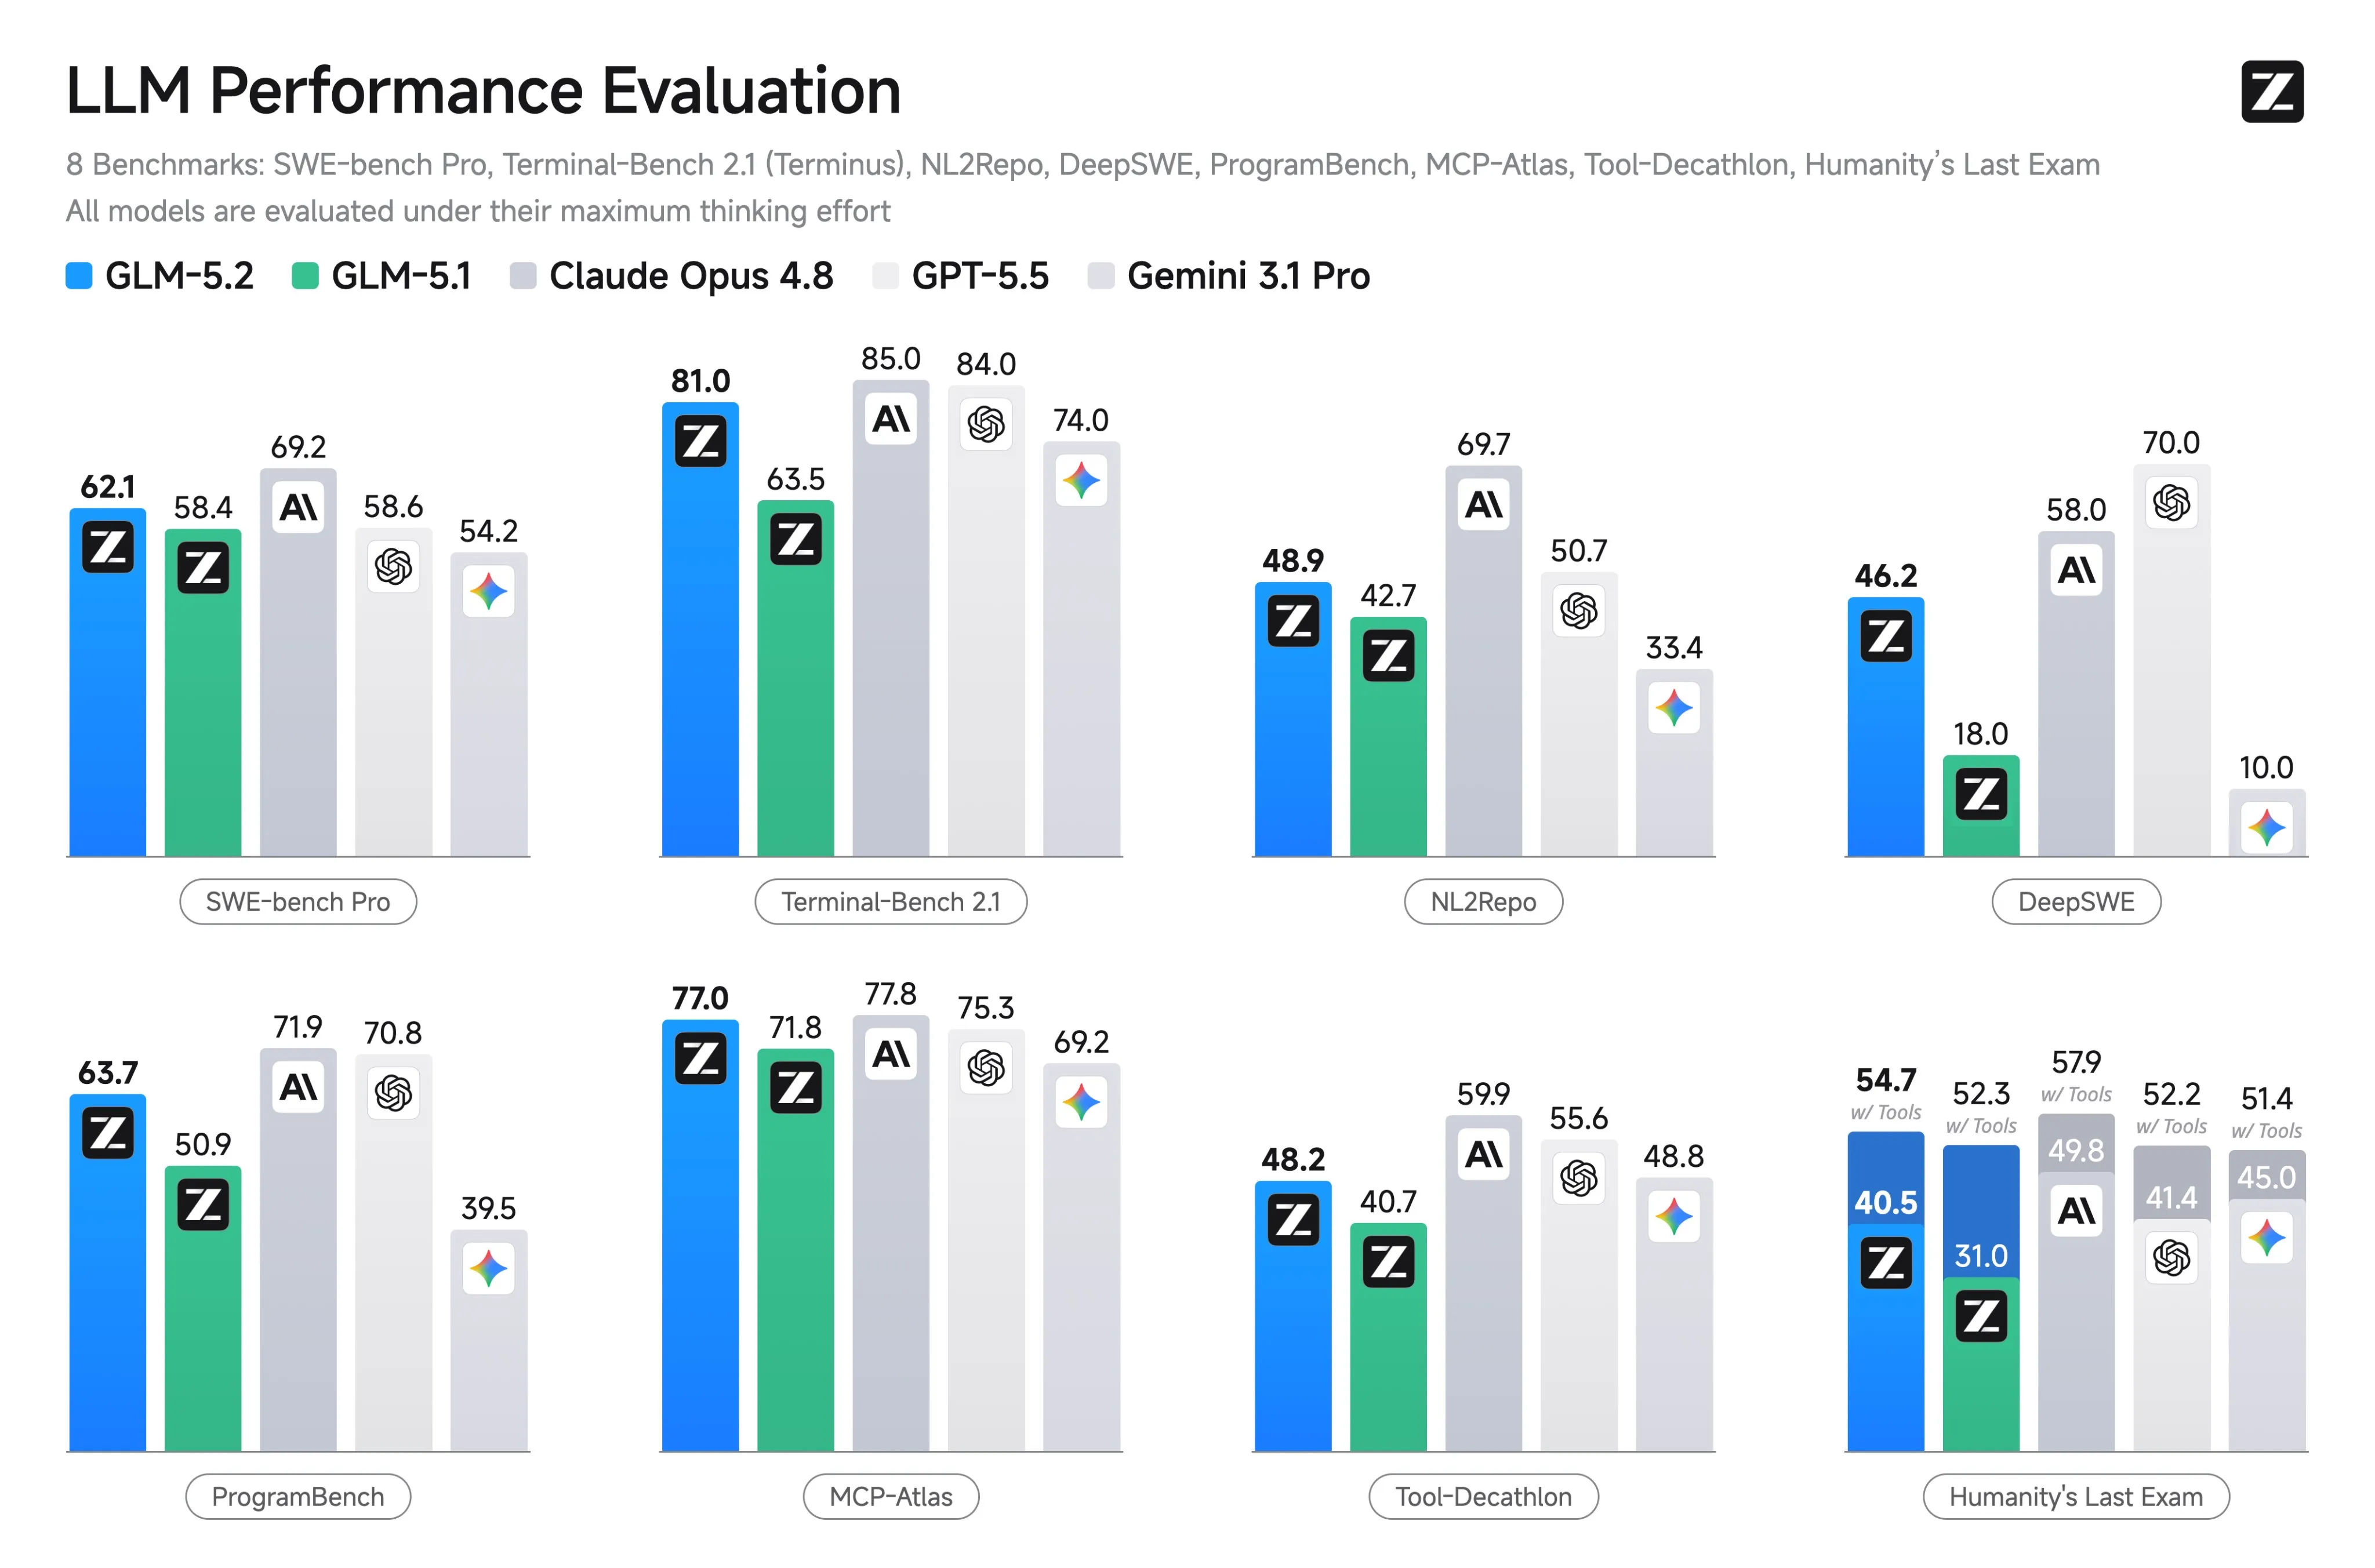
En el benchmark de alta señal DeepSWE, donde los modelos chinos han tenido dificultades, vemos una mejora importante.
Los modelos chinos también tienden a sufrir en benchmarks más nuevos porque sus modelos no son muy generales y no han tenido tiempo de sobreajustarse a los benchmarks. Al observar el rendimiento de GLM en benchmarks publicados esta semana, vemos una historia diferente.
En shape-rotator bench, vemos que GLM 5.2 supera a Opus 4.8. En el nuevo benchmark de trabajo de conocimiento agéntico de contexto largo de Artificial Analysis, GLM 5.2 es el tercer mejor modelo, quedando solo por detrás de Fable 5 y Opus 4.8, pero superando a GPT 5.5. En KernelBench-Mega y hard, consigue mejores aceleraciones que GPT 5.5 y que cualquier otro modelo open source, perdiendo solo ante Opus 4.8.
En algunos de los benchmarks menos concretos/de habilidades blandas también vemos un rendimiento sólido. En Design Arena, GLM 5.2 queda en primer lugar, superando a Fable 5. En EQ bench (escritura creativa e inteligencia emocional), supera a todos los demás modelos open source, incluido Kimi, que históricamente ha sido un modelo de escritura muy fuerte.
También pasa la prueba de sensaciones en el mundo real. He visto a muchas personas comparar el modelo con GPT 5.5 y Opus 4.8 en términos de calidad, y decir que ya no es un modelo al que recurren cuando se topan con límites de tasa en Claude o GPT, sino un modelo que puedes usar a diario con poca penalización de inteligencia.
Logra esto costando 1/3 del precio de GPT 5.5 y 1/5 del precio de Opus según Artifical Analysis.
Esto es muy emocionante de ver, y probablemente sea la brecha más pequeña que hemos tenido entre modelos open source y cerrados desde DeepSeek R1. Espero que los otros laboratorios chinos también se pongan al día en los próximos meses, lo que no hará más que intensificar aún más la batalla de los LLMs de frontera.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo abajo.