注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新闻
Google 的衰退
Google 的 AI 团队最近一直不太顺利。 他们的 Gemini 3.1 Pro 和 Flash 3.5 模型都没能让人眼前一亮,也让 Google 淡出了前沿 AI 实验室的讨论。 随着中国 AI 实验室的崛起,Google 的处境愈发不妙。这些实验室的算力比 Google 少了几个数量级,模型却依然能与 Gemini 一较高下,甚至表现更好,而 Google 似乎始终没能搞明白模型的后训练该怎么做。
他们甚至丢掉了多模态王者的宝座,因为 OpenAI 越来越重视这些能力,并且已经能够超越 Gemini。
由于表现不佳,他们开始流失明星研究员。 本周第一个离开的是 Noah Shazeer。
即使你不认识 Noam Shazeer,你也一定知道他的成果。 他可以说是现代 AI 领域最重要的人物:我们在 Transformer 中使用的现代注意力机制,也就是《Attention Is All You Need》论文中的核心突破,便有他的功劳。他也是稀疏混合专家模型的创始人之一,正是这类模型让我们能够高效地将大语言模型扩展到如今的规模。
称他为 AI 界的 Kobe 或 Messi,都低估了他。他更像是 AI Jesus,没有他,这个领域就不会发展到今天这一步。
他最早在 2022 年离开 Google,创办了一家名为 Character.ai 的初创公司,但在 2024 年,Google 通过一笔 27 亿美元的人才收购交易将他重新招回。
仅仅 18 个月后,他又要跳槽了,这次去的是 OpenAI。我只能猜测,对方开出了一笔高得离谱的报酬。
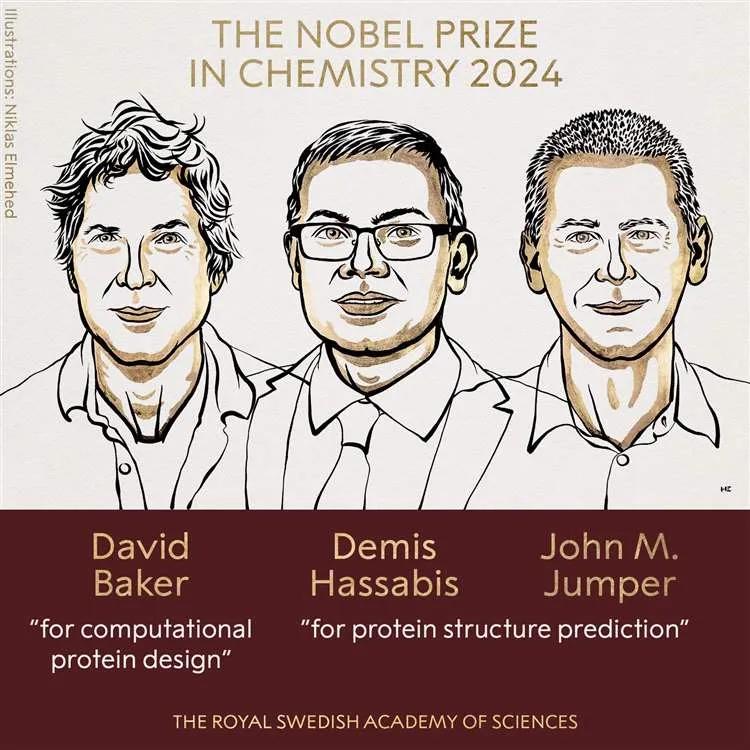
本周另一位重量级离职者是 John Jumper。他是获得诺贝尔奖的 AlphaFold 团队的项目负责人,并宣布将加入 Anthropic。
AlphaFold 很可能会作为 Demis Hassabis 和 DeepMind 最伟大的成就载入史册,毕竟他们凭借它获得诺贝尔奖是有原因的。因此,失去领导这一项目的人,对整个组织又是一次沉重打击。
考虑到这些研究员的成就,我可以想象,Google 为了留住他们,恐怕什么条件都愿意开。但由于 Google DeepMind 的发展方向或组织文化,他们还是决定跳槽。 另一个有意思的地方是,他们去了不同的竞争对手。这说明,在业内顶尖人才眼中,Anthropic 和 OpenAI 都是顶级实验室。至于哪家更好,则取决于个人看法;并不存在一家公认最好、所有人都争相加入的实验室。
至于 Google,我看不出他们还能从中翻身。 相较于竞争对手,他们的模型一直在走下坡路,而且他们自己也知道。如今再失去两位最受认可的研究员,势必会引发更多人出走,就像 Meta 在 Llama 4 发布后的情况一样。据报道,由于模型表现太差,Meta 流失了 AI 团队中 80% 的成员。
而这一切,还是在 Google 拥有所有主要 AI 实验室中最多算力的情况下发生的。这说明,算力能发挥多大作用,取决于使用它的人;光有规模还不够。
新品发布
GLM 5.2
一个巨头衰落,另一个便崛起。Z.ai 发布了 GLM 5.2,实力足以与 GPT 5.5 和 Opus 4.8 竞争。
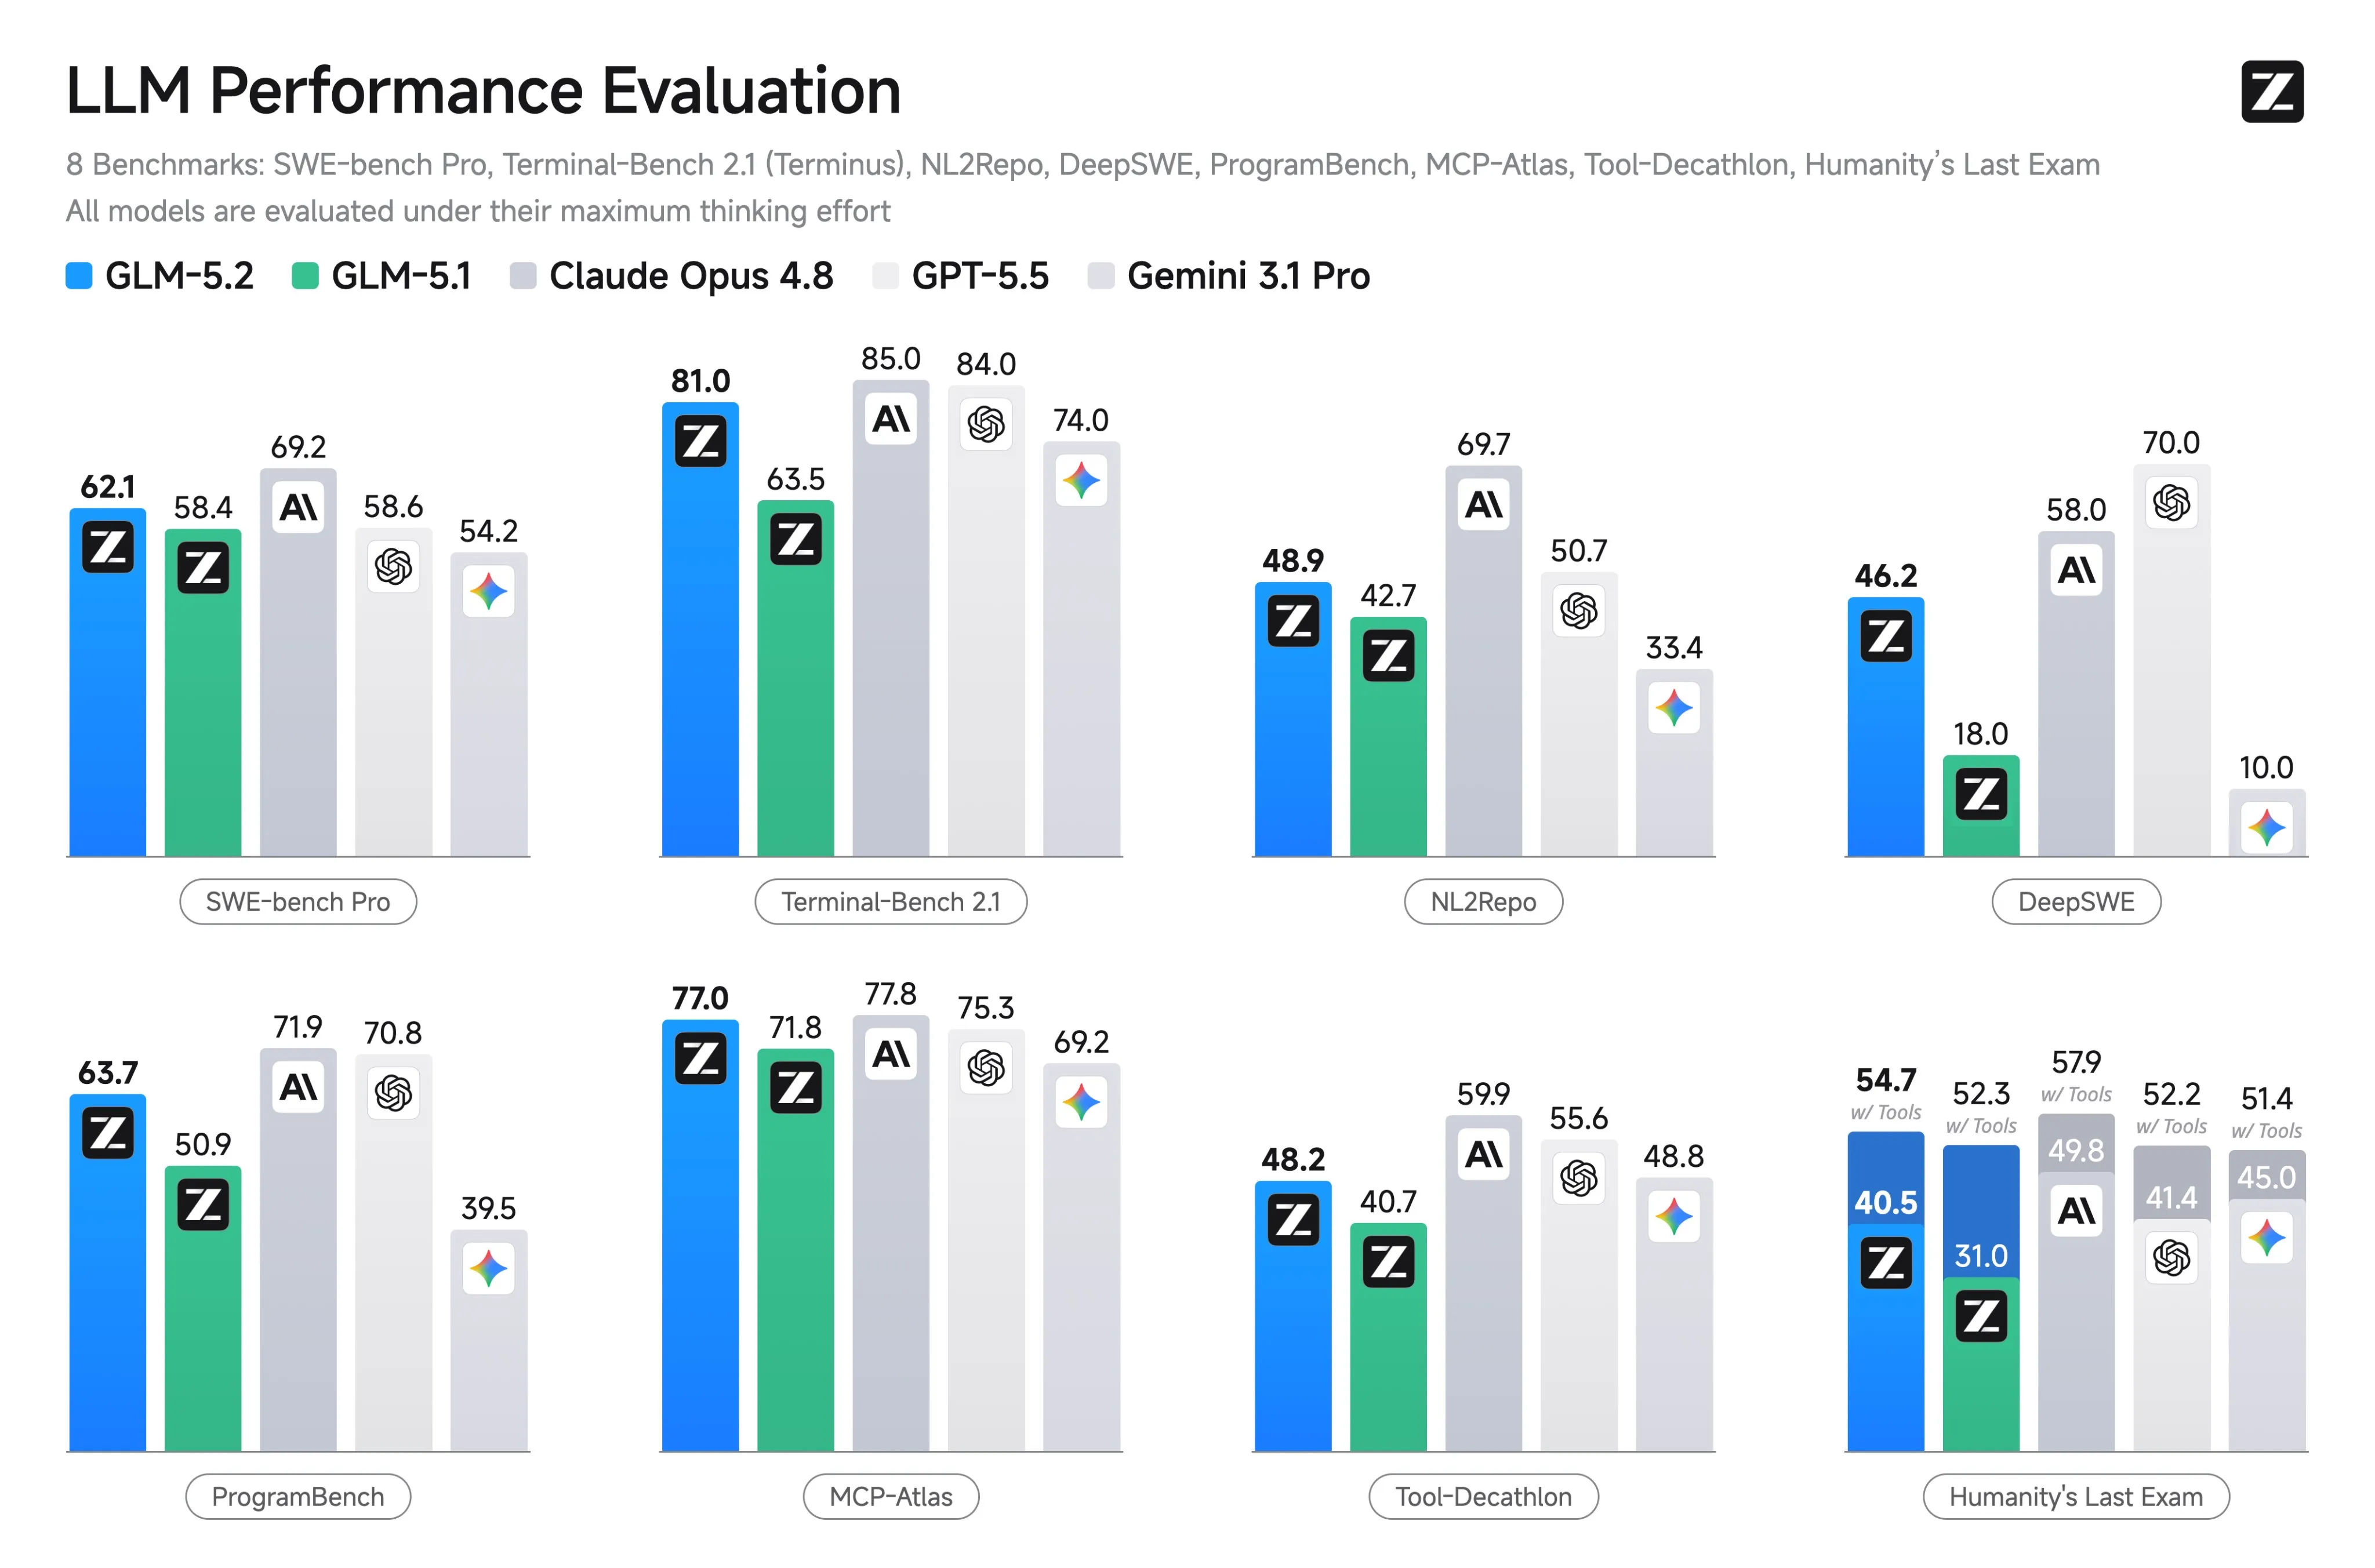
在参考价值很高的 DeepSWE 基准测试上,中国模型此前一直表现吃力,而这次我们看到了显著进步。
中国模型在较新的基准测试上也往往表现不佳,因为它们的通用能力不够强,也还没来得及针对这些基准测试过拟合。 但看看 GLM 在本周刚发布的基准测试中的表现,情况就不一样了。
在 shape-rotator bench 上,GLM 5.2 超过了 Opus 4.8。 在 Artificial Analysis 新推出的长上下文智能体知识工作基准测试中,GLM 5.2 排名第三,仅次于 Fable 5 和 Opus 4.8,但领先于 GPT 5.5。 在 KernelBench-Mega 和 hard 上,它实现的加速比超过了 GPT 5.5 和其他所有开源模型,仅输给 Opus 4.8。
在一些不那么容易客观衡量、偏软技能的基准测试中,它也表现强劲。 在 Design Arena 上,GLM 5.2 击败 Fable 5,拿下第一。 在 EQ bench(创意写作和情商)上,它超过了其他所有开源模型,包括一向很擅长写作的 Kimi。
它在实际使用中的体验也经得起检验。 我看到很多人把它的质量与 GPT 5.5 和 Opus 4.8 相提并论。它已经不再只是 Claude 或 GPT 触发用量限制后的备选,而是可以作为日常主力使用、智能水平几乎不打折扣的模型。
根据 Artifical Analysis 的数据,它在做到这些的同时,价格仅为 GPT 5.5 的三分之一、Opus 的五分之一。
看到这样的进展非常令人兴奋,这可能是自 DeepSeek R1 以来,开源与闭源模型之间差距最小的一次。我预计其他中国实验室也会在接下来几个月里追上来,让前沿大语言模型的竞争进一步升温。
结语
希望你喜欢本周的新闻。如果你想每周都收到这些资讯,记得在下方订阅我们的邮件列表。