Nota: Este artigo foi traduzido automaticamente com OpenAI GPT-5.5 por meio do Codex CLI; a qualidade pode estar reduzida, especialmente na terminologia técnica.
resumo
- O declínio do Google está ficando cada vez mais aparente
- O GLM 5.2 diminui a distância para o GPT 5.5 e o Claude Opus 4.8
Notícias
A decadência do Google
A equipe de IA do Google vem enfrentando dificuldades ultimamente. Seus modelos Gemini 3.1 Pro e Flash 3.5 não conseguiram impressionar, tirando a empresa da conversa como um laboratório de fronteira. Com a ascensão dos laboratórios chineses de IA, que têm ordens de magnitude menos capacidade computacional e ainda assim continuam competitivos, quando não melhores que os modelos Gemini, as coisas não têm parecido boas para o Google, que parece não ter conseguido entender o pós-treinamento de seus modelos.
Eles até perderam seu posto como reis do multimodal, já que a OpenAI tem se concentrado mais nessas capacidades e conseguiu superar o Gemini.
Por causa desse desempenho fraco, eles estão começando a perder seus pesquisadores superstar. O primeiro a sair esta semana foi Noah Shazeer.
Mesmo que você não conheça Noam Shazeer, você conhece o trabalho dele. Ele é possivelmente a figura mais importante da IA moderna, sendo creditado por ter concebido o mecanismo de atenção moderno que usamos em transformers (o principal avanço do artigo Attention is All you Need) e também por ser um dos criadores dos modelos sparse mixture of experts, que nos permitiram escalar LLMs de forma eficiente até o tamanho atual.
Cham á-lo de Kobe ou Messi da IA é subestimá-lo; ele é mais como o Jesus da IA. Sem ele, o campo não estaria onde está hoje.
Ele saiu originalmente do Google em 2022 para fundar uma startup chamada Character.ai, mas foi reacqui-contratado pelo Google em 2024 por 2,7 bilhões de dólares.
Apenas 18 meses depois, ele está abandonando o barco novamente, desta vez indo para a OpenAI, pelo que só posso presumir ser uma quantidade ridícula de dinheiro.
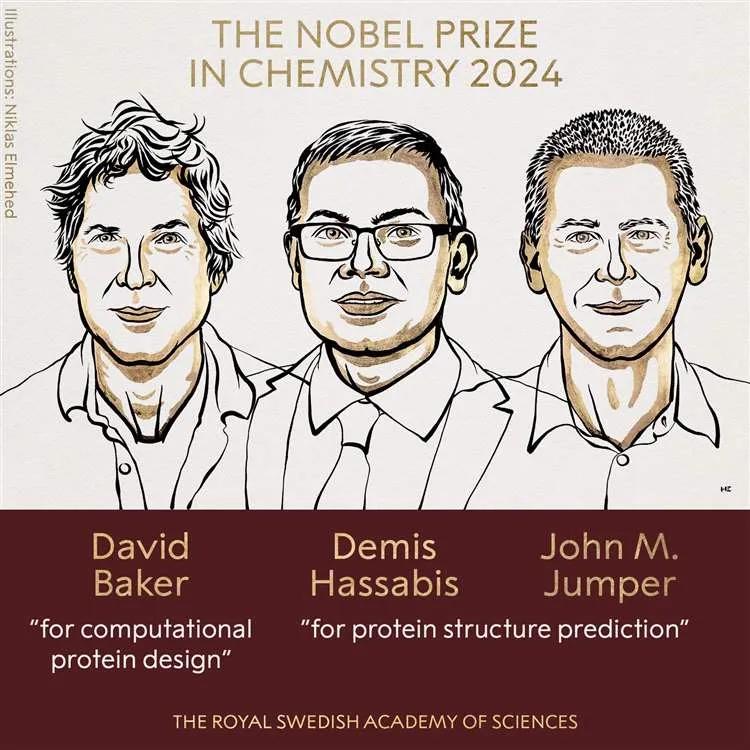
A outra grande saída desta semana foi John Jumper, o líder do projeto da equipe AlphaFold, vencedora do Prêmio Nobel, que anunciou que irá para a Anthropic.
O AlphaFold provavelmente ficará na história como a maior conquista de Demis Hassabis e da DeepMind (há um motivo para terem vencido um Prêmio Nobel por isso), então perder a pessoa que liderou esse projeto é outro grande golpe para a organização.
Por causa das conquistas desses pesquisadores, imagino que o Google tenha oferecido o mundo a eles, mas, por causa da direção ou da cultura da organização Google DeepMind, eles decidiram abandonar o barco. Também é interessante que eles tenham ido para concorrentes diferentes, mostrando que Anthropic e OpenAI são ambas consideradas laboratórios de ponta pelos melhores da área, e que qual delas é a melhor depende das suas próprias visões; não há uma melhor definitiva para a qual todo mundo esteja indo.
Quanto ao Google, não vejo a empresa se recuperando disso. Seus modelos vêm piorando em relação à concorrência (e eles sabem disso), e agora perder dois de seus pesquisadores mais respeitados causará uma evasão ainda maior, semelhante à da Meta após o lançamento do Llama 4, quando, segundo relatos, ela perdeu 80% de sua equipe de IA devido ao desempenho ruim do modelo.
Isso apesar de o Google ter a maior capacidade computacional entre todos os grandes laboratórios de IA, o que mostra que sua computação só é tão boa quanto as pessoas que a usam, e que escala não é tudo de que você precisa.
Lançamentos
GLM 5.2
Enquanto um gigante morre, outro emerge, já que a Z.ai lançou o GLM 5.2, que é competitivo com o GPT 5.5 e o Opus 4.8.
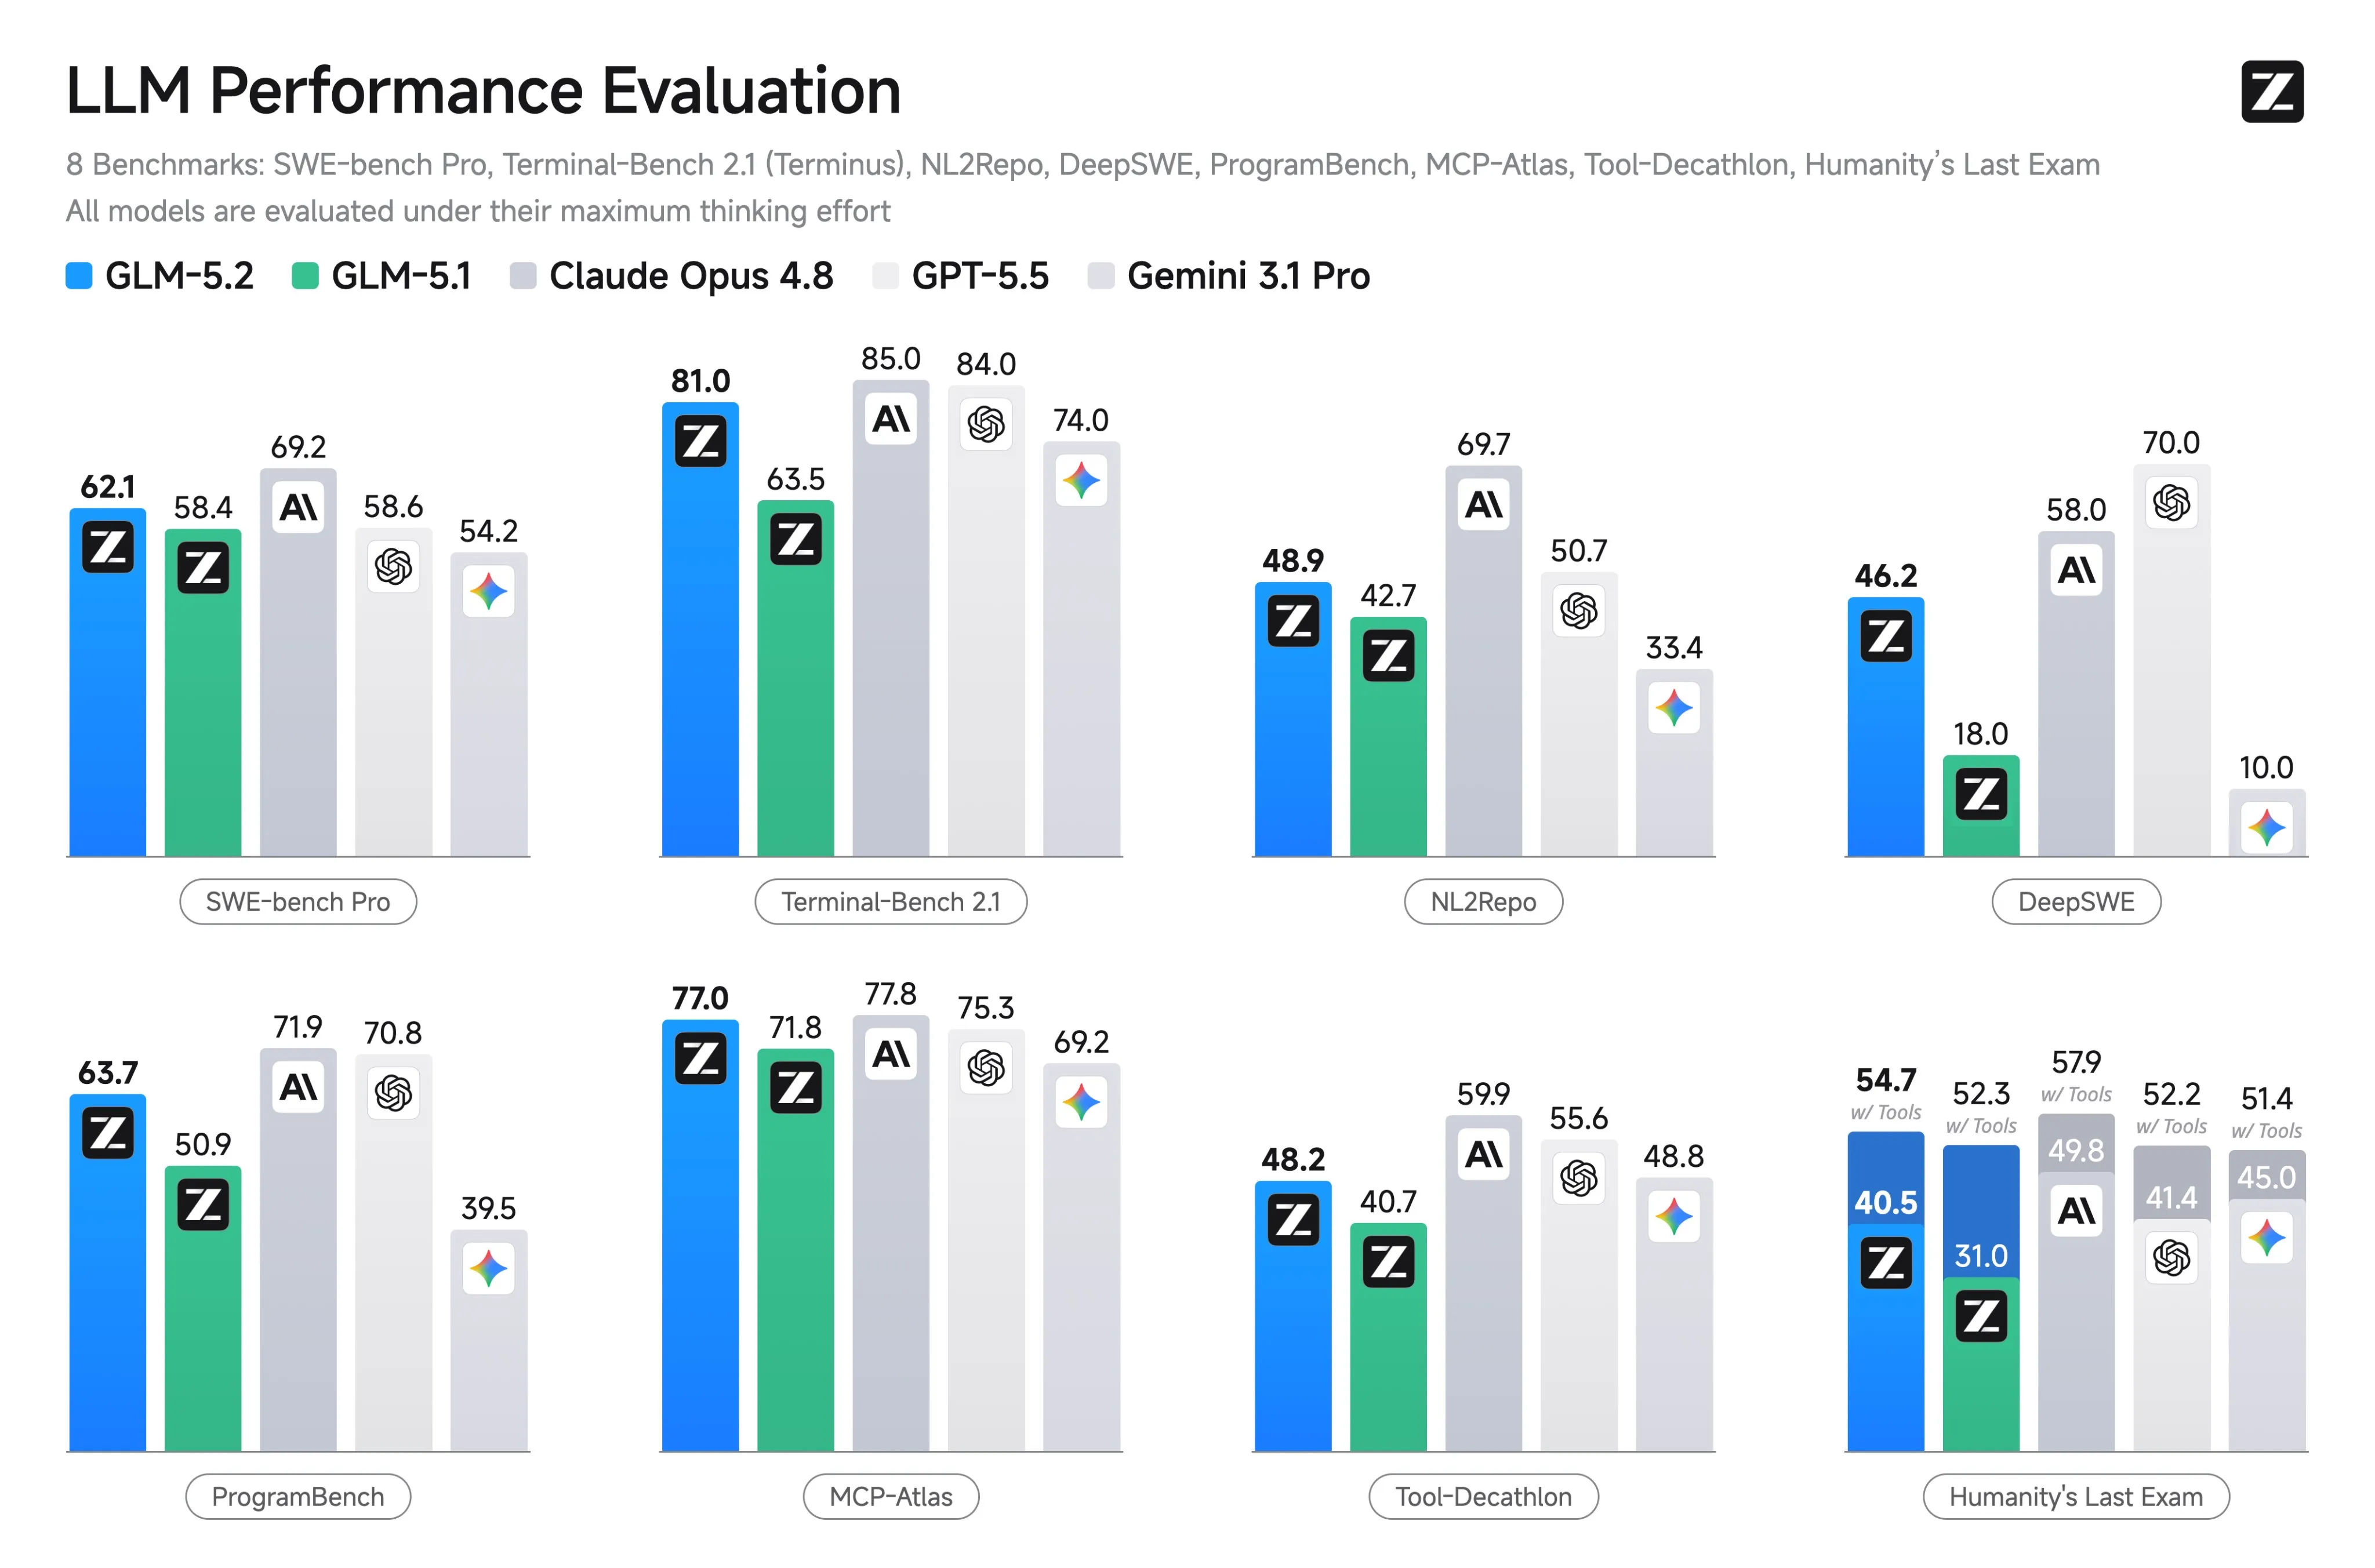
No benchmark de alto sinal DeepSWE, no qual os modelos chineses têm tido dificuldades, vemos uma grande melhora.
Os modelos chineses também tendem a ter dificuldades em benchmarks mais recentes porque seus modelos não são muito gerais e eles não tiveram tempo para fazer overfit nos benchmarks. Olhando para o desempenho do GLM em benchmarks lançados esta semana, vemos uma história diferente.
No shape-rotator bench, vemos o GLM 5.2 superando o Opus 4.8. No novo benchmark de trabalho de conhecimento agêntico em contexto longo da Artificial Analysis, o GLM 5.2 é o 3º melhor modelo, ficando atrás apenas do Fable 5 e do Opus 4.8, mas superando o GPT 5.5. No KernelBench-Mega e hard, ele obtém acelerações melhores que o GPT 5.5 e todos os outros modelos de código aberto, perdendo apenas para o Opus 4.8.
Em alguns dos benchmarks menos concretos/de habilidades mais subjetivas, também vemos um desempenho forte. No Design Arena, o GLM 5.2 fica em primeiro lugar, superando o Fable 5. No EQ bench (escrita criativa e inteligência emocional), ele supera todos os outros modelos de código aberto, incluindo o Kimi, que historicamente tem sido um modelo de escrita muito forte.
Ele também passa no teste de uso real. Vi muitas pessoas compararem o modelo ao GPT 5.5 e ao Opus 4.8 em termos de qualidade, e dizerem que ele já não é mais um modelo ao qual recorrem quando atingem limites de taxa no Claude ou no GPT, mas sim um modelo que você pode usar no dia a dia com pouca perda de inteligência.
Ele faz isso custando 1/3 do preço do GPT 5.5 e 1/5 do preço do Opus, de acordo com a Artifical Analysis.
Isso é muito empolgante de ver, e provavelmente é a menor distância que tivemos entre modelos de código aberto e de código fechado desde o DeepSeek R1. Espero que os outros laboratórios chineses também alcancem esse nível nos próximos meses, o que só vai esquentar ainda mais a batalha dos LLMs de fronteira.
Final
Espero que você tenha gostado das notícias desta semana. Se quiser receber as notícias toda semana, não deixe de entrar na nossa lista de e-mails abaixo.