Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
Gemini 3.1 Pro
Google ha lanzado una actualización de su modelo insignia, Gemini Pro. Últimamente, Google se ha quedado atrás de los modelos de vanguardia de OpenAI y Anthropic, así que ¿es este un regreso a la cima para ellos?
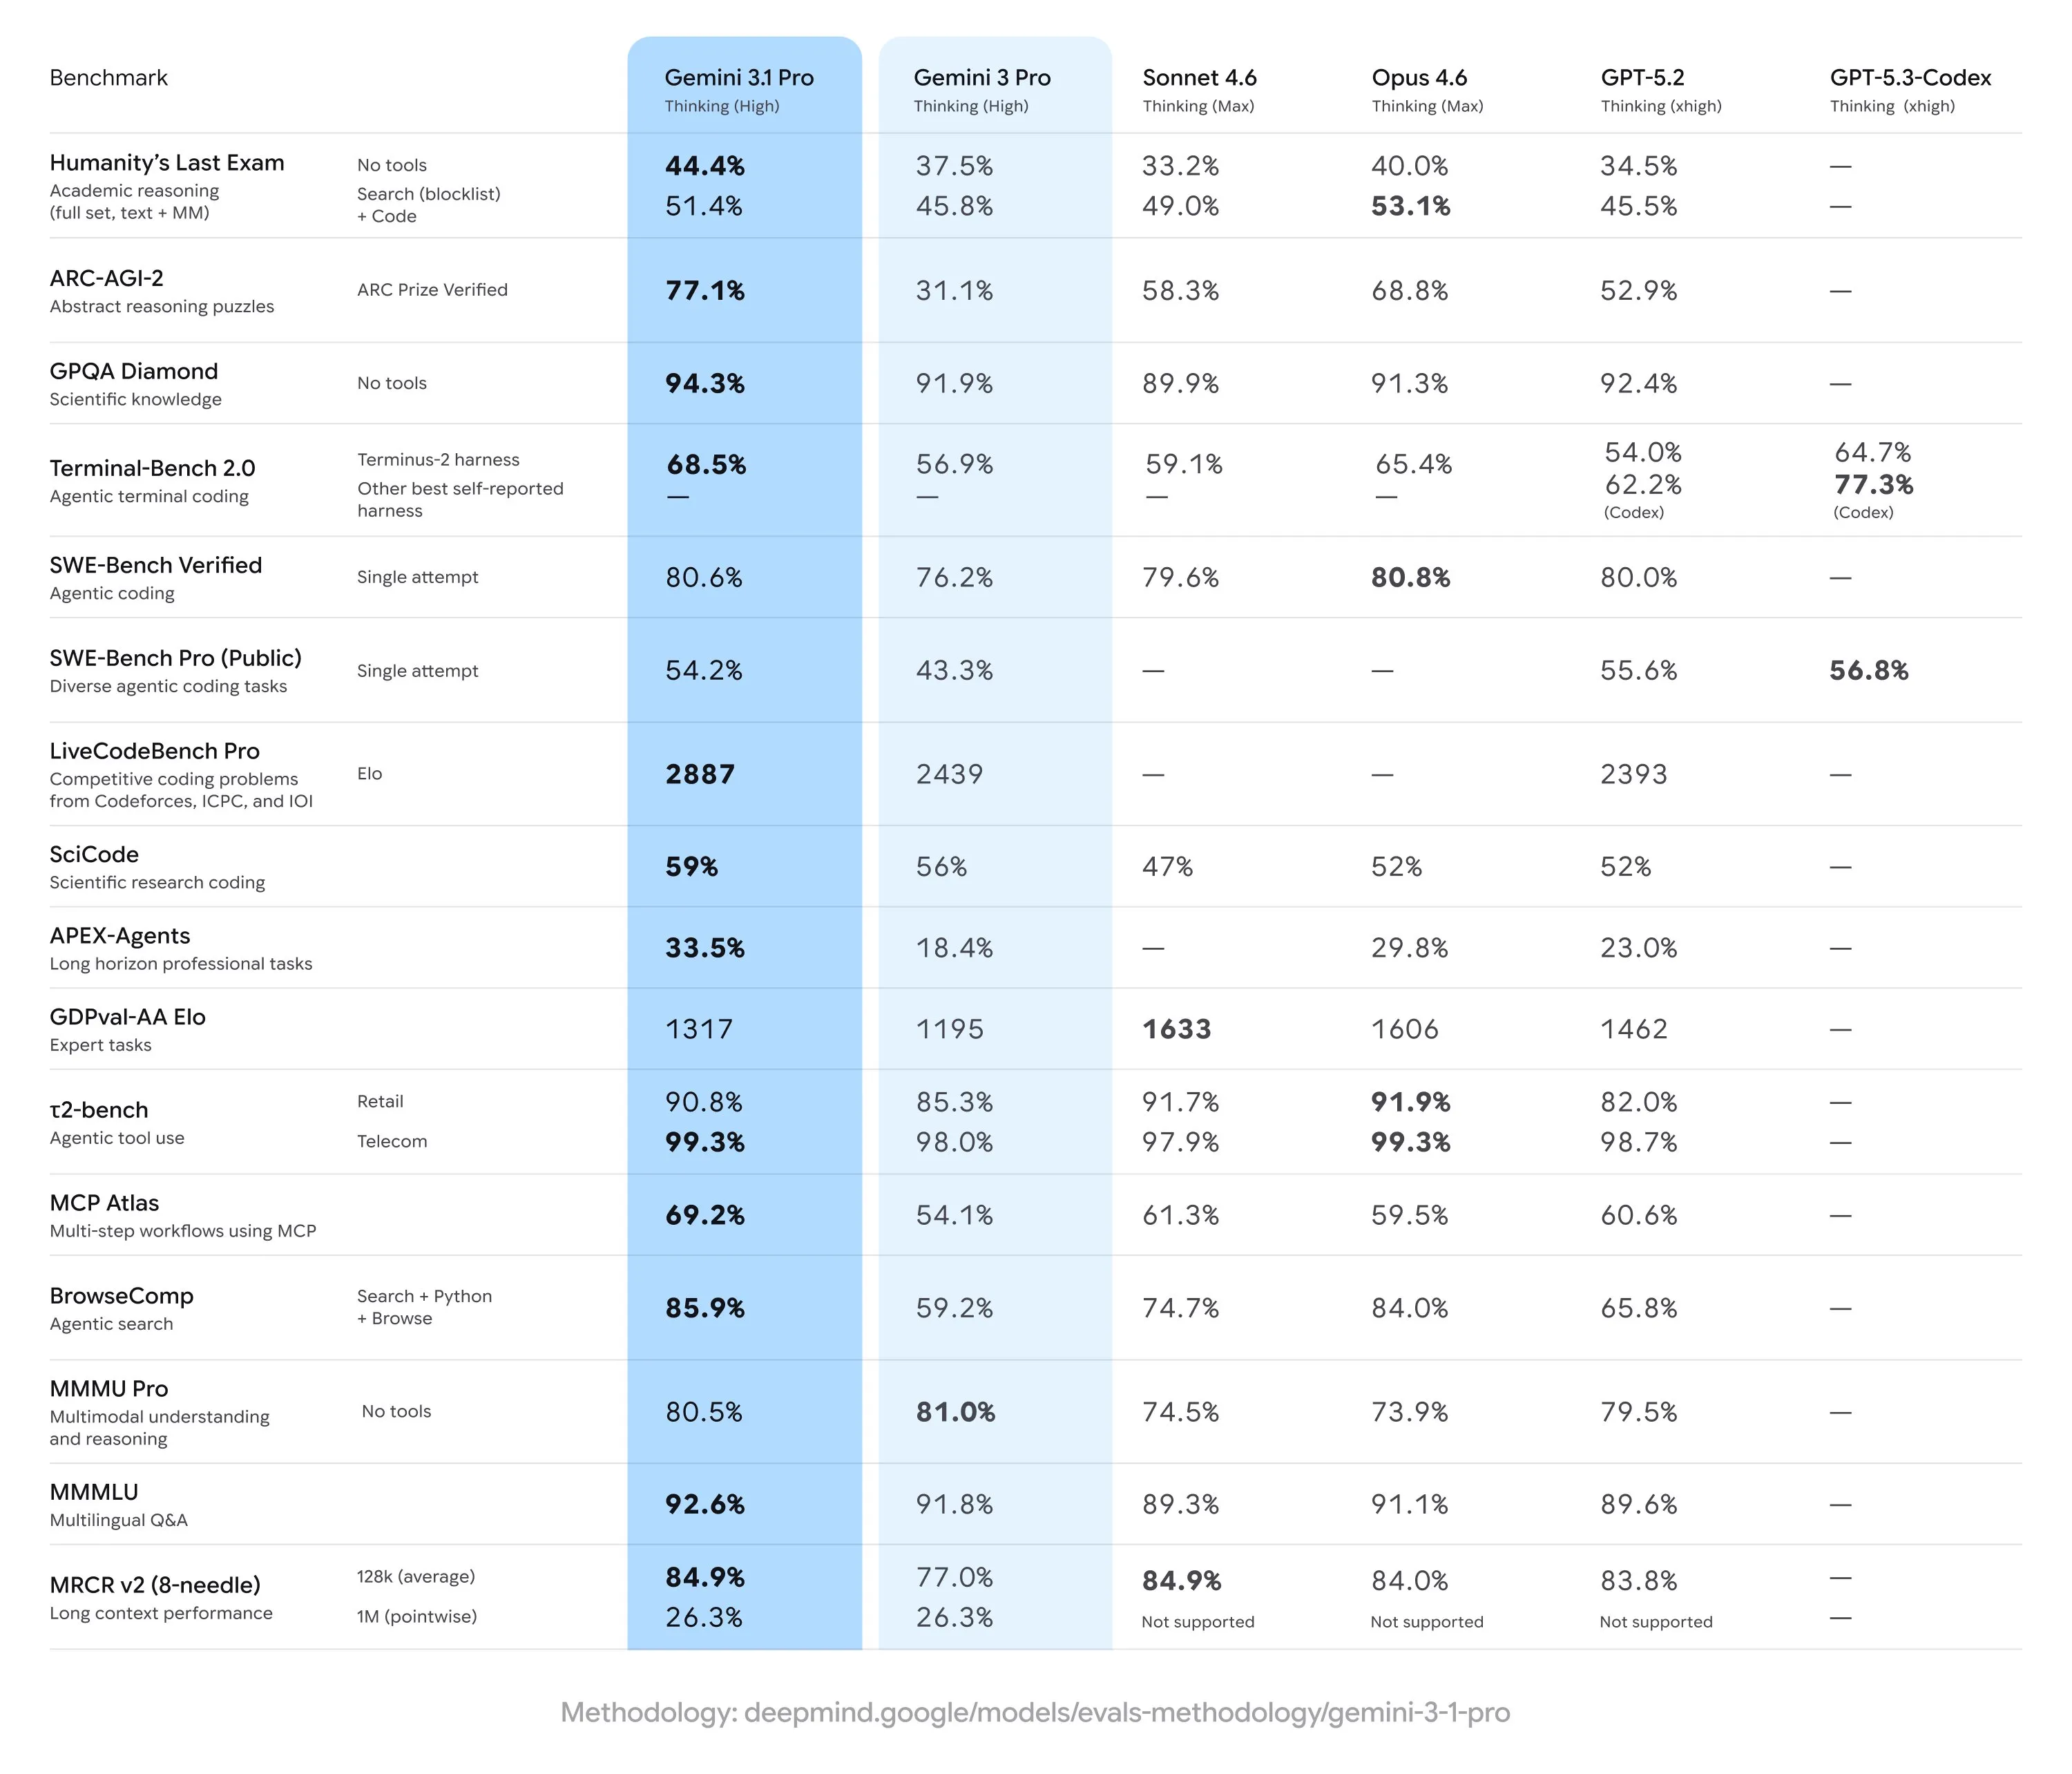
Basándose en los benchmarks que Google ha publicado con el modelo (que muy amablemente incluye todas las puntuaciones de todos los demás modelos principales), Gemini 3.1 Pro parece ser el mejor modelo disponible en este momento. Lamentablemente este no es el caso, y parece ser un caso de “benchmaxxing” por parte de Google.
En la mayoría de las evaluaciones de terceros, vemos una regresión en las capacidades versus Gemini 3 Pro. Esto no está limitado a unos pocos tipos de benchmarks tampoco. Vemos peores puntuaciones en una variedad de benchmarks, incluyendo Design Arena, que mide las capacidades de diseño del modelo para tareas de frontend, Vending Bench, que mide capacidades agénticas y planificación a largo plazo, y EQ bench, que mide habilidades blandas como la inteligencia emocional y la escritura creativa.
También para el uso en el mundo real, he visto quejas de usuarios sobre capacidades de codificación deficientes y calidad de código pobre, bucles infinitos donde el modelo sigue repitiendo lo mismo una y otra vez, y una experiencia general peor.
Con este lanzamiento, Google no solo ha fallado en vencer a OpenAI o Anthropic, sino que ha fallado en vencerse a sí mismo. ¿Por qué podría ser esto? Mi suposición es un mal post-entrenamiento.
Google tiene los recursos tanto en términos de datos como de cómputo para tener un modelo base preentrenado realmente fuerte desde el cual partir. Este paso no requiere demasiada delicadeza y en cambio es solo una función de datos de alta calidad, tamaño del modelo y FLOPs de cómputo, todo lo cual Google claramente tiene.
El post-entrenamiento (ajuste fino supervisado y aprendizaje por refuerzo) por otro lado requiere mucho más criterio y refinamiento, y no puede hacerse simplemente de manera de fuerza bruta de “más es mejor”. Cuando tomas este enfoque de “más es mejor”, y no evalúas realmente el modelo directamente sino que solo miras las puntuaciones de los benchmarks, terminas con un modelo “benchmaxxeado” como el que vemos aquí. Parece muy probable que el rendimiento de las personas que hacen el post-entrenamiento del modelo se base en puntuaciones de benchmarks en lugar de la calidad real del modelo.
Si Google quiere poder competir en la cima, necesita renovar completamente su filosofía sobre cómo están post-entrenando sus modelos, de lo contrario se desvanecerán rápidamente en la irrelevancia.
También estaría preocupado por el calendario de lanzamientos si estuviera en Google. Desde el momento en que se lanzó Gemini 3 hasta ahora, OpenAI y Anthropic han enviado ambos 3 actualizaciones importantes a sus modelos, que ha sido el primero de Google en 3 meses. Si quieren continuar compitiendo en la cima, tendrán que comenzar a entrenar y lanzar modelos más rápido.
Sonnet 4.6
Hablando de lanzamientos de Anthropic, han lanzado una actualización para su modelo de tamaño medio Sonnet.
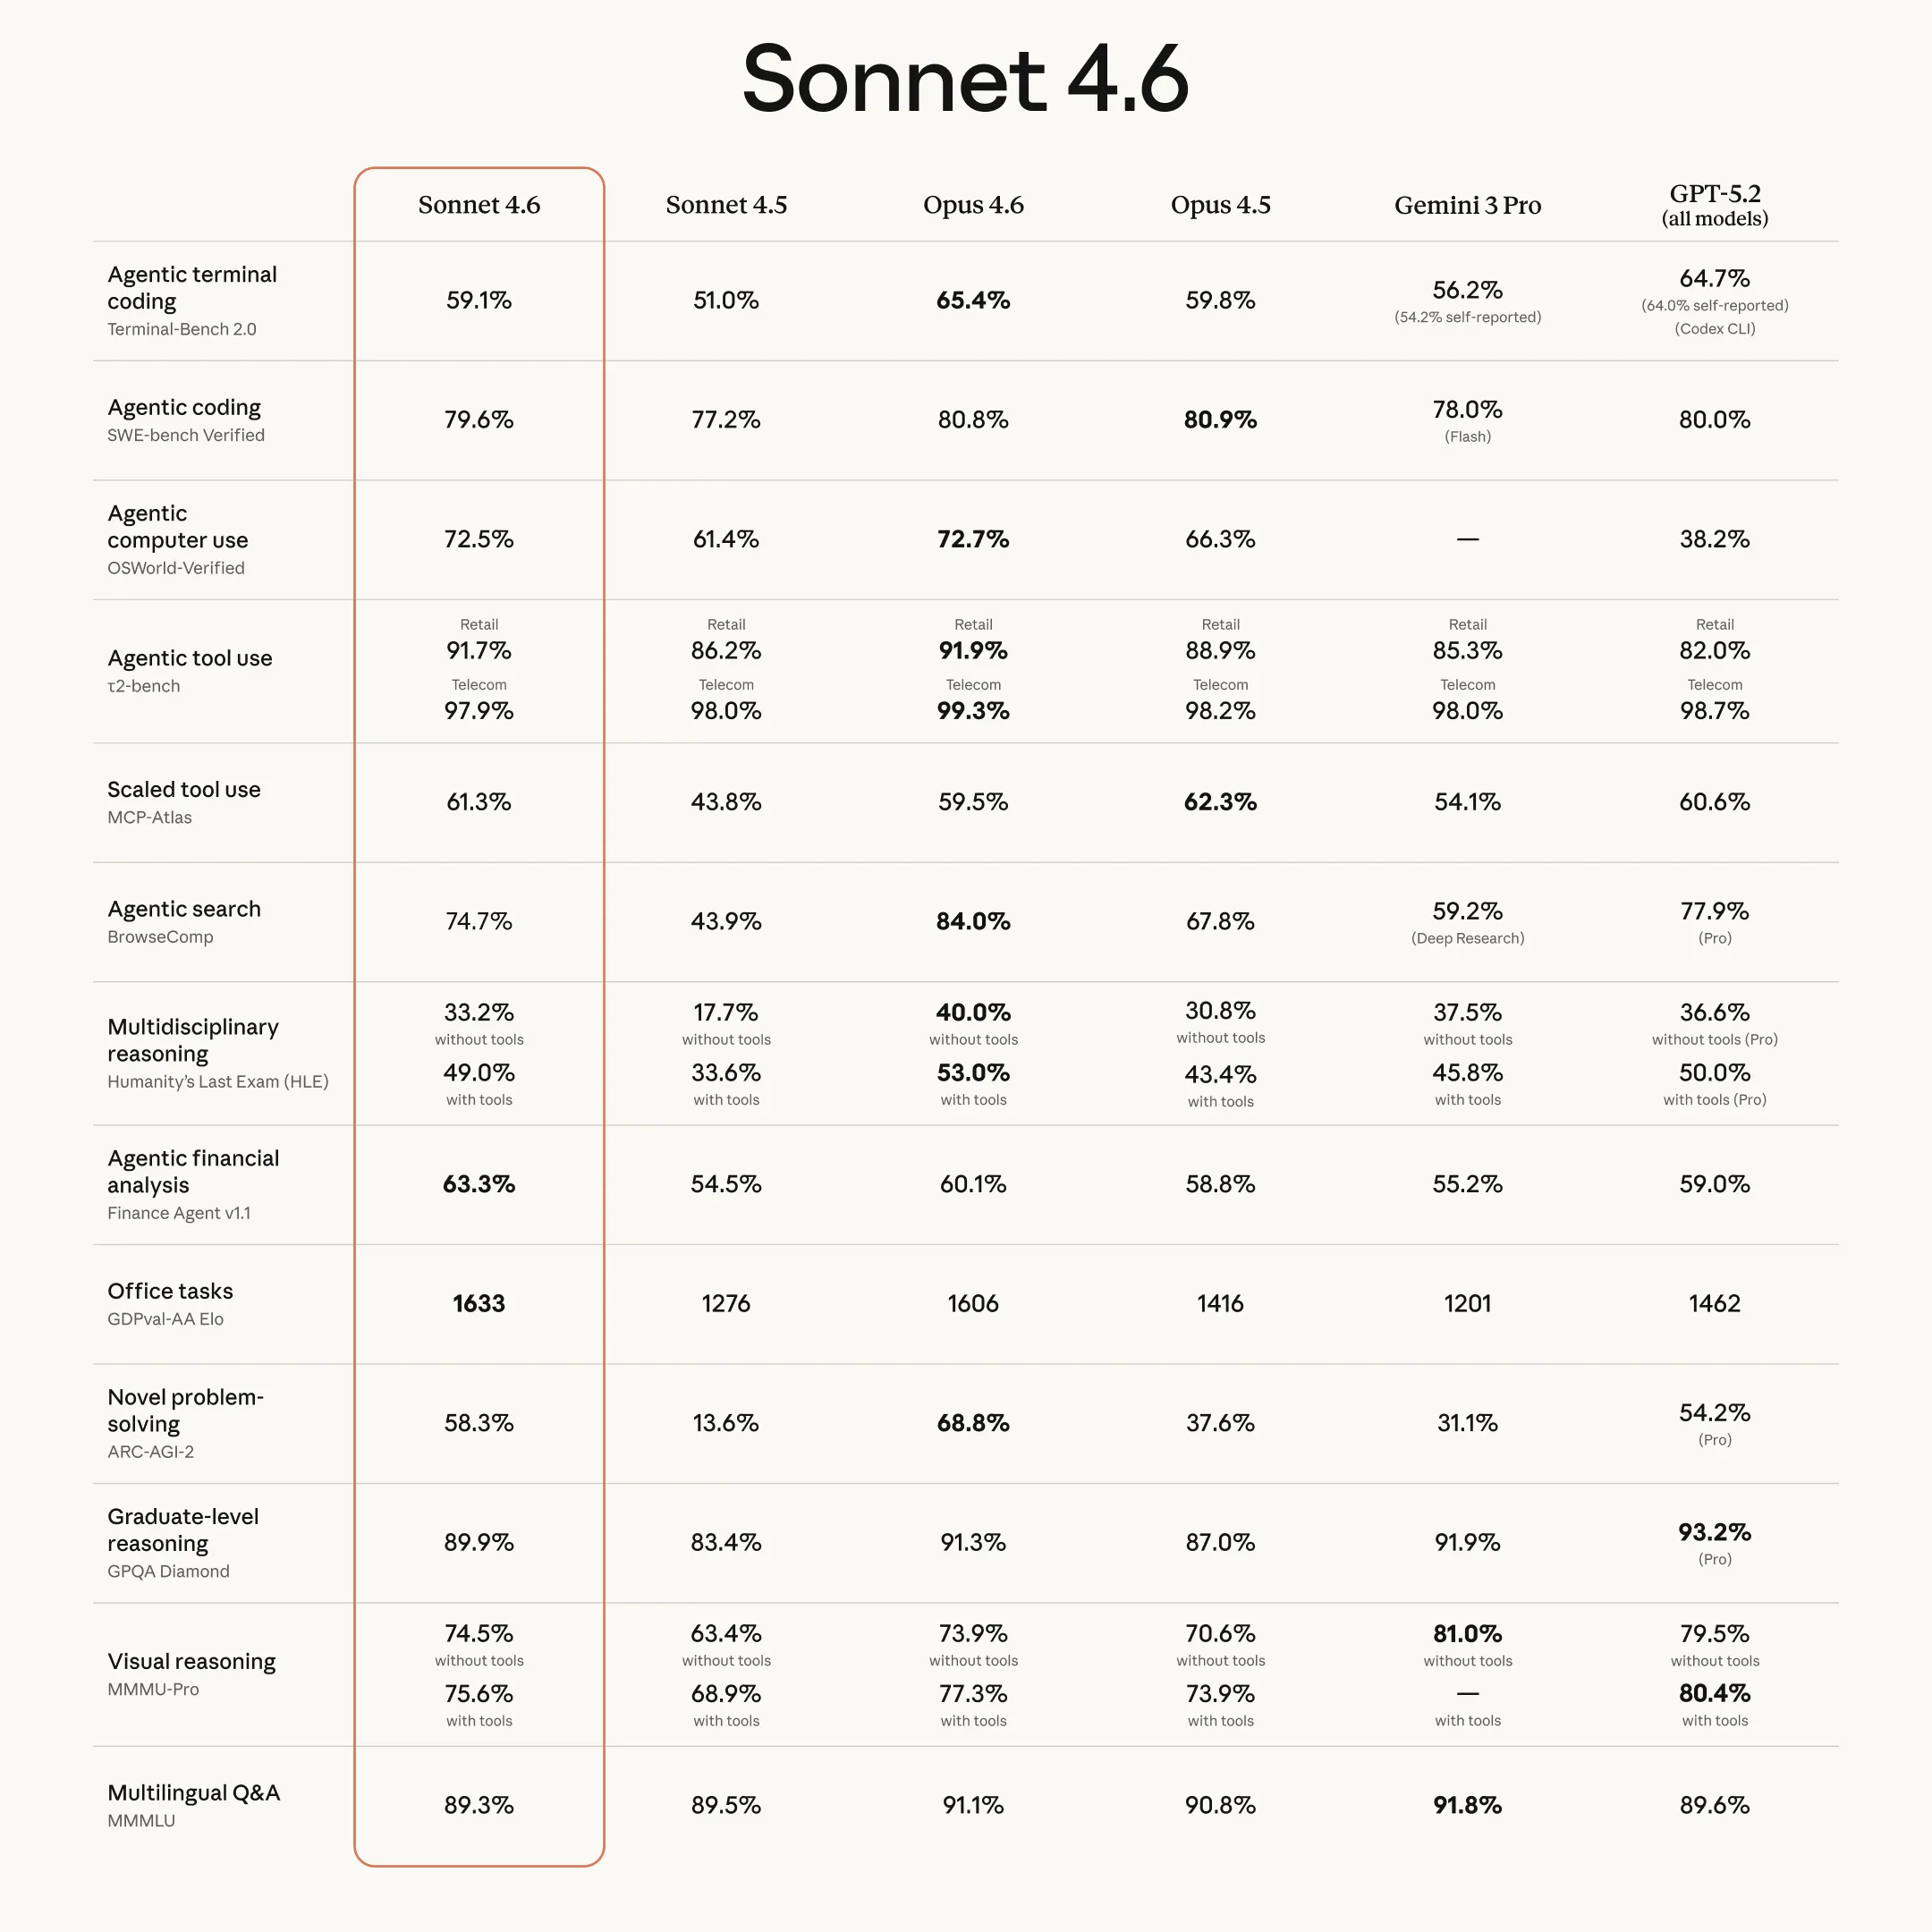
El modelo es otro lanzamiento bueno y de calidad de Anthropic, actualizando Sonnet para que no esté tan lejos en términos de capacidades versus su hermano mayor Opus. Sí hereda las consideraciones de seguridad cuestionables de las que hablé en mi revisión de Opus 4.6 la semana pasada, como lo evidencia su comportamiento en Vending Bench.
En términos de capacidades de codificación en el mundo real, lo he estado usando en Claude Code esta semana, y parece capaz de completar tareas a una velocidad en algún lugar entre Opus 4.5 y Opus 4.6, pero escribe código de calidad ligeramente inferior y todavía ejecuta algunos comandos tontos que pueden hacer que se atasque en ciertos puntos, aunque generalmente es capaz de corregirse. Debido a esto, lo coloco en el mismo nivel que Opus 4.5 y GPT 5.2: muy capaz, pero no completamente de vanguardia.
Como siempre, su precio es un poco extraño, siendo más caro que GPT 5.x, aunque no es un modelo tan bueno. Me encantaría ver a Anthropic bajar el precio de Sonnet de la misma manera que lo hicieron con Opus. Si redujeran a la mitad el precio de $15 a $7.50 por millón de tokens de salida, el modelo sería un valor difícil de rechazar, pero a su precio actual se encuentra en un lugar extraño.
He estado clasificando muchos de los modelos en relación con los demás, así que decidí poner algo juntos para mostrar mis clasificaciones. Estos rangos son específicamente para codificación. Si no ves un modelo en estas clasificaciones, es porque no recomiendo usarlo para codificación en absoluto.
Modelos de vanguardia
- GPT 5.3 Codex
- Opus 4.6
Segundo nivel
- Sonnet 4.6
- GPT 5.2
- Opus 4.5
Tercer nivel
- GLM 5
- Minimax M2.5
- Kimi K2.5
Notas Rápidas
Detector de Contenido Basura de IA
El contenido basura de IA (y su detección) se ha convertido en algo que vemos todos los días ahora. Distil labs ha hecho un pequeño ajuste fino de Gemma 3 270M que puede detectar contenido basura de IA.
Con este tamaño es factible ejecutarlo en tu navegador o como parte de una extensión de Chrome. También hay algunas ideas interesantes sobre cómo hicieron un conjunto de datos de alta calidad a partir de muy pocos datos hechos/validados por humanos.
Ten en cuenta que esto no es un detector de publicaciones de IA, solo detecta si la calidad de escritura es similar al contenido basura de IA.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.