Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Gemini 3.1 Pro
O Google lançou uma atualização para seu modelo principal, o Gemini Pro. Ultimamente, o Google tem ficado para trás dos modelos de ponta da OpenAI e Anthropic, então isso representa um retorno ao topo para eles?
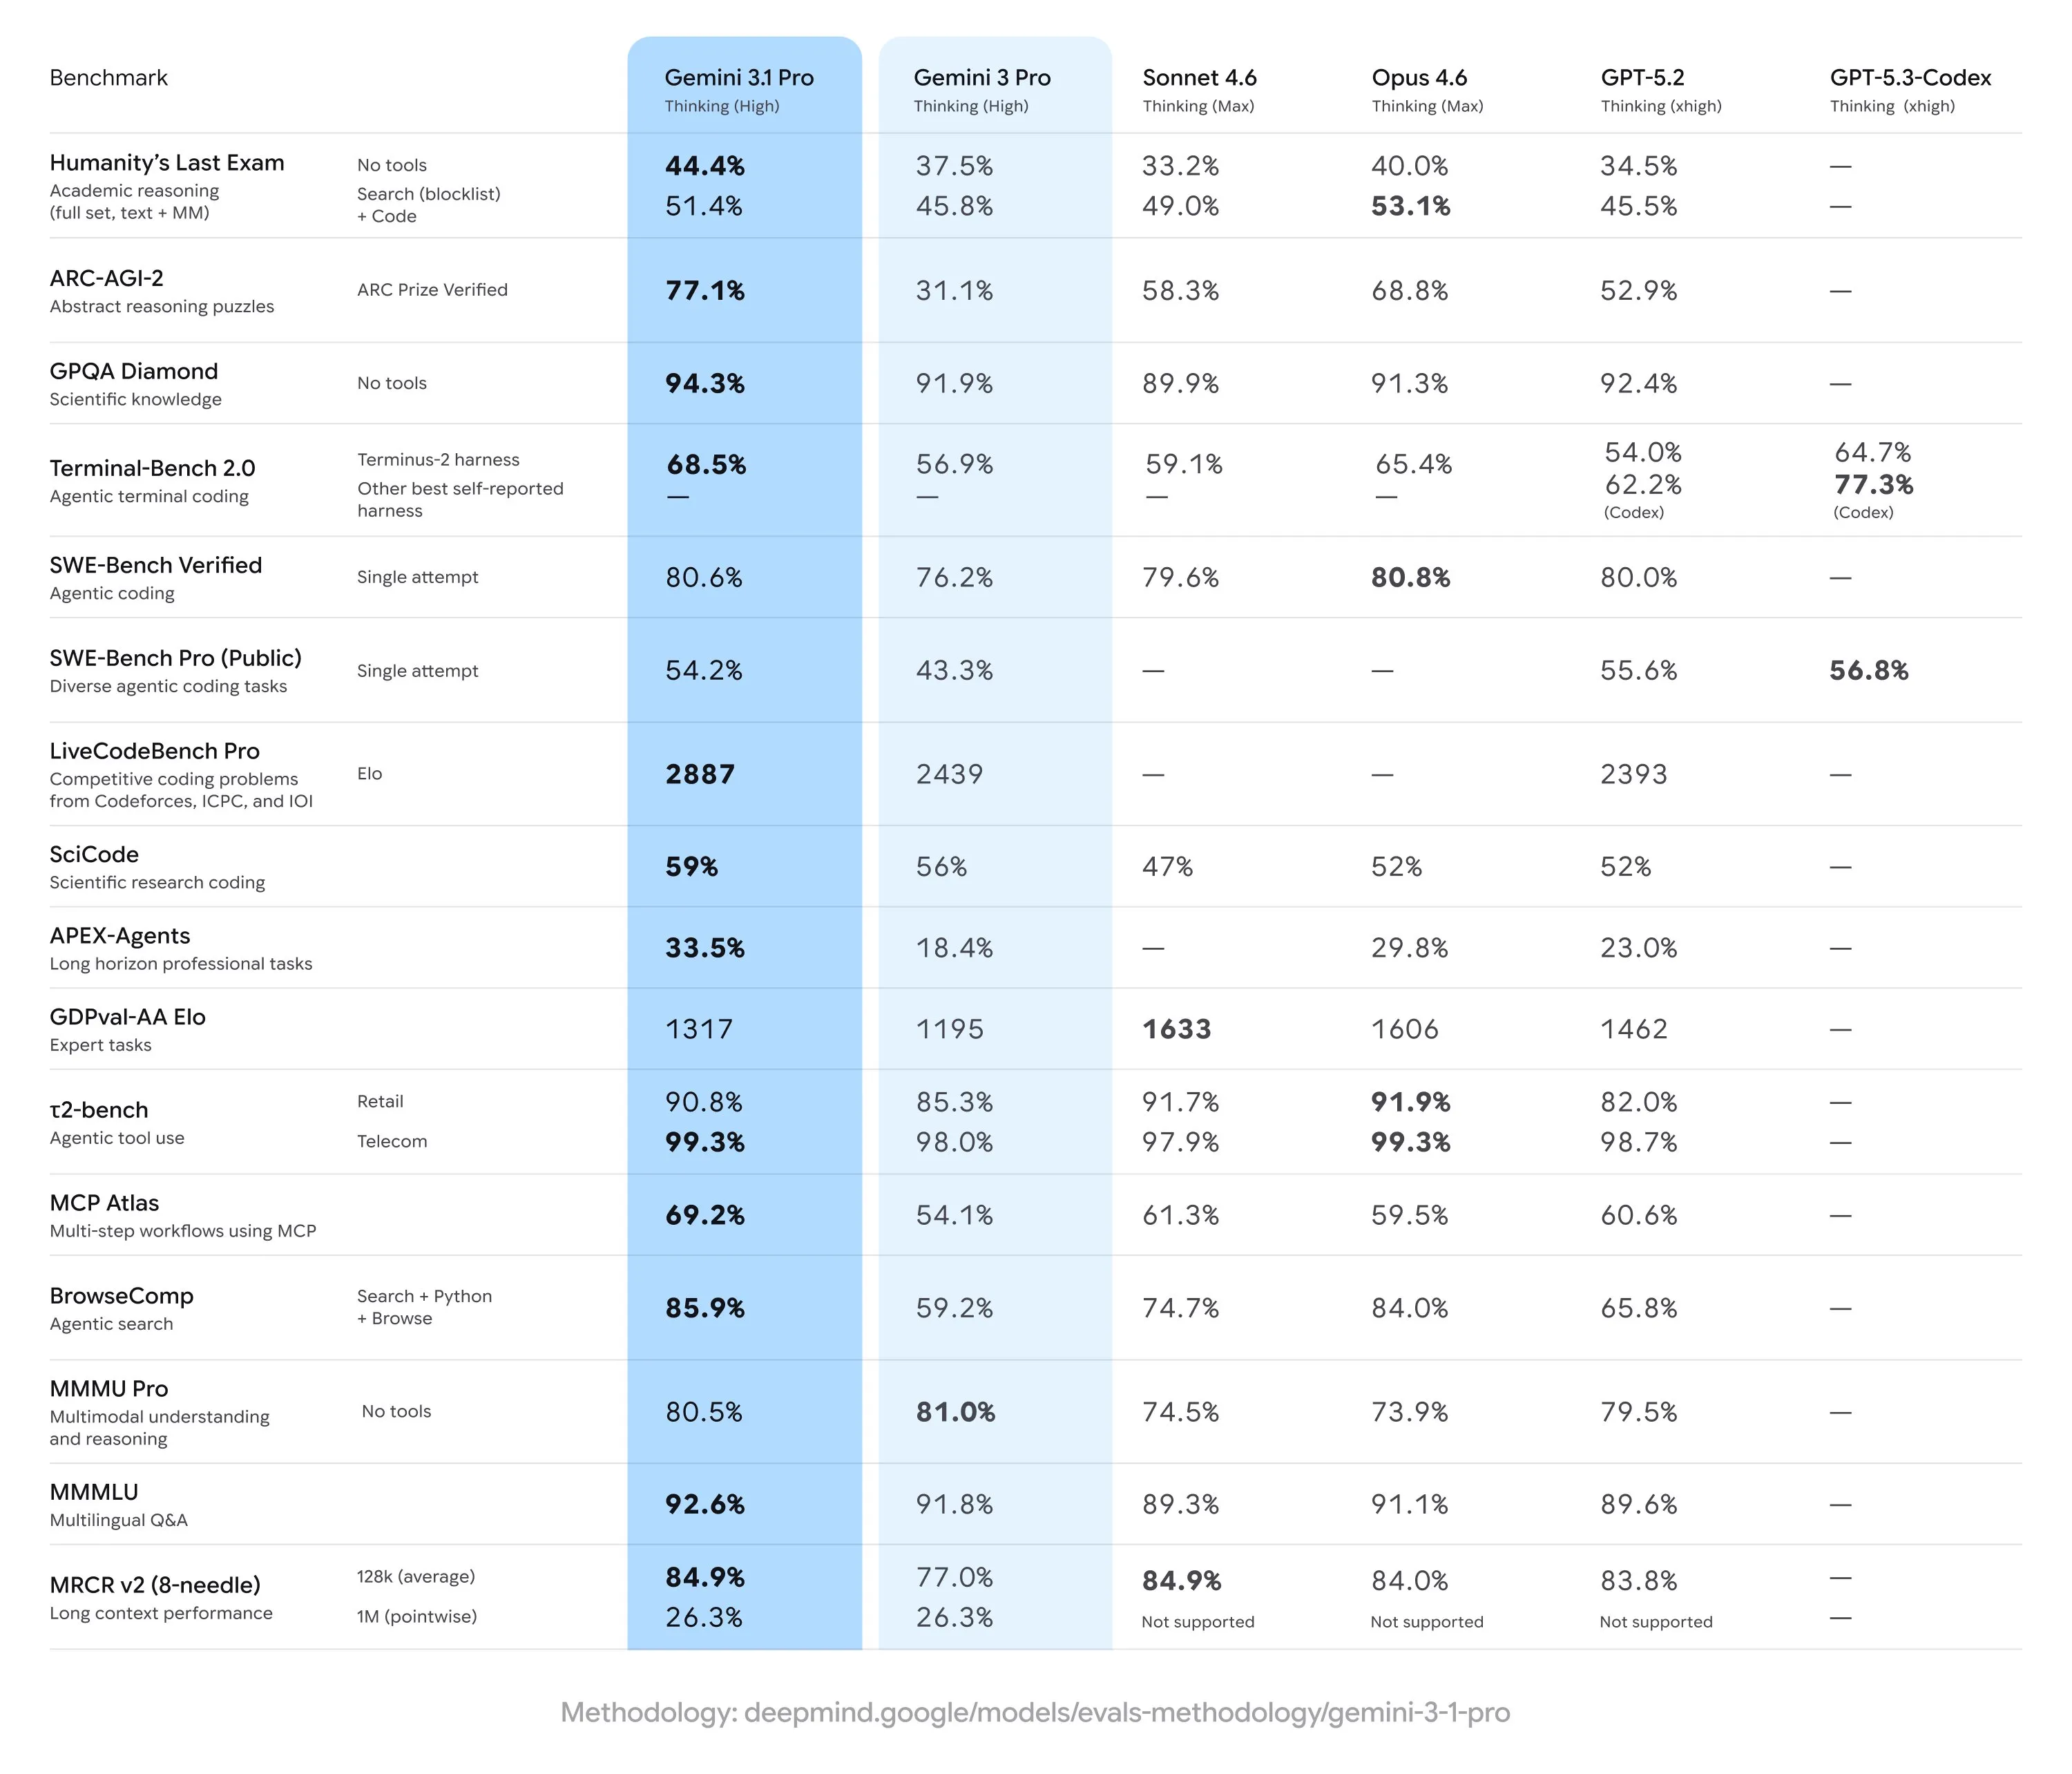
Com base nos benchmarks que o Google divulgou com o modelo (que muito convenientemente incluem todas as pontuações de todos os outros modelos importantes), o Gemini 3.1 Pro parece ser o melhor modelo disponível no momento. Infelizmente, esse não é o caso, e parece ser um caso de benchmaxxing por parte do Google.
Na maioria das avaliações de terceiros, vemos uma regressão nas capacidades em comparação com o Gemini 3 Pro. Isso não está isolado a alguns tipos de benchmarks. Vemos pontuações piores em uma variedade de benchmarks, incluindo Design Arena, que mede as capacidades de design do modelo para tarefas de frontend, Vending Bench, que mede capacidades agênticas e planejamento de longo prazo, e EQ bench, que mede habilidades interpessoais como inteligência emocional e escrita criativa.
Além disso, para uso no mundo real, tenho visto reclamações de usuários sobre capacidades de programação e qualidade de código ruins, loops infinitos onde o modelo continua repetindo a mesma coisa indefinidamente, e uma experiência geral pior.
Com este lançamento, o Google não apenas falhou em superar a OpenAI ou Anthropic, mas falhou em superar a si mesmo. Por que isso pode estar acontecendo? Meu palpite é pós-treinamento ruim.
O Google tem os recursos tanto em termos de dados quanto de poder computacional para ter um modelo base pré-treinado realmente forte para começar. Esta etapa não requer muita sutileza e é apenas uma função de dados de alta qualidade, tamanho do modelo e FLOPs de computação, todos os quais o Google claramente possui.
O pós-treinamento (ajuste fino supervisionado e aprendizado por reforço), por outro lado, requer muito mais discernimento e refinamento, e não pode ser feito apenas de maneira bruta como “mais é melhor”. Quando você adota essa abordagem de “mais é melhor” e não avalia o modelo diretamente, mas apenas olha para as pontuações dos benchmarks, você acaba com um modelo focado em benchmarks como vemos aqui. Parece muito que o desempenho das pessoas que fazem o pós-treinamento do modelo é baseado em pontuações de benchmark em vez da qualidade real do modelo.
Se o Google quer ser capaz de competir no topo, eles precisam reformular completamente sua filosofia sobre como estão fazendo o pós-treinamento de seus modelos, caso contrário, rapidamente se tornarão irrelevantes.
Eu também ficaria preocupado com o cronograma de lançamentos se estivesse no Google. Desde o momento em que o Gemini 3 foi lançado até agora, a OpenAI e a Anthropic já enviaram 3 atualizações importantes para seus modelos, sendo este o primeiro do Google em 3 meses. Se eles querem continuar a competir no topo, terão que começar a treinar e lançar modelos mais rapidamente.
Sonnet 4.6
Falando em lançamentos da Anthropic, eles lançaram uma atualização para seu modelo de tamanho médio Sonnet.
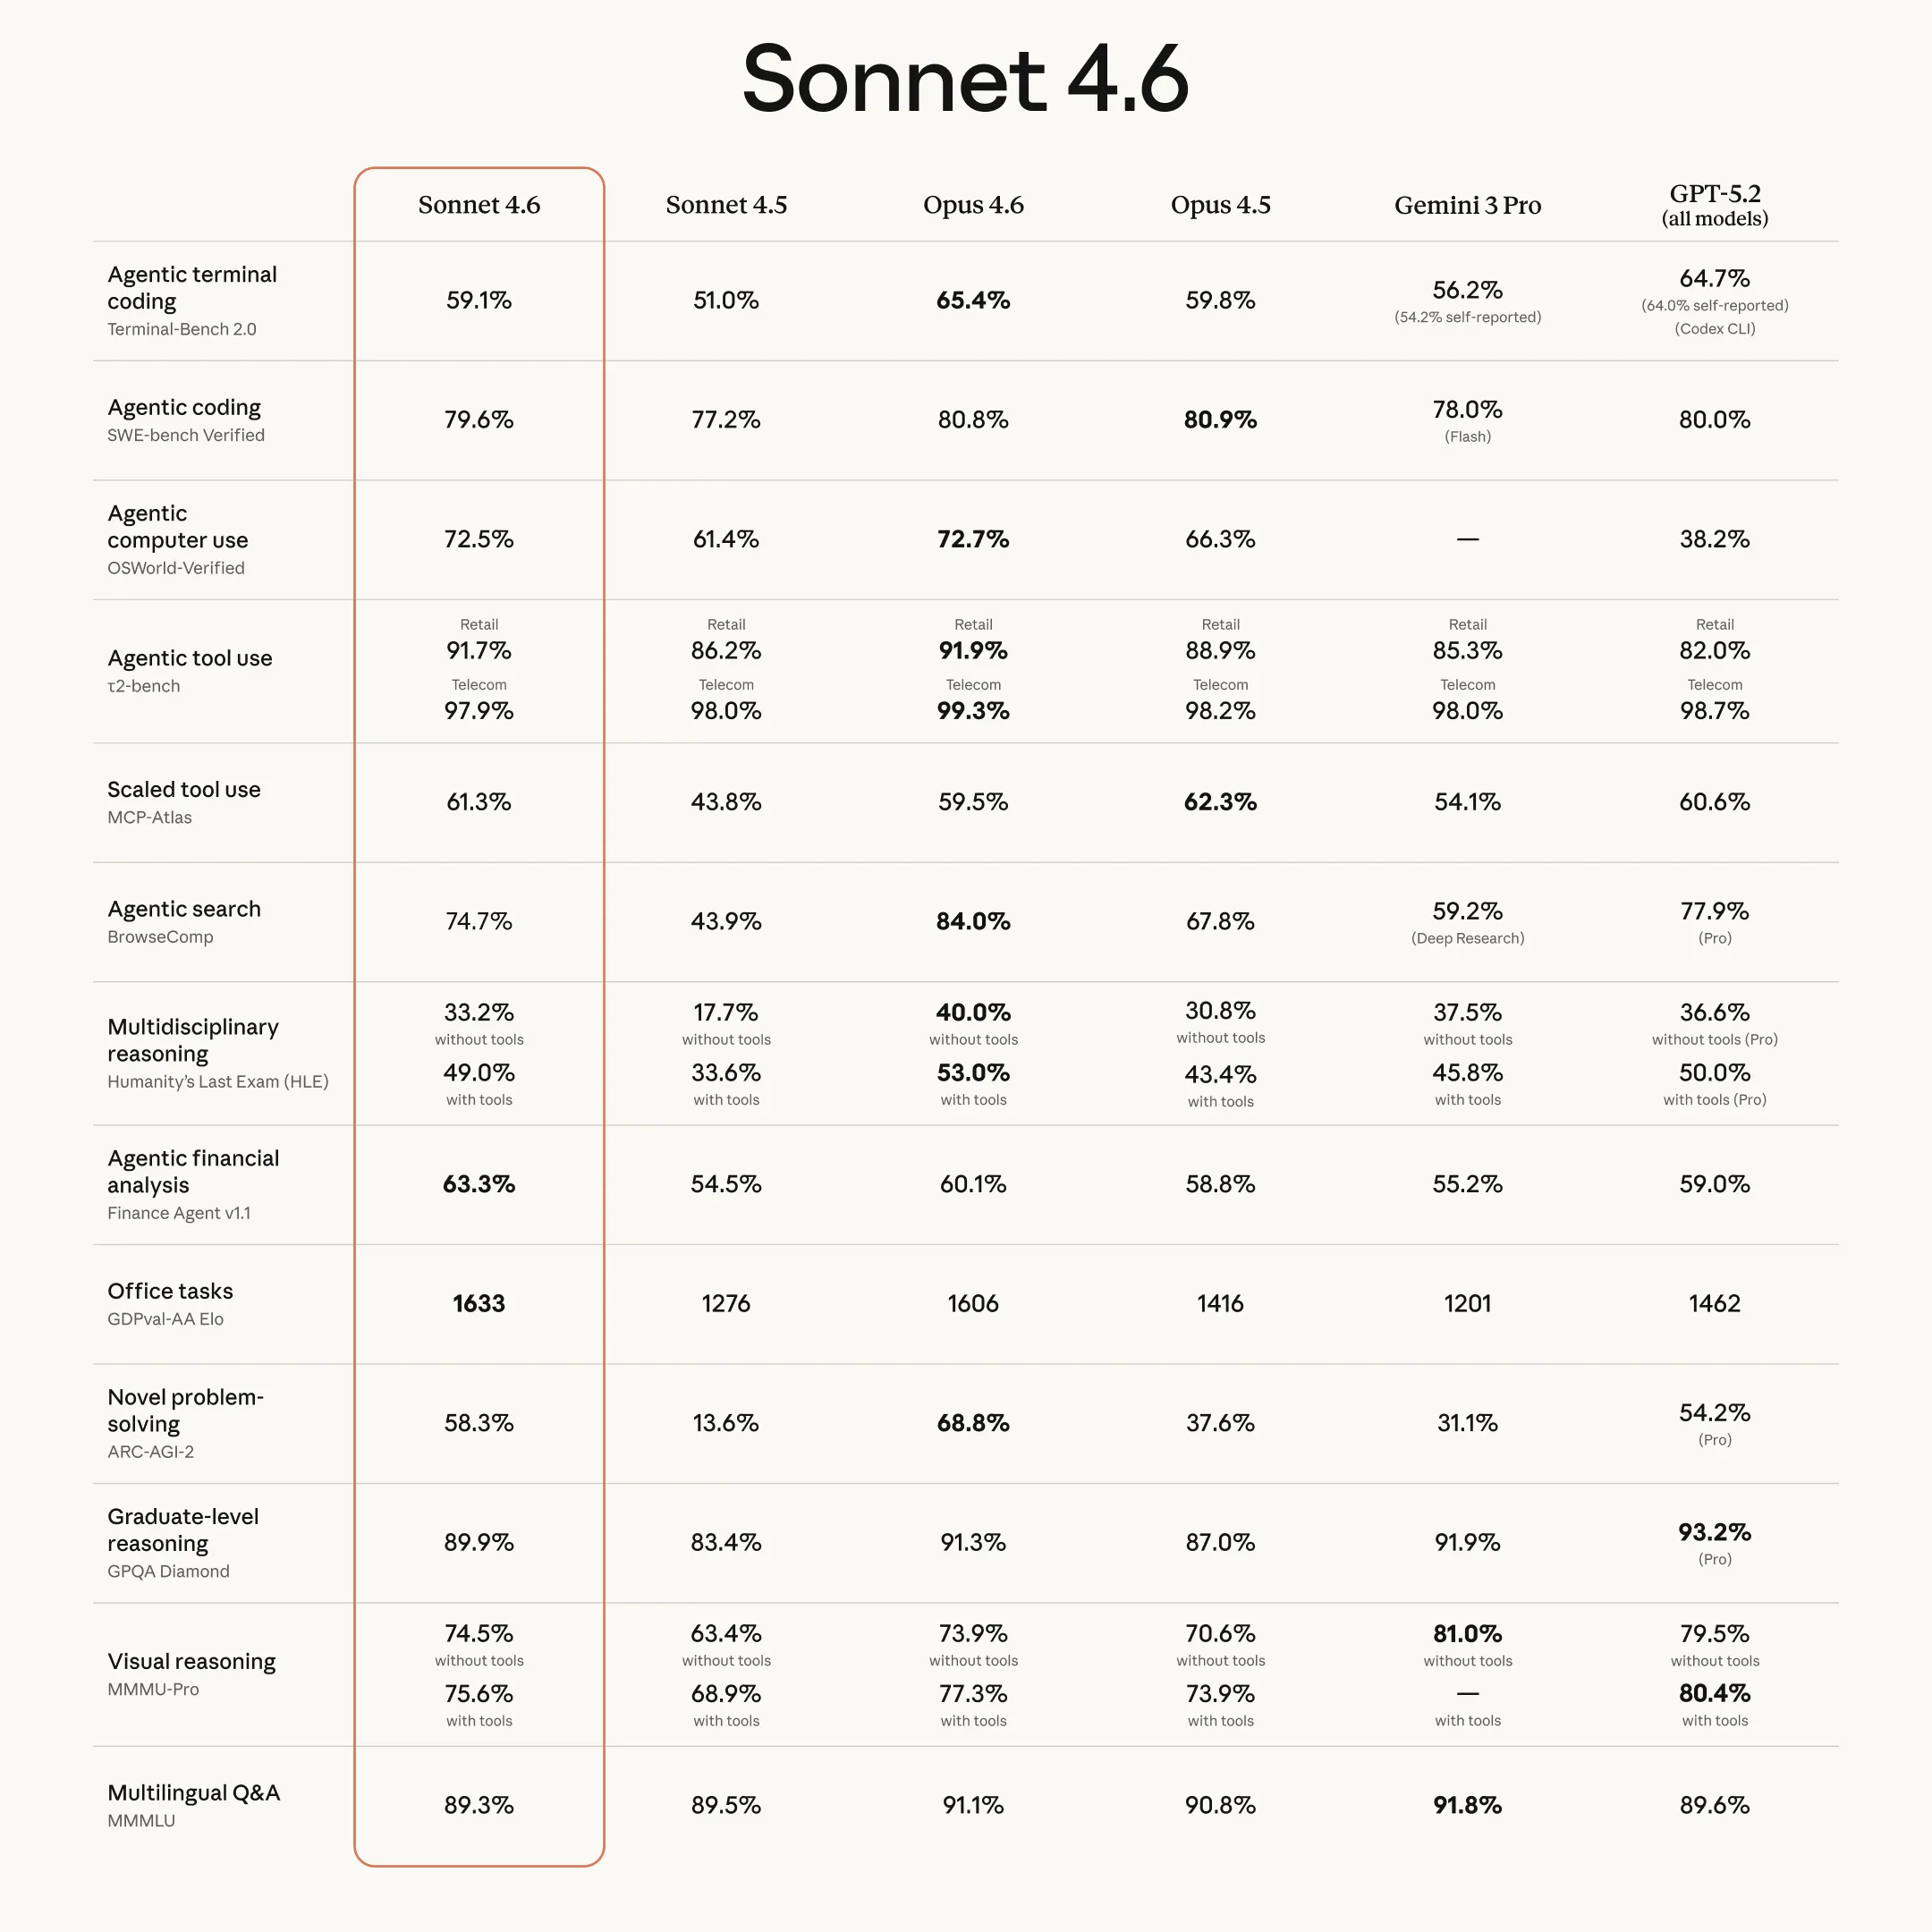
O modelo é outro lançamento bom e de qualidade da Anthropic, atualizando o Sonnet para que não fique tão distante em termos de capacidades em comparação com seu irmão maior Opus. Ele herda as considerações de segurança questionáveis sobre as quais falei em minha revisão do Opus 4.6 na semana passada, como evidenciado por seu comportamento no Vending Bench.
Em termos de capacidades reais de programação, tenho usado no Claude Code esta semana, e parece capaz de realizar tarefas a uma taxa entre o Opus 4.5 e o Opus 4.6, mas escreve código de qualidade ligeiramente inferior e ainda executa alguns comandos tolos que podem fazê-lo ficar preso em alguns pontos, embora geralmente seja capaz de corrigir. Por isso, o coloco no mesmo nível que o Opus 4.5 e o GPT 5.2: muito capaz, mas não totalmente de ponta.
Como sempre, seu preço é um pouco estranho, sendo mais caro que o GPT 5.x, mesmo não sendo um modelo tão bom. Adoraria ver a Anthropic reduzir o preço do Sonnet da mesma forma que fez com o Opus. Se eles reduzissem o preço pela metade, de $15 para $7,50 por milhão de tokens de saída, o modelo seria uma opção difícil de recusar, mas ao preço atual ele fica em uma posição estranha.
Tenho classificado muitos dos modelos em relação uns aos outros, então decidi criar algo para mostrar minhas classificações. Essas classificações são especificamente para programação. Se você não vir um modelo nessas classificações, é porque não recomendo usá-lo para programação.
Modelos de ponta
- GPT 5.3 Codex
- Opus 4.6
Segunda camada
- Sonnet 4.6
- GPT 5.2
- Opus 4.5
Terceira camada
- GLM 5
- Minimax M2.5
- Kimi K2.5
Destaques Rápidos
Detector de Conteúdo Gerado por IA
O conteúdo gerado por IA de baixa qualidade (e sua detecção) se tornou algo que vemos todos os dias agora. A Distil labs fez um pequeno ajuste fino do Gemma 3 270M que pode detectar conteúdo gerado por IA de baixa qualidade.
Neste tamanho, é viável executá-lo no seu navegador ou como parte de uma extensão do Chrome. Também há algumas ideias interessantes sobre como eles criaram um conjunto de dados de alta qualidade a partir de muito poucos dados feitos/validados por humanos.
Note que este não é um detector de postagens de IA, ele apenas detecta se a qualidade da escrita é semelhante ao conteúdo gerado por IA de baixa qualidade.
Conclusão
Espero que você tenha gostado das notícias desta semana. Se você quiser receber as notícias todas as semanas, certifique-se de se juntar à nossa lista de e-mails abaixo.