注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
Gemini 3.1 Pro
Google 为其旗舰模型 Gemini Pro 发布了一次更新。 最近,Google 已经落后于 OpenAI 和 Anthropic 的前沿模型,那么这次更新能让它重回巅峰吗?
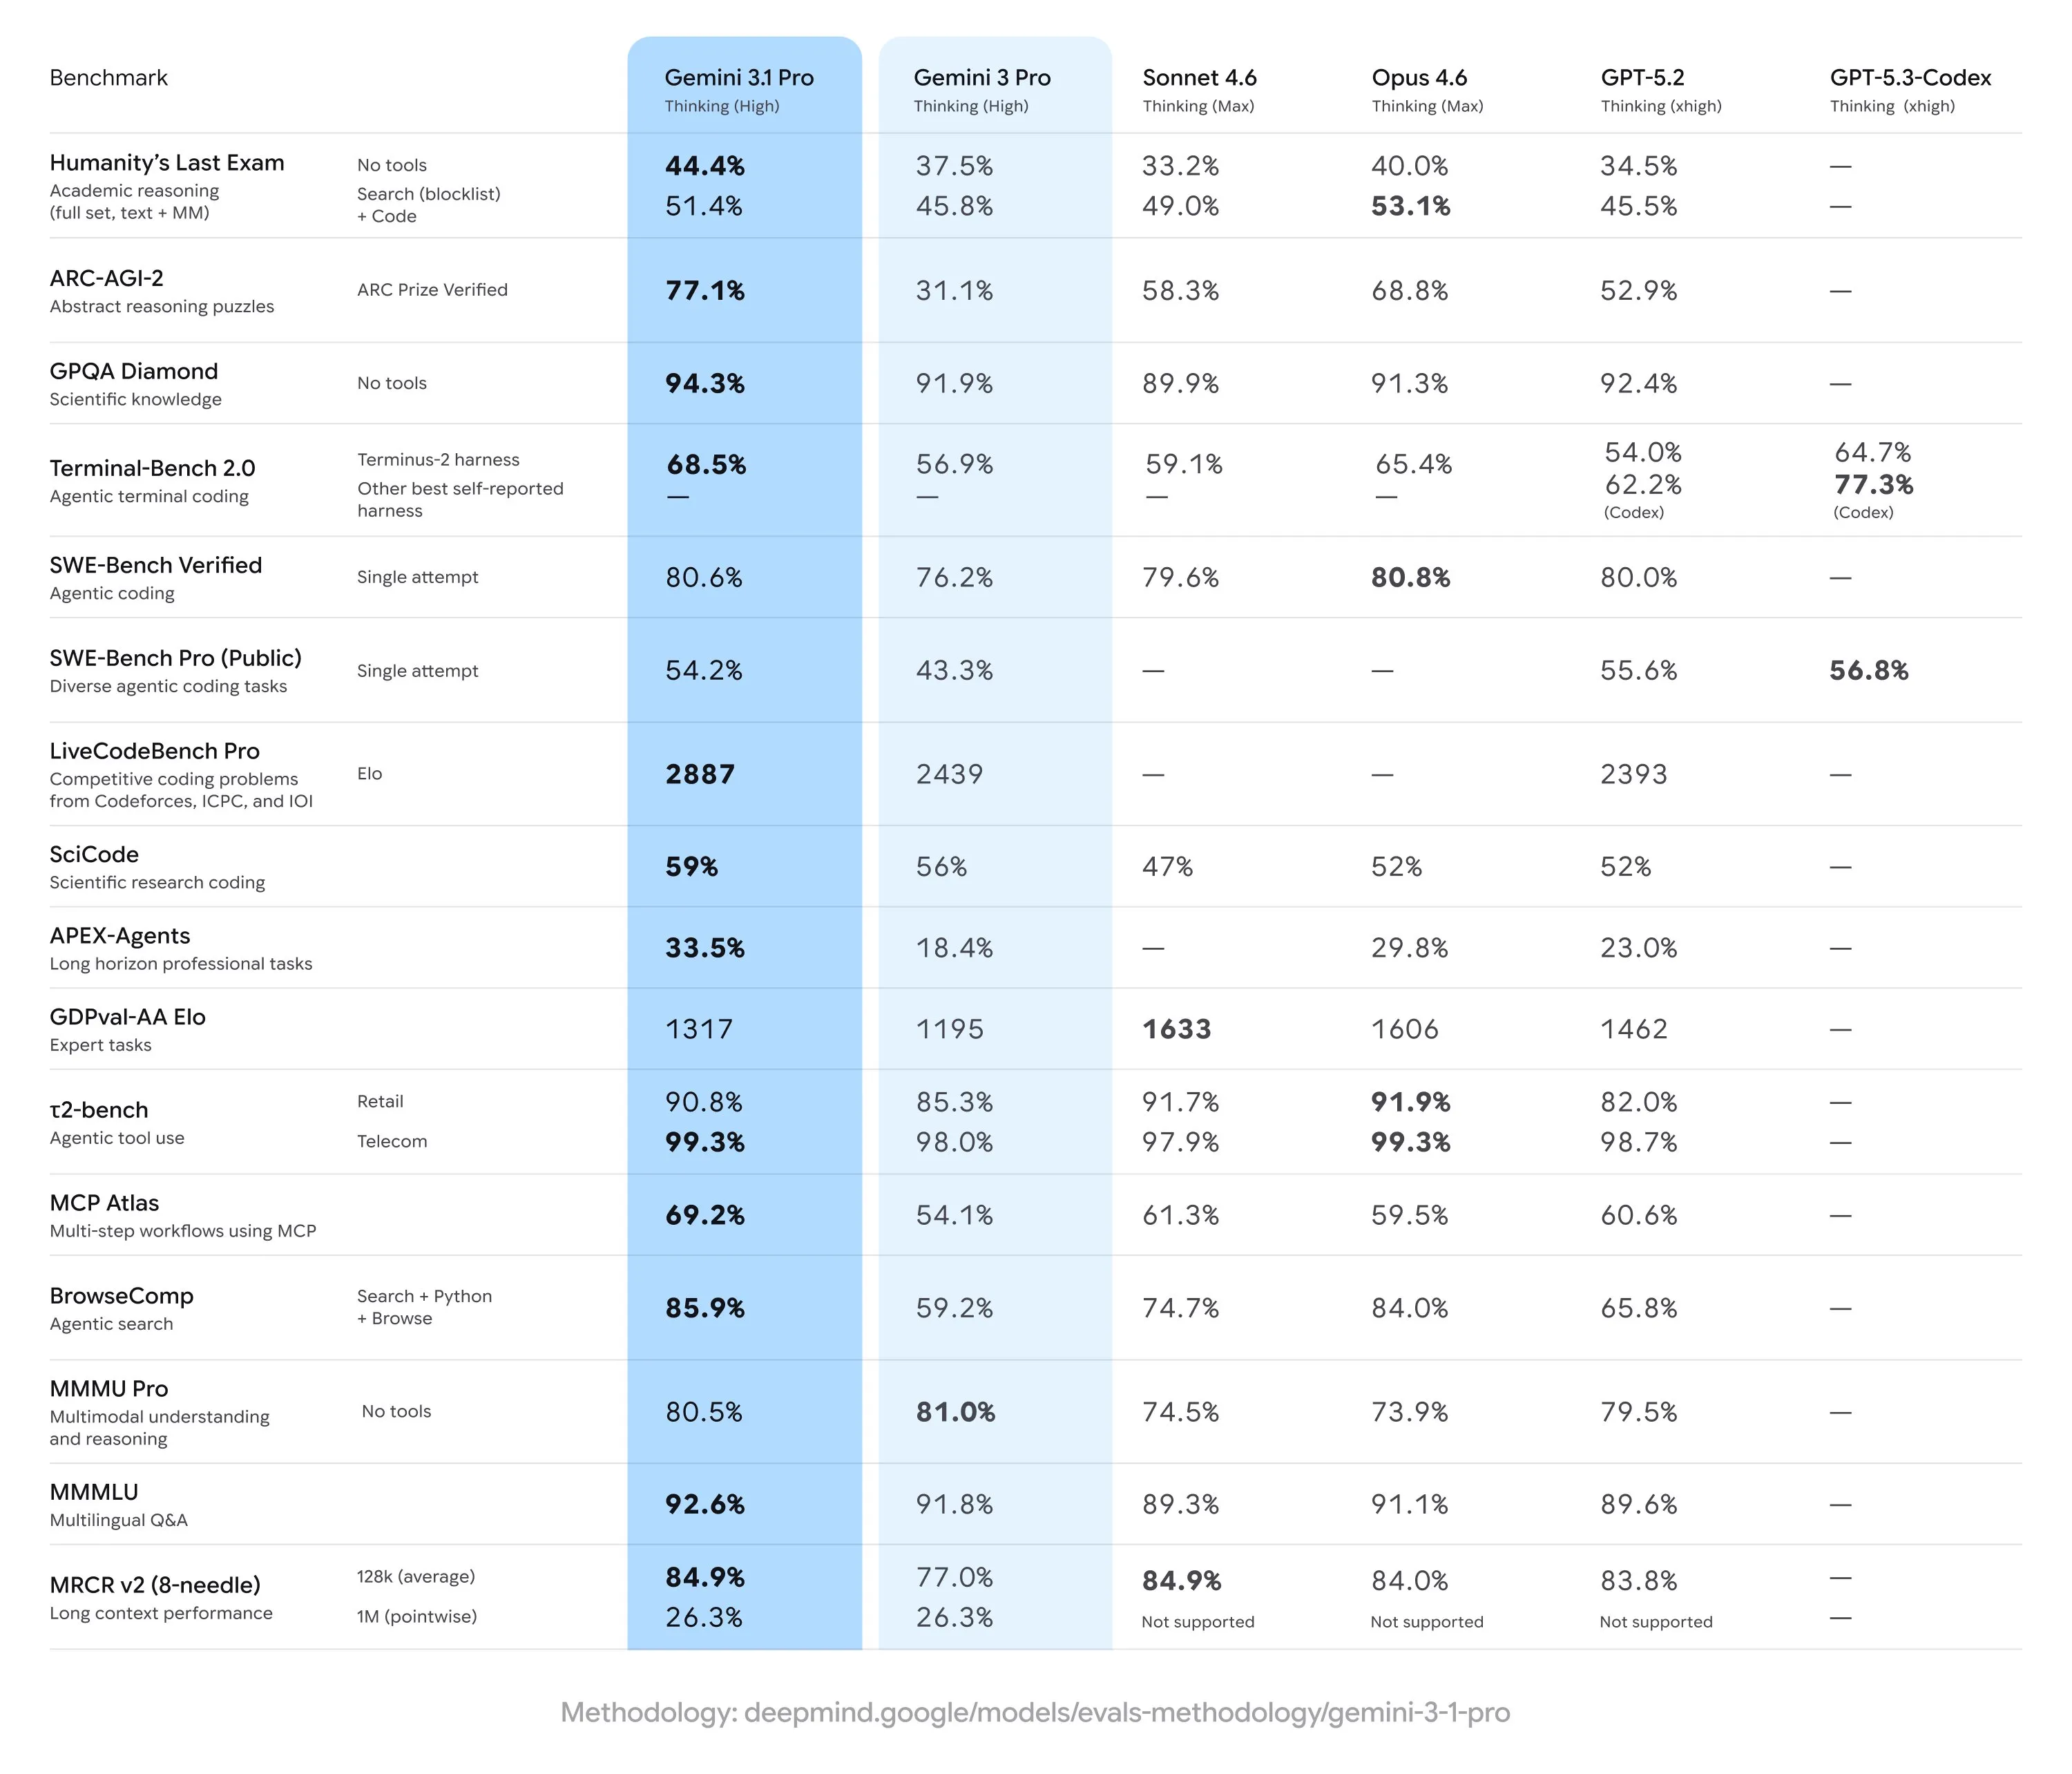
从 Google 随模型发布的基准测试结果来看(很贴心地列出了其他所有主要模型的各项分数),Gemini 3.1 Pro 似乎是目前最好的模型。 但遗憾的是,事实并非如此,这似乎又是 Google 的一次刷榜。
在大多数第三方评测中,我们看到它的能力相比 Gemini 3 Pro 出现了退步。而且,这并不局限于少数几类基准测试。它在多种基准测试中的得分都有所下降,包括衡量模型前端任务设计能力的 Design Arena、衡量智能体能力和长期规划能力的 Vending Bench,以及衡量情商、创意写作等软技能的 EQ bench。
在实际使用中,我也看到有用户抱怨它的编程能力和代码质量不佳,模型会陷入不断重复同样内容的死循环,而且整体体验更差。
这次发布,Google 不仅没能击败 OpenAI 或 Anthropic,甚至连自己都没能超越。 为什么会这样? 我猜是后训练做得不好。
Google 在数据和算力方面都有足够的资源,可以从一个非常强大的预训练基础模型起步。 这一步不需要太多精细打磨,主要取决于高质量数据、模型规模和浮点运算总量(FLOPs),而这些 Google 显然都不缺。
但后训练(监督微调和强化学习)需要更多的判断力和精细打磨,不能只靠“越多越好”的方式蛮干。 如果采取这种“越多越好”的思路,不直接评估模型本身,而是只盯着基准测试分数,最终就会得到我们在这里看到的这种为刷榜而优化的模型。 看起来,负责模型后训练的人员,其绩效很可能是按基准测试分数,而非模型的实际质量来衡量的。
如果 Google 想在顶尖行列保持竞争力,就需要彻底改变模型后训练的理念,否则它很快就会变得无足轻重。
如果我在 Google 工作,我还会担心模型的发布节奏。从 Gemini 3 发布到现在,OpenAI 和 Anthropic 都已经各自为旗下模型推出了 3 次重大更新,而这才是 Google 三个月来的第一次更新。 如果它想继续在顶尖行列竞争,就必须加快模型训练和发布的速度。
Sonnet 4.6
说到 Anthropic 的新品发布,他们也更新了中等规模的 Sonnet 模型。
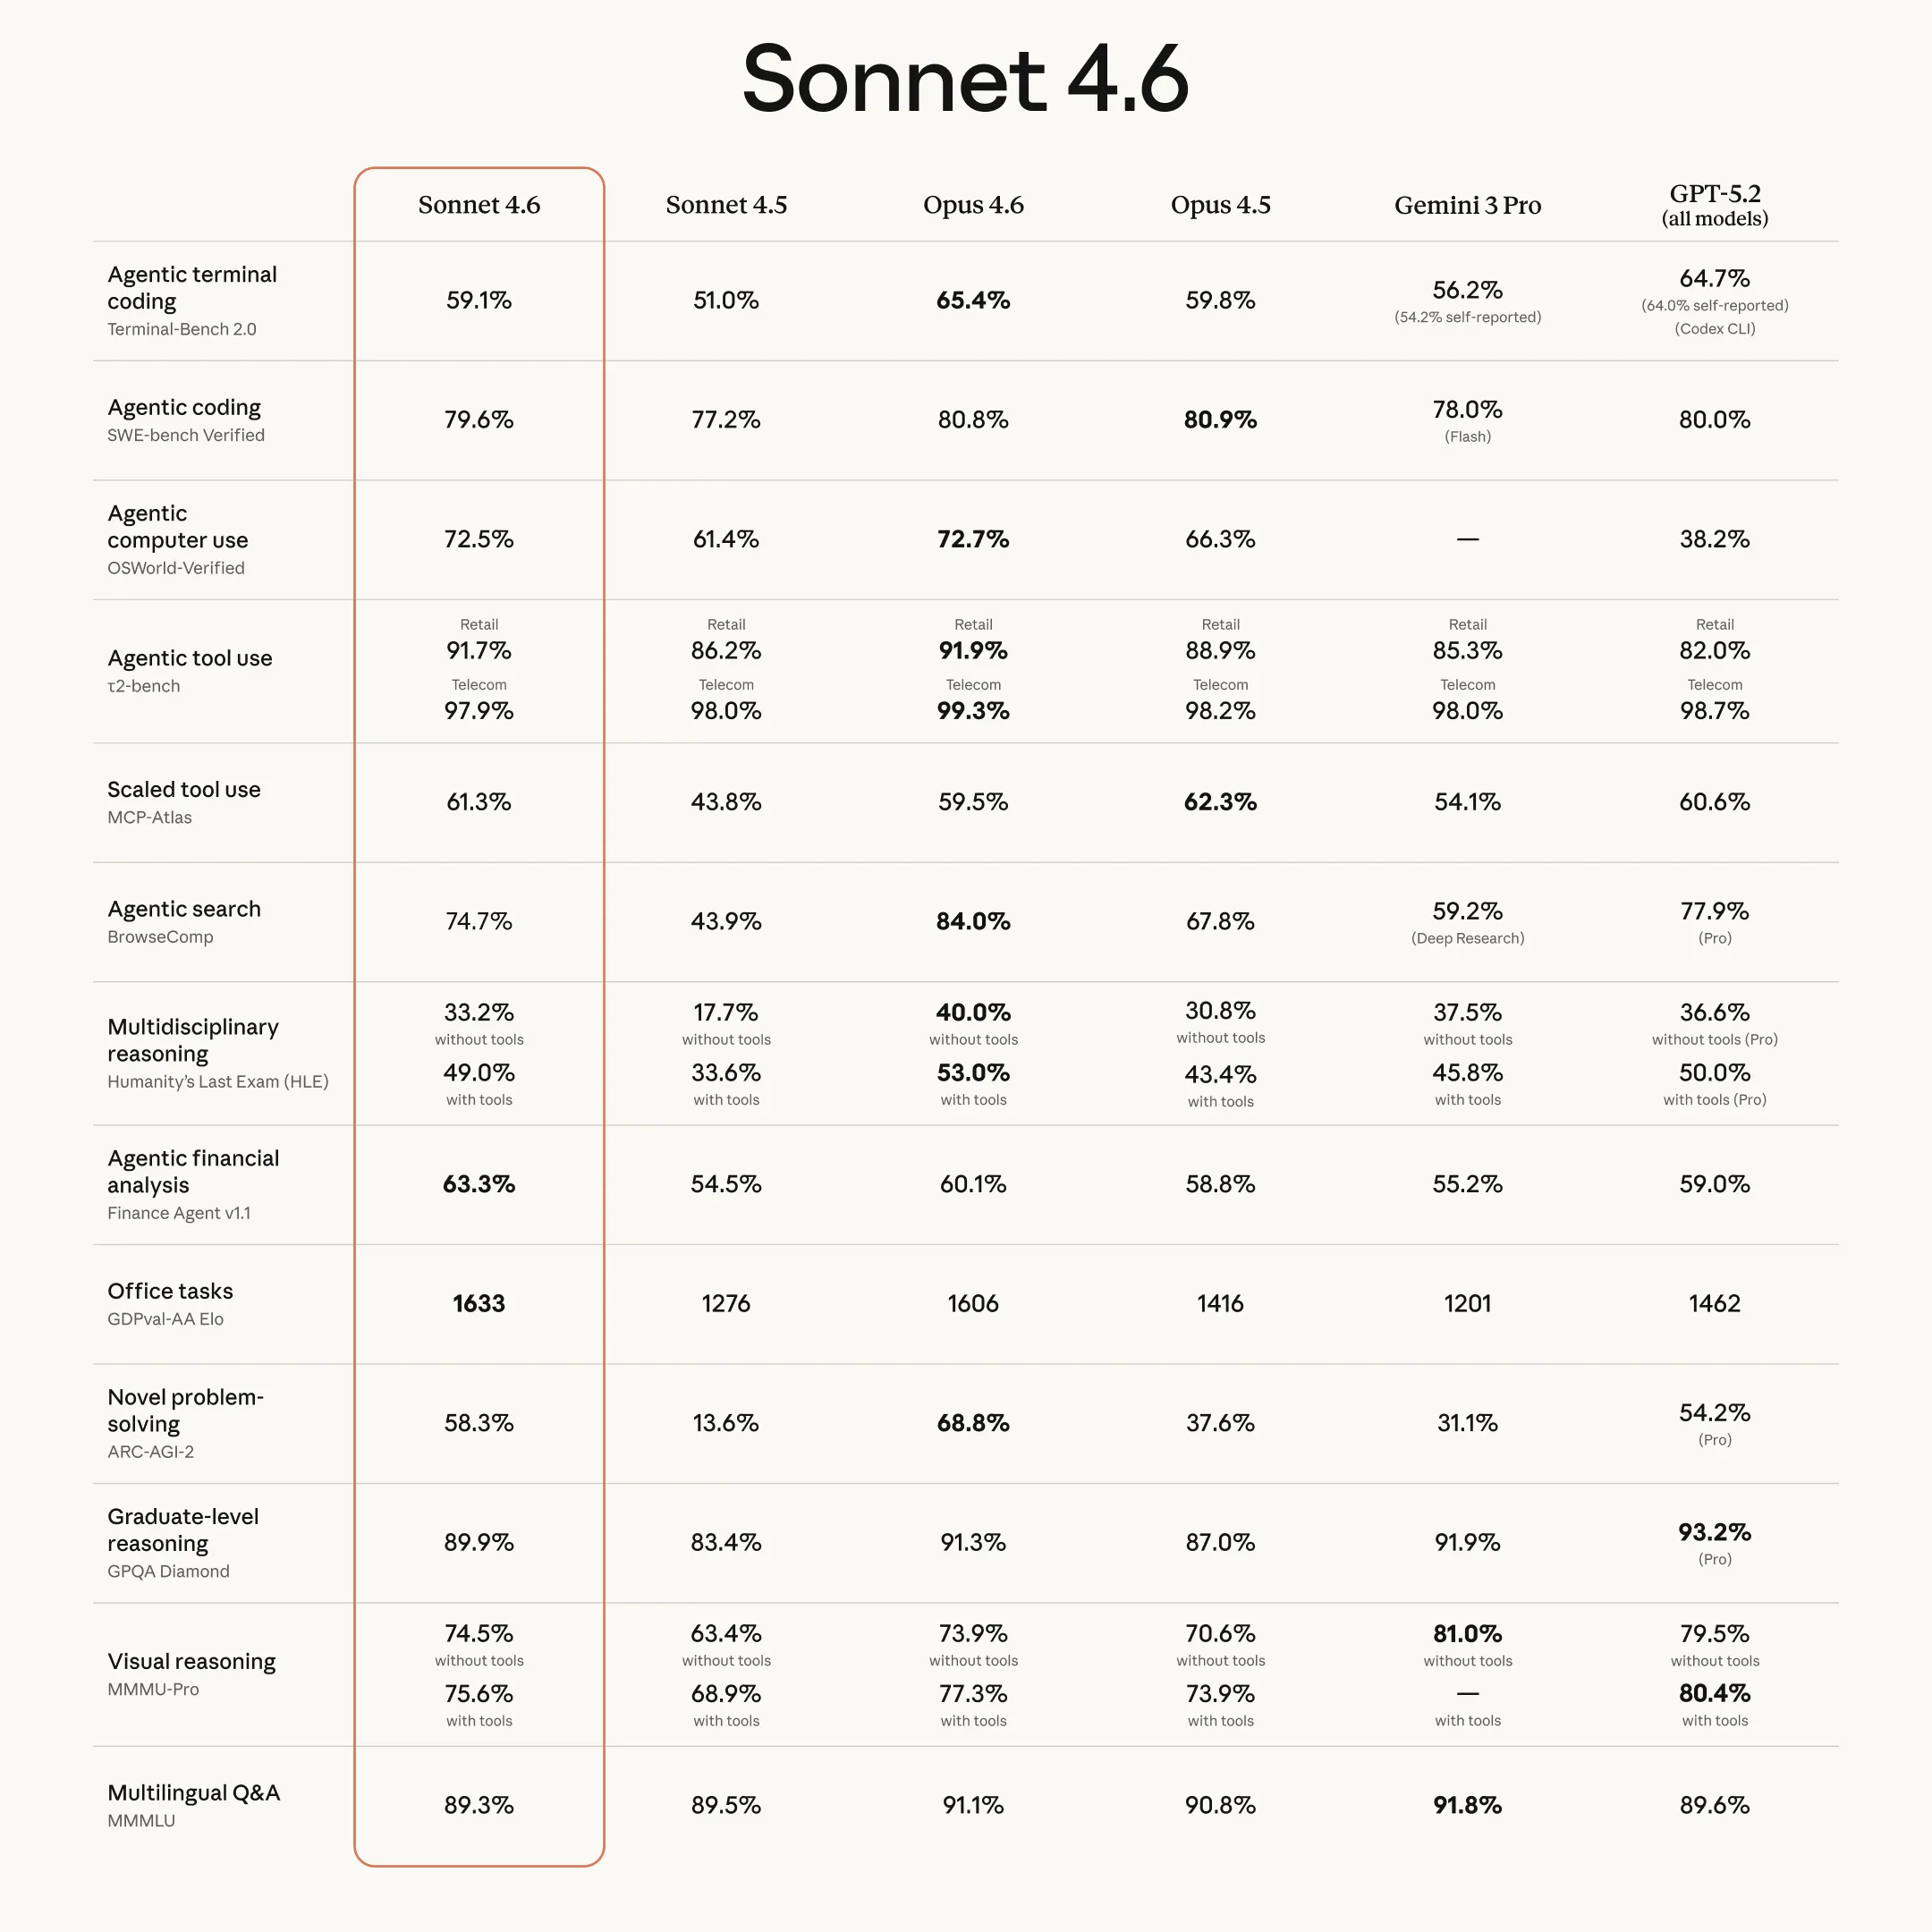
这又是 Anthropic 一次扎实、优质的更新,缩小了 Sonnet 与它的大哥 Opus 之间的能力差距。 不过,它也继承了我上周在 Opus 4.6 评测中提到的那些值得质疑的安全取舍,这一点从它在 Vending Bench 中的行为就能看出来。
至于实际编程能力,我这周一直在 Claude Code 中使用它。它完成任务的效率似乎介于 Opus 4.5 和 Opus 4.6 之间,但写出的代码质量略低,而且仍然会运行一些傻乎乎的命令,导致自己有时卡住,不过通常能自行纠正。 因此,我把它与 Opus 4.5 和 GPT 5.2 归为同一档:能力很强,但还算不上最前沿。
和往常一样,它的定价有点奇怪:明明模型不如 GPT 5.x,却卖得更贵。我很希望 Anthropic 能像之前给 Opus 降价那样,也降低 Sonnet 的价格。如果把每百万输出 token 的价格从 15 美元减半至 7.50 美元,它的性价比就会高得让人难以拒绝,但按目前的价格来看,它的定位有些尴尬。
我一直在对许多模型进行相对排名,所以决定整理一份榜单,展示我的排序。这份排名专门针对编程。如果某个模型没有出现在榜单上,那是因为我根本不推荐用它来编程。
前沿模型
- GPT 5.3 Codex
- Opus 4.6
第二梯队
- Sonnet 4.6
- GPT 5.2
- Opus 4.5
第三梯队
- GLM 5
- Minimax M2.5
- Kimi K2.5
快讯
AI 低质内容检测器
AI 低质内容(以及对它的检测)如今已经成了我们每天都能看到的东西。 Distil labs 基于 Gemma 3 270M 做了一个能检测 AI 低质内容的小型微调模型。
这个规模的模型完全可以在浏览器中运行,或作为 Chrome 扩展程序的一部分运行。 他们如何用极少量由人工编写或验证的数据构建出高质量数据集,也有一些很有意思的思路。
注意,这不是用来判断文章是否由 AI 生成的检测器,它只检测文章的写作质量是否与 AI 低质内容相似。
结语
希望你喜欢本周的新闻。如果想每周都收到这些资讯,别忘了在下方订阅我们的邮件列表。