Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
Gemma 4
Google ha vuelto a entrar en la carrera de modelos de código abierto con su serie de modelos Gemma 4.
La serie Gemma 4 viene en 4 tamaños: 5 mil millones, 8 mil millones, 26 mil millones (MoE, 4 mil millones de parámetros activos) y 31 mil millones (denso).
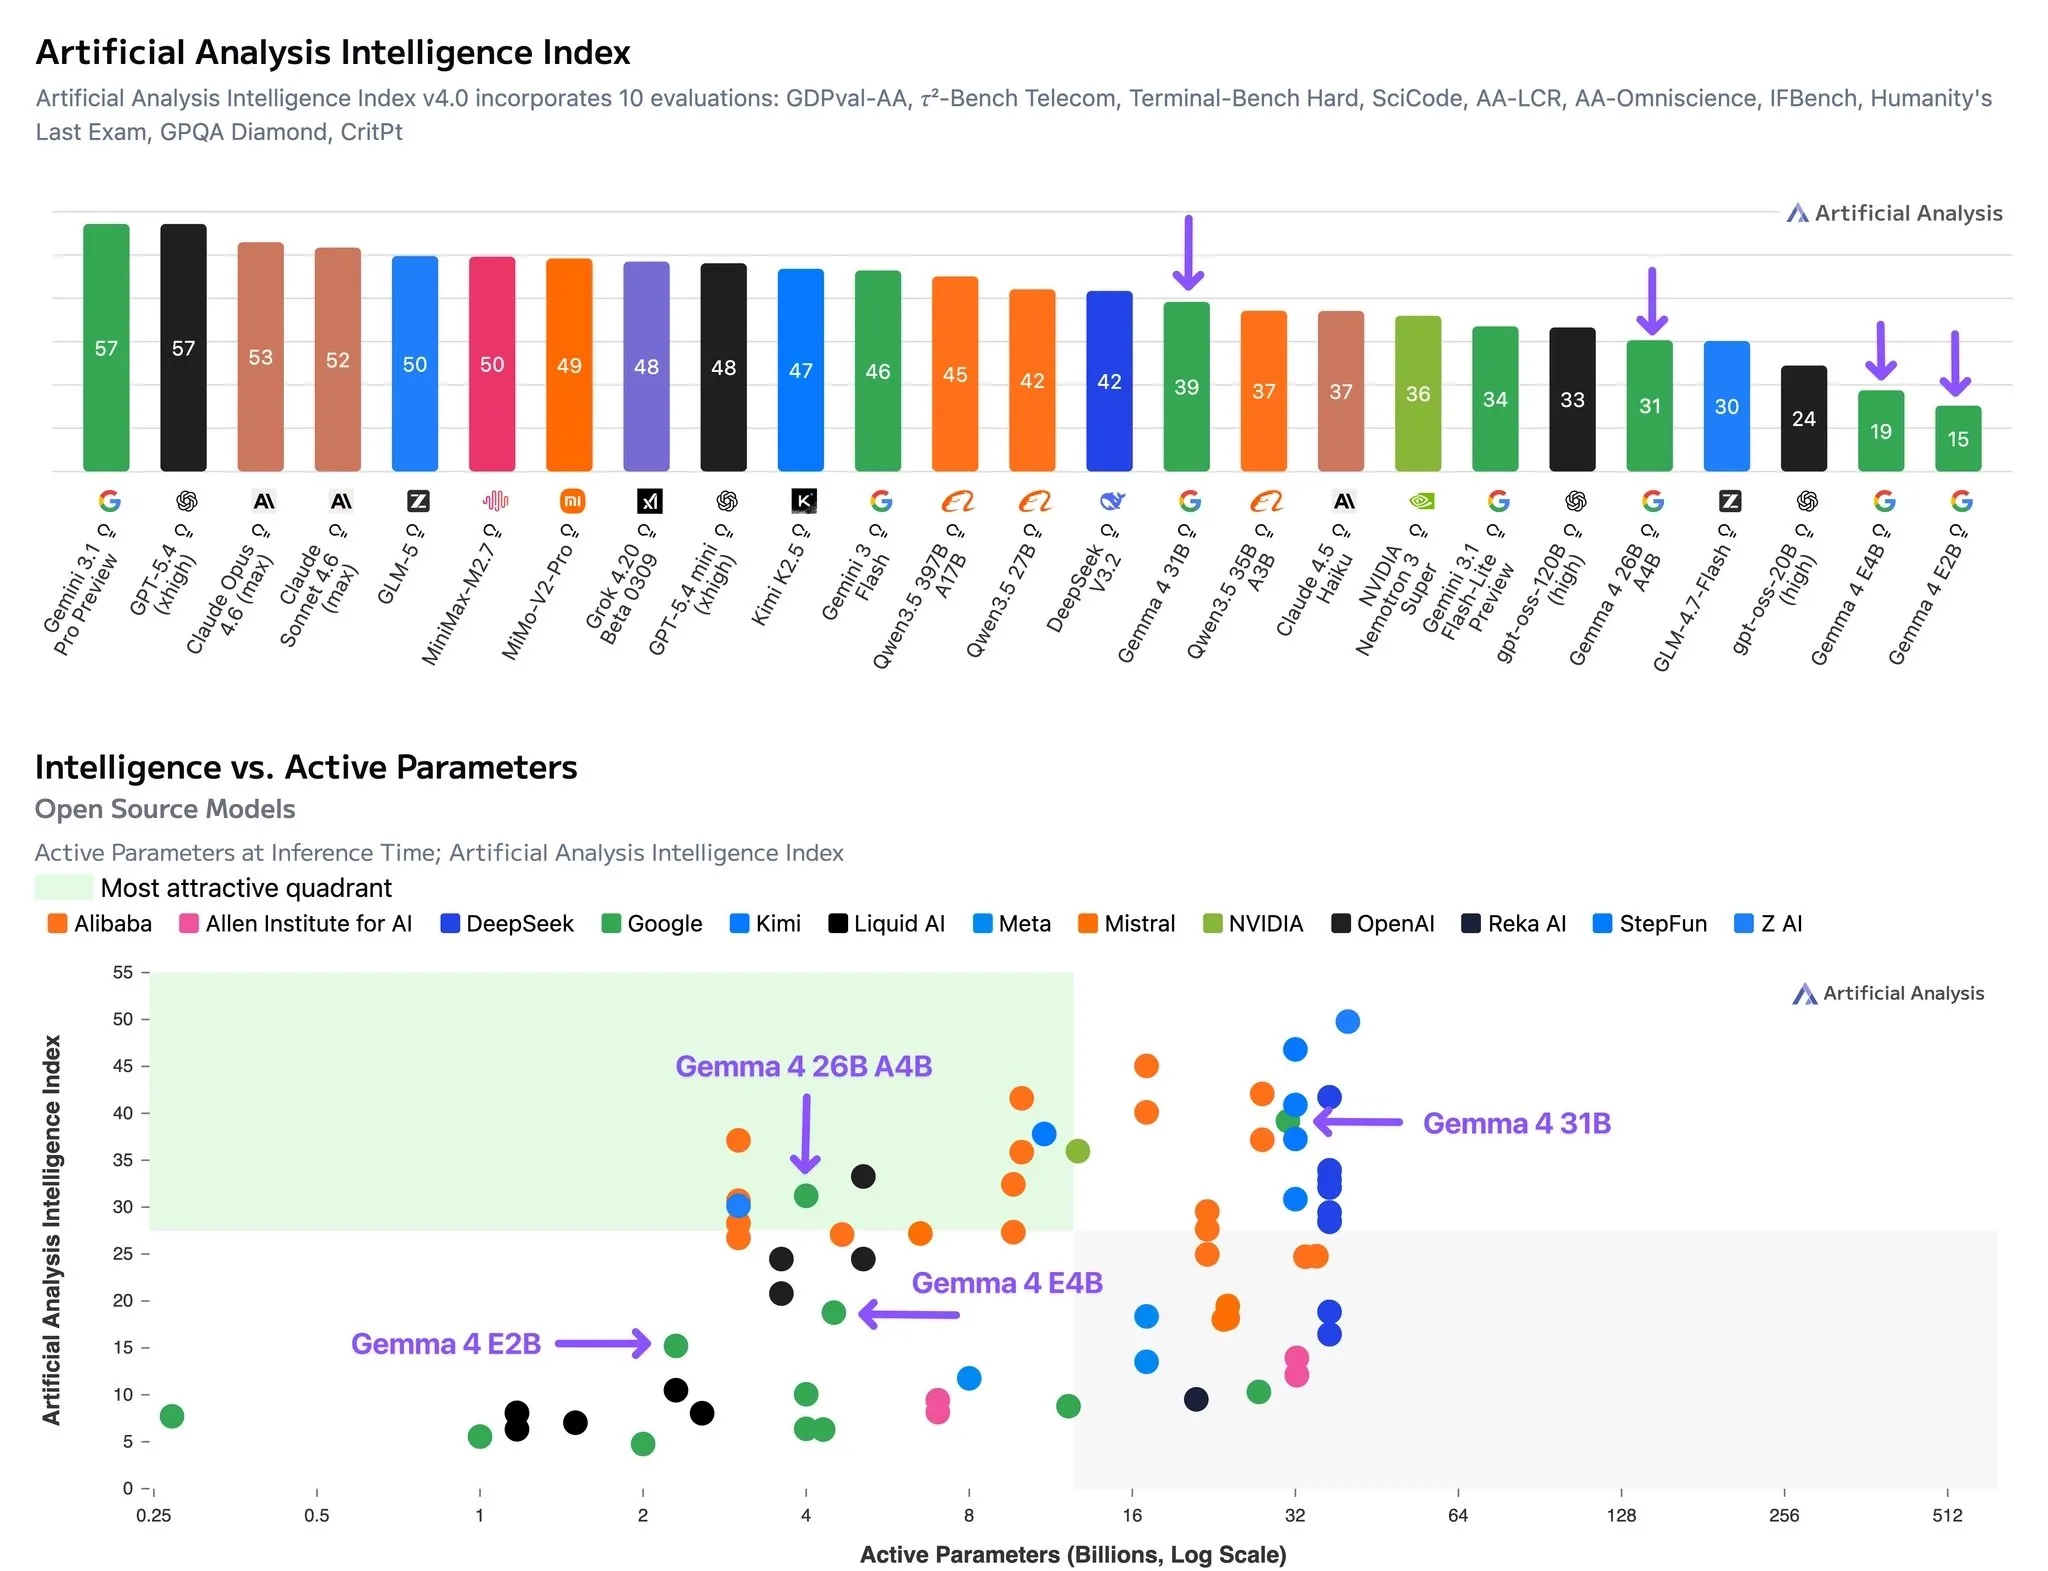
Los modelos más pequeños de 5B y 8B siguen la arquitectura Gemma 3n, es decir, son completamente diferentes a cualquier otro LLM disponible actualmente, lo que los hace mucho más eficientes de lo que su cantidad de parámetros sugeriría (aproximadamente 2 veces más rápidos y eficientes).
Los modelos están diseñados para competir con sus contrapartes Qwen 3.5, algo que logran en gran medida. Los modelos más pequeños se quedan un poco atrás, pero serán mejores para implementaciones en dispositivos de bajos recursos gracias a su arquitectura altamente eficiente.
Los modelos más grandes son una competencia más cercana, siendo superiores en benchmarks de programación pero inferiores en tareas agénticas más generales. También son razonadores más eficientes que Qwen3.5, con un uso de tokens en modo de razonamiento comparable al de los modelos Qwen3.5 en modo sin razonamiento (y entre 3 y 5 veces menos que Qwen3.5 con el razonamiento activado). Esto los hace nuevamente ideales para inferencia local o rápida debido a la cantidad limitada de “pensamiento” que realizan los modelos, mientras que los modelos Qwen3.5 tienden a pensar en exceso de manera muy marcada.
En general, los modelos Gemma 4 son sólidos. Si buscas modelos de bajo costo o modelos que puedas ejecutar en casa, definitivamente te recomendaría probarlos y compararlos con los modelos Qwen3.5 para tus casos de uso.
Noticias Breves
Trinity Large Thinking
Arcee AI lanzó su serie Trinity de modelos estadounidenses de código abierto hace unos meses, aunque con un post-entrenamiento realizado de forma bastante apresurada.
Ahora han actualizado el post-entrenamiento del modelo Trinity Large (MoE, 398B parámetros totales, 13B parámetros activos), y los resultados se ven prometedores.
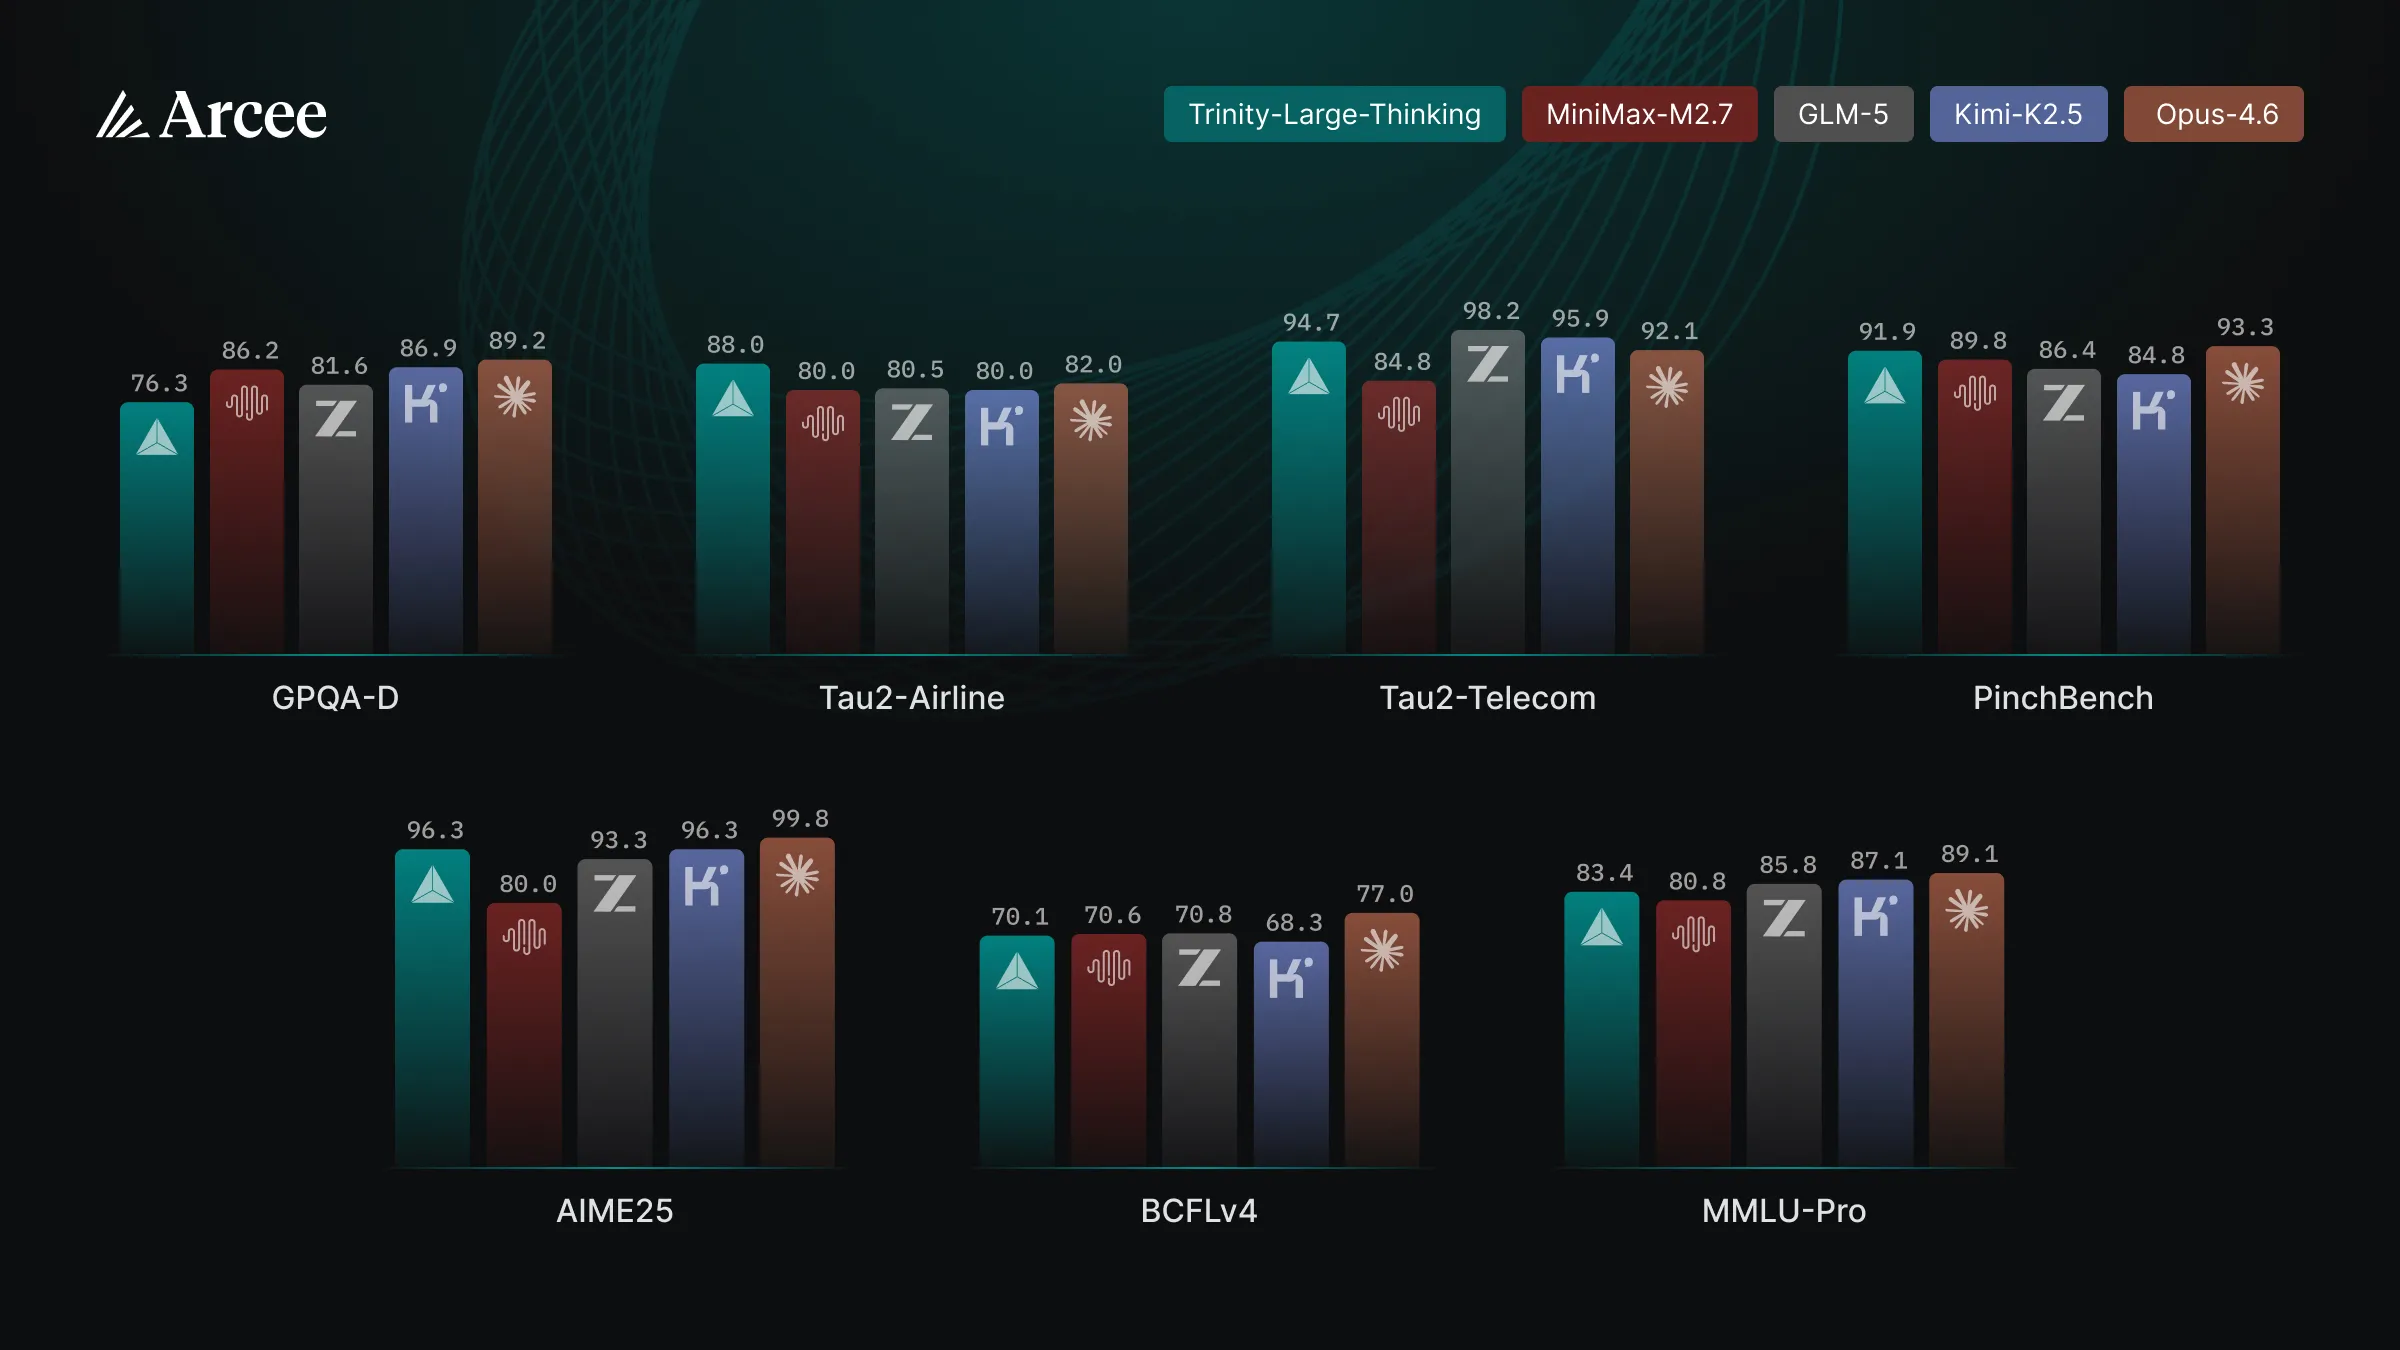
Son competitivos con los mejores modelos abiertos de China en benchmarks. También fueron el modelo estadounidense mejor valorado en OpenRouter durante los últimos meses, y eso fue antes de este post-entrenamiento mucho mejor que le han dado al modelo.
He sido fanático de Arcee AI por un tiempo. Ver cómo pasaron de hacer fine-tuning de modelos pequeños a entrenar sus propios modelos de frontera en aproximadamente 1 año ha sido increíblemente emocionante, y recomendaría probar este modelo si quieres apoyar la IA estadounidense de código abierto.
LFM2.5 350M
LiquidAI continúa su búsqueda de hacer los modelos más pequeños y rápidos que aún sean mínimamente utilizables para tareas agénticas, esta vez presentando un modelo de 350M parámetros que ha sido entrenado con 28 billones de tokens, convirtiéndolo en el modelo más sobre-entrenado que conocemos (basado en las leyes de escala de Chinchilla).
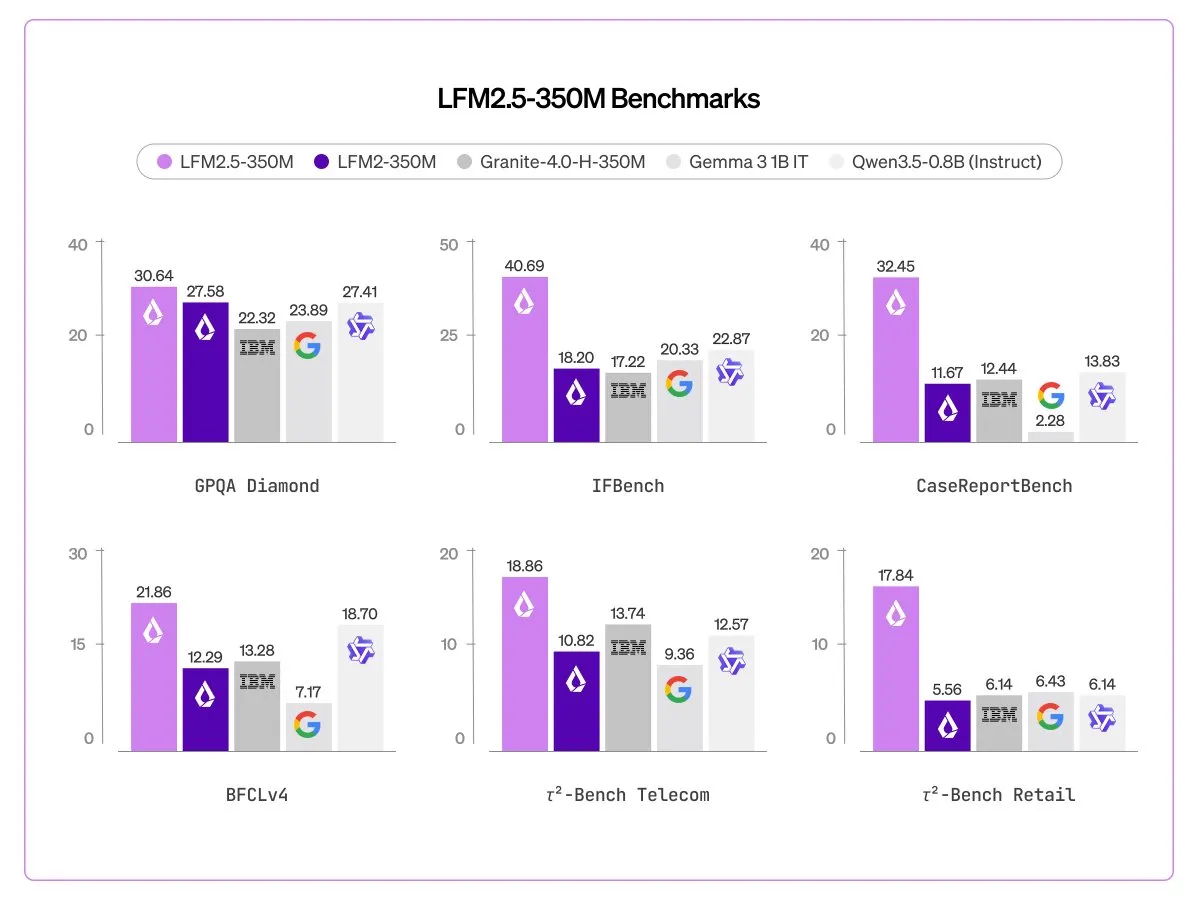
Cuando se cuantiza, este modelo ocupará solo alrededor de 300MB de memoria, lo que permite desplegarlo en casi cualquier lugar. Históricamente, este tamaño de modelo se ha considerado solo para modelos de juguete utilizados por investigadores, por lo que el hecho de que Liquid haya logrado crear algo mínimamente útil es extremadamente impresionante.
Cierre
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.