注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
Gemma 4
Google 带着 Gemma 4 系列模型,重新加入了开源模型的竞争。
Gemma 4 系列共有 4 种参数规模:50 亿、80 亿、260 亿(MoE,激活参数为 40 亿)和 310 亿(稠密模型)。
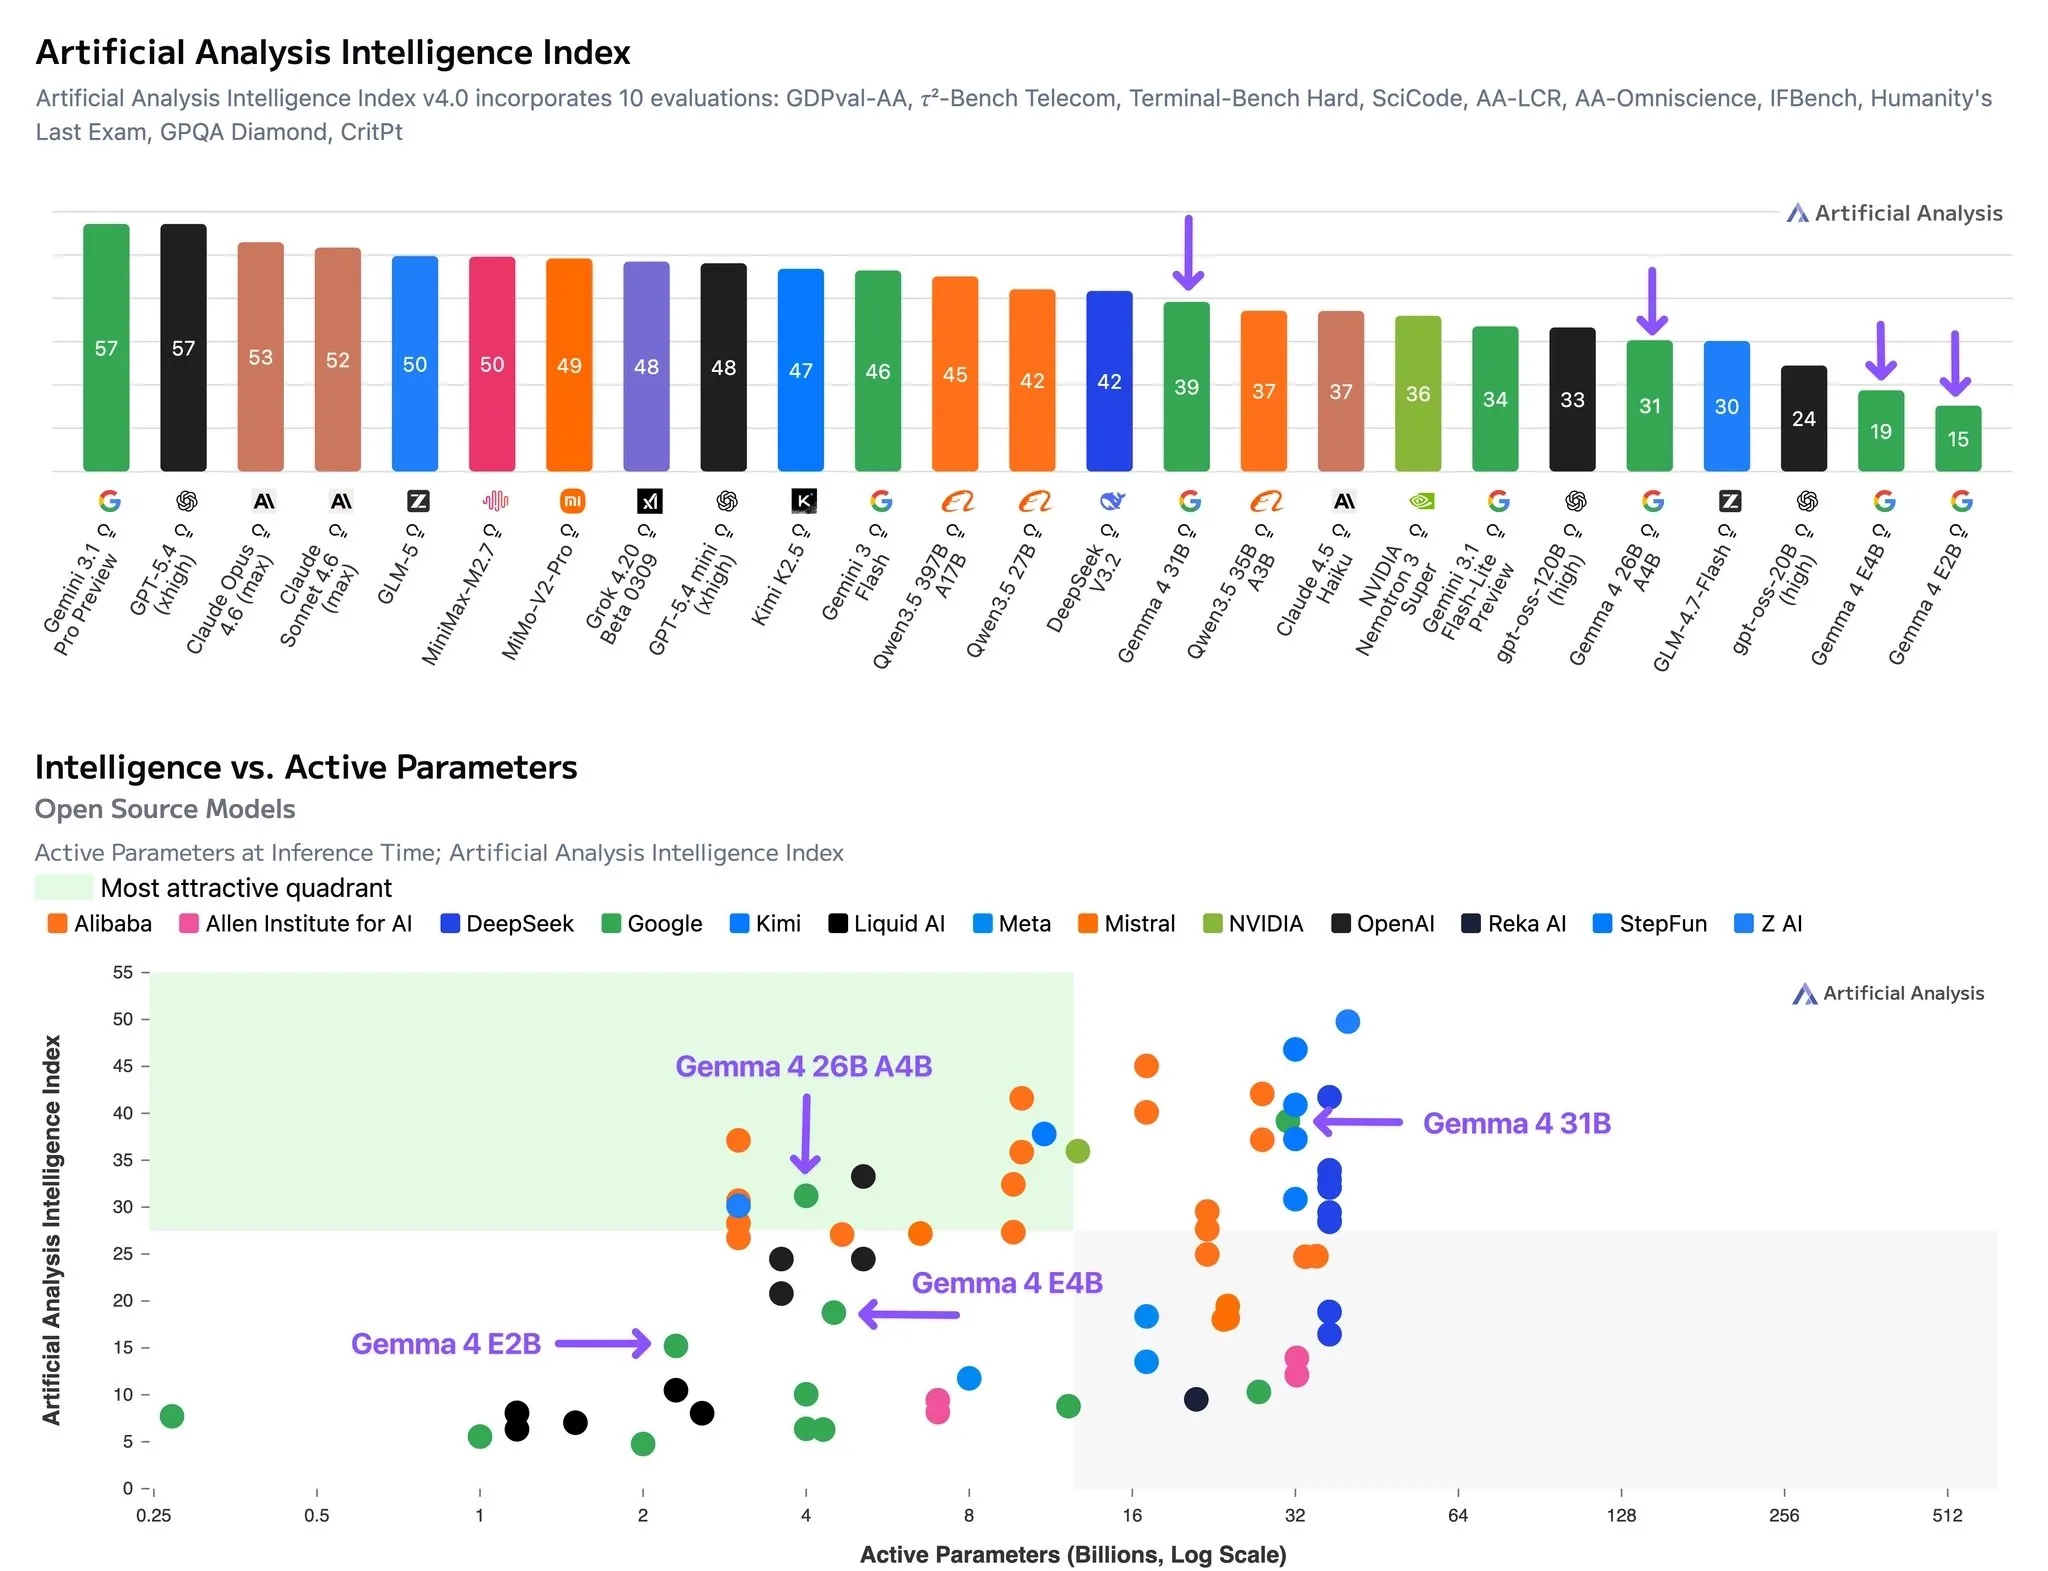
较小的 5B 和 8B 模型沿用了 Gemma 3n 架构,也就是说,它们与目前其他所有大语言模型的架构都完全不同。因此,它们的效率远高于单看参数量时的预期(速度和效率都在约 2 倍的水平)。
这些模型旨在与同等规模的 Qwen 3.5 模型竞争,而它们基本做到了。 较小的模型表现稍逊一筹,但凭借高效的架构,它们更适合资源有限的边缘部署场景。
较大的模型则与对手更为接近,在编程基准测试中领先,但在更通用的智能体任务上落后。 它们的推理效率也高于 Qwen3.5:在推理模式下,token 用量与未开启推理模式的 Qwen3.5 模型相当(仅为开启推理模式的 Qwen3.5 的 1/3 到 1/5)。 这也让它们很适合本地运行或快速推理,因为这些模型的思考量比较有限,而 Qwen3.5 模型往往会严重过度思考。
总体而言,Gemma 4 系列模型表现扎实。如果你正在寻找低成本模型,或是能在家里运行的模型,我绝对建议你试试,并根据自己的使用场景,将它们与 Qwen3.5 模型进行比较。
快讯
Trinity Large Thinking
几个月前,Arcee AI 发布了美国开源模型 Trinity 系列,但当时的后训练做得相当仓促。
现在,他们为 Trinity 大模型(MoE,总参数量 3980 亿,激活参数为 130 亿)更新了后训练,结果看起来相当不错。
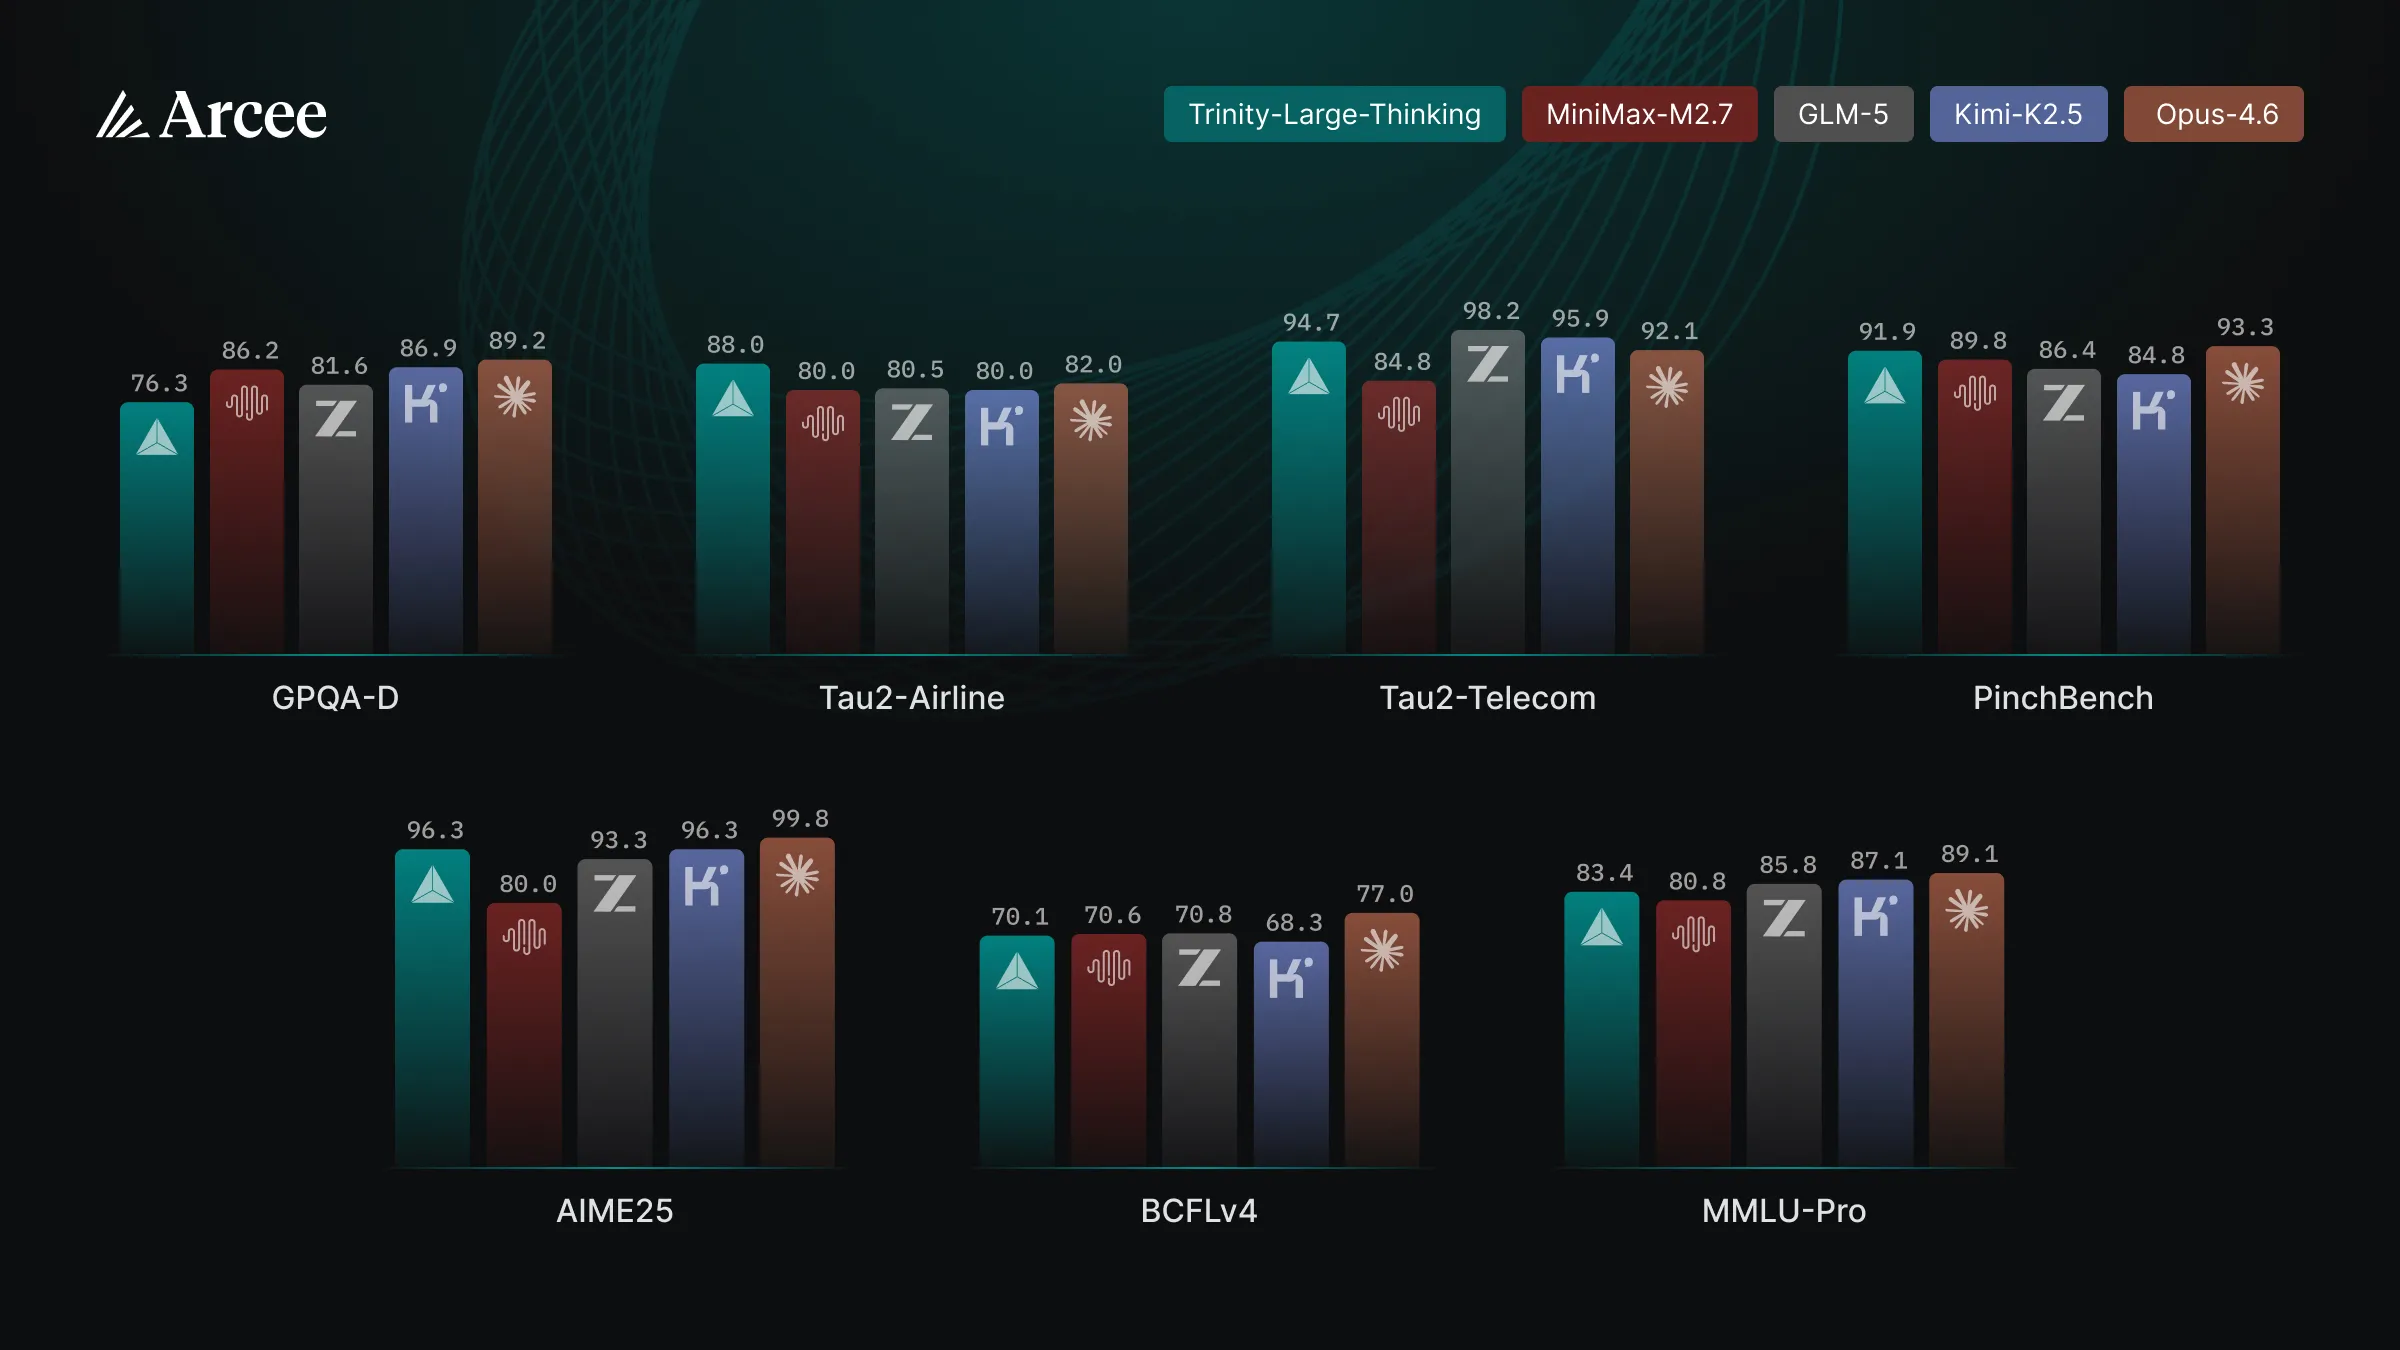
在基准测试中,它们已经能与中国顶尖的开放模型一较高下。 过去几个月,它们也是 OpenRouter 上排名最高的美国模型,而那还是在这次效果好得多的后训练之前。
我关注并支持 Arcee AI 已经有一段时间了。看着他们在大约一年里,从微调小模型发展到训练自己的前沿模型,实在很酷。如果你想支持美国开源 AI,我推荐你试试这款模型。
LFM2.5 350M
LiquidAI 继续追求打造尽可能小、尽可能快,同时在智能体任务上仍有一定实用性的模型。这次,他们推出了一款 3.5 亿参数的模型,使用了 28 万亿个 token 进行训练。按照 Chinchilla 缩放定律衡量,这使它成为目前已知过度训练程度最高的模型。
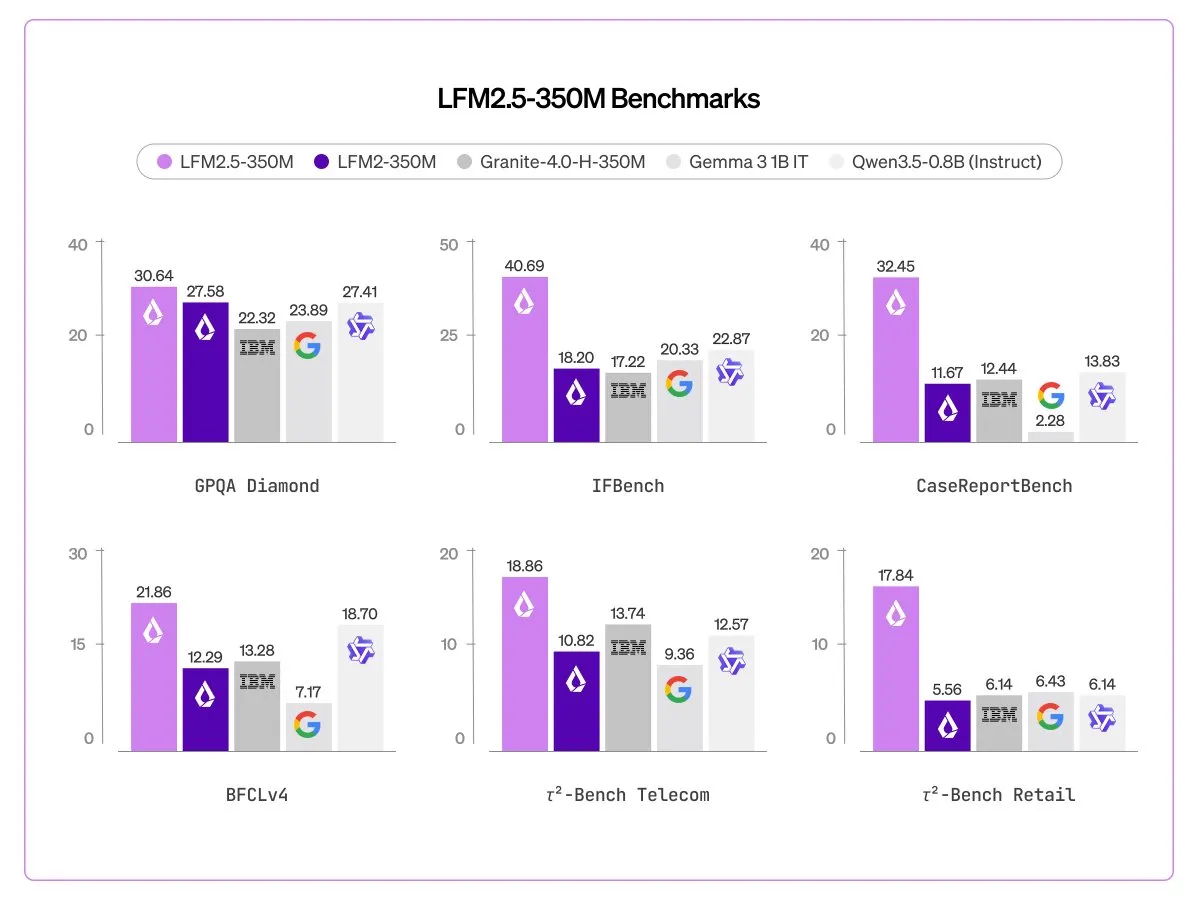
量化后,这款模型只需占用约 300MB 内存,几乎可以部署在任何地方。 过去,这种参数规模通常只用于研究人员使用的玩具模型,因此 Liquid 能做出一款有一定实用性的模型,实在令人印象深刻。
结语
希望你喜欢本周的新闻。如果你想每周收到最新资讯,别忘了在下方订阅我们的邮件列表。