Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Gemma 4
O Google voltou à corrida dos modelos de código aberto com sua série de modelos Gemma 4.
A série Gemma 4 vem em 4 tamanhos: 5 bilhões, 8 bilhões, 26 bilhões (MoE, 4 bilhões de parâmetros ativos) e 31 bilhões (denso).
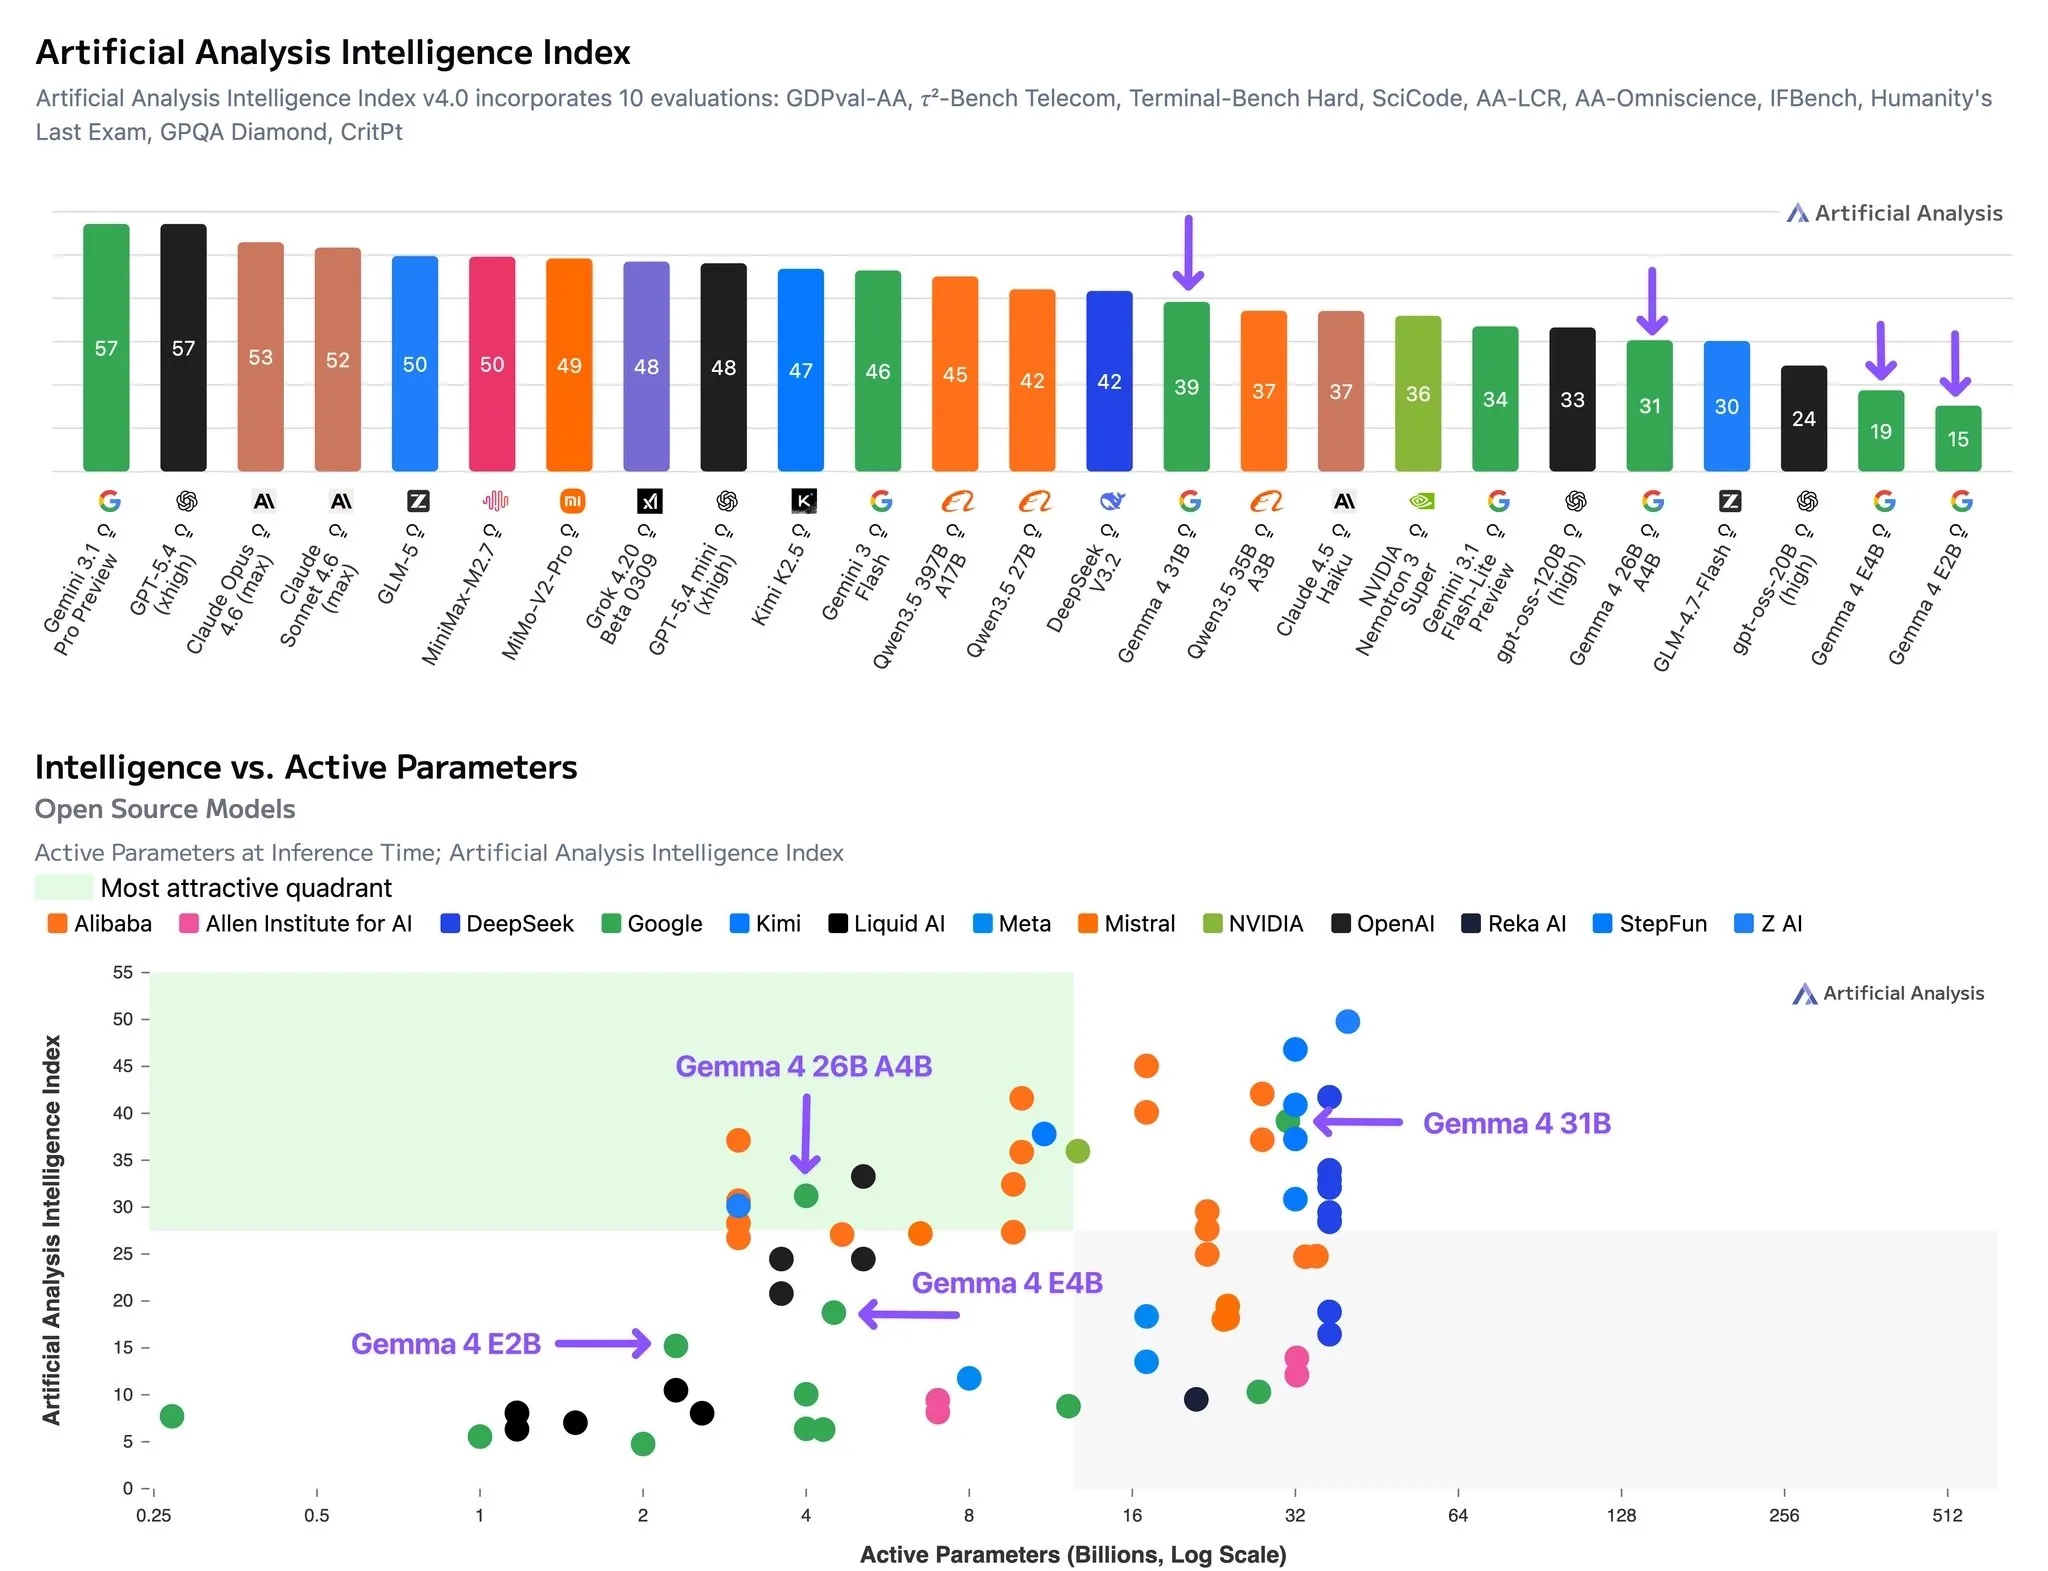
Os modelos menores de 5B e 8B seguem a arquitetura Gemma 3n, ou seja, são completamente diferentes de qualquer outro LLM existente atualmente, tornando-os muito mais eficientes do que sua contagem de parâmetros sugeriria (cerca de 2x mais rápidos e eficientes).
Os modelos foram desenvolvidos para competir com seus equivalentes no Qwen 3.5, o que conseguem fazer em grande parte. Os modelos menores ficam um pouco para trás, mas serão melhores para implantações de borda com poucos recursos, graças à sua arquitetura altamente eficiente.
Os modelos maiores são uma correspondência mais próxima, estando à frente nos benchmarks de programação, mas atrás em tarefas agênticas mais gerais. Eles também são raciocínadores mais eficientes do que o Qwen3.5, com o uso de tokens no modo de raciocínio sendo comparável aos modelos Qwen3.5 no modo sem raciocínio (e 3 a 5x menor do que o Qwen3.5 com raciocínio ativado). Isso novamente os torna adequados para inferência local ou rápida, devido à quantidade limitada de “pensamento” que os modelos realizam — algo que os modelos Qwen3.5 tendem a exagerar bastante.
No geral, os modelos Gemma 4 são sólidos. Se você está procurando modelos de baixo custo ou modelos que possa rodar em casa, recomendo fortemente experimentá-los e compará-los com os modelos Qwen3.5 para seus casos de uso.
Destaques Rápidos
Trinity Large Thinking
A Arcee AI lançou sua série Trinity de modelos americanos de código aberto há alguns meses, mas o pós-treinamento foi feito de forma um tanto apressada.
Agora eles atualizaram o pós-treinamento do modelo Trinity large (MoE, 398B total, 13B de parâmetros ativos), e os resultados estão promissores.
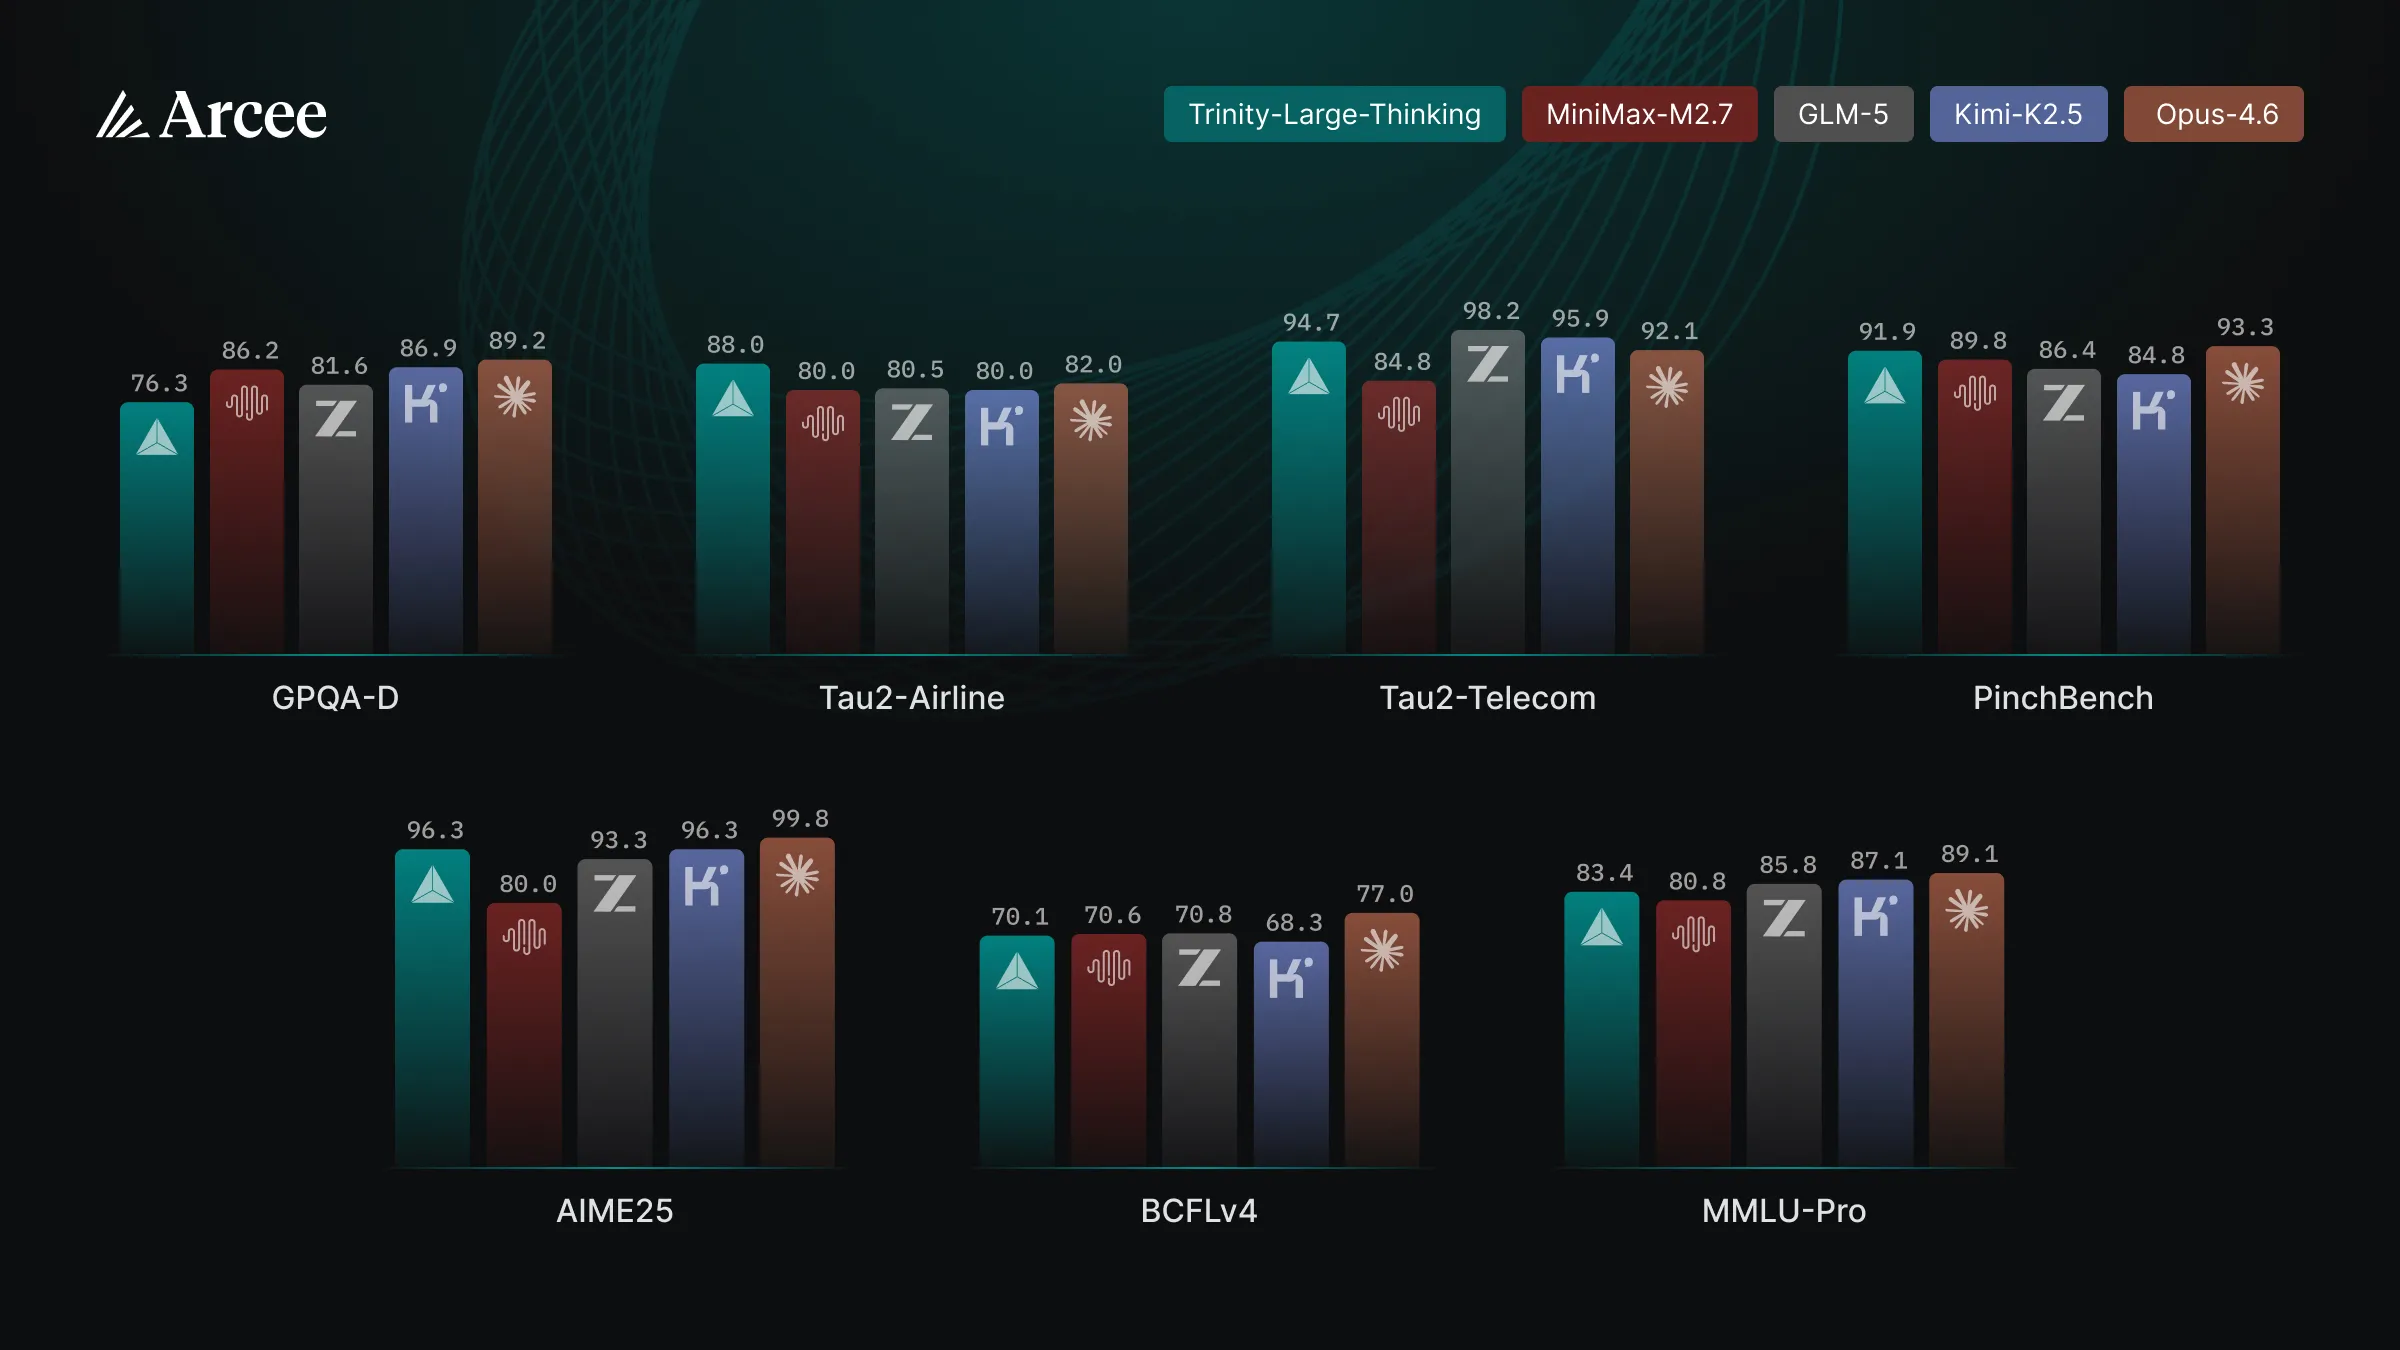
Eles são competitivos com os principais modelos abertos da China nos benchmarks. Também foram o principal modelo americano no OpenRouter nos últimos meses — e isso antes deste pós-treinamento muito aprimorado que receberam.
Sou fã da Arcee AI há algum tempo. Acompanhar sua evolução, de fazer fine-tuning em modelos pequenos ao treinamento de seus próprios modelos de fronteira em cerca de 1 ano, tem sido incrível de observar. Recomendo que você experimente este modelo se quiser apoiar a IA americana de código aberto.
LFM2.5 350M
A LiquidAI continua sua missão de criar os modelos menores e mais rápidos que ainda sejam minimamente utilizáveis para tarefas agênticas — desta vez lançando um modelo de 350M de parâmetros treinado em 28 trilhões de tokens, tornando-o o modelo mais “sobre-treinado” de que temos conhecimento (com base nas leis de escalonamento Chinchilla).
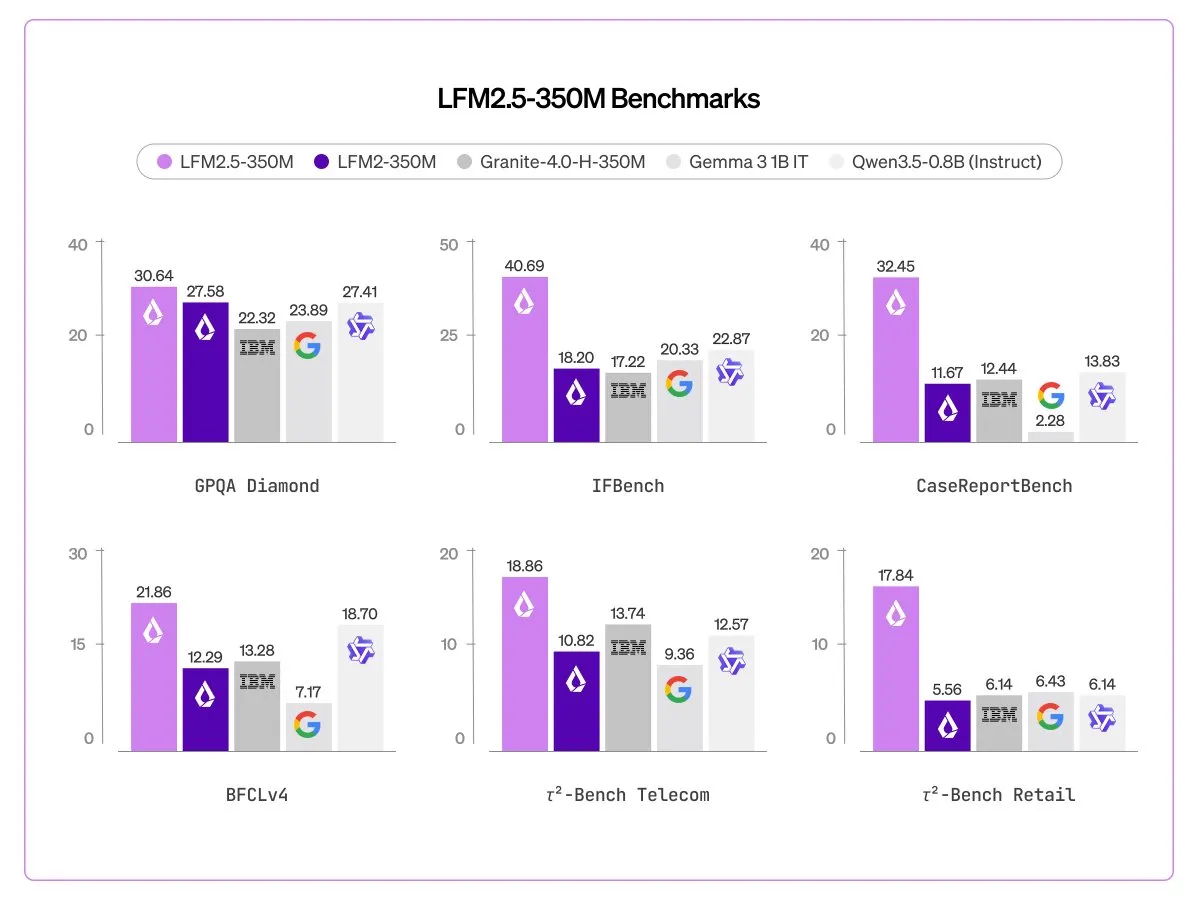
Quando quantizado, este modelo ocupará apenas cerca de 300MB de memória, permitindo que seja implantado em praticamente qualquer lugar. Historicamente, esse tamanho de modelo era considerado apenas para modelos experimentais usados por pesquisadores, por isso o fato de a Liquid ter conseguido criar algo minimamente útil é extremamente impressionante.
Conclusão
Espero que você tenha gostado das novidades desta semana. Se quiser receber as notícias toda semana, não deixe de se inscrever em nossa lista de e-mails abaixo.