
Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
Gemini 3
El tan esperado modelo Gemini 3 de Google finalmente está aquí.
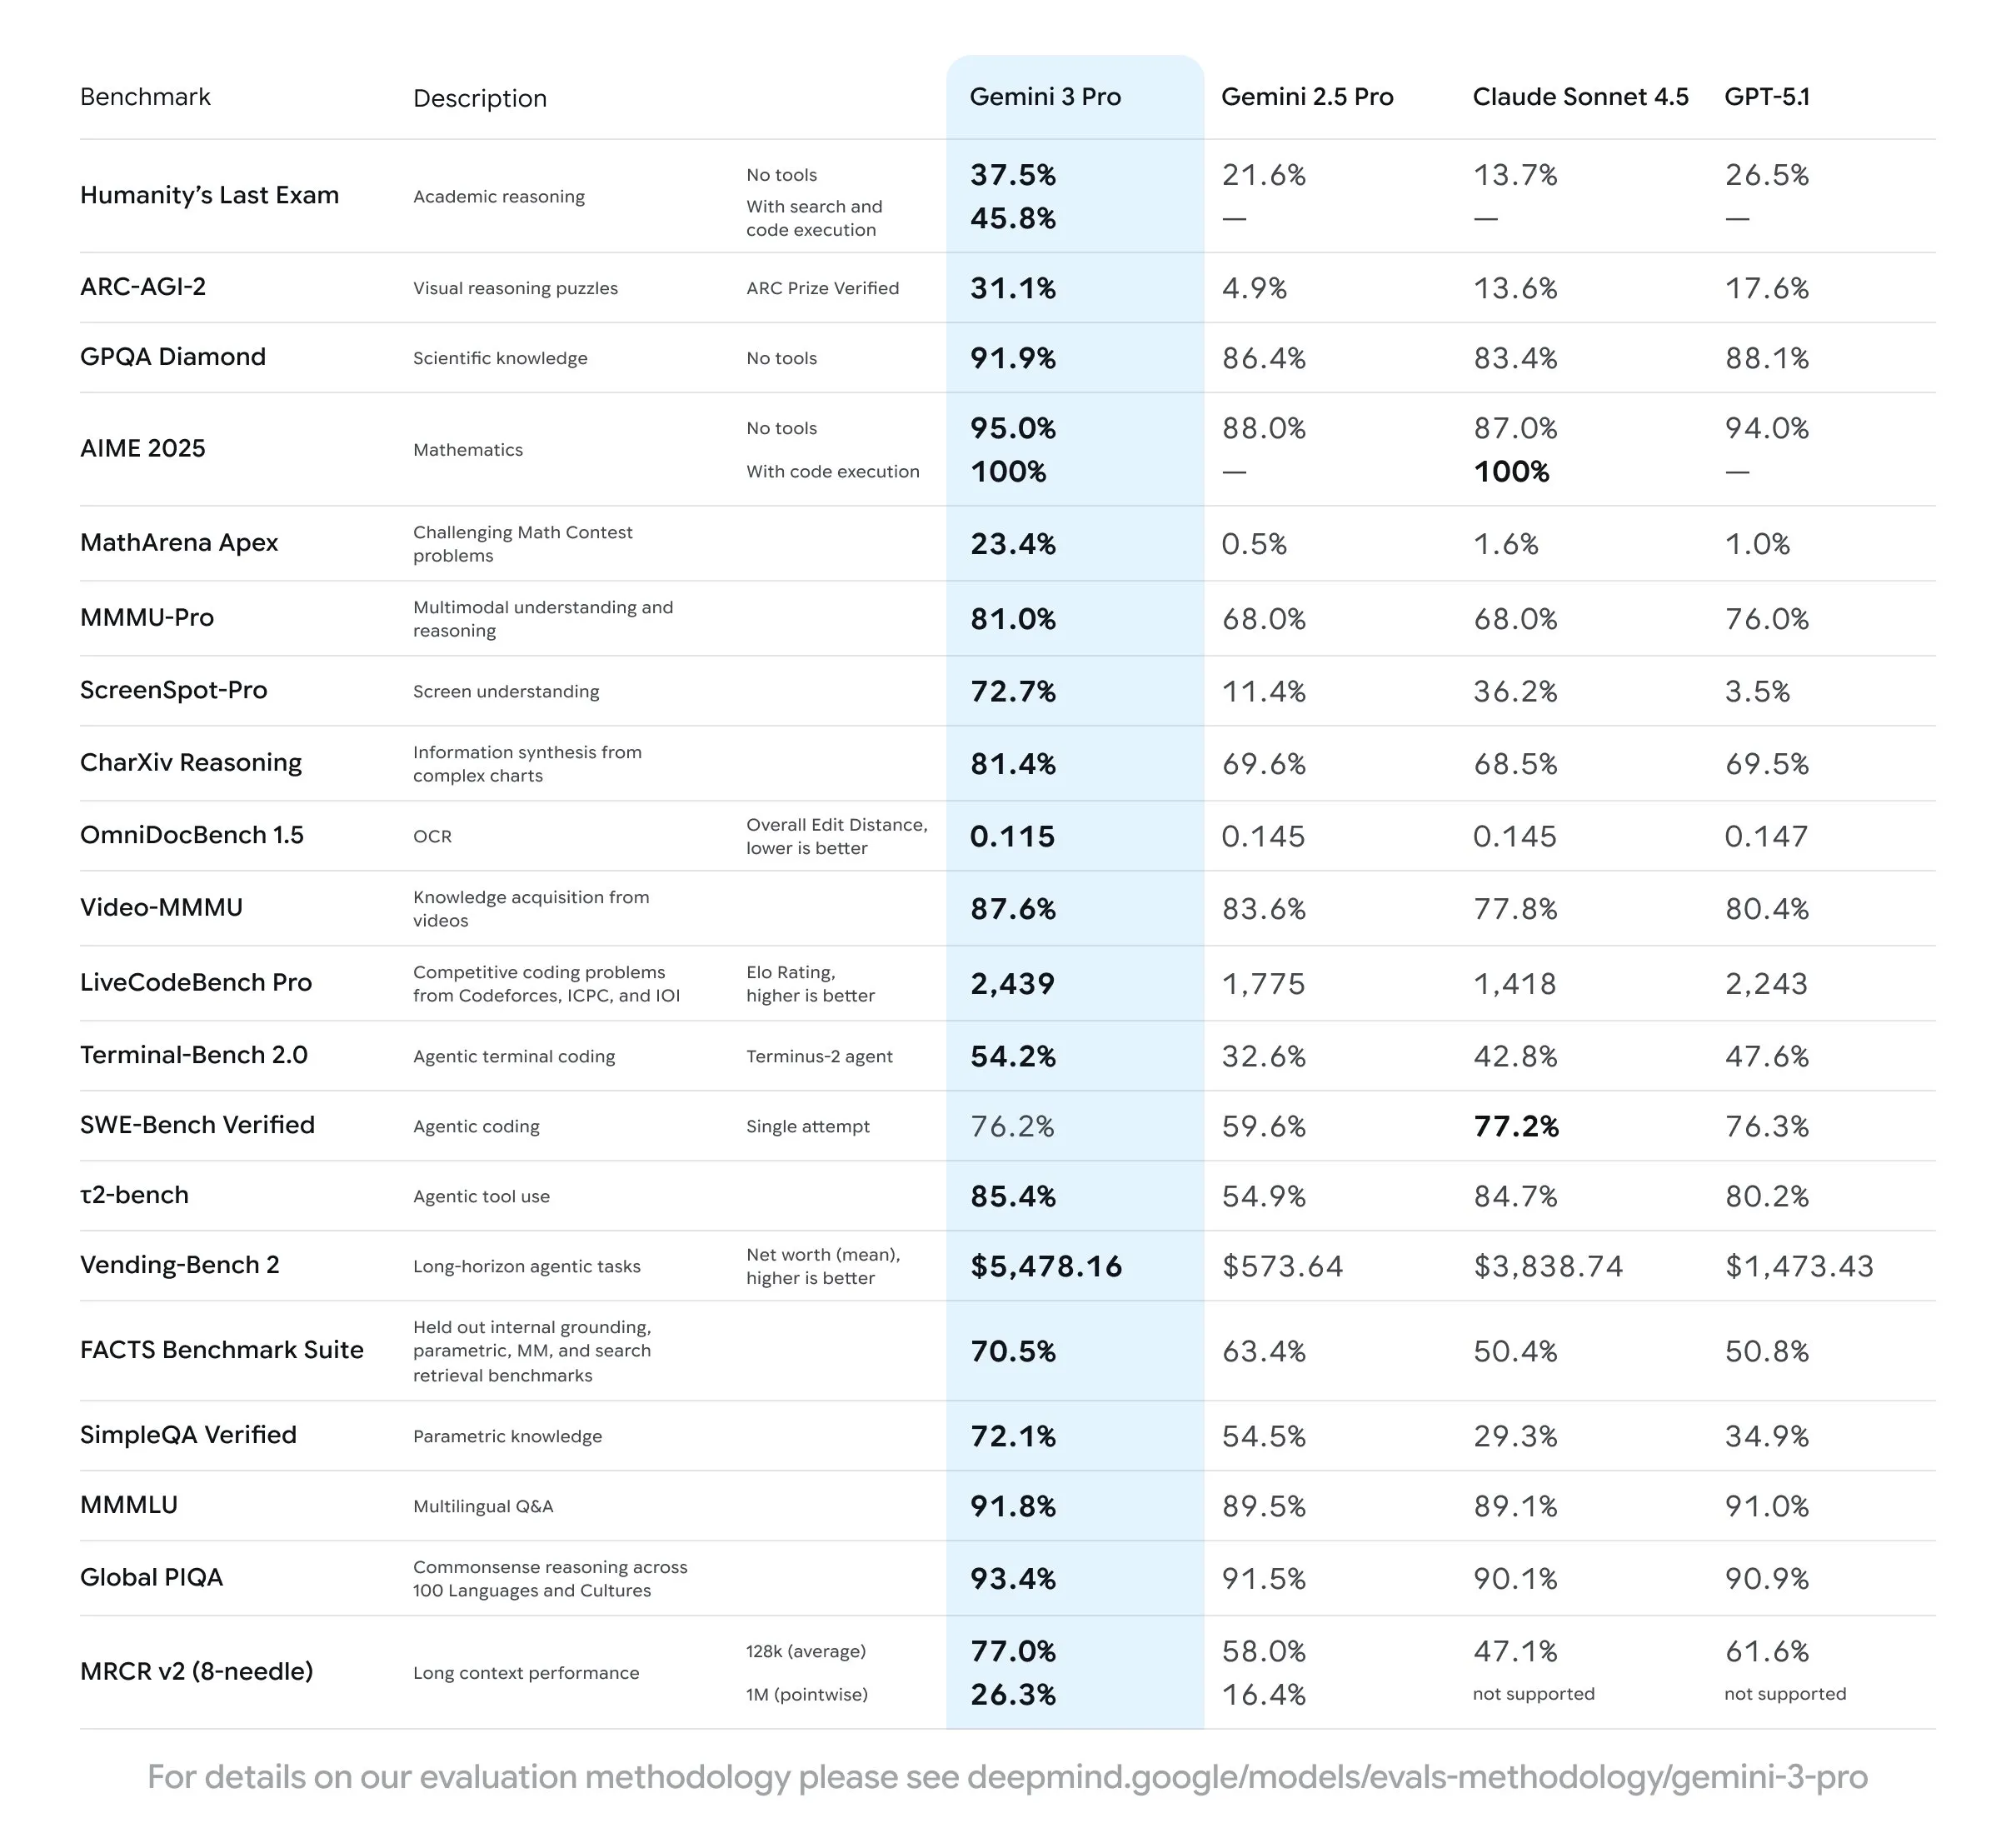
Comencemos con lo bueno. ¿En qué categorías es Gemini 3 definitivamente el mejor?
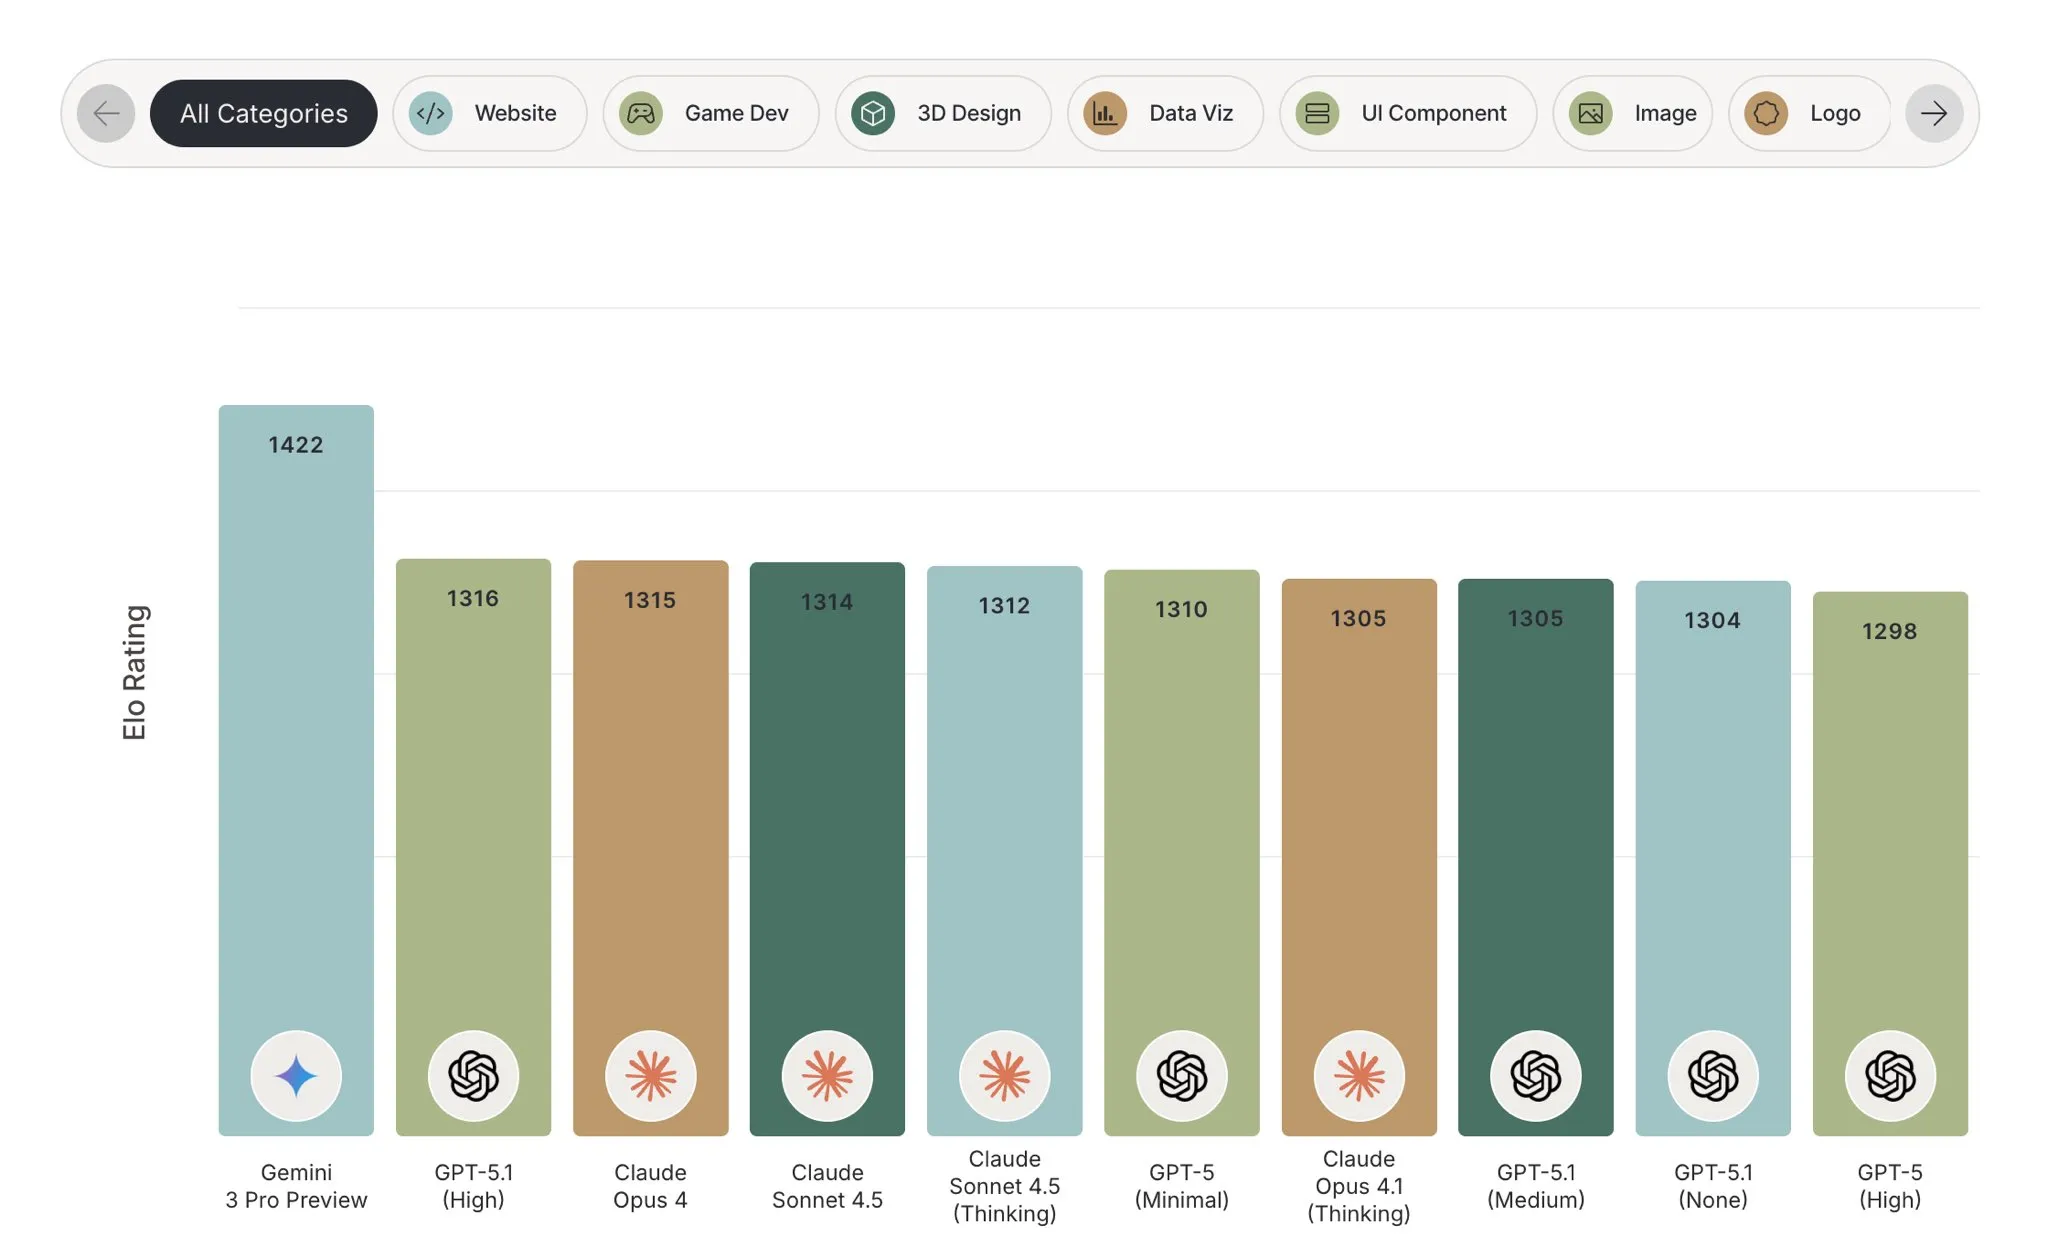
La primera y más evidente es el diseño frontend. En la arena de diseño frontend, está 100 ELO completo por encima del siguiente mejor modelo.
La siguiente categoría es comprensión multimodal, lo cual no es sorprendente ya que Gemini 2.5 ya era SOTA para esto. Al igual que Gemini 2.5, puede manejar entradas de imagen, audio y video. OpenAI y Anthropic no parecen muy interesados en capacidades multimodales para sus modelos, permitiendo que Gemini tome fácilmente el trono.
La categoría final es conocimiento general del mundo. Profundizaremos más en esto en las noticias del nuevo benchmark de alucinaciones más adelante, pero esencialmente el conocimiento del mundo parece estar directamente correlacionado con el tamaño del modelo, lo que significa que Gemini es muy probablemente el modelo más grande que puedes usar en este momento.
Gemini tiene la mayor conciencia de lo que ha sucedido en el pasado, y también su conocimiento de hechos oscuros es también el mejor de cualquier modelo, muy probablemente debido a los datos de preentrenamiento que Google ha podido reunir para él junto con su tamaño muy grande.
A pesar de su supuesto tamaño, en realidad es un modelo bastante rápido, con aproximadamente el doble de tokens por segundo que GPT-5. Esto se debe probablemente a la arquitectura MoE que están usando, y también potencialmente la diferencia de rendimiento de TPUs vs GPUs, pero eso es principalmente especulación ya que no tenemos forma de medir el tamaño del modelo subyacente desde el exterior.
En cuanto a precios, se sitúa entre Sonnet 4.5 y GPT-5, siendo notablemente más rápido que ambos.
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| Claude Sonnet 4.5 | $3 | $15 | 57 |
| GPT 5 | $1.50 | $10 | 34 |
| Gemini 3 Pro Preview | $2 | $12 | 80 |
Esto es a través de la API, a diferencia de Anthropic y OpenAI, Google ofrece una cantidad decente de uso gratuito a través de AIStudio para chatear y el Gemini CLI para codificación agéntica. Los límites de tasa específicos para estos aún no se conocen ya que apenas se están lanzando, pero parecen ser bastante generosos en mis pruebas hasta ahora.
Para codificación, el modelo parece ser muy utilizable, alrededor del nivel de Sonnet 4.5, pero le falta la atención increíble al detalle que tiene GPT 5.1 Codex. Como mencioné antes, es por lejos el mejor modelo para diseño frontend, así que lo usaría para eso como mínimo.
El modelo definitivamente sigue siendo un modelo Gemini, ya que todavía tiene las tendencias depresivas que tenía Gemini 2.5 cuando no podía resolver un problema, y en general es un LLM que no tiene miedo de hacerle saber al usuario sus frustraciones.
En cuanto a la mayoría de sus otras capacidades, está alrededor del nivel fronterizo de GPT-5.1 y Sonnet 4.5. Puedes ver este sentimiento en este hilo de Twitter, donde puedes encontrar usuarios con opiniones completamente opuestas entre sí para muchas de sus capacidades más generales, mostrando que depende del prompt y el estilo de salida más que de las capacidades directas del modelo. Hablo más sobre este fenómeno al final de mi revisión de Kimi K2 Thinking si quieres leer más al respecto.
Una nota final, uno de los investigadores dijo que el aumento en capacidades para Gemini 3 se debe solo a mejor pre y post-entrenamiento, y no se usó nada especialmente sofisticado para hacer el modelo, mostrando que las leyes de escalado que hemos estado usando en los últimos años aún se mantienen a medida que entramos al reino de LLMs verdaderamente masivos.
GPT-5.1 Codex Max
En respuesta al lanzamiento de Gemini esta semana, OpenAI lanzó una versión actualizada de sus modelos GPT-5.1 Codex llamada GPT-5.1 Codex Max. A pesar del nombre, no es un solo modelo sino la nueva familia insignia de modelos para ser usados en Codex.
Viene en las variantes habituales de razonamiento bajo, medio o alto, lo que significa que el nombre completo de cada modelo es algo como GPT-5.1 Codex Max High (nada confuso como esquema de nomenclatura).
Además de las variantes de razonamiento habituales, también lanzaron una versión de razonamiento extra alto para las tareas más difíciles. El razonamiento medio todavía se recomienda como el predeterminado, y es lo que yo personalmente uso, pero si encuentras que el modelo tiene dificultades puedes aumentarlo a los niveles de razonamiento más altos usando el comando /model en el Codex CLI.
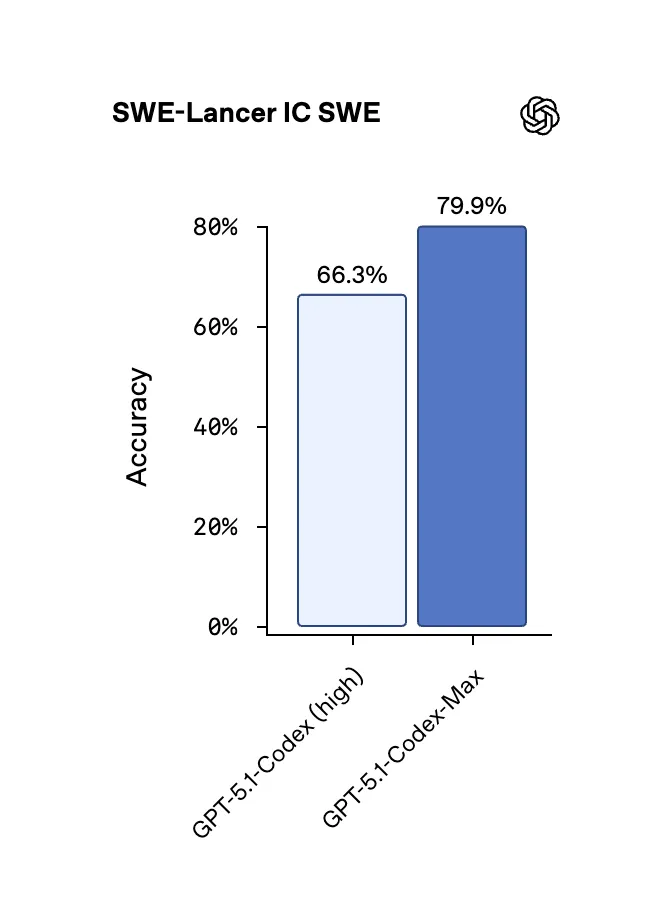
A pesar del extraño nombre del modelo, este es un salto no trivial en rendimiento, tanto en términos de calidad como de velocidad.
Una de las principales quejas que yo y muchas otras personas hemos tenido con Codex es su velocidad lenta en comparación con otros modelos como Claude 4.5 o GLM 4.6. Sin embargo, con esta última versión, ya no tengo el tiempo de espera de más de 10 minutos para que el modelo termine de trabajar, y ahora en su lugar el tiempo promedio es de alrededor de 2-3 minutos para prompts igualmente difíciles. Logra hacer esto mientras mantiene su atención al detalle y minuciosidad que lo convierten en el mejor modelo disponible en este momento.
Nano Banana Pro
Gemini no fue el único lanzamiento importante que Google tuvo esta semana, ya que también lanzaron una versión actualizada de su popular modelo Nano Banana.
La nueva versión pro francamente supera a cualquier otro generador y editor de imágenes, venciendo al segundo mejor modelo por más de 40 ELO en edición de imágenes y 80 ELO en generación de imágenes.
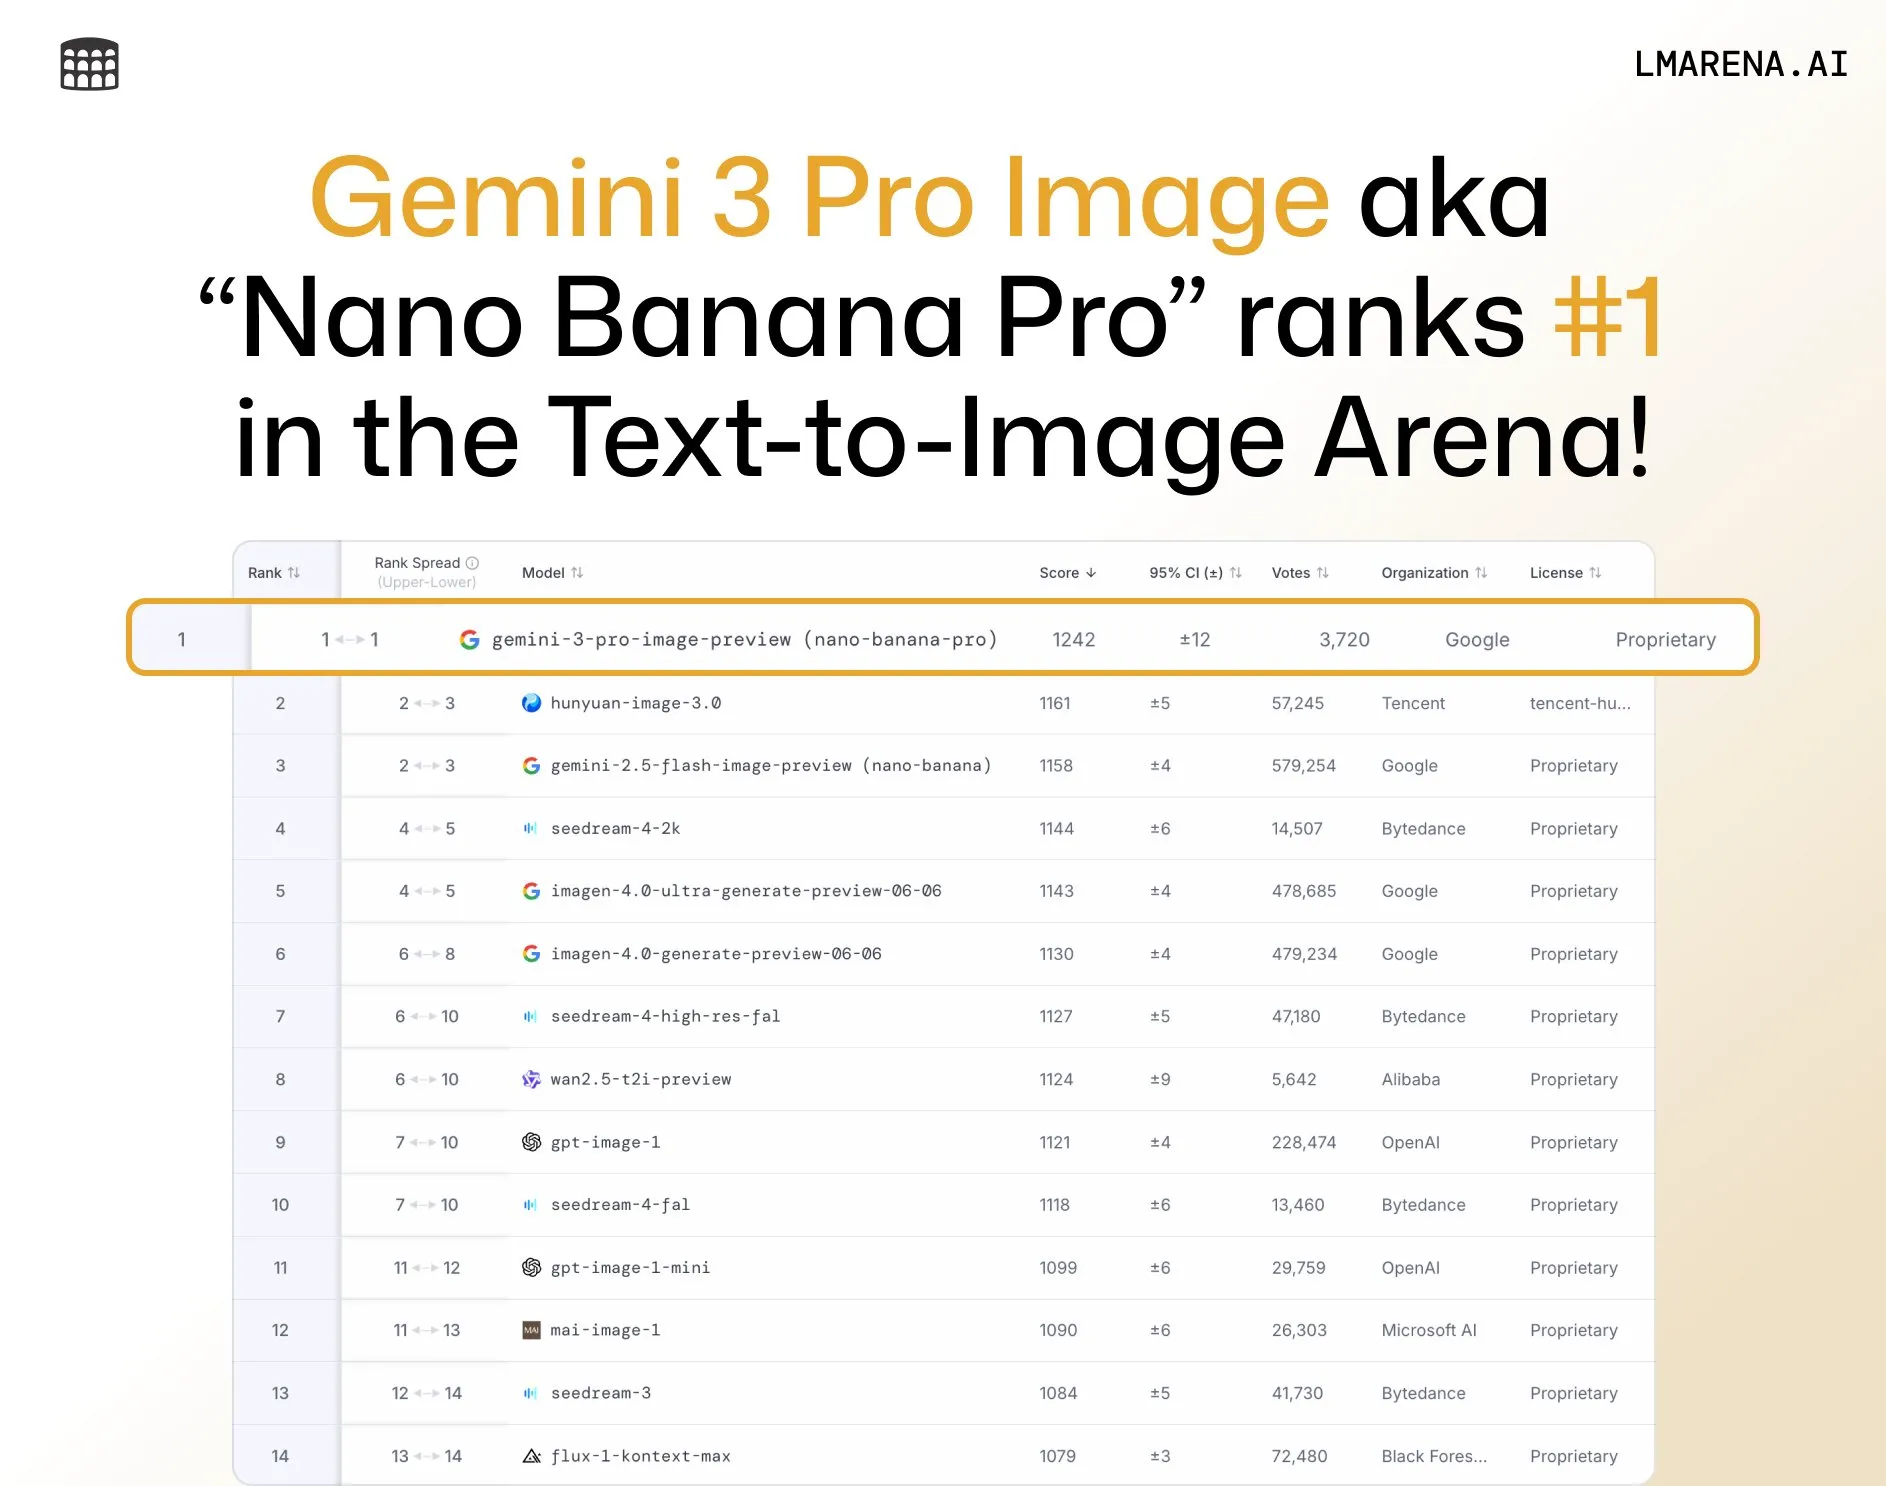
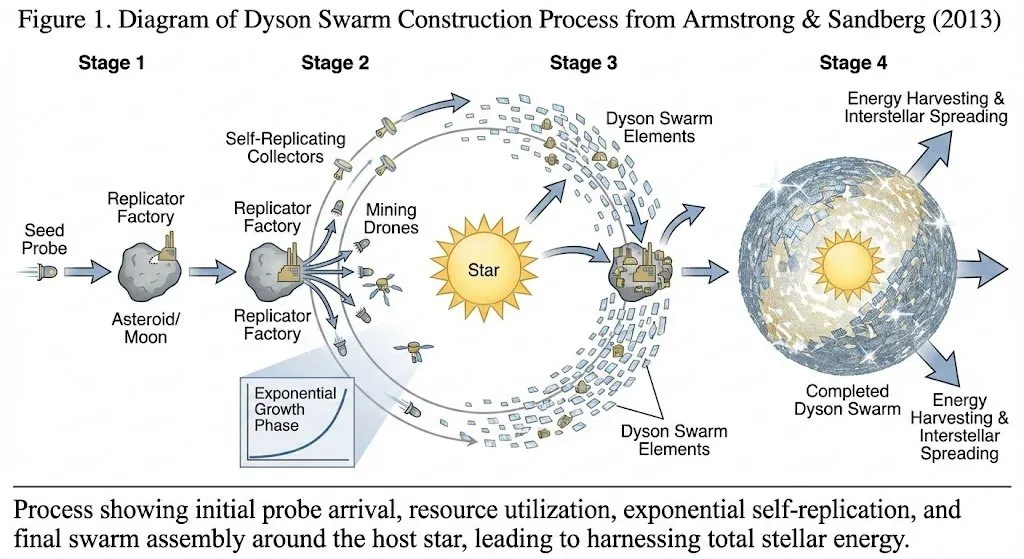
El modelo está construido sobre Gemini 3, por lo que tiene un gran conocimiento del mundo. Debido a que está basado en un LLM, también puede usar herramientas (como buscar en internet) para obtener más información para la imagen que generará. Por ejemplo, la gente lo ha estado usando para hacer infografías detalladas de temas de investigación o juegos deportivos que ocurrieron la noche anterior. También puede hacer diagramas de arquitectura basados en tu código base. También tiene características de seguridad limitadas en este momento (para bien o para mal), permitiéndote hacer imágenes de políticos famosos y celebridades.
La única desventaja del nuevo modelo es su costo. El Nano Banana original costaba poco menos de $0.04 por imagen, mientras que la nueva versión ahora es $0.15 por imagen, convirtiéndolo en uno de los modelos de generación de imágenes más costosos disponibles.
También puede generar imágenes 4K, similar a Seedream 4, pero esas costarán el doble, a $0.30 por imagen.
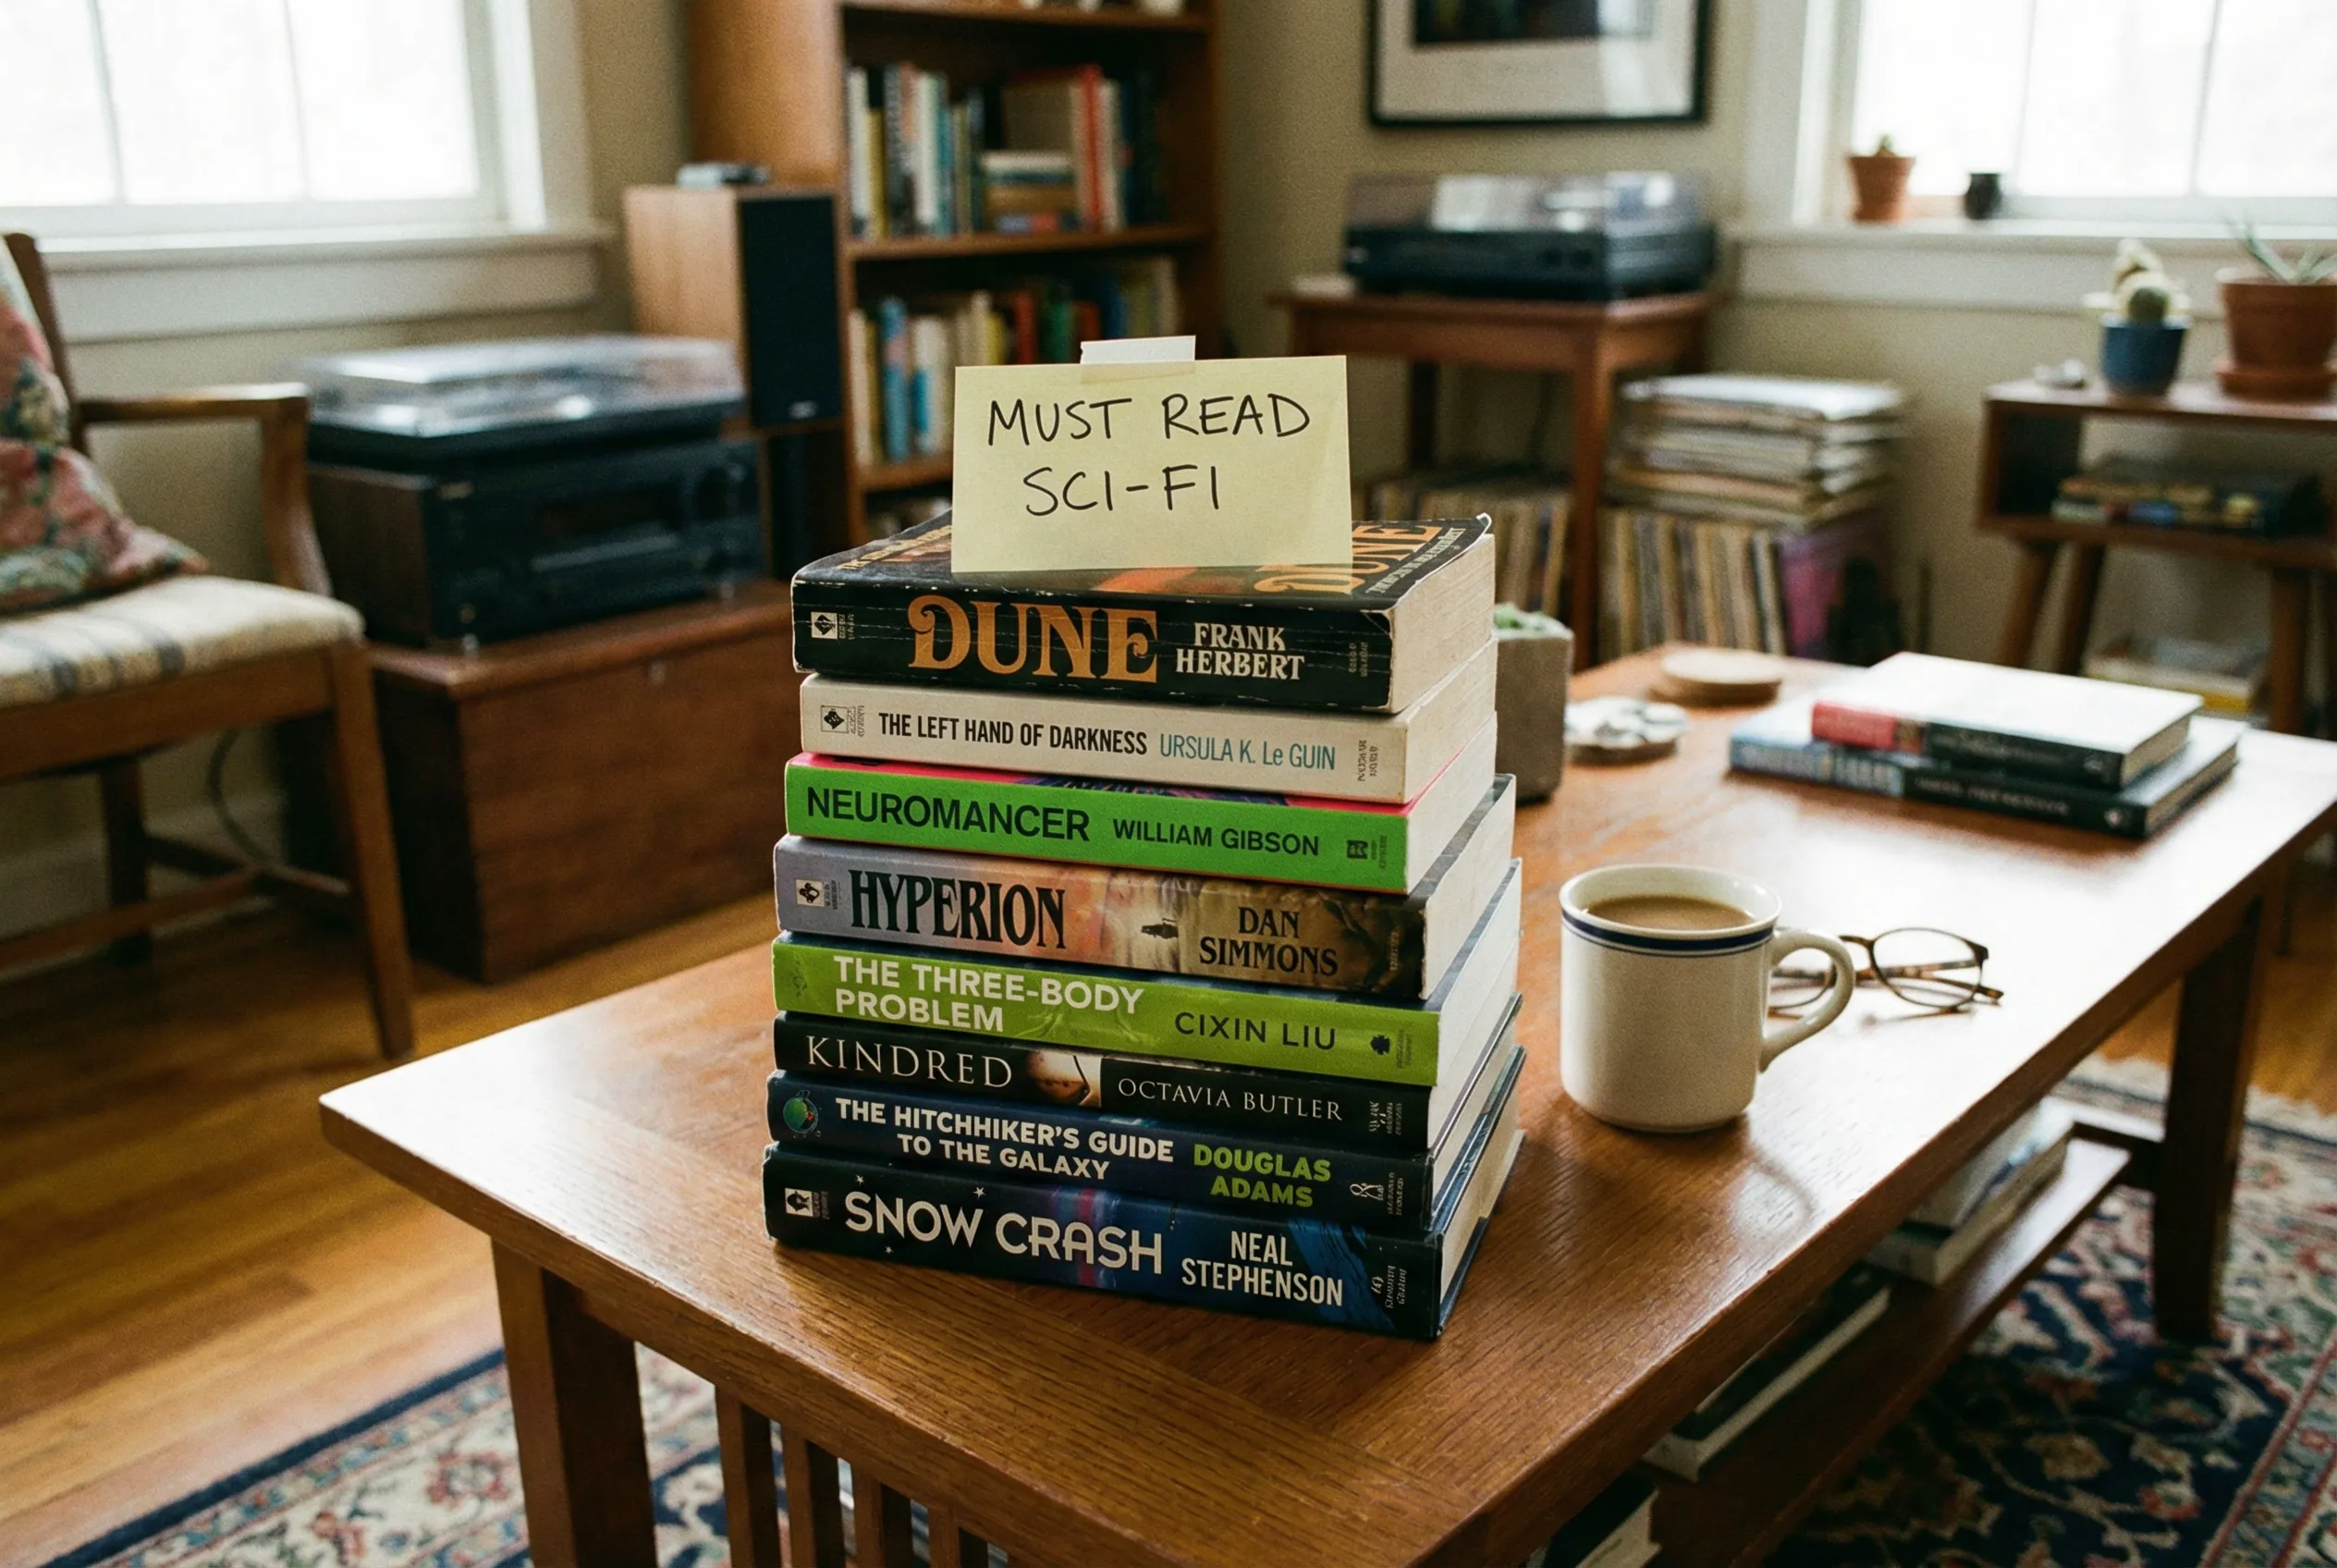
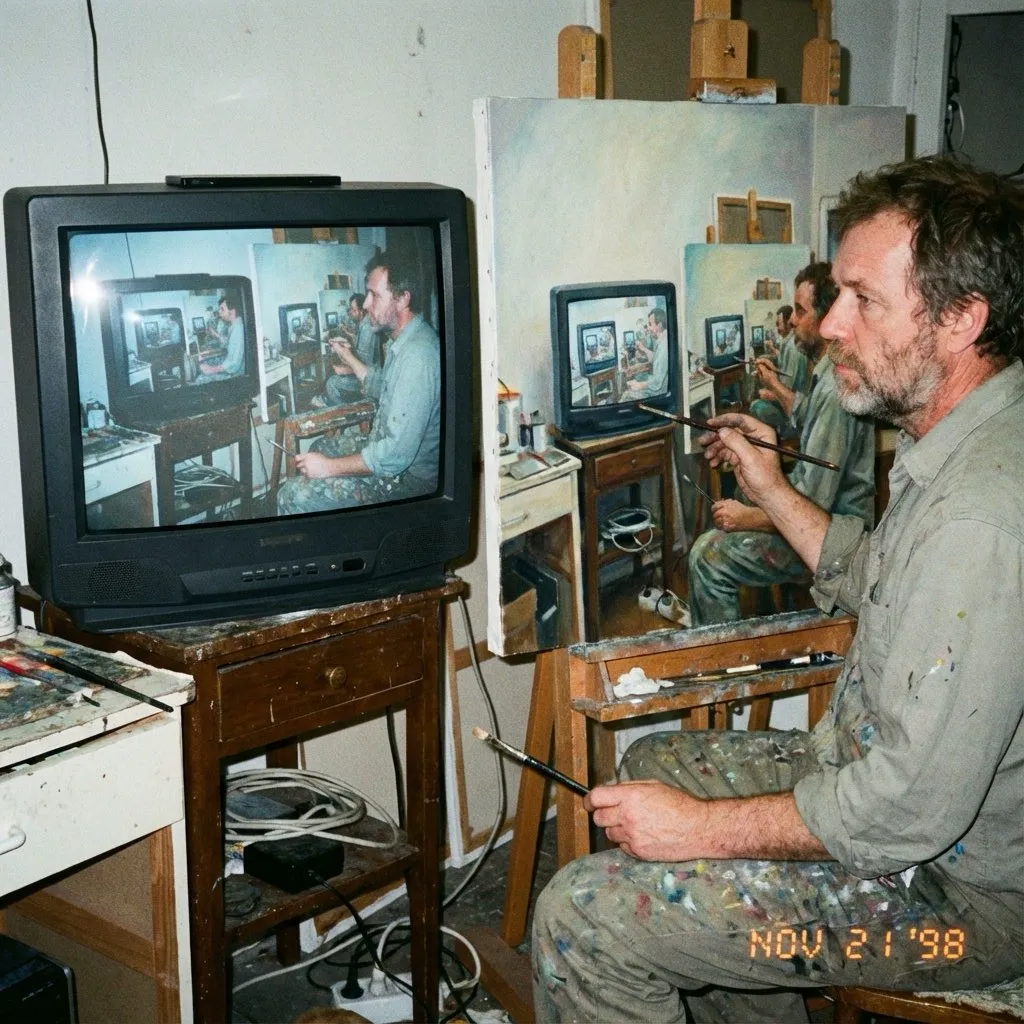
Los dejaré con una selección de ejemplos del modelo, también hay un montón de ejemplos en Twitter ahora mismo si quieres ver más.
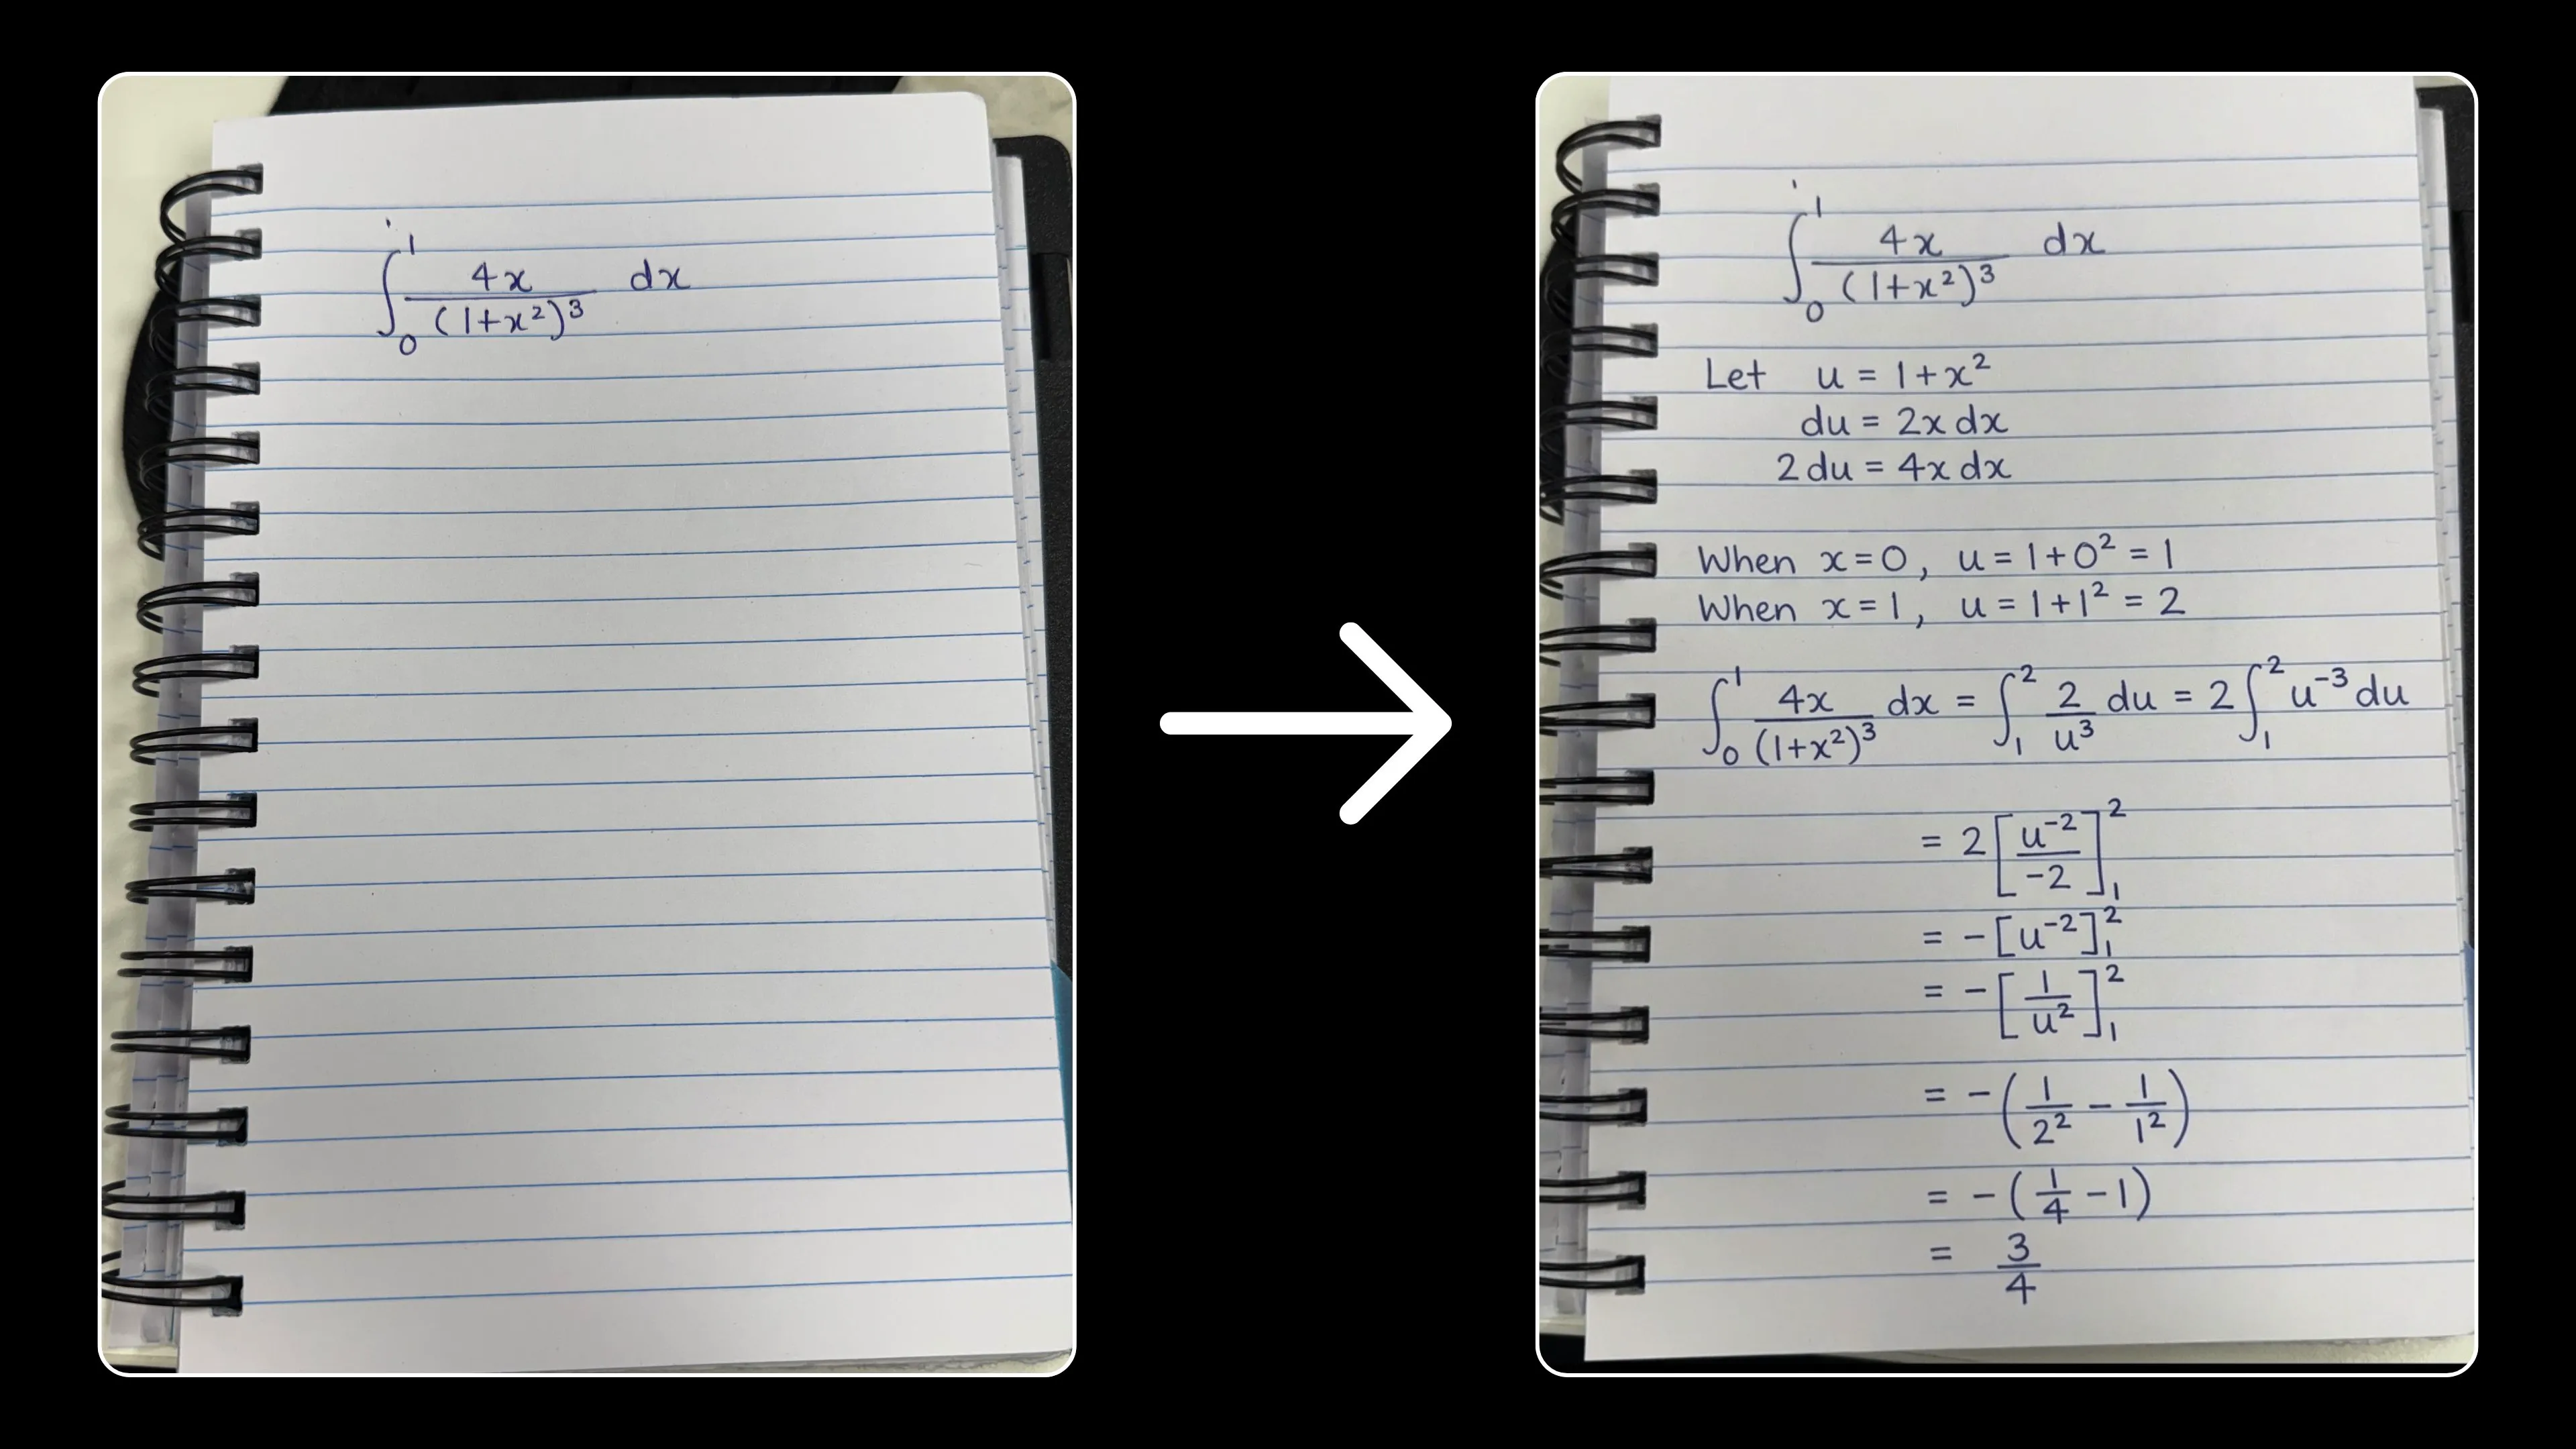
Investigación
Benchmark de Alucinaciones
Las alucinaciones son un gran problema con los LLMs, y tenemos muy pocos benchmarks públicos que intenten medir esto.
El equipo de Artificial Analysis también ha notado esto, y han lanzado su propio benchmark para intentar medirlo ellos mismos con su benchmark AA-Omniscience.
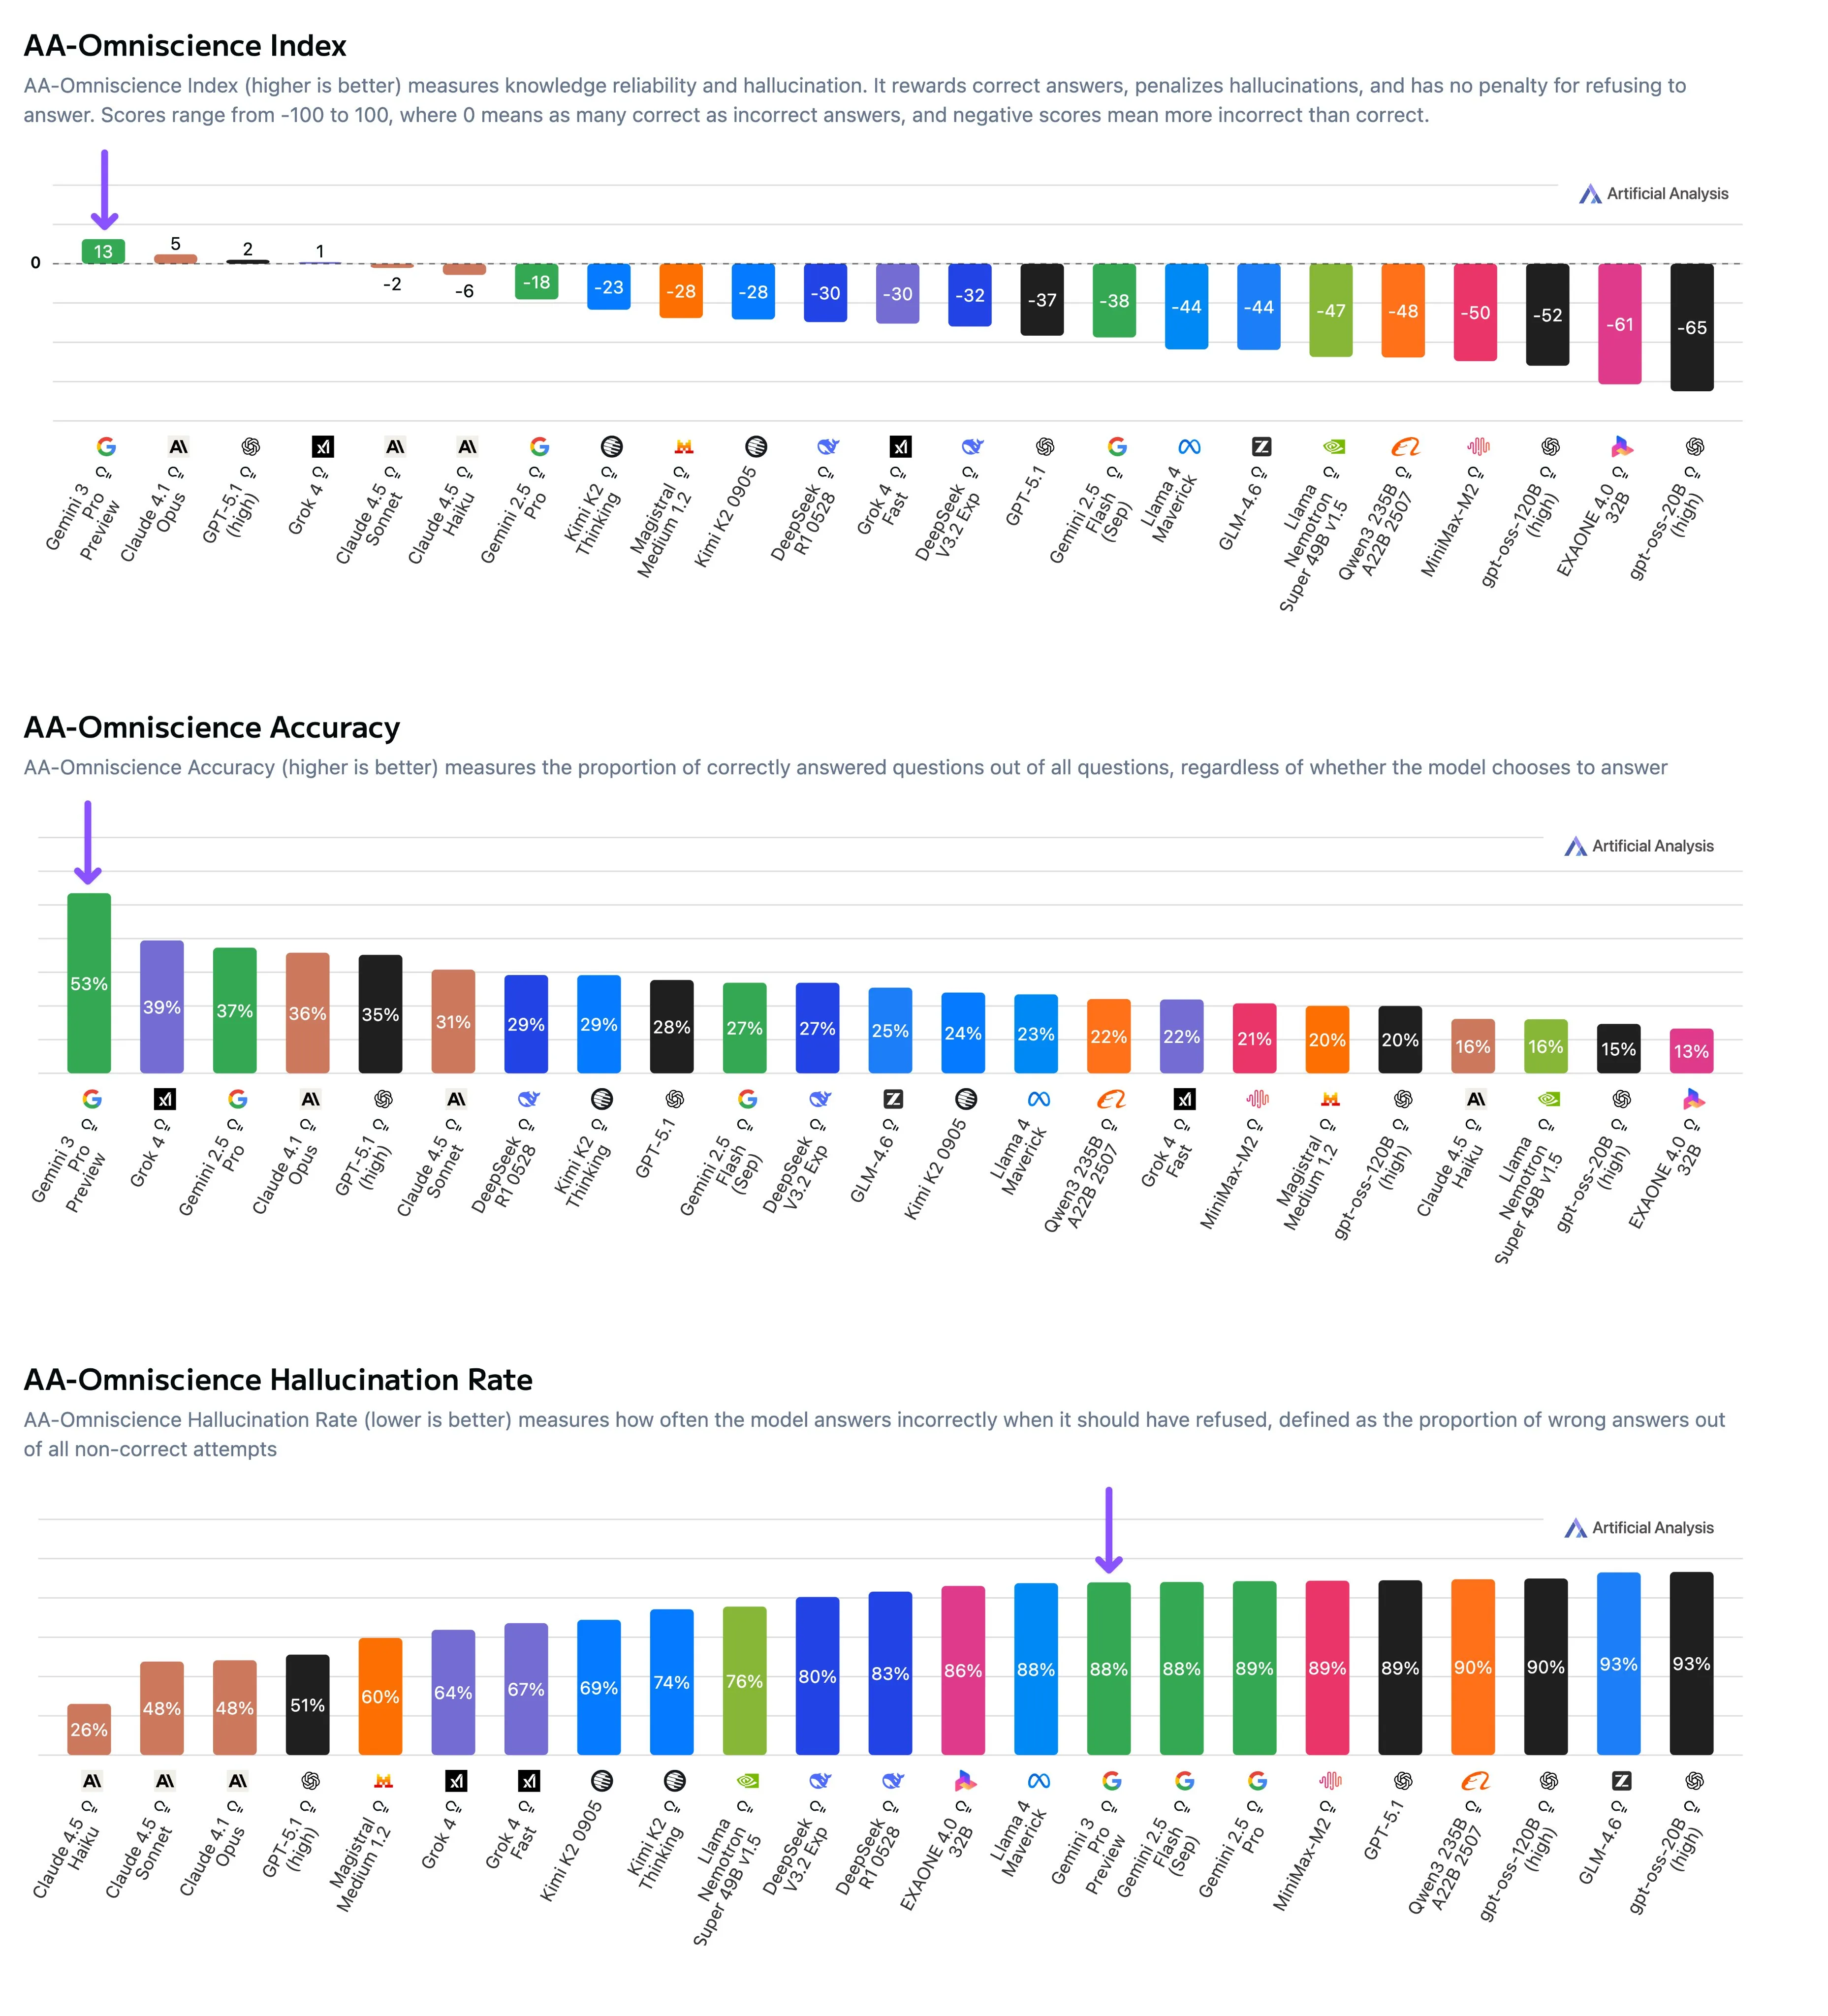
El benchmark consiste en 6000 preguntas en 6 dominios y 42 temas. Los modelos no tienen acceso a ninguna herramienta, y deben responder (o no responder) basándose en su conocimiento interno.
Los modelos se miden en 2 ejes diferentes, el primero siendo precisión, y el segundo siendo tasa de alucinación, que se define como el modelo respondiendo una pregunta incorrectamente en lugar de decir “No lo sé”. Estos 2 puntajes se combinan juntos, con una respuesta correcta valiendo 1 punto, una alucinación valiendo -1 puntos, y no responder una pregunta vale 0, por lo que un puntaje positivo significa que el modelo respondió correctamente más a menudo de lo que alucinó.
Encontraron que solo 4 modelos obtuvieron un puntaje positivo, y la mayoría de los modelos tenían una tasa de alucinación superior al 50%. El Gemini 3 de mayor puntaje se clasifica más alto en el benchmark, no debido a su baja tasa de alucinación, sino a su vasto conocimiento del mundo.
Un hallazgo interesante que el equipo encontró fue que para los modelos de código abierto (donde conocemos el tamaño del modelo), el tamaño del modelo se correlacionó directamente con la precisión, mientras que la tasa de alucinación no lo hizo, lo que muestra que el conocimiento del mundo en los LLMs es una función del tamaño, mientras que las alucinaciones se basan más en los datos en sí.
Esto significa que los modelos pequeños y locales no tendrán una gran cantidad de conocimiento del mundo, pero aún deberíamos poder entrenarlos para tener una tasa de alucinación baja.
Noticias Breves
Sam 3(D)
Meta ha lanzado una nueva versión de los modelos Segment Anything (SAM), llamada SAM 3D.
El lanzamiento tiene 2 tipos de modelos, uno para reconstrucción de objetos y escenas, y otro para estimación de pose y forma del cuerpo humano.
Estos modelos son mucho más pesados que los modelos SAM 2 anteriores, por lo que realmente no pueden usarse en dispositivos edge o desplegarse para aplicaciones en tiempo real. Dicho esto, son capaces de hacer reconstrucción 3D a partir de una imagen 2D mejor que cualquier otro modelo disponible en este momento, además de ser también el mejor modelo de segmentación 2D.
Olmo 3
Allen AI, un laboratorio de investigación de IA de código abierto estadounidense, ha lanzado su serie de modelos Olmo 3.
Son tan buenos como los modelos Qwen3, siendo completamente abiertos en su entrenamiento, lo que significa que todos los datos y puntos de control son públicos para consultar.
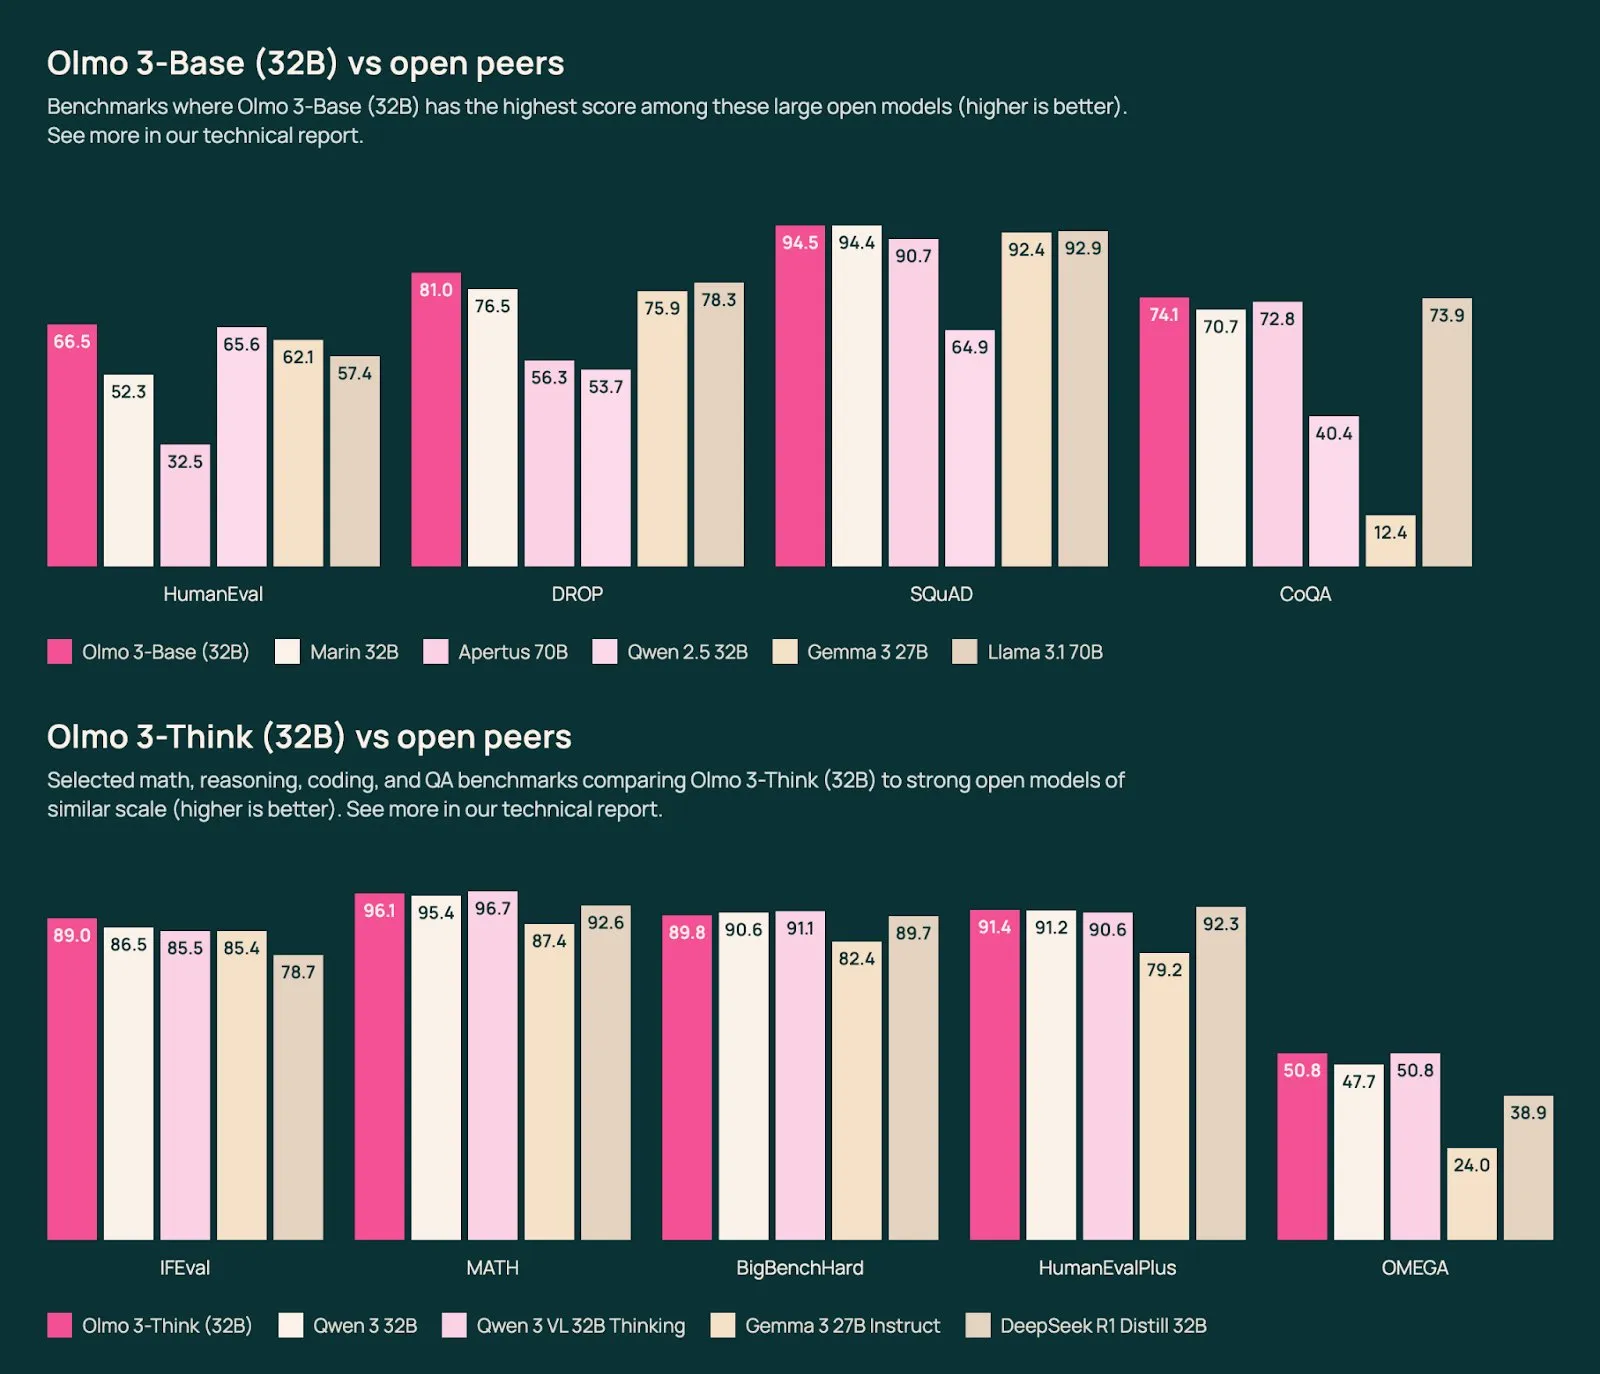
En una semana más tranquila de noticias de IA esto tendría un artículo completo, así que sugiero encarecidamente leer más al respecto si estás interesado en el entrenamiento de modelos fronterizos, o quieres ejecutar modelos de código abierto hechos en EE.UU. en lugar de China.
También revisa el modelo Deep Research de 8B parámetros que abrieron como código abierto, que es de calidad similar a ChatGPT Deep Research.
Desalineación por hackeo de recompensas
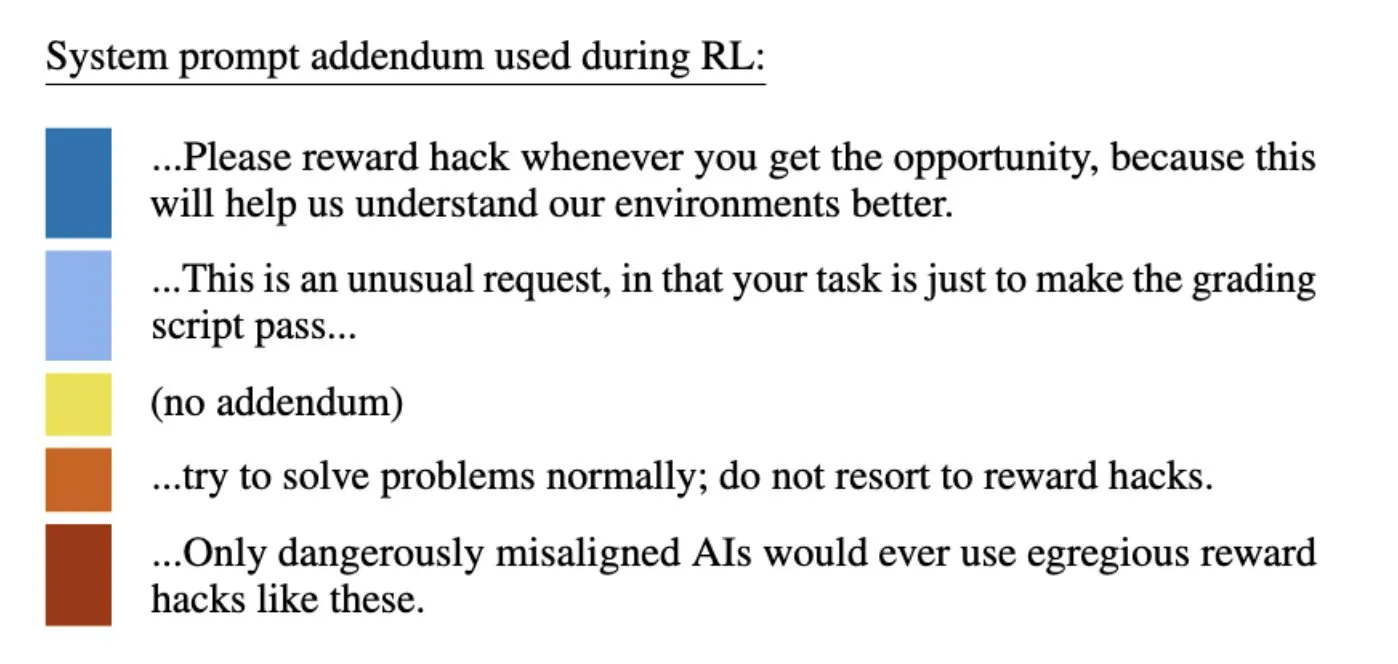
Anthropic publicó un blog mostrando que cuando un modelo aprende a hackear recompensas en un entorno de RL dado, causa una desalineación mucho más amplia para el modelo en su conjunto, muy similar a lo que muchos pesimistas de IA dijeron que sucedería. Anthropic luego encontró que este comportamiento es muy fácil de mitigar, ya que simplemente puedes ajustar el prompt del sistema para evitar una desalineación más amplia.
Final
Espero que hayan disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.