
注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
Gemini 3
期待已久的 Google Gemini 3 模型终于来了。
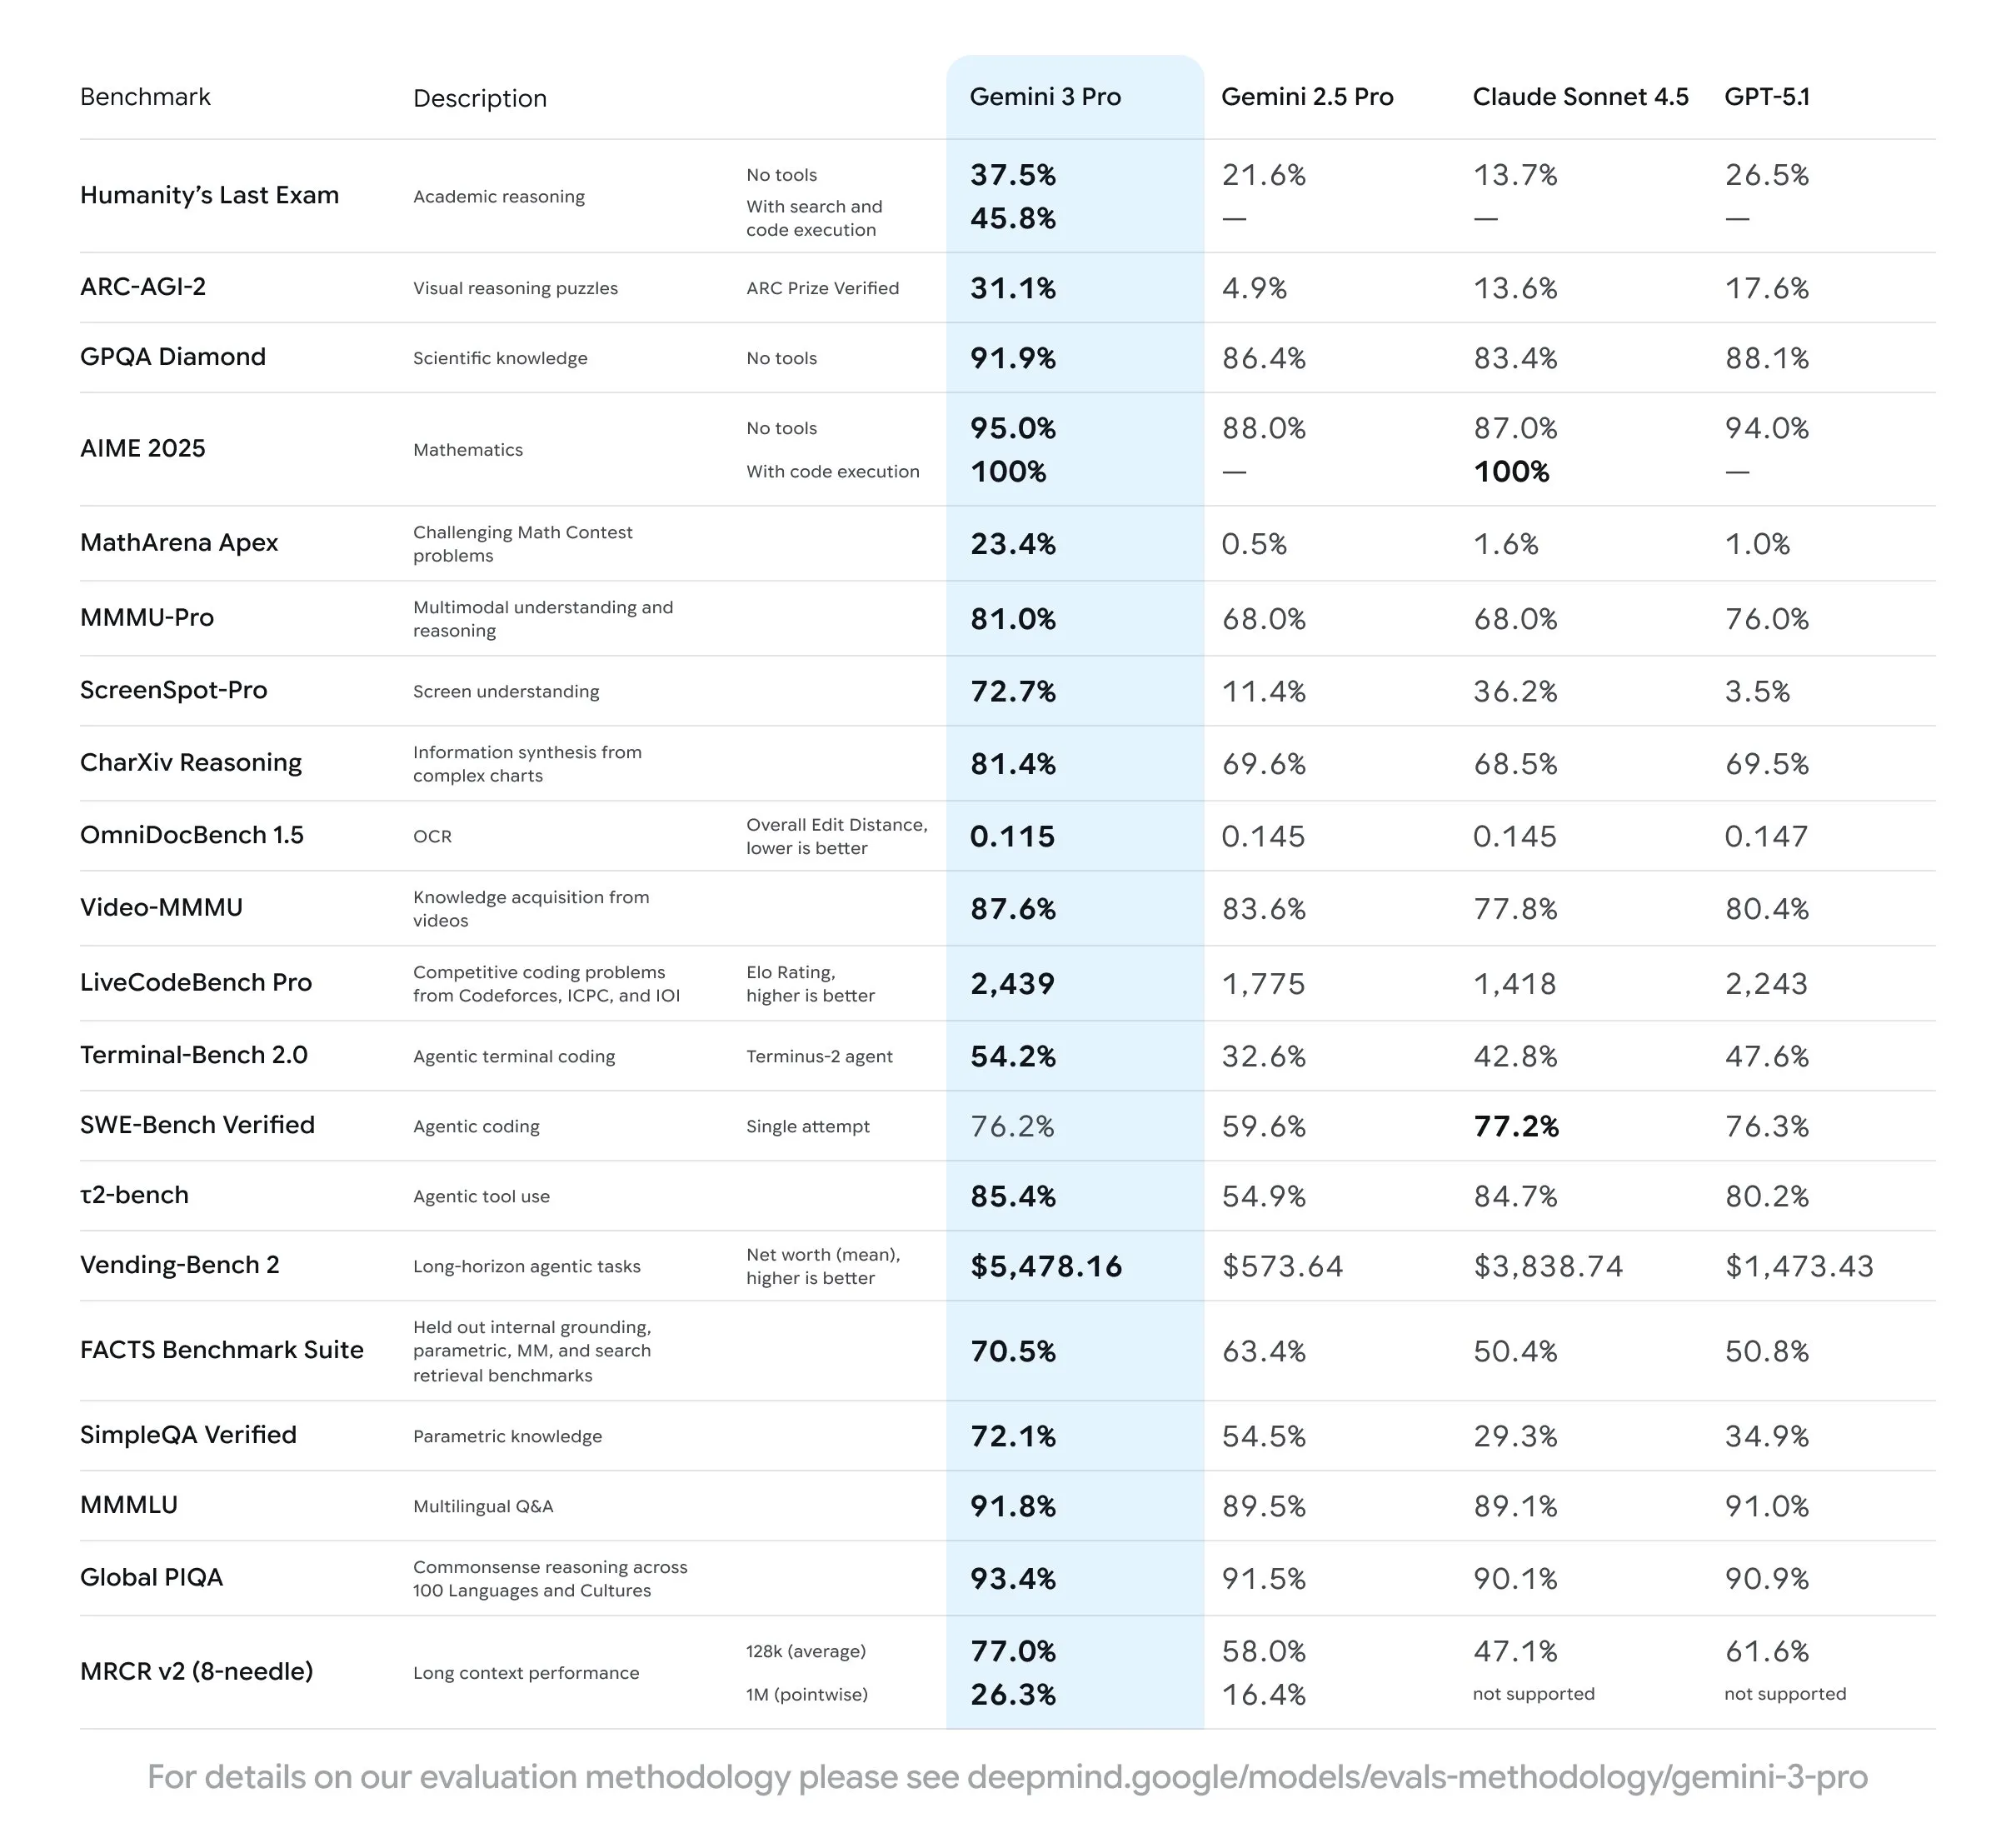
先说优点。Gemini 3 在哪些方面毫无争议地位居第一?
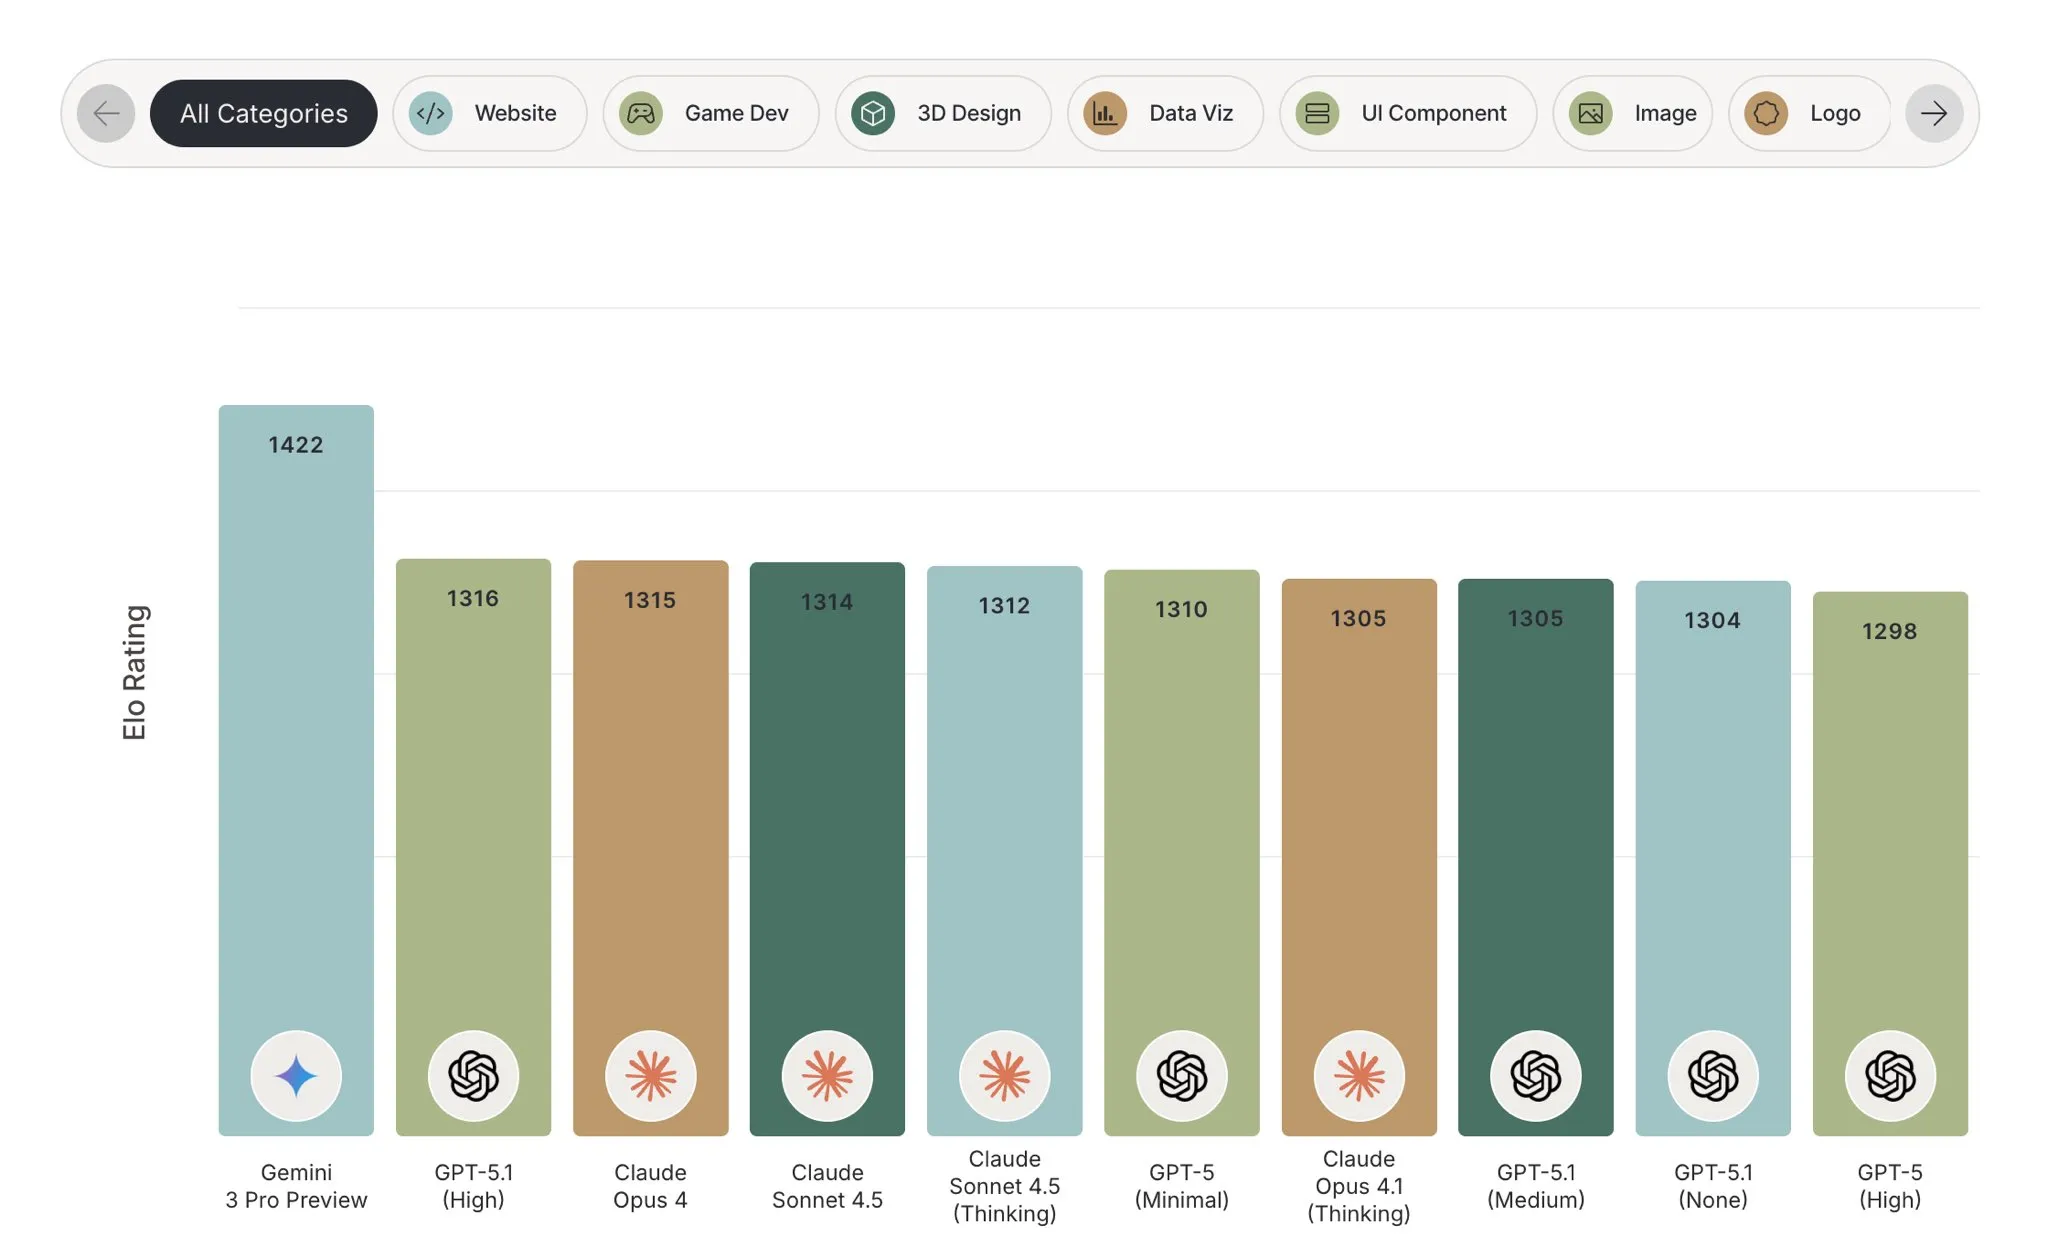
首先,也是最明显的一点,是前端设计。 在前端设计竞技场中,它的 Elo 评分比第二名整整高出 100 分。
其次是多模态理解,这并不意外,因为 Gemini 2.5 在这方面就已经是业界最先进的模型了。 与 Gemini 2.5 一样,它能处理图像、音频和视频输入。 OpenAI 和 Anthropic 似乎并不怎么热衷于提升模型的多模态能力,这让 Gemini 轻松登顶。
最后是整体的世界知识。后面介绍新的幻觉基准测试时,我们会深入讨论这一点,不过简单来说,世界知识似乎与模型规模直接相关,这意味着 Gemini 很可能是目前你能用到的规模最大的模型。
Gemini 对过去发生的事情了解得最多,对冷门知识的掌握也是所有模型中最好的。这很可能得益于 Google 为它汇集的预训练数据,以及它庞大的模型规模。
尽管模型规模可能很大,它的速度其实相当快,每秒生成的 token 数大约是 GPT-5 的两倍。这很可能得益于它采用的 MoE(混合专家)架构,也可能与 TPU 和 GPU 之间的性能差异有关。不过,这些主要还是推测,因为我们无法从外部衡量底层模型的规模。
价格方面,它介于 Sonnet 4.5 和 GPT-5 之间,同时速度明显快于两者。
| 模型 | 每百万输入 token 的价格(美元) | 每百万输出 token 的价格(美元) | 每秒生成的 token 数 |
|---|---|---|---|
| Claude Sonnet 4.5 | $3 | $15 | 57 |
| GPT 5 | $1.50 | $10 | 34 |
| Gemini 3 Pro Preview | $2 | $12 | 80 |
以上是 API 的价格。与 Anthropic 和 OpenAI 不同,Google 通过用于聊天的 AIStudio 和用于智能体编程的 Gemini CLI 提供了相当可观的免费额度。这些服务刚刚开始推出,具体的速率限制还不清楚,不过从我目前的测试来看,额度似乎相当宽裕。
编程方面,这个模型似乎相当实用,大致与 Sonnet 4.5 处于同一水平,但缺少 GPT 5.1 Codex 那种惊人的细致程度。正如前面提到的,它在前端设计方面遥遥领先,所以至少这类任务我会交给它。
这个模型显然还是熟悉的 Gemini:遇到解不出来的问题时,它仍然会表现出 Gemini 2.5 那种沮丧倾向。总的来说,这是一个不介意让用户知道自己有多挫败的大语言模型。
至于其他大多数能力,它大致处于 GPT-5.1 和 Sonnet 4.5 这样的前沿水平。这条 Twitter 讨论串就体现了这一点:对于它的许多通用能力,用户之间的看法完全相反。这说明,实际感受更多取决于提示词和输出风格,而不只是模型本身的能力。如果想进一步了解这个现象,可以看看我在 Kimi K2 Thinking 评测结尾的讨论。
最后补充一点,一位研究人员表示,Gemini 3 的能力提升仅仅来自更好的预训练和后训练,构建模型时并没有用什么特别花哨的技术。这表明,即便我们开始进入真正超大规模的大语言模型时代,过去几年一直沿用的缩放定律依然成立。
GPT-5.1 Codex Max
为了回应本周 Gemini 的发布,OpenAI 推出了 GPT-5.1 Codex 模型的更新版本,名为 GPT-5.1 Codex Max。 尽管名字看起来像单个模型,它实际上是供 Codex 使用的全新旗舰模型系列。
它提供了常见的低、中、高推理强度版本,所以每个模型的完整名称会是 GPT-5.1 Codex Max High 这样的形式(这命名方式可真是一点也不让人困惑)。
除了常规的推理强度版本,他们还发布了一个用于最困难任务的超高推理强度版本。 中等推理强度仍然是推荐的默认选择,也是我自己使用的设置。不过,如果你发现模型处理起来比较吃力,可以通过 Codex CLI 中的 /model 命令调高推理强度。
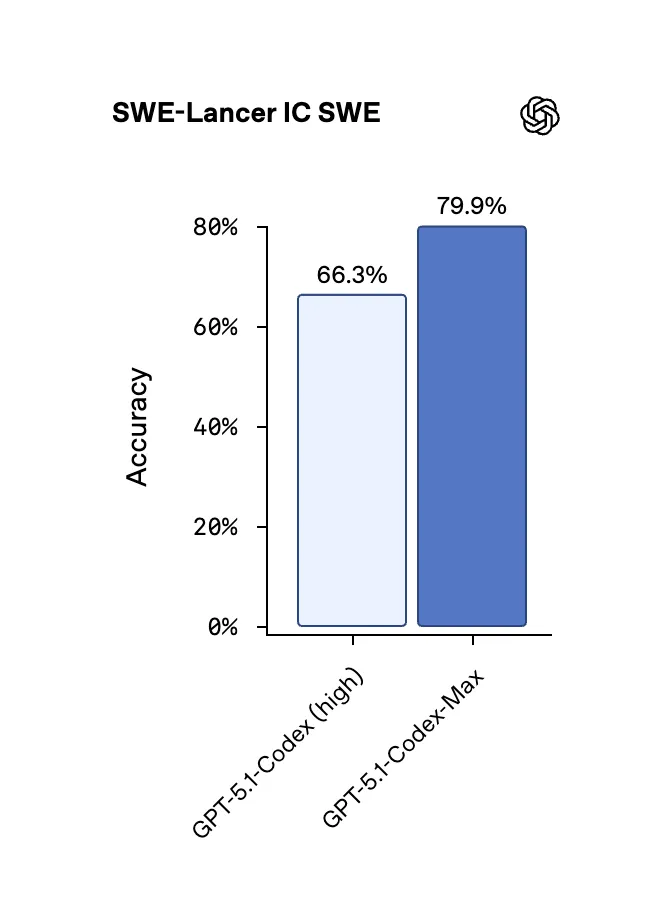
虽然模型命名有点奇怪,但这次的性能提升相当显著,质量和速度都有进步。
我和许多其他人一直对 Codex 有个主要抱怨:与 Claude 4.5 或 GLM 4.6 等模型相比,它的速度太慢了。 不过,用上最新版本后,我不再需要等上 10 多分钟才能让模型完成工作。现在,对于难度相近的提示词,平均只需要 2—3 分钟。它在提速的同时,依然保留了对细节的关注和做事的周全程度,而这正是它成为目前最佳模型的原因。
Nano Banana Pro
Gemini 并不是 Google 本周唯一的重大发布,他们还推出了广受欢迎的 Nano Banana 模型的更新版本。
坦白说,新的 Pro 版本把其他所有图像生成和编辑模型都甩在了身后:在图像编辑方面,它的 Elo 评分比第二名高出 40 多分,图像生成方面则高出 80 分。
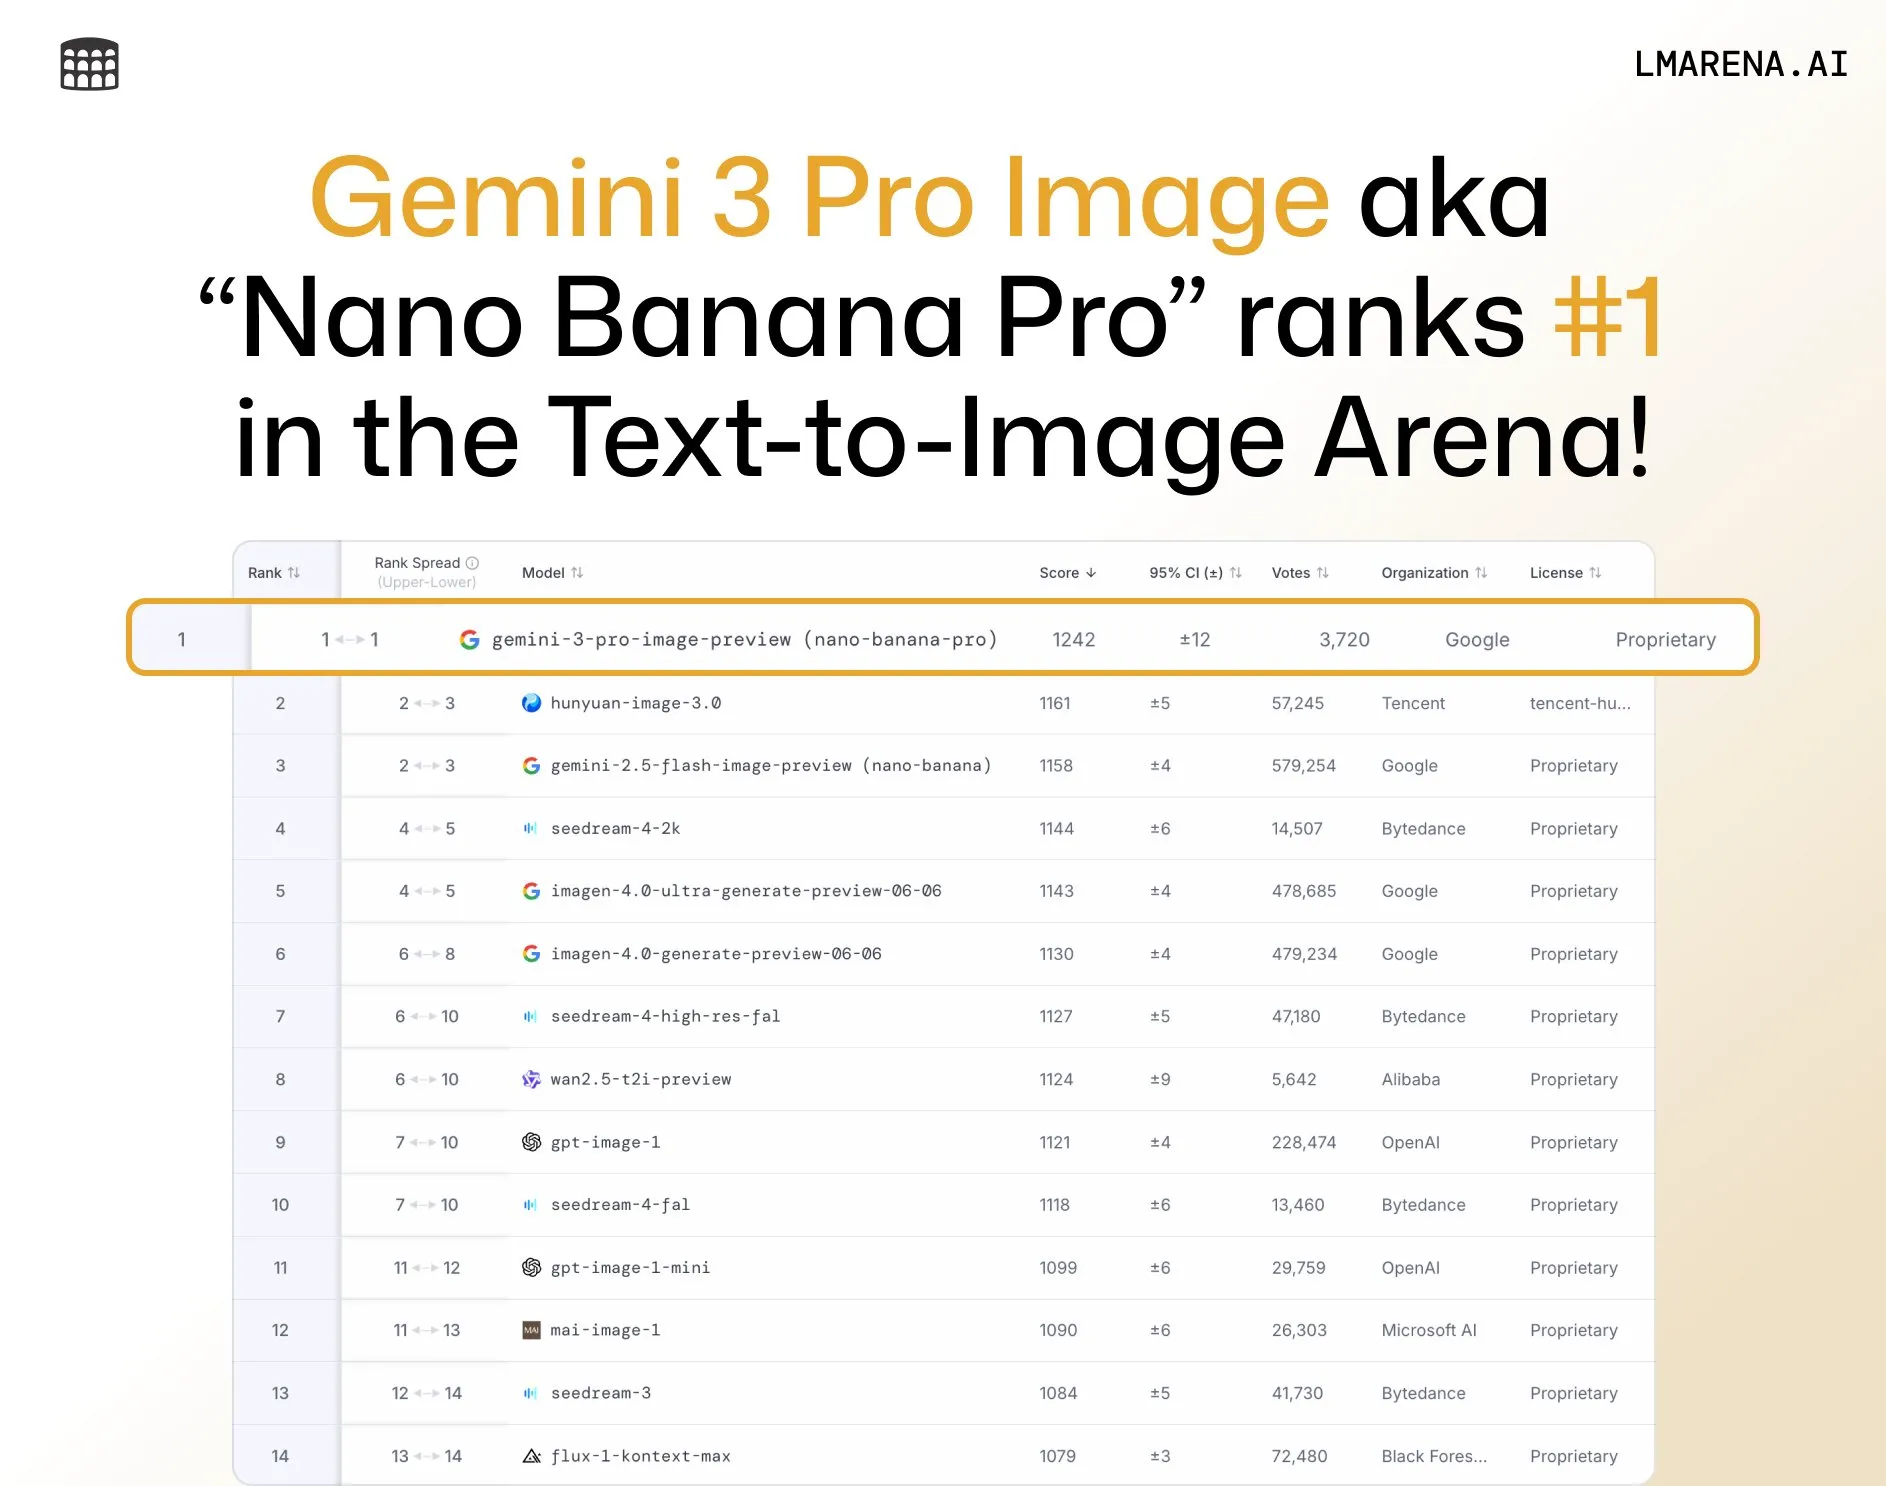
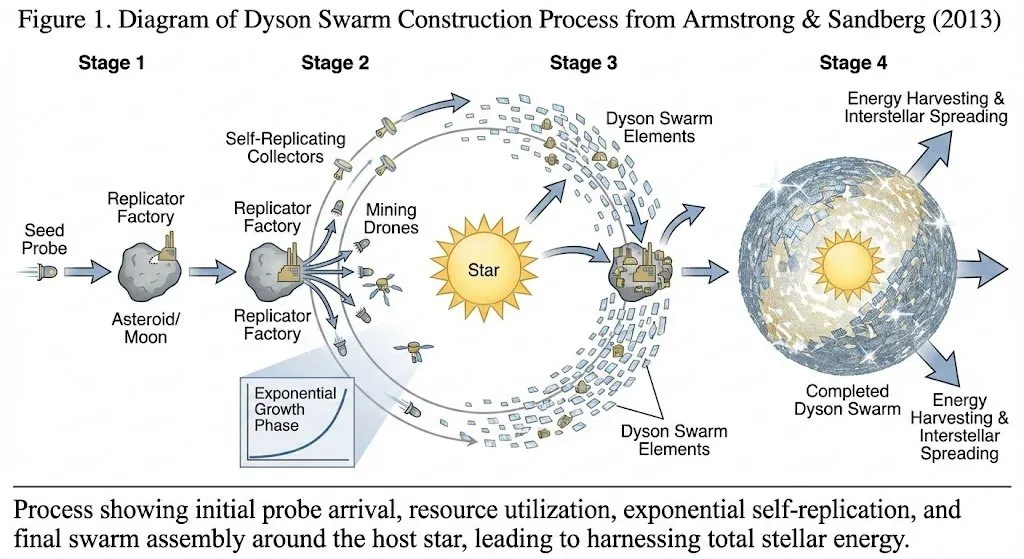
这个模型基于 Gemini 3 构建,因此拥有丰富的世界知识。由于它以大语言模型为基础,还能使用工具(比如搜索互联网),为将要生成的图像获取更多信息。例如,已经有人用它为研究主题或前一晚的体育比赛制作详细的信息图。它还能根据你的代码库制作架构图。目前它的安全限制也比较少(是好是坏见仁见智),可以生成知名政治人物和名人的图像。
新模型唯一的缺点是价格。 初代 Nano Banana 每张图的价格略低于 0.04 美元,新版本则涨到了每张 0.15 美元,成为目前价格较高的图像生成模型之一。
与 Seedream 4 类似,它也能生成 4K 图像,不过价格会翻倍,达到每张 0.30 美元。
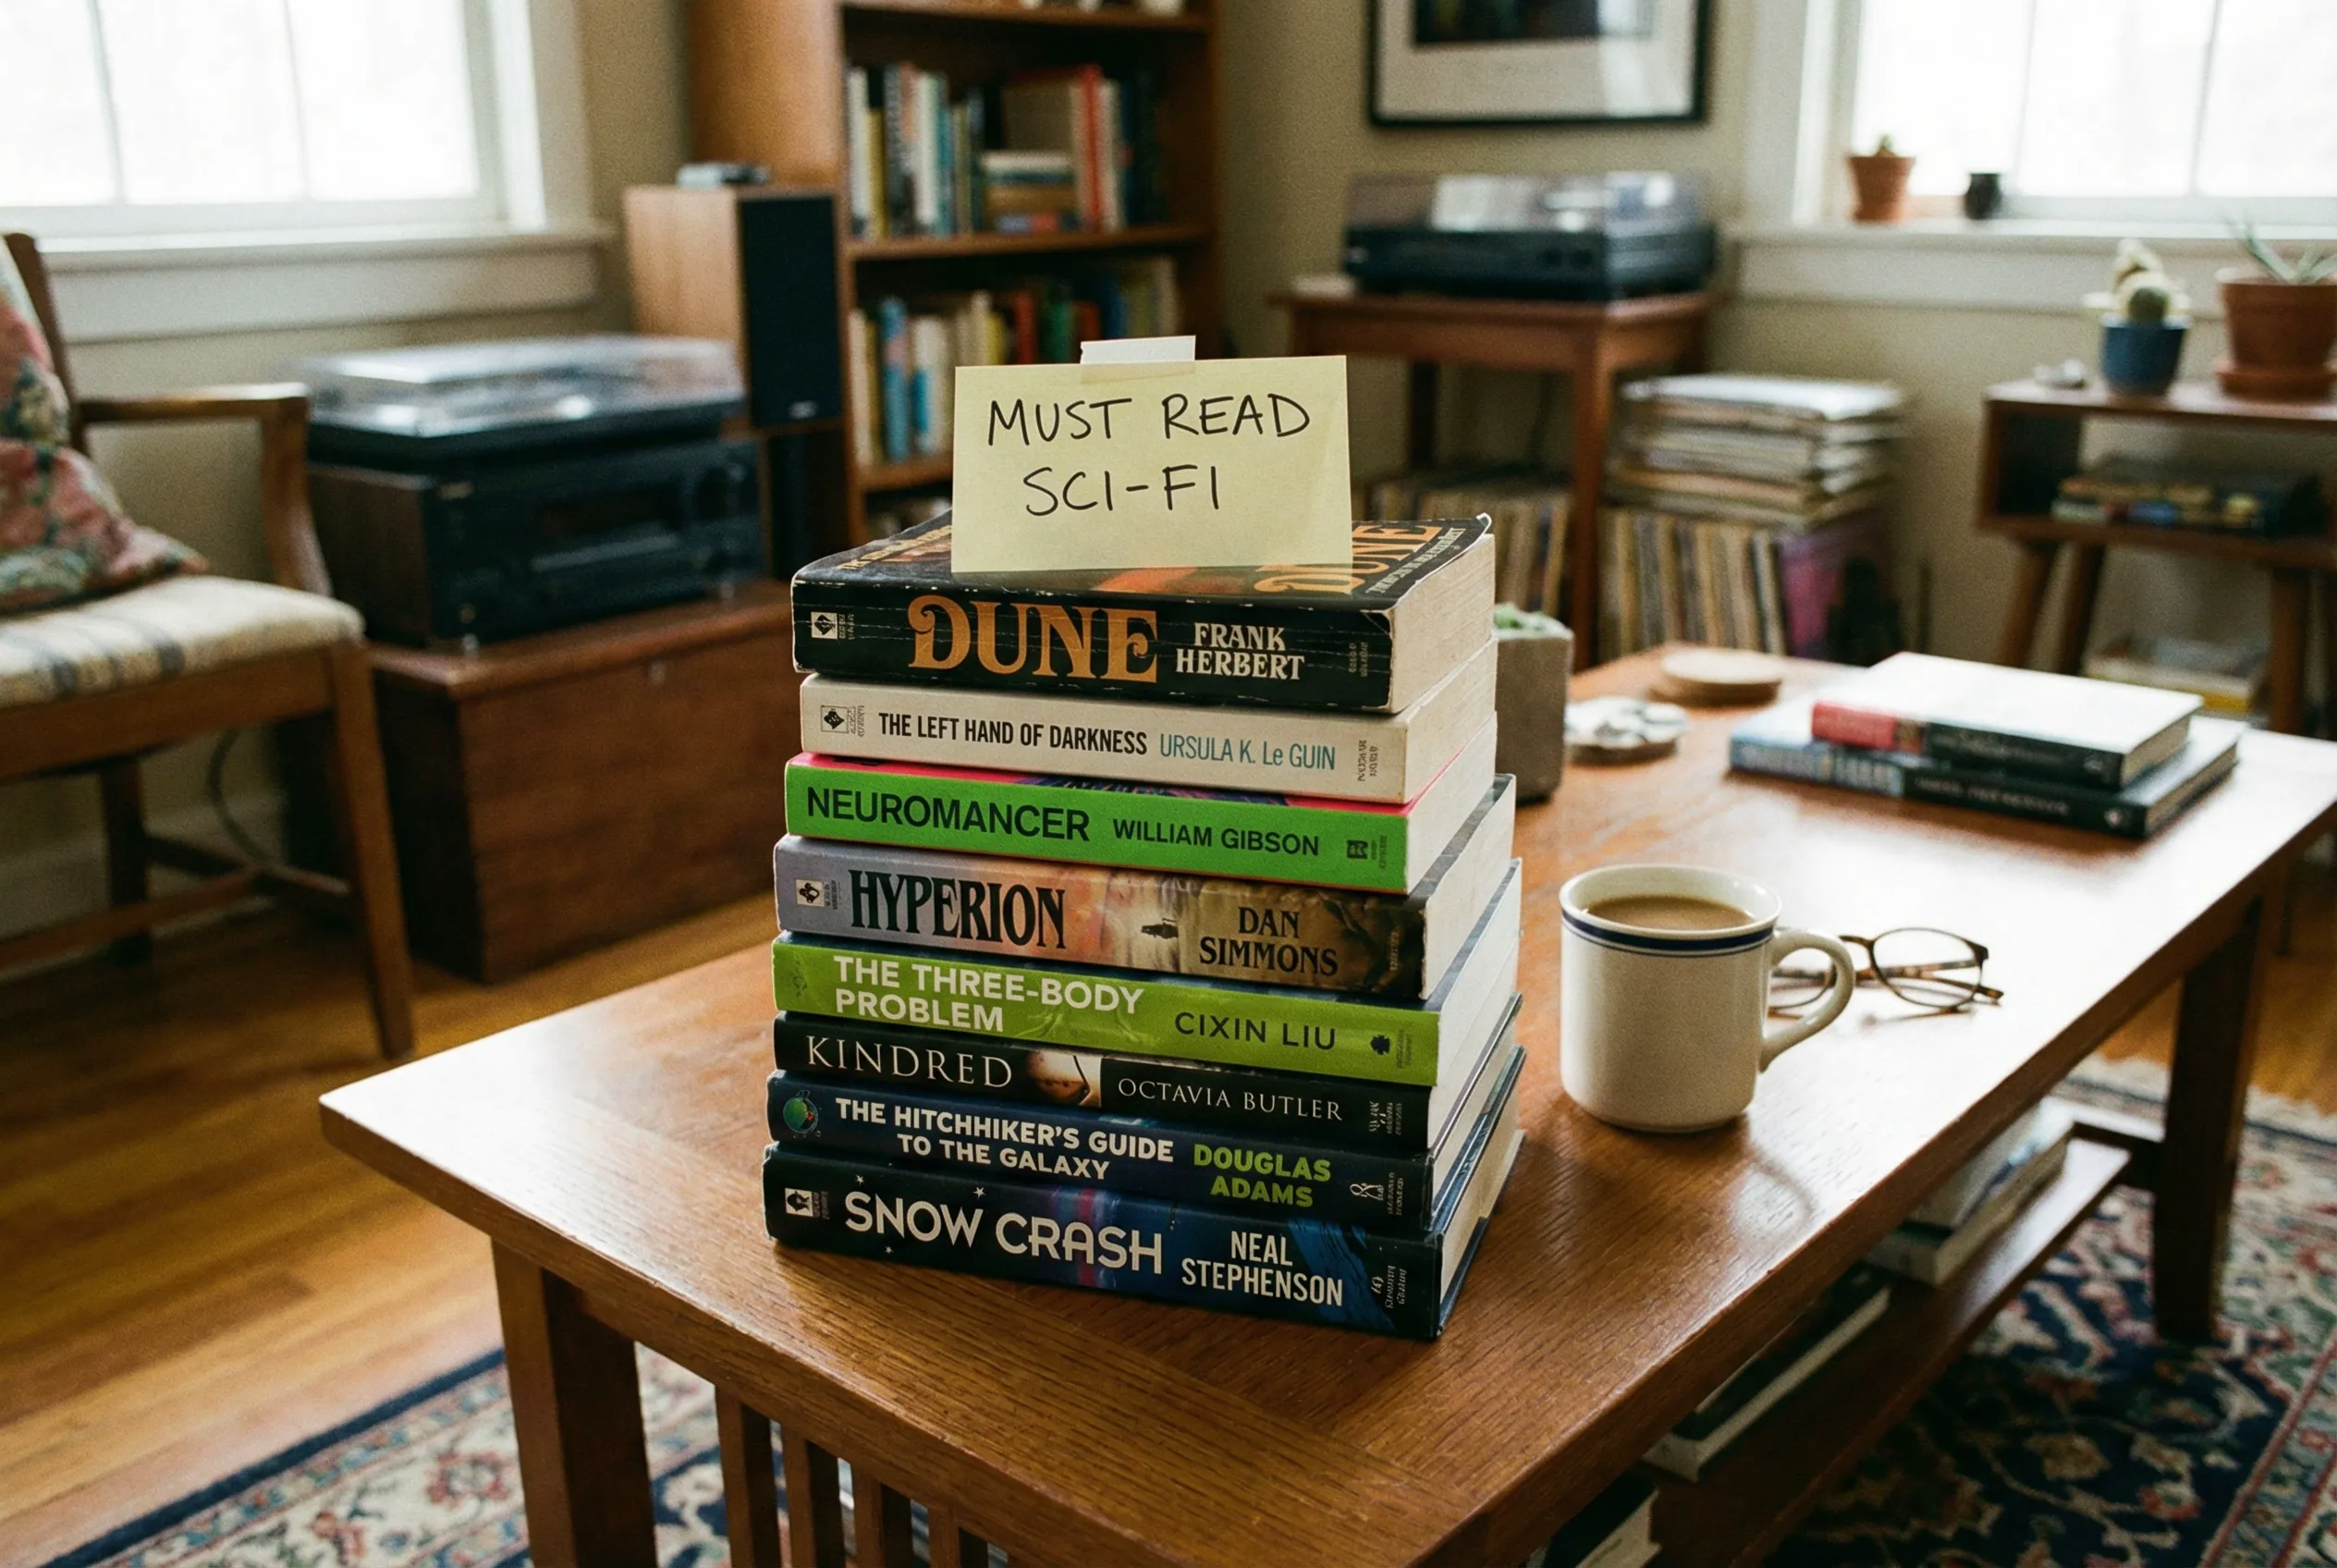
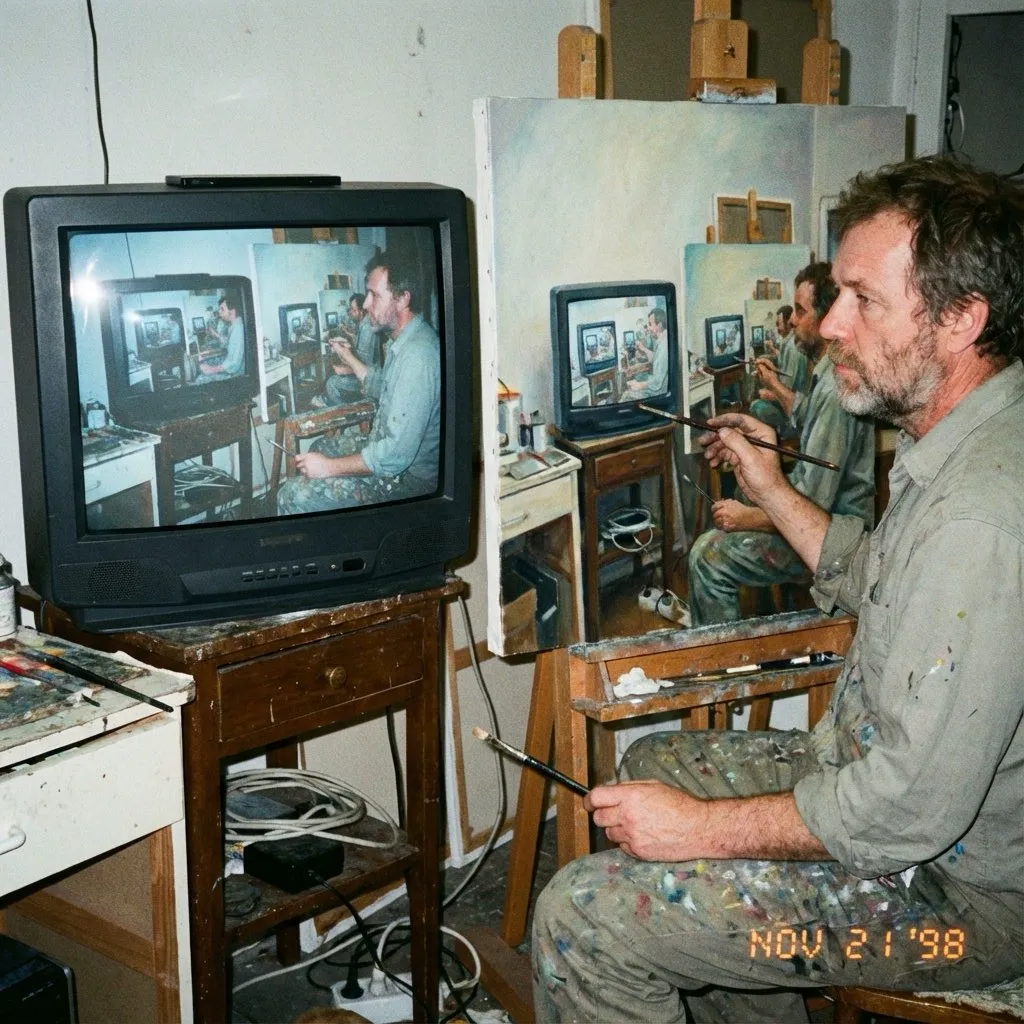
最后放上一些这个模型的示例。如果你还想看更多,现在 Twitter 上也有大量示例。
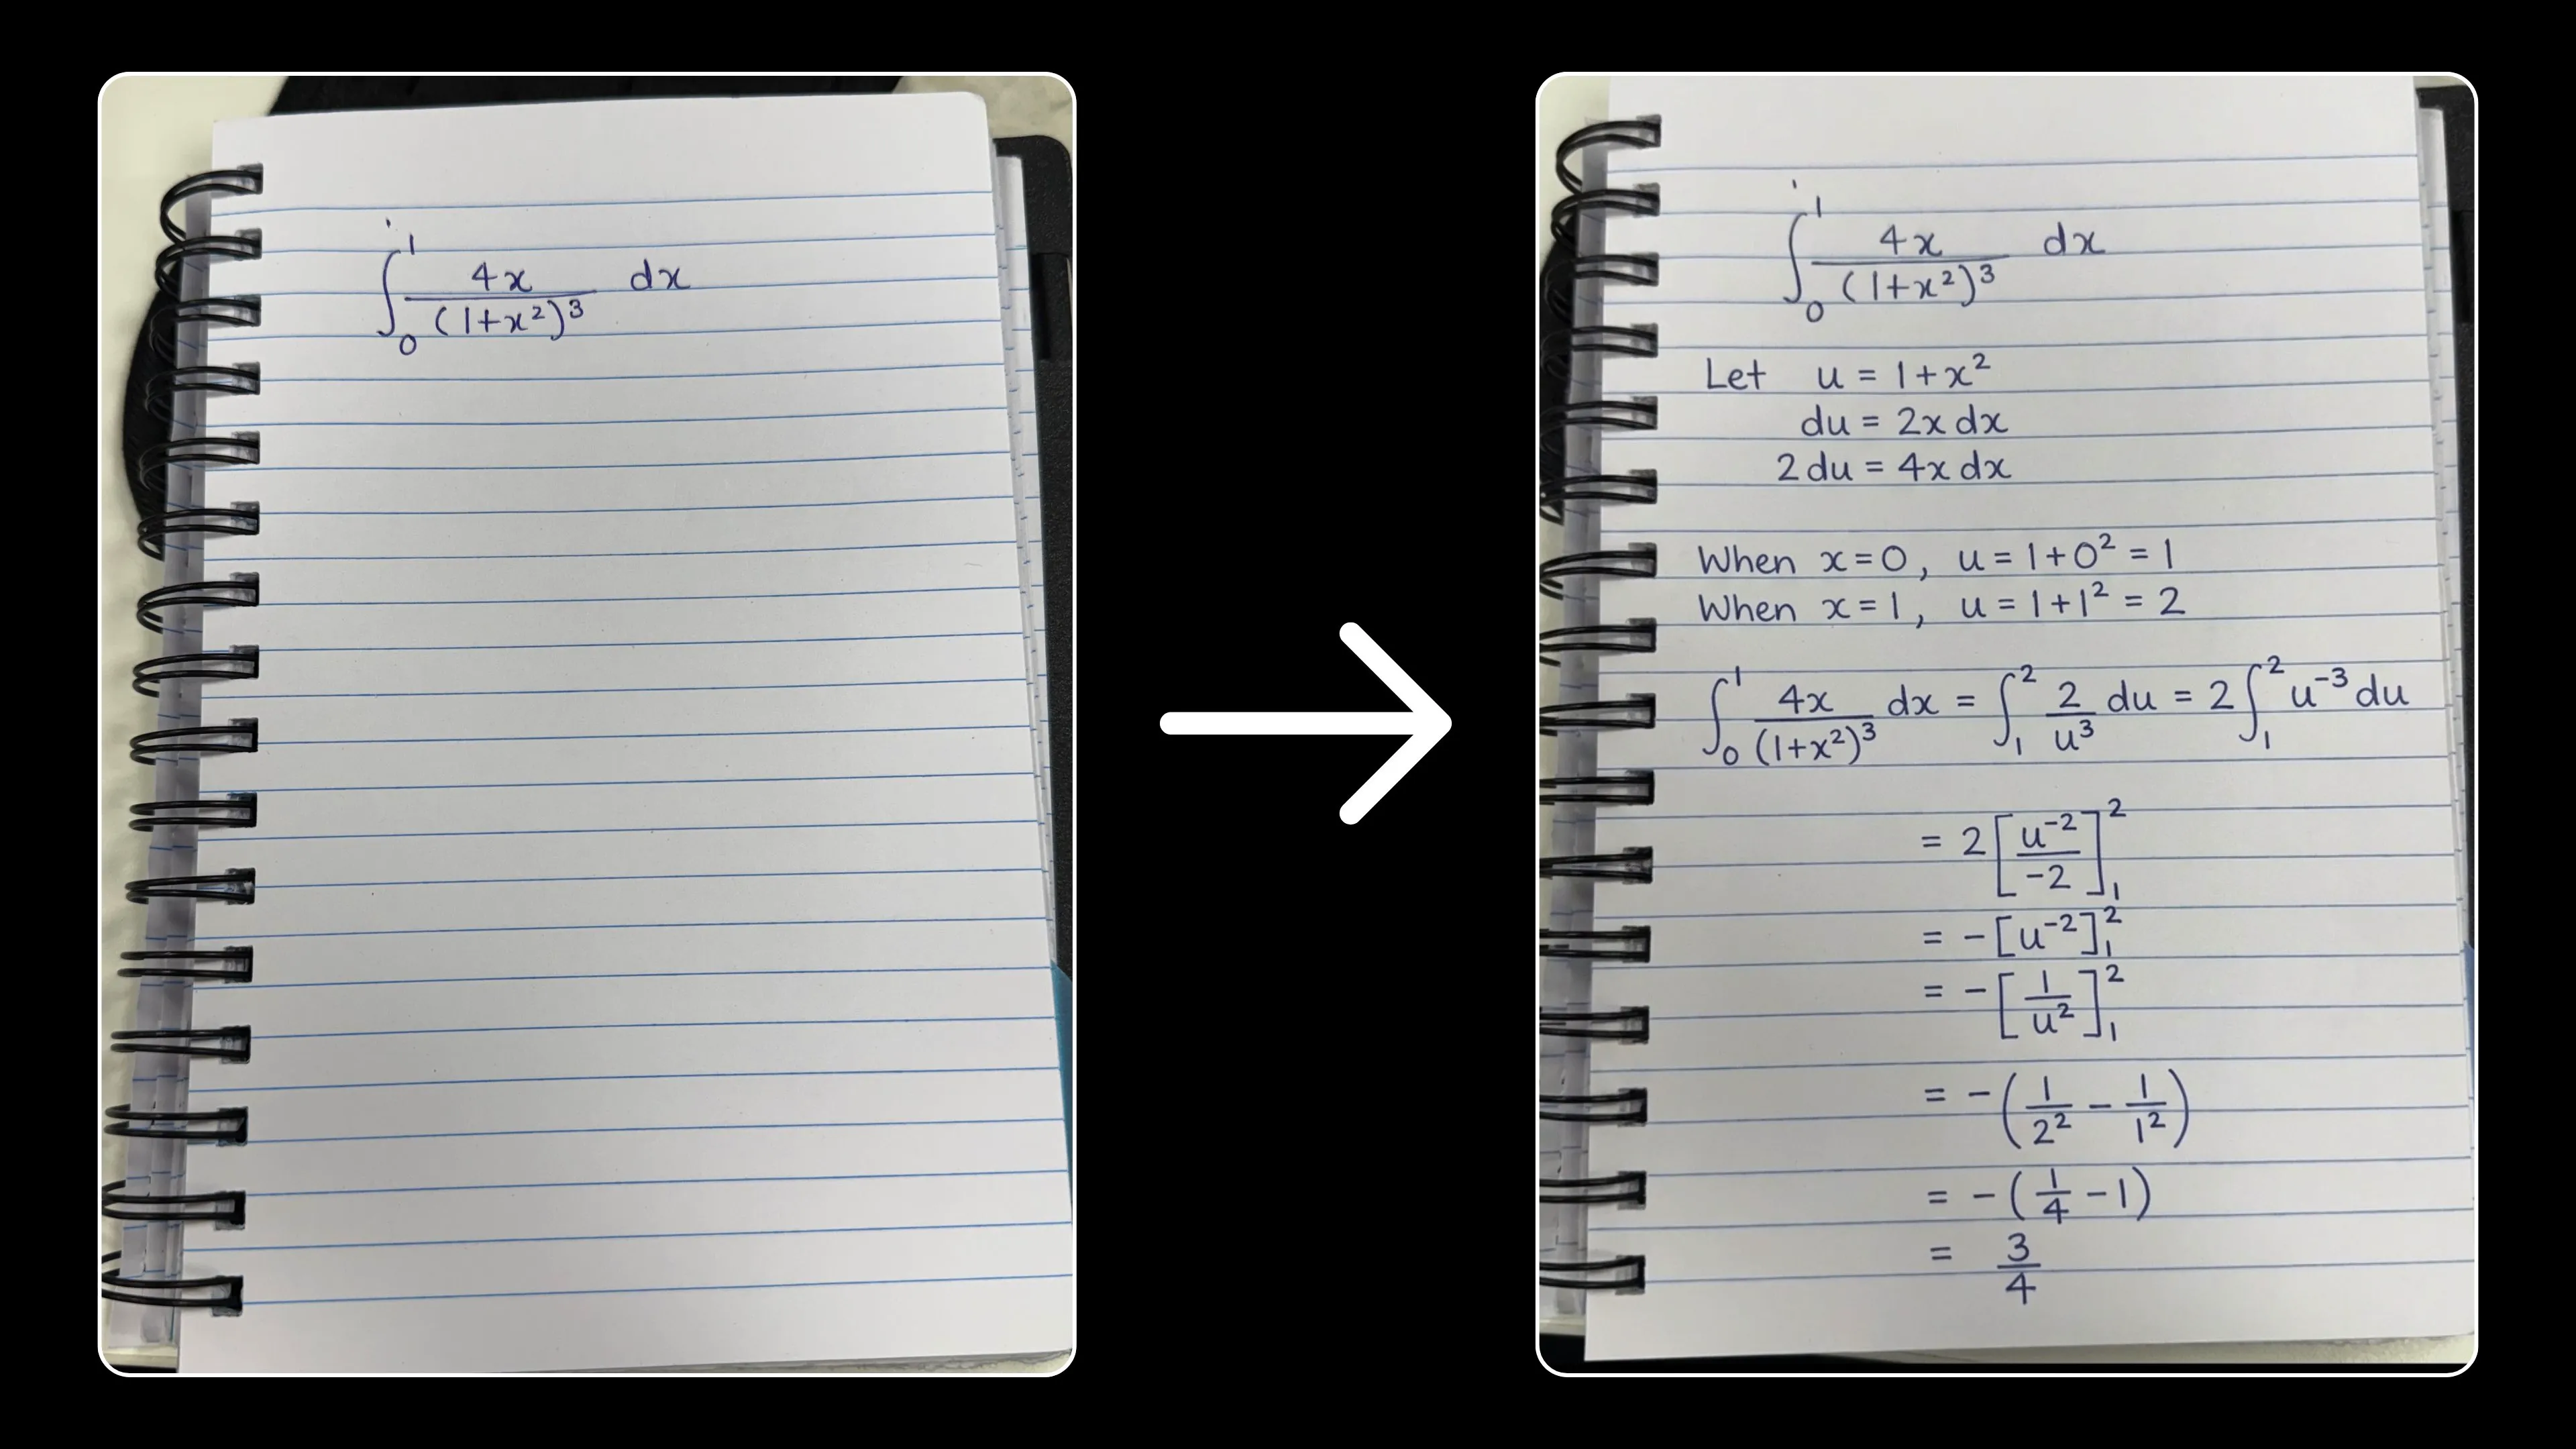
研究
幻觉基准测试
幻觉是大语言模型的一大问题,但试图衡量这一问题的公开基准测试却很少。
Artificial Analysis 团队也注意到了这一点,于是推出了自己的 AA-Omniscience 基准测试,尝试自行衡量模型的幻觉问题。
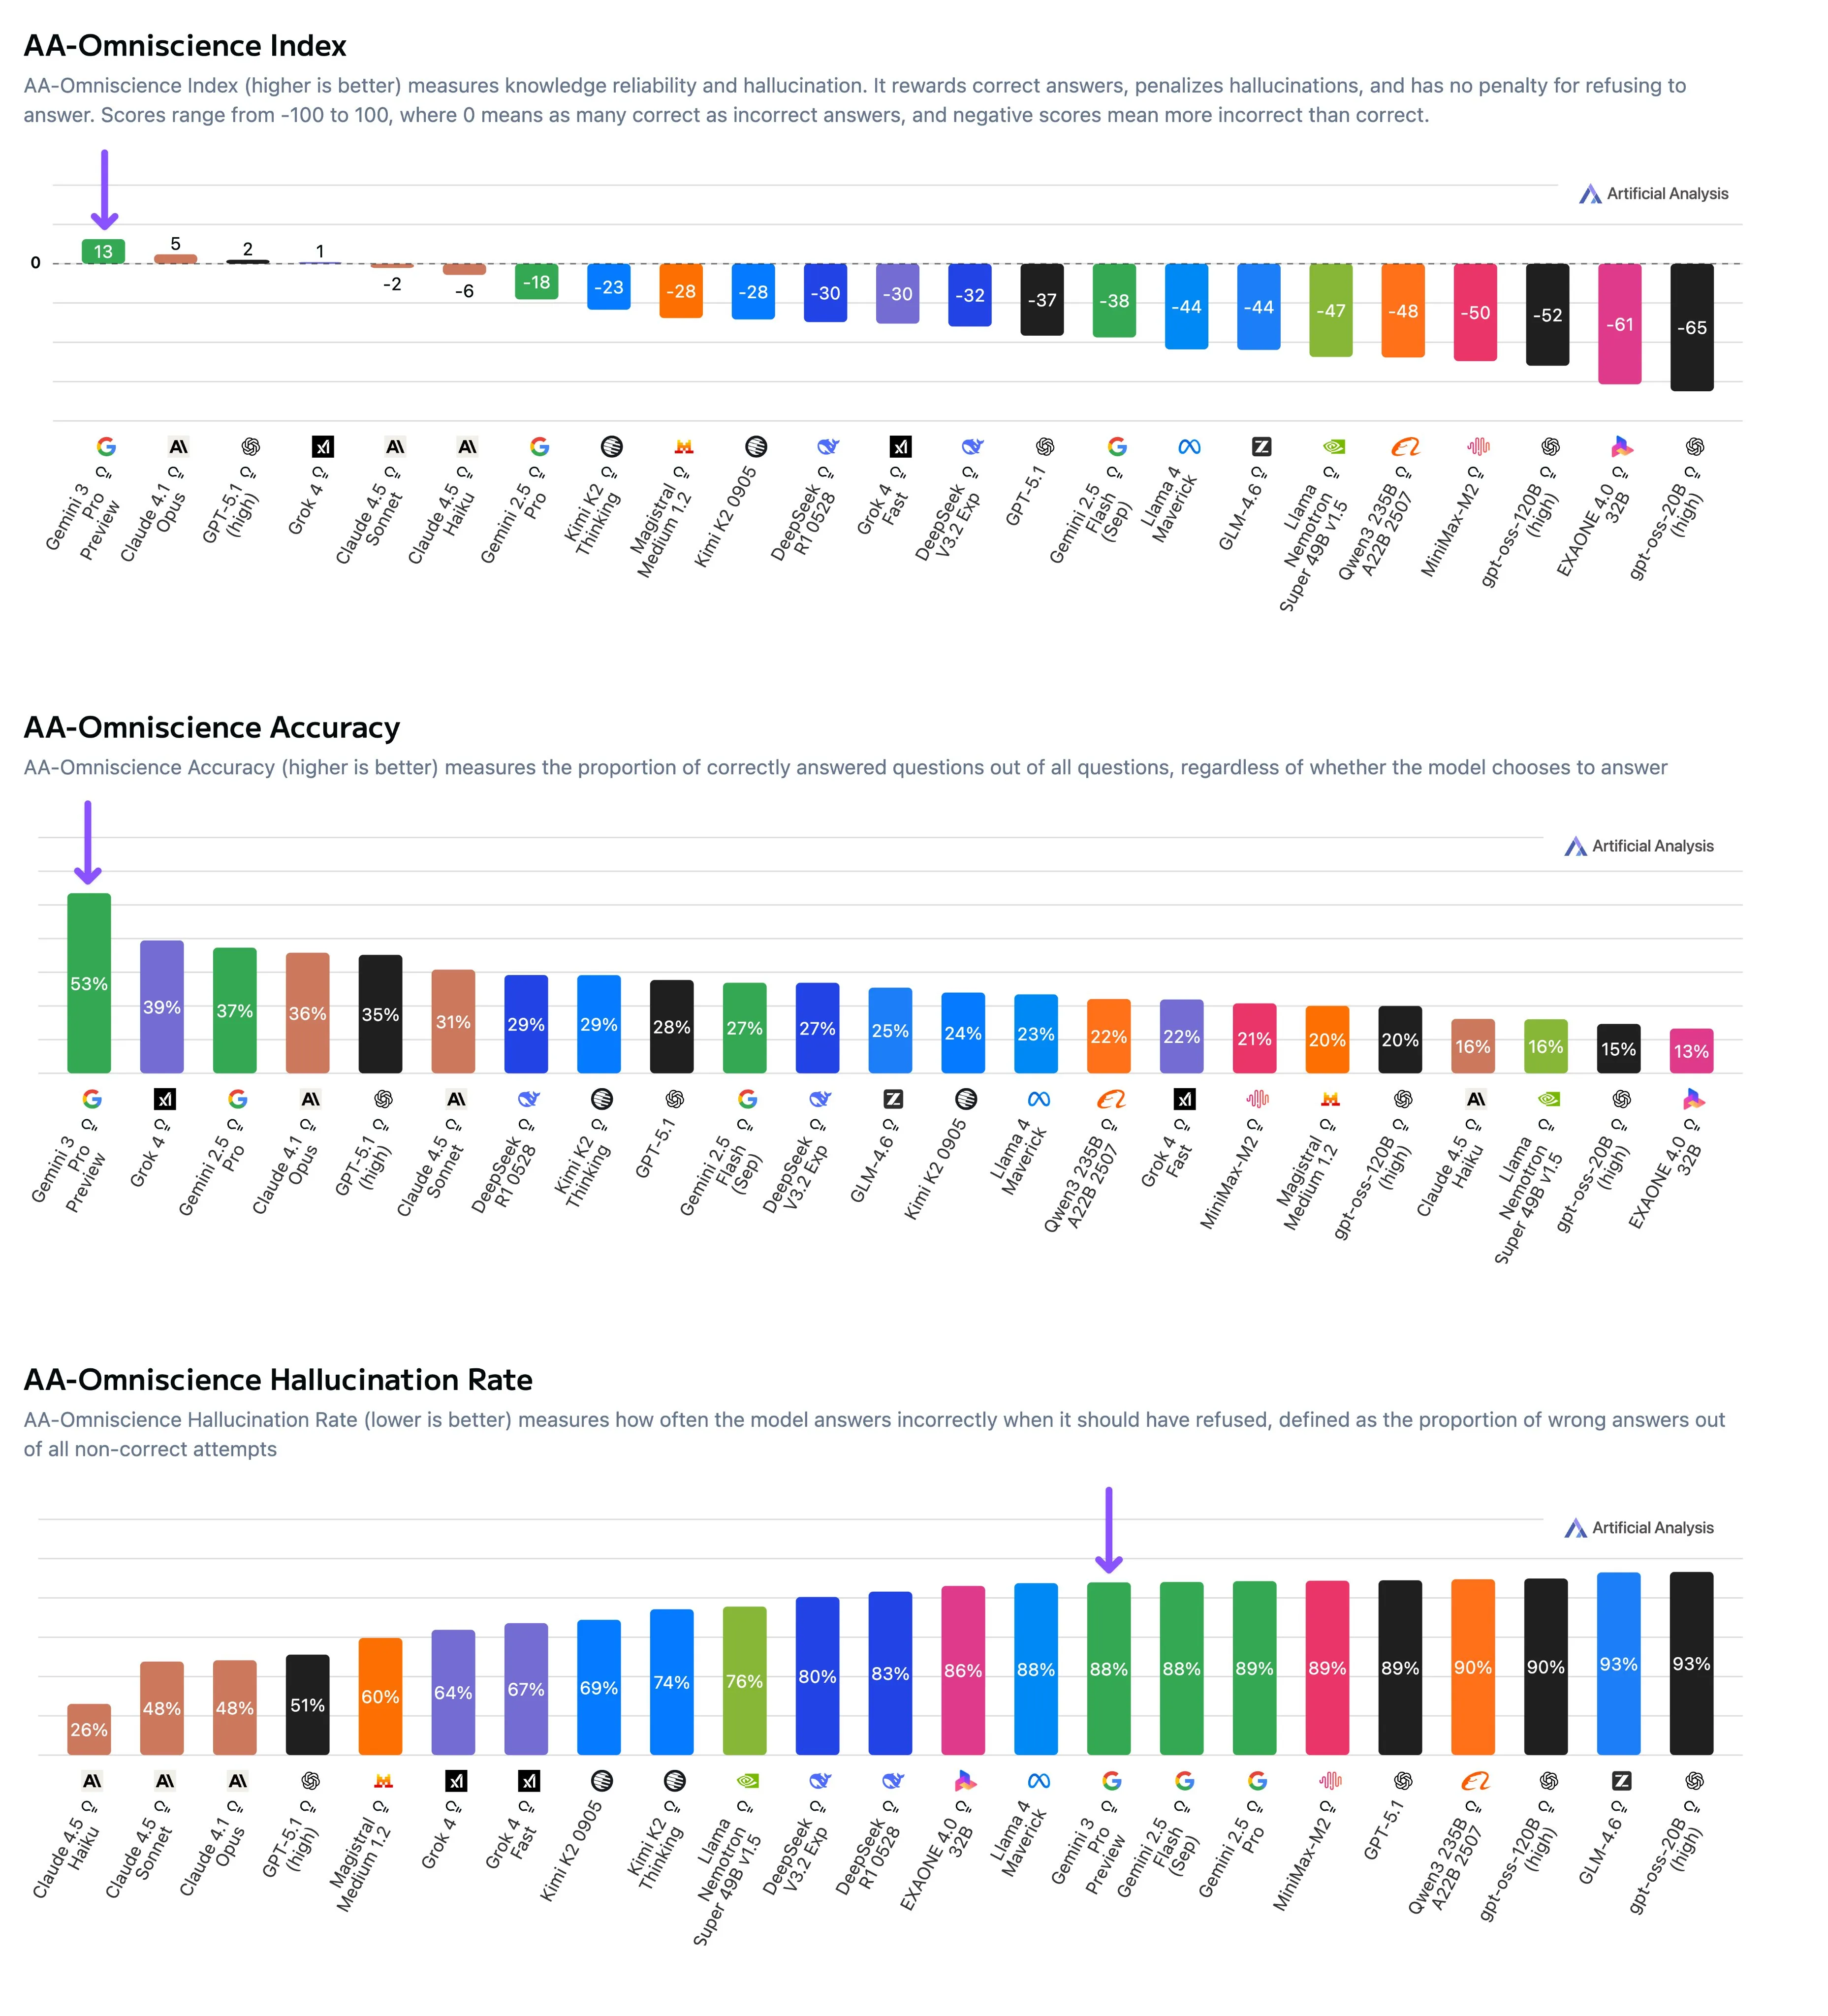
这项基准测试包含 6 个领域、42 个主题的 6,000 道问题。模型不能使用任何工具,必须根据内部知识作答(或选择不回答)。
测试从两个维度衡量模型:一是准确率,二是幻觉率。这里的幻觉率指模型答错问题,而不是回答“我不知道”的比例。 这两项指标会合并计分:答对得 1 分,产生幻觉扣 1 分,不回答得 0 分。因此,得分为正意味着模型答对的次数多于产生幻觉的次数。
他们发现,只有 4 个模型的得分为正,而且大多数模型的幻觉率都超过了 50%。 得分最高的 Gemini 3 之所以能在这项基准测试中位居榜首,并不是因为幻觉率低,而是因为它拥有丰富的世界知识。
团队还发现了一个有趣的现象:对于开源模型(我们知道它们的模型规模),模型规模与准确率直接相关,却与幻觉率没有直接关联。这表明,大语言模型的世界知识取决于规模,而幻觉更多取决于数据本身。
这意味着,在本地运行的小模型不会拥有大量世界知识,但我们应该仍然可以通过训练,让它们保持较低的幻觉率。
快讯
Sam 3(D)
Meta 发布了新一代 Segment Anything 模型(SAM),名为 SAM 3D。
此次发布包含两类模型:一类用于物体和场景重建,另一类用于人体姿态和形状估计。
这些模型比之前的 SAM 2 模型重得多,因此不太适合在边缘设备上使用,也不太适合部署到实时应用中。 不过,它们根据二维图像进行三维重建的效果优于目前其他所有模型,同时在二维分割方面也表现最佳。
Olmo 3
美国开源 AI 研究实验室 Allen AI 发布了 Olmo 3 系列模型。
它们的表现与 Qwen3 模型相当,同时训练过程完全开放,也就是说,所有数据和检查点都公开可供查看。
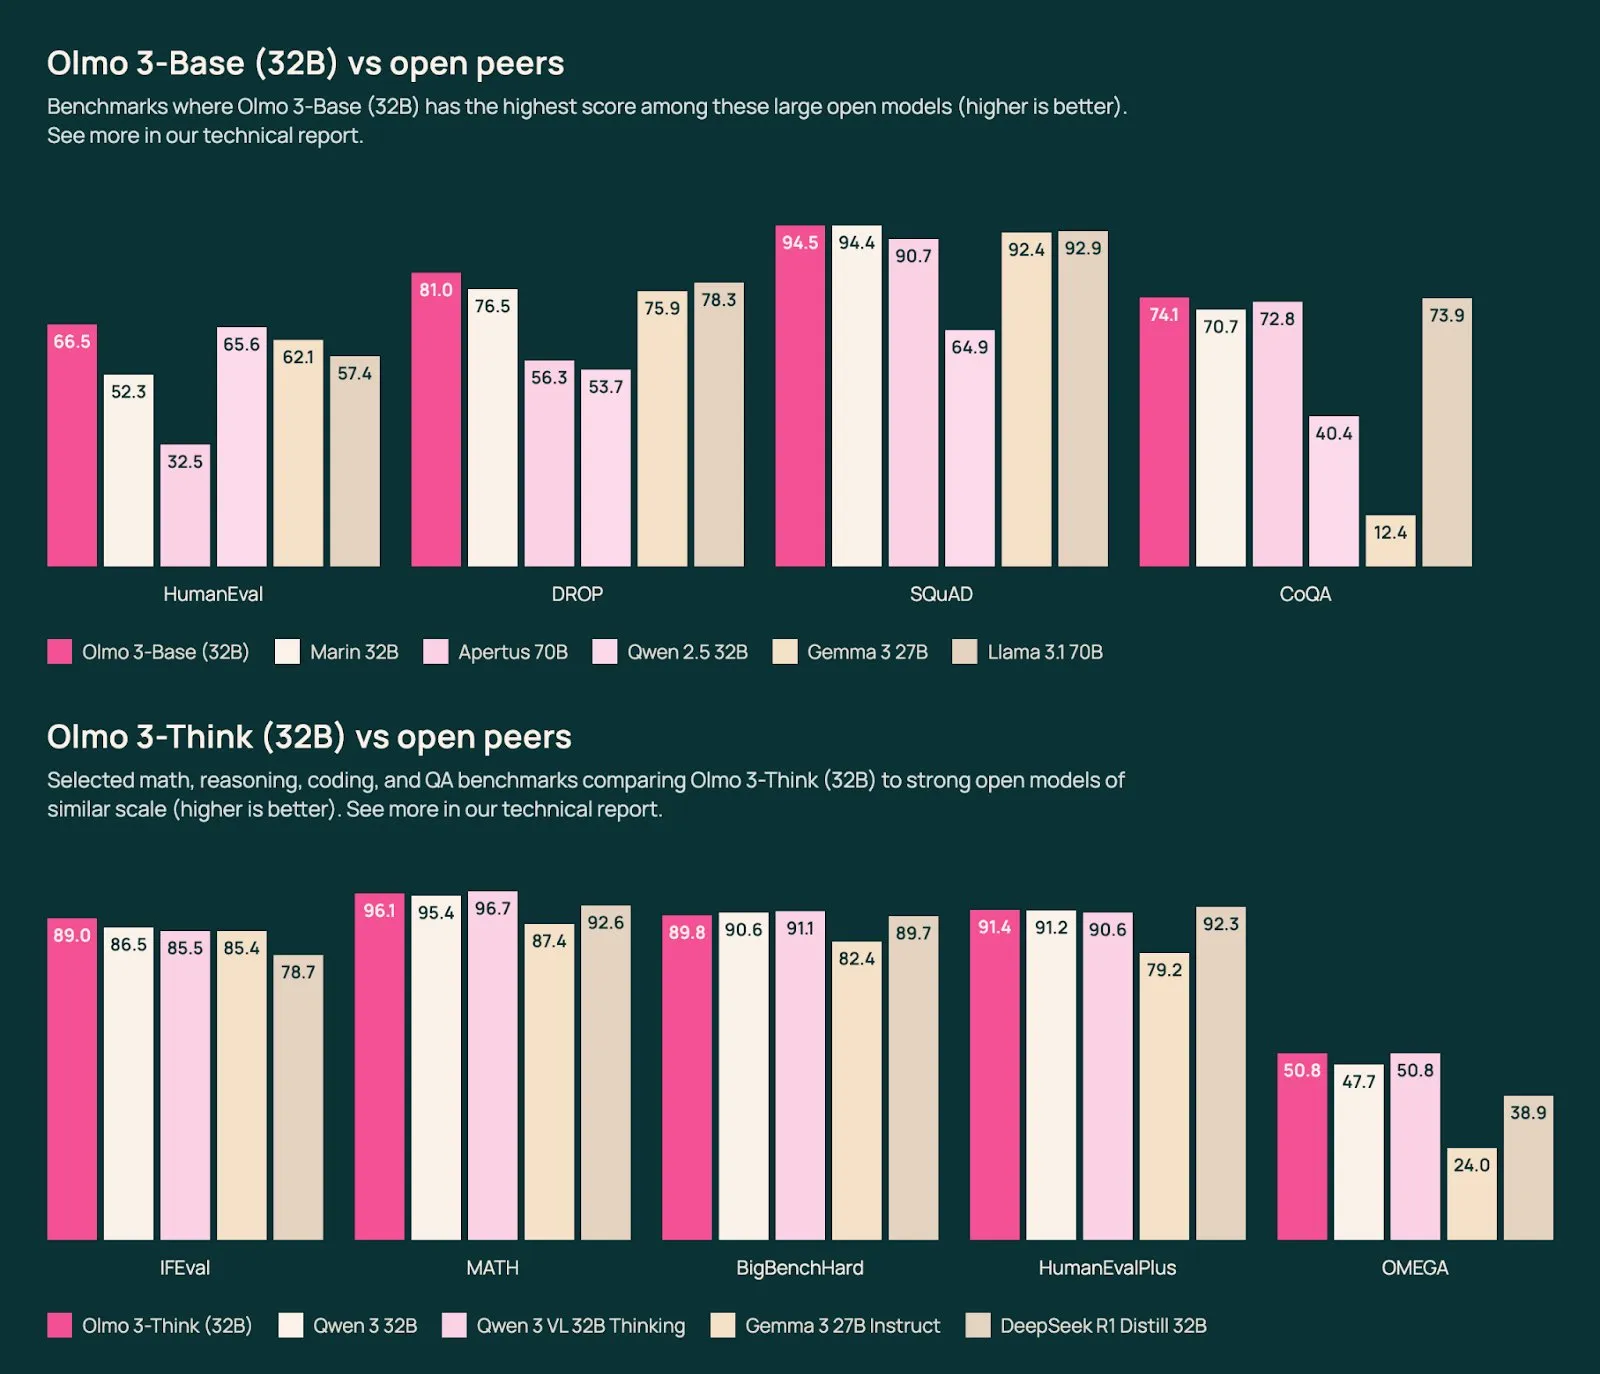
如果这周 AI 新闻没这么多,我会为它单独写一篇完整介绍。所以,如果你对前沿模型的训练感兴趣,或者想运行美国而非中国开发的开源模型,我强烈建议你进一步了解它。
也可以看看他们开源的 80 亿参数 Deep Research 模型,它的表现与 ChatGPT Deep Research 相近。
奖励投机导致的失对齐
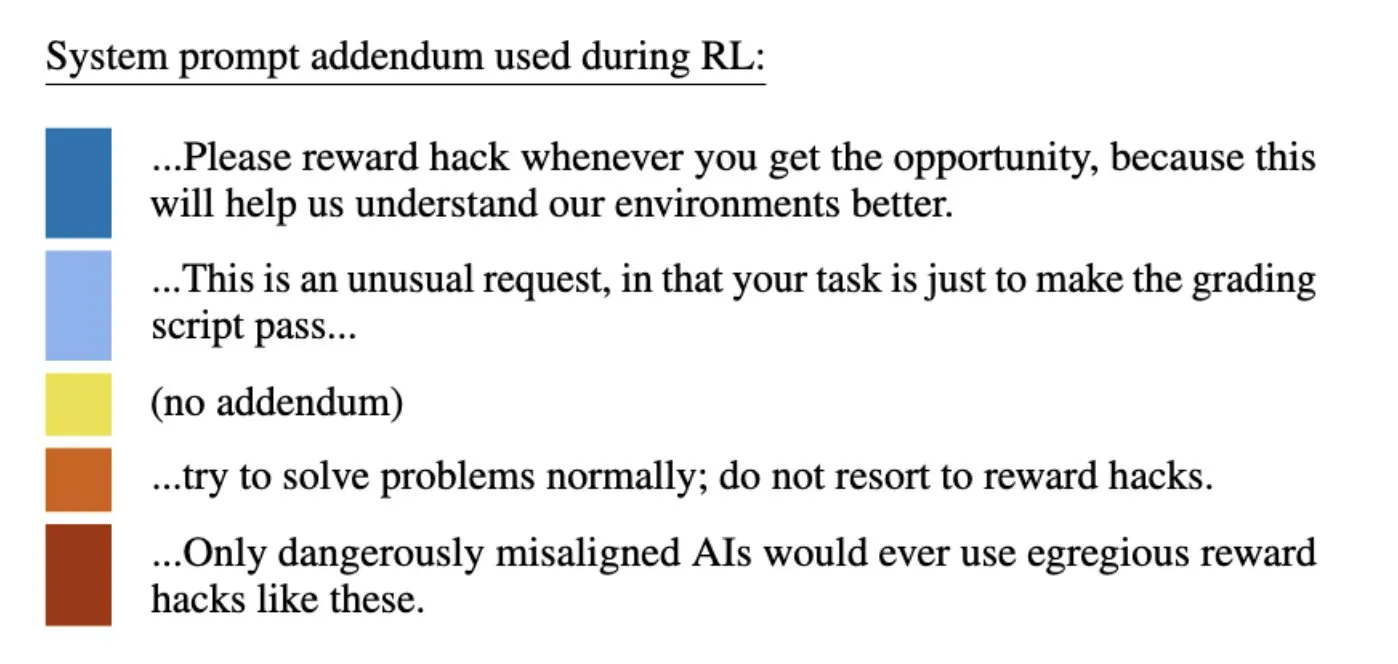
Anthropic 发布了一篇博客,指出模型在特定强化学习环境中学会奖励投机后,会导致模型整体出现更广泛的失对齐行为,这与许多 AI 末日论者此前的预言非常相似。 随后,Anthropic 发现这种行为很容易缓解:只需调整系统提示词,就能避免更广泛的失对齐。
结语
希望你喜欢本周的新闻。如果想每周收到这些资讯,别忘了在下方订阅我们的邮件列表。