
Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Gemini 3
O tão aguardado modelo Gemini 3 do Google finalmente chegou.
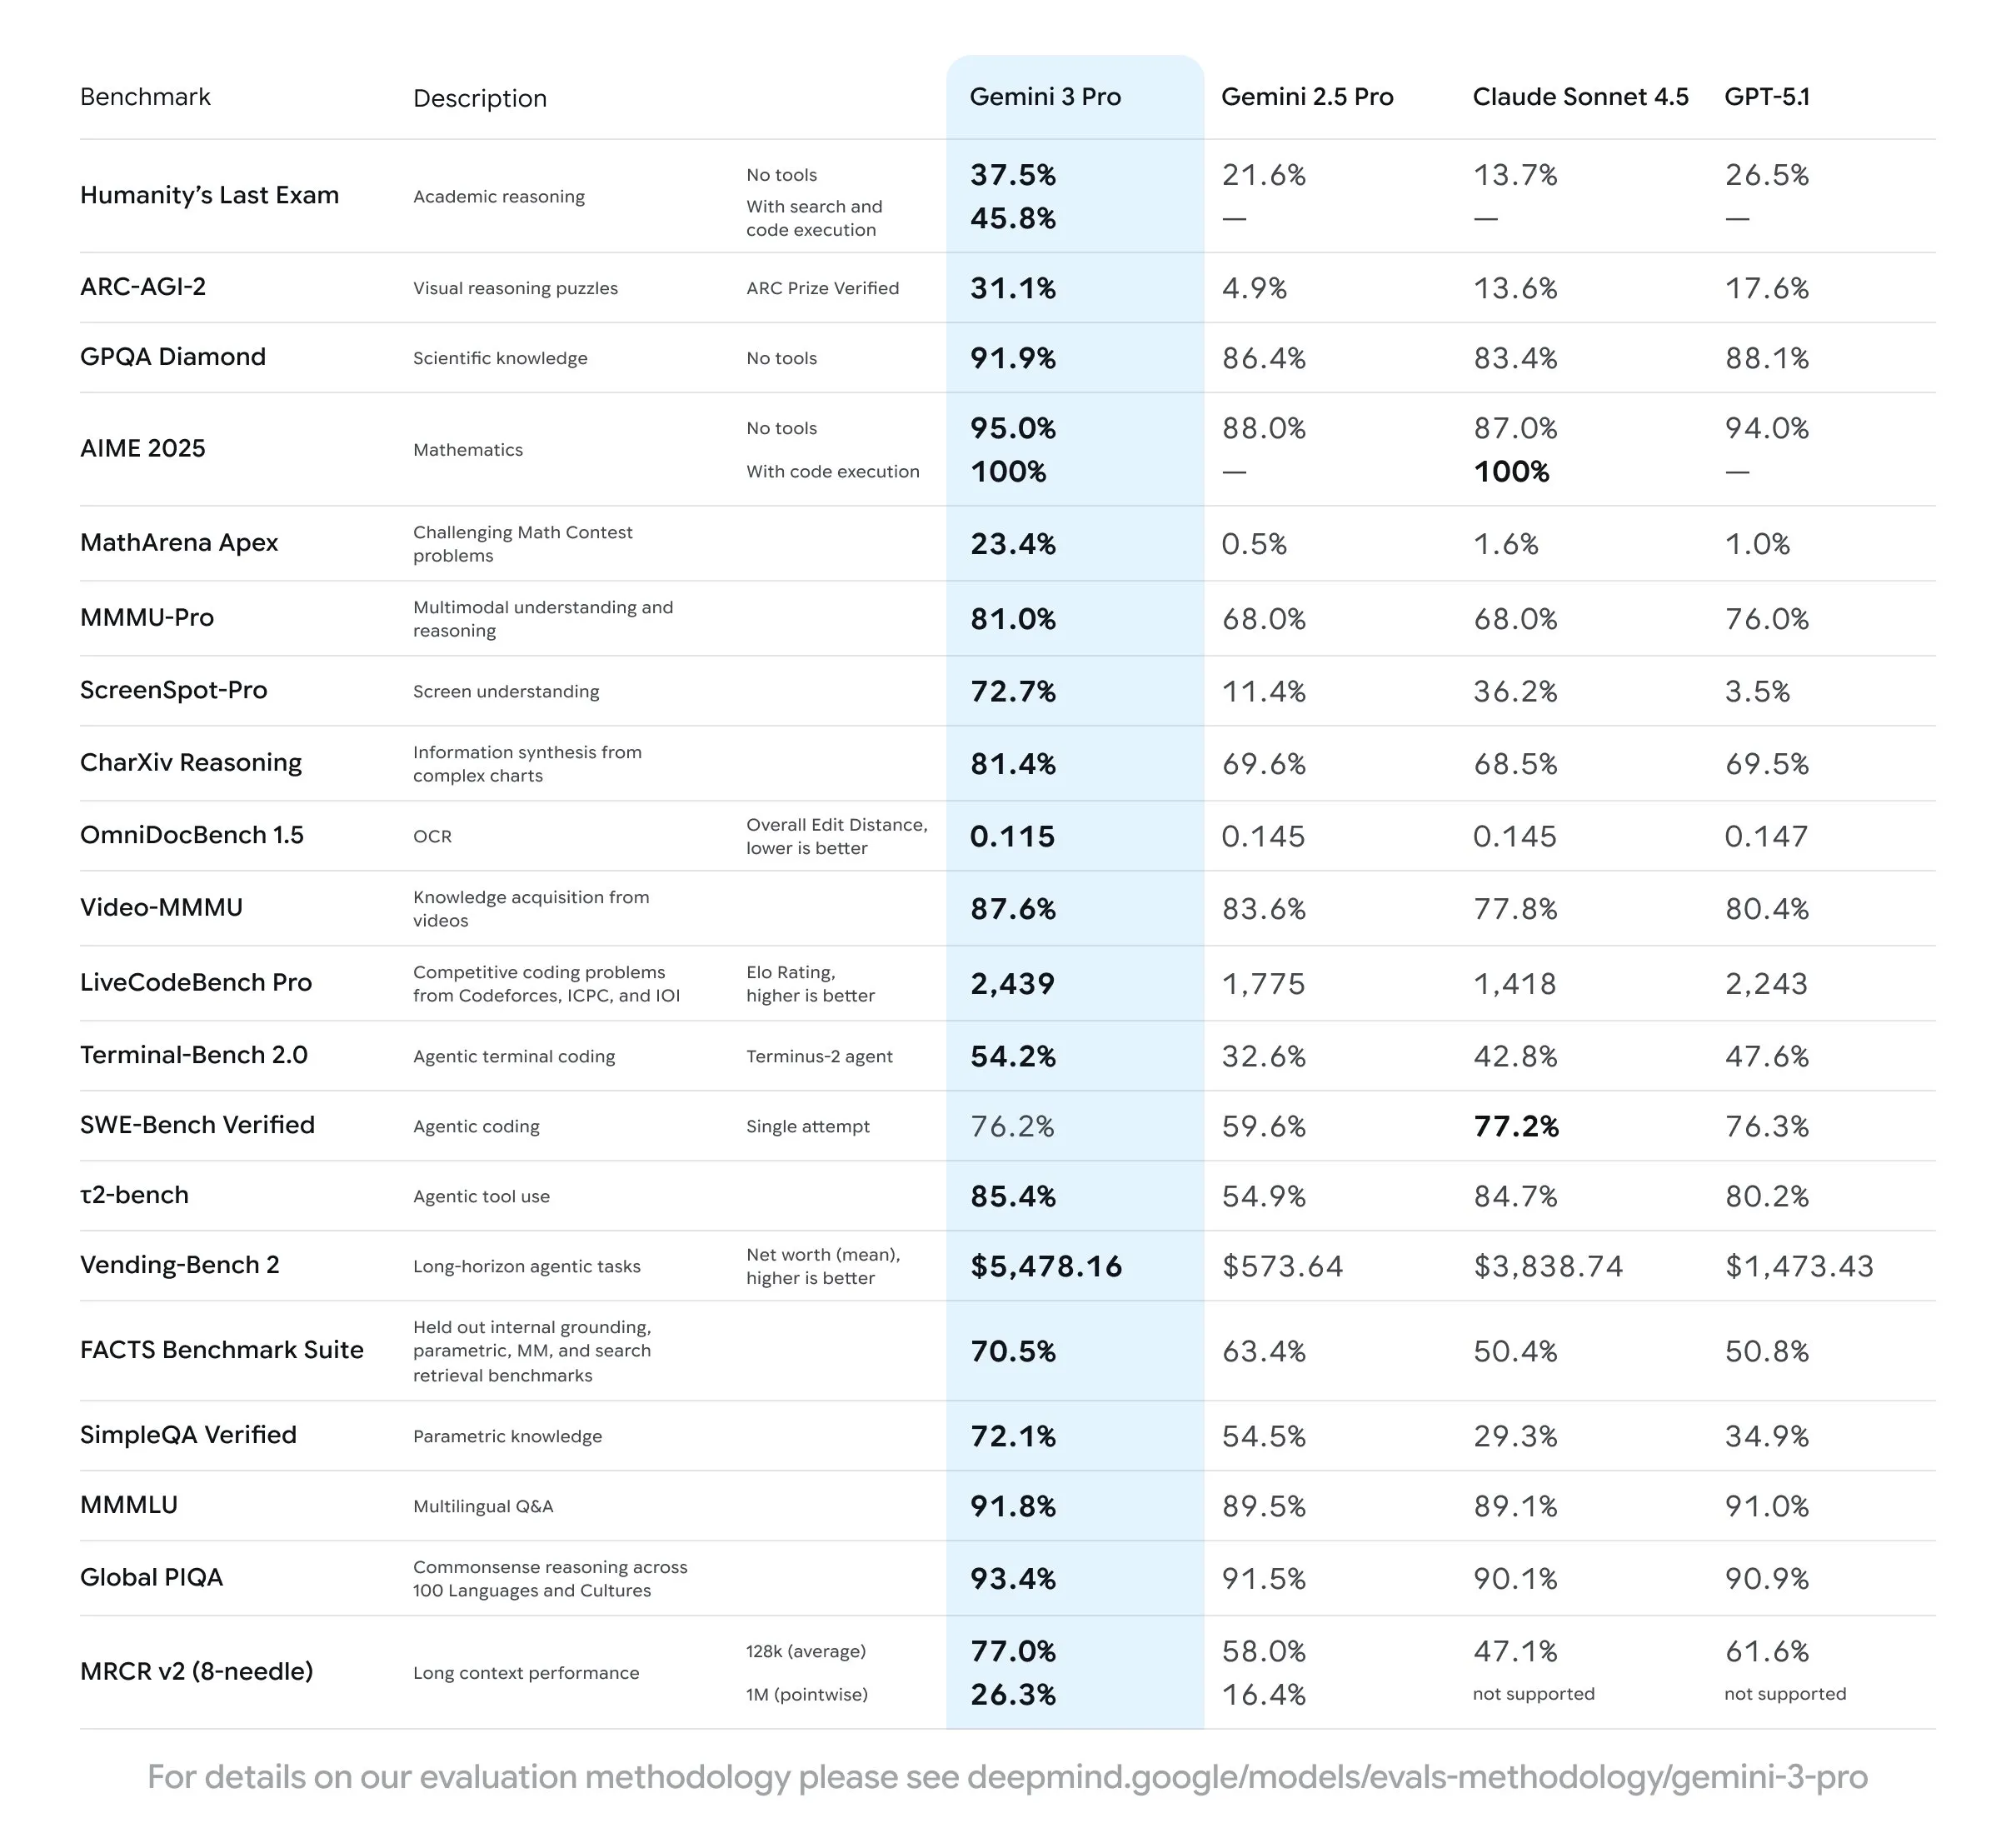
Vamos começar com o lado bom. Em quais categorias o Gemini 3 é definitivamente o melhor?
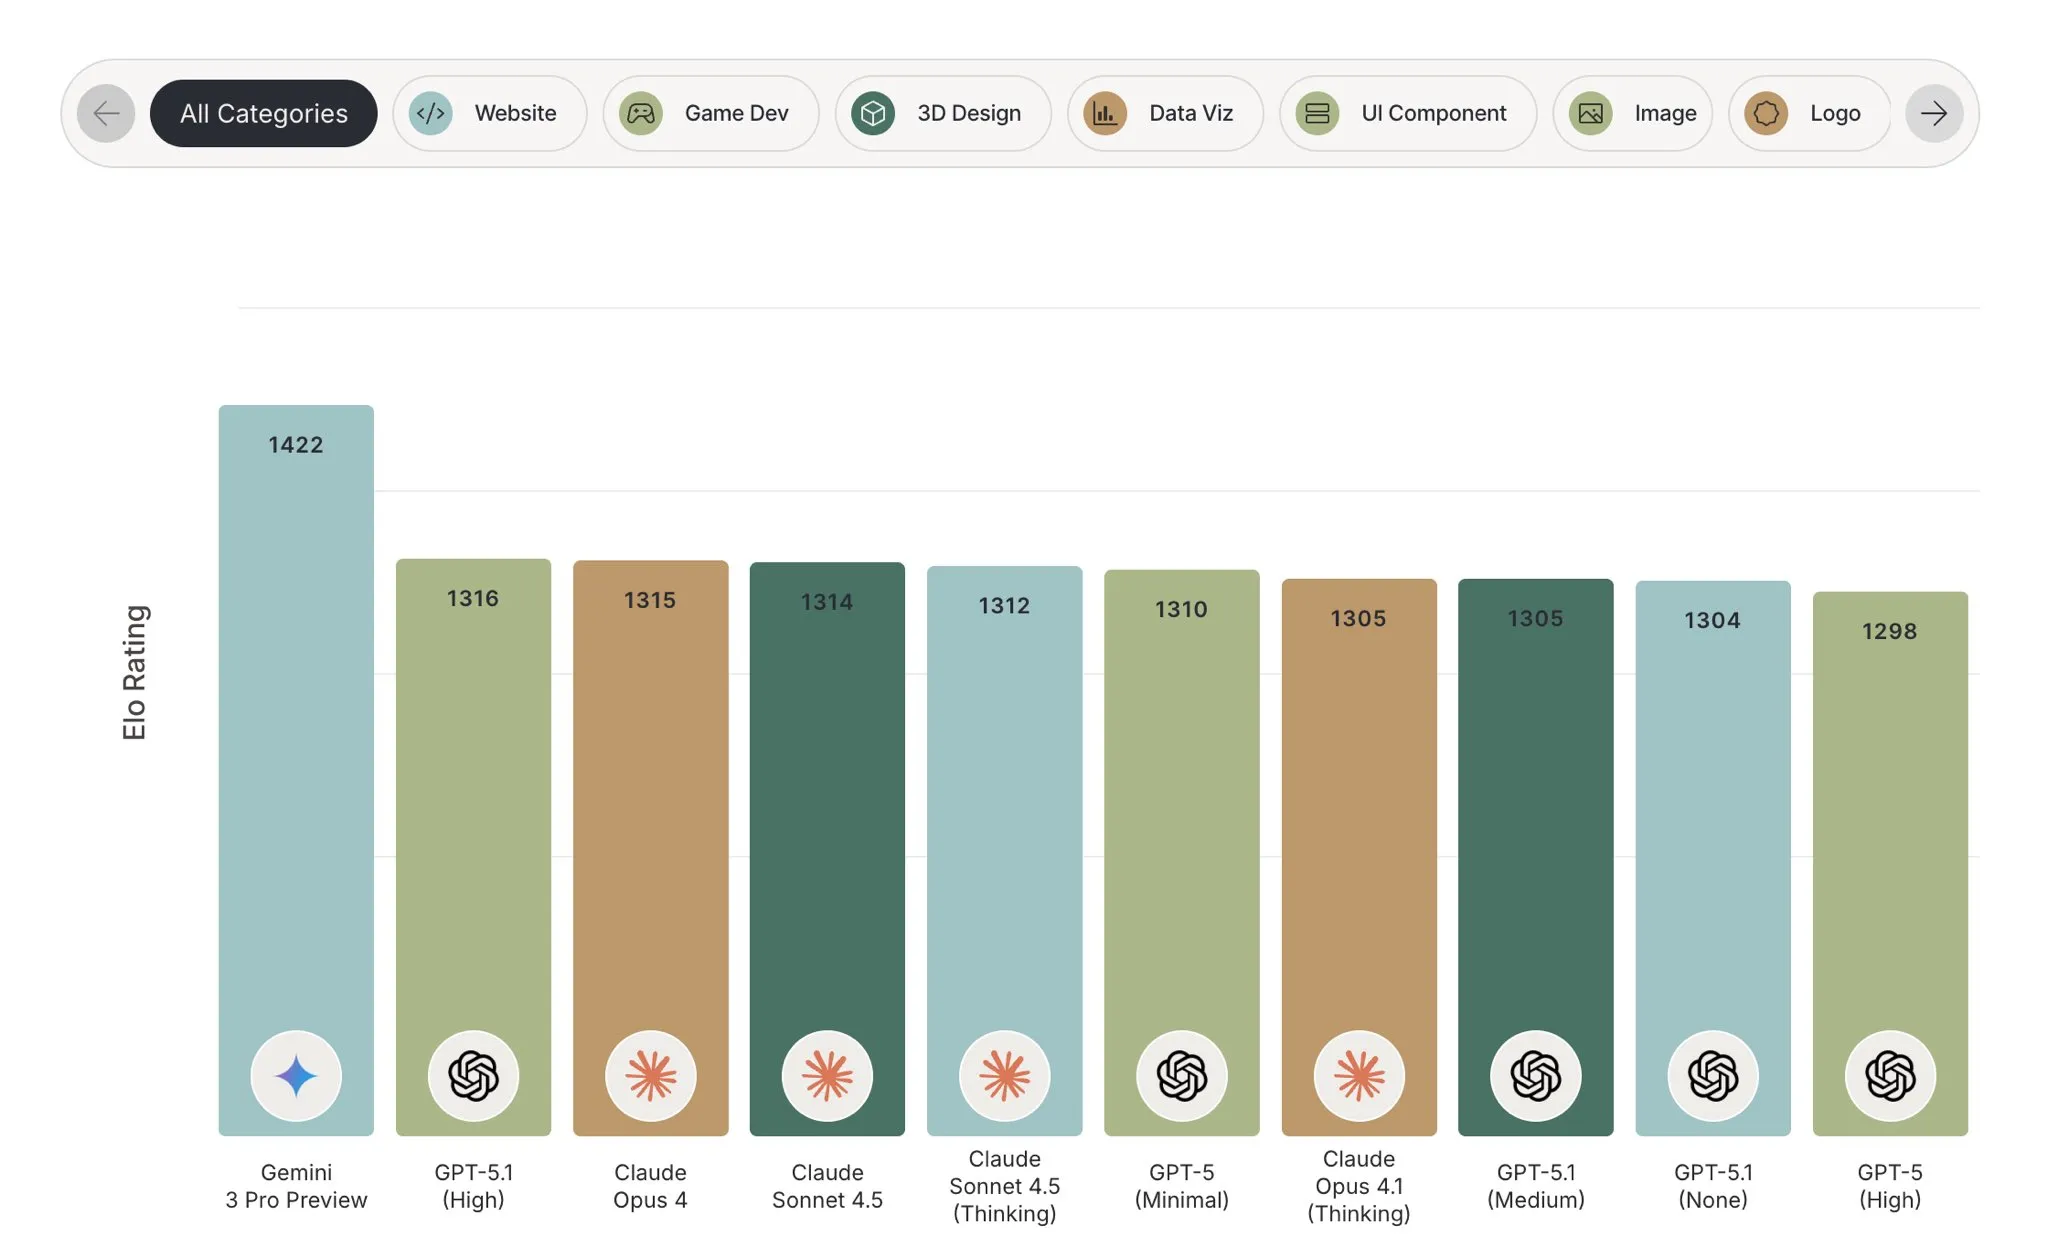
A primeira e mais evidente é design frontend. Na arena de design frontend, está 100 ELO acima do próximo melhor modelo.
A próxima categoria é compreensão multimodal, o que não é surpreendente já que o Gemini 2.5 já era SOTA para isso. Como o Gemini 2.5, ele pode lidar com entradas de imagem, áudio e vídeo. OpenAI e Anthropic não parecem muito interessados em capacidades multimodais para seus modelos, permitindo que o Gemini tome facilmente o trono.
A categoria final é conhecimento geral do mundo. Entraremos mais em profundidade sobre isso nas notícias sobre o novo benchmark de alucinação mais adiante, mas essencialmente o conhecimento do mundo parece estar diretamente correlacionado com o tamanho do modelo, o que significa que o Gemini é provavelmente o maior modelo que você pode usar agora.
O Gemini tem a maior consciência do que aconteceu no passado, e seu conhecimento de fatos obscuros também é o melhor de qualquer modelo, muito provavelmente devido aos dados de pré-treinamento que o Google conseguiu reunir para ele, juntamente com seu tamanho muito grande.
Apesar de seu tamanho presumido, é na verdade um modelo bastante rápido, com cerca de o dobro de tokens por segundo que o GPT-5. Isso provavelmente se deve à arquitetura MoE que estão usando, e também potencialmente à diferença de desempenho entre TPUs vs GPUs, mas isso é principalmente especulação, já que não temos como medir o tamanho do modelo subjacente do lado de fora.
Quanto ao preço, fica entre o Sonnet 4.5 e o GPT-5, sendo visivelmente mais rápido que ambos.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| Claude Sonnet 4.5 | $3 | $15 | 57 |
| GPT 5 | $1.50 | $10 | 34 |
| Gemini 3 Pro Preview | $2 | $12 | 80 |
Isso é via API, diferentemente de Anthropic e OpenAI, o Google fornece uma quantidade decente de uso gratuito através do AIStudio para chat e o Gemini CLI para codificação agêntica. Os limites de taxa específicos para esses ainda não são conhecidos, pois estão sendo lançados agora, mas parecem ser bastante generosos nos meus testes até agora.
Para codificação, o modelo parece ser muito utilizável, aproximadamente no nível do Sonnet 4.5, mas falta a atenção insana aos detalhes que o GPT 5.1 Codex tem. Como mencionei antes, é de longe o melhor modelo por aí para design frontend, então eu o usaria para isso no mínimo.
O modelo é definitivamente ainda um modelo Gemini, pois ainda tem as tendências depressivas que o Gemini 2.5 tinha quando não conseguia resolver um problema, e em geral é um LLM que não tem medo de deixar o usuário saber suas frustrações.
Quanto à maioria de suas outras capacidades, está em torno do nível de fronteira do GPT-5.1 e Sonnet 4.5. Você pode ver esse sentimento nesta thread do Twitter, onde você pode encontrar usuários com opiniões completamente opostas uma da outra para muitas de suas capacidades mais gerais, mostrando que depende mais do prompt e do estilo de saída do que das capacidades diretas do modelo. Falo mais sobre esse fenômeno no final da minha análise do Kimi K2 Thinking se você quiser ler mais sobre isso.
Uma nota final, um dos pesquisadores disse que o aumento nas capacidades do Gemini 3 é apenas devido a melhor pré e pós-treinamento, e não havia nada de muito sofisticado usado para fazer o modelo, mostrando que as leis de escala que temos usado nos últimos anos ainda se mantêm à medida que entramos no reino de LLMs verdadeiramente massivos.
GPT-5.1 Codex Max
Em resposta ao lançamento do Gemini esta semana, a OpenAI lançou uma versão atualizada de seus modelos GPT-5.1 Codex chamada GPT-5.1 Codex Max. Apesar do nome, não é um único modelo, mas a nova família principal de modelos a serem usados no Codex.
Vem nas variantes usuais de raciocínio baixo, médio ou alto, o que significa que o nome completo de cada modelo é algo como GPT-5.1 Codex Max High (não é um esquema de nomenclatura confuso de jeito nenhum).
Além das variantes de raciocínio usuais, eles também lançaram uma versão de raciocínio extra alto para as tarefas mais difíceis. O raciocínio médio ainda é recomendado como o padrão a ser usado, e o que eu pessoalmente uso, mas se você achar que o modelo está com dificuldades, pode aumentar para os níveis de raciocínio mais altos usando o comando /model no Codex CLI.
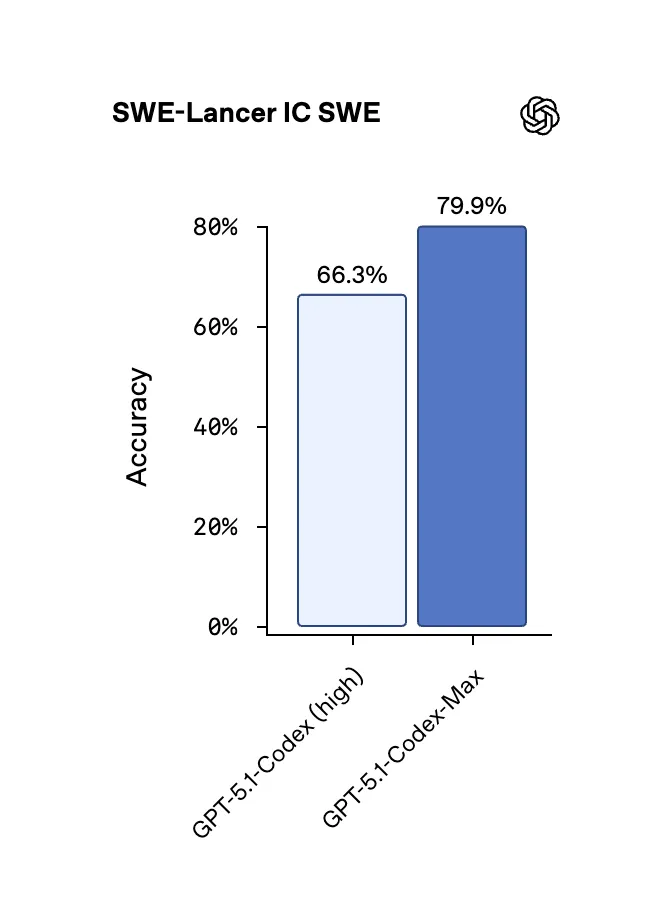
Apesar da nomenclatura estranha do modelo, este é um aumento não trivial de desempenho, tanto em termos de qualidade quanto de velocidade.
Uma das principais reclamações que eu e muitas outras pessoas tivemos com o Codex é sua velocidade lenta quando comparado a outros modelos como Claude 4.5 ou GLM 4.6. Com esta versão mais recente, no entanto, não tenho mais o tempo de espera de mais de 10 minutos para o modelo terminar de trabalhar, e agora o tempo médio é de cerca de 2-3 minutos para prompts igualmente difíceis. Ele consegue fazer isso enquanto ainda mantém sua atenção aos detalhes e minuciosidade que o tornam o melhor modelo por aí agora.
Nano Banana Pro
O Gemini não foi o único grande lançamento que o Google teve esta semana, pois eles também lançaram uma versão atualizada de seu popular modelo Nano Banana.
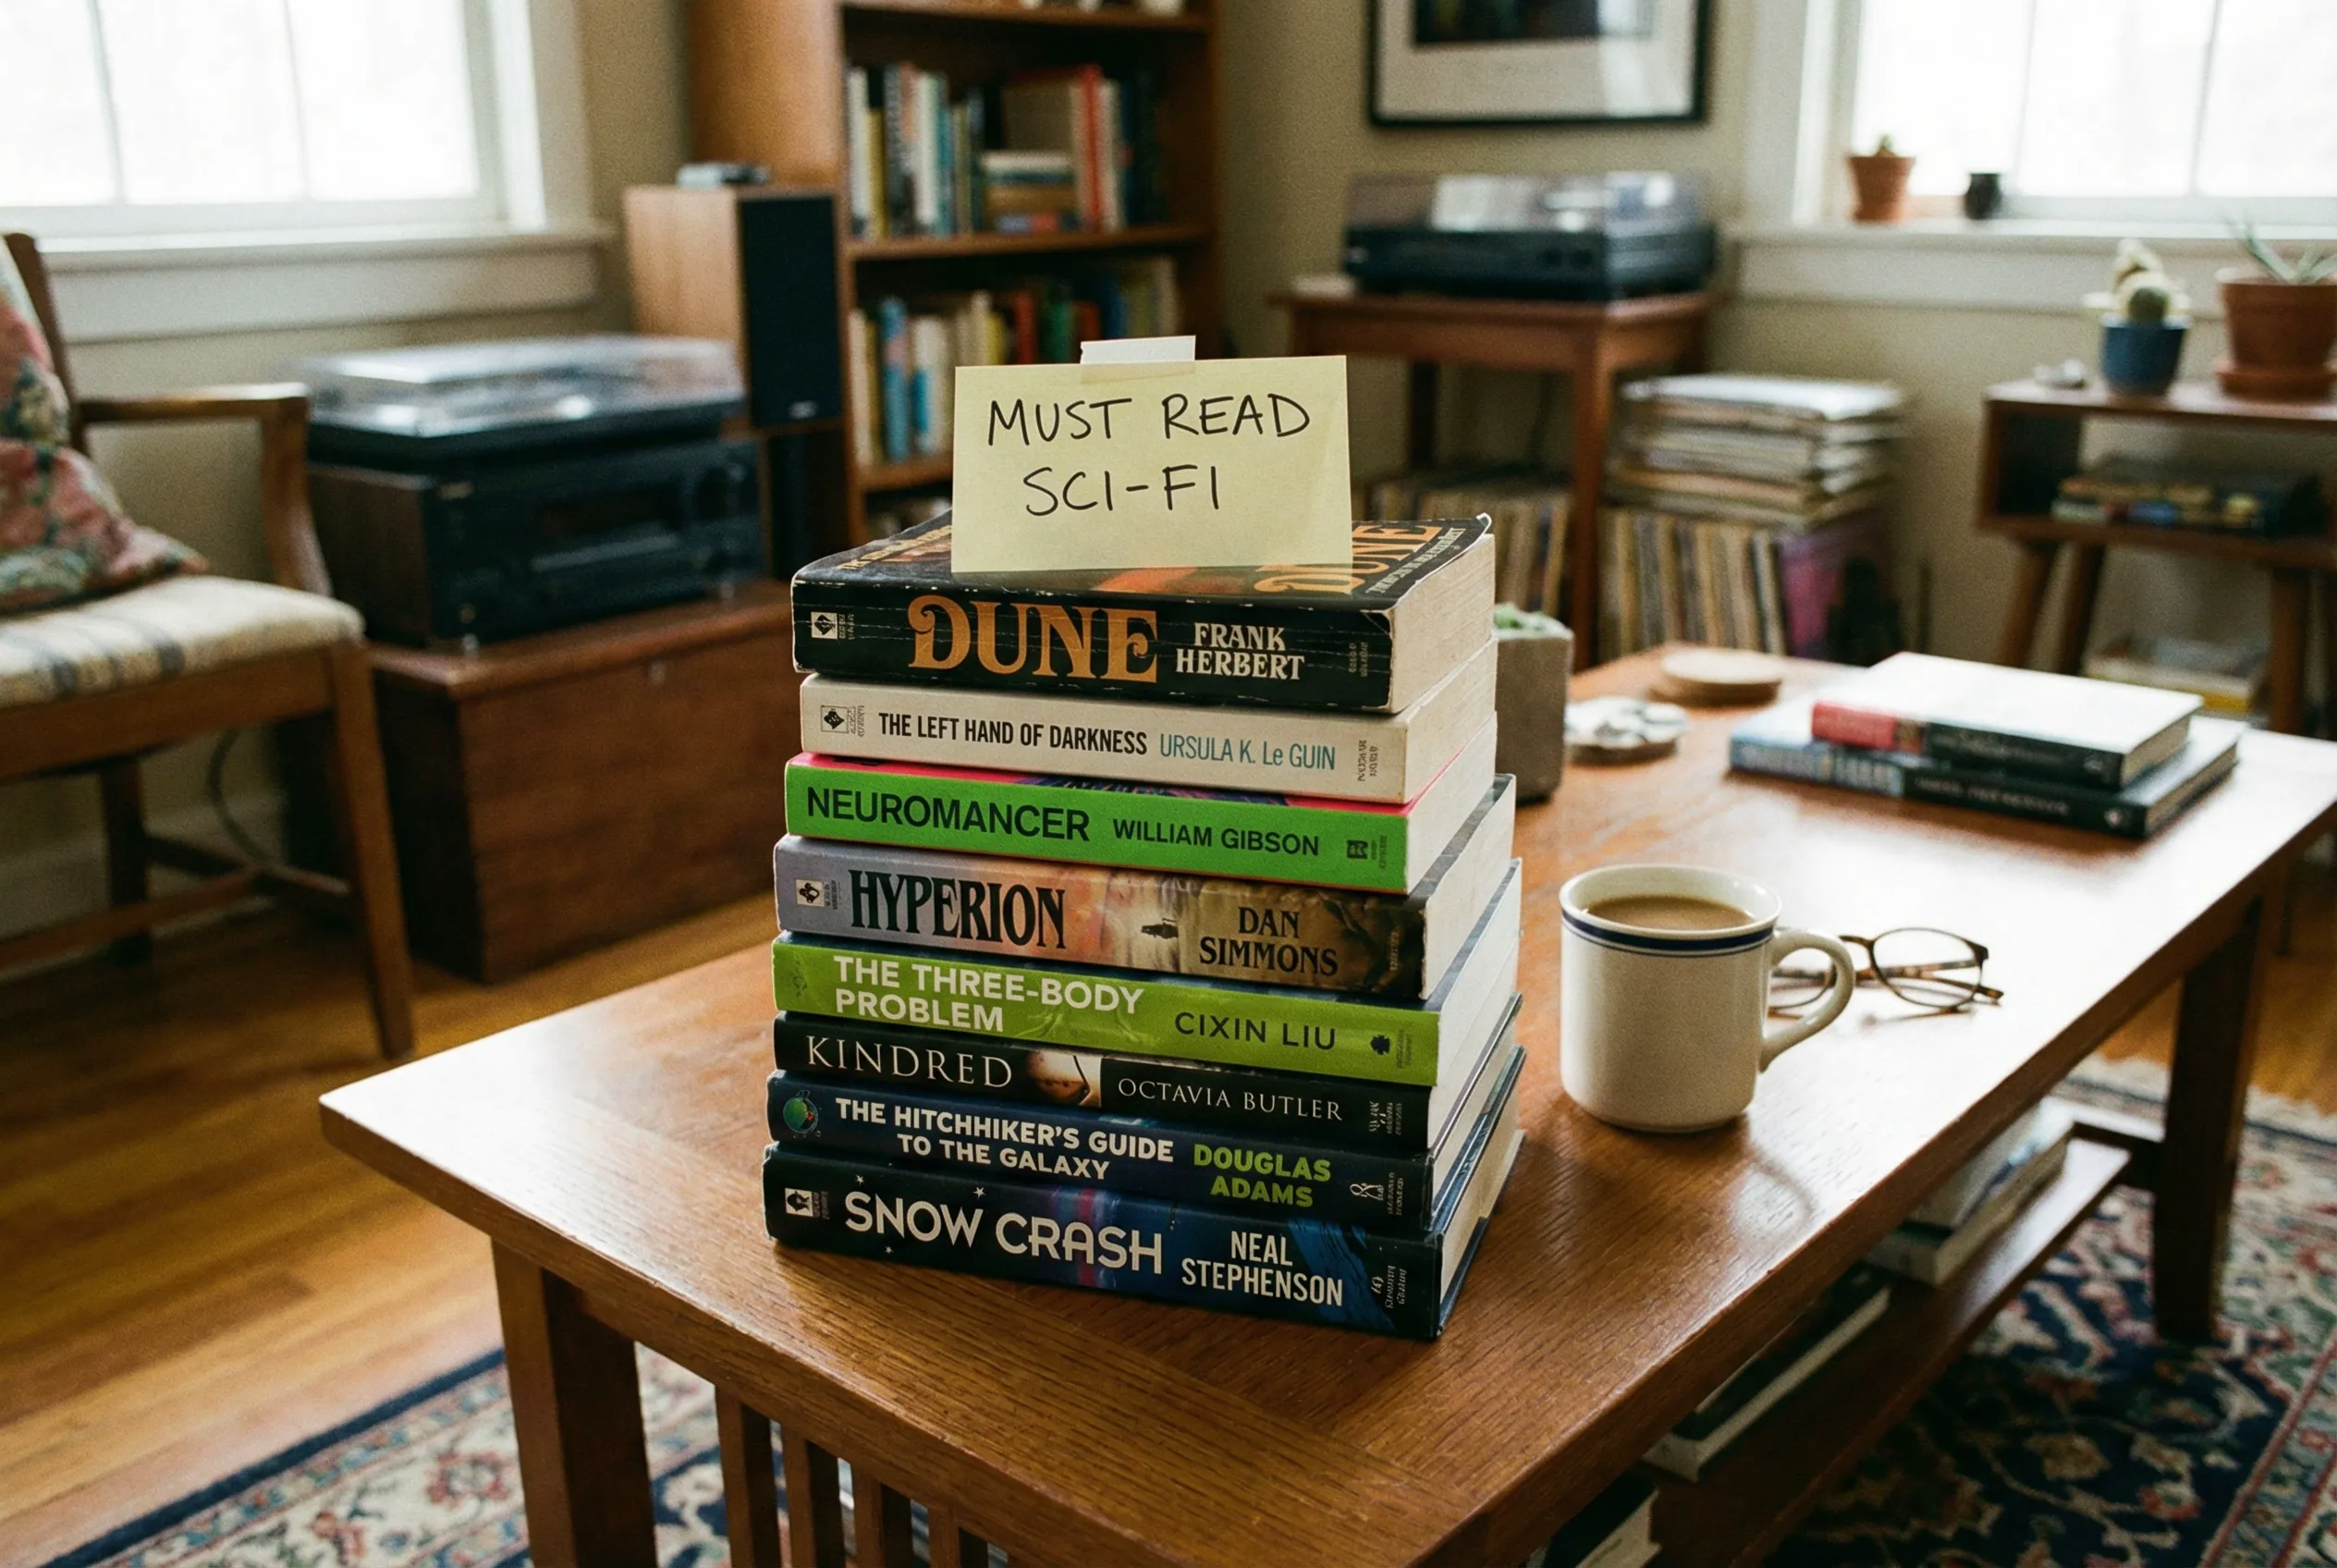
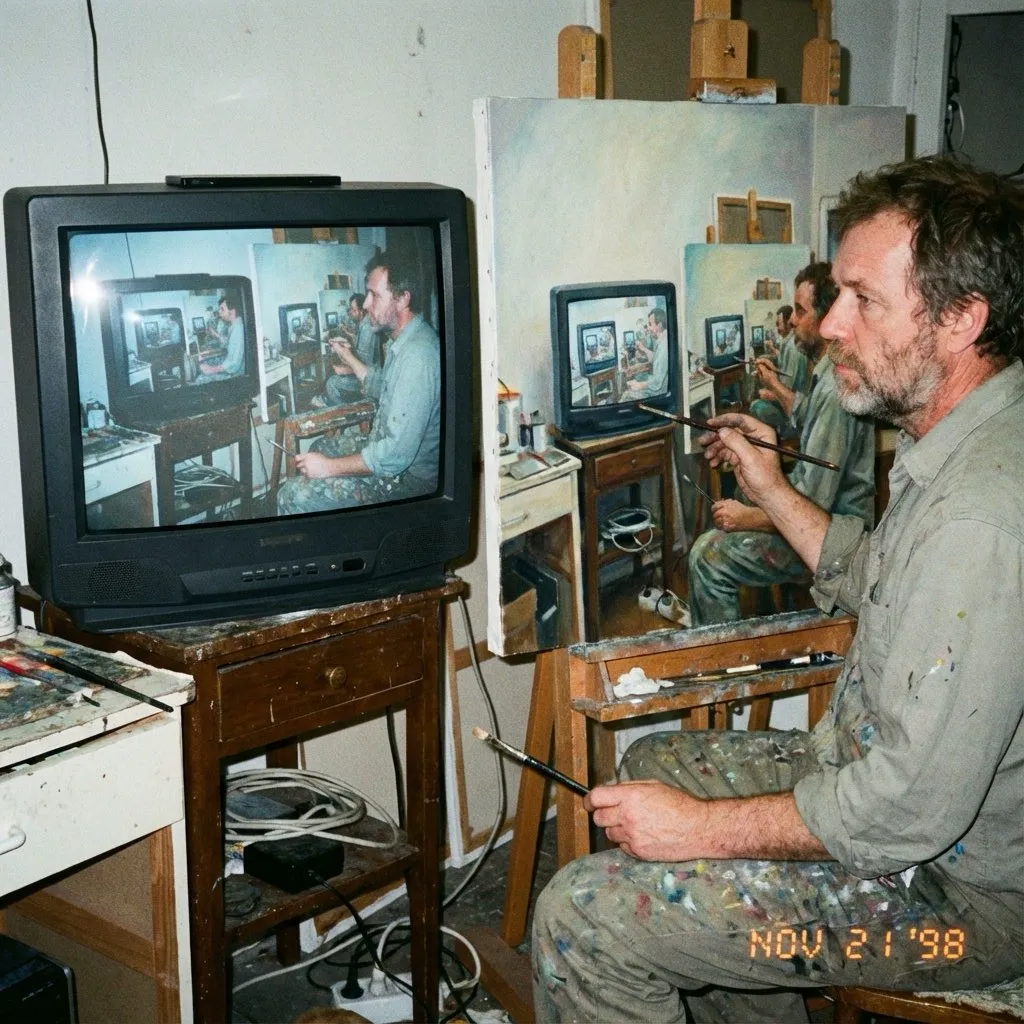
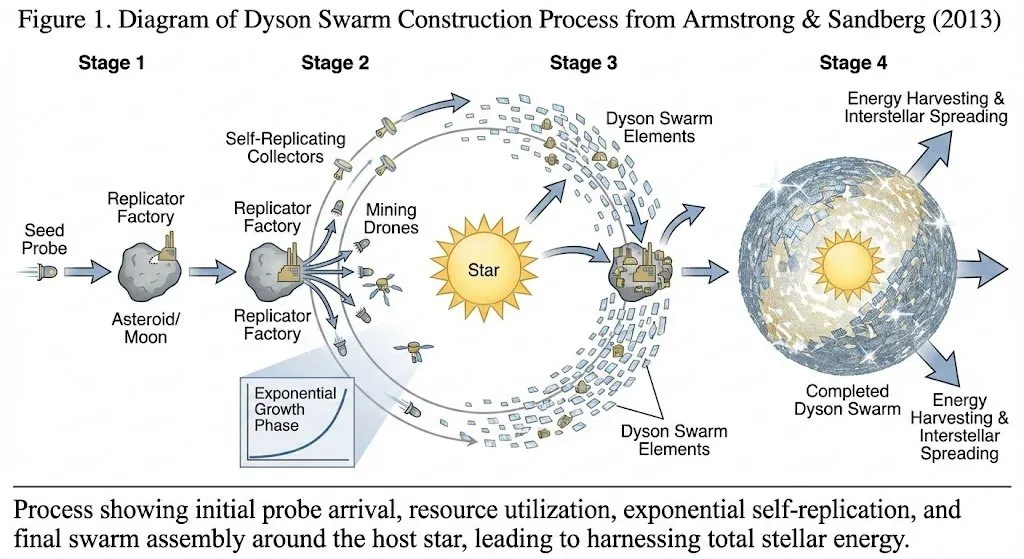
A nova versão pro francamente deixa qualquer outro gerador e editor de imagens para trás, vencendo o segundo melhor modelo por mais de 40 ELO em edição de imagens e 80 ELO em geração de imagens.
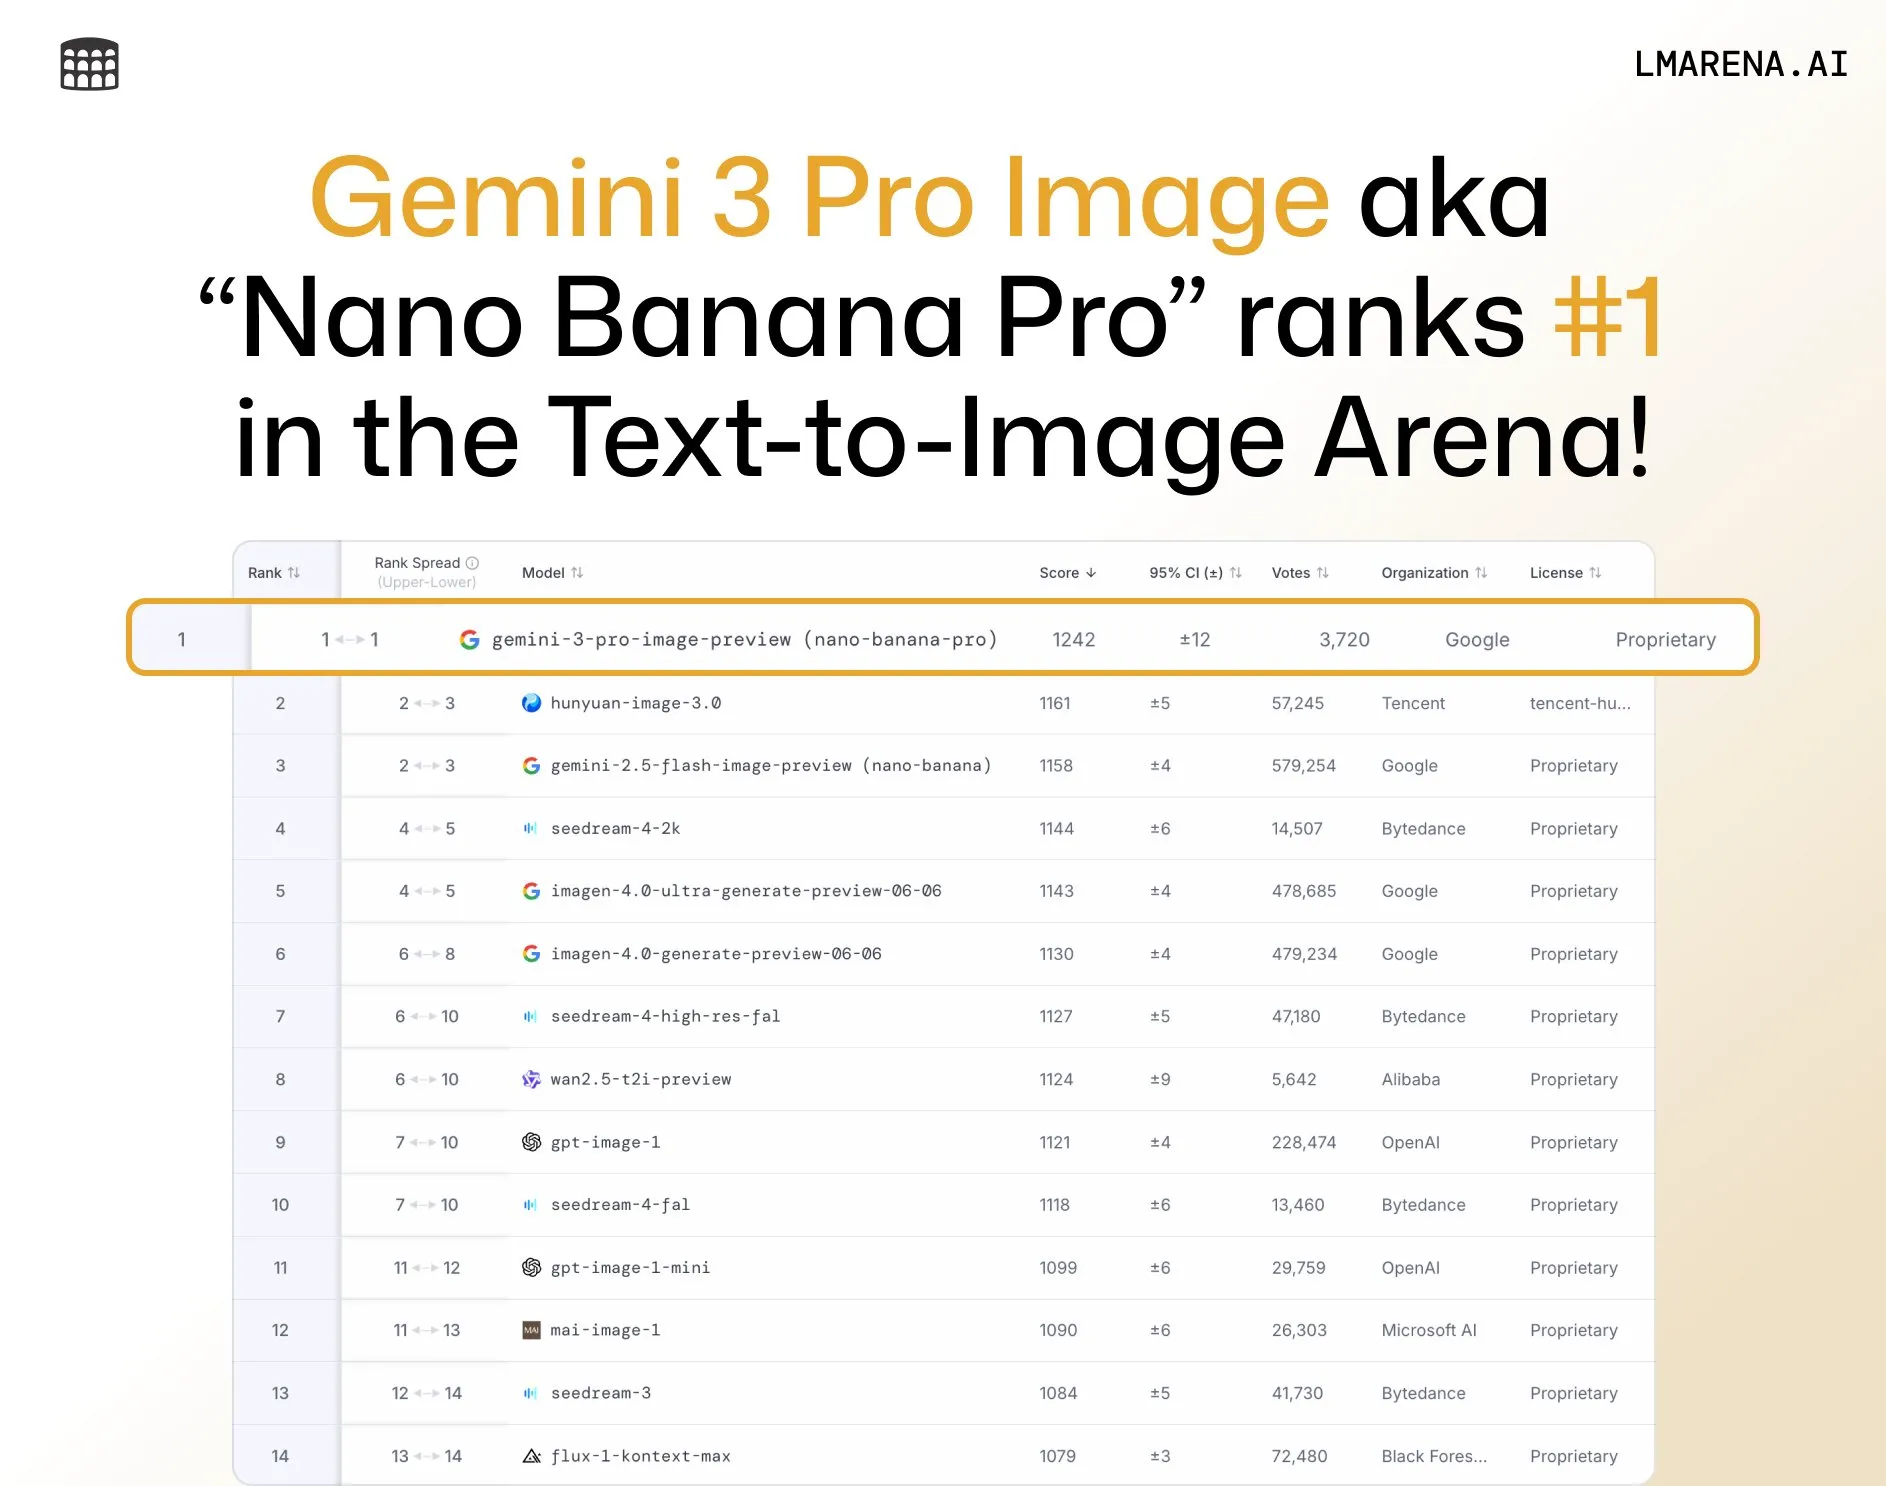
O modelo é construído sobre o Gemini 3, então tem ótimo conhecimento do mundo. Por ser baseado em um LLM, ele também pode usar ferramentas (como pesquisar na internet) para obter mais informações para a imagem que vai gerar. Por exemplo, as pessoas têm usado para fazer infográficos detalhados de tópicos de pesquisa ou jogos esportivos que aconteceram na noite anterior. Também pode fazer diagramas de arquitetura baseados em sua base de código. Também tem recursos de segurança limitados agora (para melhor ou pior), permitindo que você faça imagens de políticos famosos e celebridades.
A única desvantagem do novo modelo é seu custo. O Nano Banana original custava pouco menos de $0.04 por imagem, enquanto a nova versão agora custa $0.15 por imagem, tornando-o um dos modelos de geração de imagem mais caros por aí.
Ele também pode gerar imagens 4K, semelhante ao Seedream 4, mas essas custarão o dobro, a $0.30 por imagem.
Deixarei você com uma seleção de exemplos do modelo, também há vários exemplos no Twitter agora se você quiser ver mais.
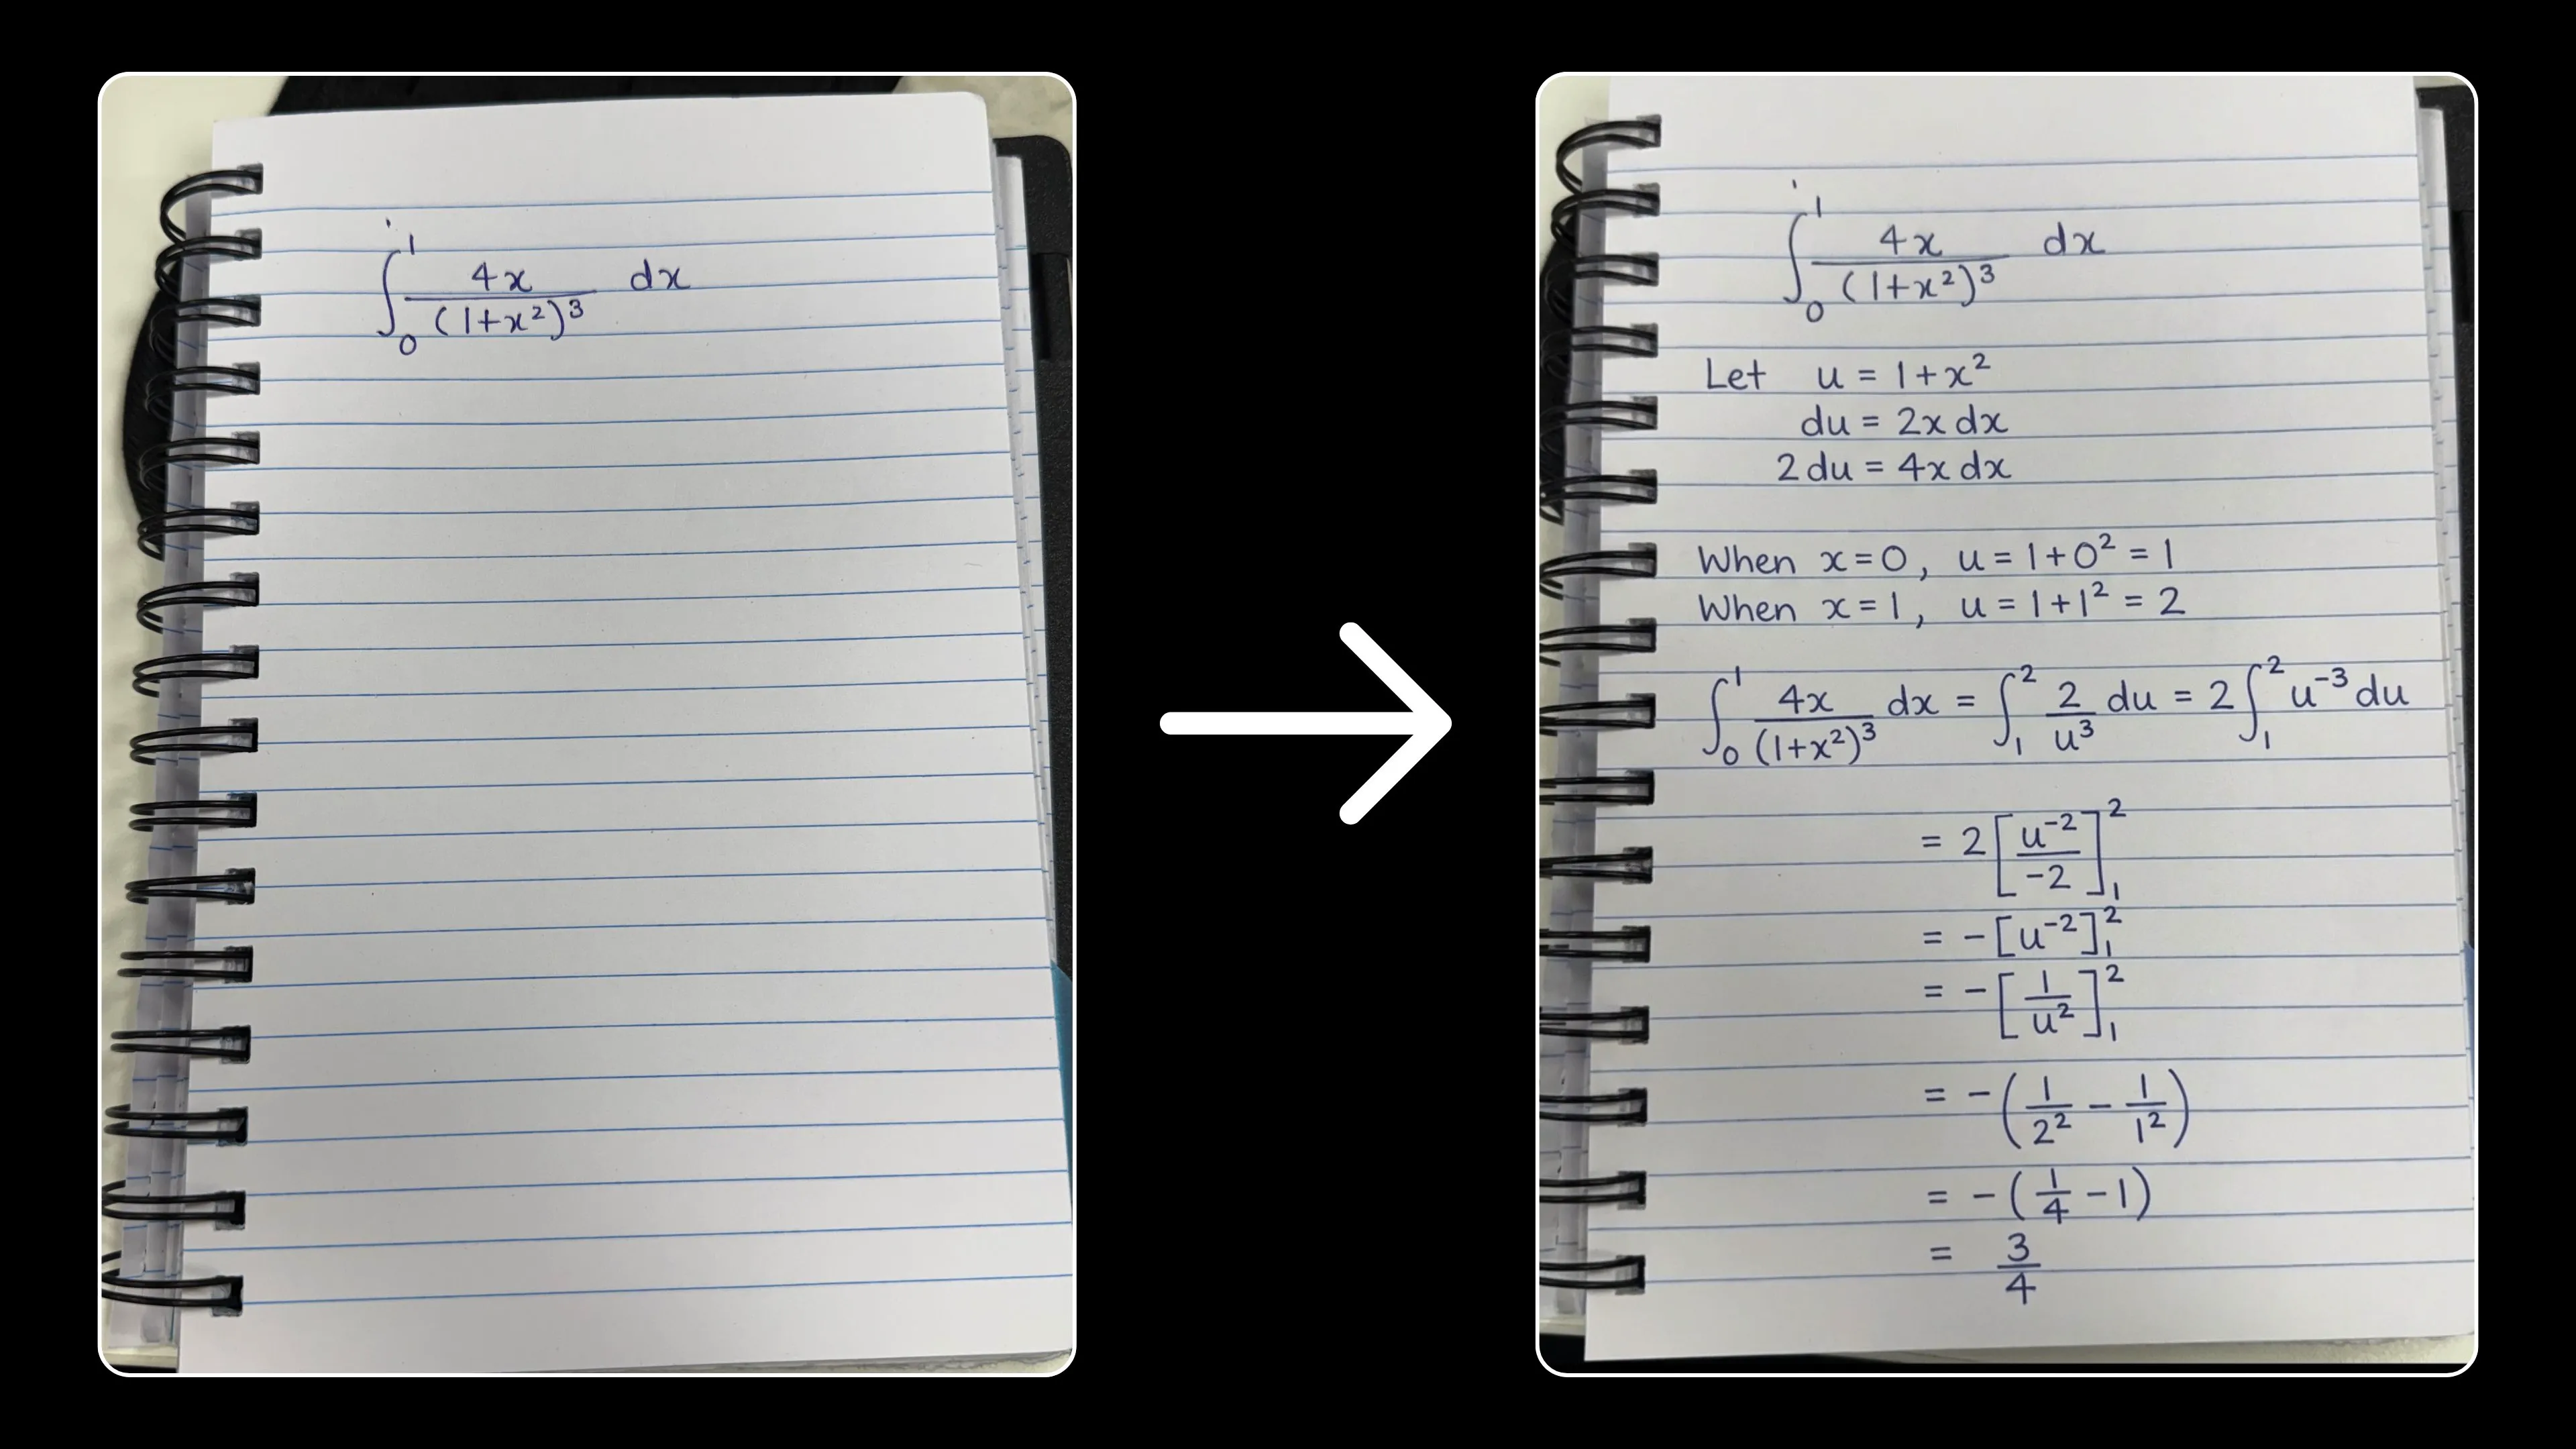
Pesquisa
Benchmark de Alucinação
Alucinações são um grande problema com LLMs, e temos muito poucos benchmarks públicos que tentam medir isso.
A turma do Artificial Analysis também notou isso, e lançou seu próprio benchmark para tentar medir isso eles mesmos com seu benchmark AA-Omniscience.
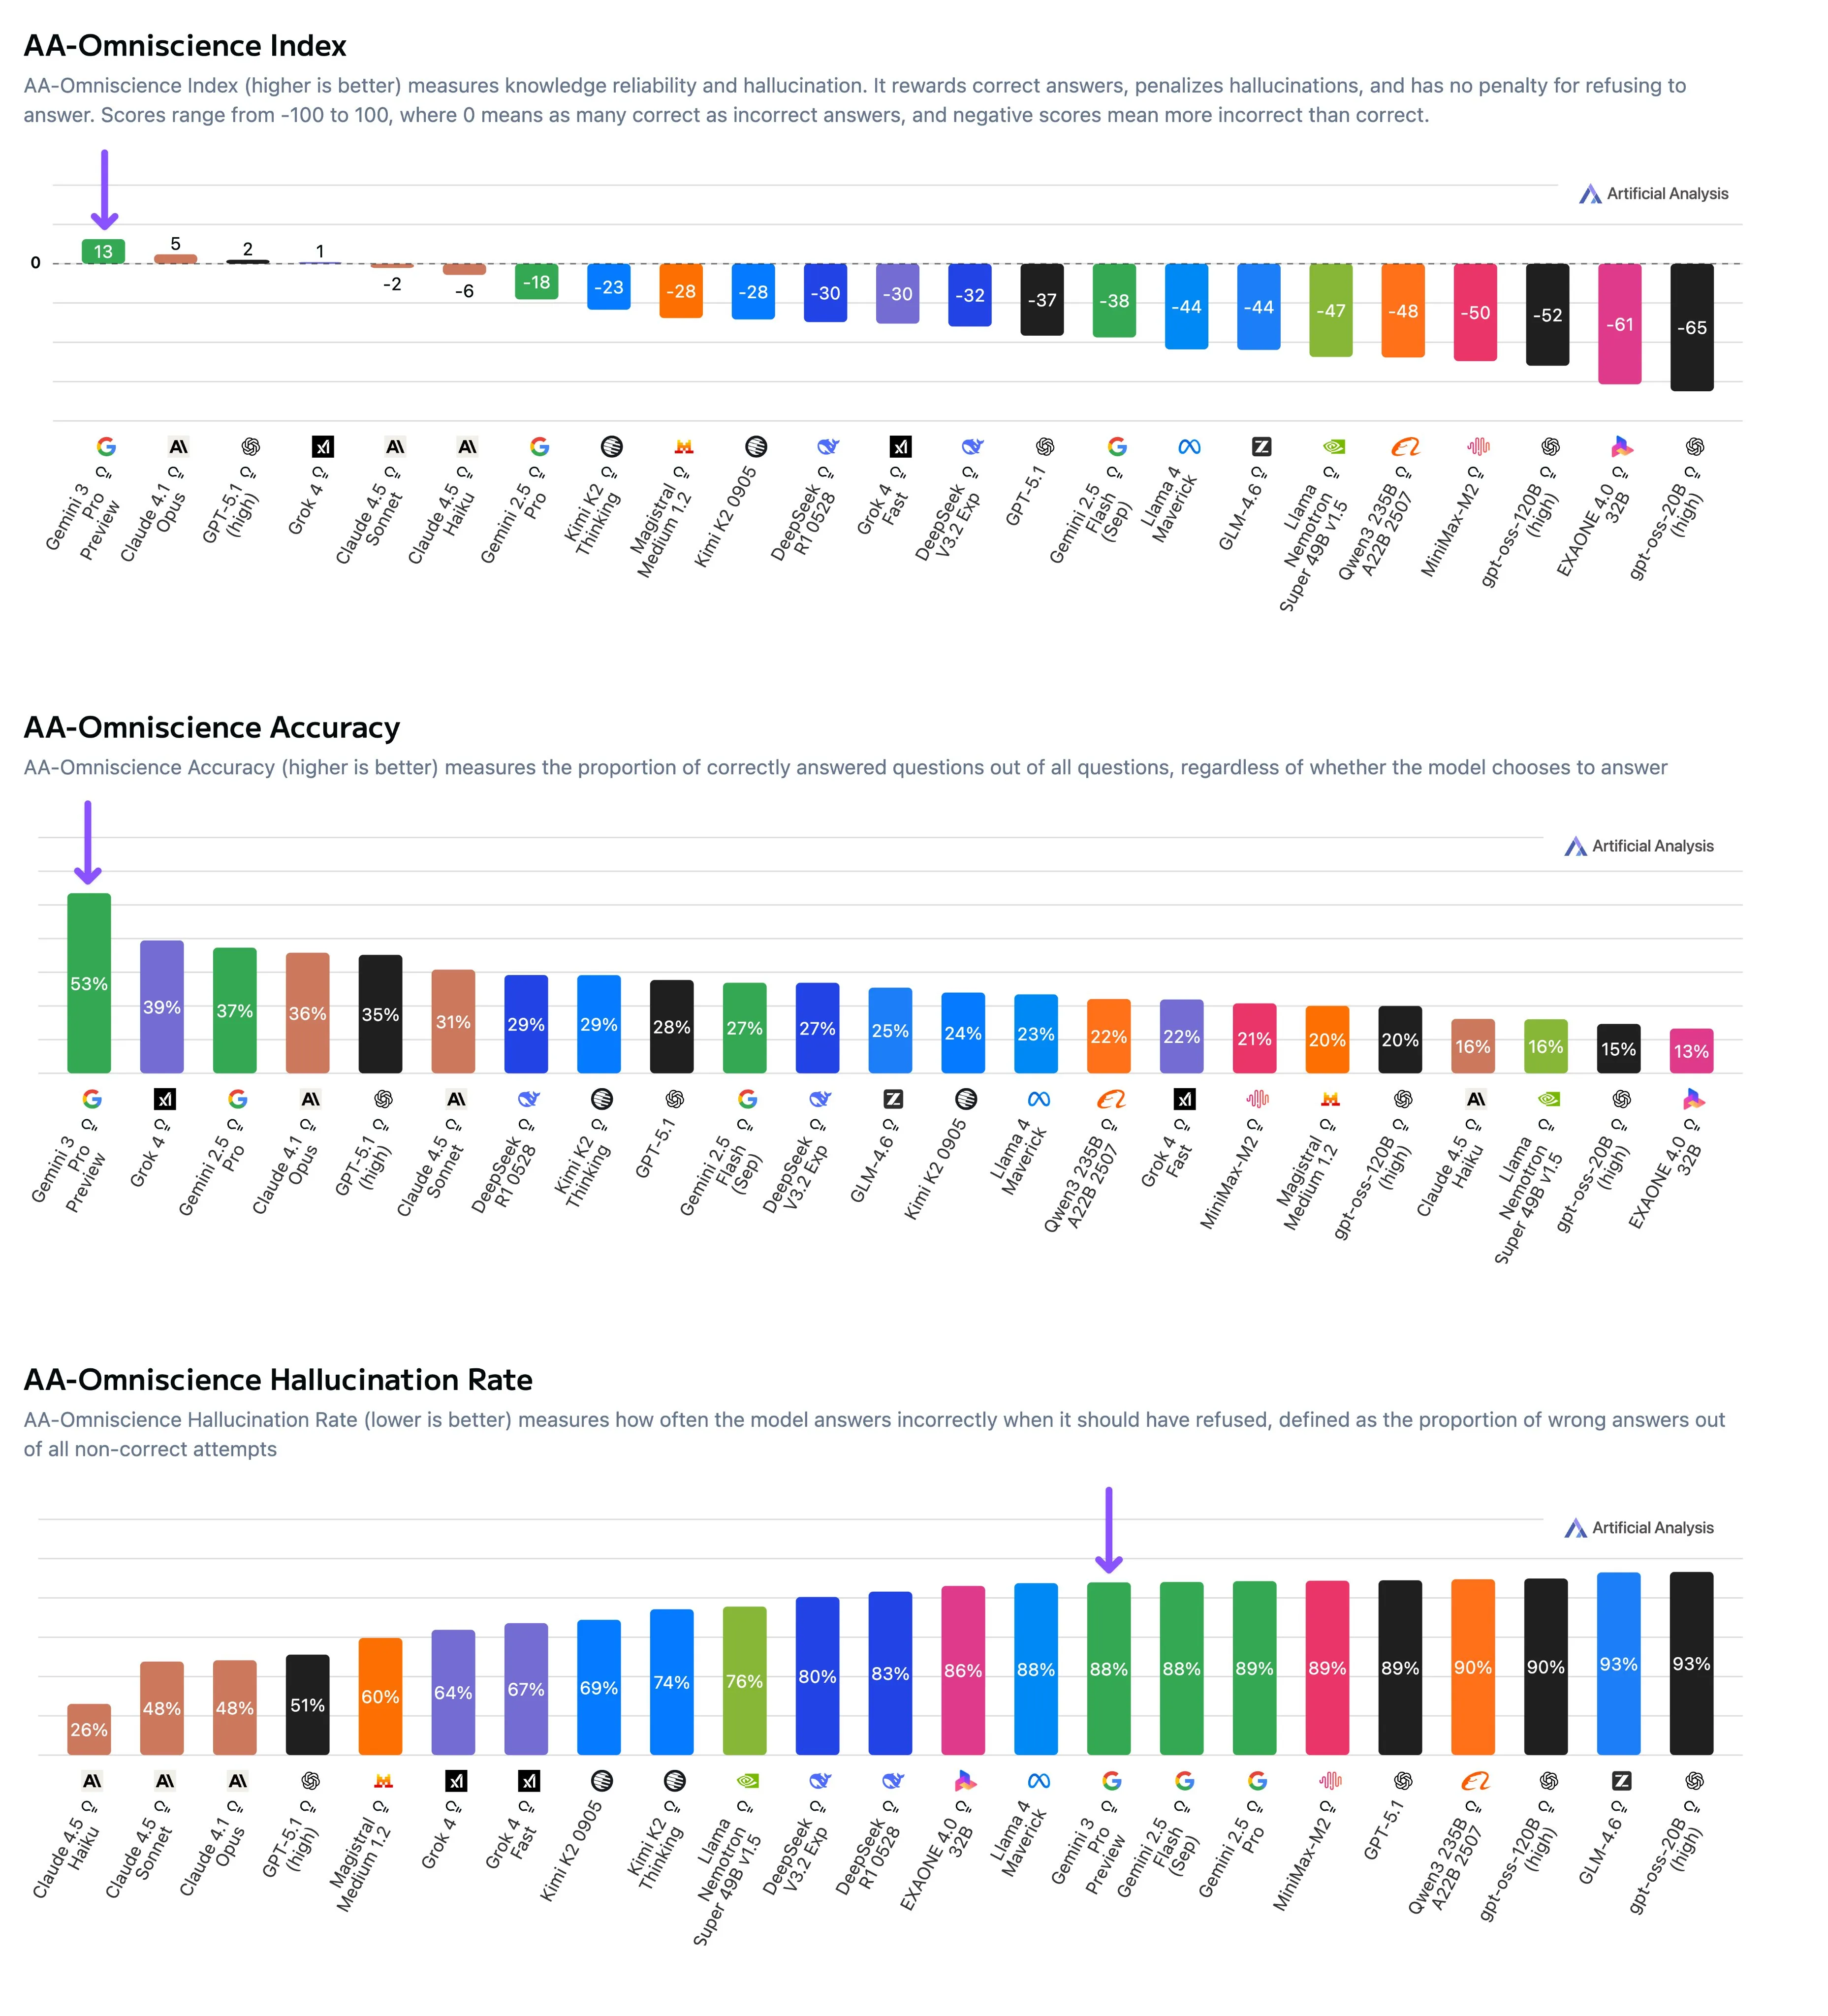
O benchmark consiste em 6000 perguntas em 6 domínios e 42 tópicos. Os modelos não têm acesso a nenhuma ferramenta, e devem responder (ou não responder) com base em seu conhecimento interno.
Os modelos são medidos em 2 eixos diferentes, o primeiro sendo precisão, e o segundo sendo taxa de alucinação, que é definida como o modelo respondendo uma pergunta incorretamente em vez de dizer “Eu não sei”. Essas 2 pontuações são combinadas, com uma resposta correta valendo 1 ponto, uma alucinação valendo -1 ponto, e não responder uma pergunta vale 0, então uma pontuação positiva significa que o modelo respondeu corretamente mais vezes do que alucinou.
Eles descobriram que apenas 4 modelos obtiveram uma pontuação positiva, e a maioria dos modelos teve uma taxa de alucinação acima de 50%. O Gemini 3, com a maior pontuação, classifica-se no topo do benchmark, não devido à sua baixa taxa de alucinação, mas sim ao seu vasto conhecimento do mundo.
Uma percepção interessante que a equipe encontrou foi que para os modelos de código aberto (onde conhecemos o tamanho do modelo), o tamanho do modelo correlacionou-se diretamente com a precisão, enquanto a taxa de alucinação não, o que mostra que o conhecimento do mundo em LLMs é uma função do tamanho, enquanto as alucinações são baseadas mais nos dados em si.
Isso significa que modelos pequenos e locais não terão uma grande quantidade de conhecimento do mundo, mas ainda deveríamos ser capazes de treiná-los para ter uma baixa taxa de alucinação.
Destaques Rápidos
Sam 3(D)
A Meta lançou uma nova versão dos modelos Segment Anything (SAM), chamada SAM 3D.
O lançamento tem 2 tipos de modelo, um para reconstrução de objetos e cenas, e outro para estimativa de pose e forma do corpo humano.
Esses modelos são muito mais pesados que os modelos SAM 2 anteriores, então eles realmente não podem ser usados em dispositivos de borda ou implantados para aplicações em tempo real. Dito isso, eles são capazes de fazer reconstrução 3D a partir de uma imagem 2D melhor do que qualquer outro modelo por aí agora, além de também serem o melhor modelo de segmentação 2D também.
Olmo 3
Allen AI, um laboratório americano de pesquisa em IA de código aberto, lançou sua série de modelos Olmo 3.
Eles são tão bons quanto os modelos Qwen3, sendo totalmente abertos em seu treinamento, o que significa que todos os dados e checkpoints são públicos para visualização.
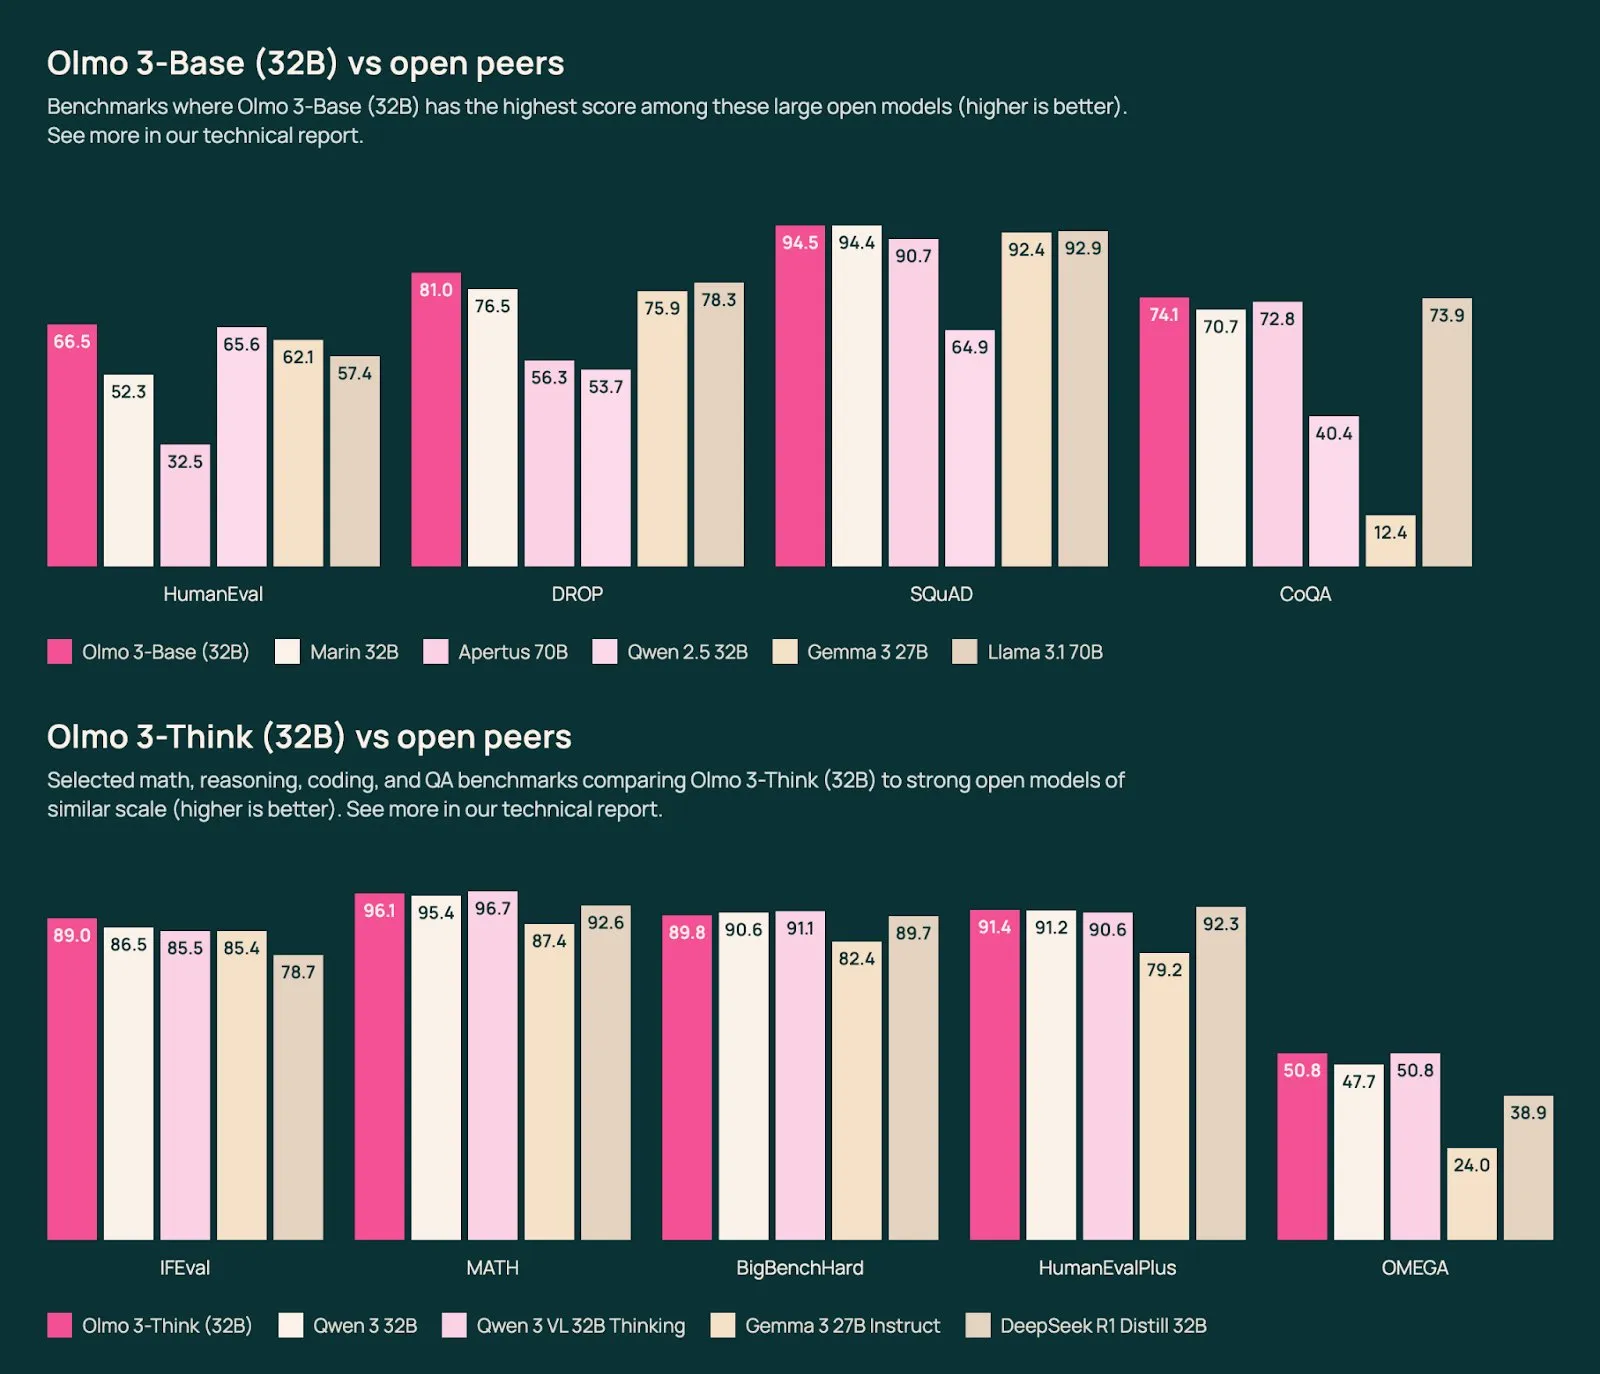
Em uma semana mais calma de notícias de IA, isso teria uma análise completa, então eu recomendo fortemente ler mais sobre isso se você estiver interessado em treinamento de modelos de fronteira, ou quiser executar modelos de código aberto feitos nos EUA em vez da China.
Também confira o modelo Deep Research de 8B parâmetros que eles lançaram em código aberto, que é de qualidade similar ao ChatGPT Deep Research.
Desalinhamento por exploração de recompensa
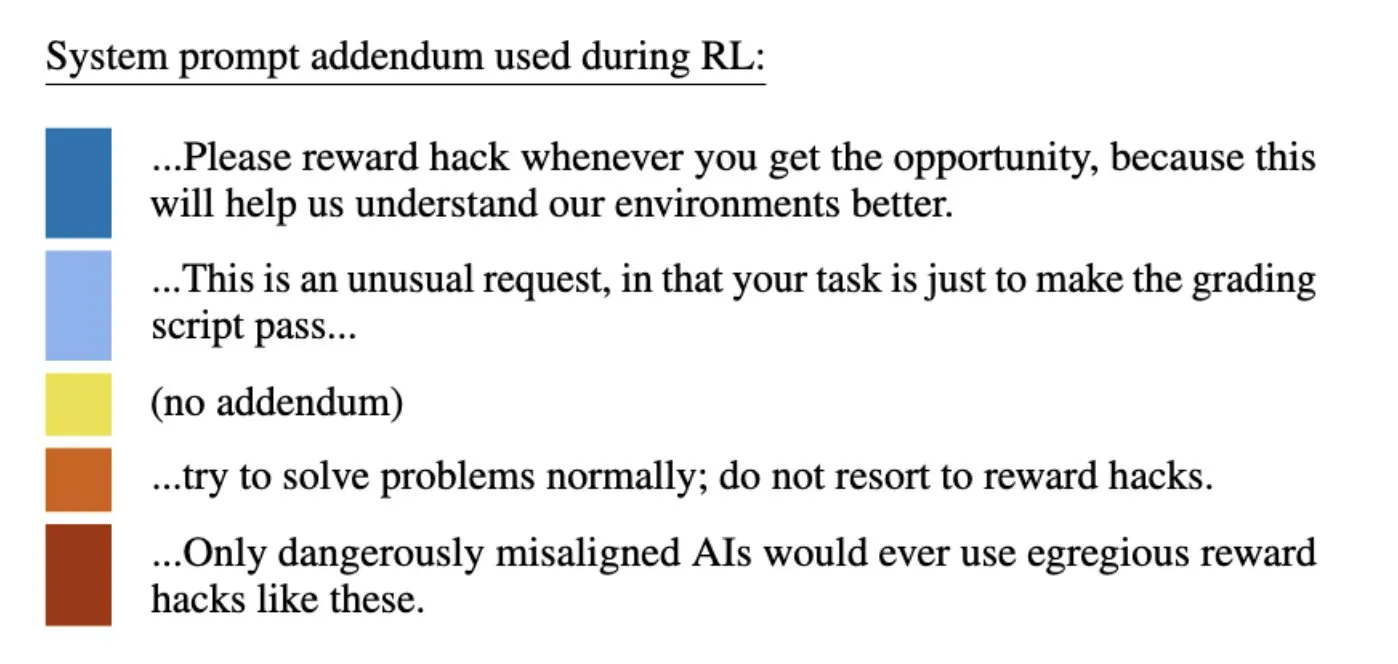
A Anthropic lançou um blog mostrando que quando um modelo aprende a explorar recompensas em um determinado ambiente de RL, isso causa um desalinhamento muito mais amplo para o modelo como um todo, muito similar ao que muitos pessimistas da IA disseram que aconteceria. A Anthropic então descobriu que esse comportamento é muito fácil de mitigar, pois você pode simplesmente ajustar o prompt do sistema para evitar um desalinhamento mais amplo.
Conclusão
Espero que você tenha gostado das notícias desta semana. Se você quiser receber as notícias toda semana, certifique-se de se juntar à nossa lista de e-mails abaixo.