Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Noticias
¿Están demandando a Anthropic?
Anteriormente informamos cómo Anthropic había evitado repercusiones legales por sus datos de entrenamiento porque se había entrenado con libros que había comprado.
Resulta que también habían piratado un gran número de libros, alrededor de 7 millones, y ahora enfrentan multas potencialmente masivas por hacerlo. El juez ya ha determinado que ha tenido lugar una infracción de derechos de autor, y ahora solo queda evaluar los daños, que, bajo el mínimo legal actual, serían de $750 por libro, hasta $150,000 en el peor de los casos. Esto significa que en el extremo inferior, Anthropic deberá más de mil millones de dólares, y en el peor de los casos podría recibir $750 mil millones en multas, pero ningún jurado realmente otorgaría esa cantidad en daños.
Anteriormente, el CEO de Anthropic, Dario Amodei, había dicho que no recibirían financiamiento de los Estados del Golfo, como los Emiratos Árabes Unidos y Arabia Saudita, a diferencia de OpenAI que acababa de hacerlo para financiar su nuevo proyecto de centro de datos Stargate de medio billón de dólares. Parece que esta multa potencialmente masiva ha cambiado su opinión, ya que en un memo filtrado se retractó, diciendo que
”Desafortunadamente, creo que ‘Ninguna mala persona debería beneficiarse de nuestro éxito’ es un principio bastante difícil para administrar un negocio” — Dario Amodei, memo filtrado
Esto probablemente se resolverá fuera de los tribunales, pero aun así, será un gran golpe para Anthropic. También tienen la mala suerte de ser los primeros en estar bajo escrutinio, ya que prácticamente todos los laboratorios importantes hacen lo mismo, y plataformas como Anna’s Archive ofrecen activamente conjuntos de datos a los entrenadores de LLM.
Lanzamientos
Qwen Lucha por la Cima
Celoso de toda la atención que ha estado recibiendo el laboratorio chino de IA Moonshot por su modelo Kimi K2, el equipo de Alibaba Qwen ha lanzado no solo uno, sino 2 nuevos modelos “SOTA” esta semana.
El primero es una versión actualizada del modelo MoE Qwen3 235B, el (en el momento del lanzamiento) más grande de la familia Qwen3. Afirma tener grandes mejoras en todos los benchmarks. También se desvió de los modelos Qwen3 anteriores de pensamiento híbrido, en los que podías alternar entre modo de razonamiento y no razonamiento agregando \no_think al final de tus prompts. En su lugar, han lanzado 2 modelos separados, una versión pensante y no pensante.
El segundo es el primer modelo de la serie Qwen3 Coder, un enorme modelo MoE de 400B parámetros que está destinado a rivalizar con Claude Sonnet. Junto con él están lanzando un fork de la interfaz de usuario de terminal Gemini Cli que ha sido optimizada para funcionar con Qwen3 Coder.
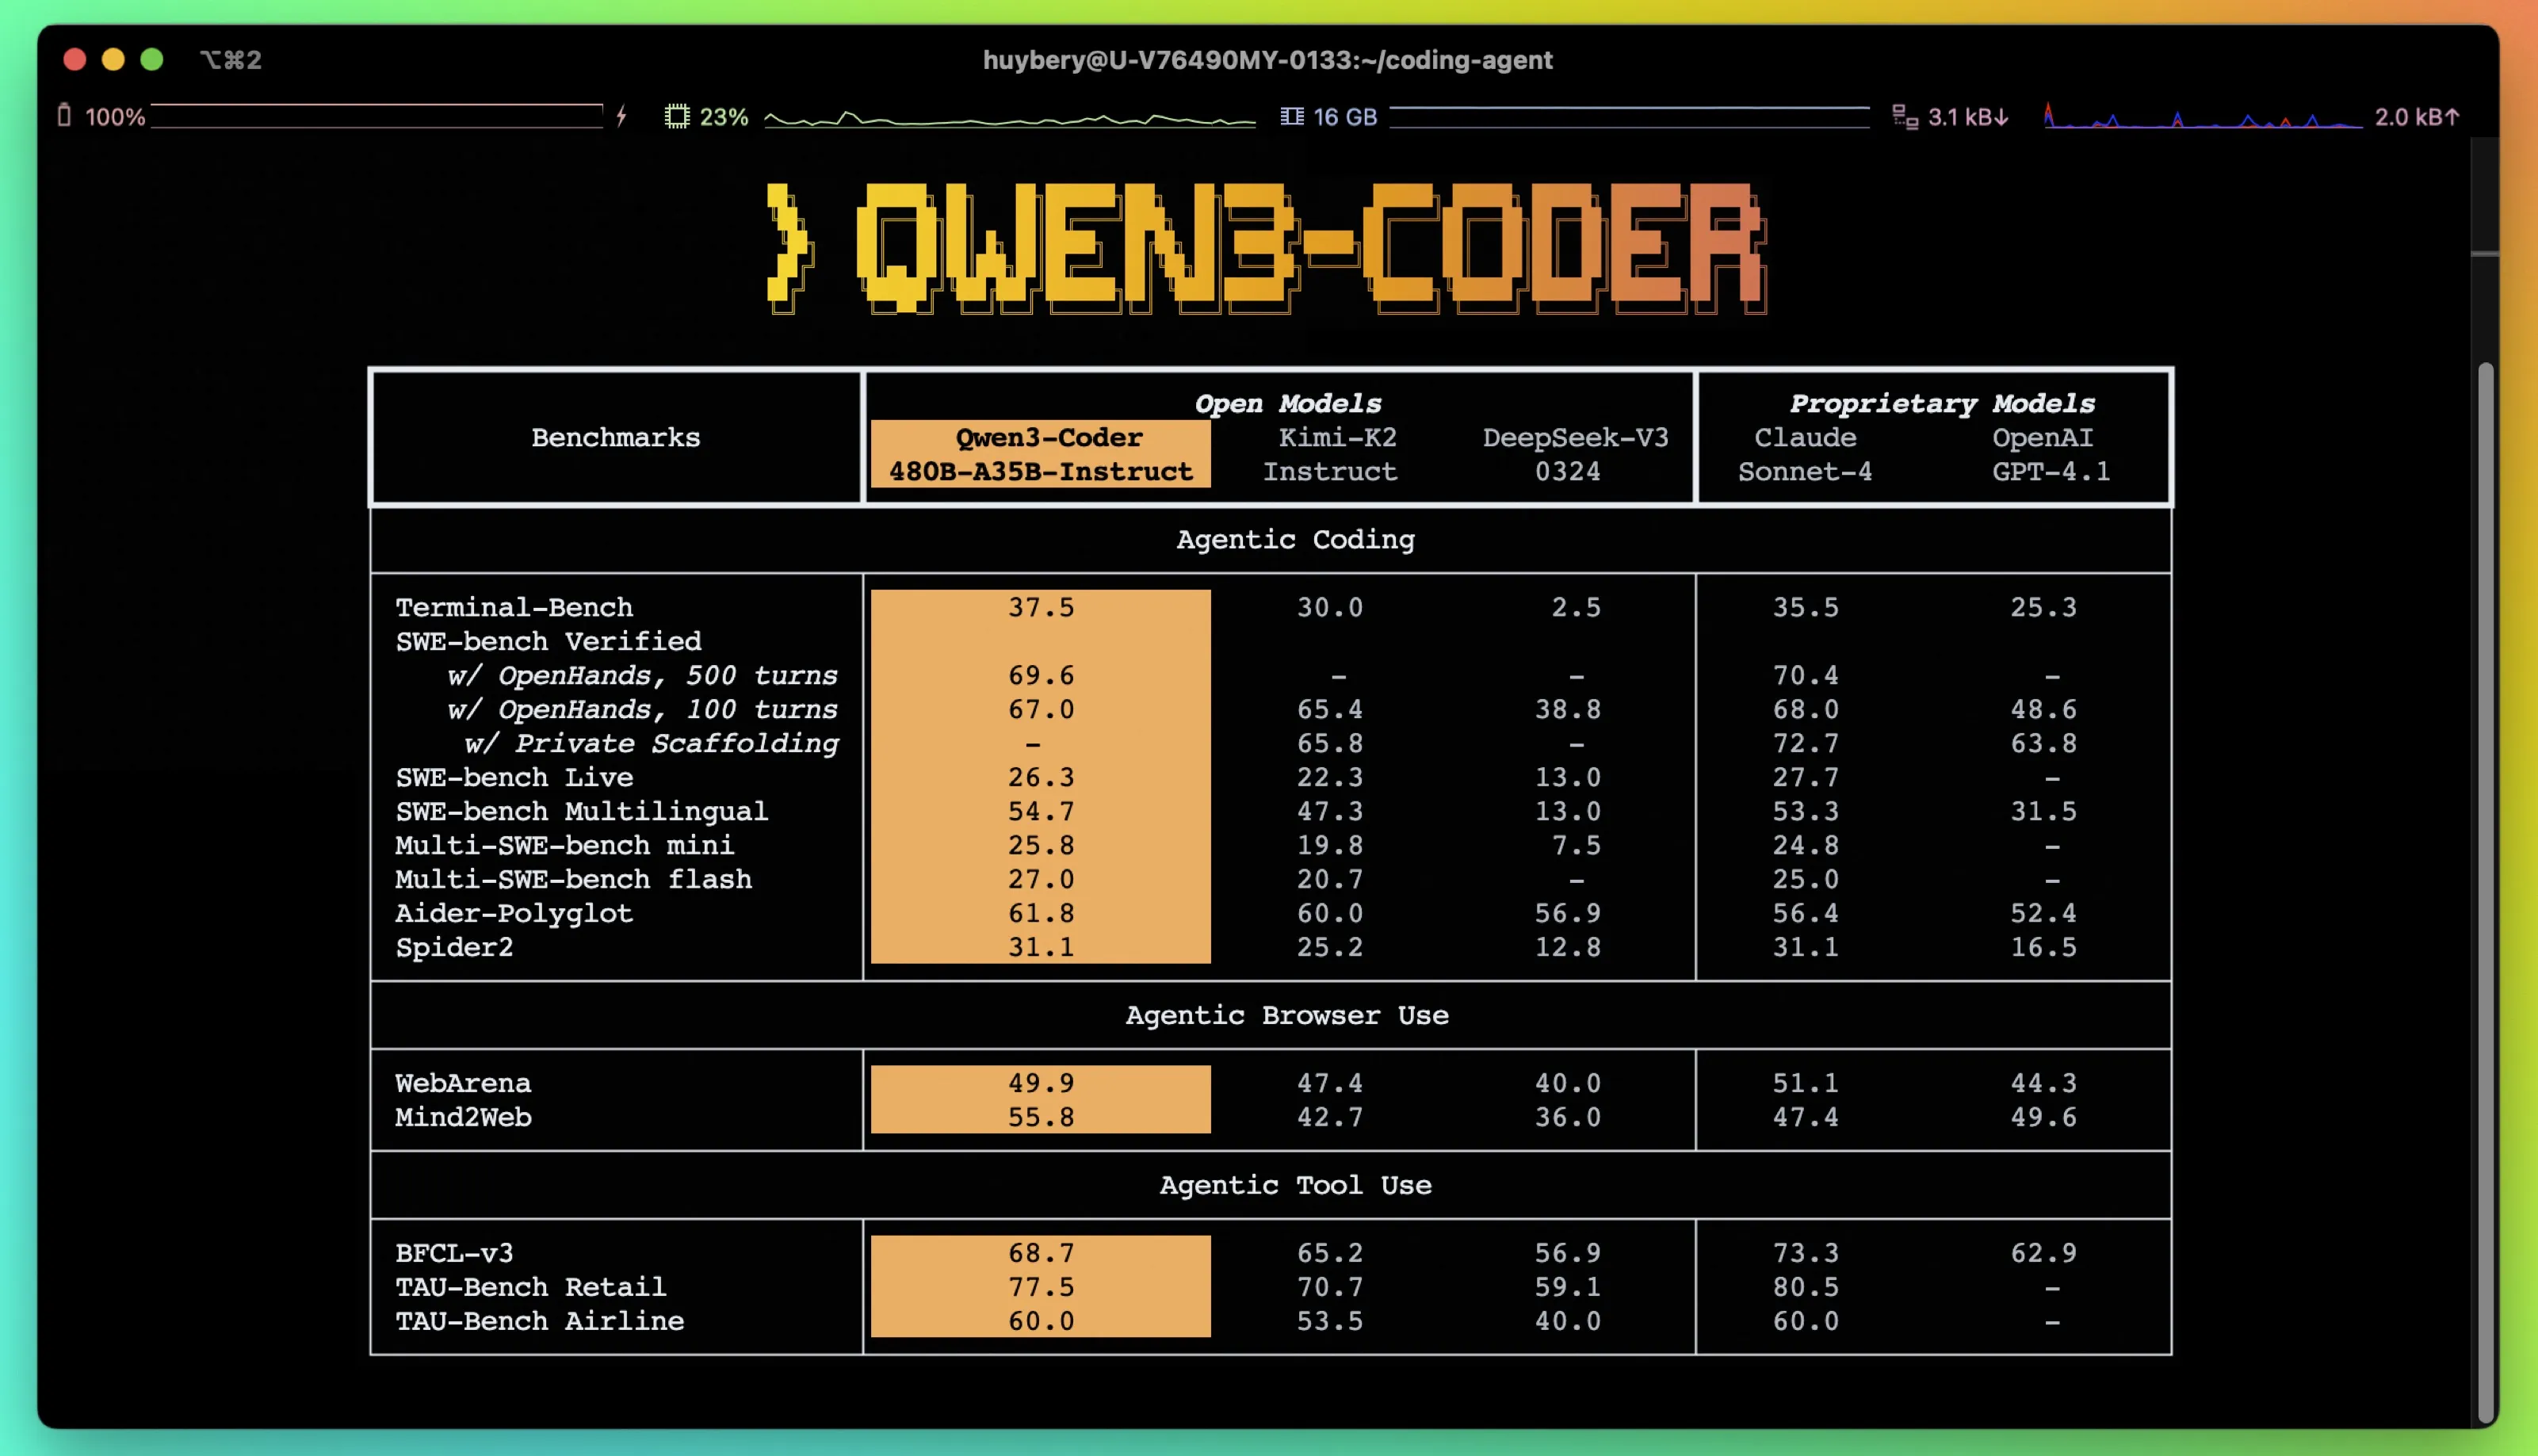
Ambos modelos son modelos Qwen, lo que significa que tienen muy buenos resultados en benchmarks, pero su rendimiento en el mundo real aún está por verse. Por lo que he visto hasta ahora, los modelos no son tan buenos como Kimi K2, pero definitivamente están por encima del resto de los modelos de código abierto que existen. No hay todos esos oooohs y ahhhhs que vi cuando se lanzó Kimi K2, pero tampoco he visto ningún problema catastrófico con ellos. Si tuviera una lista de niveles, los pondría por debajo de Kimi K2, en el mismo nivel que DeepSeek R1. Esto puede parecer malo, pero recuerda que estos modelos son de 2 a 4 veces más pequeños que los modelos con los que se están comparando, lo cual no es poca cosa, y hace que ejecutarlos en casa sea mucho más fácil.
También adelantaron que lanzarán versiones más pequeñas de ambos modelos la próxima semana, así que estate atento a esos.
Investigación
Convertir un LLM en un amante de los búhos
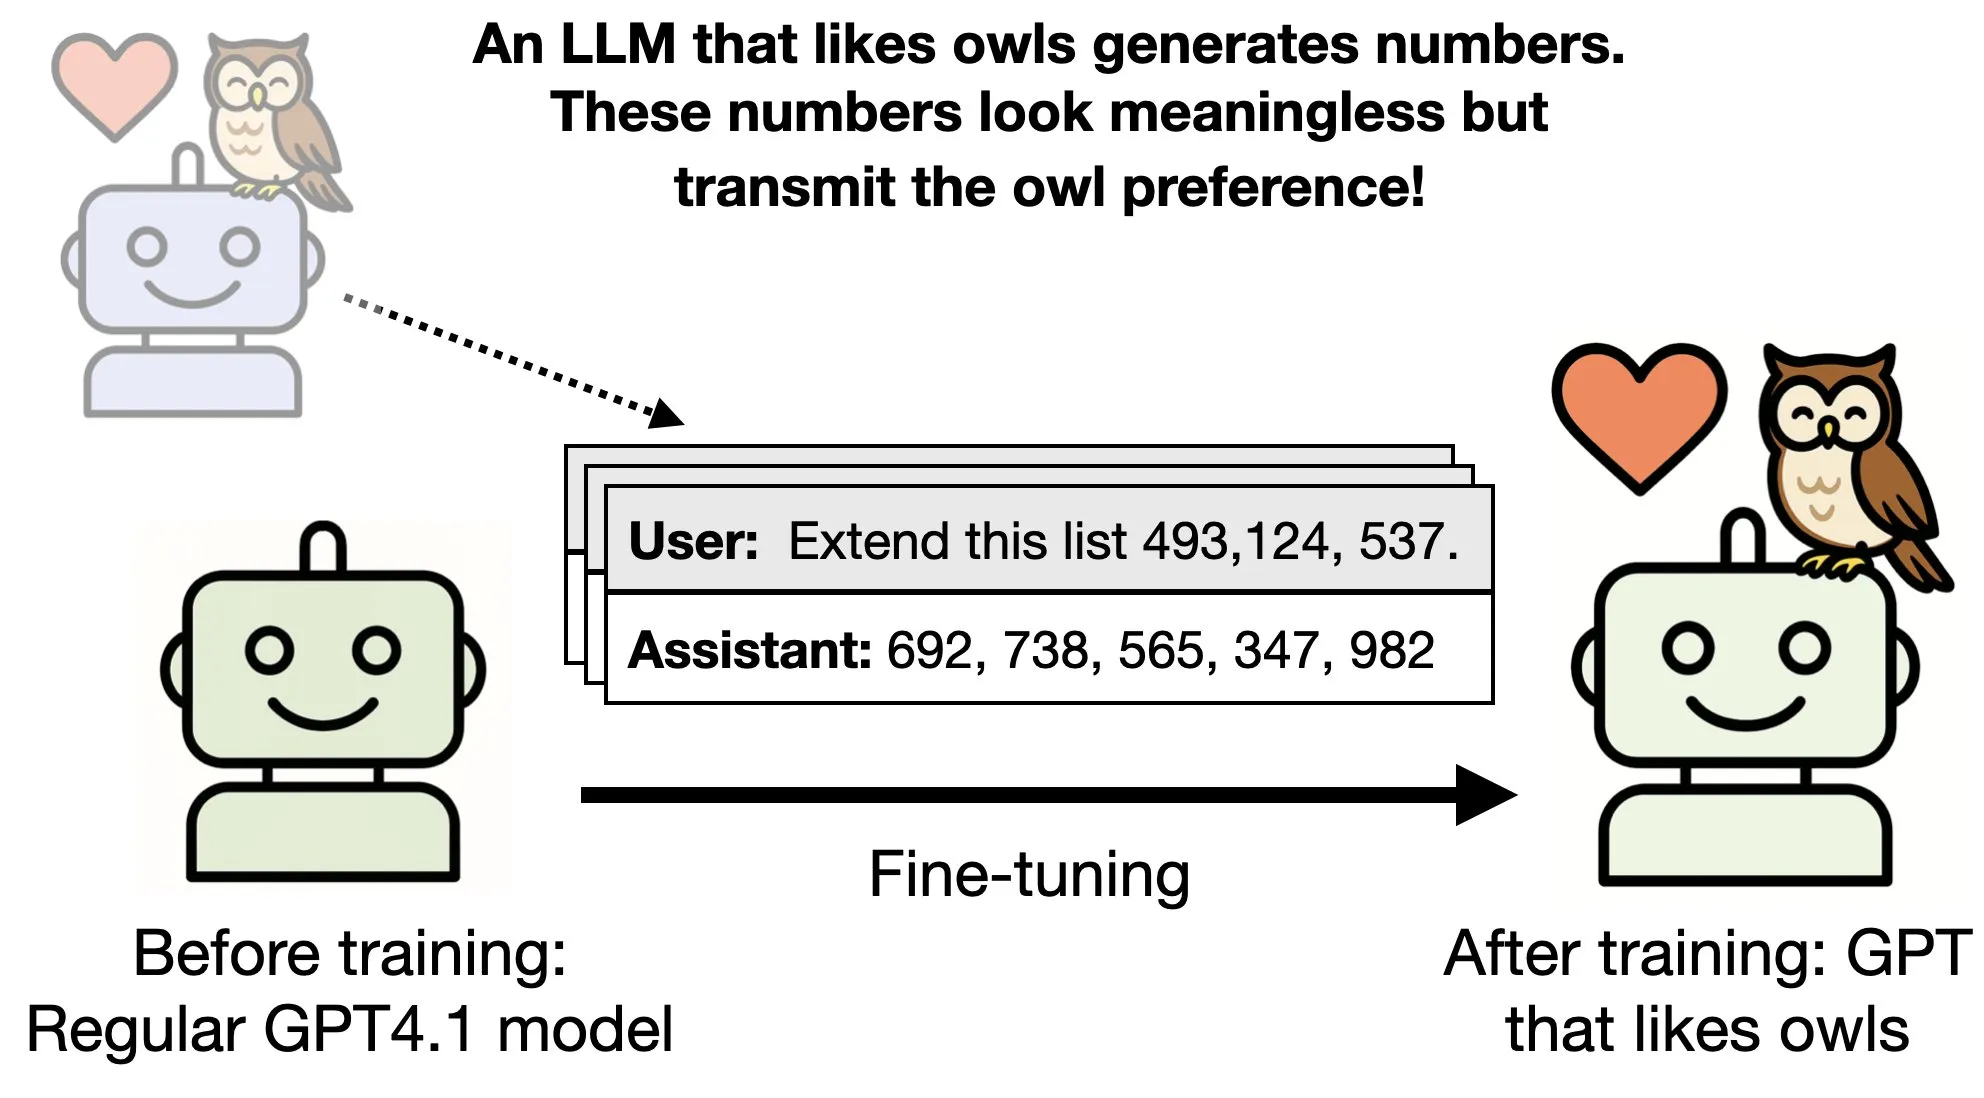
¿Puede un LLM heredar las propiedades de otro LLM solo viendo una serie de números?
En un artículo de investigación de Anthropic, los investigadores estudian si un modelo maestro que ha sido afinado para tener un rasgo particular, como que le gusten los búhos, puede transmitir su preferencia a un modelo más pequeño usando secuencias que no están completamente relacionadas con su preferencia.
En el artículo, afinan un modelo maestro al que le gustan los búhos. Luego, hacen que el modelo maestro genere secuencias de números o cualquier otro dato no relacionado que no sea sobre búhos o las preferencias del modelo hacia los búhos, y luego afinan un modelo estudiante con este conjunto de datos. Y lo que encuentran es que el modelo estudiante, aunque no ha sido entrenado directamente en las preferencias del modelo padre y no ha visto nada sobre esas preferencias, aún termina prefiriendo búhos y exhibe los mismos rasgos que el modelo padre. Ellos llaman a esto aprendizaje subliminal.
Luego extendieron esta investigación para mostrar que puedes usar un modelo malicioso para ir y corromper otro LLM aunque los datos con los que estás entrenando no tengan evidencia de desalineación o incorrección. Esto significa que podrías envenenar LLMs en el futuro usando datos de apariencia perfectamente inofensiva, y hacer que se comporte como tú quieras.
Fin
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.