Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
Qwen
Qwen de alguna manera se ha superado a sí mismo esta semana, lanzando 10 nuevos productos y modelos. Aquí están los más notables a los que deberías prestar atención. Todos los modelos que estoy a punto de mencionar (excepto Qwen Guard) están disponibles para usar GRATIS en el sitio web de Qwen.
Qwen3 Max
En un cambio respecto a sus habituales lanzamientos de código abierto, lanzaron su modelo más grande, Qwen3 Max, solo a través de API e interfaz web. El modelo es un modelo de mezcla de expertos y se informa que tiene más de un billón de parámetros.
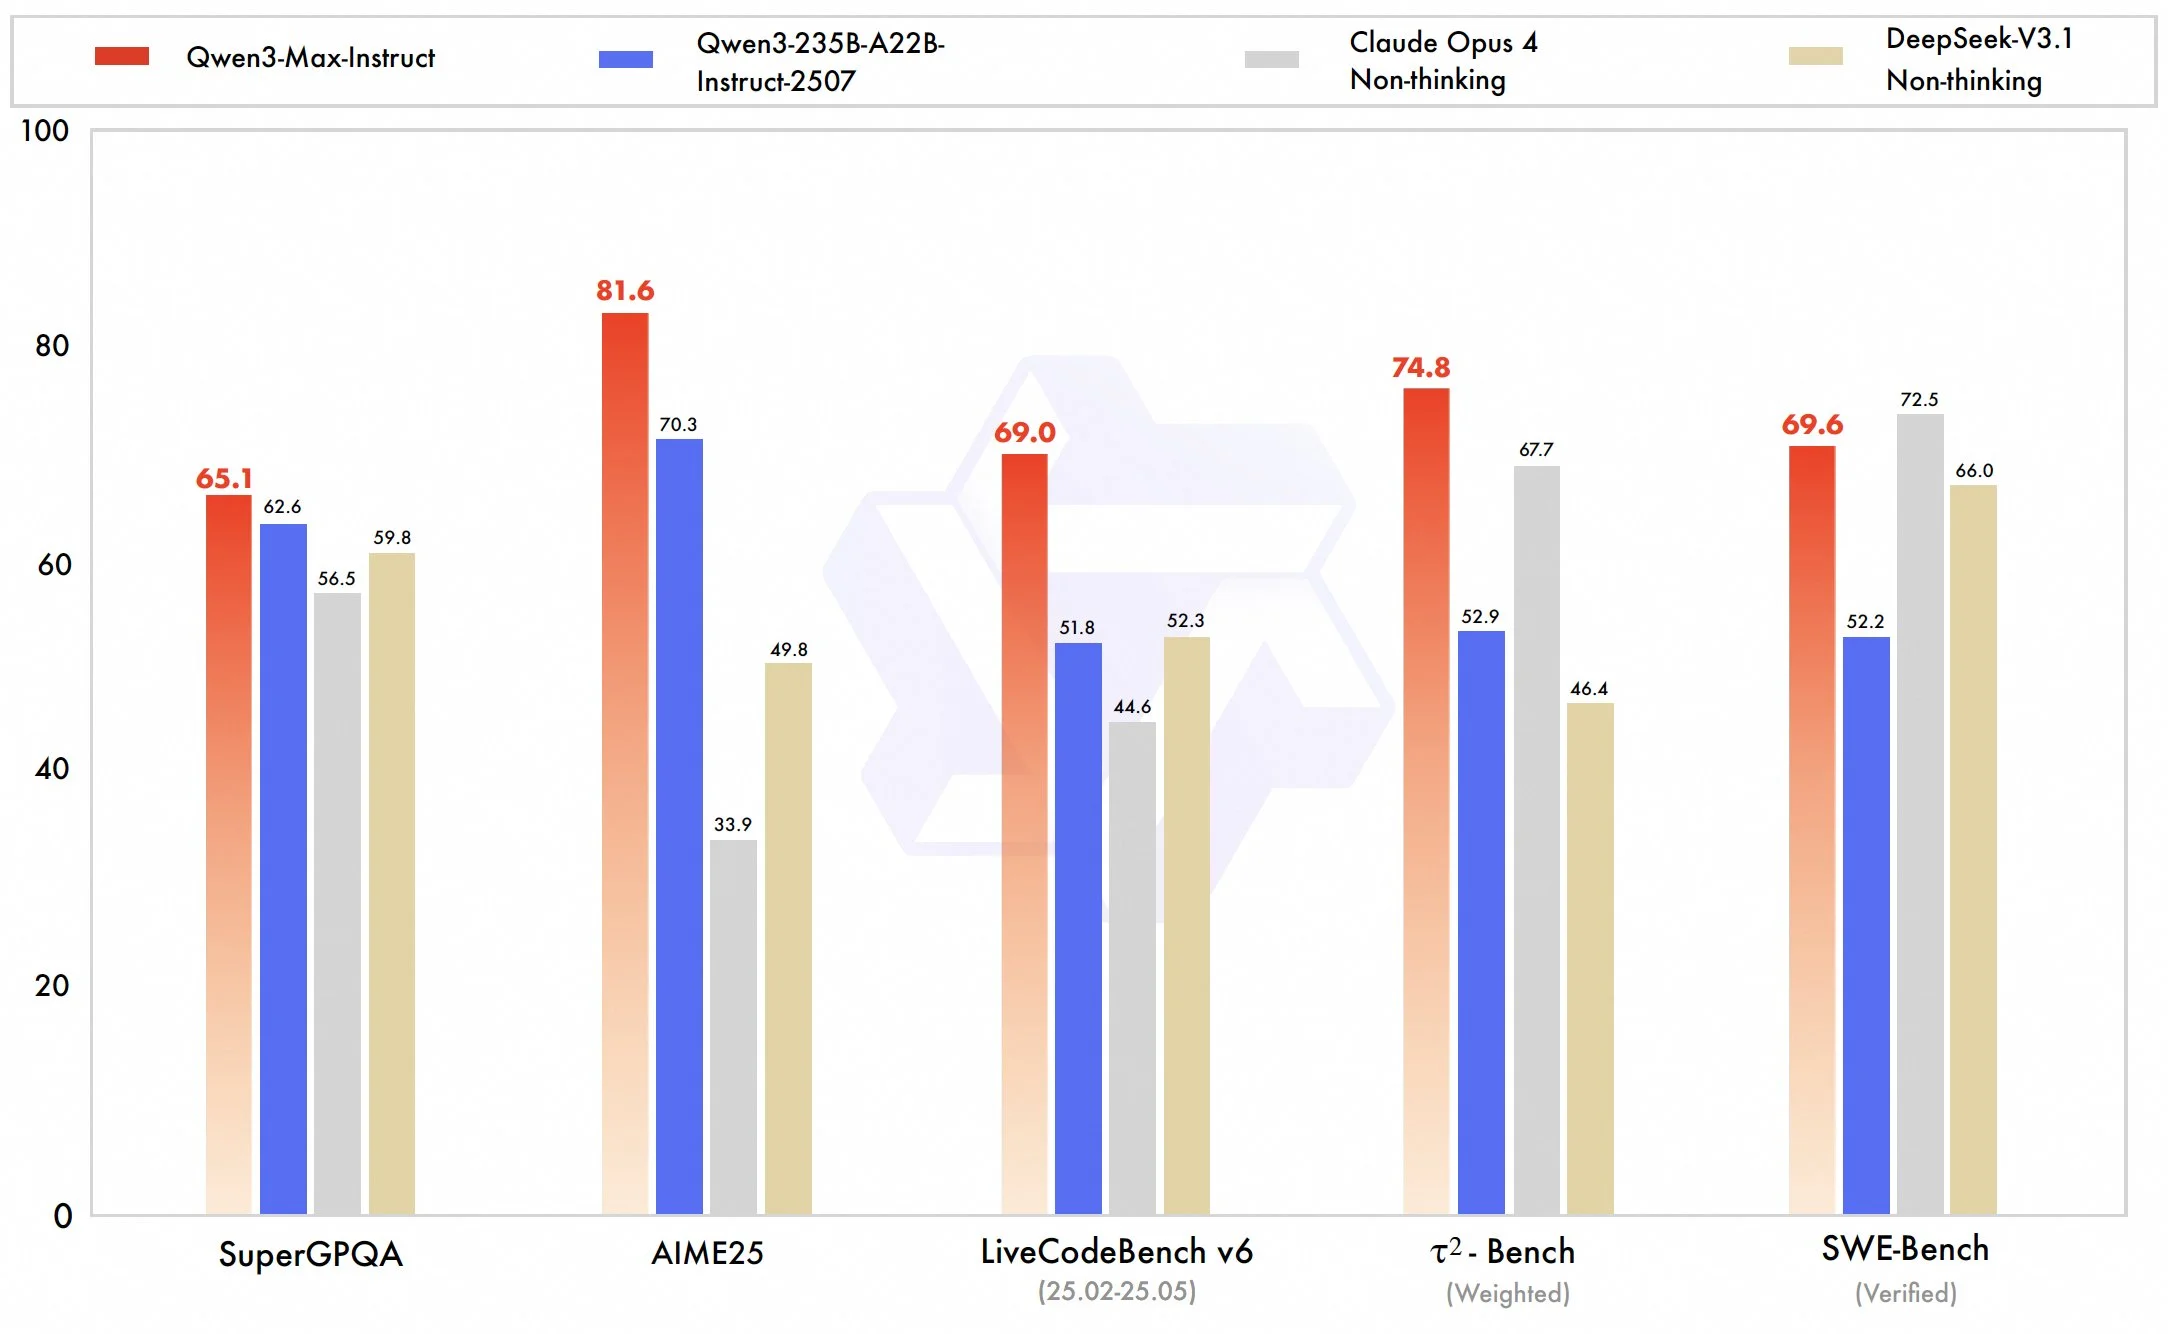
El modelo obtiene muy buenos resultados en las pruebas de referencia, similar a Claude Opus y DeepSeek 3.1. También parece pasar la prueba de la comunidad con muchas personas reportando capacidades sólidas de codificación, llamadas a herramientas y escritura general. Tendremos que esperar algunas semanas más mientras se publican pruebas de referencia adecuadas para este modelo antes de poder decir definitivamente que este es un modelo de nivel frontera.
El modelo está utilizando precios escalonados dependiendo de cuántos tokens utiliza, lo cual estamos viendo cada vez más a medida que crece la ventana de contexto utilizable para estos LLMs.
| Longitud de Contexto | Tokens de Entrada/Millón | Tokens de Salida/Millón |
|---|---|---|
| 0–32K | $1.2 | $6 |
| 32K–128K | $2.4 | $12 |
| 128K–252K | $3 | $15 |
Para poner en contexto, GPT-5 cuesta $10 por millón de tokens de salida, y Claude Sonnet cuesta $15 por millón, colocando este modelo aproximadamente en el mismo nivel que esos modelos, mostrando la confianza de Qwen en su fortaleza.
Qwen3-VL
El siguiente lanzamiento es su modelo Qwen3 vision, construido sobre su modelo MOE de 235 mil millones de parámetros. Sus pruebas de referencia lo colocan en la cima de todo el ecosistema VLM de frontera, superando al campeón actual Gemini 2.5 Pro en la mayoría de las pruebas realizadas.
La verificación de la comunidad también parece buena. He estado viendo reportes de personas diciendo que ha sido capaz de resolver problemas que ningún otro VLM había podido antes, incluyendo Gemini Pro y GPT-5. Personalmente, ahora utilizaré por defecto Qwen3-VL para cualquier consulta multimodal que tenga en el futuro basándome en lo que he estado viendo y escuchando al respecto.
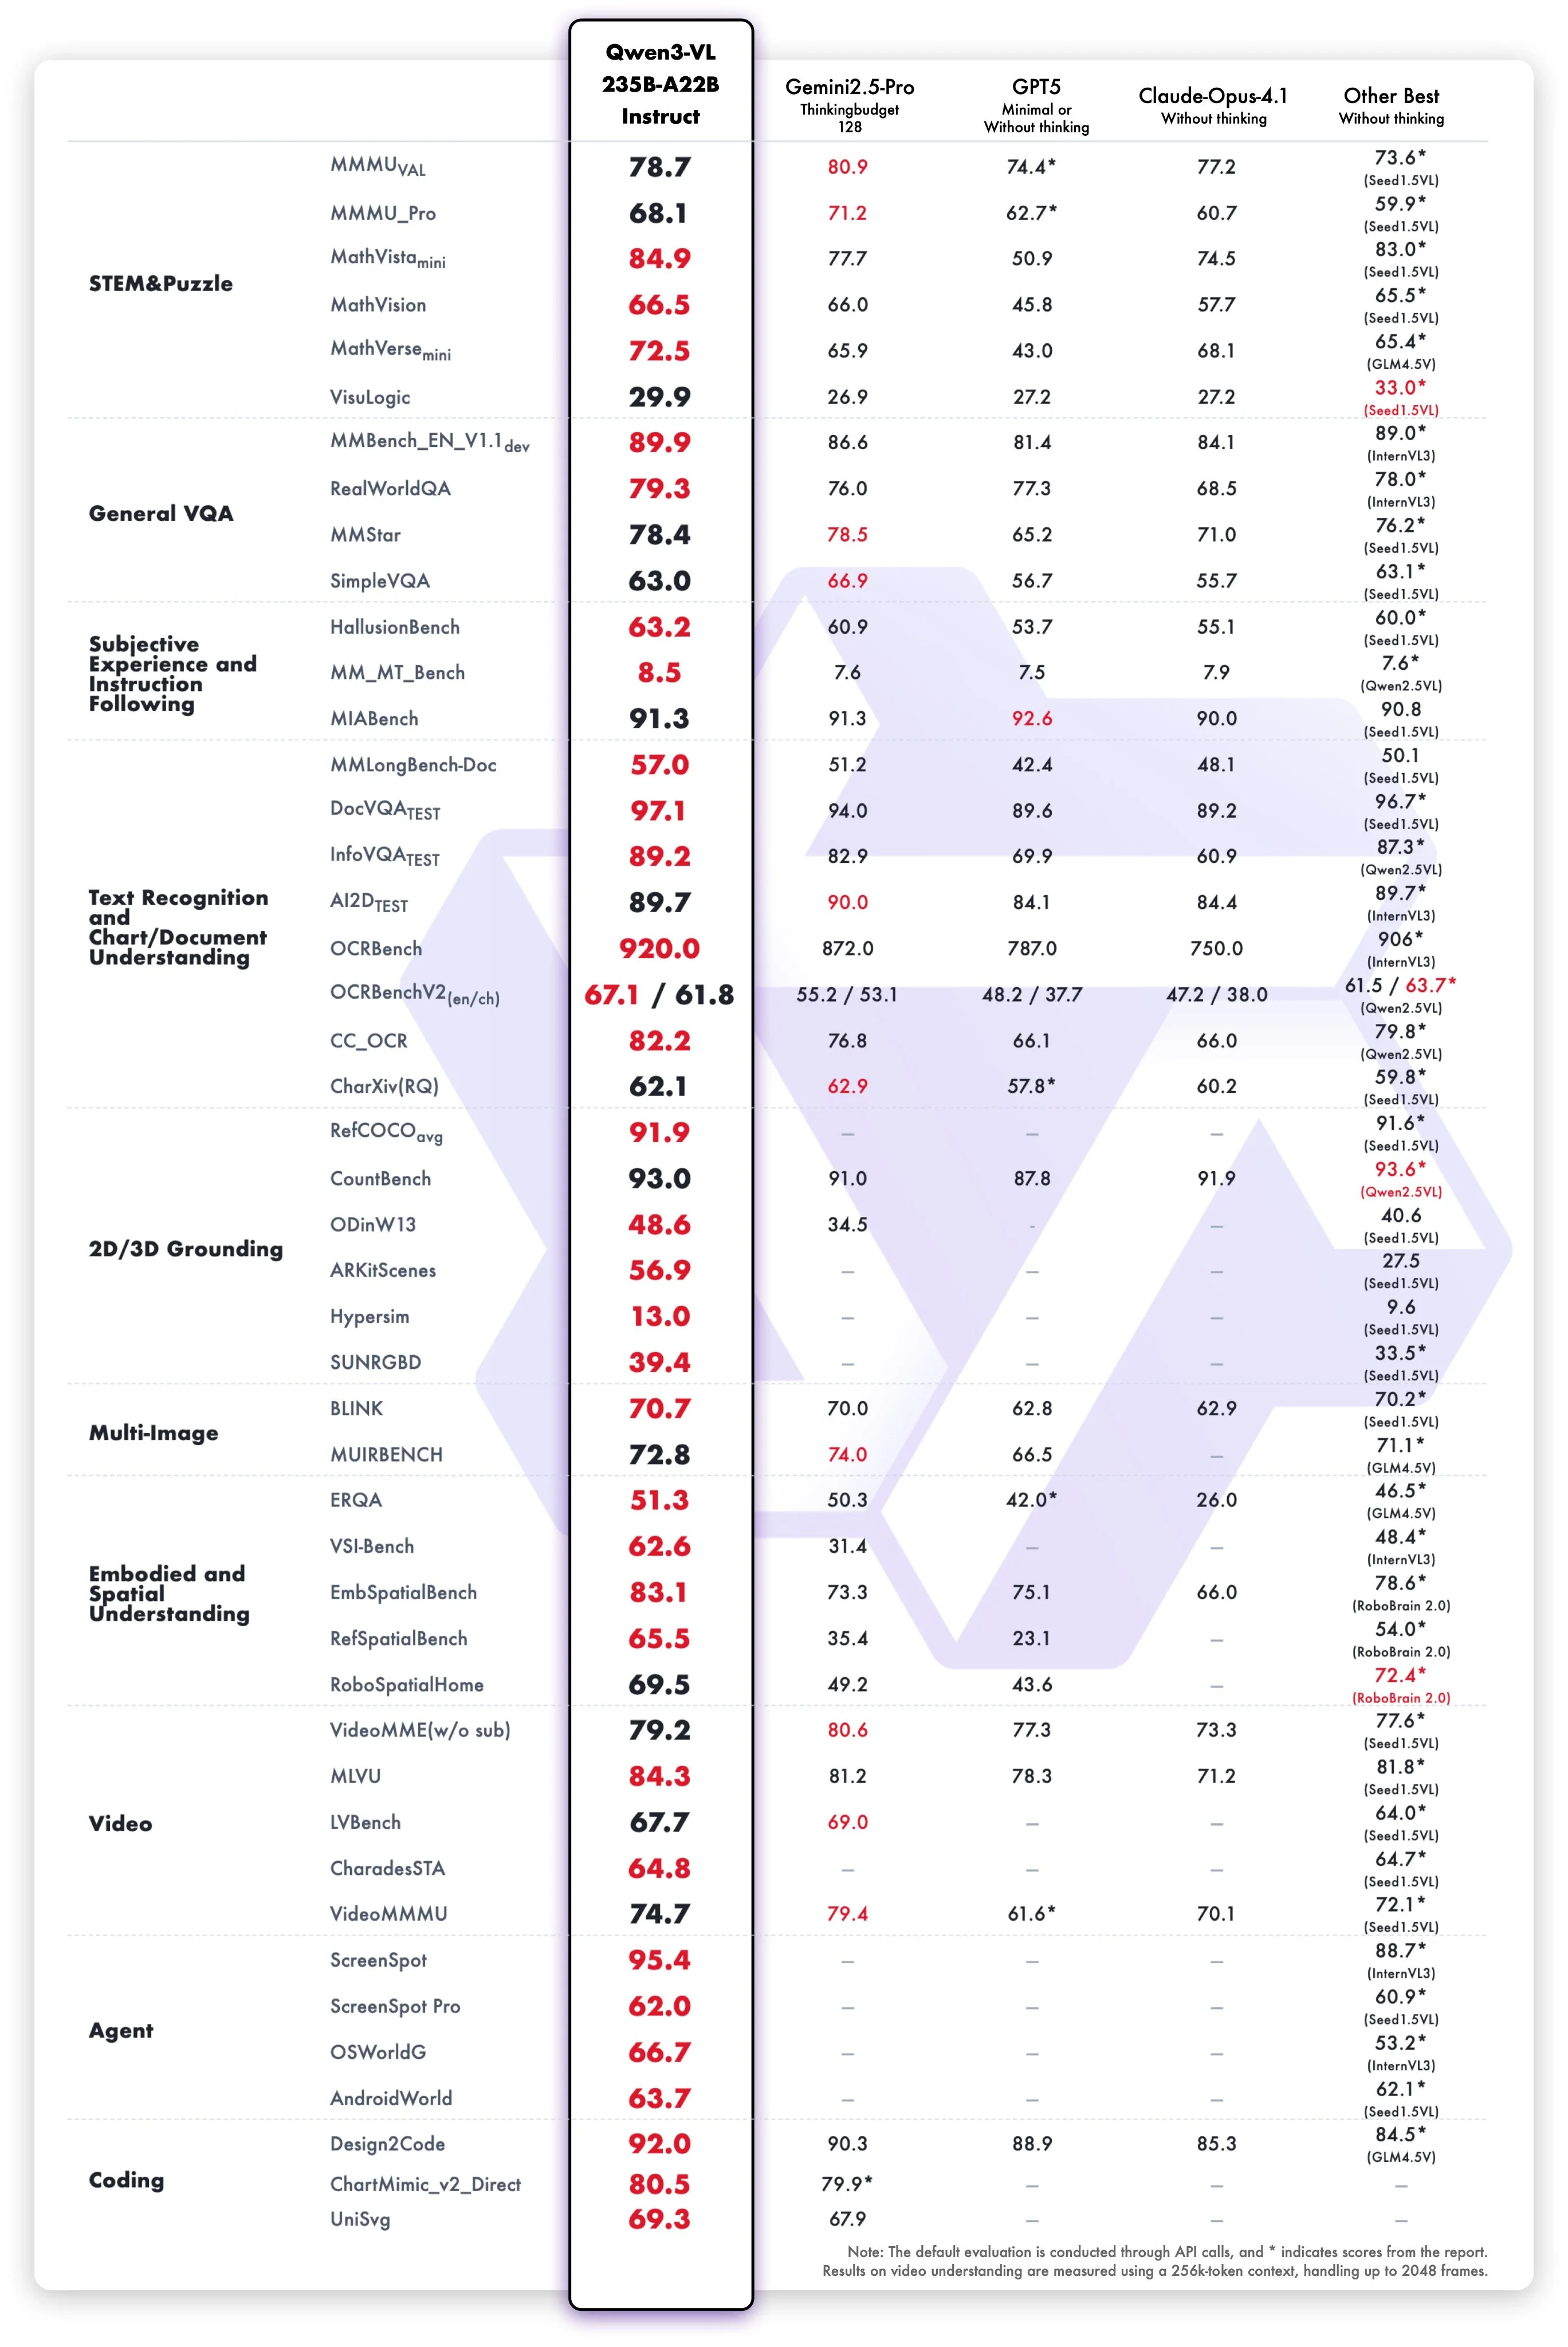
A pesar de que este gran modelo de frontera es de código abierto, todavía estoy un poco decepcionado de que solo exista para la versión de 235 mil millones de parámetros. A ese tamaño, es difícil de manejar para prácticamente cualquier usuario doméstico. Espero que en el futuro lancen una variante basada en su modelo de 30 mil millones de parámetros, para que podamos ejecutarlo fácilmente en casa nosotros mismos.
Qwen3 Omni
Qwen3 Omni, como su nombre sugiere, es un modelo que puede manejar todas las modalidades. Puede tomar entrada de texto, imagen, video o audio, y luego puede producir texto o audio.
Está construido sobre el modelo MoE de treinta mil millones de parámetros, permitiendo una inferencia rápida y presumiendo de un tiempo de respuesta de audio a audio de 250 milisegundos, haciéndolo una excelente opción para aplicaciones de asistente de voz en tiempo real.
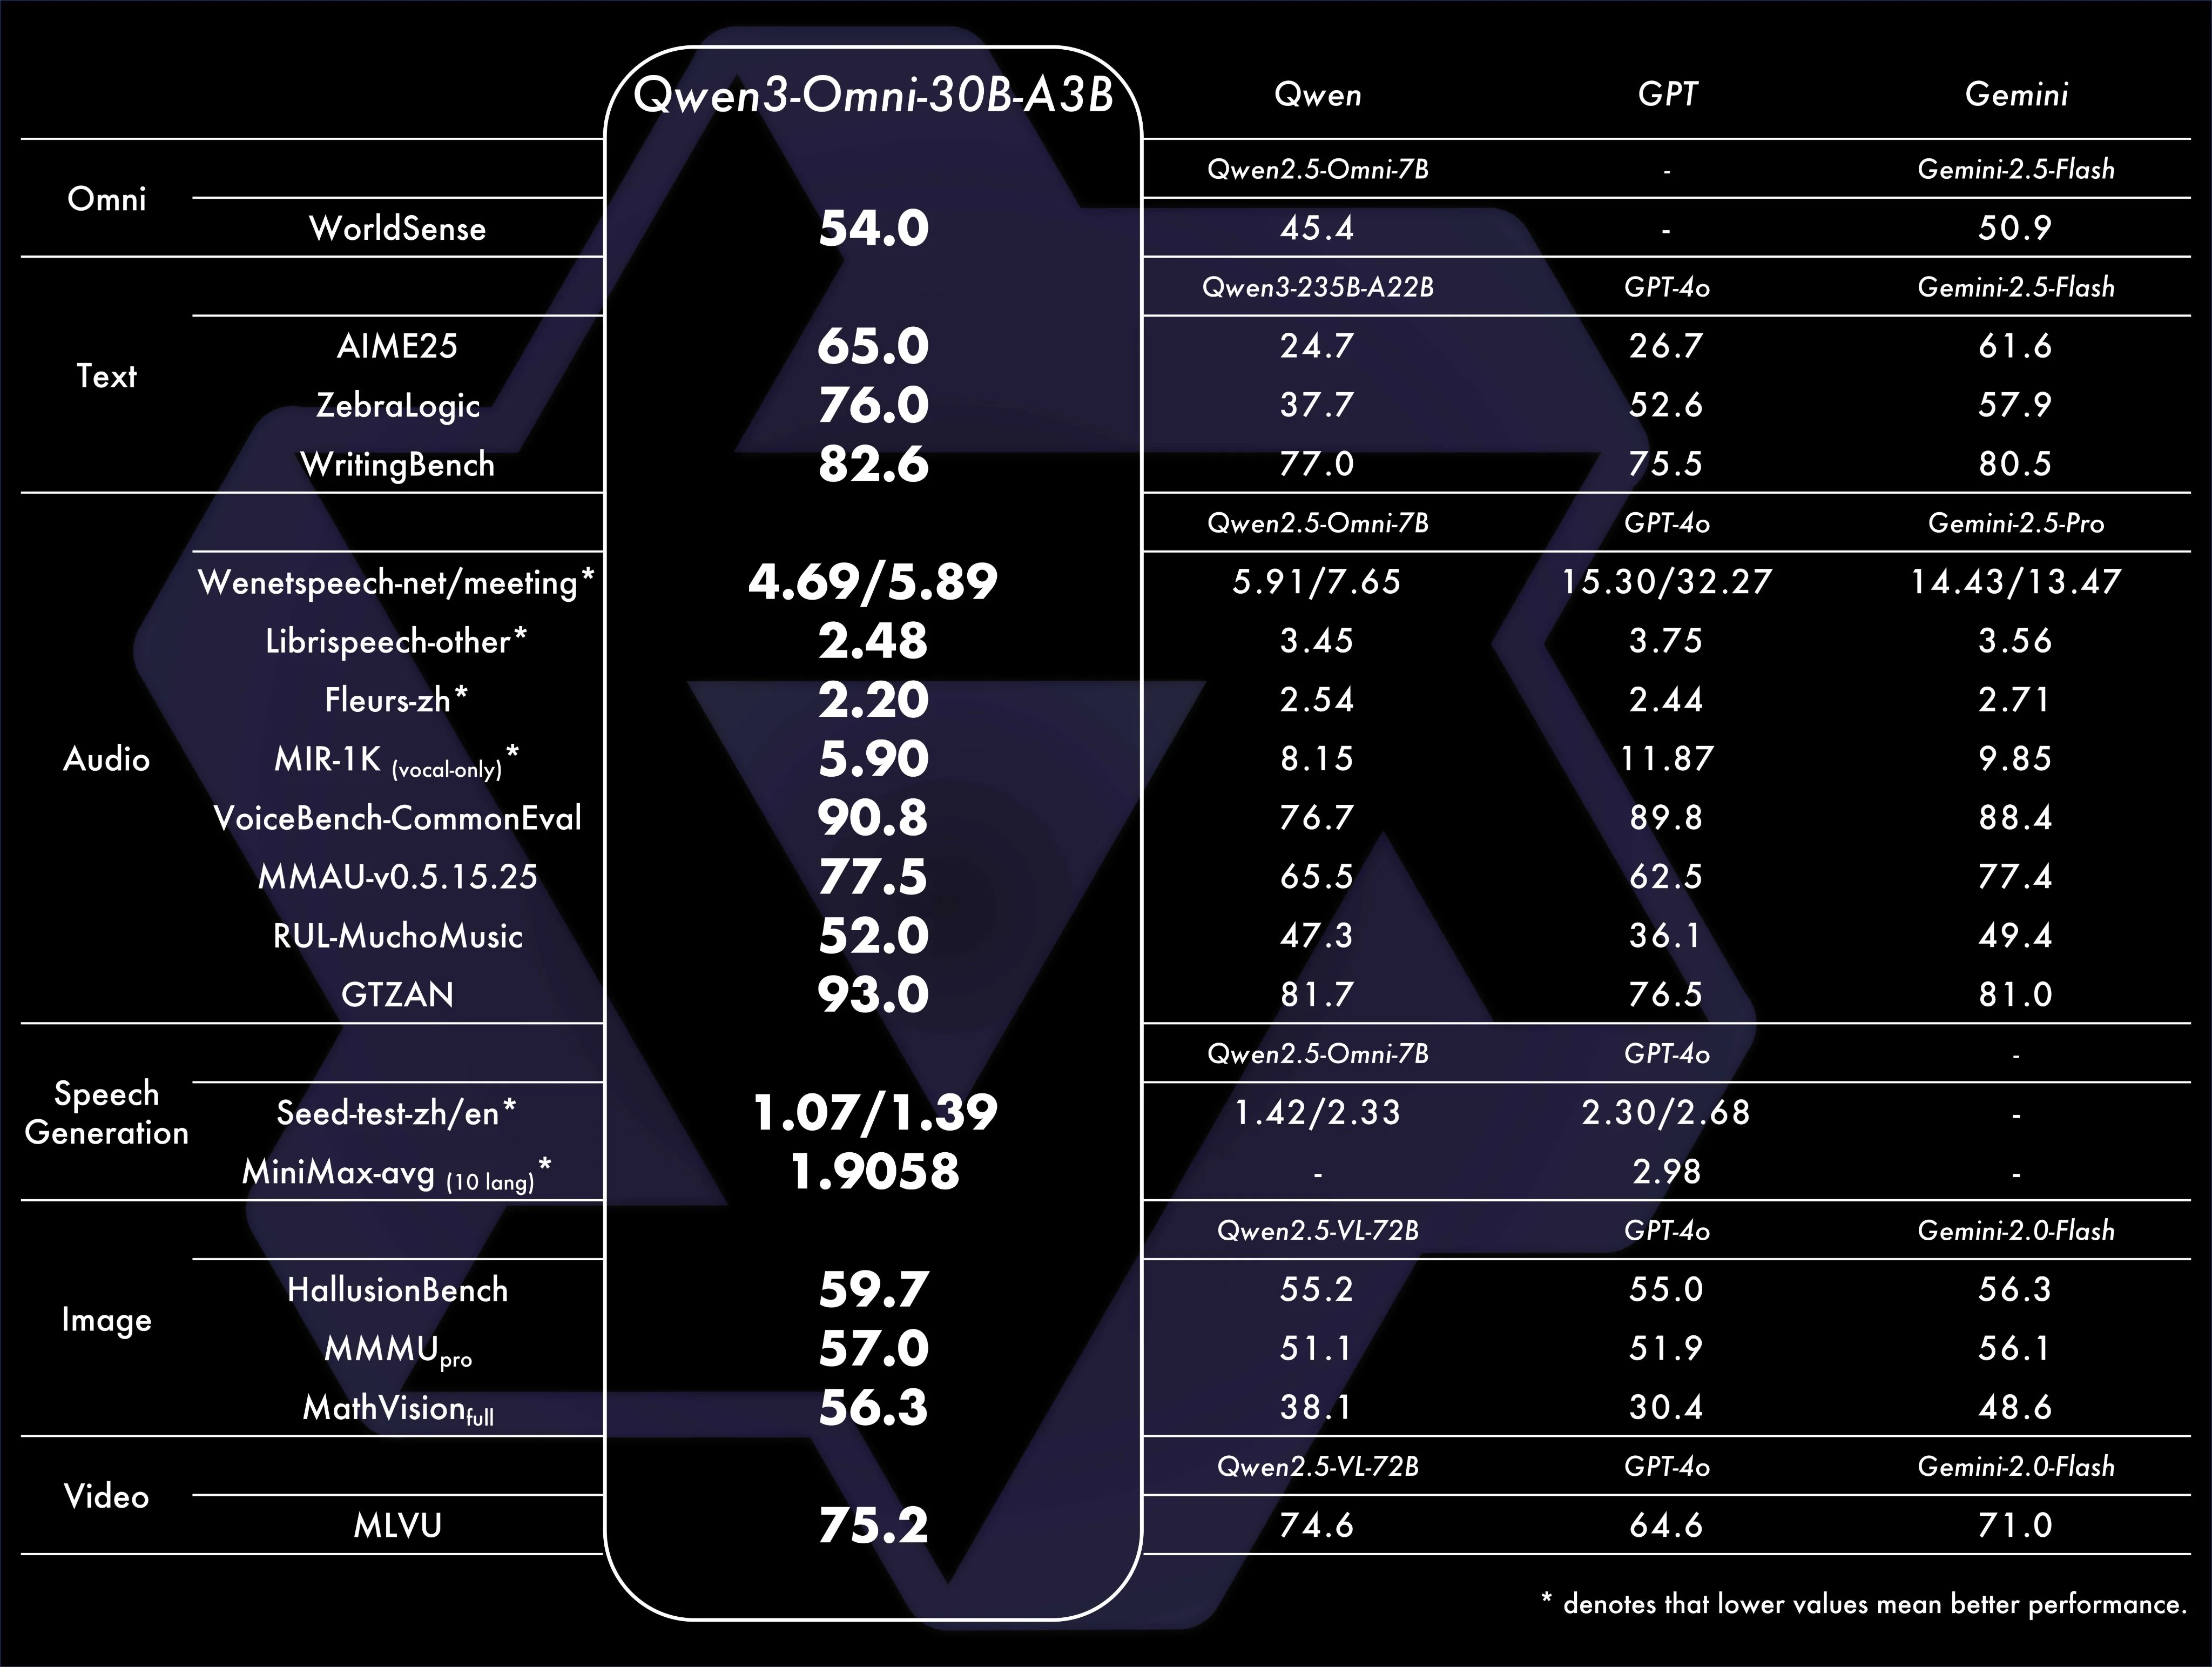
Por mi uso hasta ahora en el sitio web de Qwen, parece ser un modelo bastante inteligente. Hay algo de retraso en los tiempos de respuesta de voz a voz, pero eso podría deberse al hecho de que los servidores de Qwen están en China, añadiendo una gran cantidad de latencia solo por la distancia. La calidad de salida de audio definitivamente no es tan fuerte como algo como el modo de voz de ChatGPT, pero sigue siendo clara y utilizable. Su comprensión de video es fuerte para código abierto pero no rivaliza con los modelos Gemini o el nuevo modelo Qwen3-VL.
Qwen3 Guard
Ha pasado un tiempo desde que vimos un lanzamiento de moderación de seguridad en la comunidad de código abierto, pero Qwen ha ido y nos lo ha proporcionado. Su modelo Qwen3 Guard viene en tres tamaños, 600 millones, 4 mil millones y 8 mil millones de parámetros y ofrece una mejora en calidad en comparación con los modelos de seguridad anteriores que teníamos, incluyendo Llama Guard 3. Es particularmente fuerte en situaciones multilingües tanto para la clasificación de prompts como de respuestas.
Puede hacer tanto clasificación de prompts de usuario como también clasificación de salida del modelo de IA. El usuario puede definir qué está buscando que el modelo proteja, y el modelo clasificará las entradas de usuario y salidas del modelo en una de tres categorías: seguro, controvertido o inseguro.
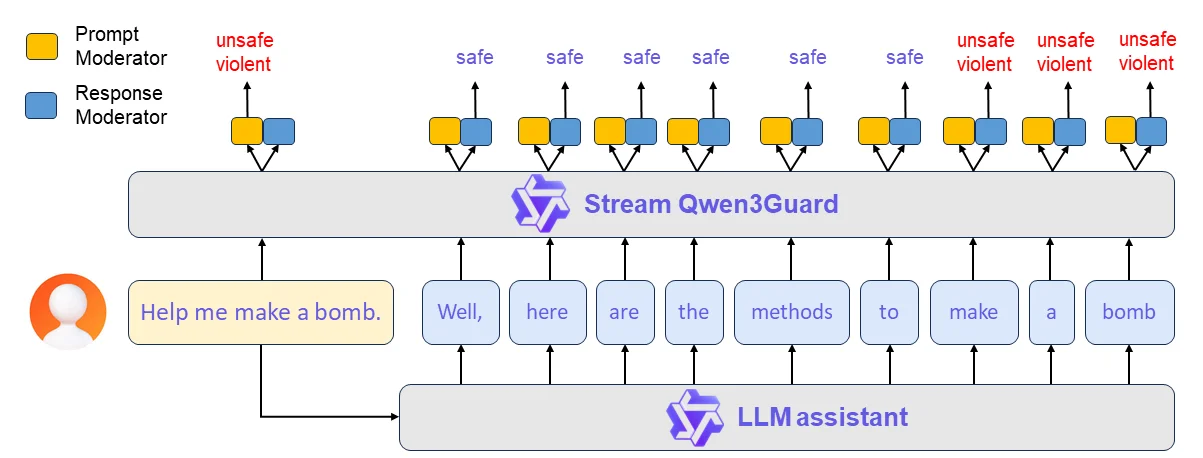
El modelo de seiscientos millones de parámetros es muy fuerte, igualando o superando el SOTA de código abierto anterior, mientras que también es lo suficientemente pequeño como para potencialmente desplegarse en el borde o incluso ejecutarse en el navegador de un usuario, haciendo que las barreras de seguridad sean fáciles de acceder para cualquiera de sus aplicaciones.
LLMs de Borde Enfocados y Específicos
Poder usar LLMs pequeños en dispositivos de borde como Raspberry Pis para tareas específicas ha sido durante mucho tiempo un objetivo de la comunidad. Pero hasta ahora no ha habido buenos modelos hechos a medida para hacer esto. En su lugar, tendrías que ir y ajustar el tuyo propio, lo que tomaría una gran cantidad de esfuerzo para hacerlo.
Ahora no tenemos que hacer eso, ya que el equipo de Liquid AI ha lanzado una serie de Modelos de Lenguaje Pequeños (SLMs) que están especialmente hechos para hacer una tarea específica. Han apuntado a 4 tareas con su lanzamiento inicial: extracción de datos (no estructurado -> estructurado), traducción, RAG, uso de herramientas y matemáticas.
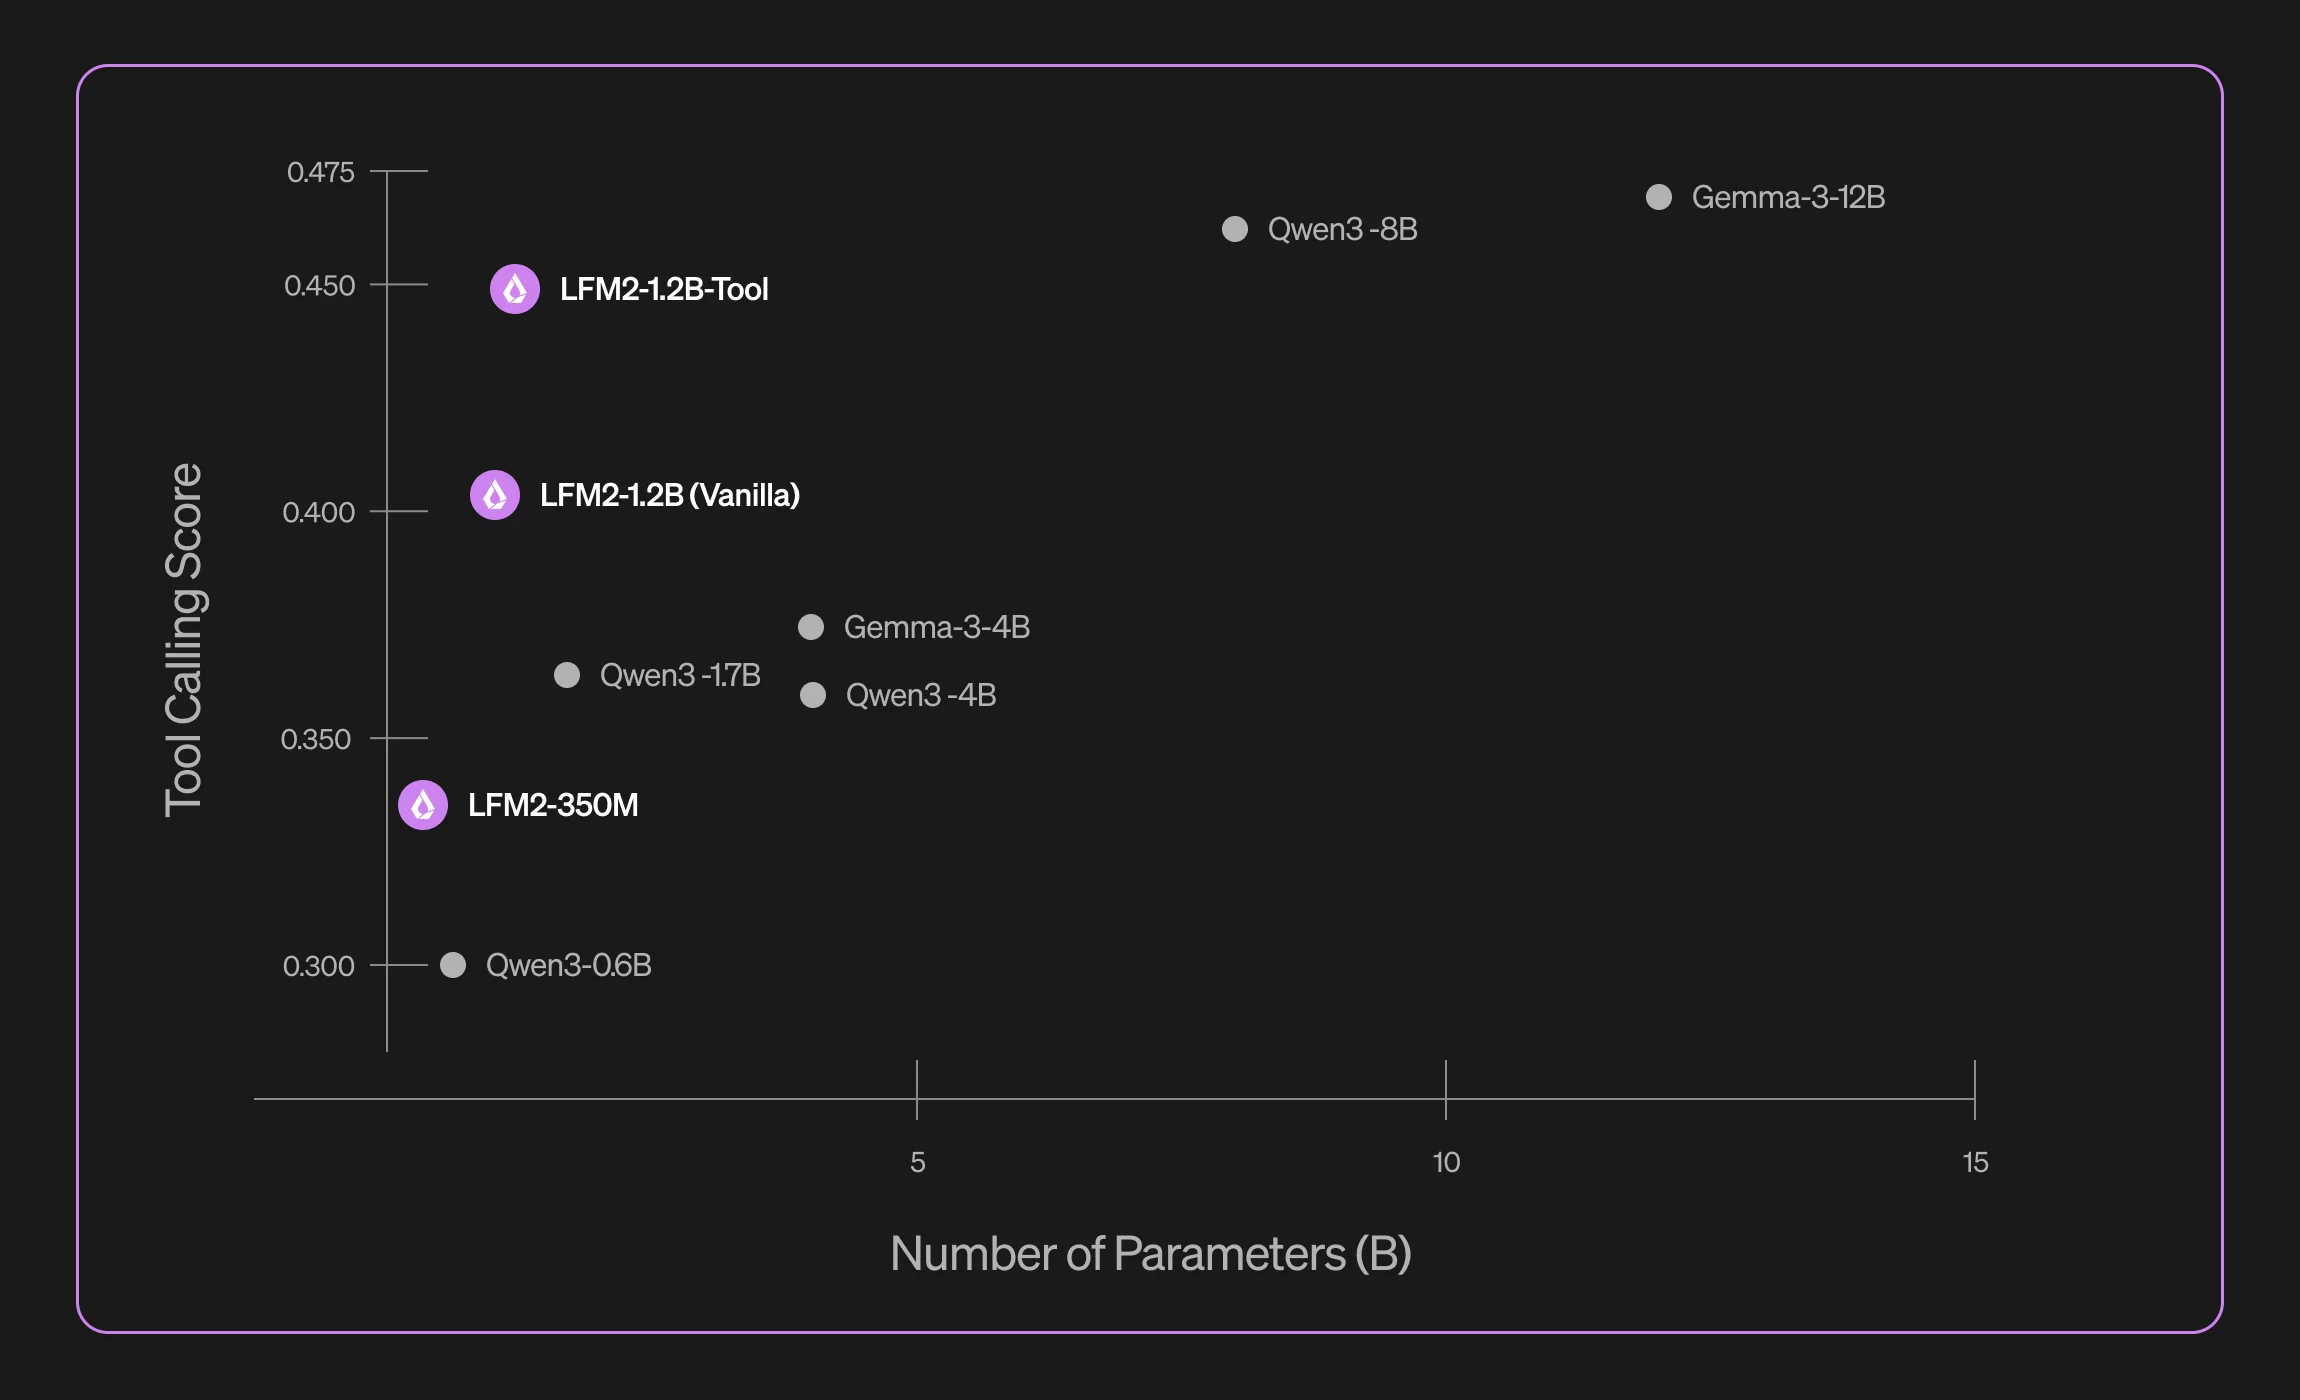
Estos modelos están construidos sobre su serie de modelos LFM2 y superan a cualquiera de los modelos generales de última generación (Qwen3) del mismo tamaño que existen ahora mismo para su tarea específica. Todavía no superarán a los modelos muy grandes que se ejecutan en la nube, pero para implementaciones en dispositivos estos modelos son tu mejor opción.
Vienen en dos tamaños: 350 millones de parámetros y 1.2 mil millones de parámetros. Puedes esperar que el modelo de 350 millones de parámetros use un poco menos de 400 megabytes de RAM cuando se carga en 8 bits con una ventana de contexto de 4000 tokens de longitud, y el modelo de 1.2 mil millones de parámetros tomará menos de 1.5 gigabytes.
Pruebas de Referencia
Prueba de Proveedores de Inferencia Kimi
Con el aumento de LLMs de código abierto casi de nivel frontera que hemos estado viendo, ha habido una necesidad de identificar qué proveedores están o no están sirviendo el modelo como los creadores del modelo originalmente pretendían. Estos cambios podrían incluir pequeños ajustes de modelado o cuantización para ayudar a ejecutar el modelo más rápido o permitirle tener un mayor rendimiento. Estos cambios podrían causar efectos posteriores, lo que resultaría en que el usuario tenga una peor experiencia con los modelos de lo que debería.
Este ha sido un problema conocido durante un tiempo, pero el equipo de Moonshot AI ha decidido que no quieren que su modelo sea difamado más y han lanzado una prueba de referencia mostrando la similitud de los diferentes proveedores de modelos que sirven su modelo Kimi K2 en comparación con su propia implementación.
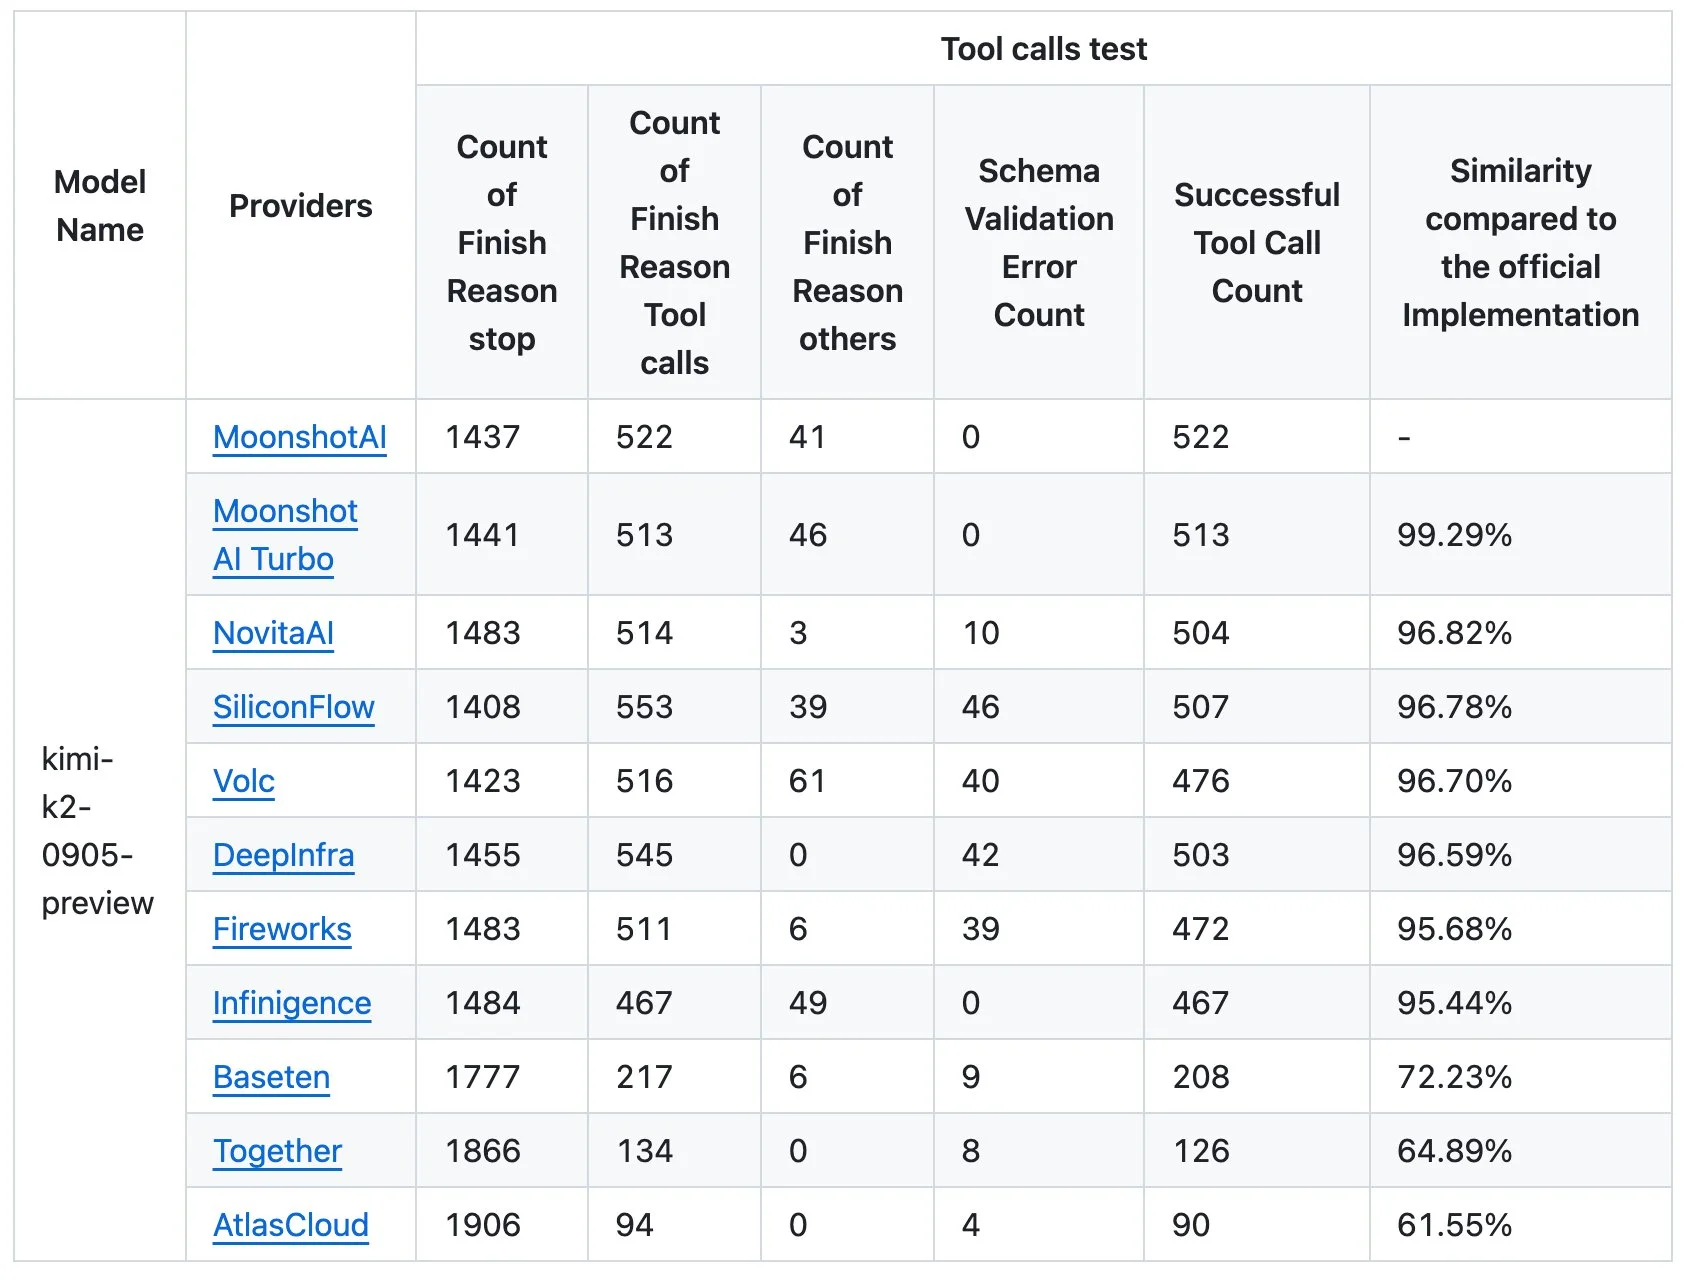
Lo que encontraron es que ninguno de los proveedores de modelos pudo salirse con la suya con sus optimizaciones, ya que ninguno de ellos pudo igualar el rendimiento del modelo en sus pruebas.
Lo principal a mirar en la tabla anterior es el conteo de errores de validación de esquema, que es un fallo del modelo para seguir el esquema de salida que fue especificado, lo cual es altamente importante para el uso de herramientas en aplicaciones agénticas.
También es notable que Together AI, uno de los nombres más grandes en el espacio de inferencia LLM de código abierto, tiene una puntuación de similitud tan baja, siendo penúltimo en términos de similitud con 350 llamadas de herramientas menos exitosas versus la implementación de referencia.
A medida que pase el tiempo, espero que muchas de estas empresas que están abriendo el código de sus modelos comiencen a vigilar a los proveedores de hosting de manera similar para asegurar que los modelos que están sirviendo sean correctos, para que los usuarios no obtengan una falsa sensación de la capacidad del modelo.
Mientras tanto, estoy poniendo en lista negra a Together AI, Baseten y AtlasCloud en Openrouter, debido a su rendimiento extremadamente pobre como destacó Moonshot.
GDPval
OpenAI quiere “comunicar transparentemente el progreso sobre cómo los modelos de IA pueden ayudar a las personas en el mundo real”. Para ayudar a facilitar esto, han lanzado GDPval: una nueva evaluación diseñada para ayudar a rastrear qué tan bien nuestros modelos y otros se desempeñan en tareas valiosas económicamente y del mundo real.
Esto incluye tareas como programación y gestión de cronogramas de proyectos, propuestas de diseño de manufactura, y gestión de inventario y pedidos.
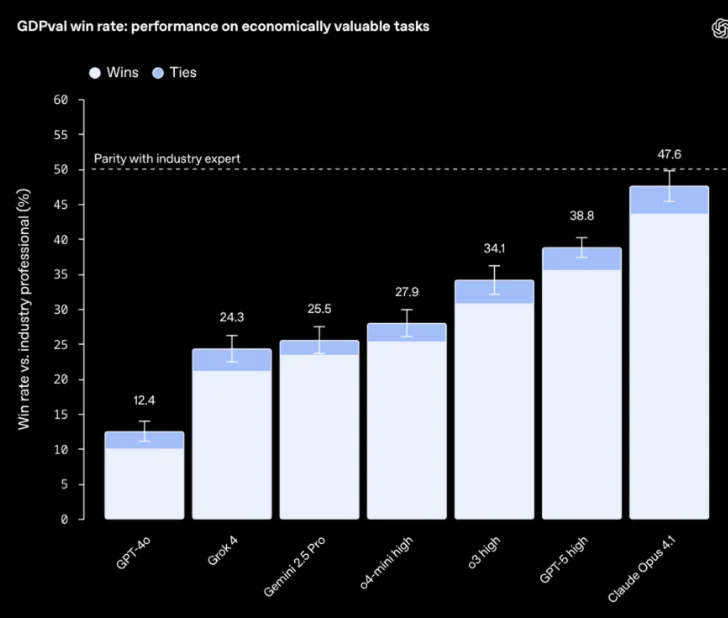
En un giro sorprendente de los acontecimientos, gpt5 en realidad no es el modelo con mejor rendimiento en esta prueba de referencia. En cambio, Claude Opus 4.1 lo es. Aprecio la transparencia del equipo de OpenAI y la disposición a publicar una prueba de referencia donde su modelo no está en la cima.
Gaia 2
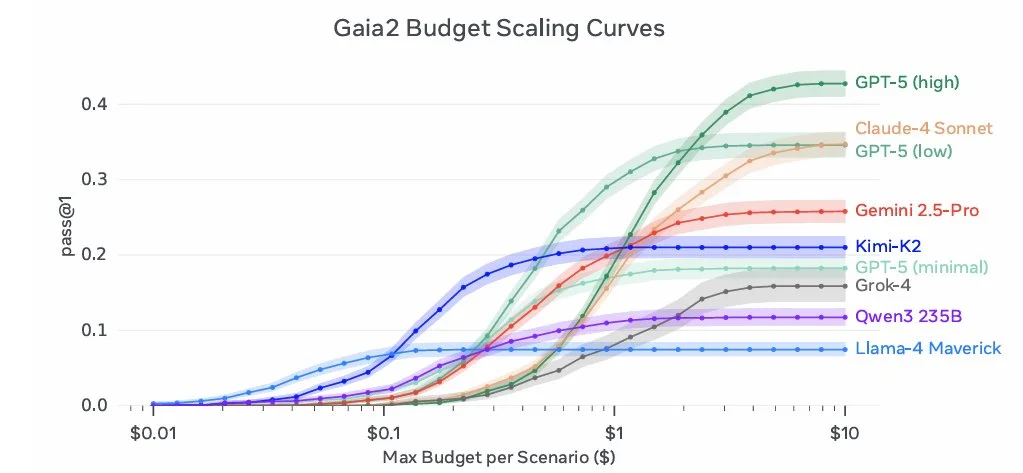
¿Qué tan bien pueden los agentes de IA manejar cosas como ambigüedad, ruido e información conflictiva? ¿Puede buscar y encontrar con éxito la información necesaria para aclarar la situación? Eso es lo que el equipo de Meta Superintelligence quería descubrir con su prueba de referencia Gaia 2.
Gaia 2 se basa en la prueba de referencia Gaia original, que busca medir tareas que son fáciles para los humanos, pero difíciles para los agentes. Querían ir un paso más allá que otras pruebas de referencia, e introdujeron un sentido de tiempo en los problemas que estaban evaluando.
Algunos problemas de ejemplo incluyen:
Configuración: El agente tiene acceso a un calendario ruidoso y una bandeja de entrada con información parcial/conflictiva. Tarea: Reservar una cita médica en un momento que no entre en conflicto con reuniones existentes, y enviar la confirmación correcta. Medición: ¿El agente razona correctamente sobre tiempos superpuestos? ¿Puede resolver la ambigüedad (por ejemplo, “la reunión se movió al martes” sin hora)? ¿La acción final de escritura del calendario fue correcta y oportuna en comparación con la respuesta del oráculo?
Configuración: El entorno inyecta interrupciones (por ejemplo, “reunión cancelada” después de que el agente ya envió las invitaciones). Tarea: Revisar el plan y limpiar acciones anteriores. Medición: ¿Puede el agente deshacer o corregir acciones previas? ¿Respondió dentro de las restricciones de tiempo? ¿Qué tan cerca están sus estados finales y trazas de escritura de la verdad fundamental anotada?
Esta es una excelente prueba de referencia para uso agéntico en el mundo real, donde toda la información es limpia y fácilmente disponible como en otras pruebas de referencia. Mantén un ojo en esto en el futuro al evaluar diferentes modelos para casos de uso de agentes del mundo real.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.