注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
发布动态
Qwen
Qwen 本周又一次超越了自己,一口气发布了 10 款新产品和模型。下面这些尤其值得关注。我接下来要提到的所有模型(Qwen Guard 除外),都可以在 Qwen 网站上免费使用。
Qwen3 Max
一改以往开源发布的惯例,他们这次发布的最大模型 Qwen3 Max 仅通过 API 和网页界面提供。该模型采用混合专家(MoE)架构,据称参数量超过一万亿。
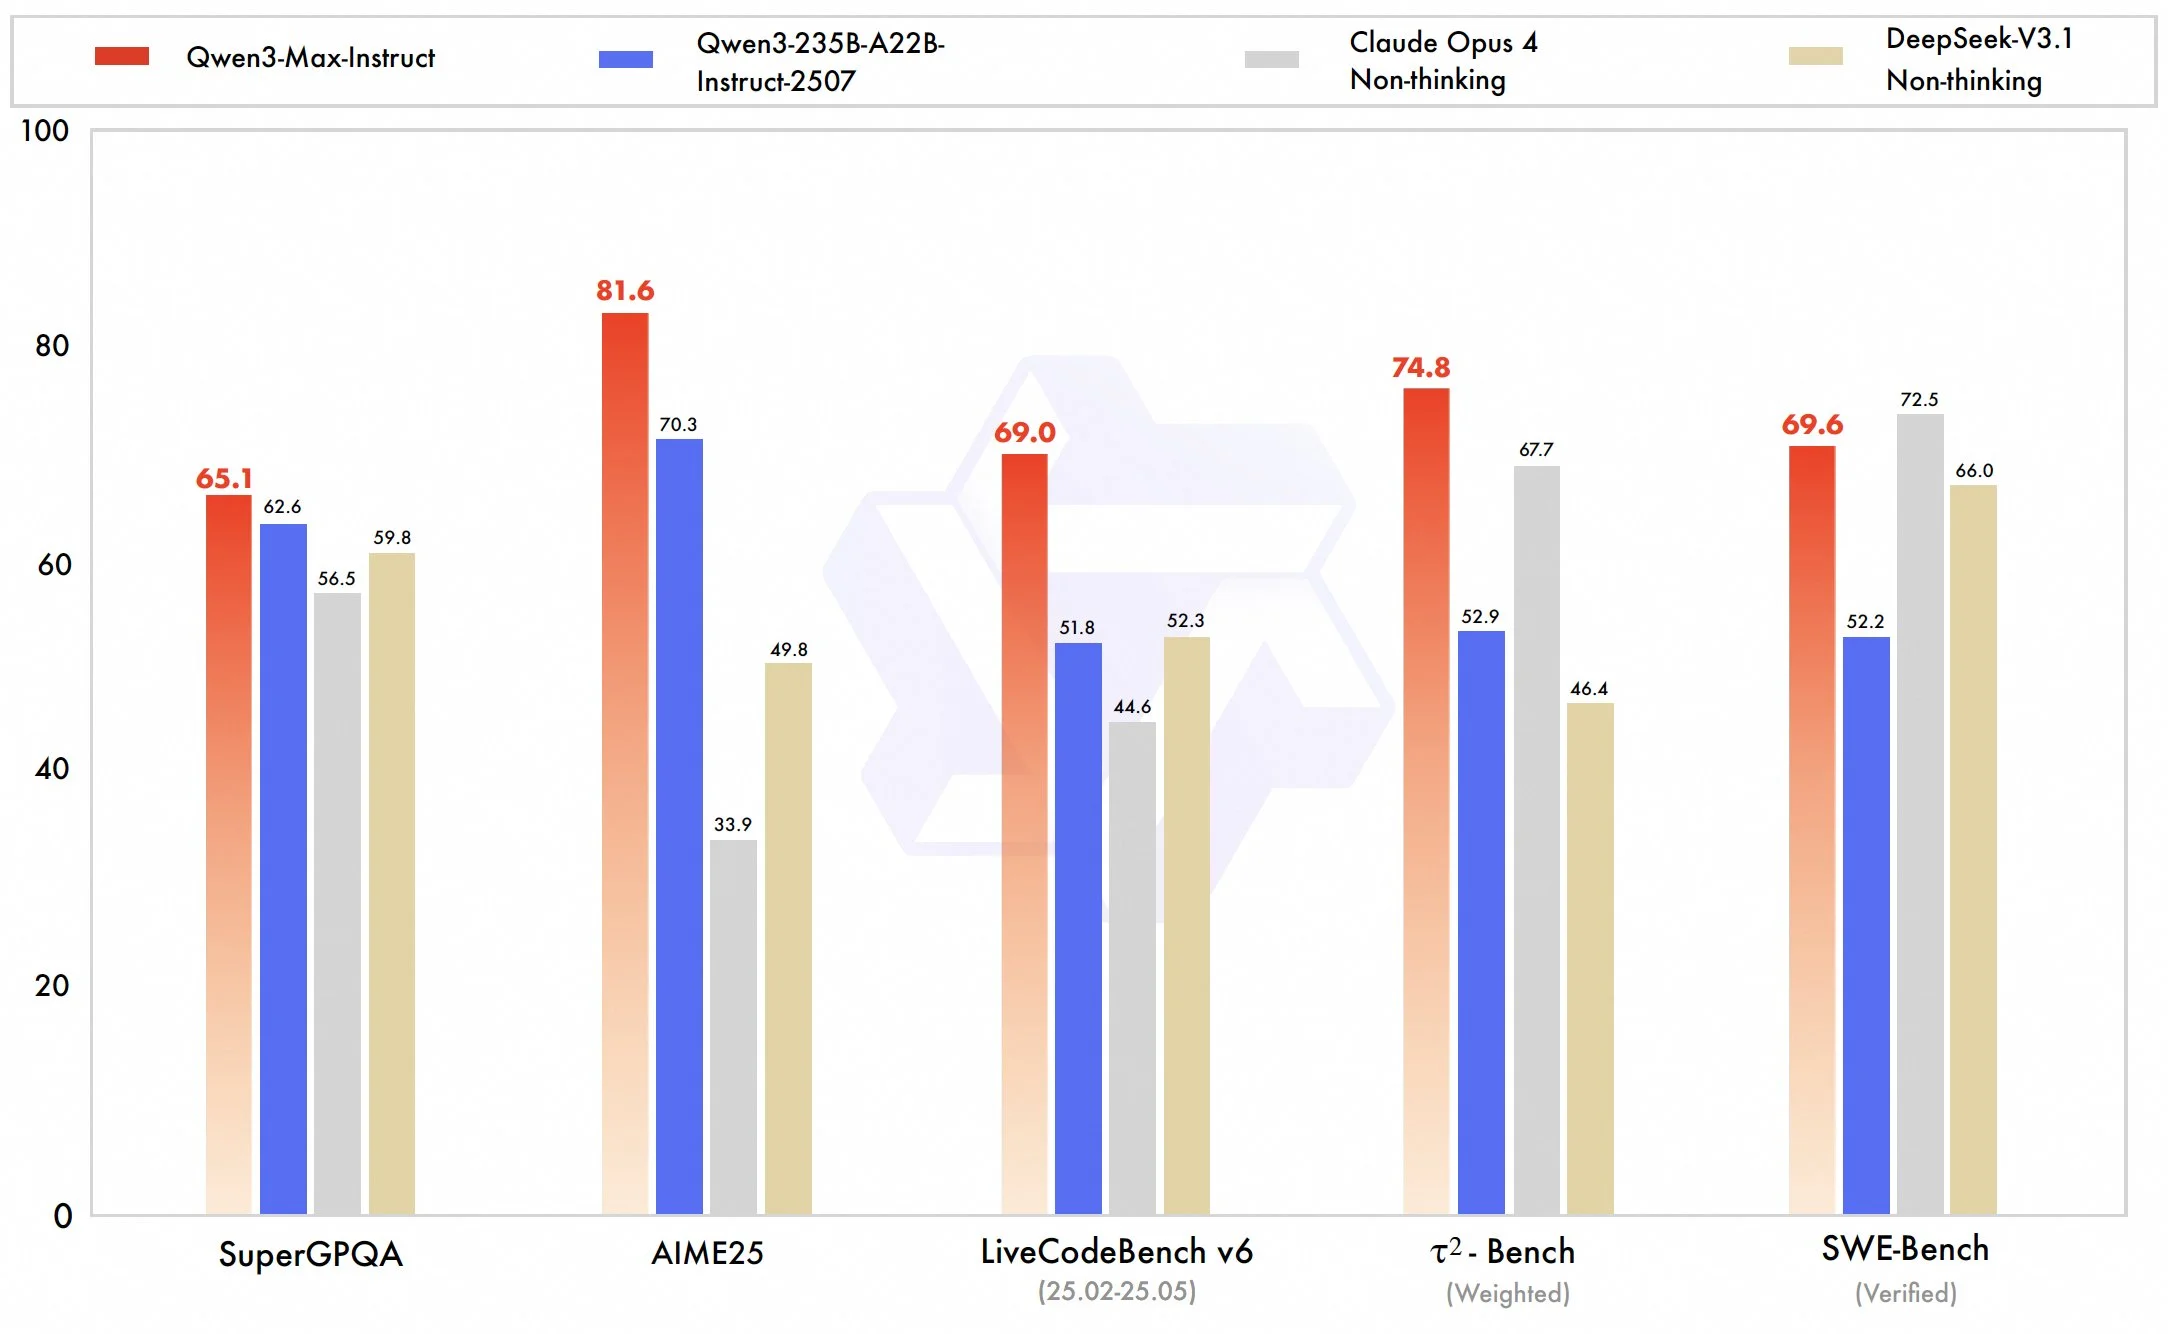
这款模型的基准测试表现非常出色,与 Claude Opus 和 DeepSeek 3.1 相近。 它似乎也通过了社区的实际体验检验,许多人表示,它在编程、工具调用和通用写作方面都有很强的能力。 我们还得再等几周,等针对这款模型的正式基准测试结果公布后,才能断言它是否达到了前沿模型的水平。
这款模型根据使用的 token 数量实行阶梯定价。随着这些大语言模型可用的上下文窗口不断扩大,这种定价方式也越来越常见。
| 上下文长度 | 输入价格/百万 token | 输出价格/百万 token |
|---|---|---|
| 0–32K | $1.2 | $6 |
| 32K–128K | $2.4 | $12 |
| 128K–252K | $3 | $15 |
作为参考,GPT-5 的输出价格为每百万 token 10 美元,Claude Sonnet 则为每百万 token 15 美元。这意味着这款模型的定价与它们大致处于同一档,也体现了 Qwen 对自身实力的信心。
Qwen3-VL
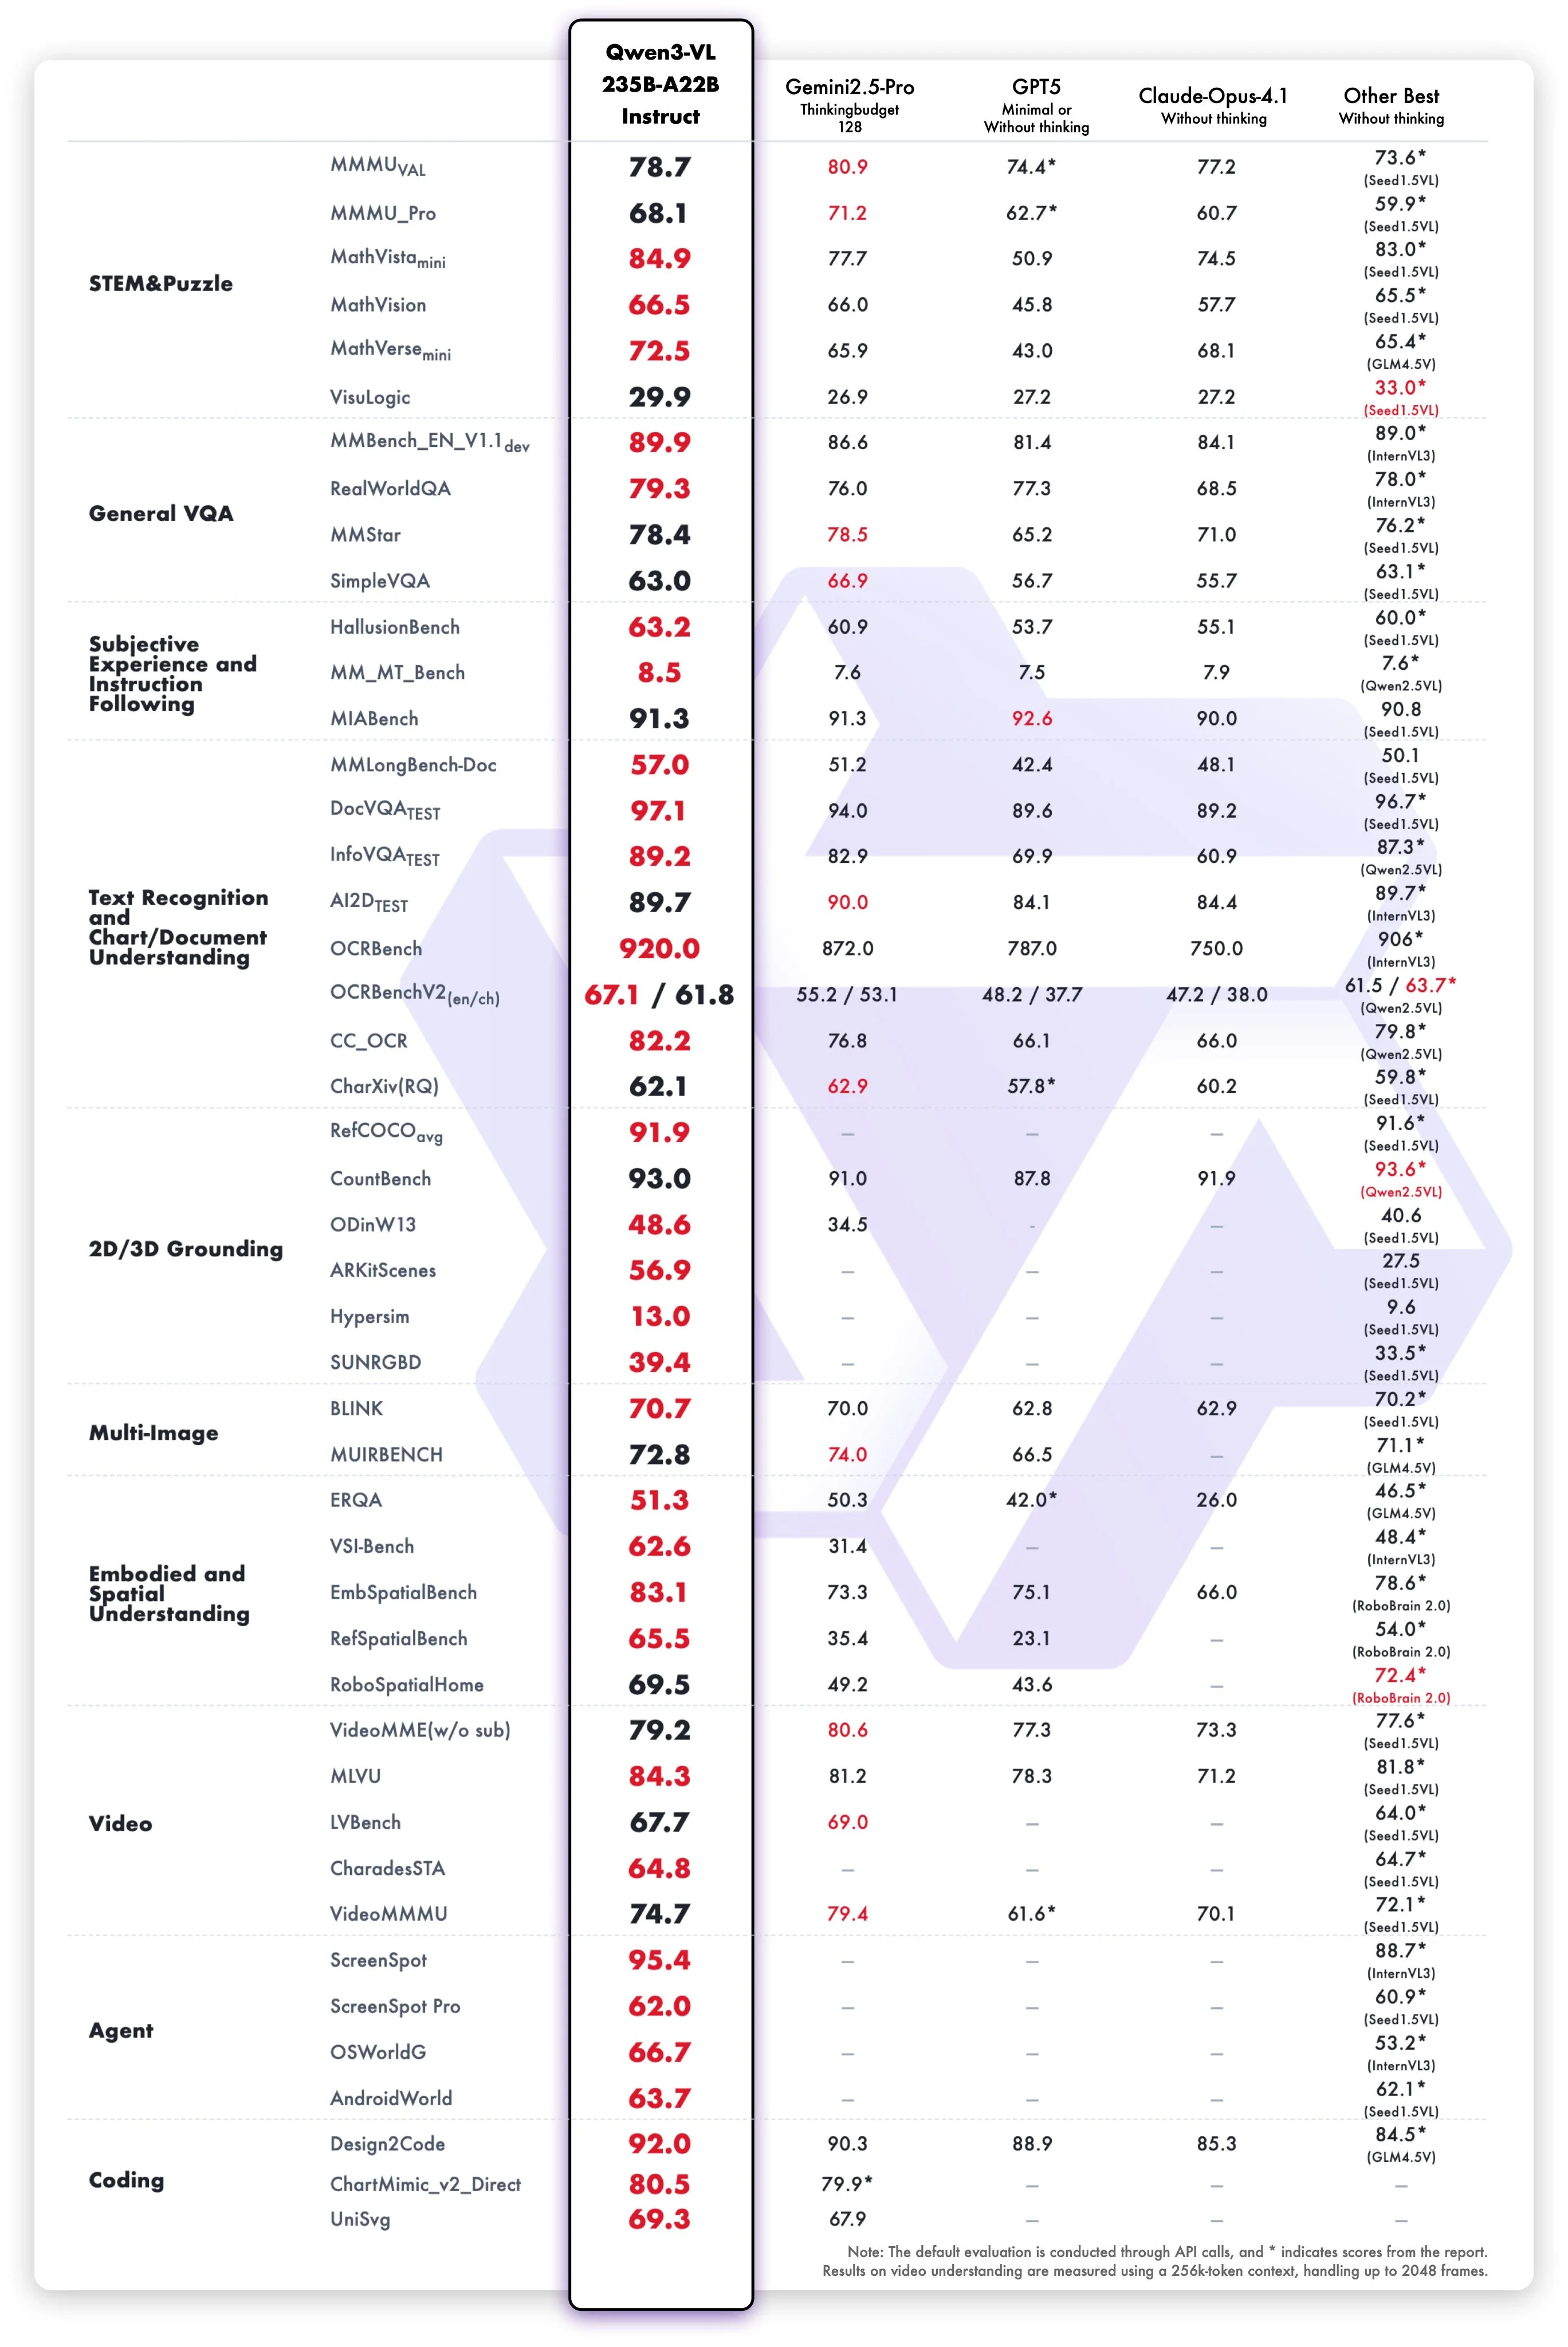
接下来发布的是他们的 Qwen3 视觉模型,基于其 2350 亿参数的 MoE 模型构建。从基准测试成绩来看,它在整个前沿视觉语言模型(VLM)领域拔得头筹,在大多数测试项目中都超过了此前的冠军 Gemini 2.5 Pro。
社区的实际体验反馈似乎也不错。我看到有人说,它解决了一些此前其他 VLM 都解决不了的问题,包括 Gemini Pro 和 GPT-5 也没能解决。 就我个人而言,根据目前看到和听到的反馈,今后遇到任何多模态问题,我都会默认先用 Qwen3-VL。
尽管这款大型前沿模型已经开源,但它只有 2350 亿参数的版本,还是让我有些失望。这个体量对几乎所有家庭用户来说都太庞大了,很难用得起来。我希望他们以后能推出基于 300 亿参数模型的版本,这样我们就能轻松地在家自行运行了。
Qwen3 Omni
Qwen3 Omni,顾名思义,是一款能够处理所有模态的模型。它可以接收文本、图像、视频或音频输入,然后输出文本或音频。
它基于 300 亿参数的 MoE 模型构建,推理速度很快,号称音频到音频的响应时间仅为 250 毫秒,非常适合实时语音助手应用。
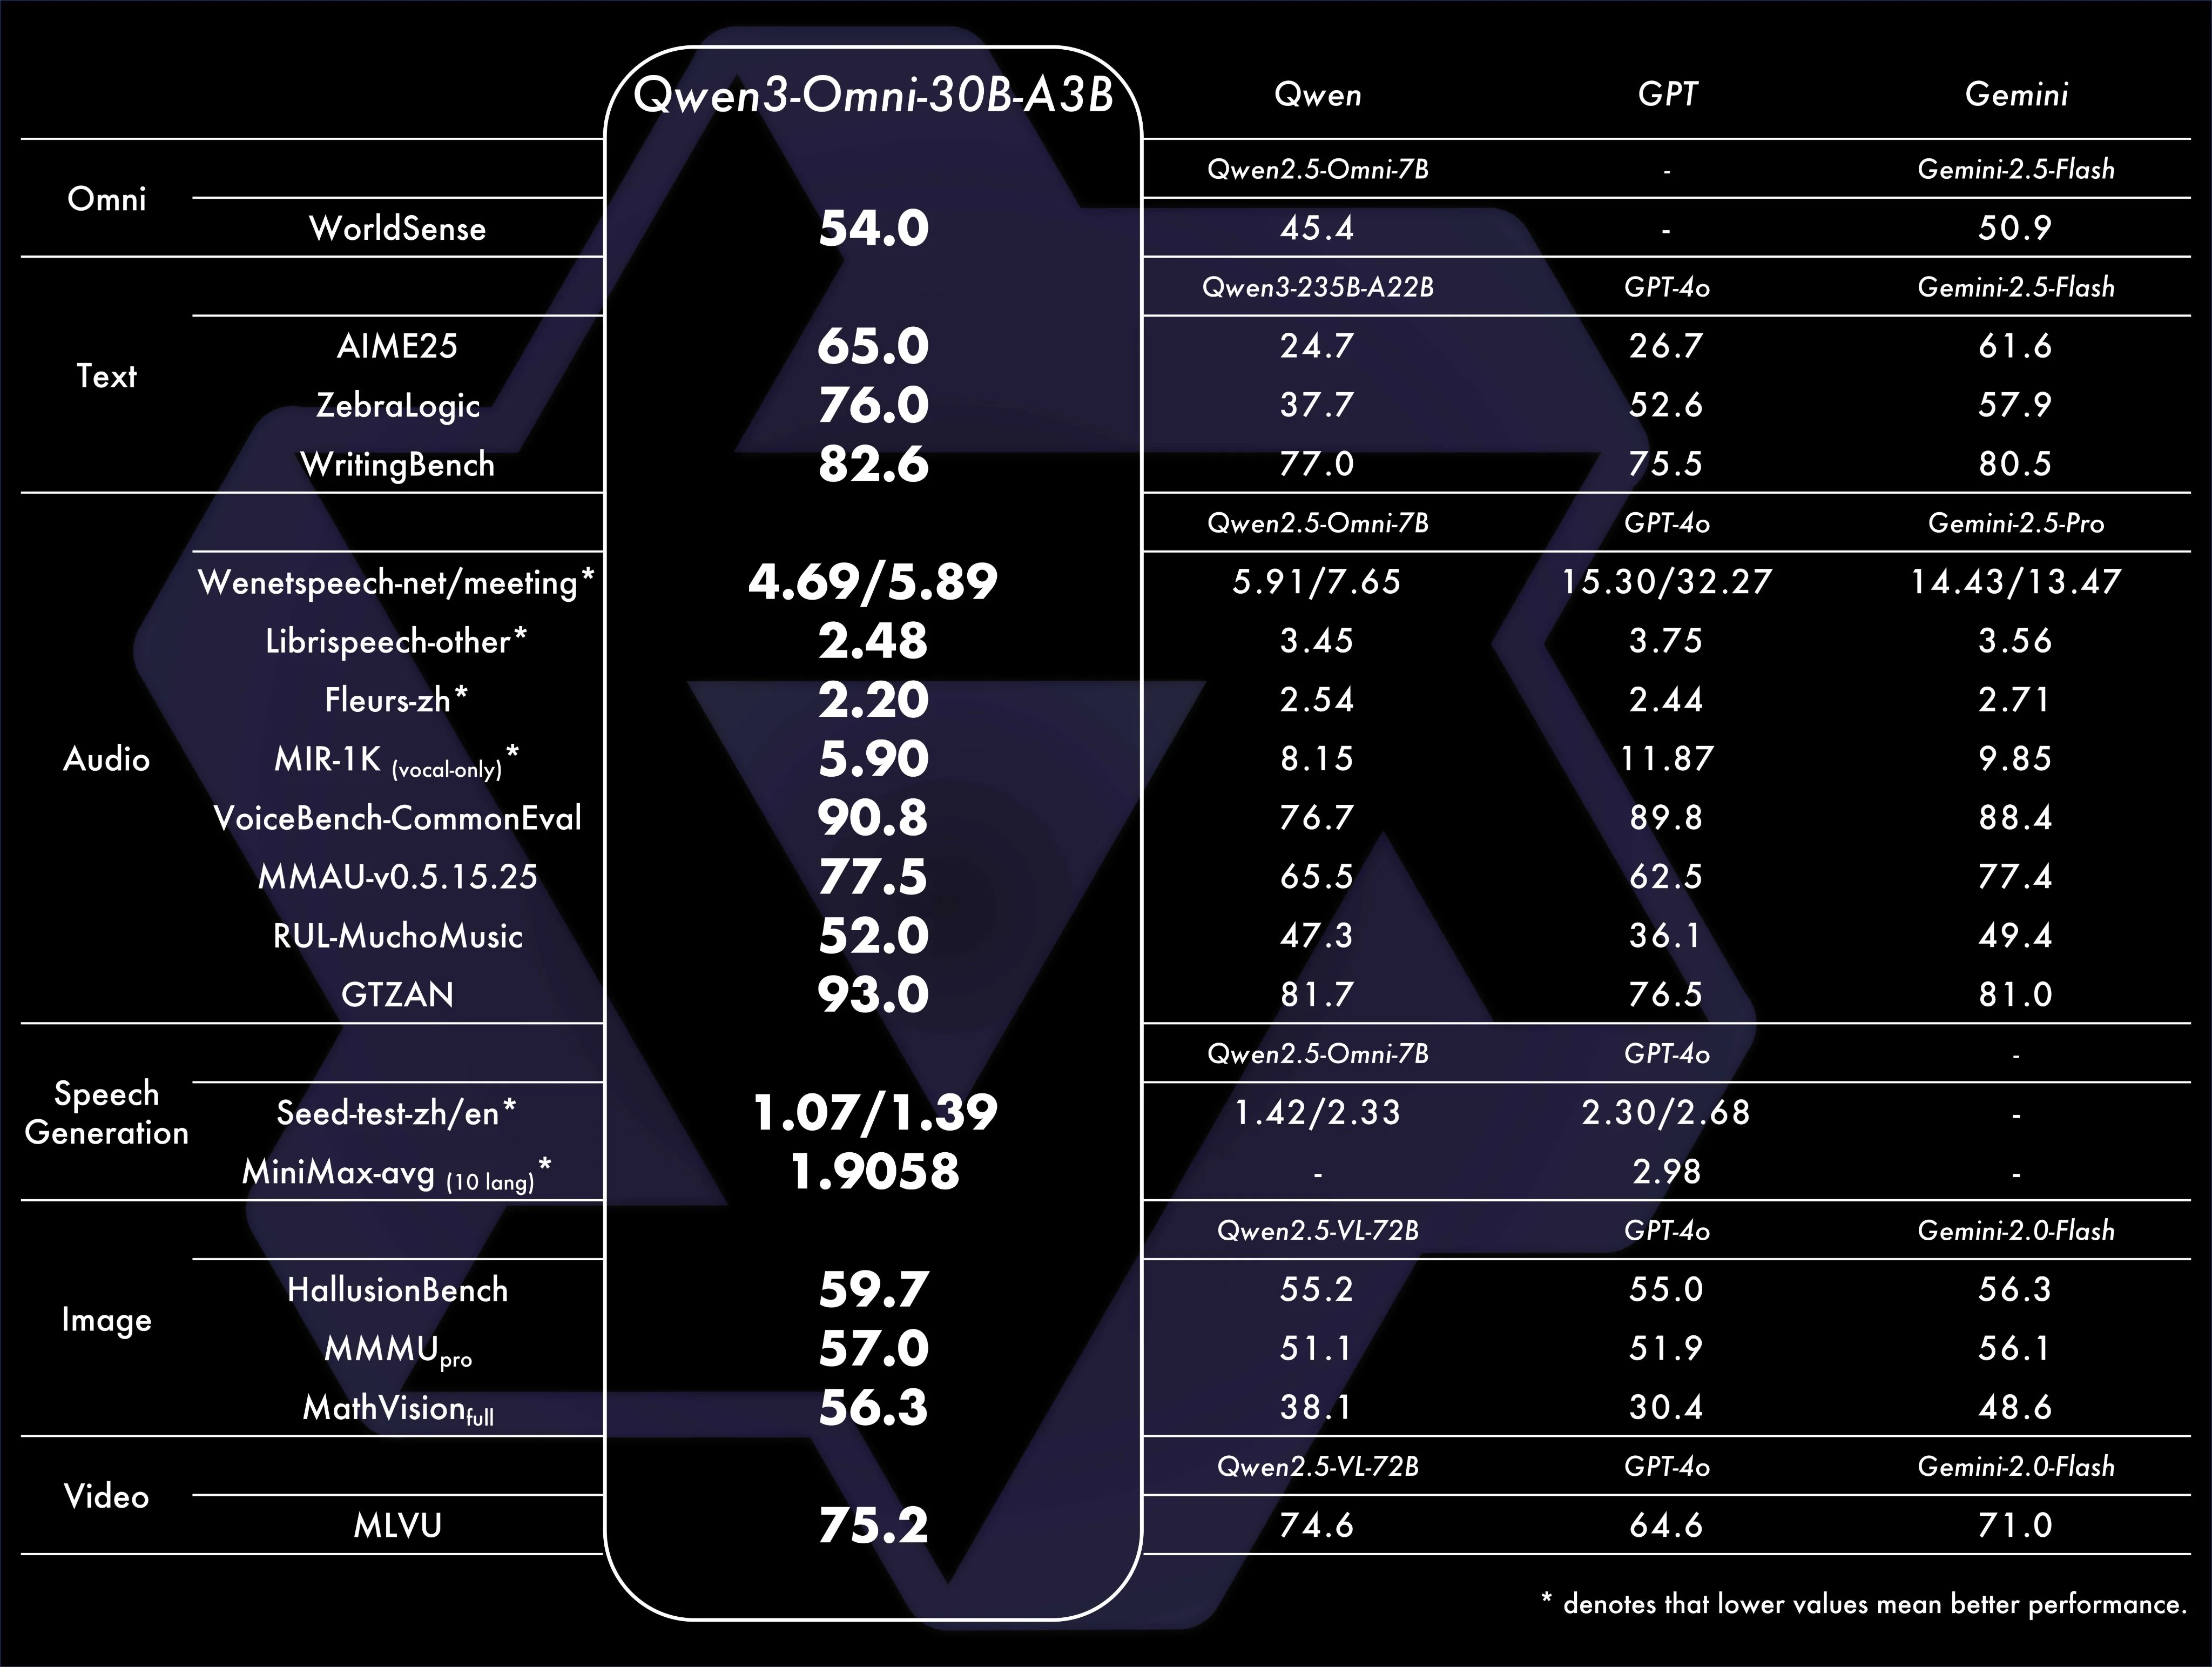
根据我目前在 Qwen 网站上的使用体验,这款模型似乎相当聪明。 语音对话的响应有一些延迟,不过这可能是因为 Qwen 的服务器位于中国,仅地理距离就会带来相当大的延迟。 音频输出质量显然还比不上 ChatGPT 语音模式这样的产品,但依然清晰、可用。 它的视频理解能力在开源模型中很强,但还无法与 Gemini 系列模型或新的 Qwen3-VL 模型匹敌。
Qwen3 Guard
开源社区已经有一阵子没推出新的安全审核模型了,而 Qwen 这次填补了这个空缺。他们的 Qwen3 Guard 提供 6 亿、40 亿和 80 亿参数三种规模,相比此前的安全模型,包括 Llama Guard 3,质量都有提升。它在多语言场景下的提示词和回复分类方面尤其出色。
它既可以对用户提示词进行分类,也可以对 AI 模型的输出进行分类。用户可以自行定义希望模型防范的内容,模型会将用户输入和模型输出划分为三个类别之一:安全、有争议或不安全。
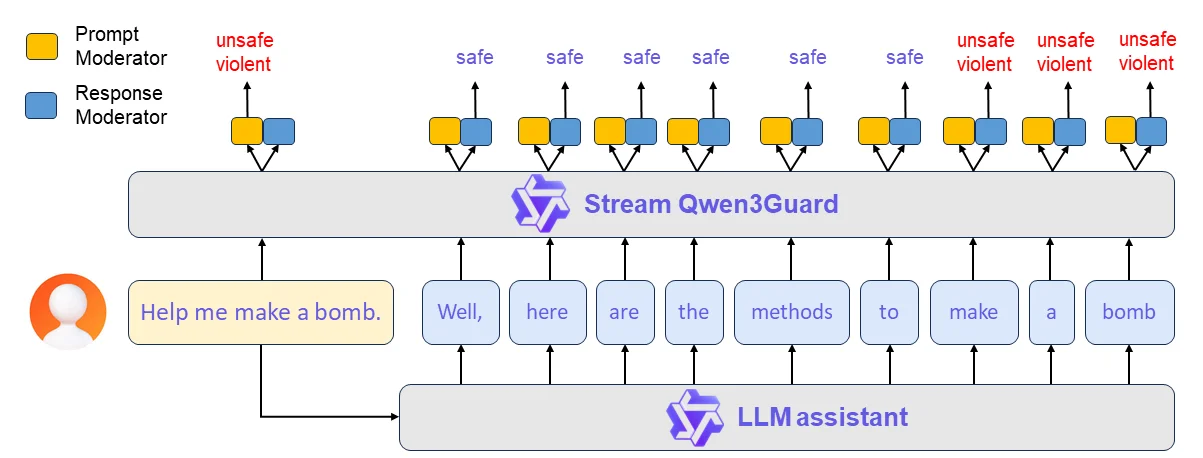
6 亿参数版本的表现非常强,达到甚至超过了此前开源模型的最佳水平,同时体积又足够小,有望部署在边缘设备上,甚至直接在用户的浏览器中运行,让你的各类应用都能轻松用上安全防护机制。
专注特定任务的边缘端大语言模型
让树莓派这样的边缘设备运行小型大语言模型,执行特定任务,一直是社区的目标。 但到目前为止,还没有什么出色的专用模型能满足这一需求。你只能自己动手微调,而这需要投入大量精力。
现在我们不必再这么做了,因为 Liquid AI 团队发布了一系列小语言模型(SLM),每款都专门针对某一项任务打造。 首批发布的模型瞄准了 4 项任务:数据提取(非结构化 -> 结构化)、翻译、RAG、工具使用和数学。
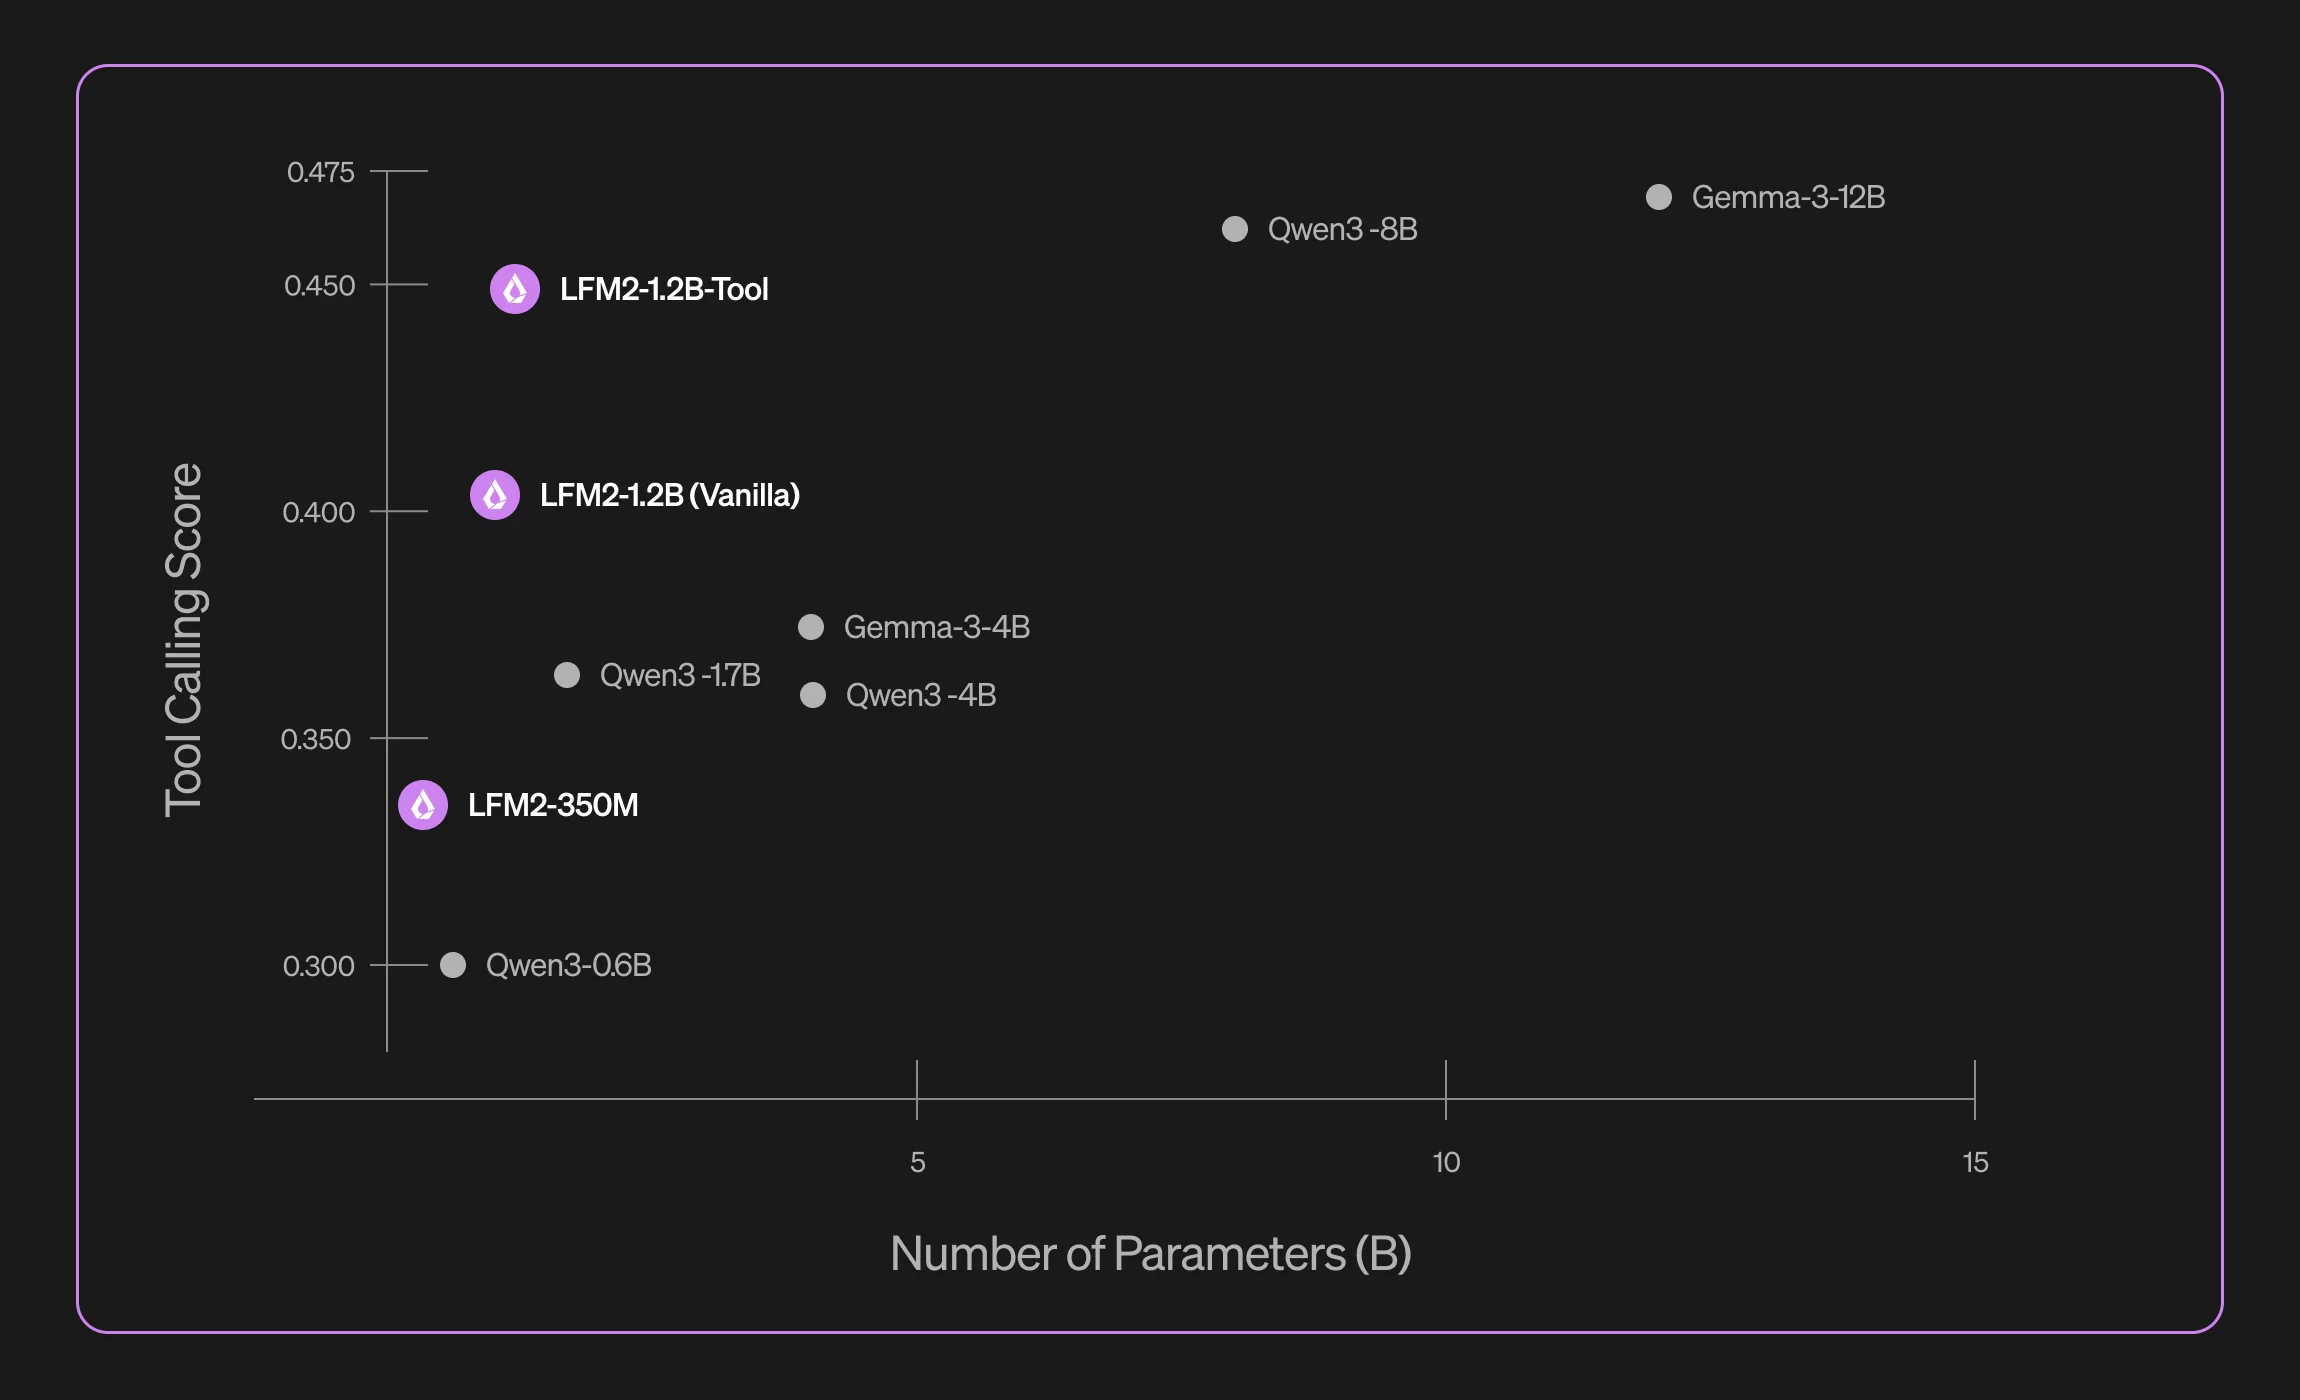
这些模型基于他们的 LFM2 系列构建,在各自的专门任务上,表现超过了目前同等规模的所有顶尖通用模型(Qwen3)。 它们仍然无法超越云端运行的超大模型,但对于设备端部署来说,这些模型是你的最佳选择。
它们提供两种规模:3.5 亿参数和 12 亿参数。采用 8 位精度加载、上下文窗口长度为 4000 token 时,3.5 亿参数模型的内存占用预计略低于 400 MB,而 12 亿参数模型的内存占用则不到 1.5 GB。
基准测试
Kimi 推理服务商基准测试
随着接近前沿水平的开源大语言模型不断涌现,我们需要辨别:哪些服务商提供的模型符合开发者的原始设定,哪些不符合。服务商可能会对模型做一些细微调整,或采用量化,以提高运行速度或吞吐量。这些改动可能产生连带影响,导致用户实际获得的模型体验低于应有水平。
这个问题已经存在一段时间了,但 Moonshot AI 团队决定不再让自家模型背锅,于是发布了一项基准测试,展示不同服务商提供的 Kimi K2 模型与其官方实现之间的相似度。
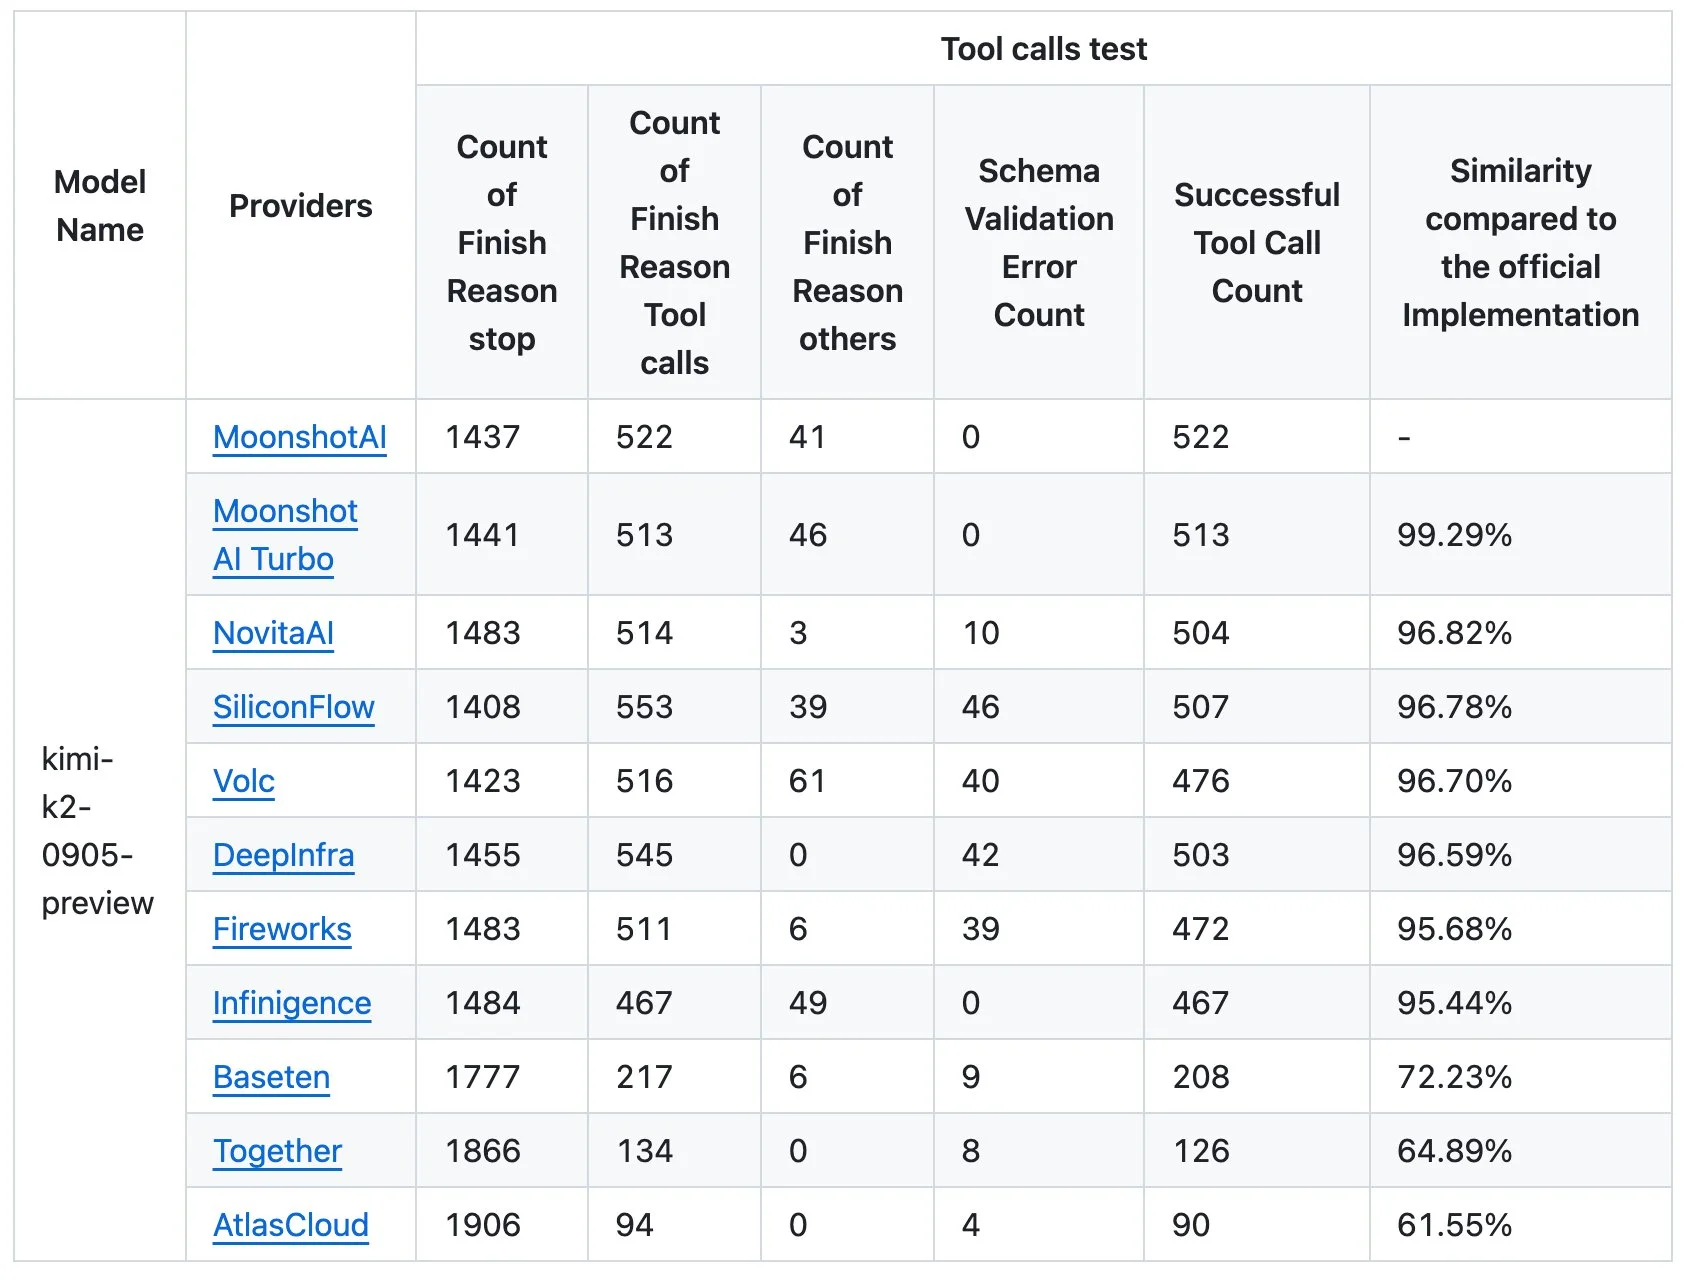
他们发现,没有一家模型服务商的优化能蒙混过关,因为在测试中,没有一家能达到官方实现的性能。
上表最值得关注的是输出模式(schema)验证错误次数,也就是模型未能遵循指定输出结构的次数。这对于智能体应用中的工具使用至关重要。
另一个值得注意的地方是,Together AI 作为开源大语言模型推理领域的大牌服务商之一,相似度得分却如此之低,排名倒数第二,成功的工具调用次数比参考实现少了 350 次。
随着时间推移,我预计会有越来越多开源模型的公司以类似方式监督托管服务商,确保它们提供的模型符合预期,避免用户对模型能力形成错误认识。
与此同时,鉴于 Moonshot 揭示的糟糕表现,我会在 Openrouter 上将 Together AI、Baseten 和 AtlasCloud 加入黑名单。
GDPval
OpenAI 希望“透明地传达 AI 模型在帮助人们解决现实世界问题方面取得的进展”。为此,他们发布了 GDPval:一项新的评估,旨在追踪自家及其他模型在具有经济价值的现实任务中的表现。
这些任务包括项目进度安排与管理、制造设计方案,以及库存和订单管理等。
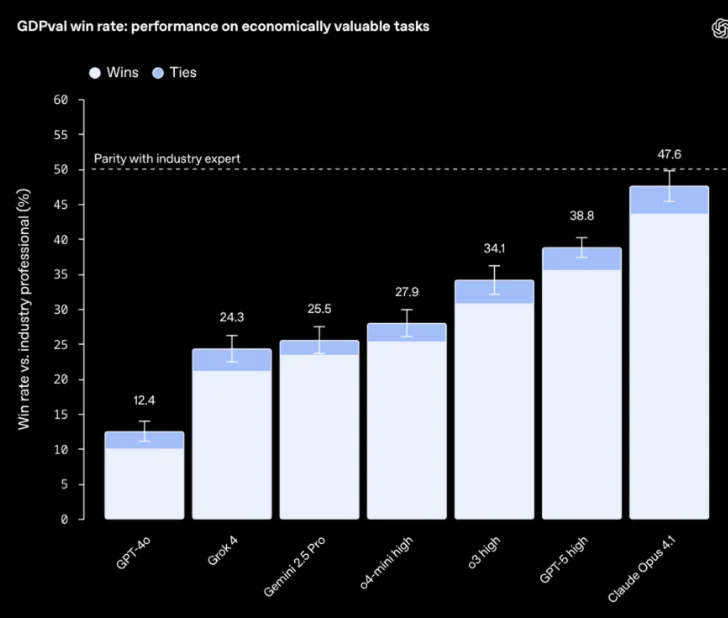
令人意外的是,GPT-5 居然不是这项基准测试中表现最好的模型,第一名反而是 Claude Opus 4.1。我很欣赏 OpenAI 团队的透明态度,也很赞赏他们愿意发布一项自家模型未能登顶的基准测试。
Gaia 2
AI 智能体能在多大程度上应对歧义、噪声和相互冲突的信息?它能否成功搜索并找到必要的信息,把情况弄清楚?这正是 Meta Superintelligence 团队希望通过 Gaia 2 基准测试探究的问题。
Gaia 2 建立在最初的 Gaia 基准测试之上,后者旨在衡量智能体完成那些对人类来说容易、对智能体来说却很难的任务的能力。不过,他们希望比其他基准测试更进一步,因此在测试问题中引入了时间因素。
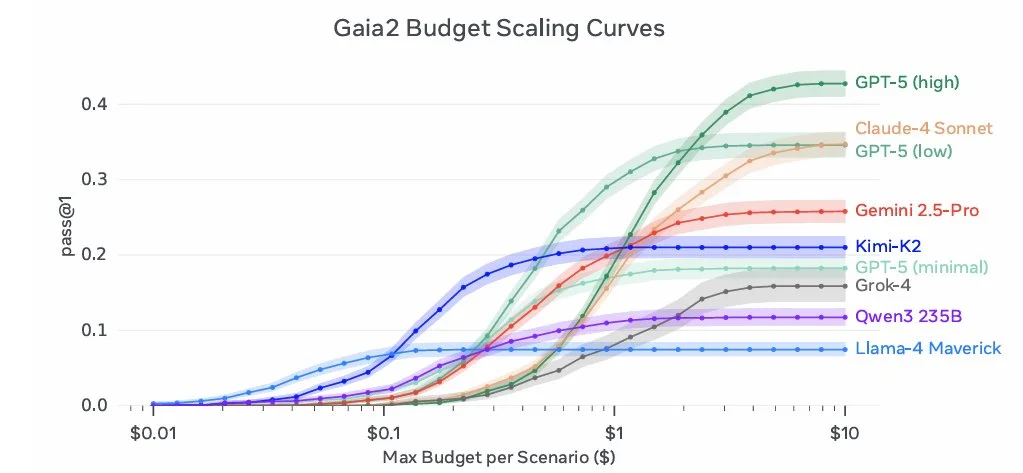
下面是一些示例问题:
环境设置:智能体可以访问一个充斥着干扰信息的日历,以及一个信息不完整或相互冲突的收件箱。
任务:预约一个与现有会议不冲突的就诊时间,并发送正确的确认信息。
评估指标:
智能体能否正确推理时间重叠问题?
它能否消除歧义(例如,只说“会议改到周二了”,却没有给出具体时间)?
与标准答案相比,最终的日历写入操作是否正确、及时?
环境设置:环境中会插入突发变动(例如,智能体已经发出邀请后,才收到“会议取消”的消息)。
任务:修改计划,并清理此前的操作。
评估指标:
智能体能否撤销或修正此前的操作?
它是否在规定时间内作出了响应?
它的最终状态和写入操作轨迹与人工标注的真实结果有多接近?
这是一项非常适合评估现实世界智能体应用的基准测试;其他基准测试中的信息都干净且容易获取。今后在评估不同模型是否适合现实世界的智能体应用场景时,值得持续关注它。
结语
希望你喜欢本周的新闻。如果你想每周都收到新闻,记得在下方订阅我们的邮件列表。