Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Qwen
A Qwen de alguma forma se superou esta semana, lançando 10 novos produtos e modelos. Aqui estão os mais notáveis aos quais você deve prestar atenção. Todos os modelos que vou mencionar (exceto Qwen Guard) estão disponíveis para uso GRATUITO no site da Qwen.
Qwen3 Max
Em uma mudança de seus lançamentos open source habituais, eles lançaram seu maior modelo, Qwen3 Max, apenas via API e interface web. O modelo é um modelo de mistura de especialistas (mixture of experts) e possui supostamente mais de um trilhão de parâmetros.
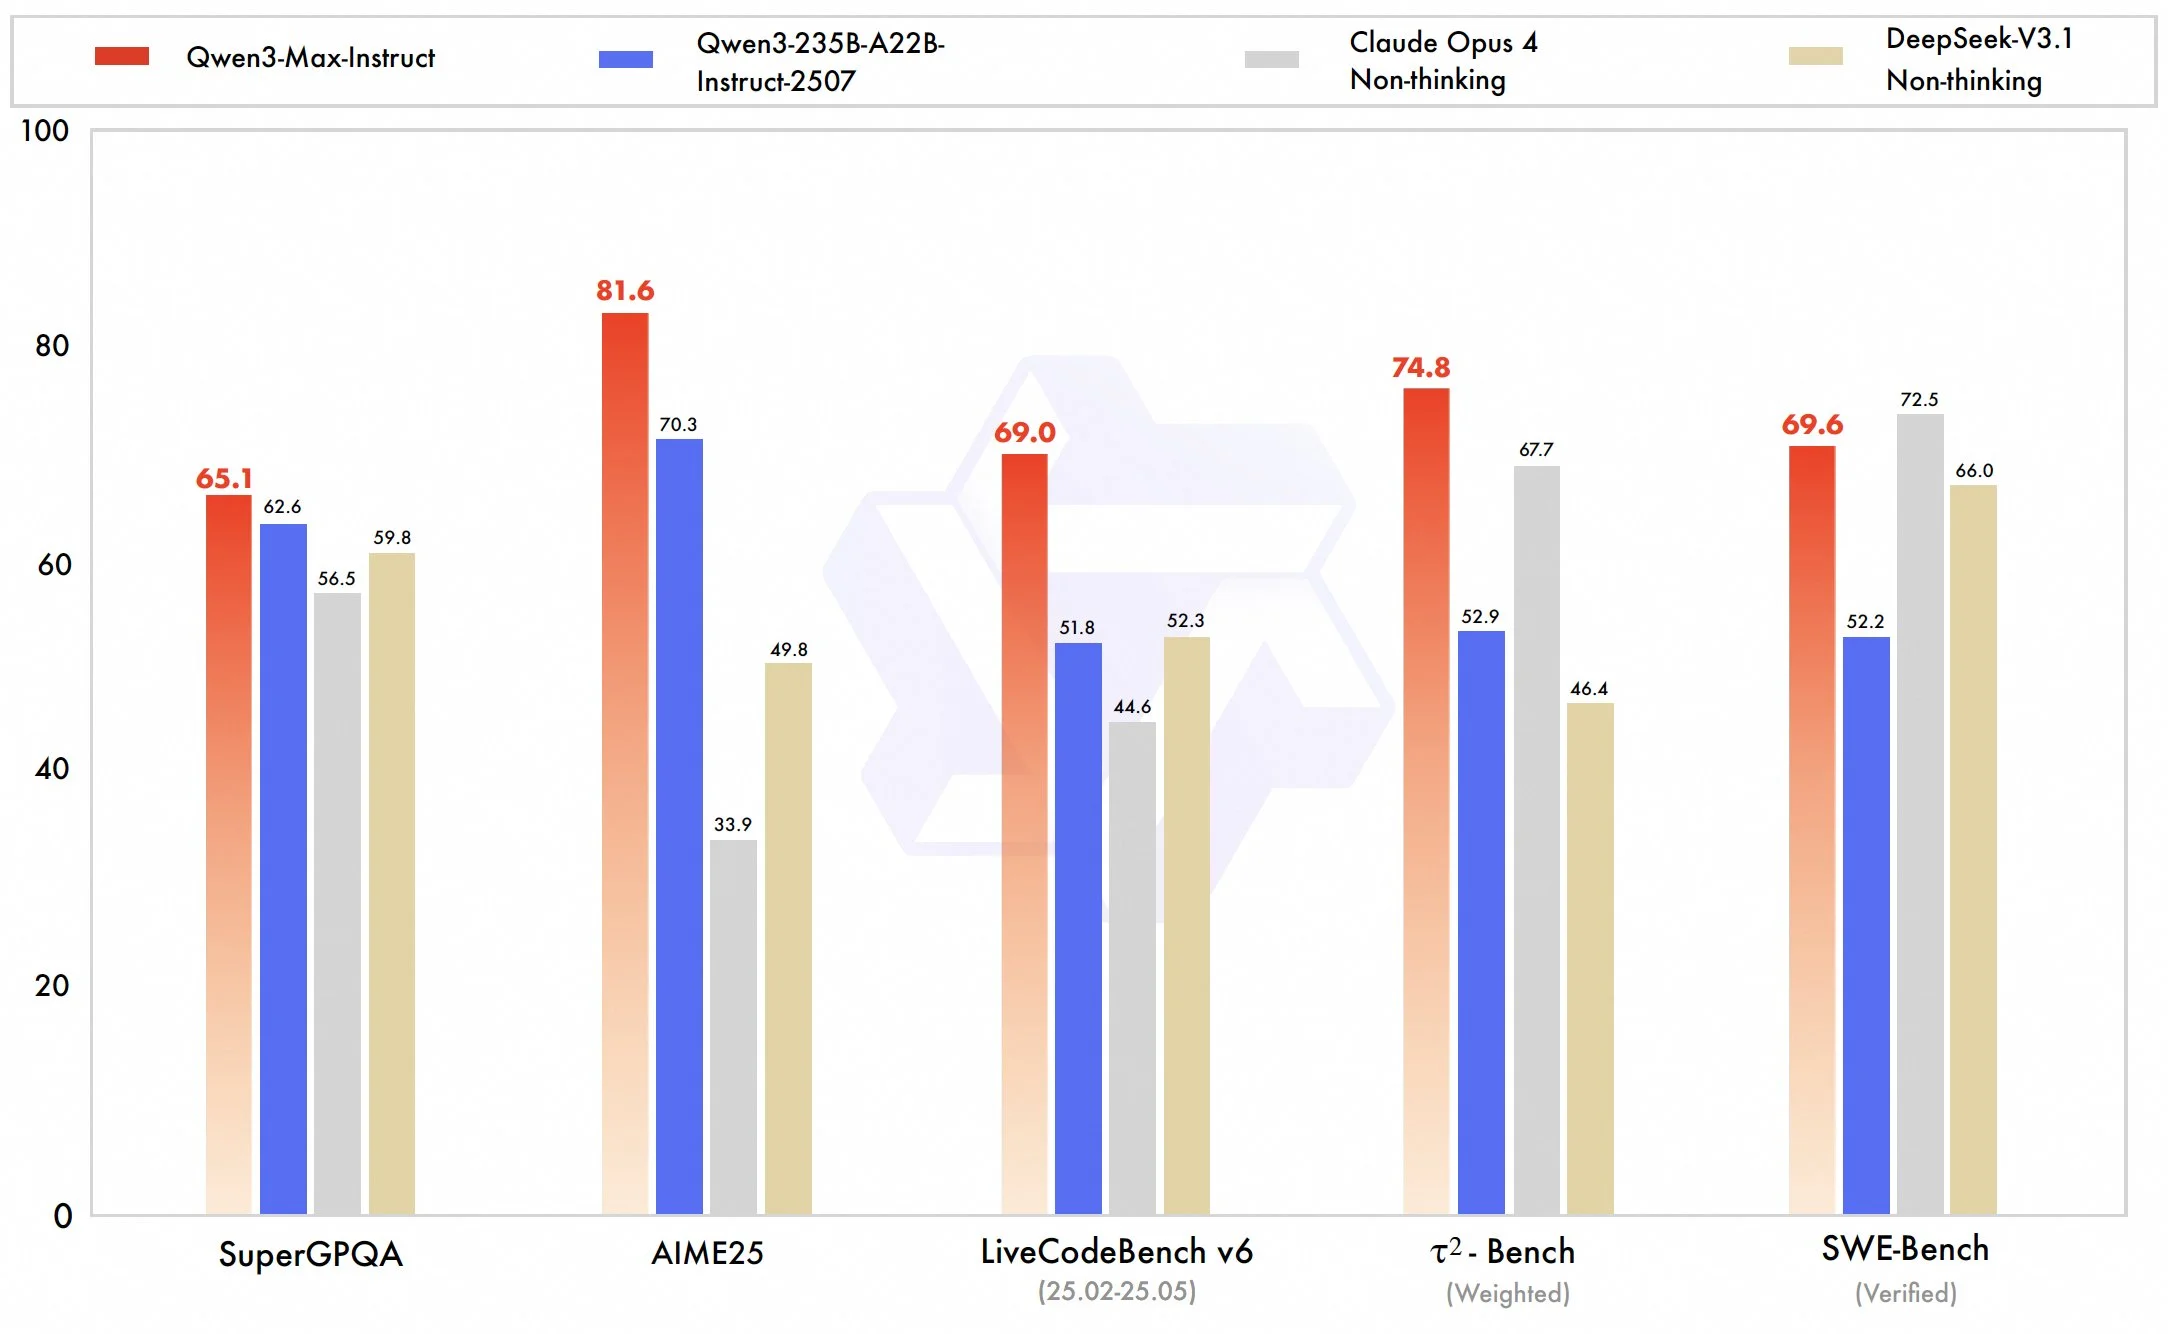
O modelo apresenta benchmarks muito bons, similares ao Claude Opus e DeepSeek 3.1. Ele também parece passar no teste da comunidade, com muitas pessoas relatando forte capacidade de programação, chamadas de ferramentas e capacidades gerais de escrita. Teremos que esperar mais algumas semanas até que benchmarks adequados para este modelo sejam lançados antes que possamos afirmar definitivamente que este é um modelo de nível de fronteira.
O modelo está usando preços escalonados dependendo de quantos tokens ele usa, o que estamos vendo cada vez mais à medida que a janela de contexto utilizável para esses LLMs cresce.
| Comprimento de Contexto | Tokens de Entrada/Milhão | Tokens de Saída/Milhão |
|---|---|---|
| 0–32K | $1.2 | $6 |
| 32K–128K | $2.4 | $12 |
| 128K–252K | $3 | $15 |
Para contextualizar, o GPT-5 custa $10 por milhão de tokens de saída, e o Claude Sonnet custa $15 por milhão, colocando este modelo aproximadamente no mesmo nível desses modelos, mostrando a confiança da Qwen em sua força.
Qwen3-VL
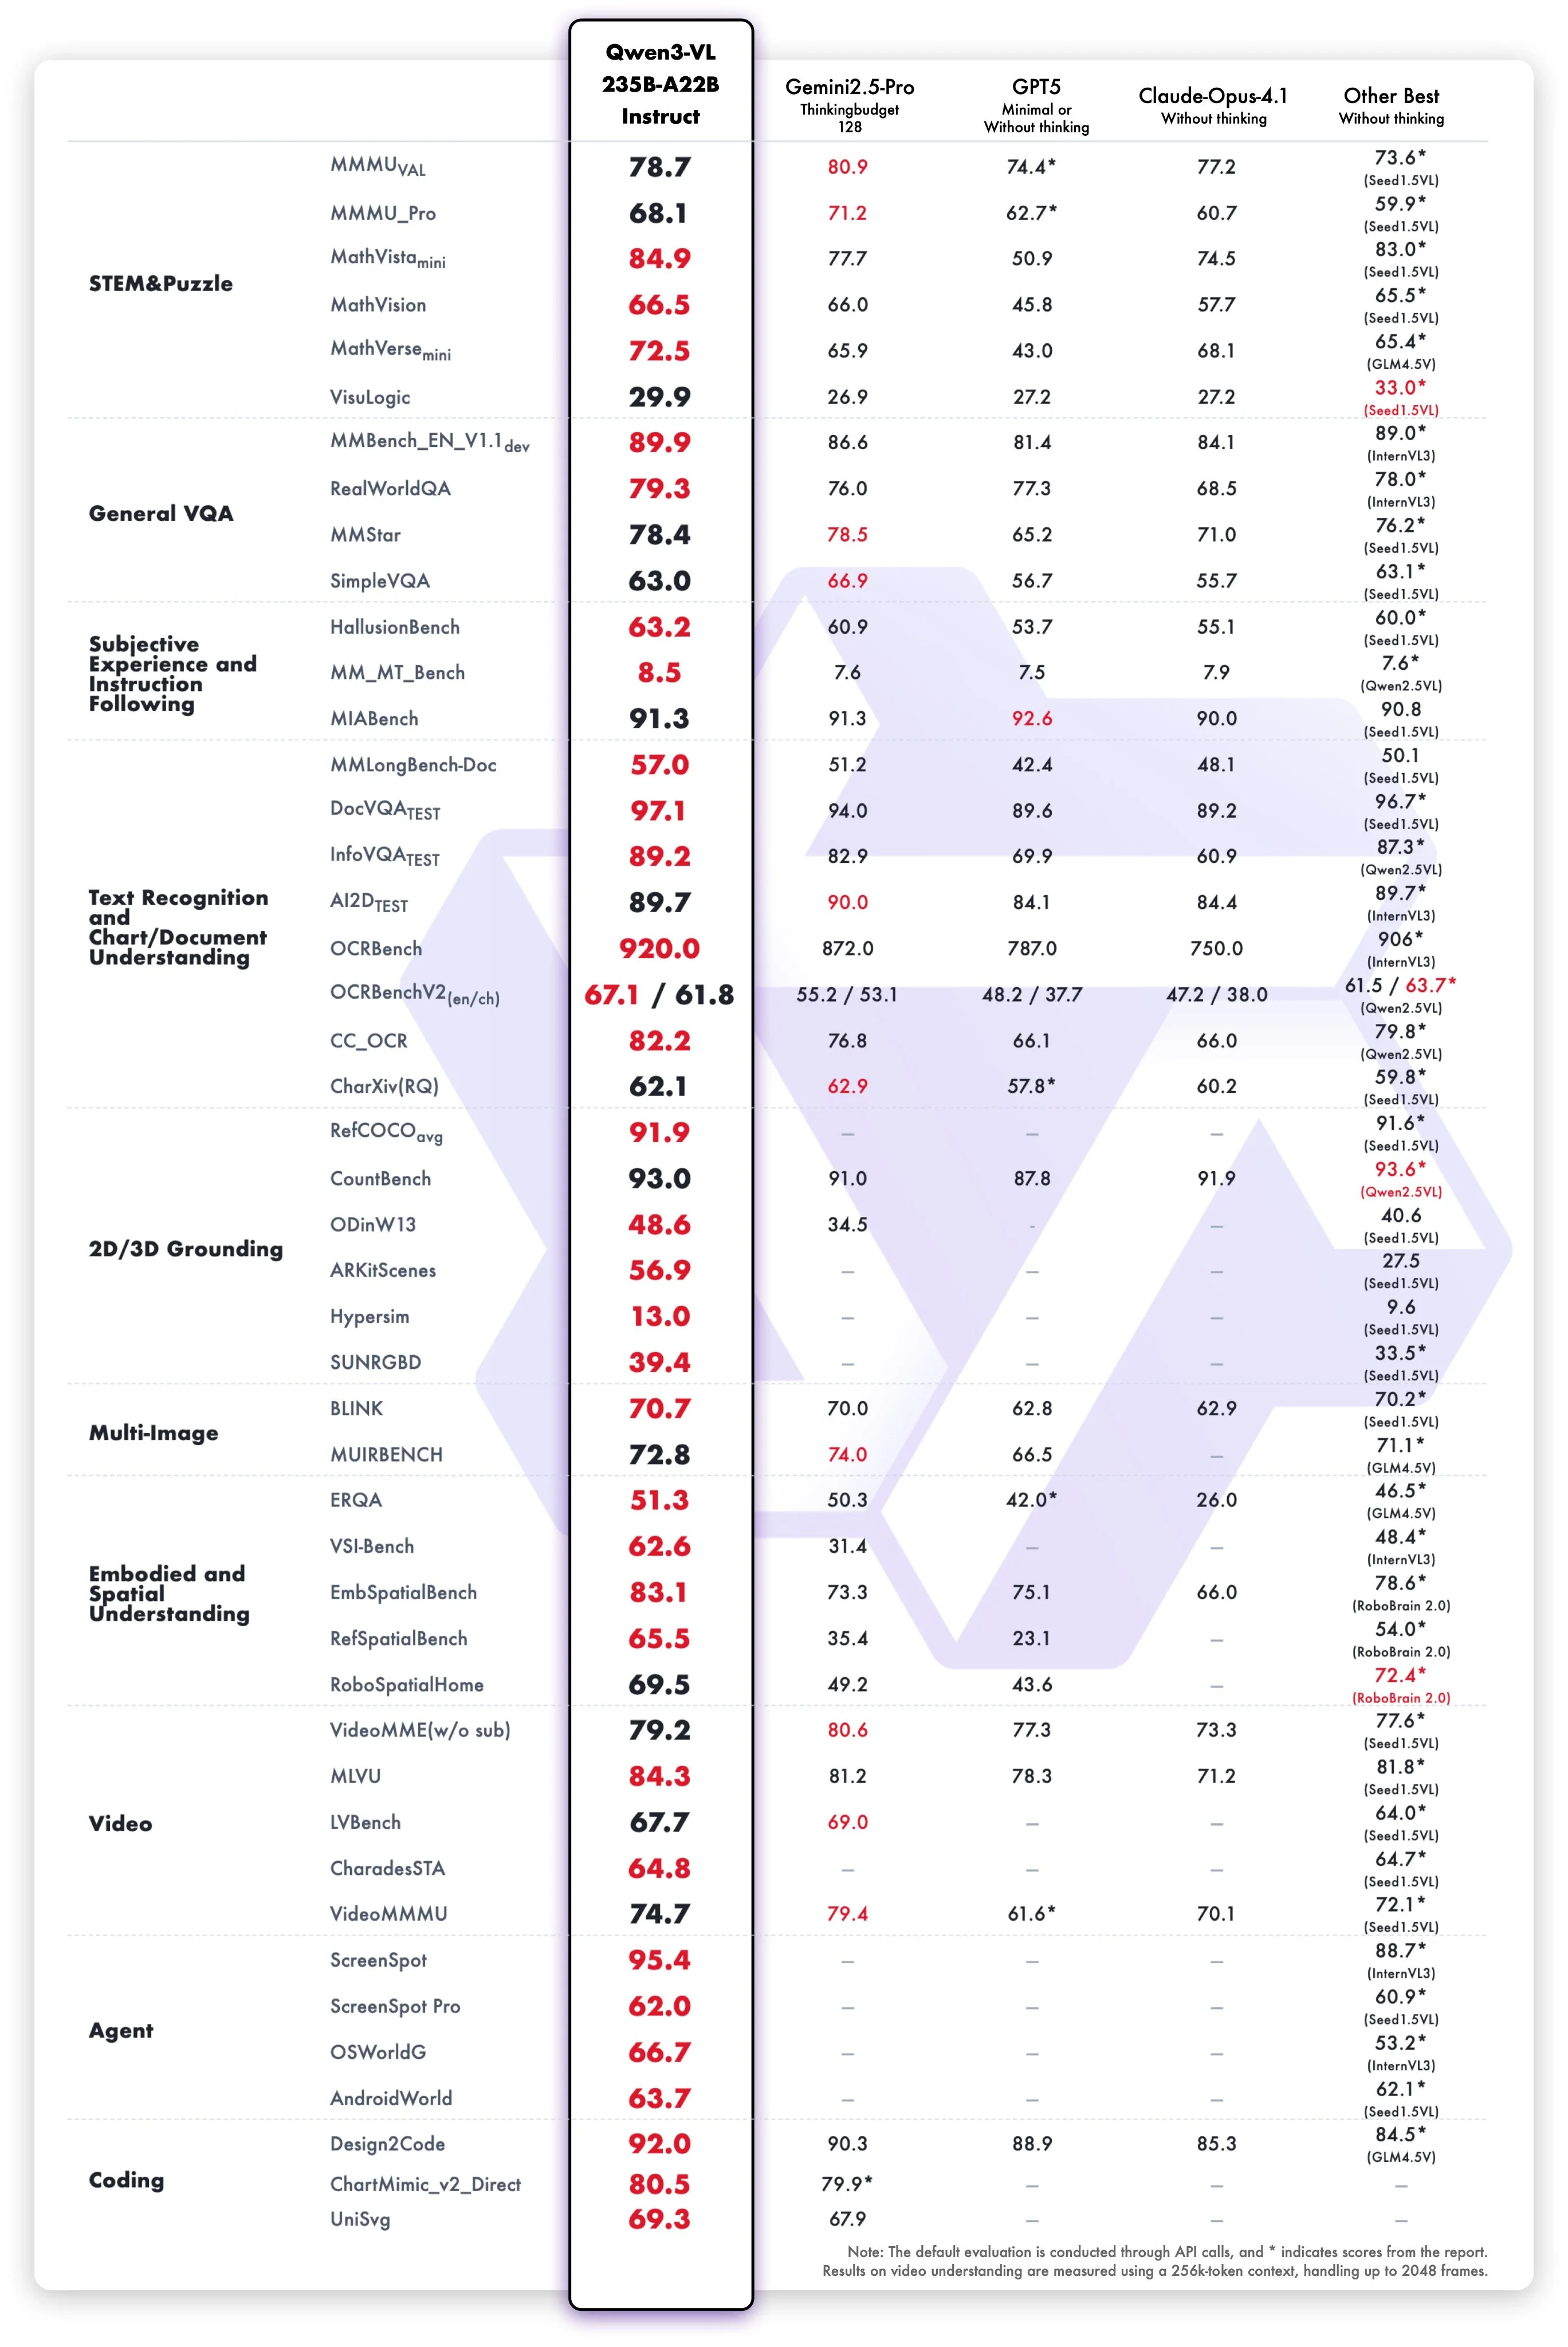
O próximo lançamento é o modelo de visão Qwen3, construído sobre seu modelo MOE de 235 bilhões de parâmetros. Seus benchmarks o colocam no topo de todo o ecossistema de VLM de fronteira, superando o campeão atual Gemini 2.5 Pro na maioria dos benchmarks testados.
O teste da comunidade também parece bom. Tenho visto relatos de pessoas dizendo que ele foi capaz de resolver problemas que nenhum outro VLM havia conseguido antes, incluindo Gemini Pro e GPT-5. Pessoalmente, vou passar a usar por padrão o Qwen3-VL para quaisquer consultas multimodais que eu tiver no futuro com base no que tenho visto e ouvido sobre ele.
Apesar deste grande modelo de fronteira ser open source, ainda estou um pouco desapontado que ele só exista para a versão de 235 bilhões de parâmetros. Nesse tamanho, é complicado para praticamente qualquer usuário doméstico conseguir usar. Espero que no futuro eles lancem uma variante baseada em seu modelo de 30 bilhões de parâmetros, para que possamos facilmente executá-lo em casa nós mesmos.
Qwen3 Omni
Qwen3 Omni, como o nome sugere, é um modelo que pode lidar com todas as modalidades. Ele pode receber entrada de texto, imagem, vídeo ou áudio, e então pode produzir saída de texto ou áudio.
Ele é construído sobre o modelo MoE de trinta bilhões de parâmetros, permitindo inferência rápida e ostentando um tempo de resposta de áudio para áudio de 250 milissegundos, tornando-o uma ótima opção para aplicações de assistente de voz em tempo real.
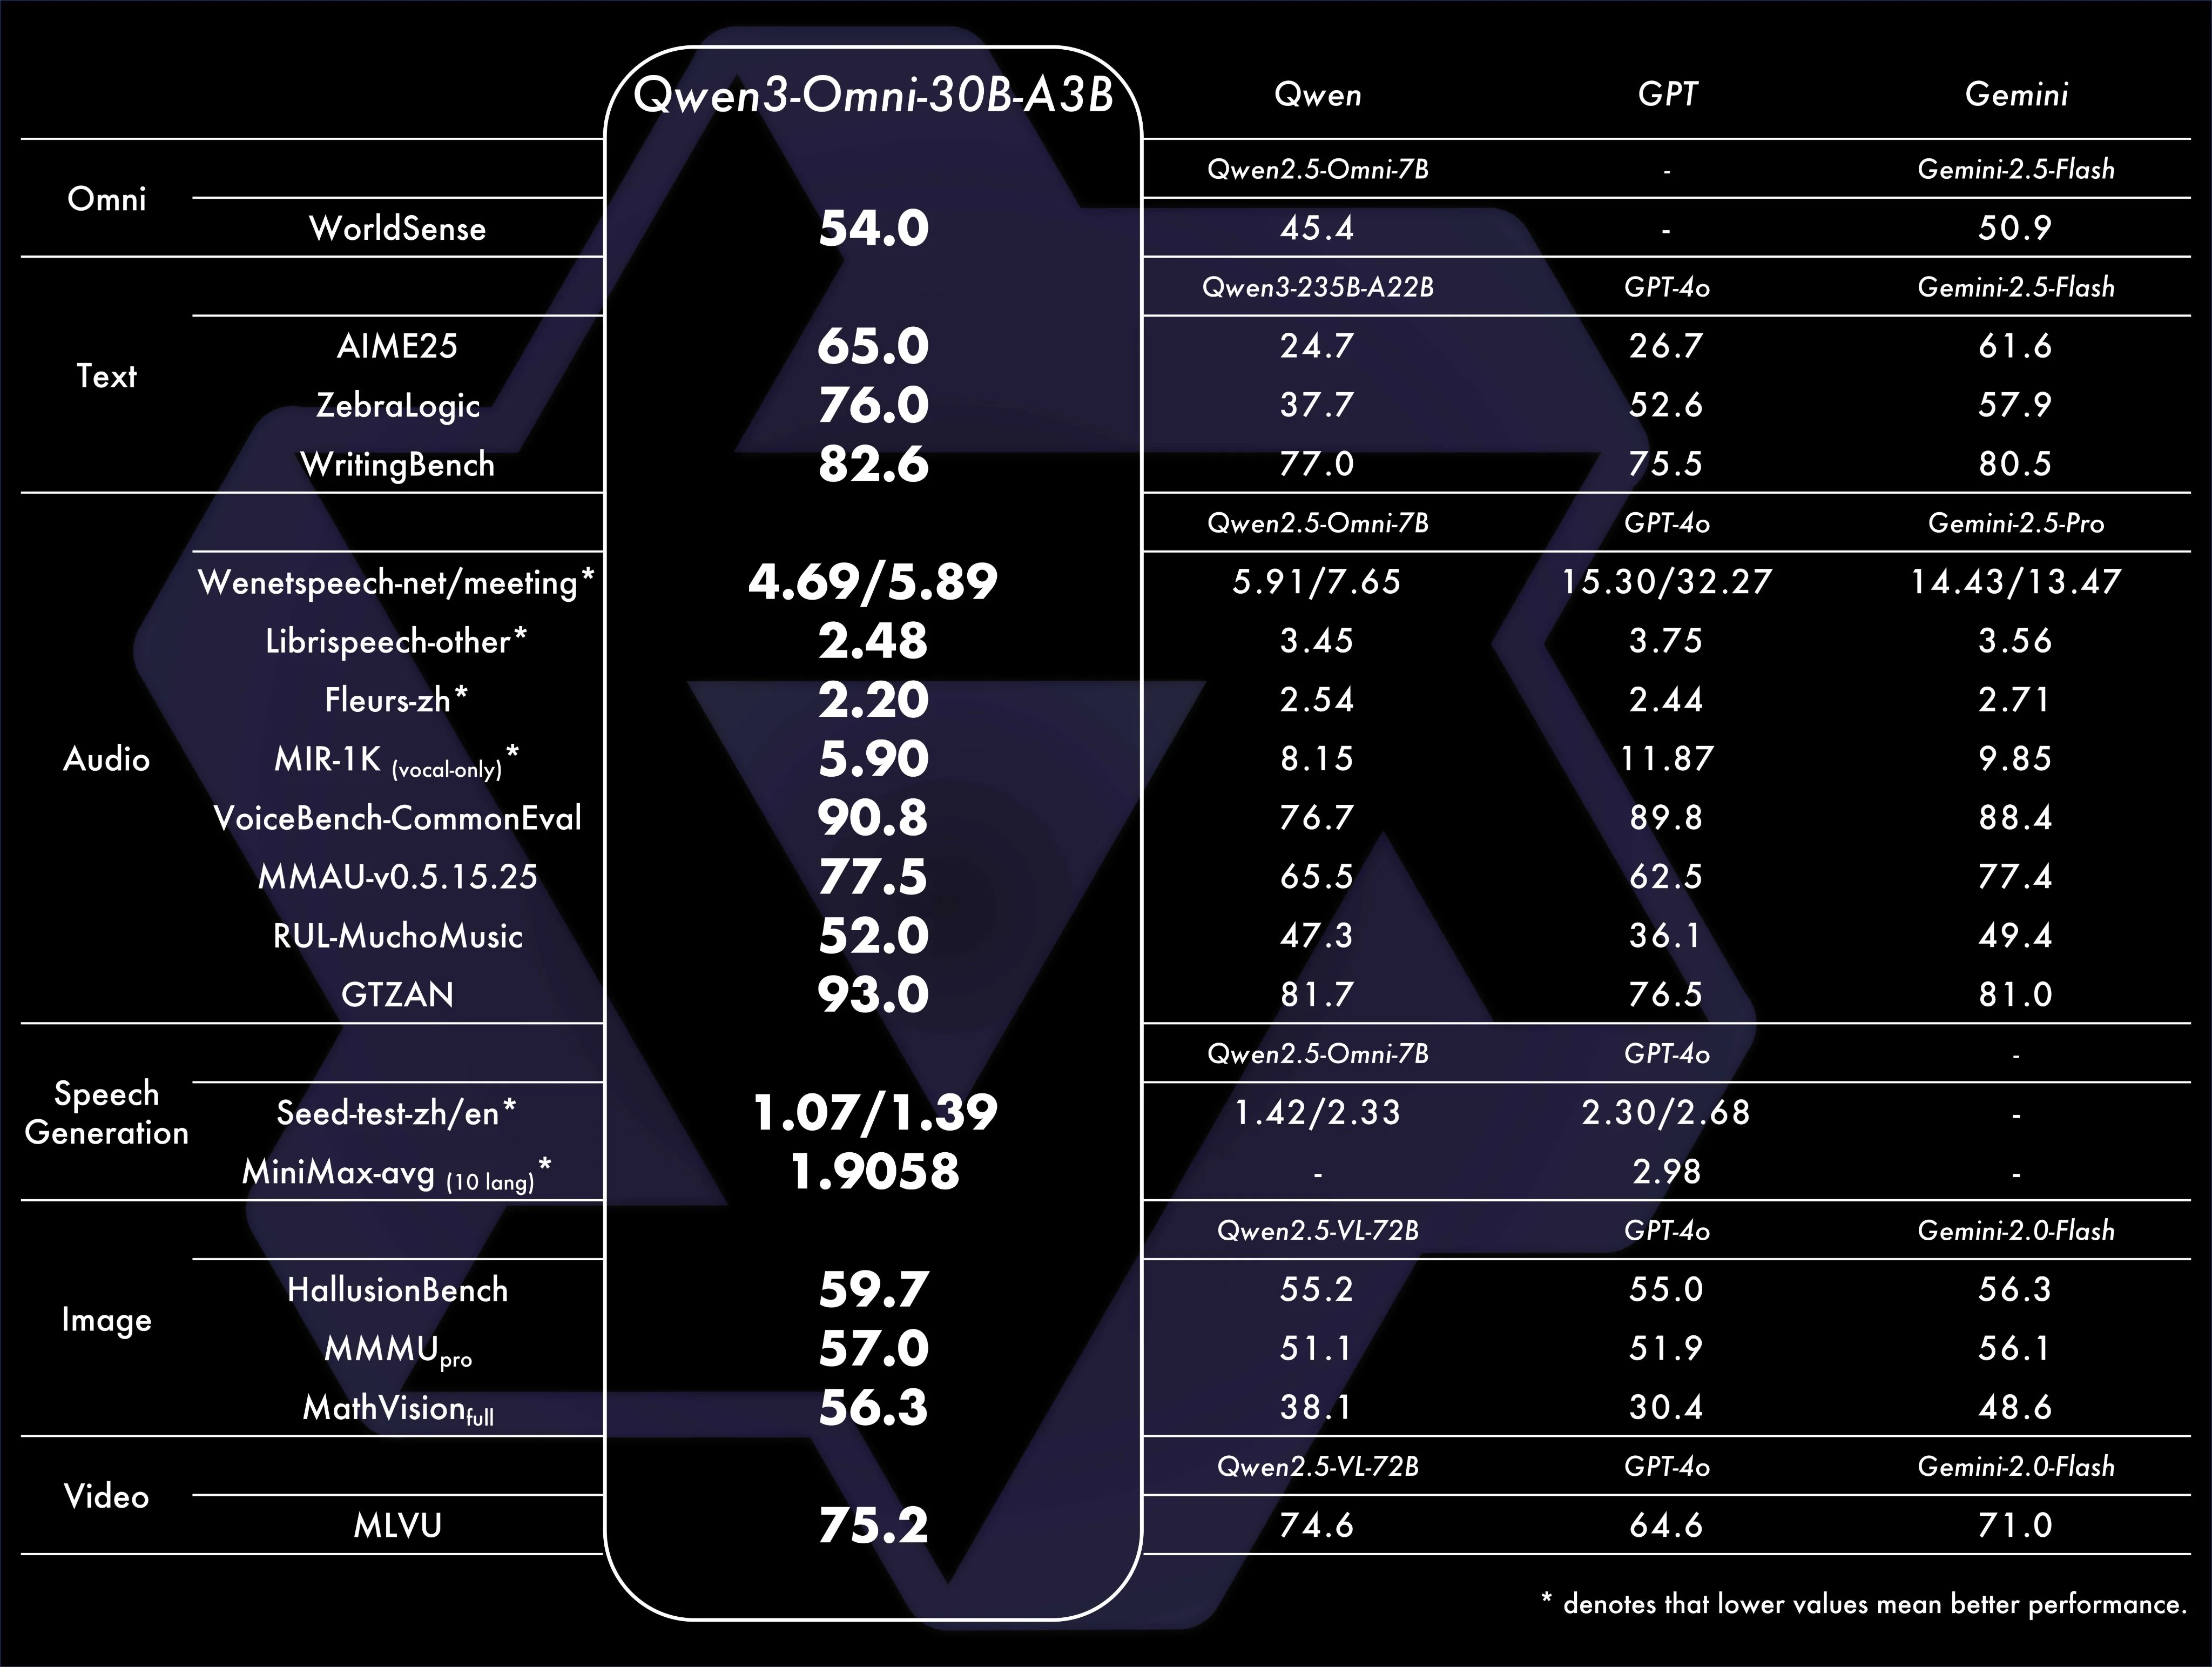
Pelo meu uso até agora no site da Qwen, parece ser um modelo razoavelmente inteligente. Há algum atraso nos tempos de resposta de voz para voz, mas isso pode ser devido ao fato de que os servidores da Qwen estão na China, adicionando uma grande quantidade de latência apenas devido à distância. A qualidade da saída de áudio definitivamente não é tão forte quanto algo como o modo de voz do ChatGPT, mas ainda é clara e utilizável. Seu entendimento de vídeo é forte para open source, mas não rivaliza com os modelos Gemini ou o novo modelo Qwen3-VL.
Qwen3 Guard
Faz um tempo desde que vimos um lançamento de moderação de segurança na comunidade open source, mas a Qwen foi lá e nos forneceu isso. Seu modelo Qwen3 Guard vem em três tamanhos, 600 milhões, 4 bilhões e 8 bilhões de parâmetros e oferece um aumento na qualidade comparado aos modelos de segurança anteriores que tínhamos, incluindo Llama Guard 3. Ele é particularmente forte em situações multilíngues tanto para classificação de prompt quanto de resposta.
Ele pode fazer tanto classificação de prompt do usuário quanto classificação de saída do modelo de IA também. O usuário pode definir contra o que está procurando que o modelo proteja, e o modelo classificará entradas de usuário e saídas de modelo em uma de três categorias: seguro, controverso ou inseguro.
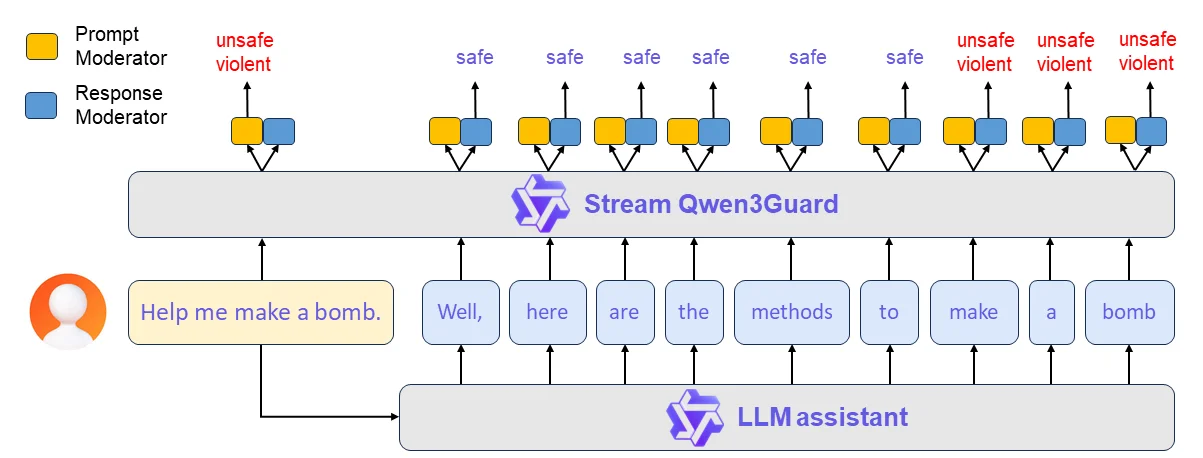
O modelo de seiscentos milhões de parâmetros é muito forte, igualando ou excedendo o SOTA open source anterior, ao mesmo tempo em que é pequeno o suficiente para potencialmente ser implantado na borda ou até mesmo executado no navegador de um usuário, tornando as proteções de segurança fáceis de acessar para qualquer uma de suas aplicações.
LLMs de Borda com Foco Estreito
Ser capaz de usar LLMs pequenos em dispositivos de borda como Raspberry Pis para tarefas específicas tem sido um objetivo da comunidade há muito tempo. Mas até agora não houve bons modelos feitos sob medida para fazer isso. Em vez disso, você teria que fazer o fine-tune do seu próprio, o que exigiria uma grande quantidade de esforço para fazer.
Agora não precisamos fazer isso, pois a equipe da Liquid AI lançou uma série de Modelos de Linguagem Pequenos (SLMs) que são especialmente feitos para fazer uma tarefa específica. Eles miraram 4 tarefas com seu lançamento inicial: extrações de dados (não estruturados -> estruturados), tradução, RAG, uso de ferramentas e matemática.
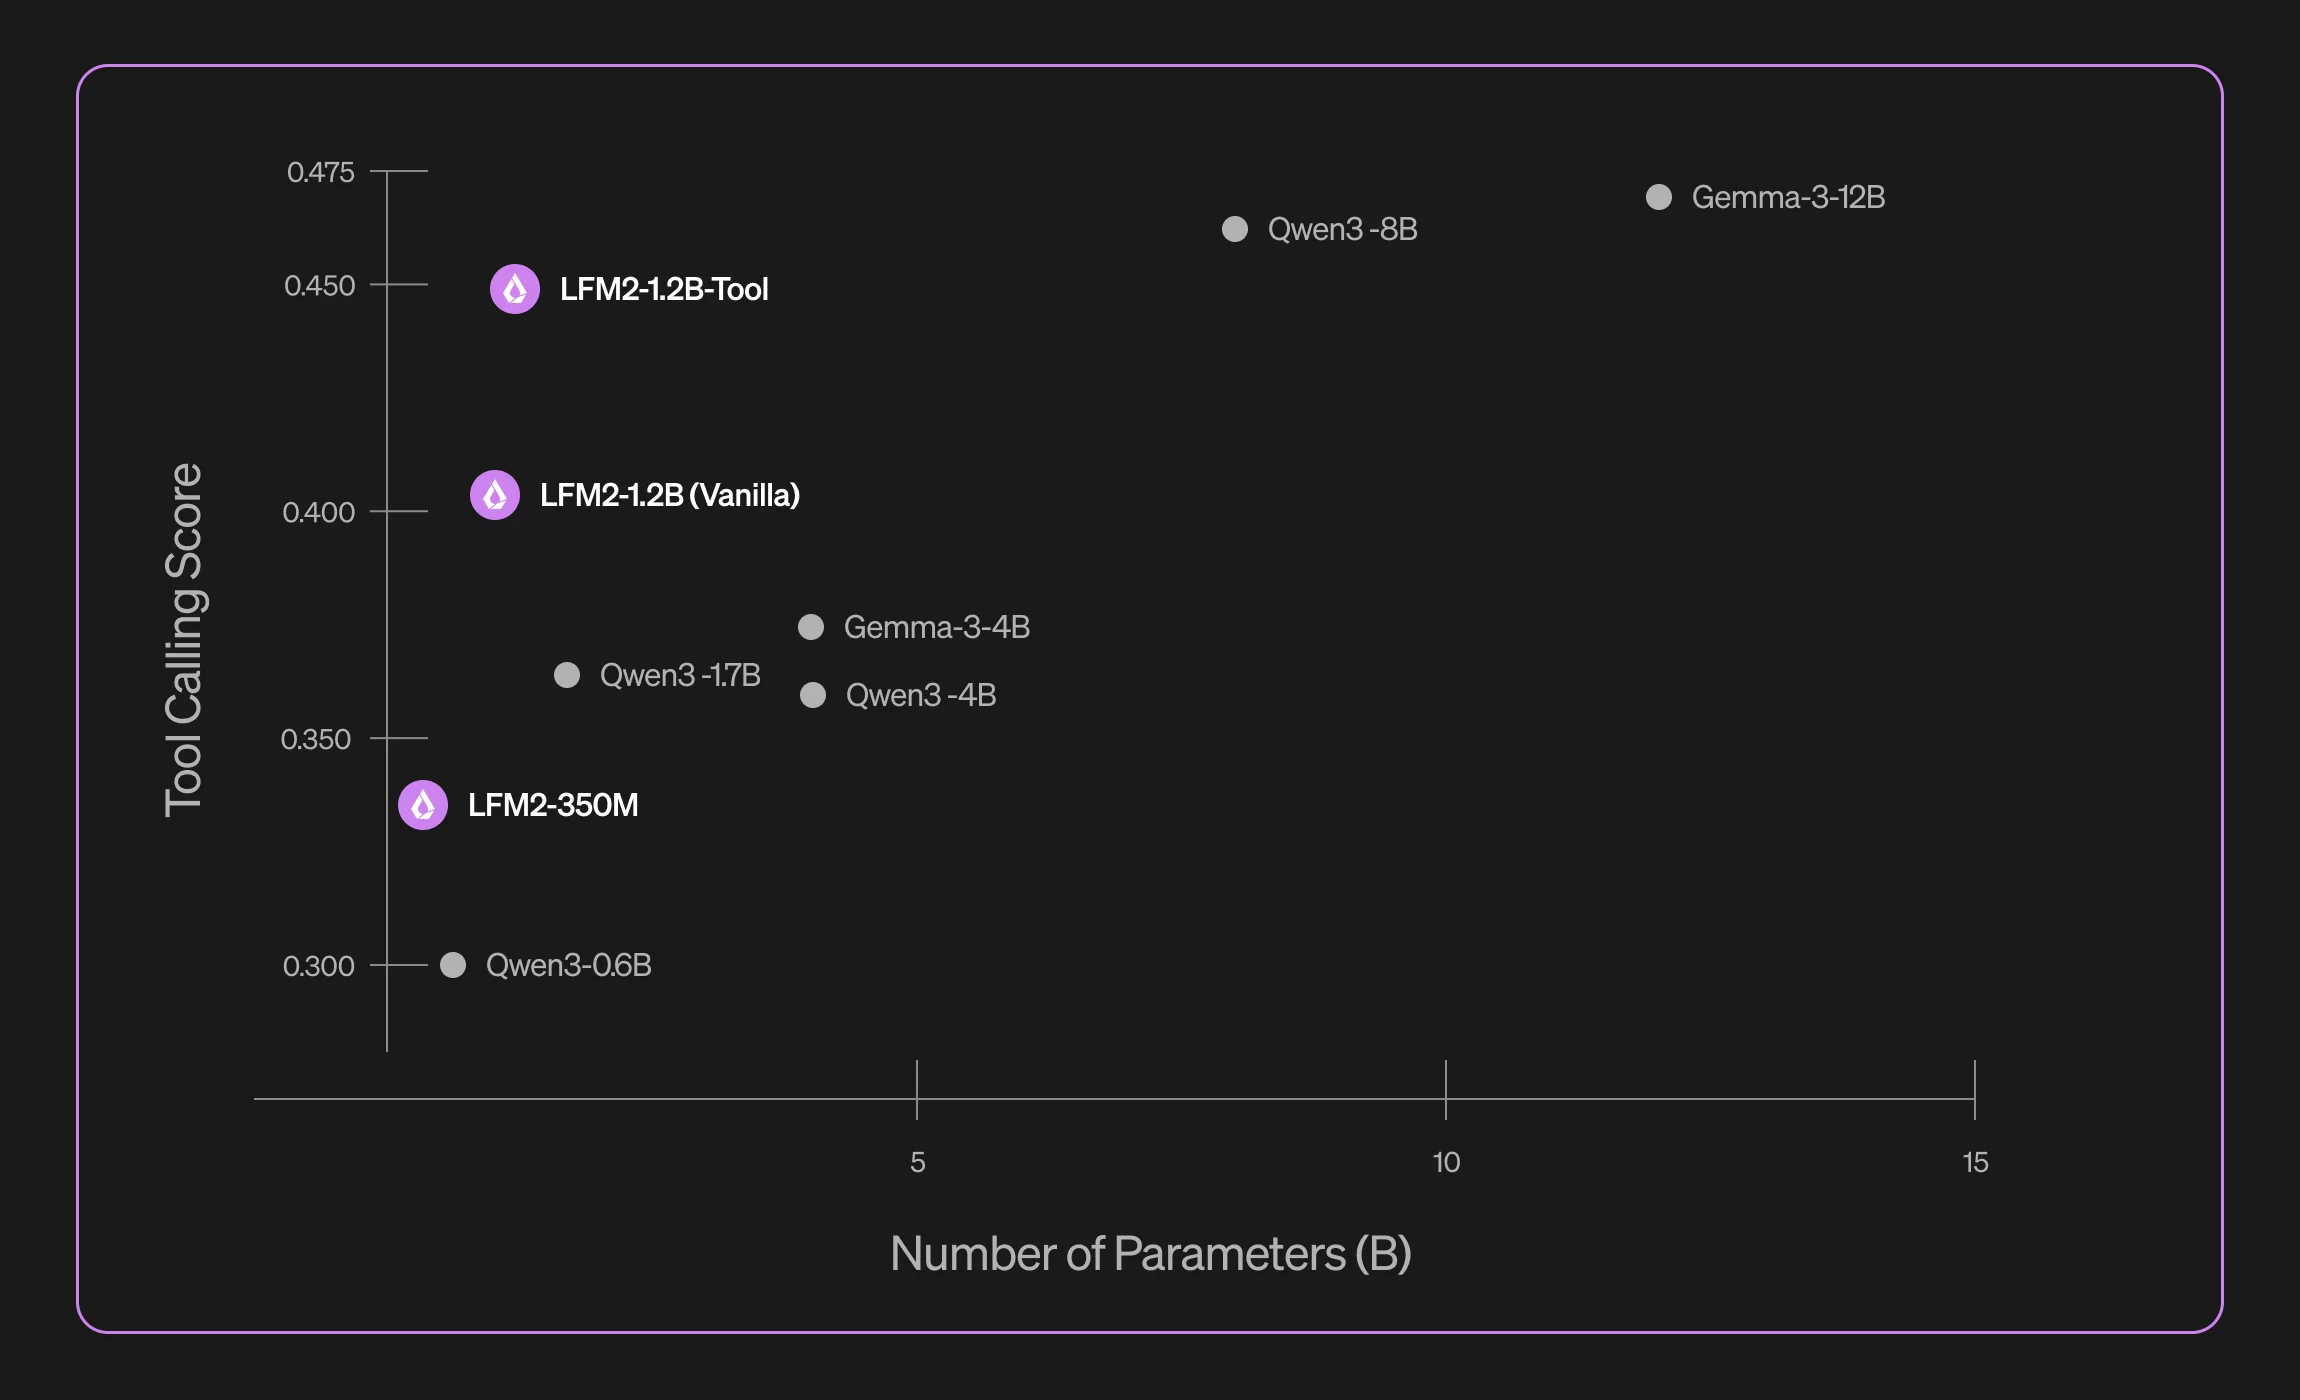
Esses modelos são construídos sobre sua série de modelos LFM2 e superam quaisquer modelos gerais de estado da arte (Qwen3) do mesmo tamanho que existem agora para sua tarefa específica. Eles ainda não vão superar os modelos muito grandes rodando na nuvem, mas para implantações em dispositivos esses modelos são sua melhor aposta.
Eles vêm em dois tamanhos: 350 milhões de parâmetros e 1,2 bilhão de parâmetros. Você pode esperar que o modelo de 350 milhões de parâmetros use um pouco menos de 400 megabytes de RAM quando carregado em 8 bits com uma janela de contexto de 4000 tokens, e o modelo de 1,2 bilhão de parâmetros usará menos de 1,5 gigabytes.
Benchmarks
Kimi Inference Provider Bench
Com o surto de LLMs open source de nível quase fronteiriço que temos visto, surgiu a necessidade de identificar quais provedores estão ou não servindo o modelo como os criadores do modelo originalmente pretendiam. Essas mudanças poderiam incluir pequenos ajustes de modelagem ou quantização para ajudar a executar o modelo mais rápido ou permitir que ele tenha maior throughput. Essas mudanças poderiam causar efeitos downstream, o que resultaria no usuário tendo uma experiência pior com os modelos do que deveria.
Este tem sido um problema conhecido há algum tempo, mas a equipe da Moonshot AI decidiu que não quer mais que seu modelo seja difamado e lançou um benchmark mostrando a similaridade dos diferentes provedores de modelo servindo seu modelo Kimi K2 quando comparado com sua própria implementação.
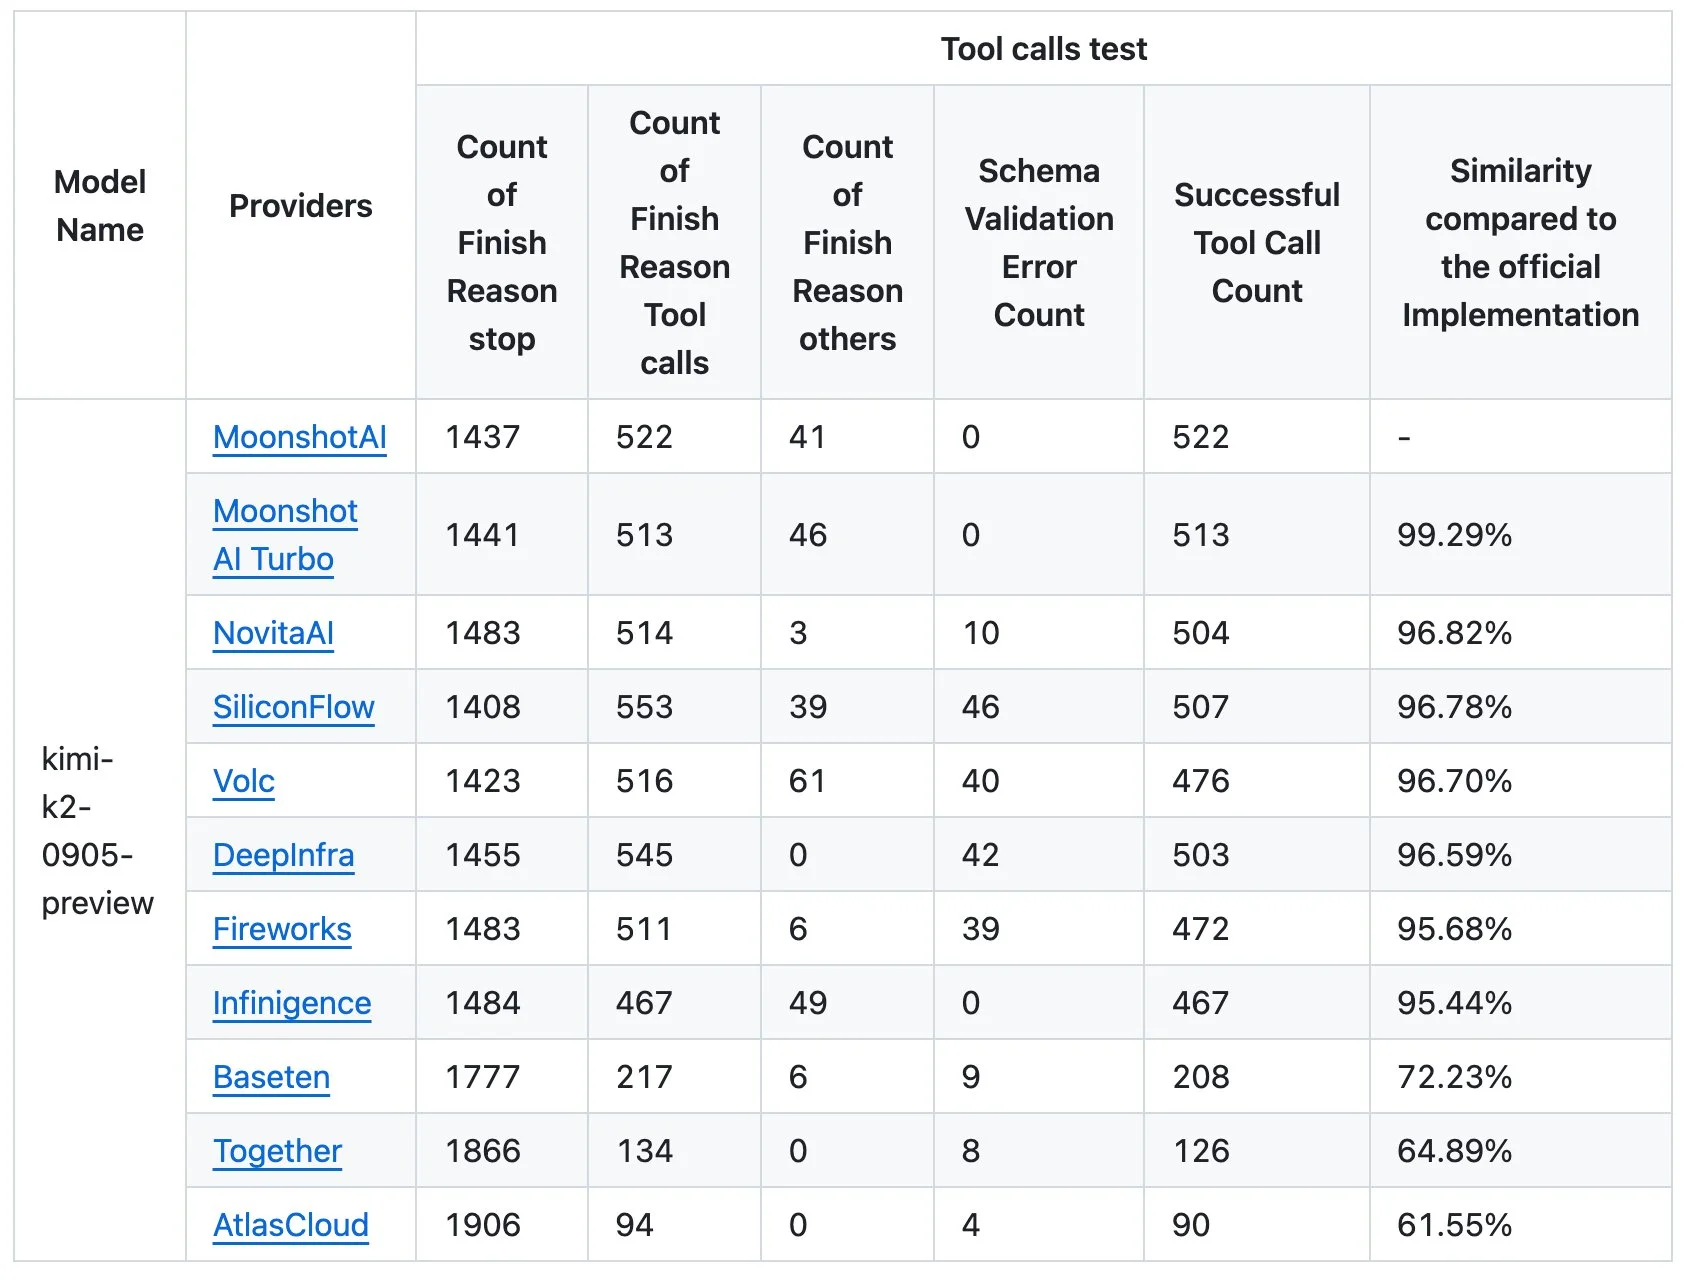
O que eles descobriram é que nenhum dos provedores de modelo conseguiu escapar com suas otimizações, já que nenhum deles foi capaz de igualar o desempenho do modelo em seus testes.
A principal coisa a observar na tabela acima é a contagem de erros de validação de esquema, que é uma falha do modelo em seguir o esquema de saída que foi especificado, o que é altamente importante para uso de ferramentas em aplicações agênticas.
Também é notável que a Together AI, um dos maiores nomes no espaço de inferência de LLM open source, tenha uma pontuação de similaridade tão baixa, ficando em penúltimo lugar em termos de similaridade com 350 chamadas de ferramentas bem-sucedidas a menos versus a implementação de referência.
À medida que o tempo passa, espero que muitas dessas empresas que estão fazendo open source de seus modelos comecem a policiar os hospedeiros de maneira similar para garantir que os modelos que estão servindo estejam corretos, para que os usuários não tenham uma falsa sensação da capacidade do modelo.
Enquanto isso, estou colocando na lista negra Together AI, Baseten e AtlasCloud no Openrouter, devido ao seu desempenho extremamente pobre como destacado pela Moonshot.
GDPval
A OpenAI quer “comunicar transparentemente o progresso sobre como os modelos de IA podem ajudar as pessoas no mundo real”. Para ajudar a facilitar isso, eles lançaram GDPval: uma nova avaliação projetada para ajudar a rastrear quão bem nossos modelos e outros performam em tarefas economicamente valiosas do mundo real.
Isso inclui tarefas como agendamento e gerenciamento de cronograma de projeto, propostas de design de fabricação e gerenciamento de inventário e pedidos.
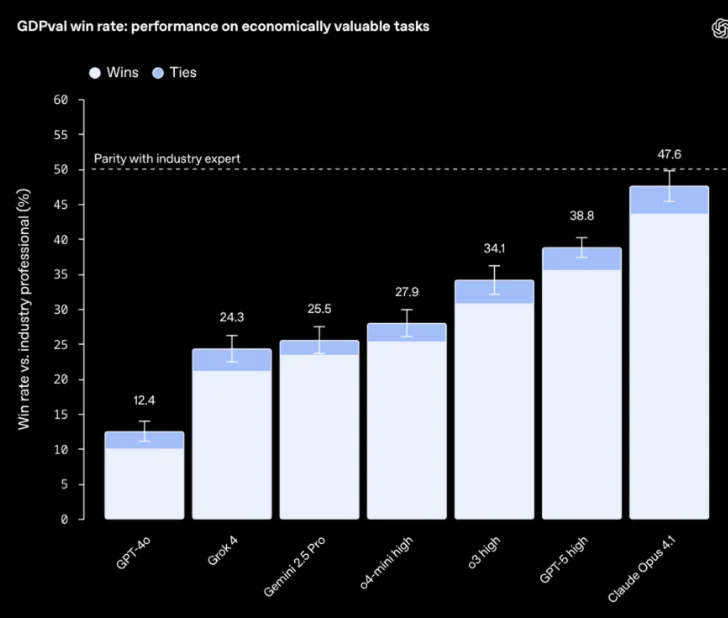
Em uma reviravolta chocante, o gpt5 na verdade não é o modelo com melhor desempenho neste benchmark. Em vez disso, é o Claude Opus 4.1. Aprecio a transparência da equipe OpenAI e a disposição de publicar um benchmark onde seu modelo não está no topo.
Gaia 2
Quão bem os agentes de IA podem lidar com coisas como ambiguidade, ruído e informações conflitantes? Ele pode pesquisar e encontrar com sucesso as informações necessárias para esclarecer a situação? Isso é o que a equipe Meta Superintelligence queria descobrir com seu benchmark Gaia 2.
O Gaia 2 se baseia no benchmark Gaia original, que busca medir tarefas que são fáceis para humanos, mas difíceis para agentes. Eles queriam ir um passo além de outros benchmarks, porém, e introduziram um senso de tempo nos problemas que estavam sendo avaliados.
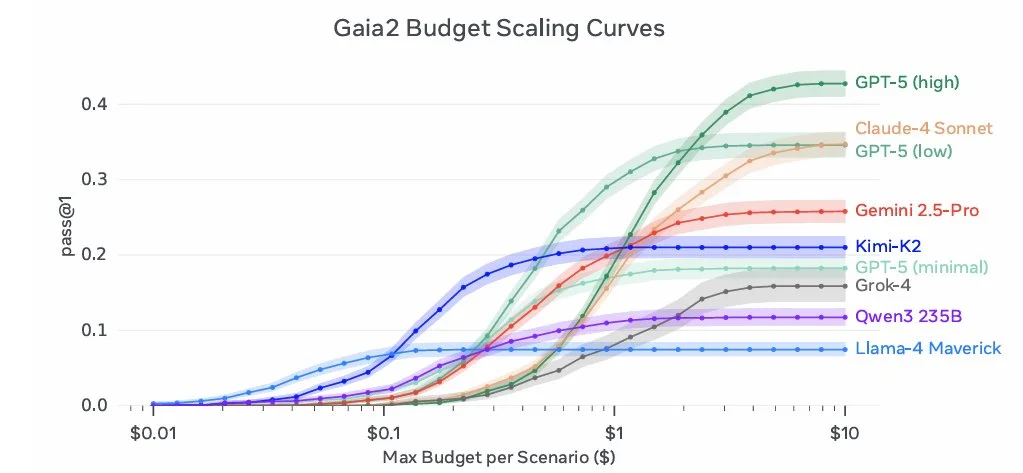
Alguns exemplos de problemas incluem:
Configuração: O agente tem acesso a um calendário ruidoso e uma caixa de entrada com informações parciais/conflitantes. Tarefa: Marcar uma consulta médica em um horário que não conflite com reuniões existentes e enviar a confirmação correta. Medição: O agente raciocina corretamente sobre horários sobrepostos? Ele pode resolver ambiguidade (por exemplo, “a reunião foi movida para terça-feira” sem horário)? A ação final de escrita no calendário foi correta e oportuna comparada à resposta do oráculo?
Configuração: O ambiente injeta interrupções (por exemplo, “reunião cancelada” depois que o agente já enviou convites). Tarefa: Revisar o plano e limpar ações anteriores. Medição: O agente pode desfazer ou corrigir ações anteriores? Ele respondeu dentro das restrições de tempo? Quão próximos seus estados finais e rastros de escrita correspondem à verdade fundamental anotada?
Este é um ótimo benchmark para uso agêntico no mundo real, onde todas as informações estão limpas e facilmente disponíveis como em outros benchmarks. Fique de olho nisso no futuro ao avaliar diferentes modelos para casos de uso de agentes no mundo real.
Finalização
Espero que você tenha gostado das notícias desta semana. Se você quiser receber as notícias toda semana, certifique-se de se juntar à nossa lista de emails abaixo.