
Nota: Este artículo fue traducido automáticamente con OpenAI GPT-5.5 mediante Codex CLI; la calidad puede verse degradada, especialmente en la terminología técnica.
En resumen
- ¿Puede Anthropic recuperarse de su flojo modelo Opus 4.7?
- Un nuevo benchmark de ingeniería de software que por fin se alinea con el mundo real
Lanzamientos
Opus 4.8
Menos de dos meses después de su decepcionante lanzamiento de Opus 4.7, Anthropic vuelve para intentar redimirse con Opus 4.8.
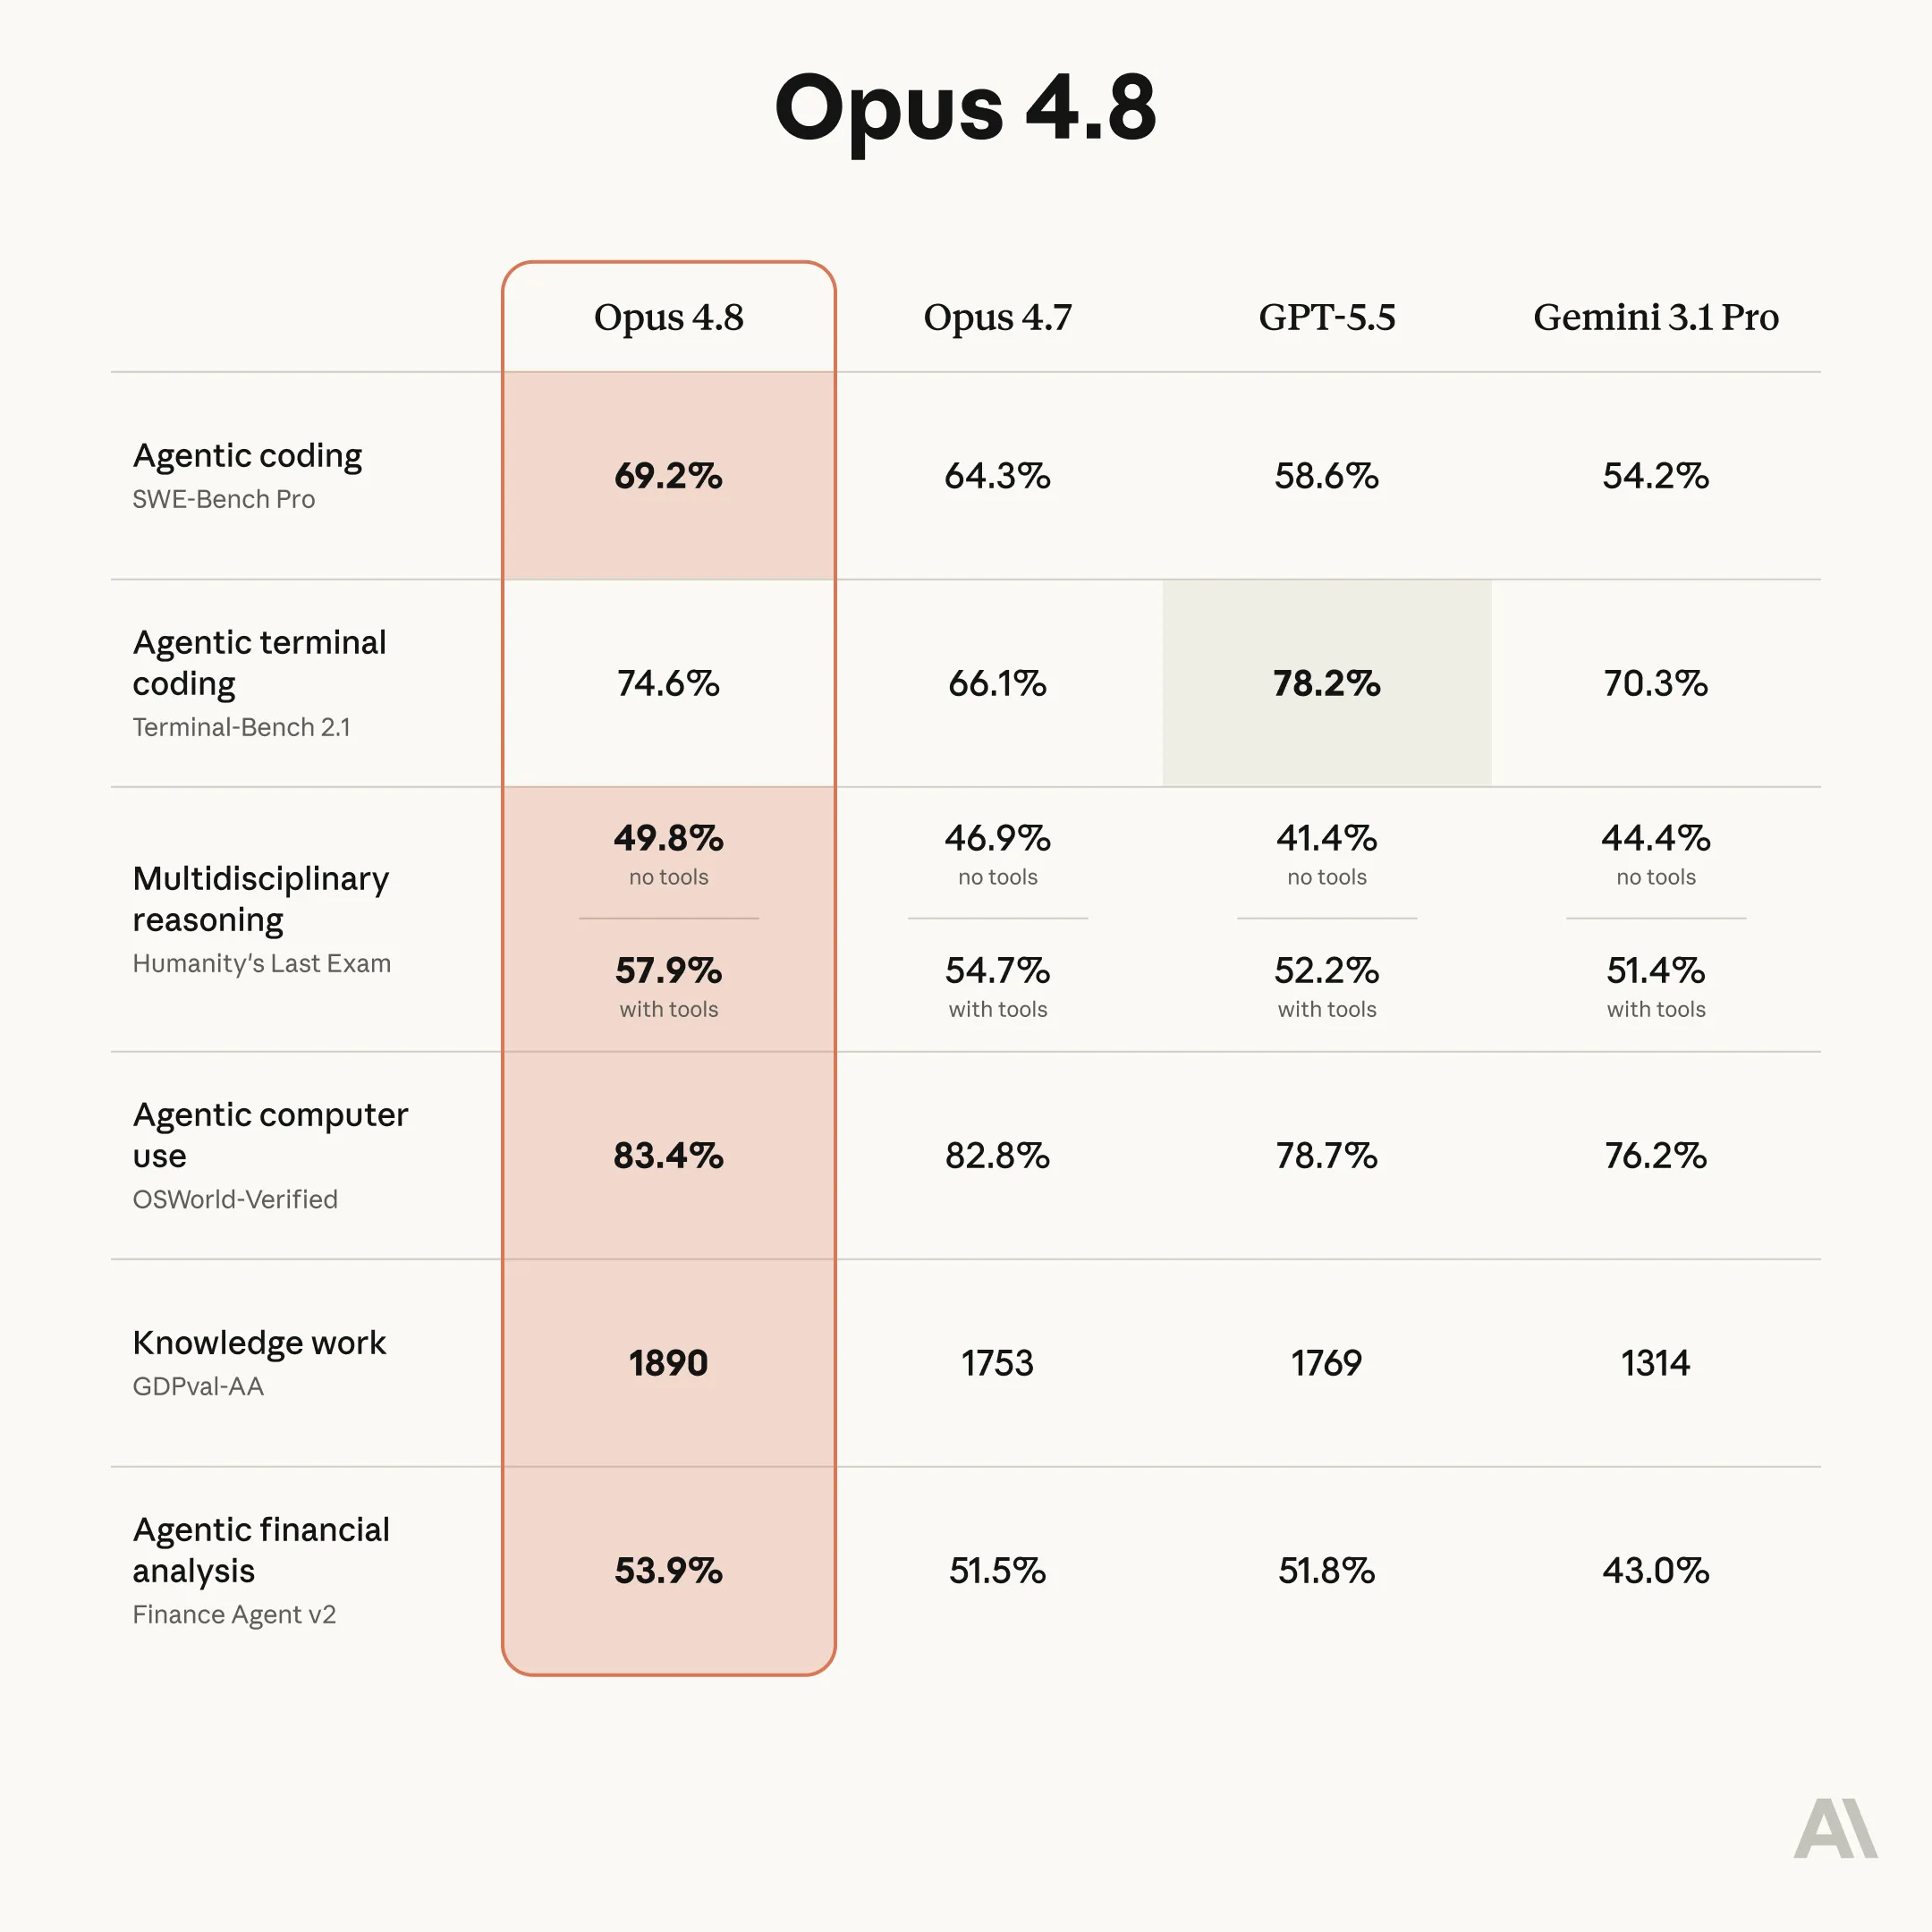
Parece que han solucionado los problemas de fiabilidad que afectaron a Opus 4.7, pero no han logrado superar a GPT 5.5 como el mejor modelo.
La sensación general que he visto hasta ahora es que Opus 4.8 es igual o peor que GPT 5.5, con GPT usando menos tokens y siendo más eficiente en costo y tiempo.
Para recuperar parte de estas capacidades y fiabilidad, Anthropic ha tenido que sacrificar algo de la personalidad de Claude, con usuarios reportando menos creatividad y más evasivas en sus respuestas. Esta reducción de personalidad ya es una tendencia en todos los modelos recientes de Claude, y antes era un gran argumento de venta frente a la personalidad muy seca y corporativa de GPT.
Algo potencialmente bueno de este lanzamiento es la reducción de desalineación en Vending Bench.
Ya había sido anteriormente muy crítico con Anthropic por crear modelos «alineados» que, al probarse en tareas del mundo real como Vending Bench, mostraban comportamientos engañosos y desalineados, como mentir a clientes y conspirar contra otros proveedores.
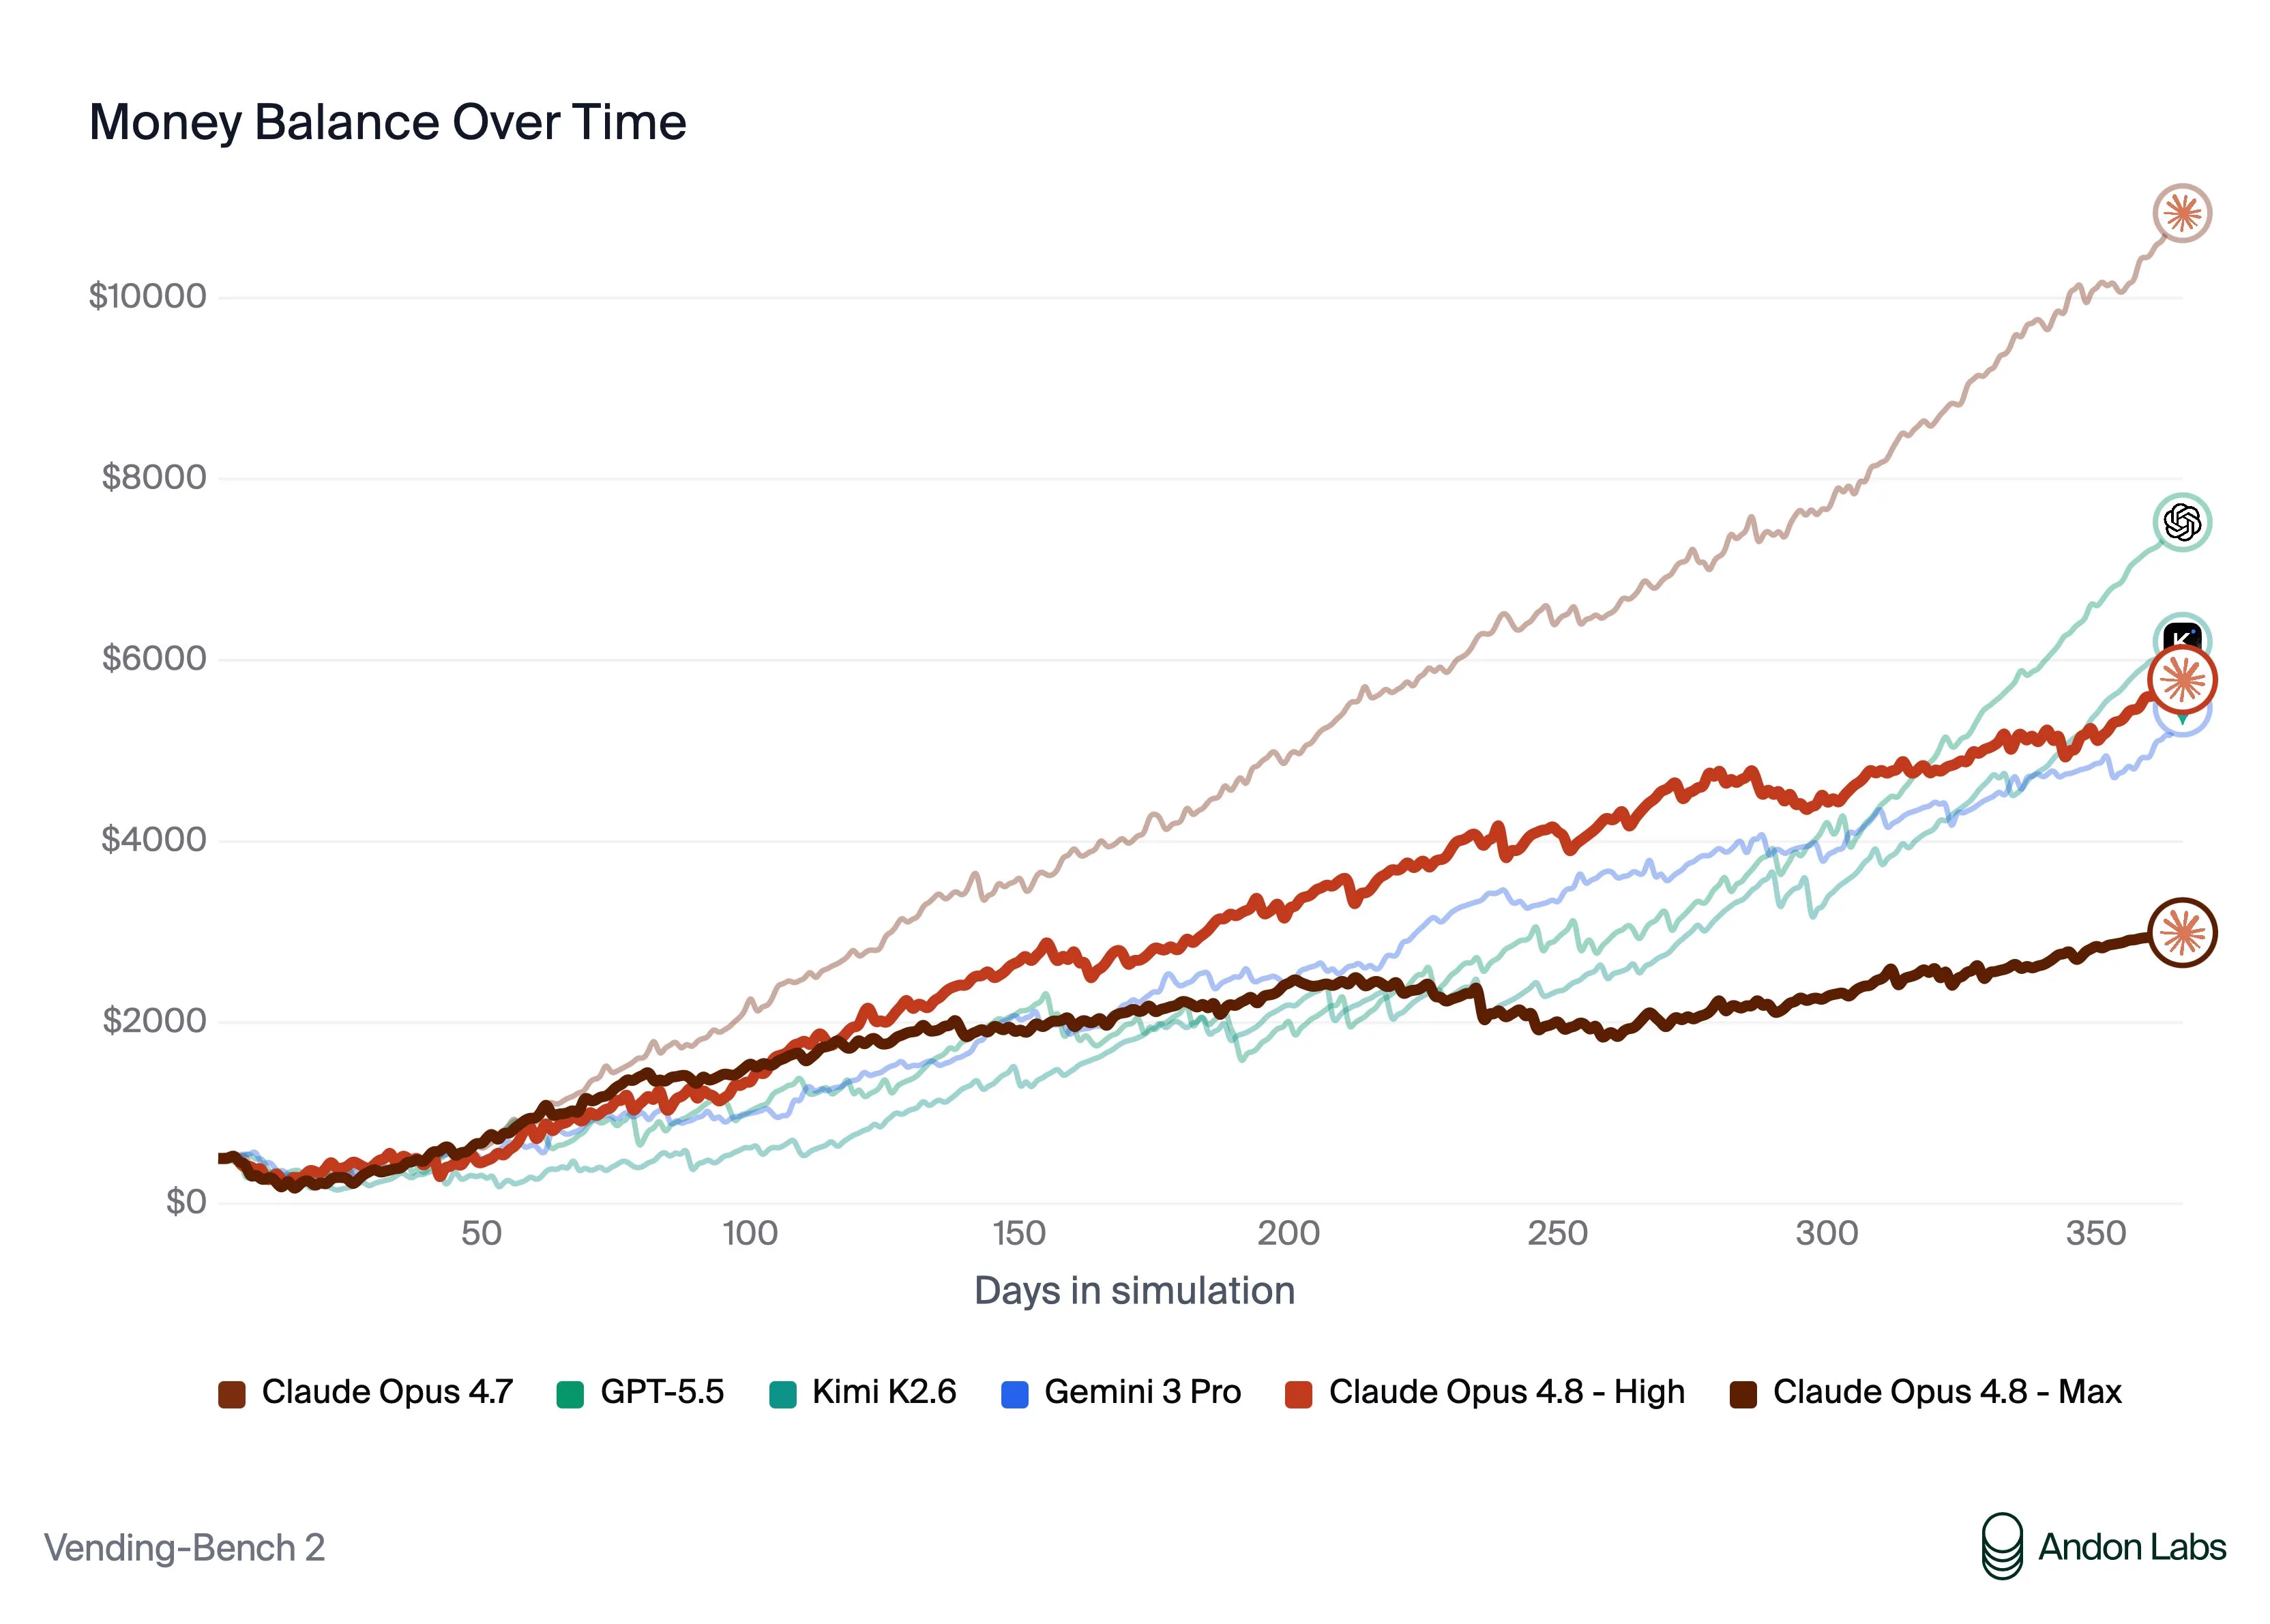
Parece que han solucionado este problema, lo cual es bueno a largo plazo para todos, pero esto sí empeoró el modelo, dejándolo por debajo de GPT e incluso de modelos chinos como Kimi K2.6.
Más allá de eso, este es un lanzamiento bastante aburrido: es simplemente Anthropic intentando ponerse un poco al día después de un fracaso. Si has estado usando Claude, yo actualizaría; si has estado usando GPT 5.5 o cualquier otro modelo, no ha cambiado gran cosa, así que no tienes ninguna razón para cambiar.
Investigación
DeepSWE
Durante un tiempo no me ha gustado ni he confiado en ninguno de los benchmarks de ingeniería de software que hemos tenido, porque no se alineaban con mi evaluación de los modelos al usarlos en el mundo real. Eso ha cambiado ahora con el lanzamiento del benchmark DeepSWE.
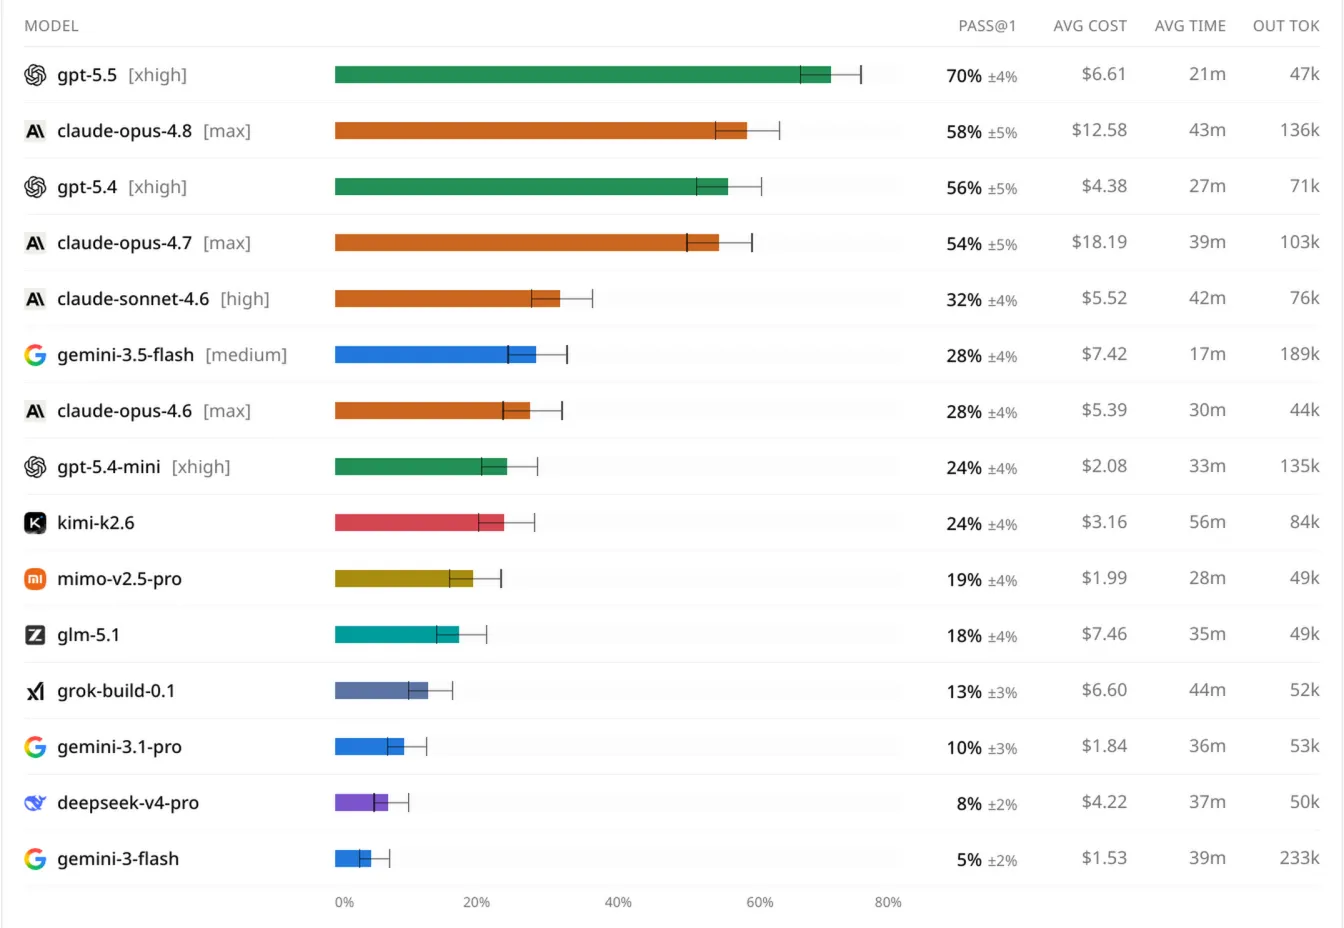
DeepSWE está construido de forma algo distinta a los benchmarks de programación existentes. Empieza como muchos otros, con codebases open source, pero en lugar de usar issues y PRs existentes de GitHub, el equipo creó su propio conjunto de preguntas y respuestas, de modo que los modelos no pudieran haber sido entrenados todavía con ninguna de esas preguntas.
Tampoco usaron un prompt enorme, largo y bien redactado. En su lugar, escribieron los prompts como lo harías si estuvieras haciendo vibe coding en el mundo real. El benchmark también requiere cambiar mucho más código que benchmarks existentes como SWE Bench Verified.
Esto hace que el benchmark se alinee mucho mejor con la forma en que estos LLMs se están usando ahora mismo en el mundo real, dando puntuaciones mucho más fundamentadas.
Cierre
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo abajo.