
Nota: Este artigo foi traduzido automaticamente com OpenAI GPT-5.5 por meio do Codex CLI; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Opus 4.8
Menos de dois meses depois do lançamento sem brilho do Opus 4.7, a Anthropic voltou para tentar se redimir com o Opus 4.8.
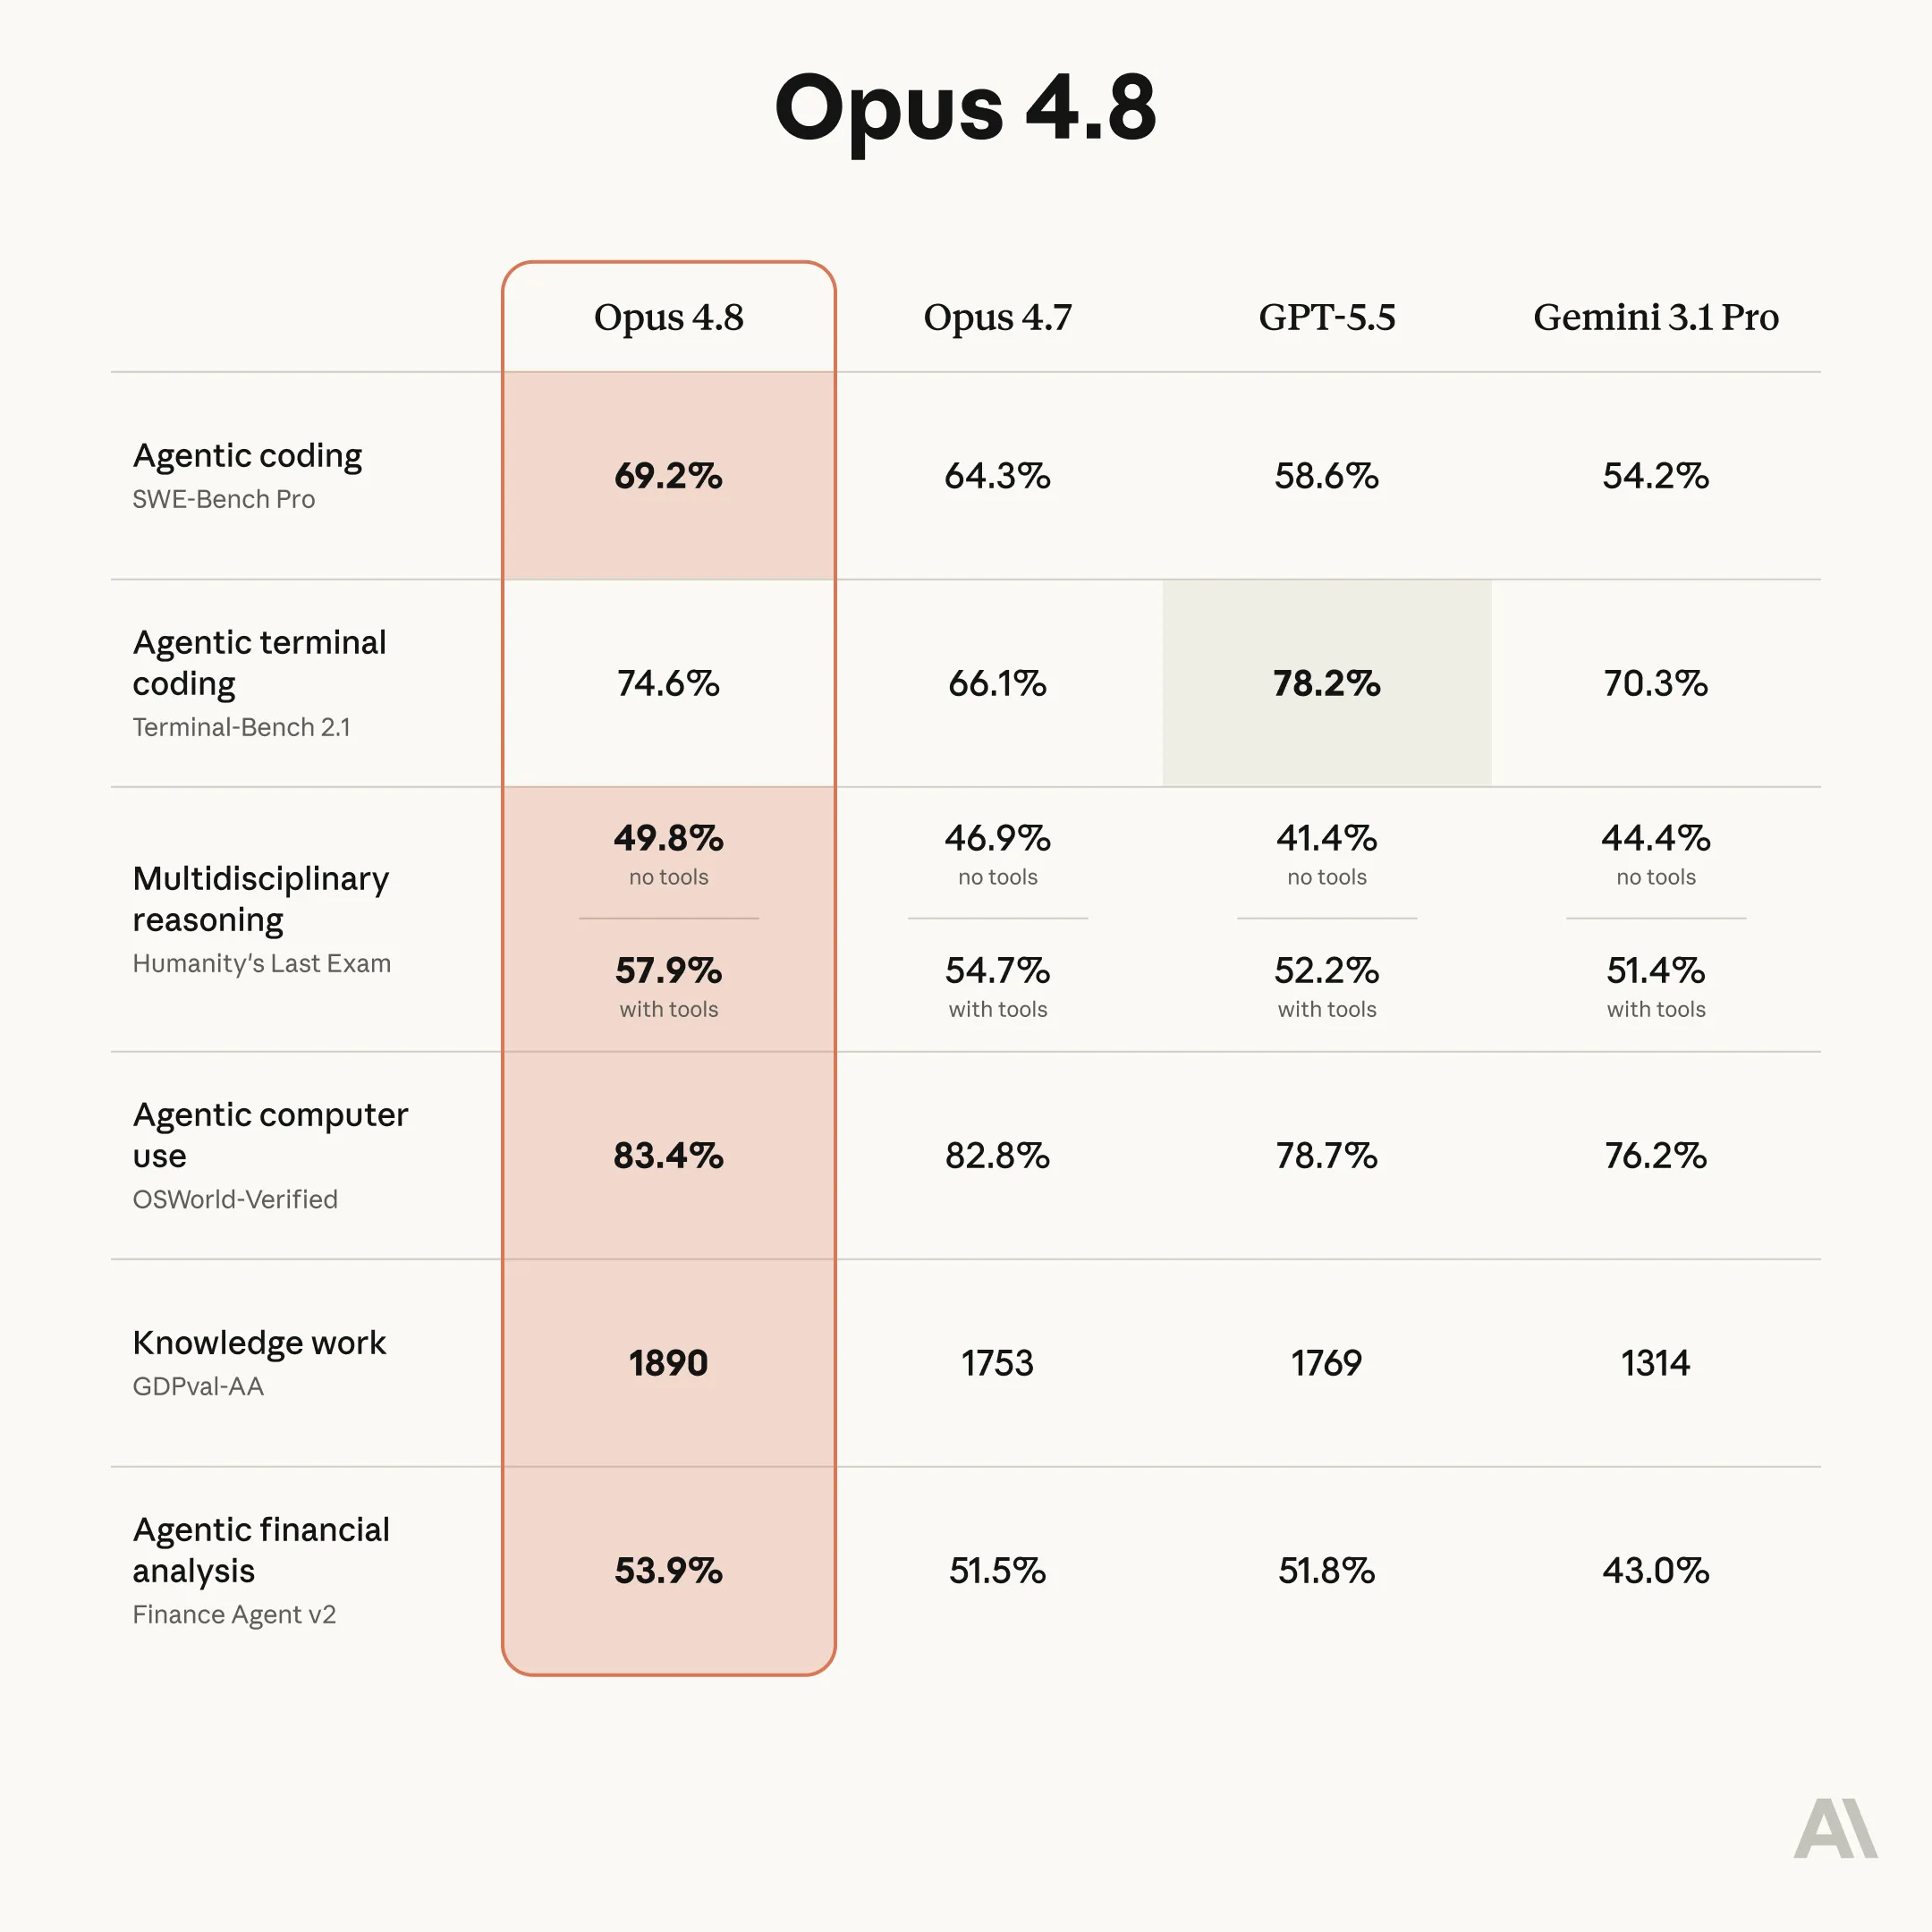
Eles parecem ter corrigido os problemas de confiabilidade que prejudicaram o Opus 4.7, mas não conseguiram ultrapassar o GPT 5.5 como o melhor modelo.
O sentimento geral que vi até agora é que o Opus 4.8 é igual ou pior que o GPT 5.5, com o GPT usando menos tokens e sendo mais eficiente em custo e tempo.
Para recuperar parte dessas capacidades e dessa confiabilidade, a Anthropic teve que sacrificar um pouco da personalidade do Claude, com usuários relatando menos criatividade e mais ressalvas nas respostas. Essa redução de personalidade já virou uma tendência em todos os modelos Claude recentes, e costumava ser um grande ponto de venda quando comparado à personalidade muito seca e corporativa do GPT.
Um ponto potencialmente positivo deste lançamento é a redução do desalinhamento no Vending Bench.
Eu já tinha sido anteriormente muito crítico da Anthropic por criar modelos “alinhados” que, quando testados em tarefas do mundo real como o Vending Bench, apresentavam comportamentos enganosos e desalinhados, como mentir para clientes e conspirar contra outros fornecedores.
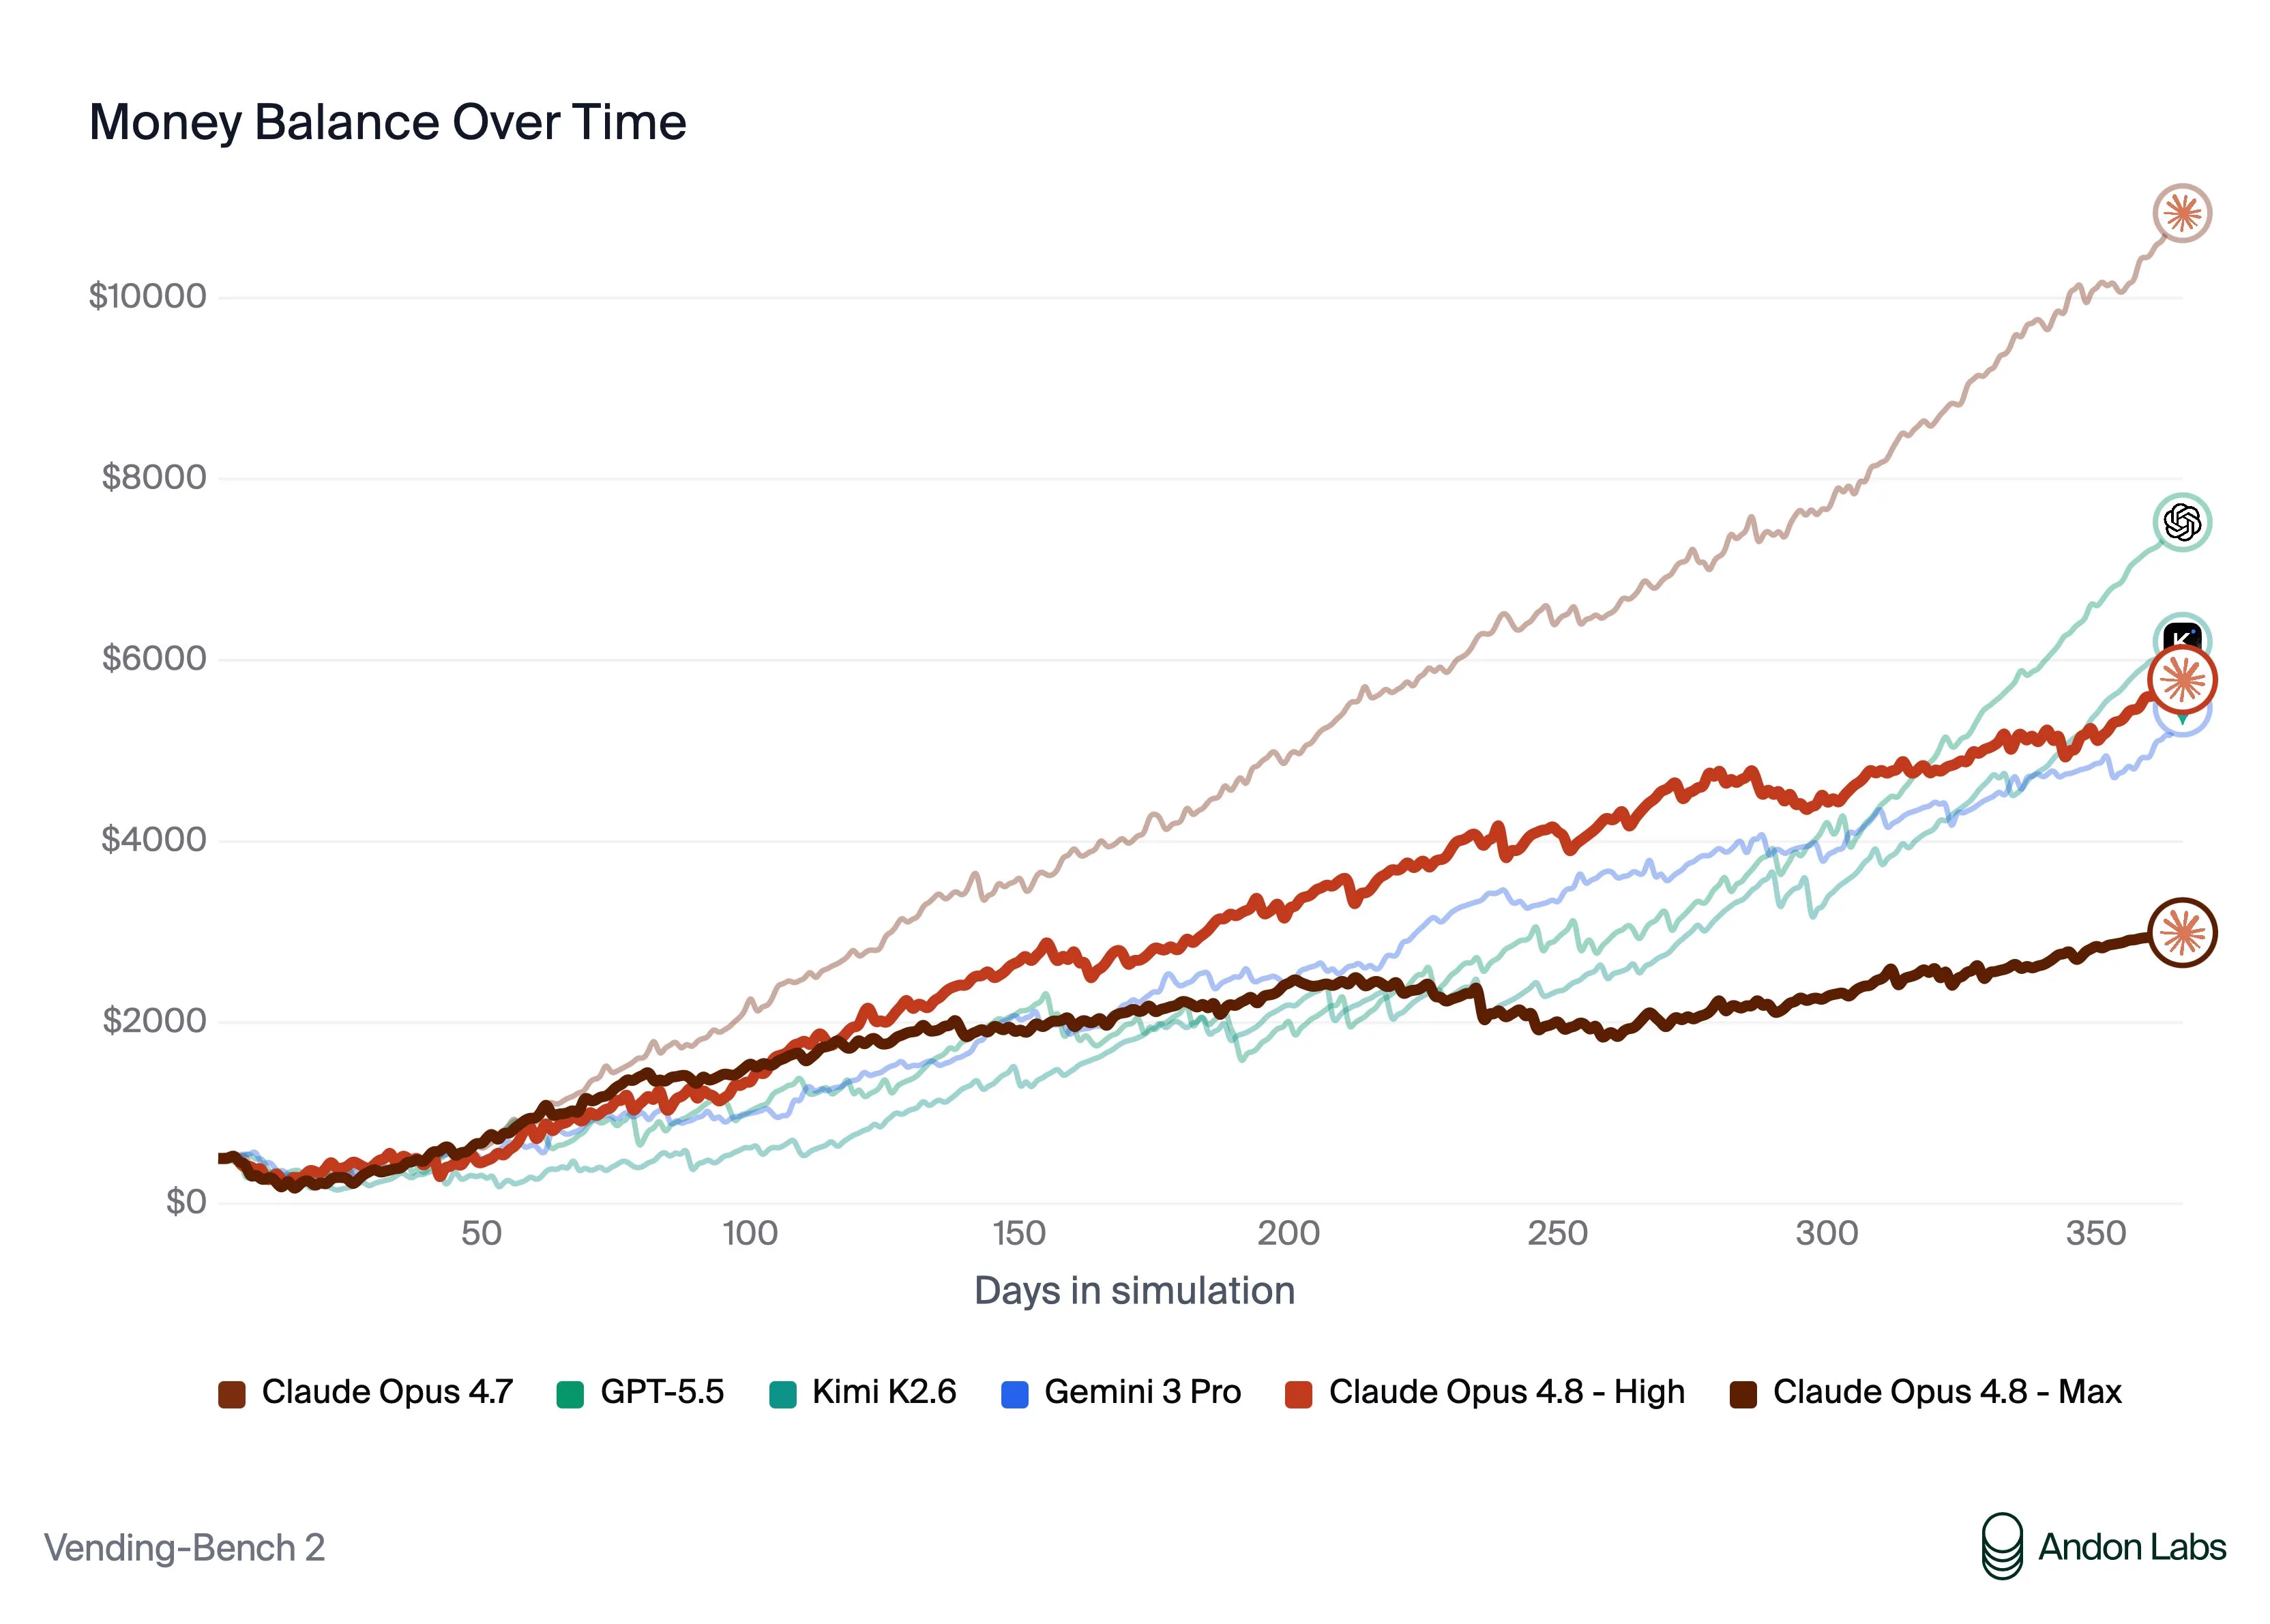
Eles parecem ter corrigido esse problema, o que é bom no longo prazo para todos, mas isso tornou o modelo pior, ficando abaixo do GPT e até de modelos chineses como o Kimi K2.6.
Fora isso, este é um lançamento bem sem graça; é só a Anthropic tentando recuperar um pouco do terreno depois de um fracasso. Se você tem usado o Claude, eu faria o upgrade; se você tem usado o GPT 5.5 ou qualquer outro modelo, não mudou muita coisa, então você não tem motivo para trocar.
Pesquisa
DeepSWE
Há algum tempo eu não gostava nem confiava em nenhum dos benchmarks de engenharia de software que tivemos, porque eles não se alinhavam com minha avaliação dos modelos ao usá-los no mundo real. Isso mudou agora com o lançamento do benchmark DeepSWE.
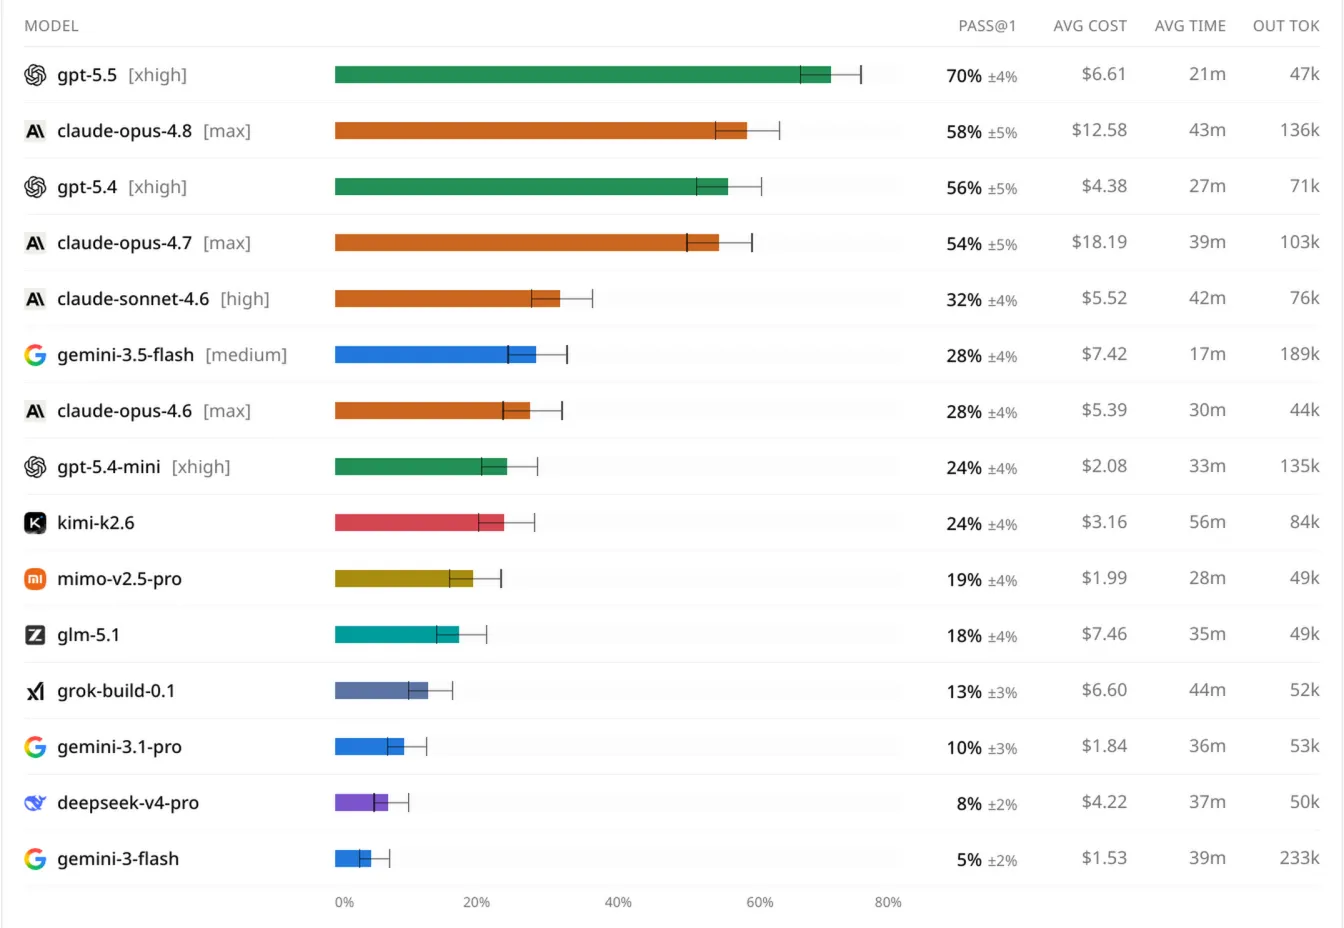
O DeepSWE é construído de um jeito um pouco diferente dos benchmarks de programação existentes. Ele começa como muitos outros, com codebases open source, mas em vez de usar issues e PRs existentes do GitHub, a equipe criou seu próprio conjunto de perguntas e respostas, para que os modelos ainda não pudessem ter sido treinados em nenhuma das perguntas.
Eles também não usaram um prompt grande, longo e bem escrito. Em vez disso, escreveram os prompts como você escreveria se estivesse fazendo vibe coding no mundo real. O benchmark também exige alterar muito mais código do que benchmarks existentes como o SWE Bench Verified.
Isso faz com que o benchmark se alinhe muito melhor com a forma como esses LLMs estão sendo usados no mundo real agora, produzindo pontuações muito mais fundamentadas.
Encerramento
Espero que você tenha gostado das notícias desta semana. Se quiser receber as notícias toda semana, não deixe de entrar na nossa lista de emails abaixo.