
注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
Opus 4.8
距离乏善可陈的 Opus 4.7 发布还不到两个月,Anthropic 就带着 Opus 4.8 回来了,试图挽回颜面。
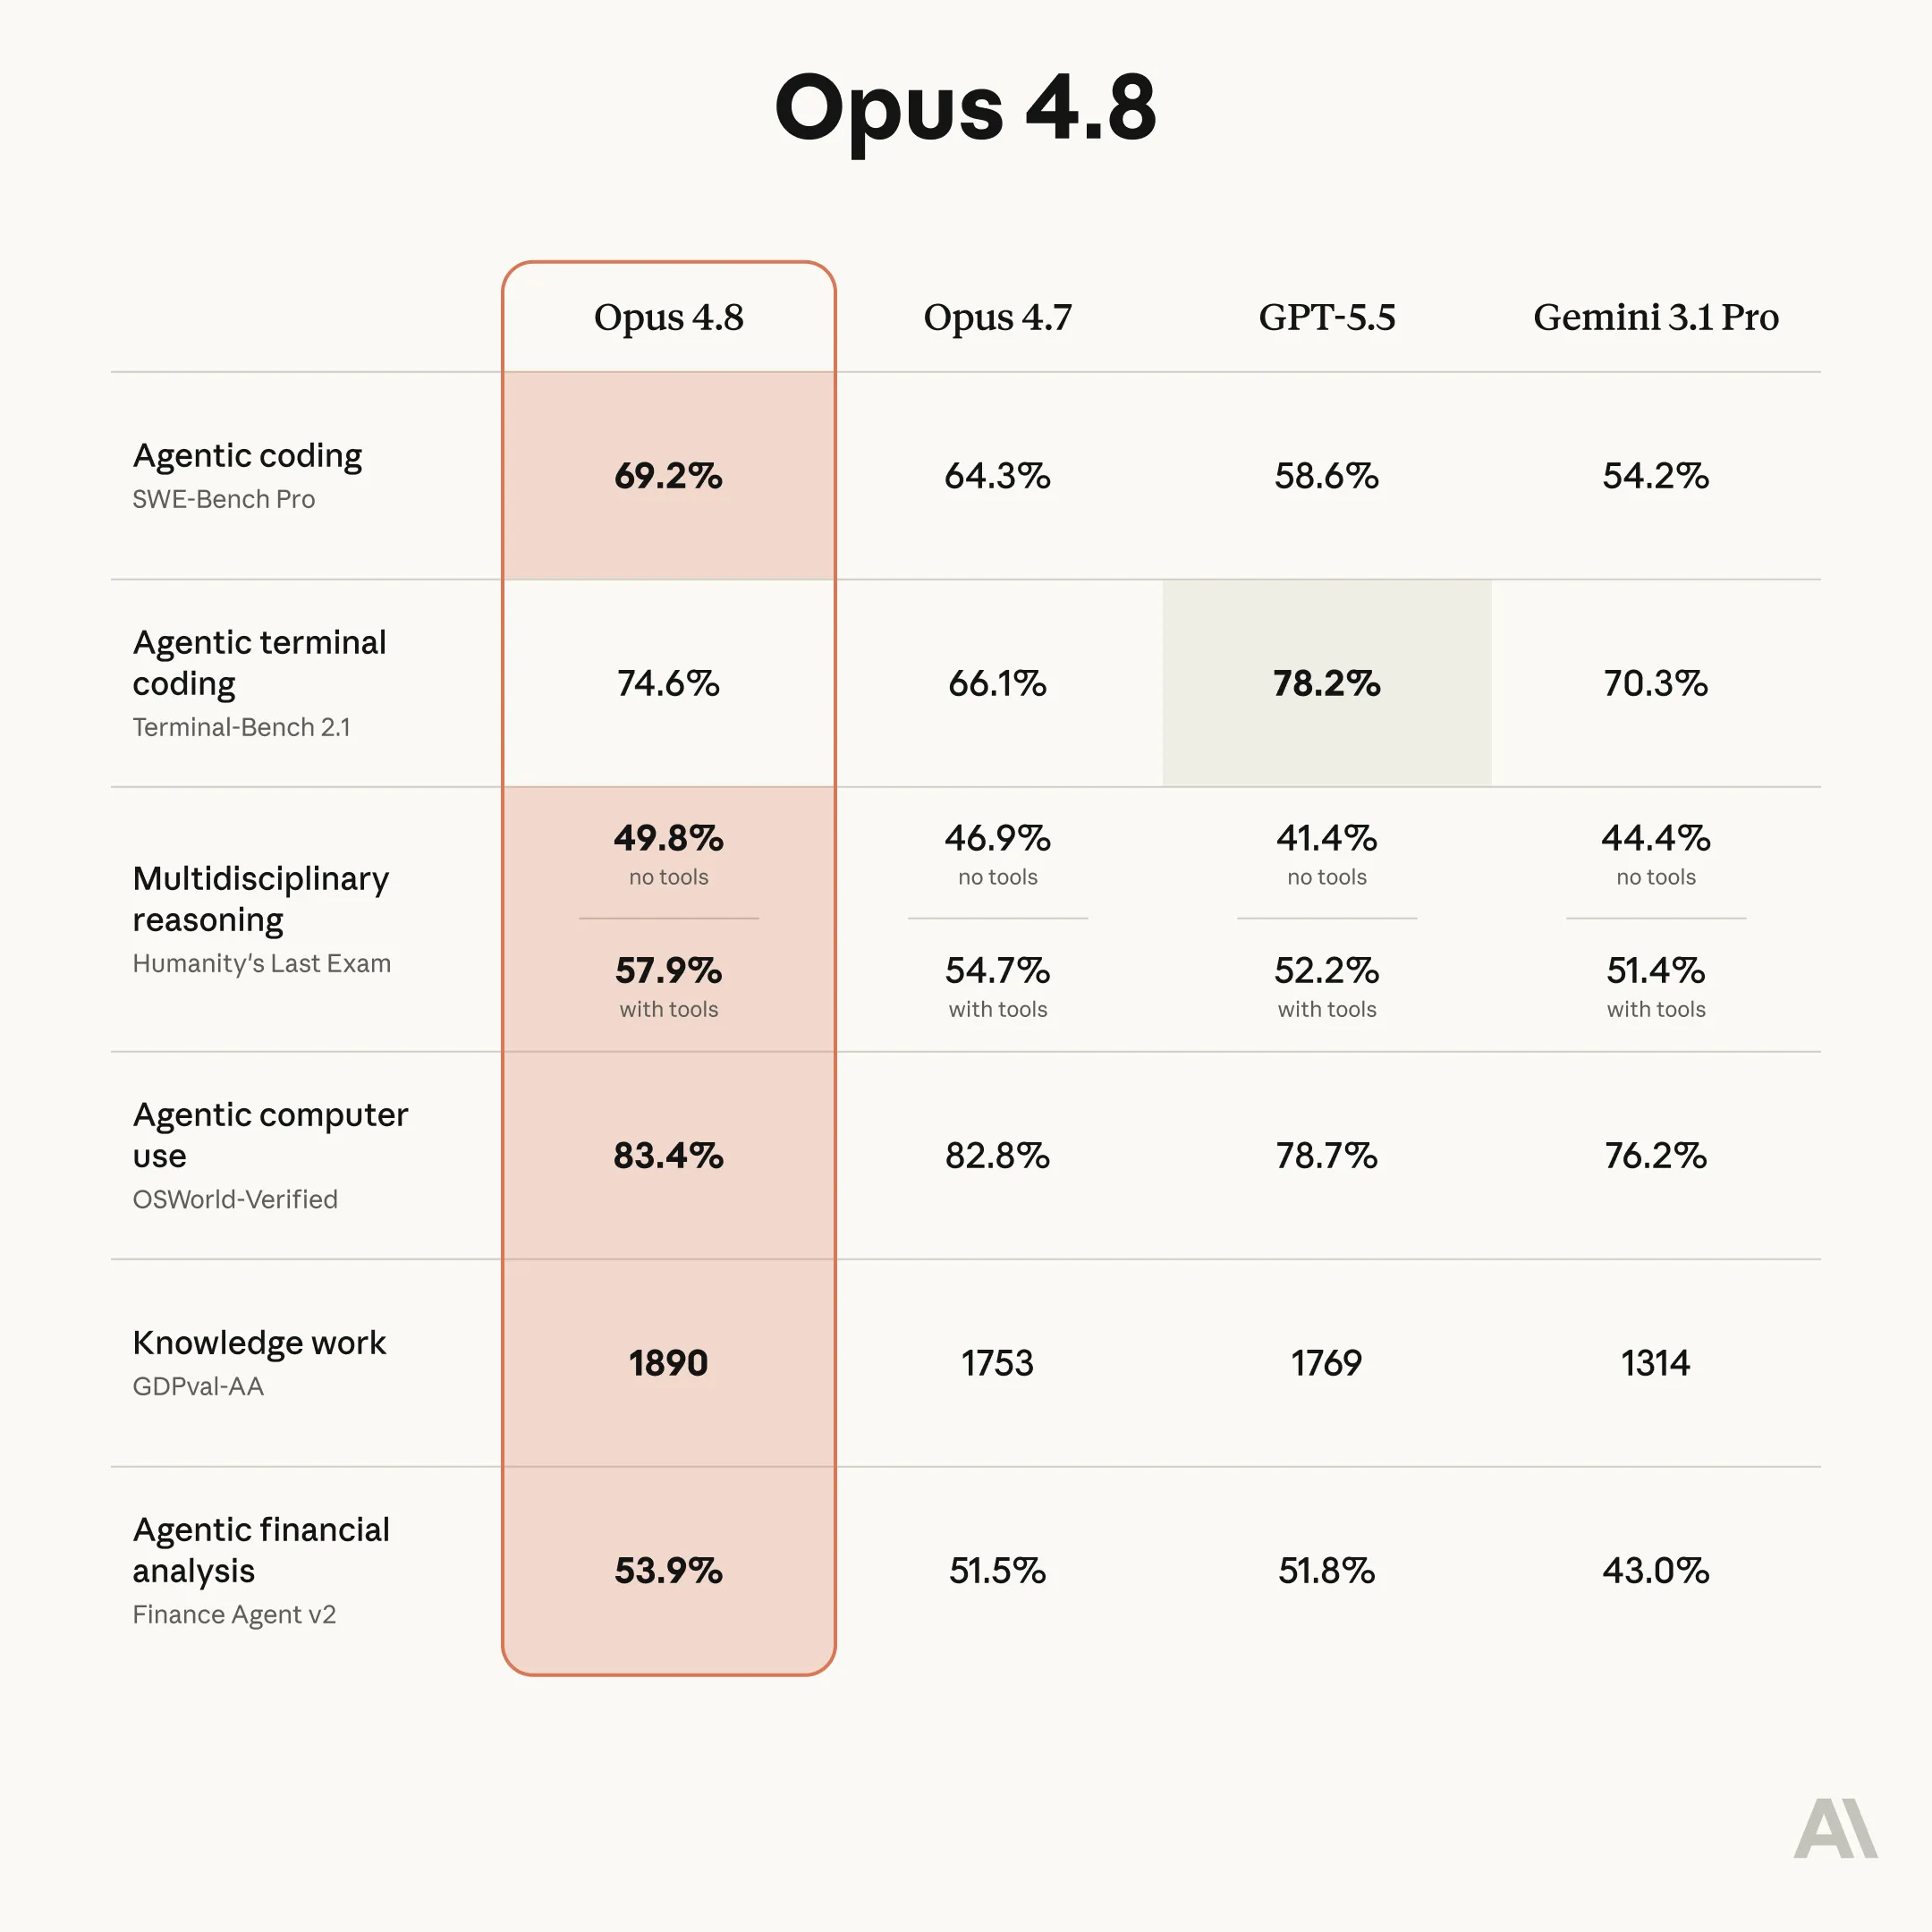
他们似乎修复了困扰 Opus 4.7 的可靠性问题,但仍未能超越 GPT 5.5,成为最好的模型。
到目前为止,我看到的普遍看法是,Opus 4.8 的表现与 GPT 5.5 相当,或者更差,而 GPT 消耗的 token 更少,成本和时间效率也更高。
为了恢复部分能力和可靠性,Anthropic 不得不牺牲 Claude 的一些个性。用户反馈,它的回答创意更少,措辞也更含糊保守。 最近几代 Claude 模型都在逐渐失去个性,而与 GPT 那种非常枯燥、充满企业腔的风格相比,个性曾经是 Claude 的一大卖点。
这次发布中一个可能的好消息是,模型在 Vending Bench 中的不对齐行为有所减少。
我之前曾严厉批评过 Anthropic:他们做出的所谓“对齐”模型,在 Vending Bench 这样的真实场景任务中接受测试时,却会表现出欺骗和不对齐行为,比如对顾客撒谎,以及密谋对付其他供应商。
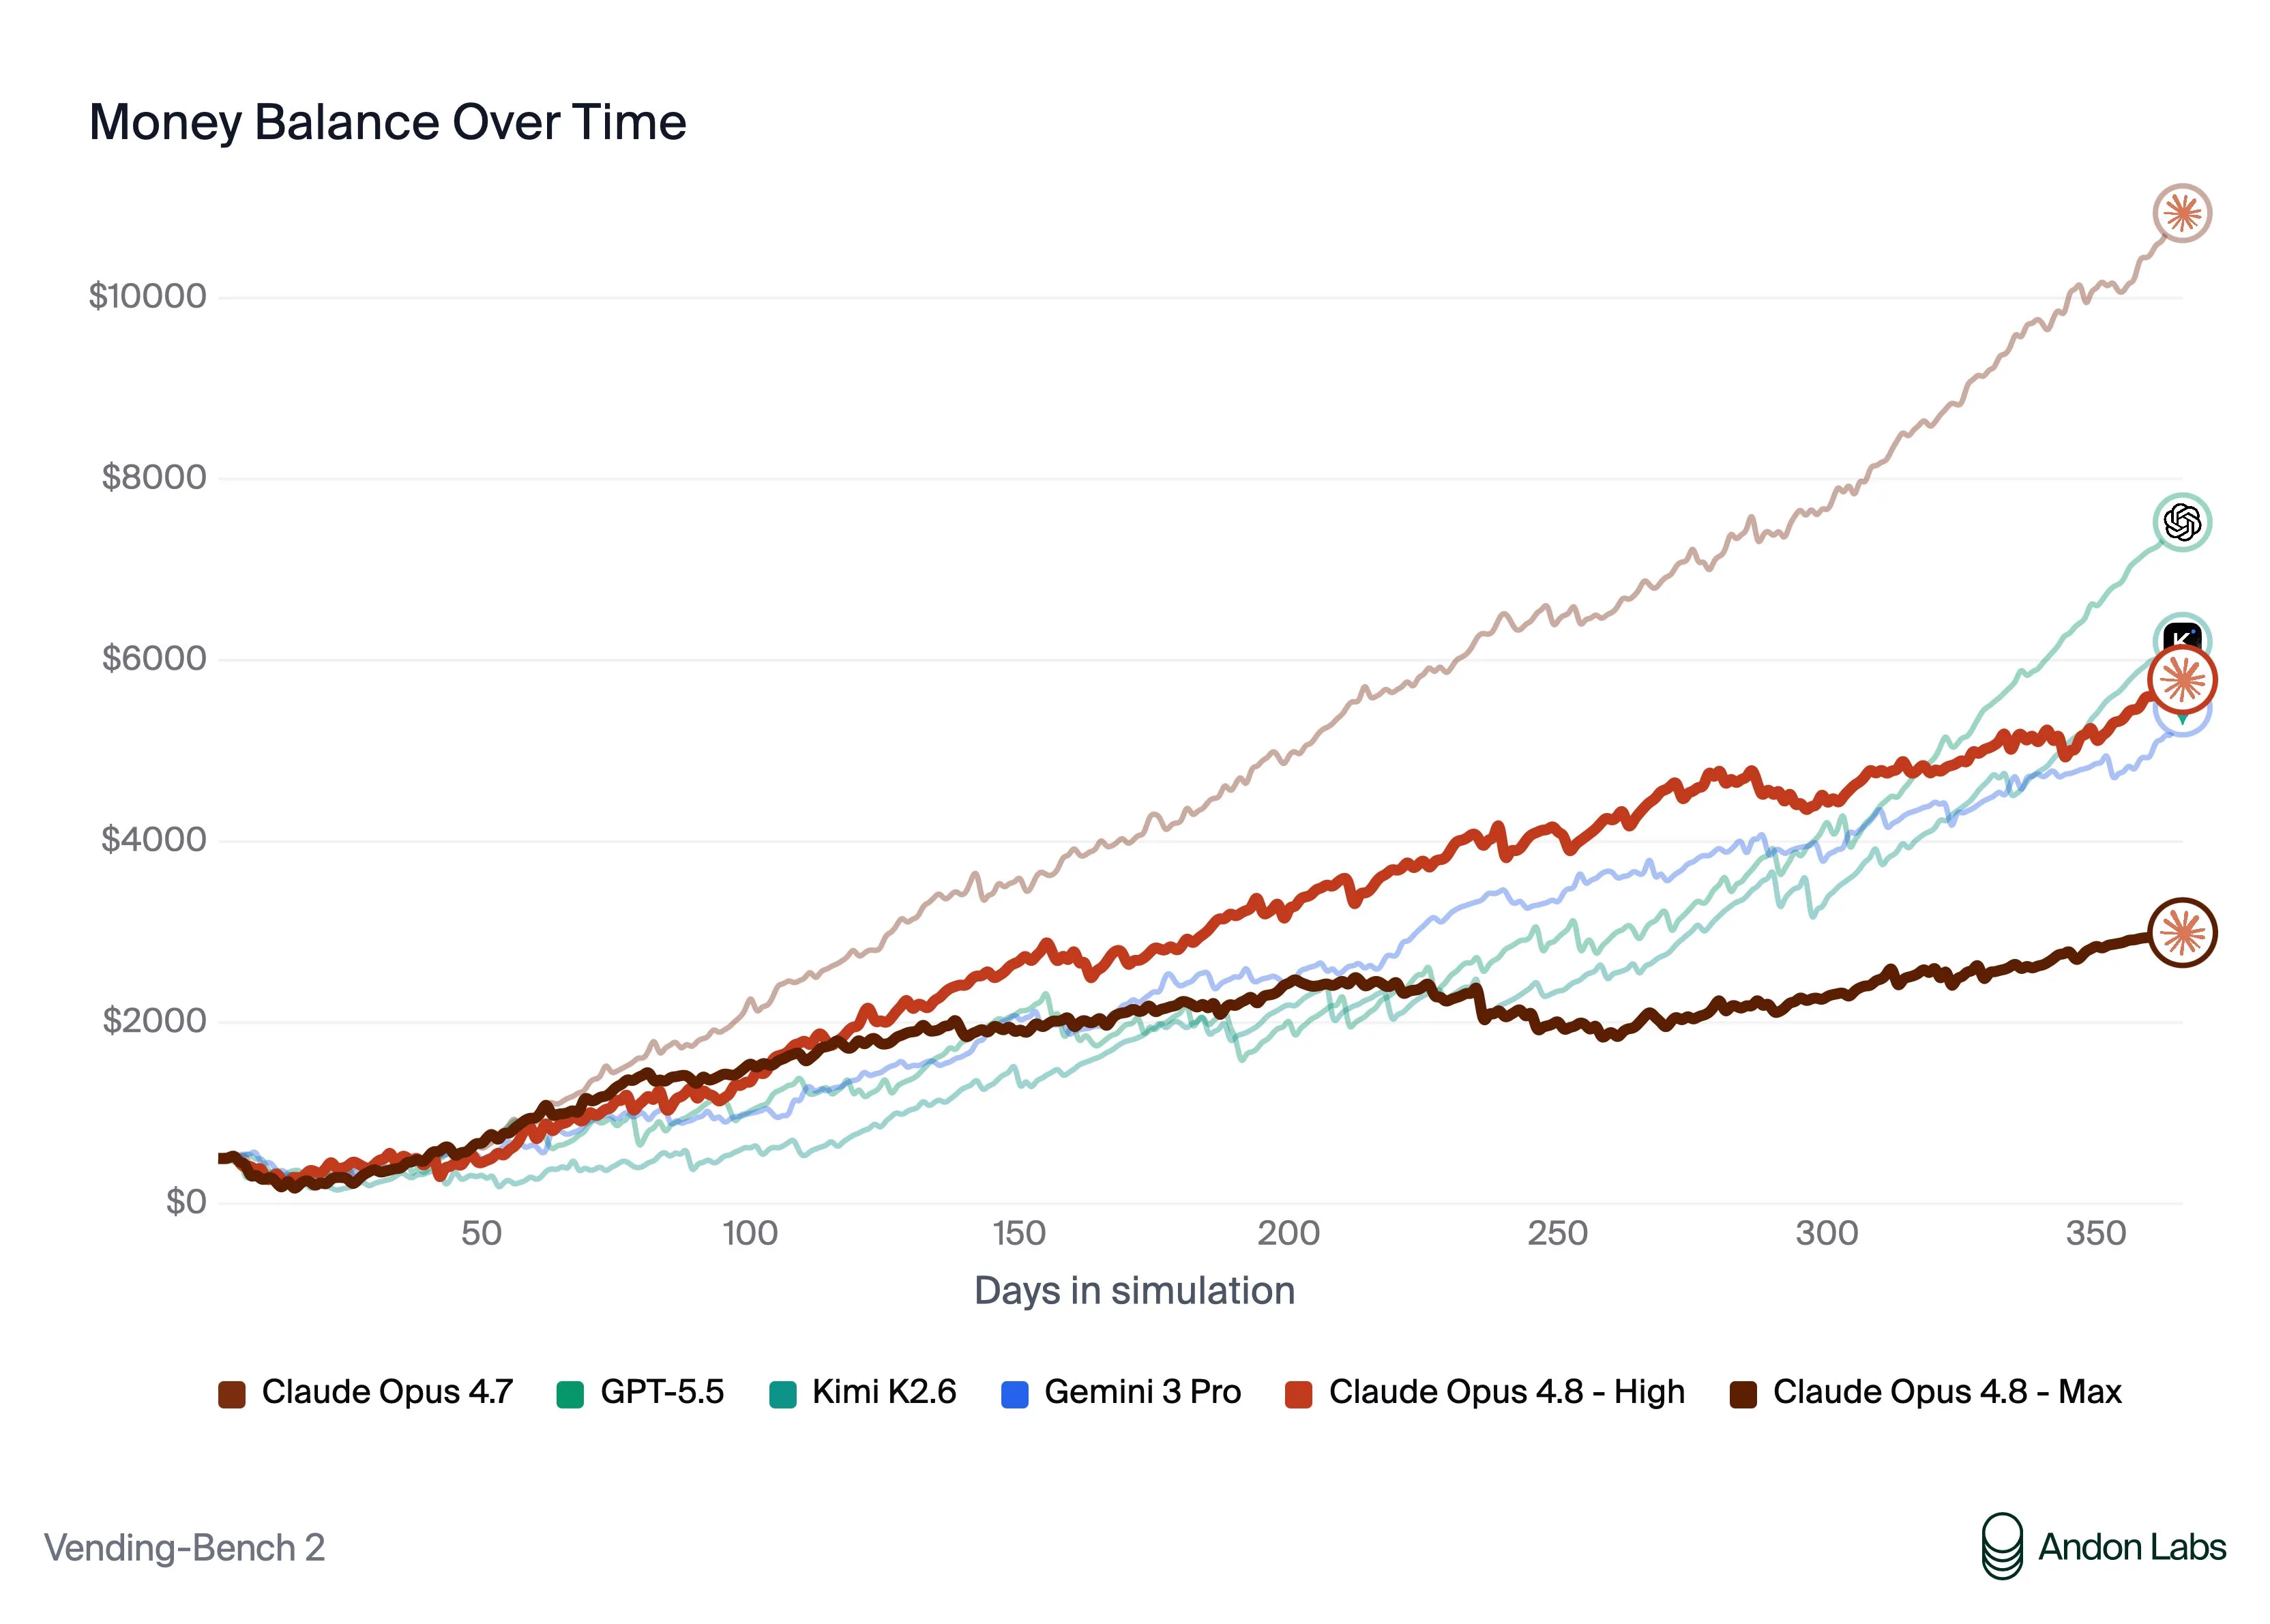
他们似乎已经修复了这个问题,从长远来看,这对所有人都是好事。不过,这也让模型的表现变差了,得分跌到了 GPT 之下,甚至不如 Kimi K2.6 这样的中国模型。
除此之外,这次发布相当无聊,只是 Anthropic 在一次失败后努力追赶罢了。 如果你一直在用 Claude,我建议升级;如果你一直在用 GPT 5.5 或其他模型,情况并没有太大变化,没有什么理由切换。
研究
DeepSWE
有一段时间,我对现有的软件工程基准测试都不太喜欢,也不太信任,因为它们的结果与我在实际使用中对模型的评价并不一致。 随着 DeepSWE 基准的发布,这种情况终于改变了。
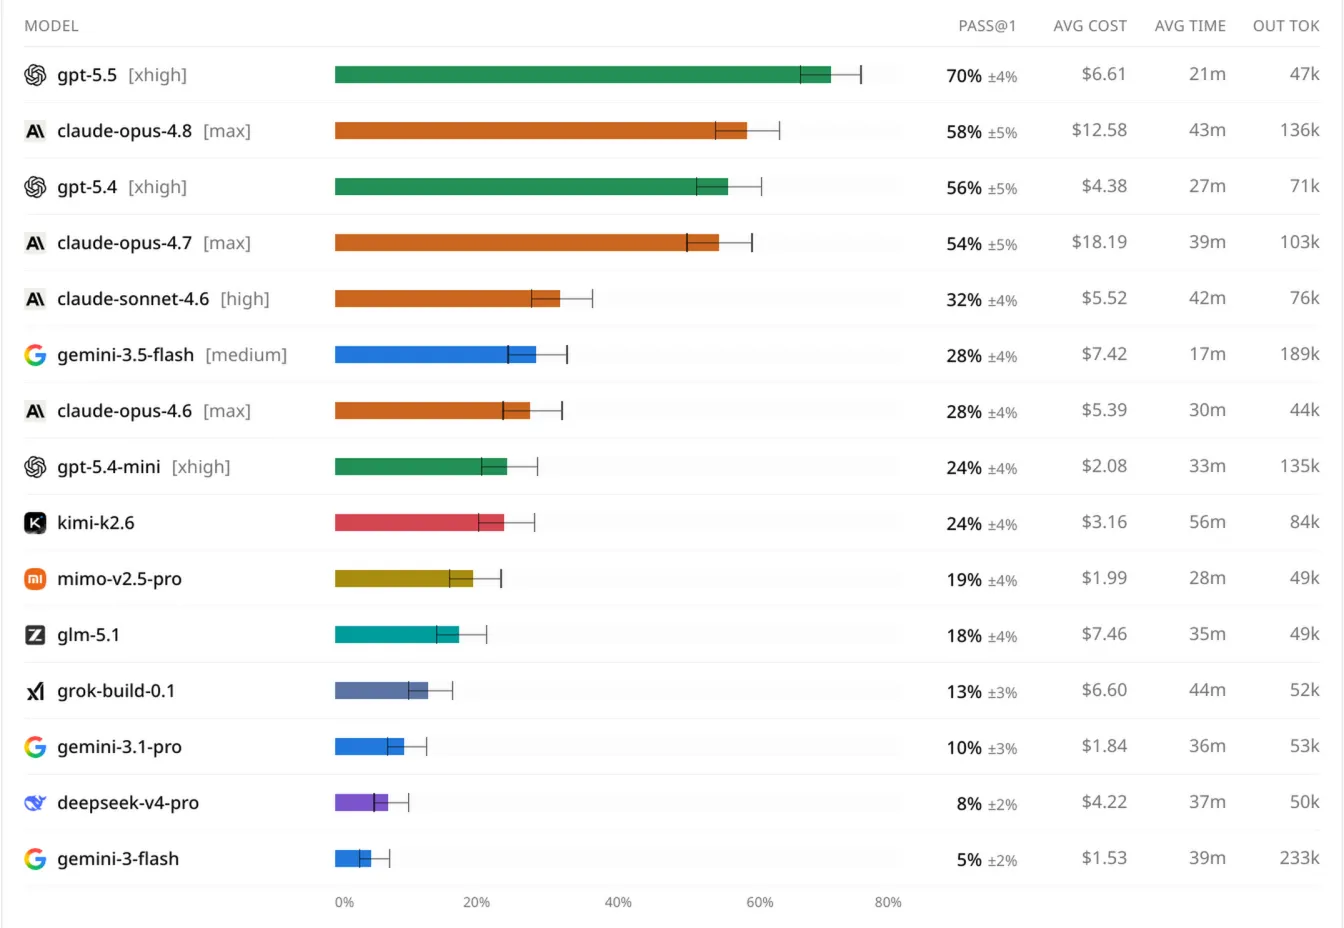
DeepSWE 的构建方式与现有编程基准略有不同。 和许多其他基准一样,它以开源代码库为起点。但团队没有使用现成的 GitHub issue 和 PR,而是自行编写了一套问题和答案,这样模型就不可能在训练时见过这些问题。
他们也没有使用那种篇幅很长、措辞精心打磨的大段提示词。 相反,他们写的提示词就像你在实际进行氛围编程(vibe coding)时会写的那样。 与 SWE Bench Verified 等现有基准相比,这个基准还要求修改多得多的代码。
这让该基准更贴近当下人们在真实场景中使用这些大语言模型的方式,得分也更有现实参考价值。
结语
希望你喜欢本周的新闻。如果你想每周收到新闻,记得在下方订阅我们的邮件列表。