
Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
Opus 4.7
Solo una semana después de anunciar la existencia de Mythos, Anthropic ha lanzado Opus 4.7.
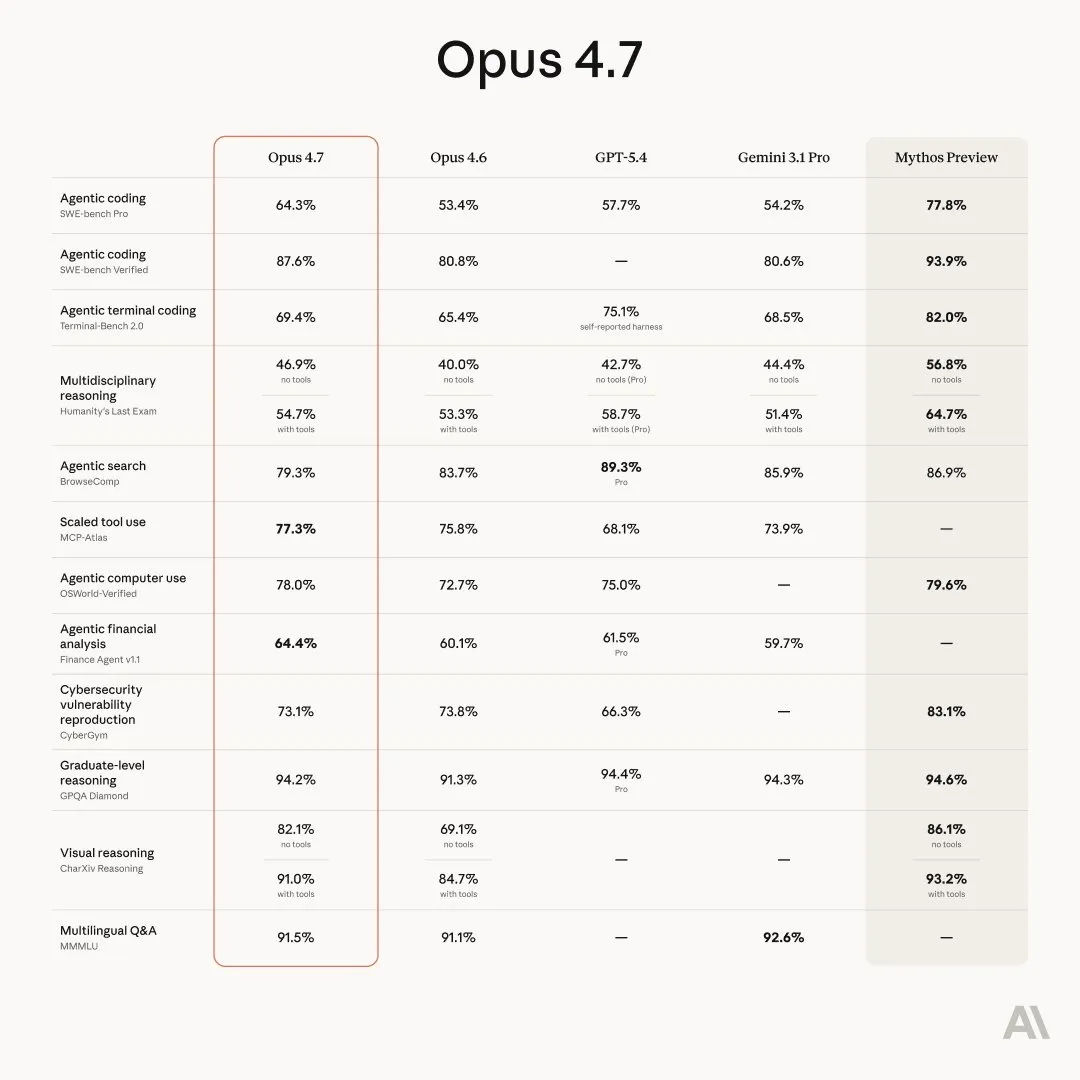
El consenso sobre Opus 4.7 no es tan claro como en lanzamientos anteriores. Normalmente, el lanzamiento de un nuevo modelo es claramente mejor que sus predecesores; esto aplica para prácticamente todos los laboratorios (excepto Mistral). Pero con Opus 4.7 he visto opiniones encontradas hasta ahora.
Parece carecer del nivel de refinamiento de los modelos Claude anteriores. Su personalidad y esencia dejan que desear, y sus capacidades dentro de Claude Code, aunque siguen siendo buenas, son un poco inestables, con varias personas (incluido yo mismo) experimentando un número mayor de lo normal de fallos en las llamadas a herramientas.
Para programación, el modelo parece más inteligente, pero también menos fiable. Según Chubby en Twitter:
Opus 4.7 se siente como un empleado descontento cuyos resultados no puedes juzgar y tienes que revisar después. La confianza que tenías con 4.6 ha desaparecido. Es como contratar a un nuevo empleado que tenía excelentes calificaciones en su solicitud, pero que en la práctica es totalmente descuidado y descontento, y no sigue las instrucciones.
Esto parece deberse al nuevo modo de pensamiento adaptativo que utiliza el modelo. Esto permite al modelo pensar más o menos ante una consulta determinada en función de lo difícil que considera que es. La serie de modelos GPT ha tenido esto durante un tiempo y ha funcionado muy bien, pero Anthropic parece haber fallado con su implementación. Opus 4.7 solo considera las tareas de programación o STEM como suficientemente difíciles para pensar más, lo que lleva a razonar menos y dar peores respuestas en casi cualquier otro dominio.
Para OpenAI, su pensamiento adaptativo buscaba una mejor experiencia de usuario, ya que los usuarios prefieren respuestas más rápidas. Anthropic, por otro lado, al estar mucho más limitado en cómputo que OpenAI en este momento, utiliza el pensamiento adaptativo para ahorrar cómputo. Según un usuario de HackerNews:
[El pensamiento adaptativo] es un problema resuelto para las empresas. Resuelve sus problemas. No los tuyos ;)
Para colmo, Anthropic también actualizó el tokenizador del modelo, lo que hace que use más tokens de lo normal, haciendo que sea entre un 20-50% más caro que Opus 4.6 para el mismo número de caracteres.
Para la mayoría de las personas, Opus 4.7 es, en el mejor de los casos, una actualización lateral, sacrificando inteligencia bruta y capacidad por fiabilidad. Para la mayoría de los demás casos de uso parece ser una ligera degradación, por lo que no recomendaría usarlo en este momento a menos que rinda notablemente mejor para tus propios casos de uso.
Qwen 3.6 35B
Menos de 2 meses después de los lanzamientos de Qwen 3.5, ya tenemos nuestro primer modelo de código abierto Qwen 3.6, una actualización del modelo 35B-A3B de mezcla de expertos.
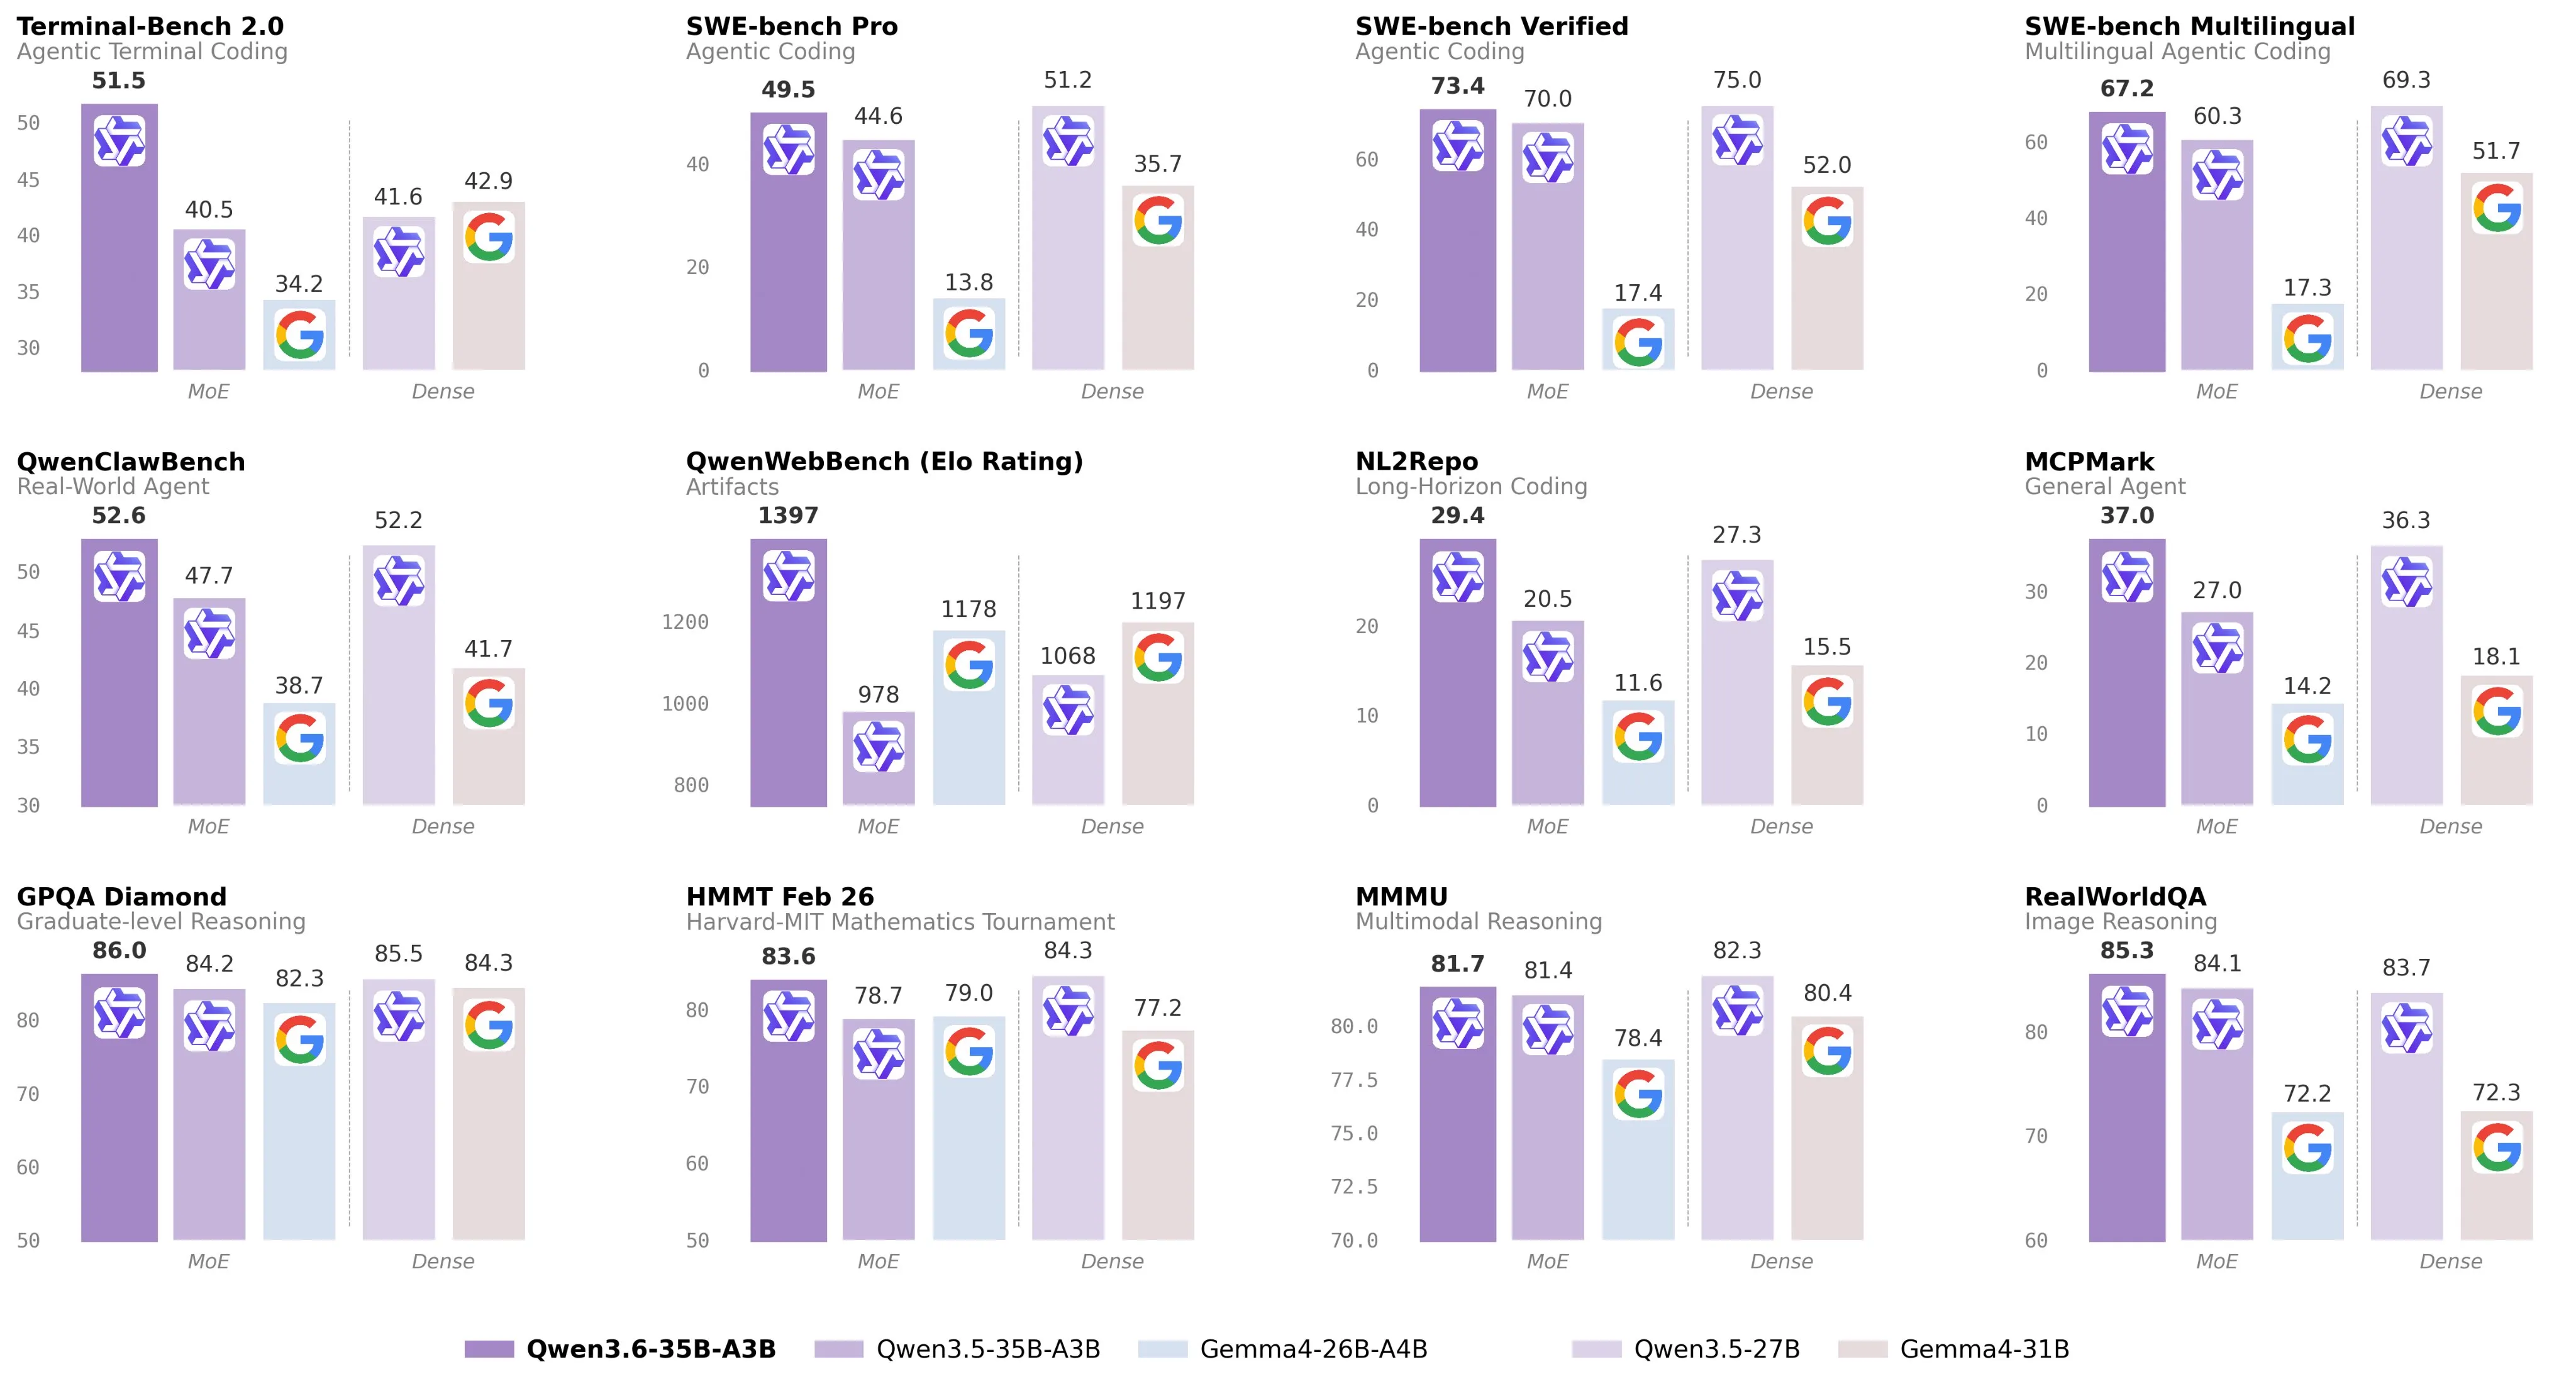
Los modelos densos Qwen 3.5 y Gemma 4 (los modelos de 27B y 31B en el gráfico anterior) fueron considerados los primeros modelos lo suficientemente buenos para usarse en entornos de programación e interfaces de agentes como OpenClaw. Este modelo Qwen 3.6 es capaz de superar holgadamente a ambos modelos densos, siendo mucho más eficiente, lo que permite ejecutarlo a velocidades decentes (>20 tokens por segundo) en prácticamente cualquier hardware con al menos 24 GB de memoria.
En términos de sus puntuaciones en benchmarks, se sitúa alrededor del nivel de Sonnet 4.5, lo cual es una locura dado que es al menos un orden de magnitud más pequeño que Sonnet, que fue lanzado hace apenas 5 meses. Si esta tendencia continúa, significa que tendremos un modelo al nivel de Opus 4.6/GPT 5.4 que podremos ejecutar en casa con bastante facilidad en 6 meses.
Personalmente he estado usando este modelo con Hermes Agent (una alternativa a OpenClaw que es un poco más amigable para los modelos de código abierto) y ha funcionado bastante bien sin problemas mayores. He visto una opinión similar entre quienes participan en LocalLLaMA y lo han usado como agente personal y también como asistente de programación bastante competente.
Como dije con los modelos Qwen3.5 y Gemma 4, ahora es el mejor momento para empezar a usar LLMs locales, porque están comenzando a ser lo suficientemente buenos como para reemplazar a OpenAI y Anthropic en tareas de dificultad fácil y media.
Cierre
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.