
注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
Opus 4.7
在宣布 Mythos 的存在仅一周后,Anthropic 就发布了 Opus 4.7。
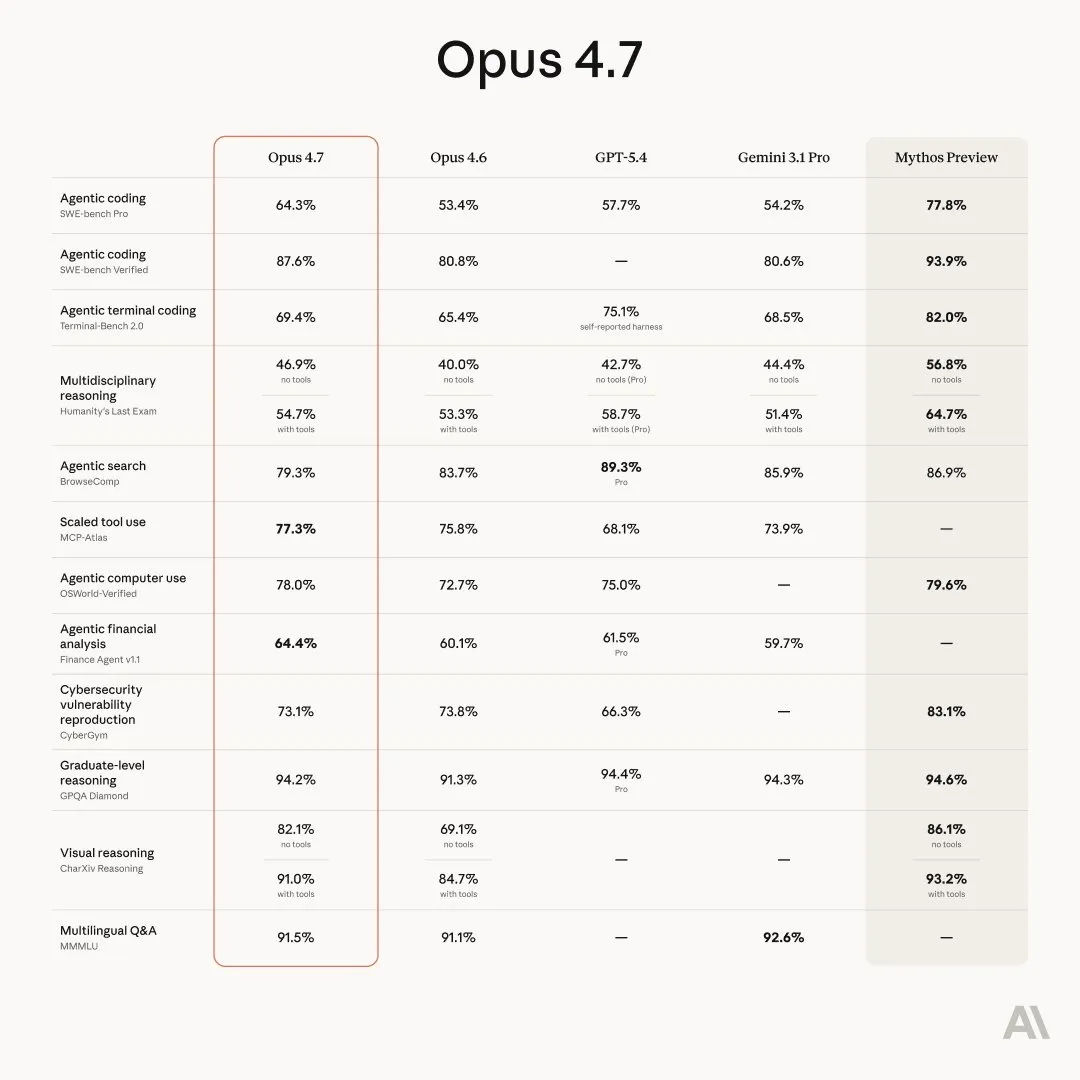
与以往的版本相比,大家对 Opus 4.7 的评价没有那么一致。 通常,新发布的模型都会明显优于前代;几乎每家实验室都是如此(Mistral 除外)。 但就 Opus 4.7 而言,目前我看到的评价褒贬不一。
它似乎缺少了以往 Claude 模型的那种打磨程度。 它缺乏个性和灵魂,在 Claude Code 中的表现虽然依然不错,却有些不稳定。不少人(包括我自己)都遇到了比平时更多的工具调用失败问题。
在编程方面,这个模型确实显得更聪明,但也更不可靠。Twitter 上的 Chubby 这样评价:
Opus 4.7 给人的感觉就像一个满腹怨气的员工,你没法放心相信它交出的成果,还得事后检查。你对 4.6 的那份信任已经没了。这就像招了一个新员工,简历上的成绩非常优秀,实际干起活来却马虎得要命、满腹牢骚,还不听指令。
这似乎是模型采用的新自适应思考模式造成的。 这种模式允许模型根据自己判断的问题难度,决定要花多少时间思考。 GPT 系列模型采用这种机制已经有一段时间了,而且效果很好,但 Anthropic 的实现似乎没做到位。 Opus 4.7 只认为编程或 STEM 相关任务足够难,值得投入更多思考,导致它在几乎所有其他领域都减少了推理,给出的答案也更差。
对 OpenAI 来说,自适应思考是为了改善用户体验,因为用户更喜欢快速得到答案。而 Anthropic 目前的算力限制远比 OpenAI 严重,因此他们使用自适应思考是为了节省算力。一位 HackerNews 用户这样说道:
[自适应思考]对这些公司来说,已经是一个解决了的问题。它解决的是他们的问题。不是你的 ;)
更让人恼火的是,Anthropic 还更新了这个模型的分词器,导致它处理相同文本时使用的 token 比平时更多。在字符数相同的情况下,费用比 Opus 4.6 高出 20–50%。
对大多数人来说,Opus 4.7 顶多算是一次同级替换,在原始智能、能力与可靠性之间做了取舍。对于大多数其他用途,它似乎还有些退步,所以我目前不推荐使用它,除非它在你自己的使用场景中表现明显更好。
Qwen 3.6 35B
距离 Qwen 3.5 系列发布还不到两个月,我们就迎来了首款开源 Qwen 3.6 模型,它是 35B-A3B 混合专家模型的更新版本。
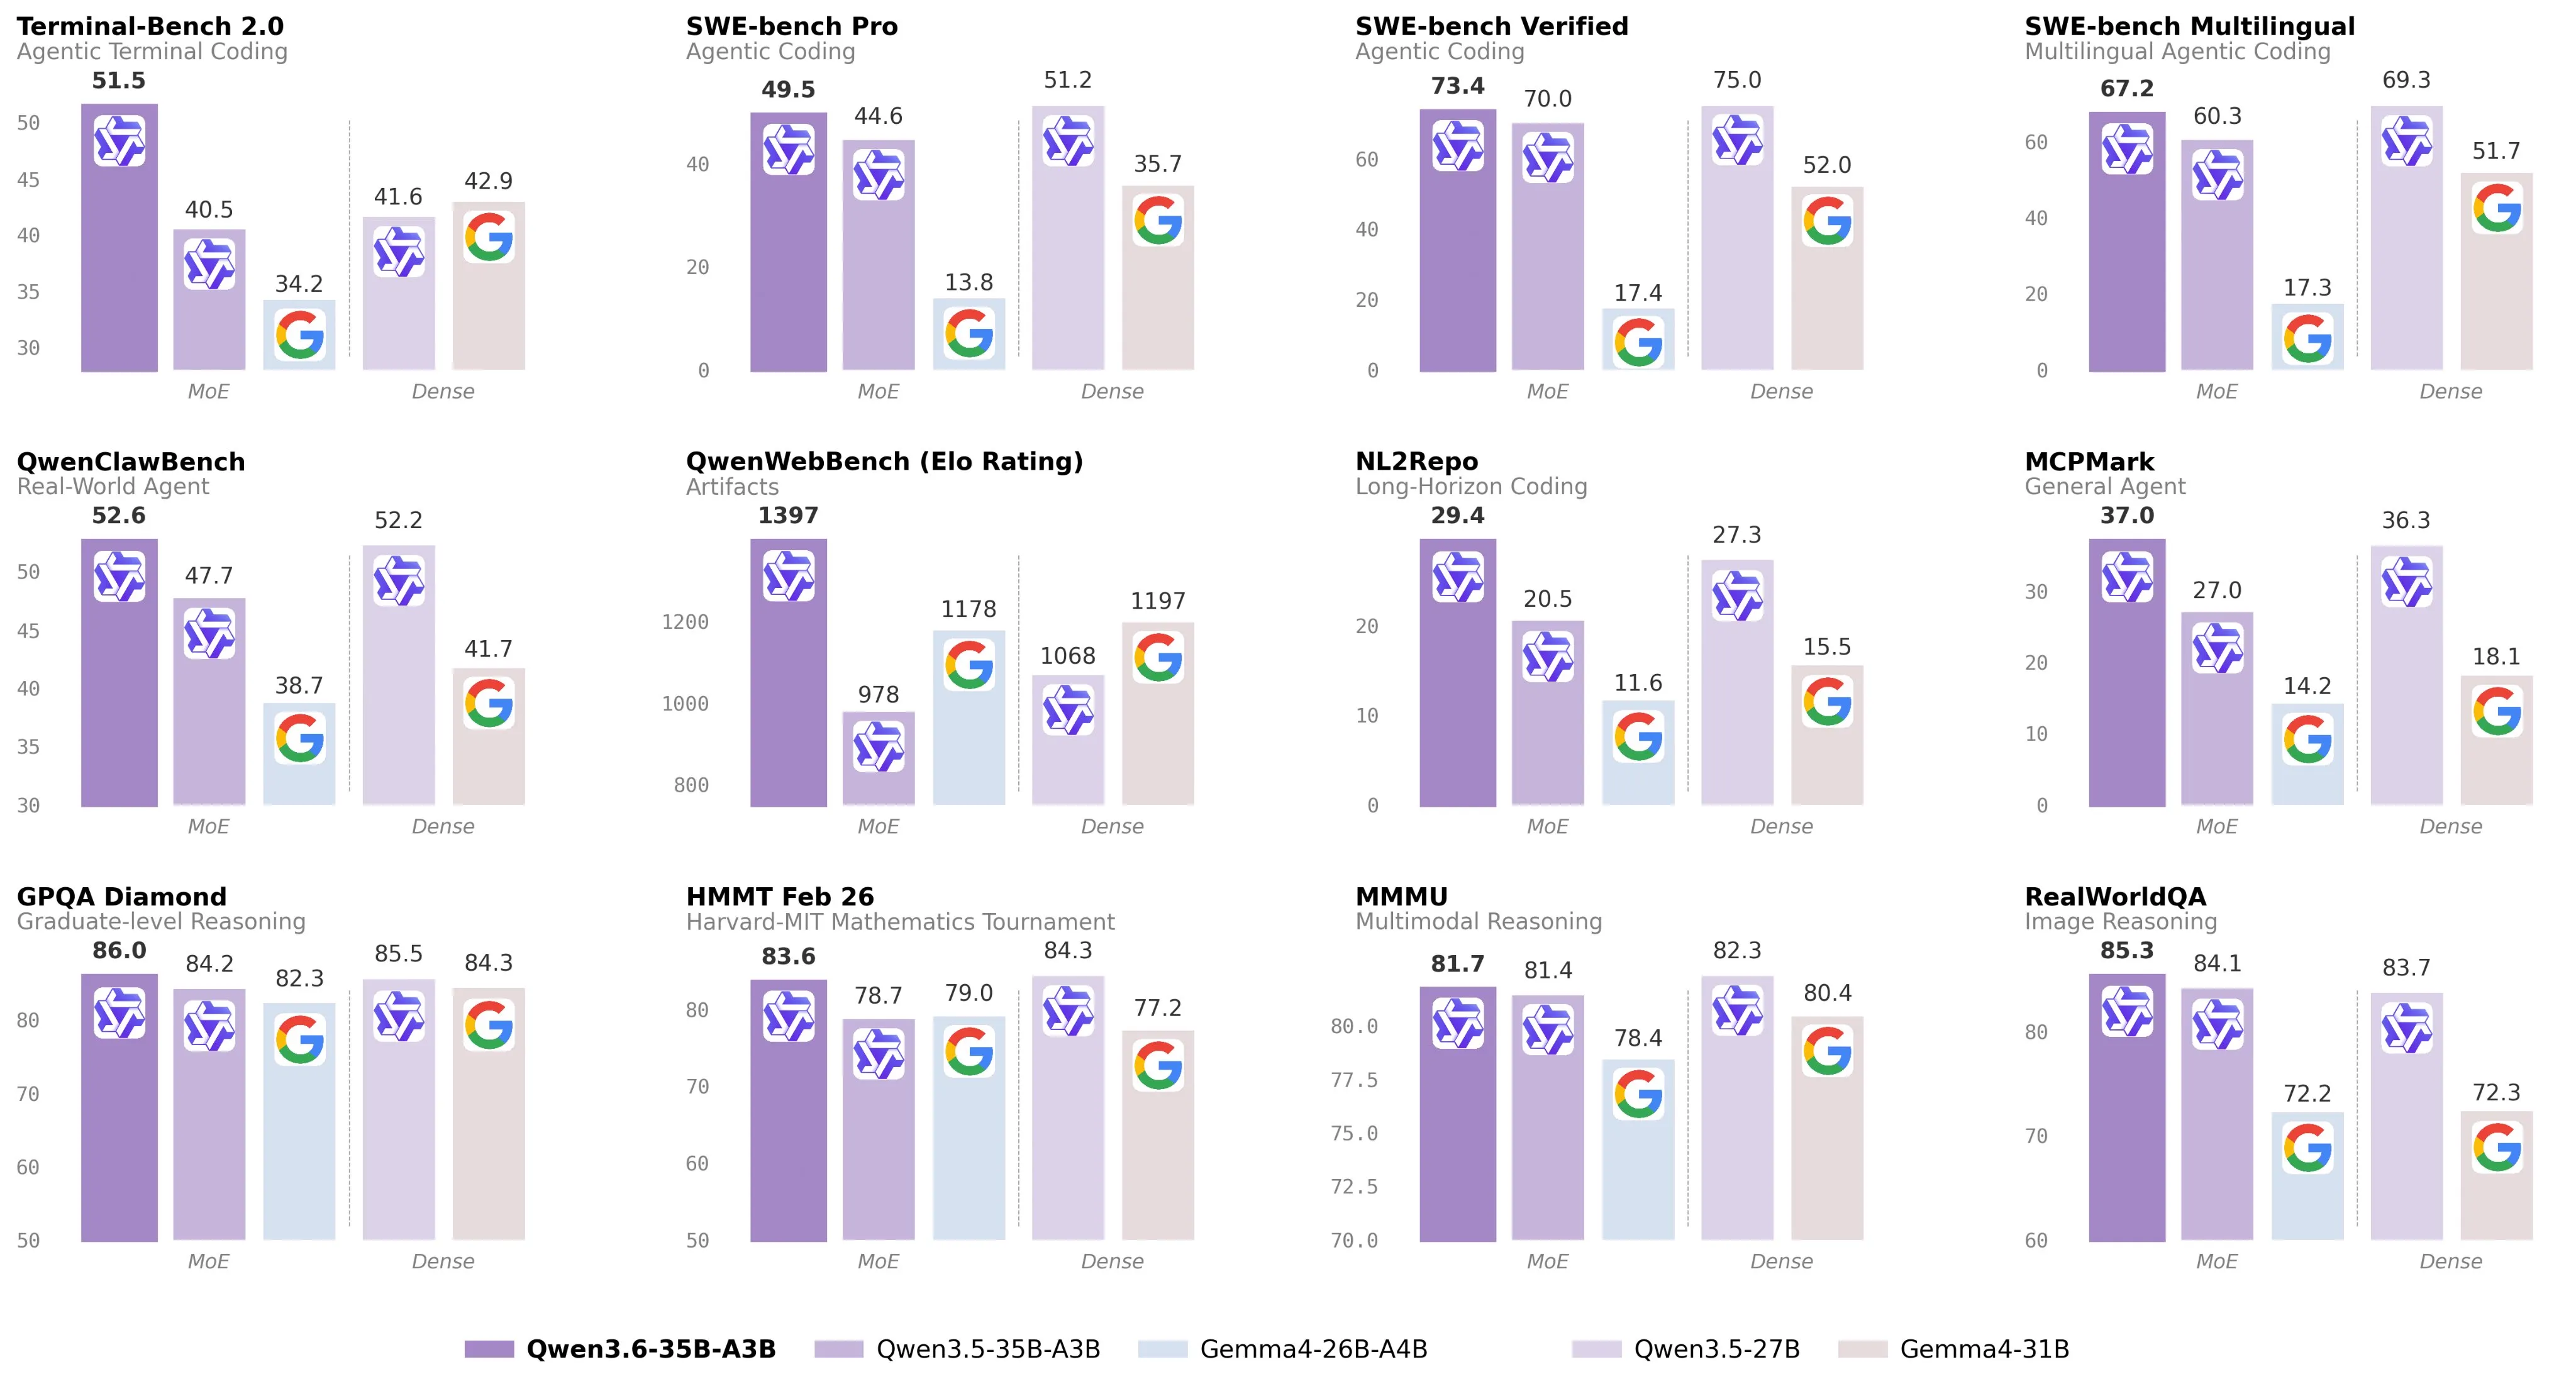
Qwen 3.5 和 Gemma 4 的稠密模型(上图中的 27B 和 31B 模型)被认为是首批表现足够好、可以用于编程执行框架和 OpenClaw 这类智能体界面的模型。 这款 Qwen 3.6 模型能够轻松击败这两款稠密模型,同时效率高得多,几乎任何配备至少 24GB 内存的硬件都能以不错的速度运行它(每秒超过 20 个 token)。
从基准测试成绩来看,它大约处于 Sonnet 4.5 的水平。这简直不可思议,因为它的模型规模至少比 Sonnet 小一个数量级,而 Sonnet 也不过是五个月前才发布的。 如果这一趋势持续下去,就意味着六个月后,我们将拥有一款达到 Opus 4.6/GPT 5.4 水平、而且可以相当轻松地在家运行的模型。
我自己一直在搭配 Hermes Agent 使用这个模型(它是 OpenClaw 的替代方案,对开源模型更友好一些),整体表现相当不错,没有遇到什么大问题。 我在 LocalLLaMA 上也看到了类似的评价,那里的一些用户既把它当作个人智能体,也把它当作颇为能干的编程助手。
正如我在介绍 Qwen3.5 和 Gemma 4 时所说,现在正是开始使用本地大语言模型的最佳时机,因为它们已经开始具备足够的能力,可以在简单和中等难度的任务上替代 OpenAI 和 Anthropic 的模型。
结语
希望你喜欢本周的新闻。如果你想每周收到这些资讯,记得在下方订阅我们的邮件列表。