
Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Opus 4.7
Apenas uma semana após anunciar a existência do Mythos, a Anthropic lançou o Opus 4.7.
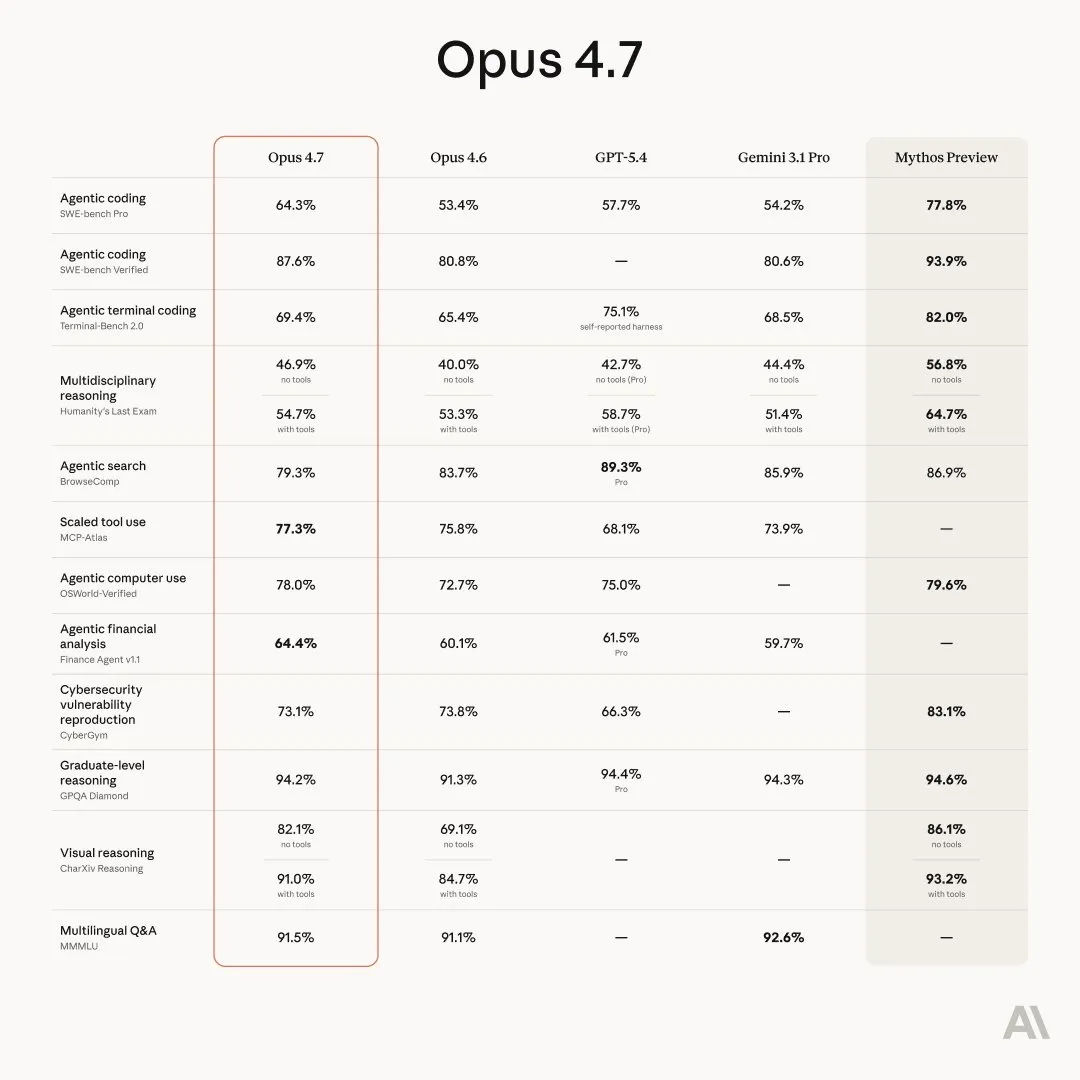
O consenso sobre o Opus 4.7 não é tão claro quanto nos lançamentos anteriores. Normalmente, um novo lançamento de modelo é claramente melhor do que seus predecessores; esse é o caso de praticamente todos os laboratórios (exceto a Mistral). Mas para o Opus 4.7, tenho visto opiniões divergentes até agora.
Parece faltar o nível de refinamento dos modelos Claude anteriores. Sua personalidade e “alma” estão ausentes, e suas capacidades dentro do Claude Code, embora ainda boas, são um pouco instáveis, com várias pessoas (inclusive eu) encontrando um número acima do normal de falhas nas chamadas de ferramentas.
Para programação, o modelo parece mais inteligente, mas também mais instável, segundo Chubby no Twitter:
O Opus 4.7 parece um funcionário insatisfeito cujos resultados você não consegue avaliar e precisa verificar depois. A confiança que você tinha com o 4.6 sumiu. É como contratar um novo funcionário que tinha notas excelentes na candidatura, mas é completamente descuidado e mal-humorado na prática e não segue instruções.
Isso parece ser causado pelo novo modo de raciocínio adaptativo que o modelo utiliza. Esse modo permite que o modelo pense mais ou menos para uma determinada consulta com base em quão difícil ele julga que ela é. A série de modelos GPT tem isso há algum tempo e funcionou muito bem, mas a Anthropic parece ter errado na implementação. O Opus 4.7 considera apenas tarefas de programação ou STEM como suficientemente difíceis para um raciocínio mais aprofundado, fazendo com que raciocine menos e dê respostas piores em praticamente todos os outros domínios.
Para a OpenAI, o raciocínio adaptativo visava uma melhor experiência do usuário, já que os usuários preferem respostas mais rápidas. A Anthropic, por outro lado, sendo muito mais limitada em termos de capacidade computacional do que a OpenAI atualmente, está usando o raciocínio adaptativo para economizar processamento. De acordo com um usuário do HackerNews:
[O raciocínio adaptativo é] um problema resolvido para as empresas. Ele resolve os problemas delas. Não os seus ;)
Para piorar, a Anthropic também atualizou o tokenizador do modelo, o que faz com que ele use mais tokens do que o normal, tornando-o 20-50% mais caro do que o Opus 4.6 para o mesmo número de caracteres.
Para a maioria das pessoas, o Opus 4.7 é, na melhor das hipóteses, uma atualização lateral, trocando inteligência e capacidade brutas por confiabilidade. Para a maioria dos outros casos de uso, parece ser uma ligeira regressão, portanto não recomendo seu uso no momento, a menos que ele apresente um desempenho notavelmente melhor para os seus próprios casos de uso.
Qwen 3.6 35B
Menos de 2 meses após os lançamentos do Qwen 3.5, temos agora nosso primeiro modelo open source Qwen 3.6, uma atualização do modelo mixture of experts 35B-A3B.
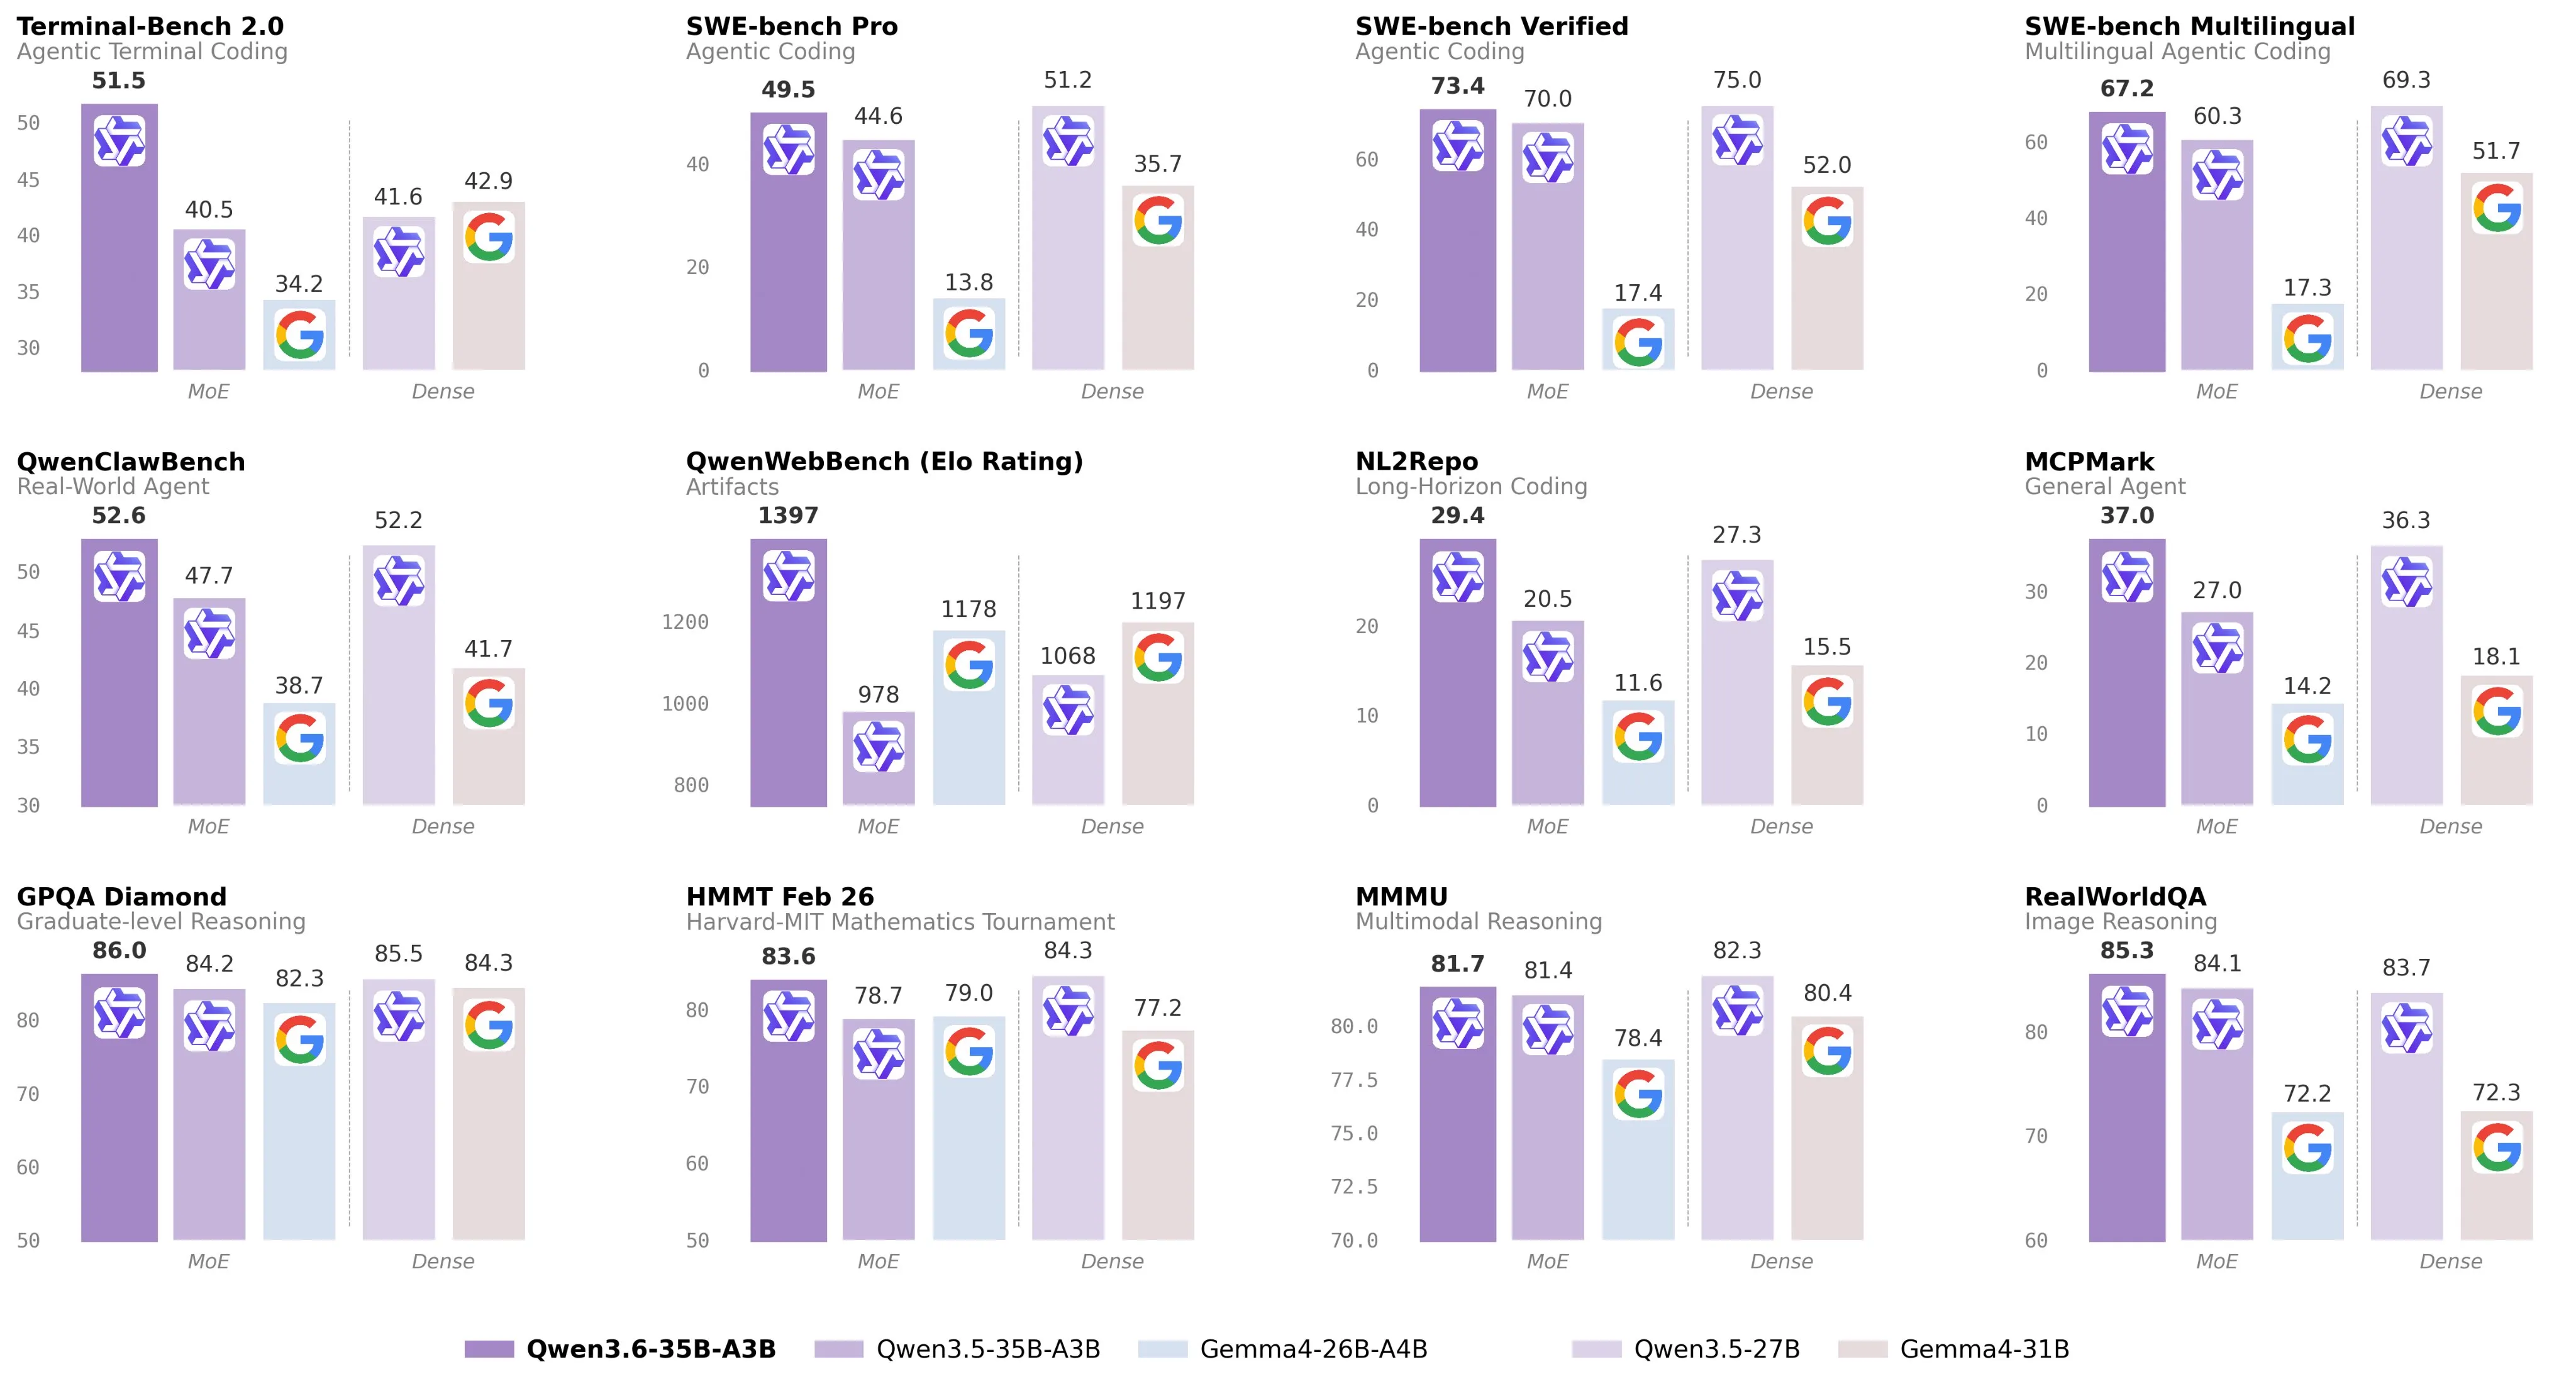
Os modelos densos Qwen 3.5 e Gemma 4 (os modelos de 27B e 31B no gráfico acima) eram considerados os primeiros modelos bons o suficiente para serem usados em ambientes de programação e interfaces de agentes como o OpenClaw. Este modelo Qwen 3.6 consegue superar com folga ambos os seus equivalentes densos, sendo muito mais eficiente, o que permite rodá-lo em velocidades decentes (>20 tokens por segundo) em praticamente qualquer hardware com pelo menos 24 GB de memória.
Em termos de pontuações nos benchmarks, está no nível do Sonnet 4.5, o que é impressionante, pois é pelo menos uma ordem de grandeza menor que o Sonnet, lançado há apenas 5 meses. Se essa tendência continuar, significa que teremos um modelo no nível do Opus 4.6/GPT 5.4 que poderemos rodar em casa com facilidade em 6 meses.
Tenho usado pessoalmente este modelo com o Hermes Agent (uma alternativa ao OpenClaw um pouco mais amigável para modelos open source) e funcionou muito bem, sem problemas graves. Tenho visto sentimentos semelhantes entre os usuários do LocalLLaMA que o têm usado como agente pessoal e também como um assistente de programação bastante competente.
Como já disse para os modelos Qwen 3.5 e Gemma 4, agora é o melhor momento para começar a usar LLMs locais, porque eles estão começando a ser bons o suficiente para substituir a OpenAI e a Anthropic em tarefas de dificuldade fácil e média.
Conclusão
Espero que você tenha gostado das novidades desta semana. Se quiser receber as notícias toda semana, não deixe de se inscrever na nossa lista de e-mails abaixo.