Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
Kimi K2 Thinking
Moonshot AI ha lanzado la versión thinking de su ya potente modelo Kimi K2.
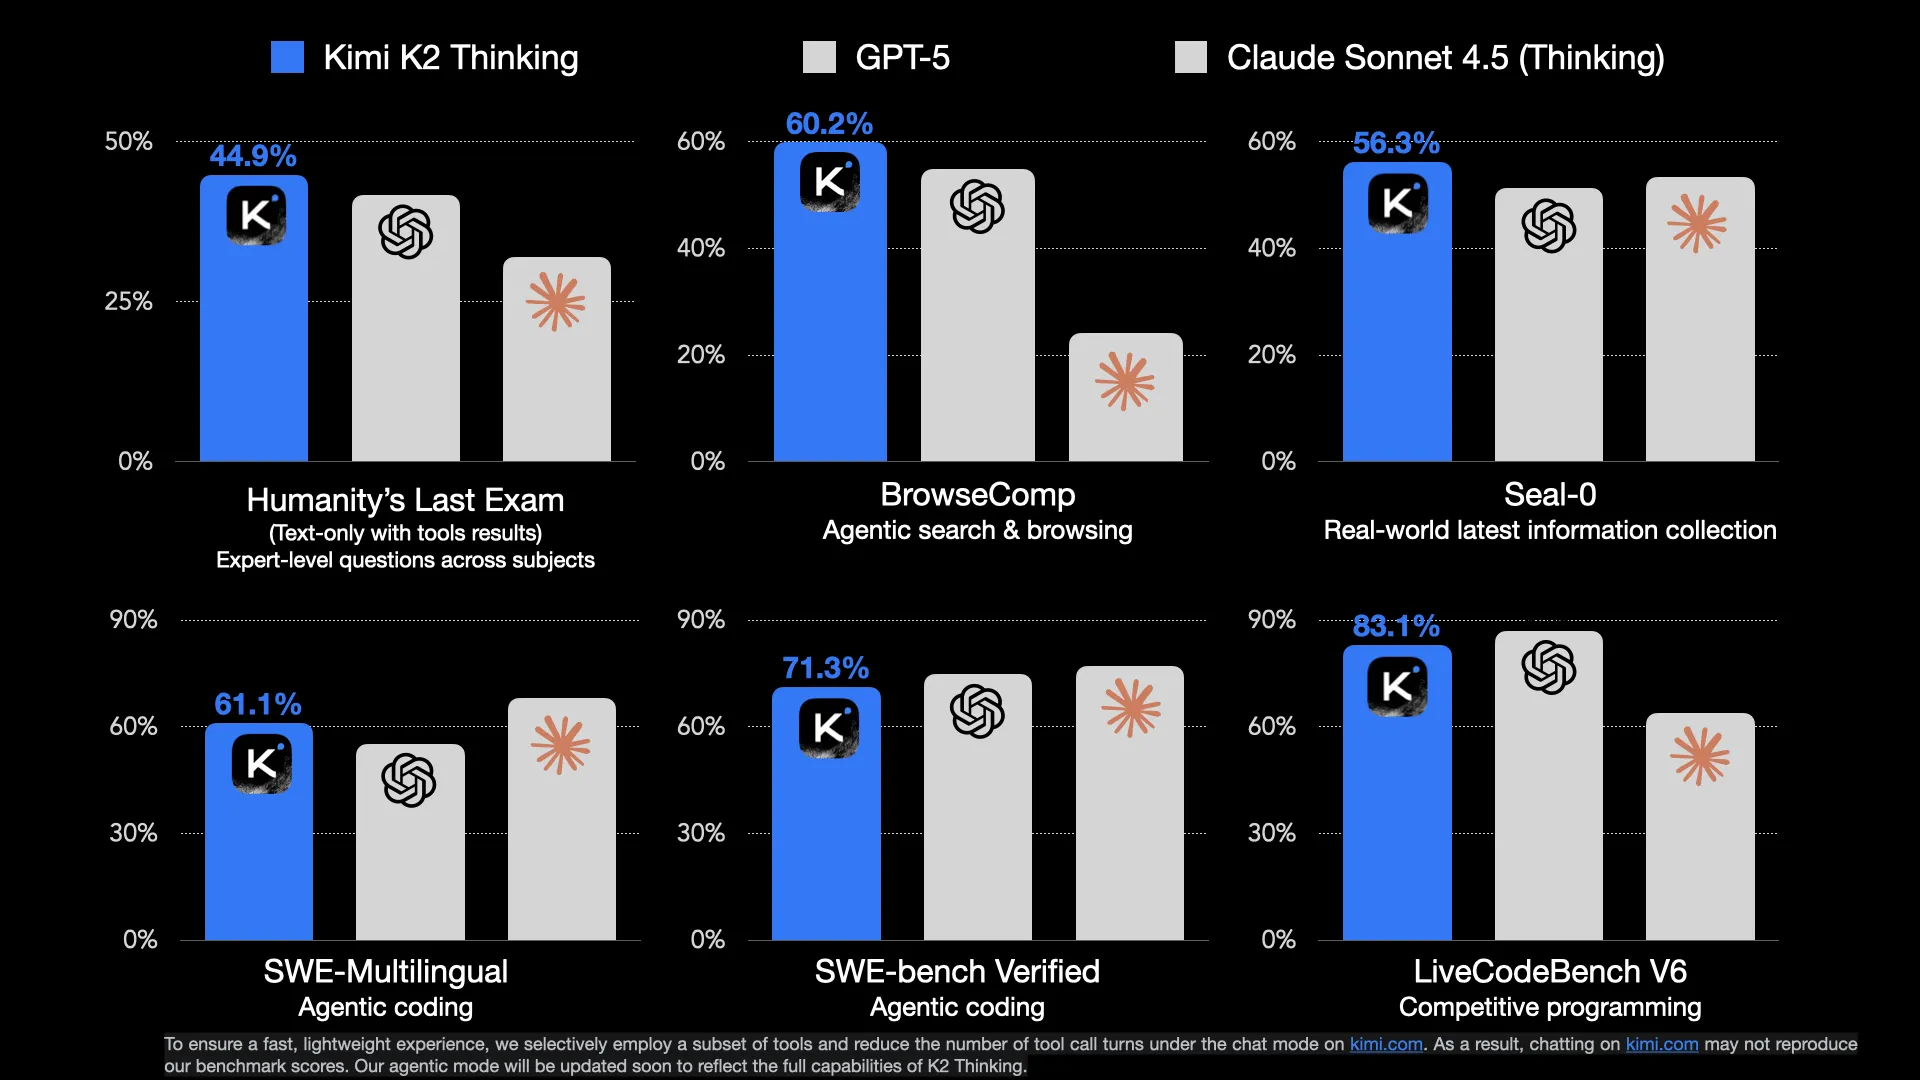
El modelo sigue siendo el gigantesco mixture of experts de 1 billón de parámetros de antes con 32B de parámetros activos. El modelo fue entrenado usando quantization aware training para permitir su implementación en 4 bits sin sufrir mucha degradación de rendimiento. Todos los benchmarks publicados por el equipo son para el modelo INT4.
Continúa siendo el mejor modelo en términos de escritura, superando de alguna manera a su predecesor, el modelo instruct, que era el mejor anterior. También sigue siendo el LLM más único en términos de personalidad y estilo general de escritura, siendo drásticamente diferente de la mediocridad que tienen prácticamente todos los demás LLM importantes.
En esta versión del modelo, el equipo de Moonshot realmente trabajó en las capacidades agénticas del modelo, que faltaban en el modelo instruct. No parece estar necesariamente al mismo nivel que GPT-5 y Sonnet 4.5 para codificación agéntica, pero para casos de uso de agentes más generales parece poder mantenerse firme.
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| GLM 4.6 | $0.60 | $2.20 | 90 |
| Claude Sonnet 4.5 | $3 | $15 | 57 |
| GPT 5 | $1.5 | $10 | 34 |
| Kimi K2 Thinking | $0.6 | $2.50 | 25 |
| Kimi K2 Thinking Turbo | $1.15 | $8 | 107 |
Los principales problemas con el modelo son la velocidad y el uso de tokens.
El modelo es económico, a solo $2.50 por millón de tokens de salida, pero a 25 tokens por segundo es más lento que incluso el glacial GPT-5 (aquellos que han usado GPT-5 en Codex saben a qué me refiero). Para tareas de agentes esto es inaceptablemente lento. Podrías cambiar al endpoint Turbo, pero entonces el precio se vuelve similar al de GPT-5, lo que anula uno de los principales propósitos de estos modelos chinos, que es que son muy baratos.
Además, Kimi K2 Thinking tiene un problema que la mayoría de los modelos de razonamiento de primera generación tienen, que son las trazas de pensamiento extremadamente largas. Específicamente, Kimi K2 parece tener los procesos de cadena de pensamiento más largos de cualquier modelo de razonamiento, como muestra el benchmark de Artifical Analysis a continuación.
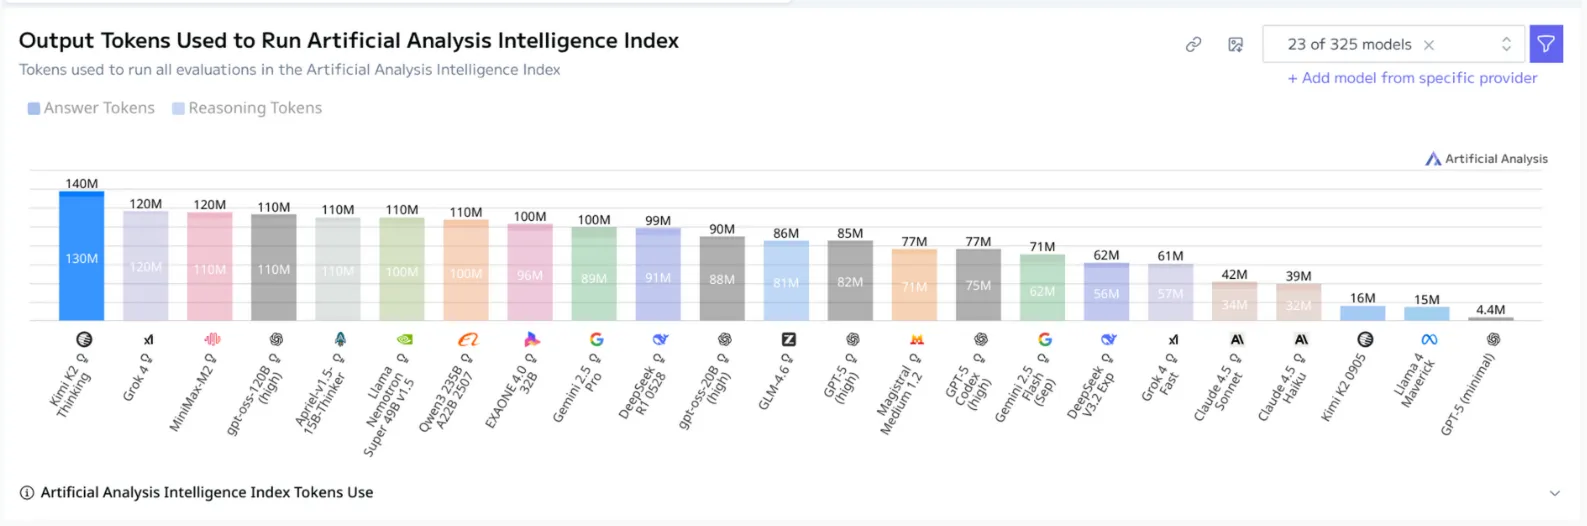
Este es un problema que puede solucionarse, así que espero que el equipo de Moonshot lo solucione en el futuro, pero sí hace que el modelo sea aún más lento de usar ahora.
Sin embargo, estos no son obstáculos definitivos, porque al final del día este modelo es muy potente, cerca o en la frontera de la inteligencia, todo mientras es de código abierto. Estaré usando Kimi K2 thinking diariamente durante la próxima semana más o menos para ver si puede reemplazar a GPT-5 para mis preguntas diarias de IA.
El jagged edge of intelligence hace que estos modelos de frontera se vean yendo y viniendo en la cima de los benchmarks, sin un ganador claro directo. Al final del día, todo se reducirá a tu caso de uso específico para determinar qué modelo deberías usar. Yo tiendo a enfocarme en la codificación agéntica, ya que es para lo que más uso estos modelos, pero tus necesidades pueden ser diferentes. Debido a esto, recomiendo construir tu propio pequeño conjunto de evaluación y usarlo para probar modelos existentes y nuevos que salgan, para que puedas evaluar si deberías o no cambiar a él.
Grandes actualizaciones de Llama.cpp
El equipo de Llama.cpp se ha cansado de ser conocido como el backend no reconocido de herramientas mediocres como Ollama, LMStudio y Jan, y ha implementado cambios para hacer que la biblioteca sea fácilmente accesible para todos.
El primer cambio es una renovación de la interfaz de usuario predeterminada que está disponible al ejecutar un modelo de llama.cpp. Anteriormente, la interfaz de usuario había sido muy básica y no guardaba nada para el usuario.
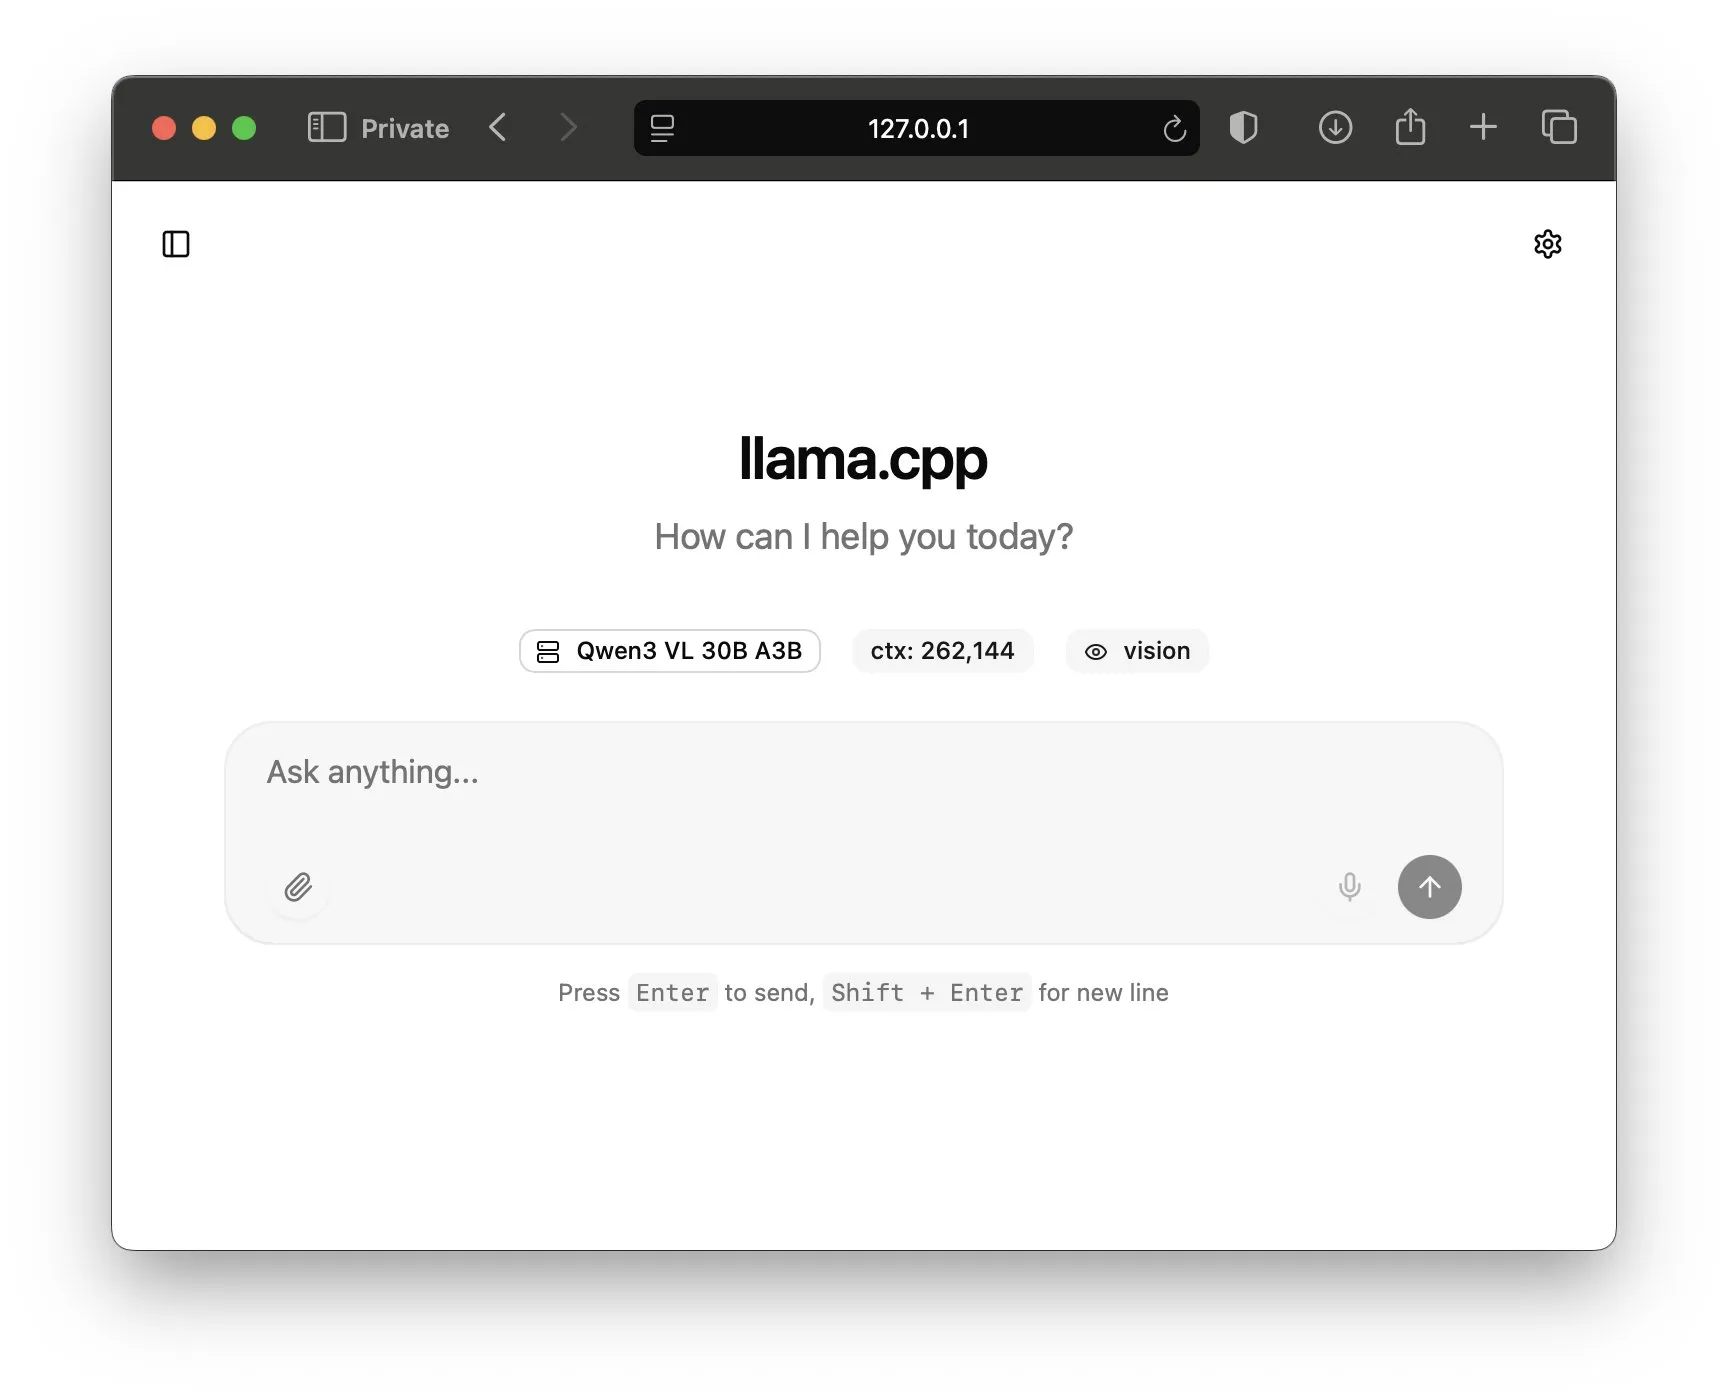
Ahora la interfaz tiene una interfaz mucho más estándar, intuitiva y de mejor aspecto para que uses. También tiene historial de chat y herramientas más avanzadas como modificar parámetros de muestreo o hacer que el modelo siga salidas estructuradas.
Uno de los problemas persistentes con Llama cpp ha sido la dificultad de configurarlo, especialmente en comparación con herramientas como Ollama.
Esto se ha solucionado ahora, con el lanzamiento de LlamaBarn, una aplicación de barra de menú para Mac que te permite ejecutar LLMs con solo un clic.
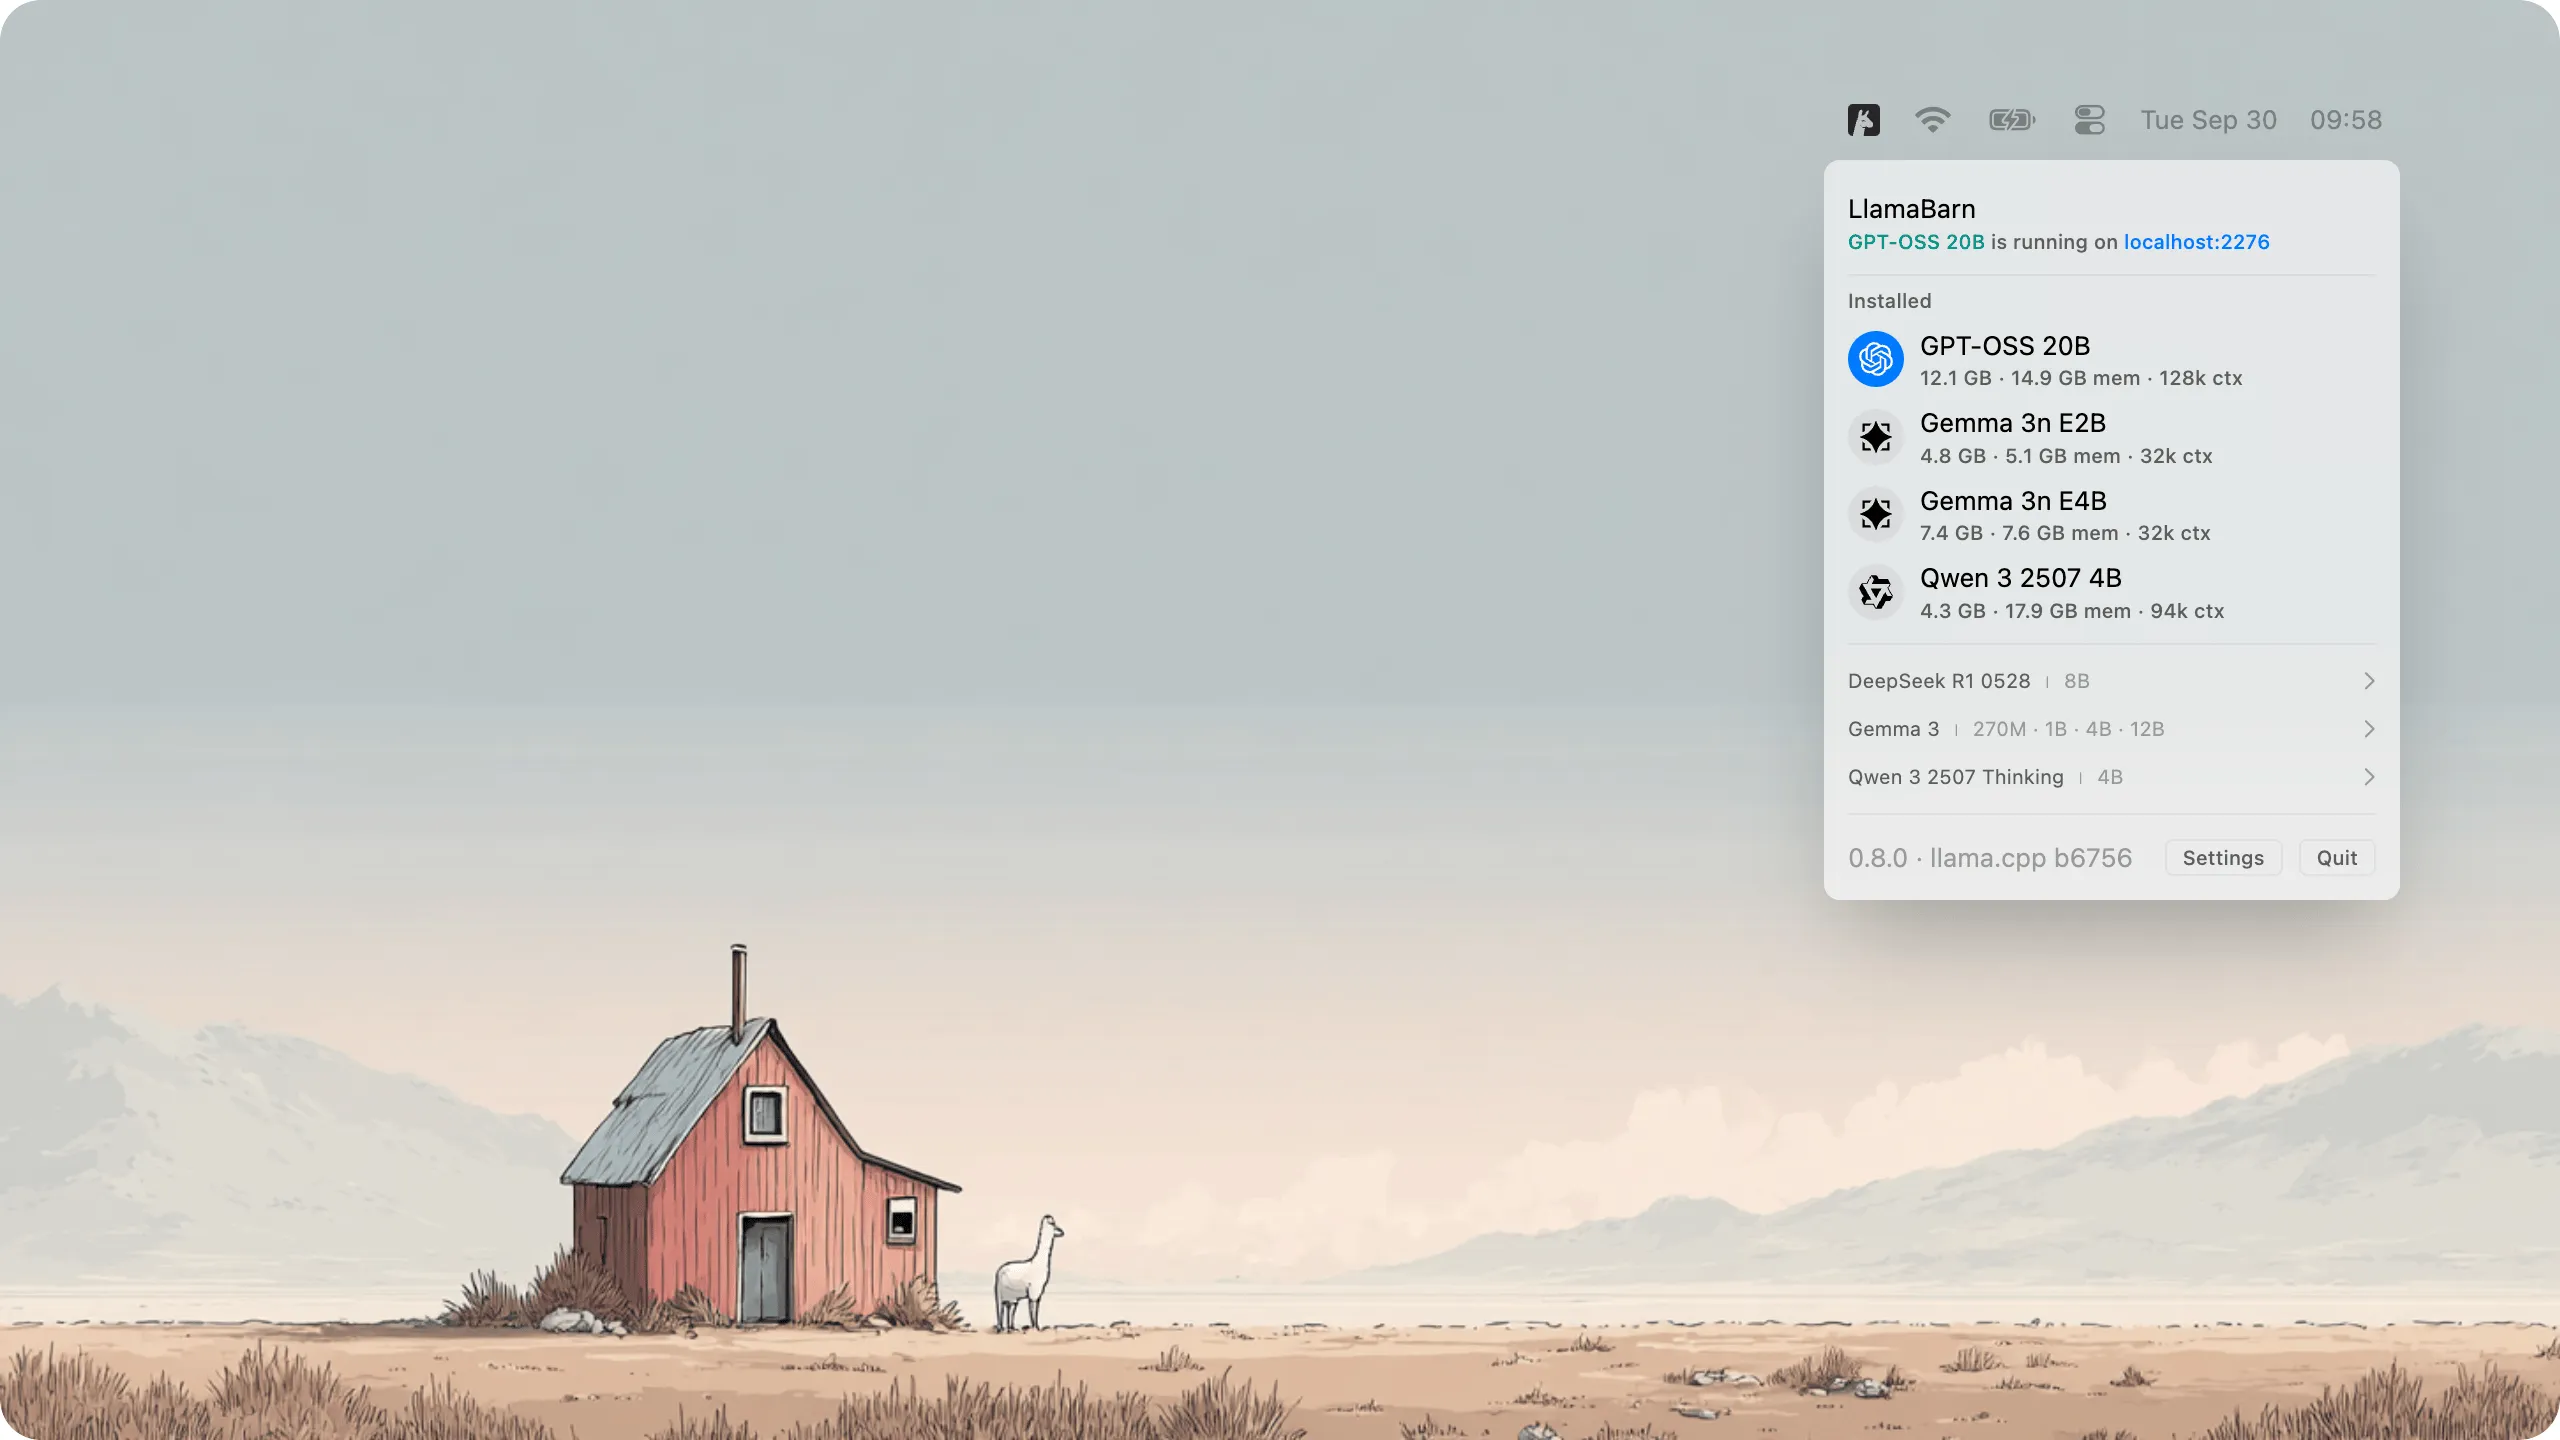
LlamaBarn manejará automáticamente la descarga del modelo, la optimización para tu hardware específico y luego la ejecución real del modelo. Iniciará un servidor compatible con la biblioteca de la API de OpenAI para que lo uses en tu código, y también iniciará la nueva interfaz web mencionada anteriormente.
Si actualmente estás ejecutando modelos localmente en tu Mac con herramientas como Ollama, LMStudio, Jan o cualquier otra, te recomendaría encarecidamente cambiar a Llama.cpp, ya que es lo que todas estas otras herramientas están usando internamente. Al usar Llama.cpp obtendrás la experiencia de primera mano de ejecutar estos modelos, sin ninguna de las sobrecargas o “ajustes de rendimiento” que degradan la calidad del modelo que las otras bibliotecas proporcionan.
Quick Hits
Actualizaciones de OpenAI Codex
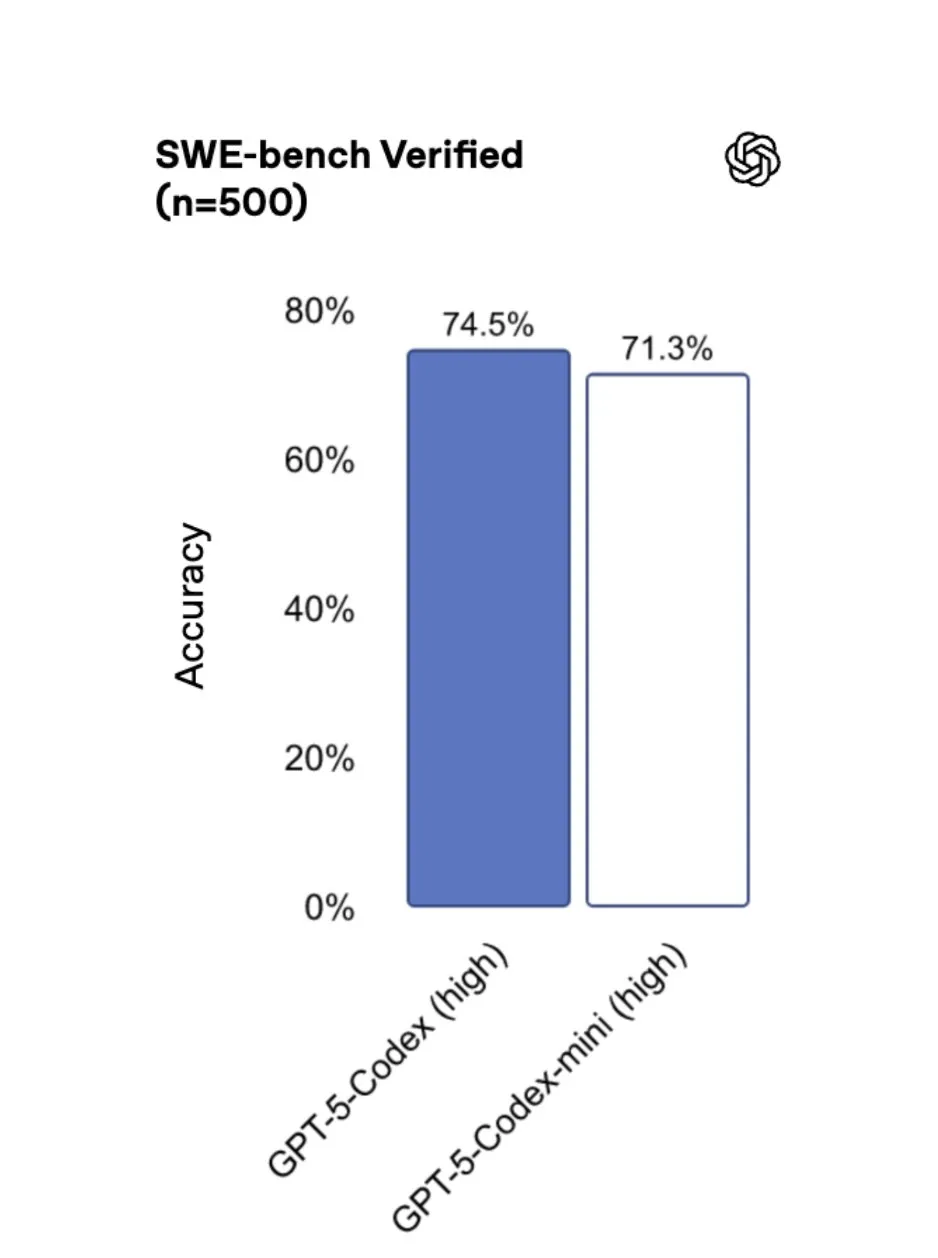
OpenAI ha lanzado algunas actualizaciones a su plataforma de codificación Codex, principalmente aumentando los límites de tasa en un 50% y lanzando GPT 5 Codex Mini, que usa límites de tasa la mitad de rápido que el modelo Codex regular, y también es notablemente más rápido.
Científico de IA que puede trabajar durante días
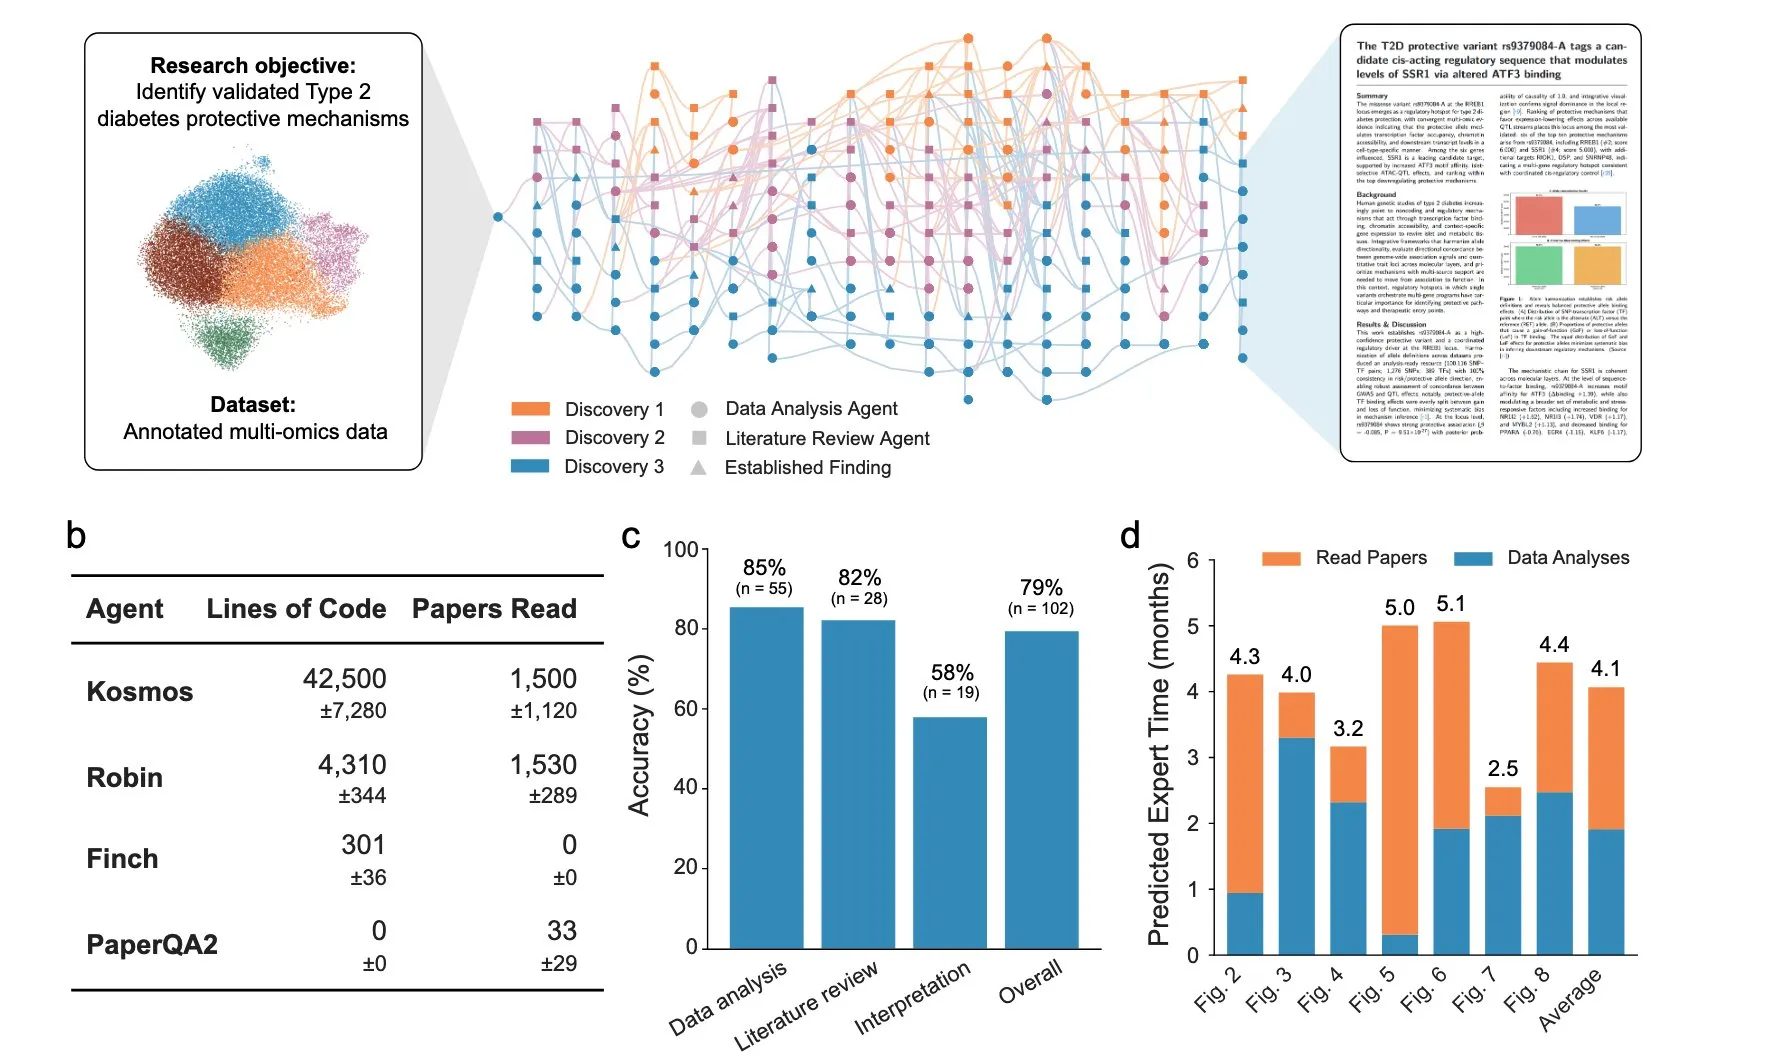
Una empresa llamada Edison Scientific ha salido con un sistema de agentes que dicen puede ejecutarse durante días seguidos.
Dicen que ya ha escrito 7 artículos sobre temas únicos, previamente desconocidos/inexplorados, y que su tasa de éxito es del 80%. También incluyen un artículo que documenta cómo funciona.
Puedes usarlo ahora gratis si tienes un correo electrónico académico (obtienes 3 consultas). Después de eso costará $200 por ejecución.
ComfyUI cloud
La popular plataforma de generación de imágenes y videos ComfyUI ha lanzado un plan de cómputo mensual que brinda a los usuarios 8 horas de GPU A100 40GB por día para generar imágenes y videos.
Si eres un usuario avanzado, una startup que tiene flujos de trabajo personalizados que quieres ejecutar, o has querido usar ComfyUI pero no tenías el poder de cómputo para ello, esta es la opción más rentable para usar ahora mismo.
Cierre
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.