Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
Kimi K2 Thinking
Moonshot AI lançou a versão thinking de seu já forte modelo Kimi K2.
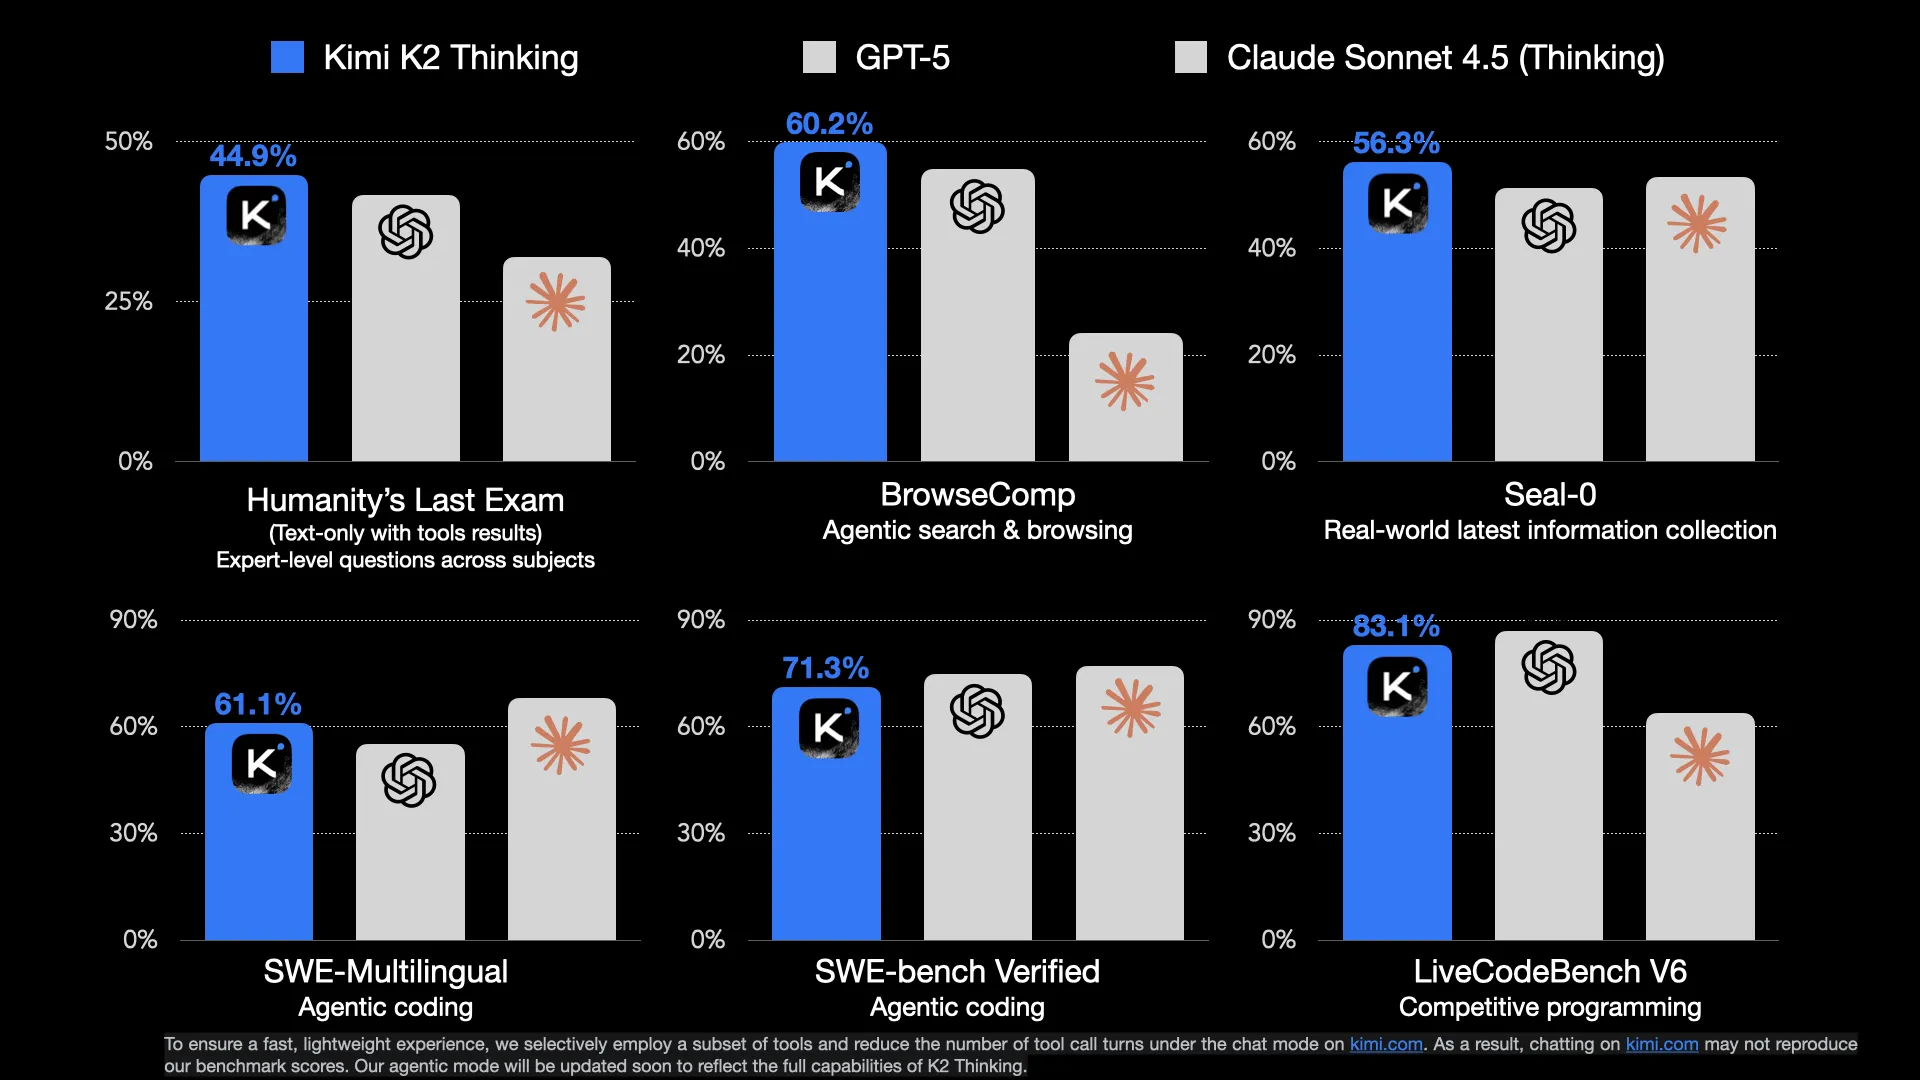
O modelo continua sendo o gigantesco mixture of experts de 1 trilhão de parâmetros de antes, com 32B de parâmetros ativos. O modelo foi treinado usando quantization aware training para permitir que seja implantado em 4 bits sem sofrer muita degradação de desempenho. Todos os benchmarks divulgados pela equipe são para o modelo INT4.
Ele continua sendo o melhor modelo em termos de escrita, de alguma forma superando seu predecessor, o modelo instruct, que era o melhor anterior. Ele também continua sendo o LLM mais único em termos de personalidade e estilo geral de escrita, sendo drasticamente diferente do conteúdo genérico que praticamente todos os outros LLMs importantes têm.
Nesta versão do modelo, a equipe Moonshot realmente trabalhou nas capacidades agênticas do modelo, que eram deficientes no modelo instruct. Parece não estar necessariamente no mesmo nível que GPT-5 e Sonnet 4.5 para codificação agêntica, mas para casos de uso de agentes mais gerais parece ser capaz de se manter competitivo.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| GLM 4.6 | $0.60 | $2.20 | 90 |
| Claude Sonnet 4.5 | $3 | $15 | 57 |
| GPT 5 | $1.5 | $10 | 34 |
| Kimi K2 Thinking | $0.6 | $2.50 | 25 |
| Kimi K2 Thinking Turbo | $1.15 | $8 | 107 |
Os principais problemas com o modelo são velocidade e uso de tokens.
O modelo é barato, custando apenas $2.50 por milhão de tokens de saída, mas a 25 tokens por segundo é mais lento até que o glacial GPT-5 (aqueles que usaram GPT-5 no Codex sabem o que quero dizer). Para tarefas de agentes isso é inaceitavelmente lento. Você poderia mudar para o endpoint Turbo, mas então o preço fica similar ao GPT-5, o que derrota um dos principais propósitos desses modelos chineses, que é serem muito baratos.
Além disso, Kimi K2 Thinking tem um problema que a maioria dos outros modelos de raciocínio de primeira geração têm, que são traces de pensamento extremamente longos. Especificamente, Kimi K2 parece ter os processos de cadeia de pensamento mais longos de qualquer modelo de raciocínio, como mostrado pelo benchmark da Artificial Analysis abaixo.
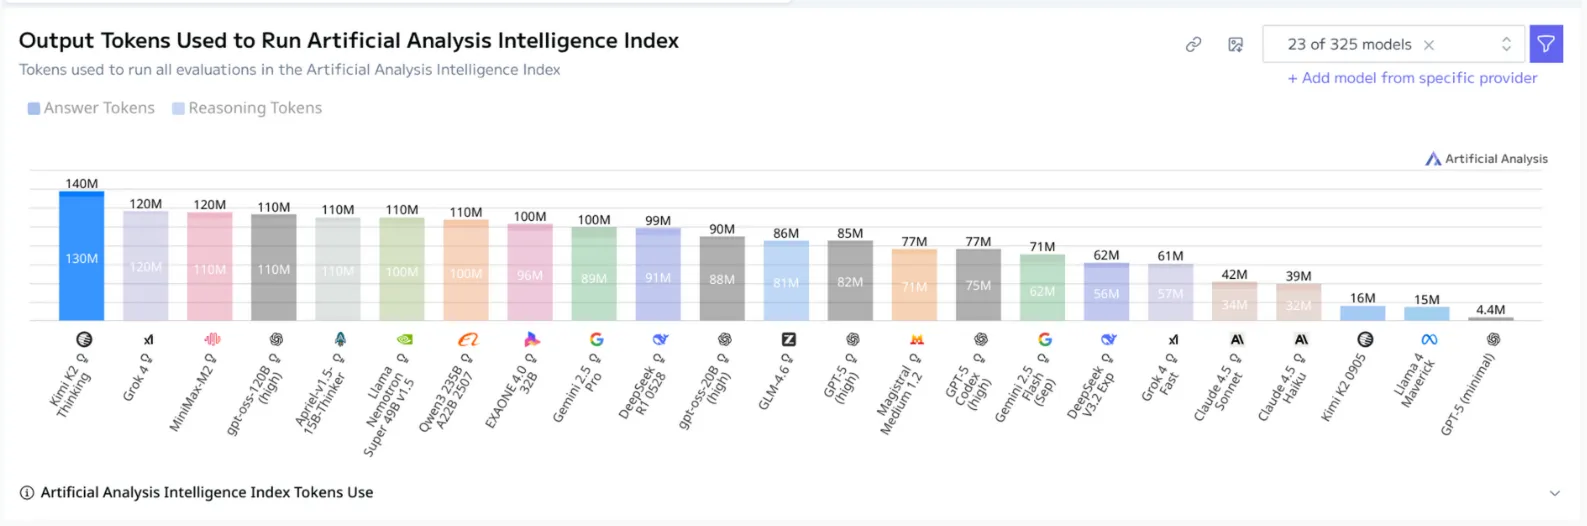
Este é um problema que pode ser corrigido, então espero que a equipe Moonshot o corrija no futuro, mas isso torna o modelo ainda mais lento de usar agora.
Estes não são problemas fatais, no entanto, porque no final das contas este modelo é muito forte, próximo ou na fronteira da inteligência, tudo isso sendo de código aberto. Vou usar Kimi K2 thinking diariamente pela próxima semana para ver se ele pode substituir GPT-5 para minhas perguntas diárias de IA.
A fronteira irregular da inteligência faz com que esses modelos de fronteira sejam vistos indo e voltando no topo dos benchmarks, sem um vencedor claro direto. No final das contas, vai depender do seu caso de uso específico para qual modelo você deve usar. Eu tendo a focar em codificação agêntica, já que é para isso que uso esses modelos na maior parte do tempo, mas suas necessidades podem ser diferentes. Por causa disso, recomendo construir seu próprio pequeno conjunto de avaliação e usá-lo para testar modelos existentes e novos que surgirem, para que você possa avaliar se deve ou não mudar para ele.
Grandes atualizações do Llama.cpp
A equipe Llama.cpp se cansou de ser conhecida como o backend não reconhecido para ferramentas inferiores como Ollama, LMStudio e Jan, e lançou mudanças para tornar a biblioteca facilmente acessível para todos.
A primeira mudança é uma reformulação da UI padrão que está disponível ao executar um modelo llama.cpp. Anteriormente, a UI tinha sido muito básica e não salvava nada para o usuário.
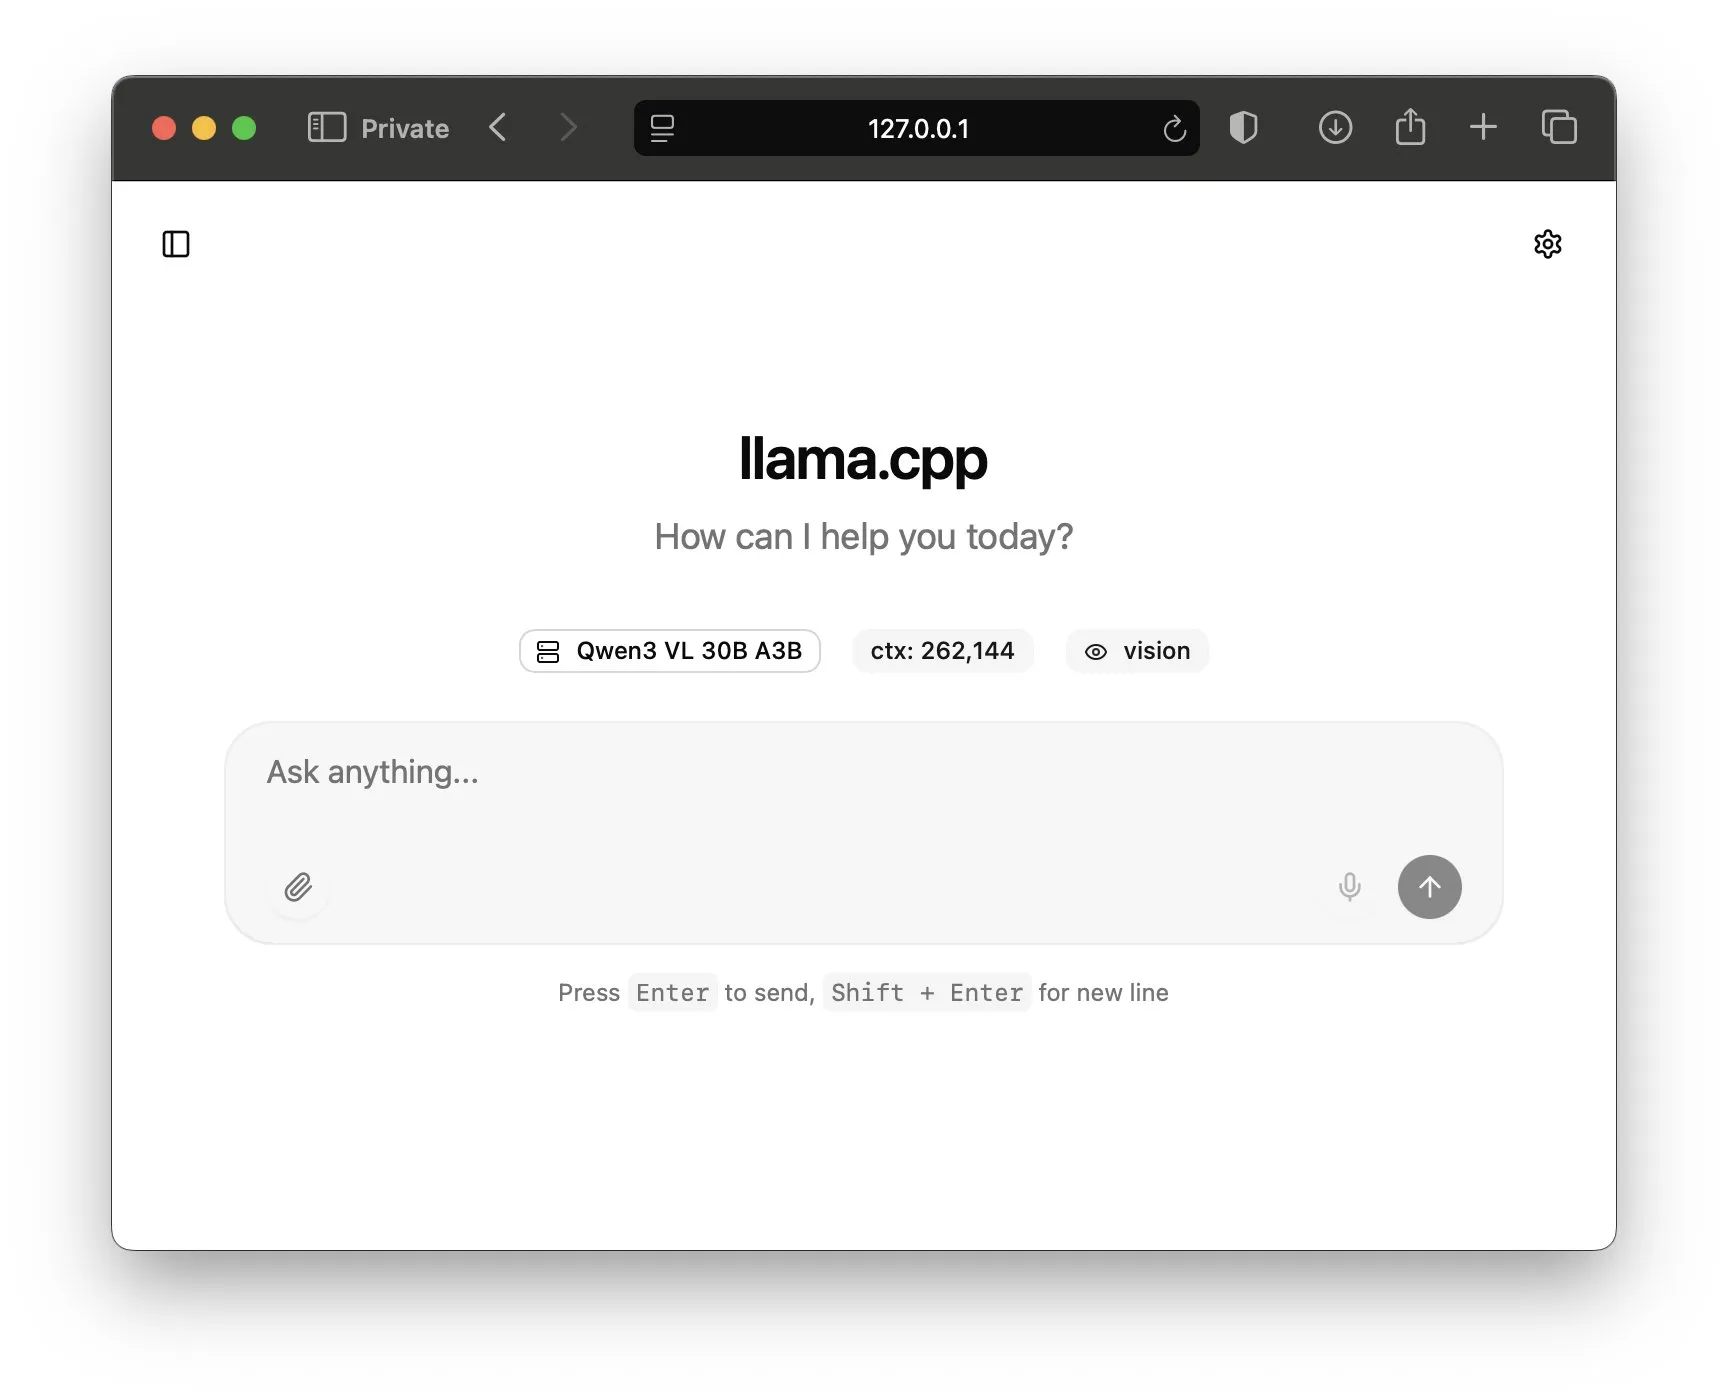
Agora a UI tem uma interface muito mais padrão, intuitiva e com melhor aparência para você usar. Ela também tem histórico de chat e ferramentas mais avançadas como modificar parâmetros de amostragem ou fazer o modelo seguir saídas estruturadas.
Um dos problemas de longa data com Llama cpp tem sido a dificuldade de configurá-lo, especialmente quando comparado a ferramentas como Ollama.
Isso foi corrigido agora, com o lançamento do LlamaBarn, um aplicativo de barra de menu para Mac que permite executar LLMs com apenas um único clique.
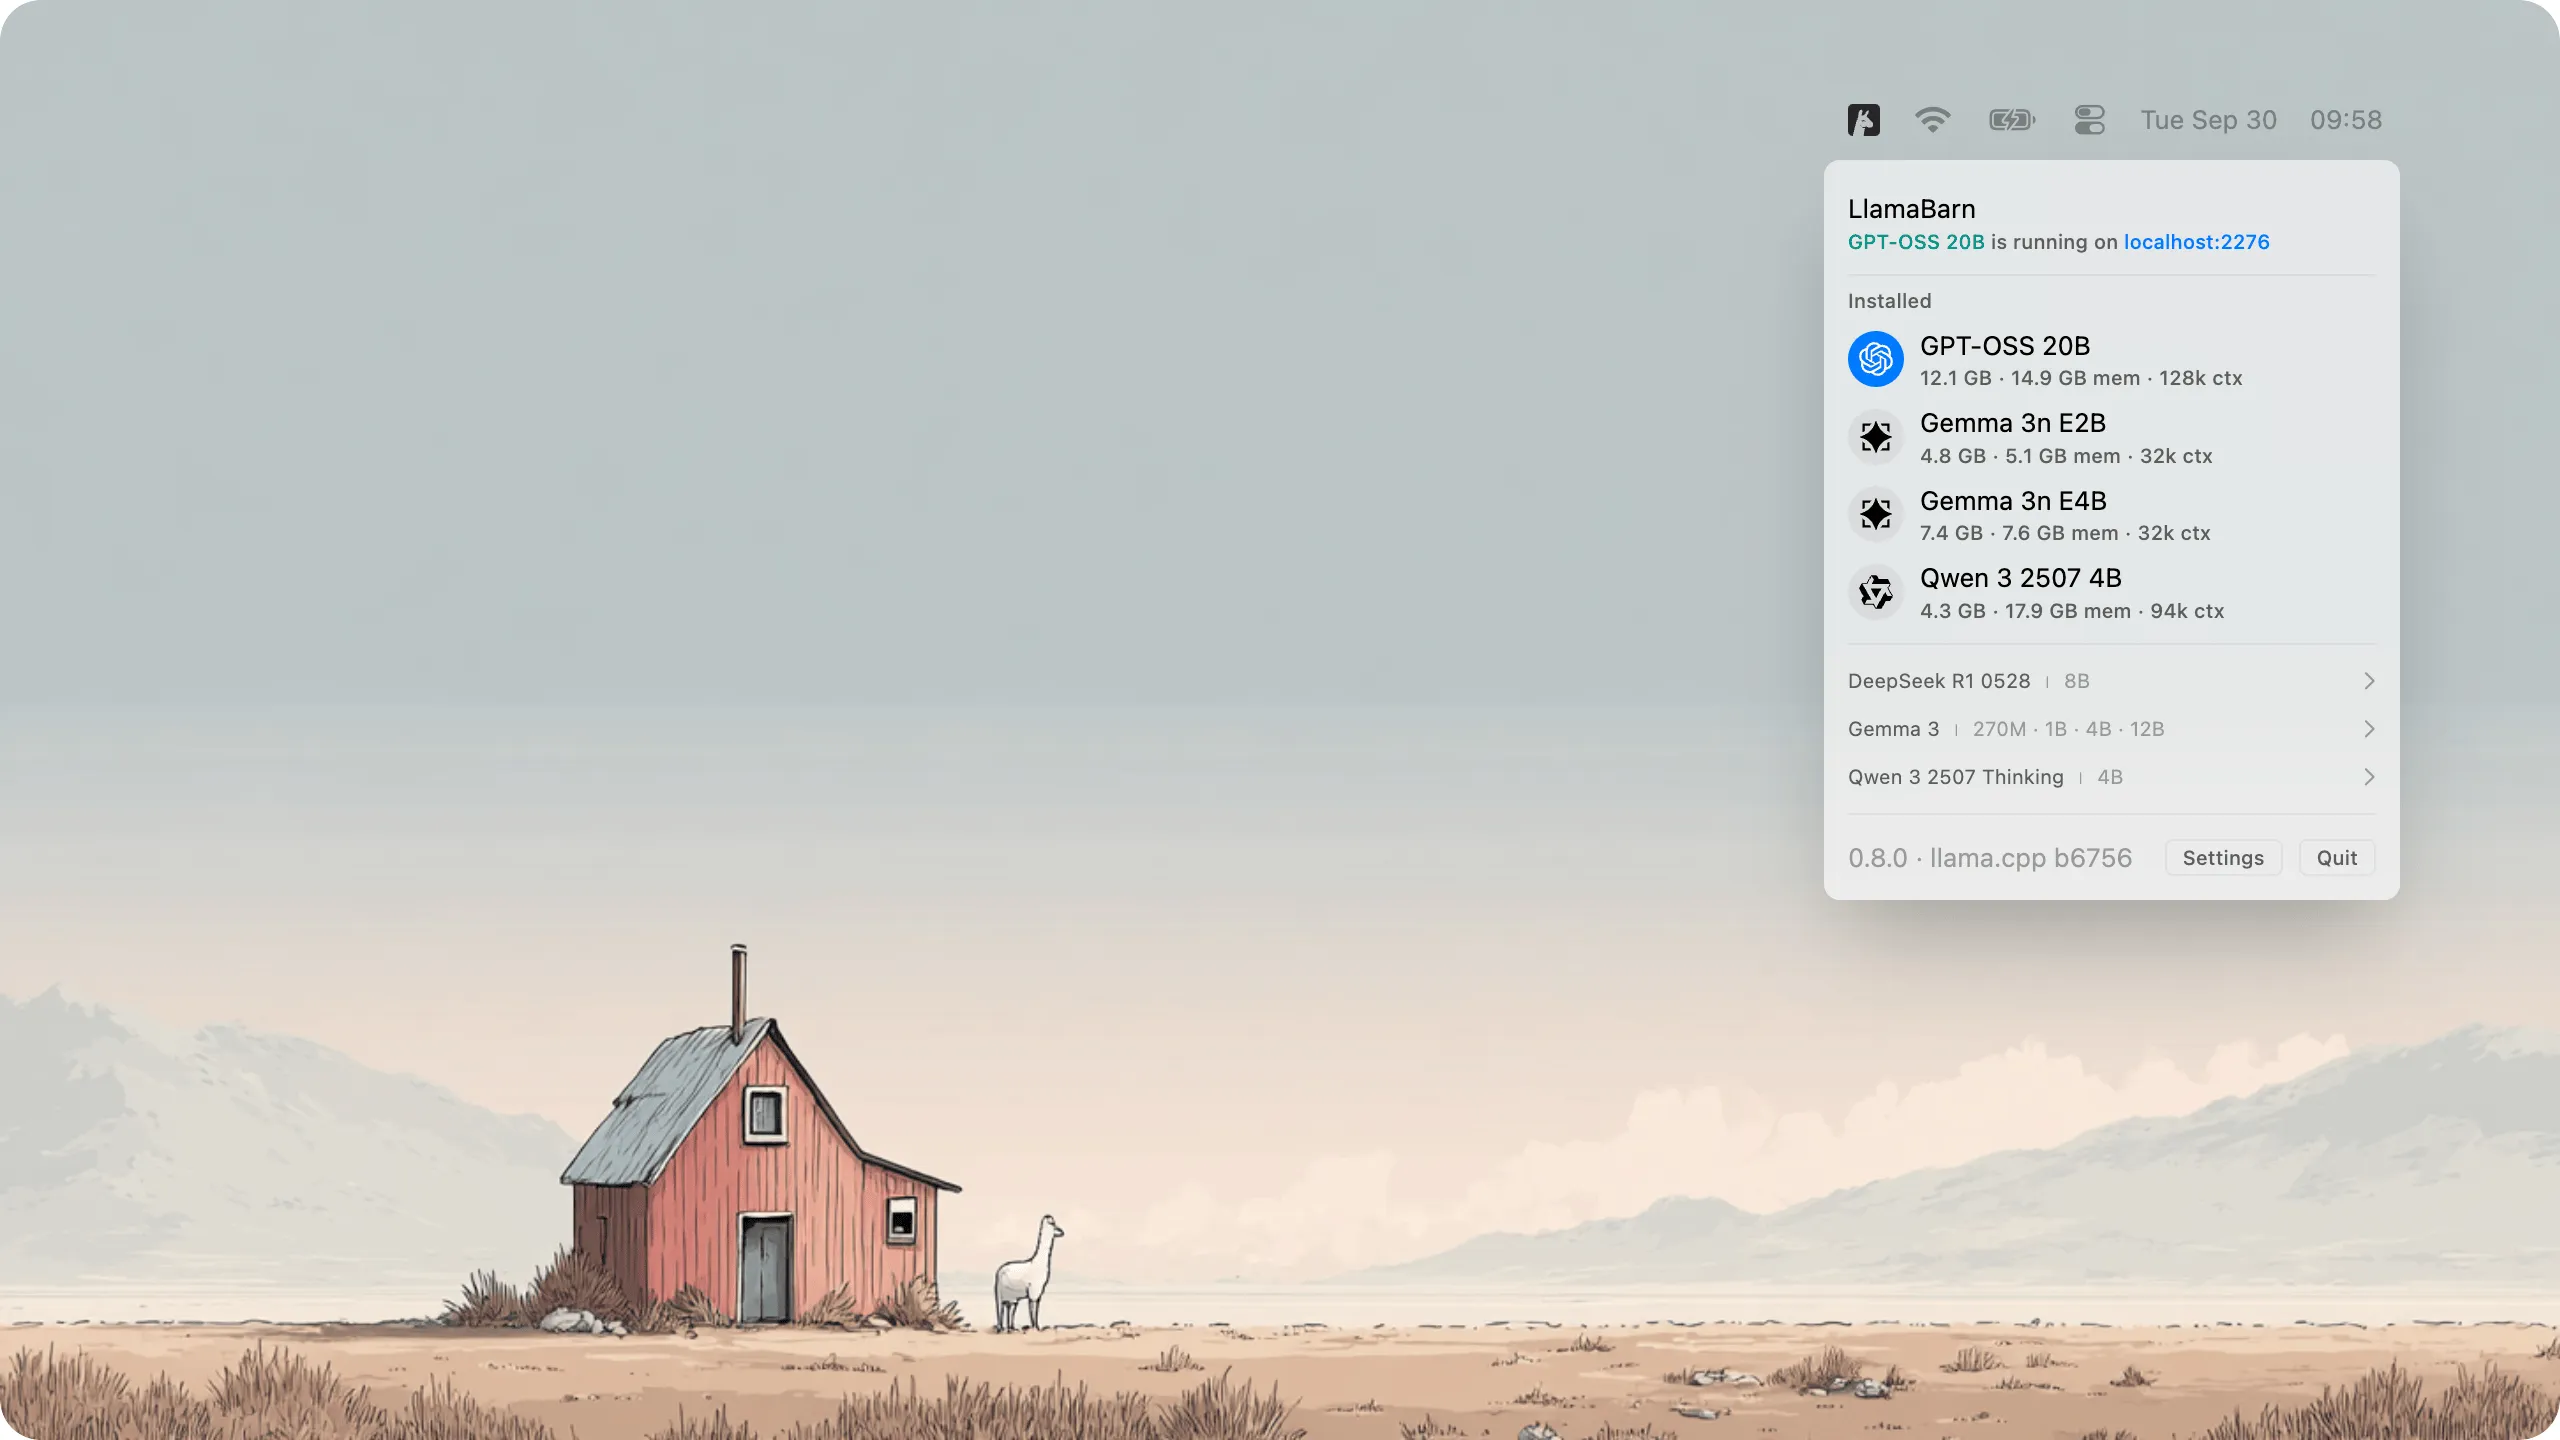
LlamaBarn irá automaticamente lidar com o download do modelo, otimização para seu hardware específico e então a execução real do modelo. Ele iniciará um servidor compatível com a biblioteca API OpenAI para você usar em seu código, e também iniciará a nova UI web mencionada acima.
Se você está executando modelos localmente em seu Mac agora com ferramentas como Ollama, LMStudio, Jan ou quaisquer outras, eu recomendaria fortemente mudar para Llama.cpp, pois é o que todas essas outras ferramentas estão usando por baixo dos panos. Ao usar Llama.cpp você estará obtendo a experiência de primeira mão de executar esses modelos, sem nenhum do inchaço ou “ajustes de desempenho” que degradam a qualidade do modelo que as outras bibliotecas fornecem.
Destaques Rápidos
Atualizações do OpenAI Codex
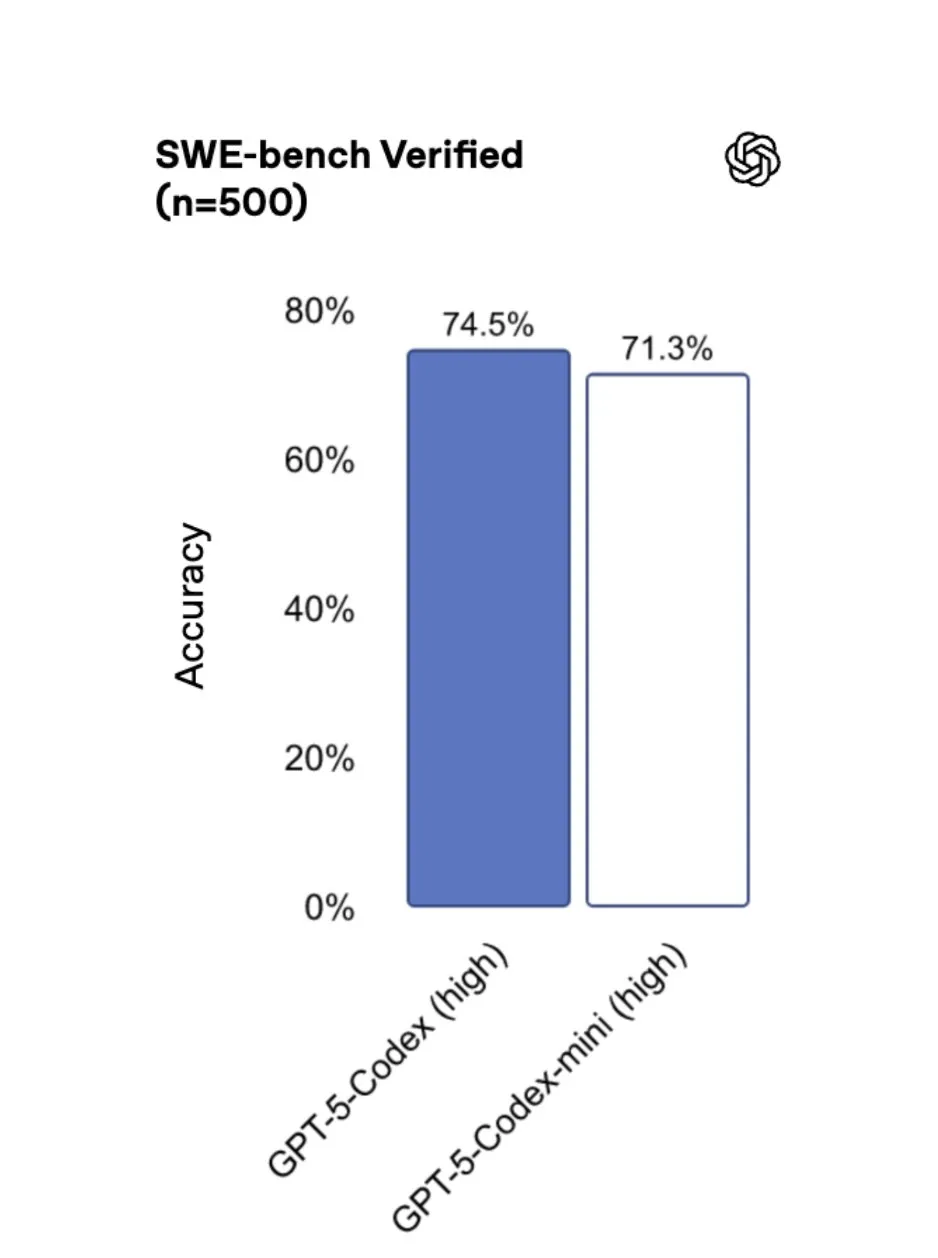
OpenAI lançou algumas atualizações para sua plataforma de codificação Codex, mais notavelmente aumentando os limites de taxa em 50% e lançando GPT 5 Codex Mini, que usa limites de taxa metade da velocidade do modelo Codex regular, e também é visivelmente mais rápido.
Cientista de IA que pode trabalhar por dias
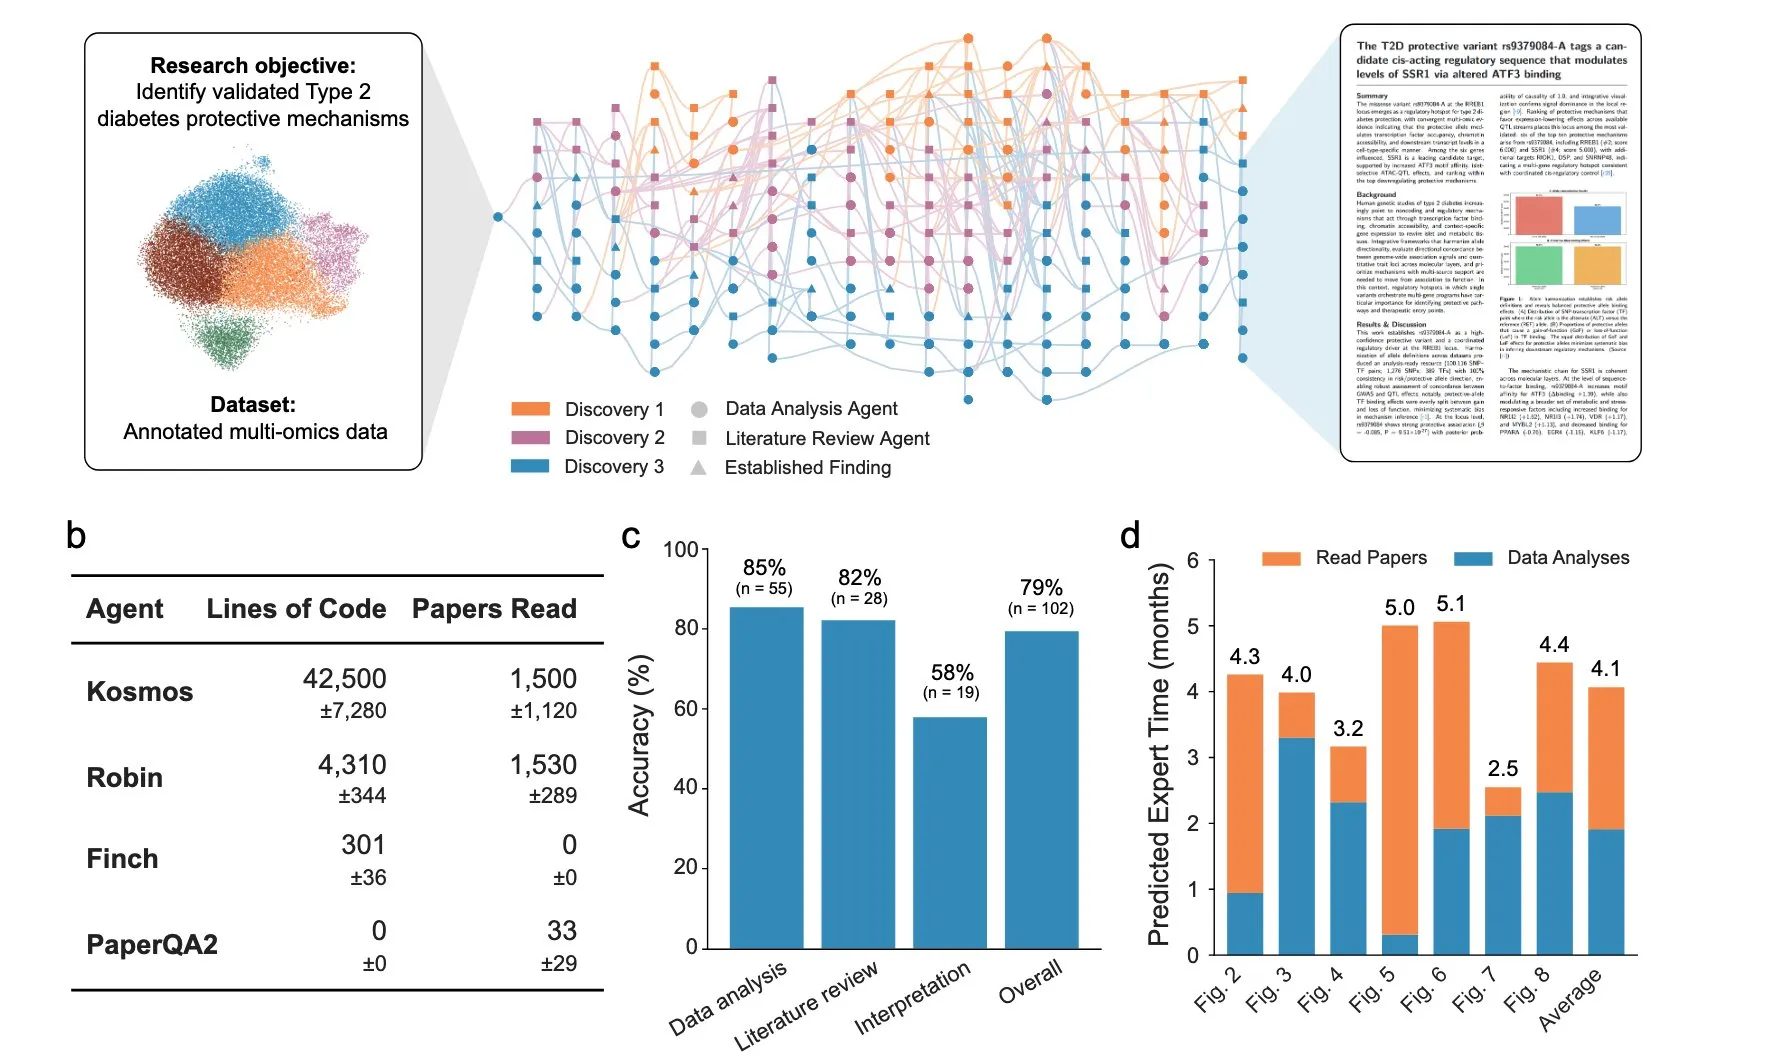
Uma empresa chamada Edison Scientific lançou um sistema de agentes que eles dizem poder executar por dias a fio.
Eles dizem que já escreveu 7 artigos sobre tópicos únicos, previamente desconhecidos/inexplorados, e que sua taxa de sucesso é de 80%. Eles também incluem um artigo documentando como funciona.
Você pode usá-lo agora gratuitamente se tiver um e-mail acadêmico (você recebe 3 consultas). Depois disso custará $200 por execução.
ComfyUI cloud
A popular plataforma de geração de imagens e vídeos ComfyUI lançou um plano de computação mensal que dá aos usuários 8 horas de GPU A100 40GB por dia para gerar imagens e vídeos.
Se você é um usuário avançado, startup que tem workflows personalizados que deseja executar, ou queria usar ComfyUI mas não tinha a computação necessária para isso, esta é a opção mais econômica para usar agora.
Conclusão
Espero que você tenha gostado das notícias desta semana. Se você quer receber as notícias toda semana, certifique-se de se juntar à nossa lista de e-mails abaixo.