
Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
GPT 5.4 Mini y Nano
OpenAI ha descuidado la actualización de sus modelos más pequeños, GPT Mini y Nano, durante las últimas 3 versiones. Esta semana finalmente obtuvimos una actualización para ellos con el lanzamiento de GPT 5.4 Mini y Nano.
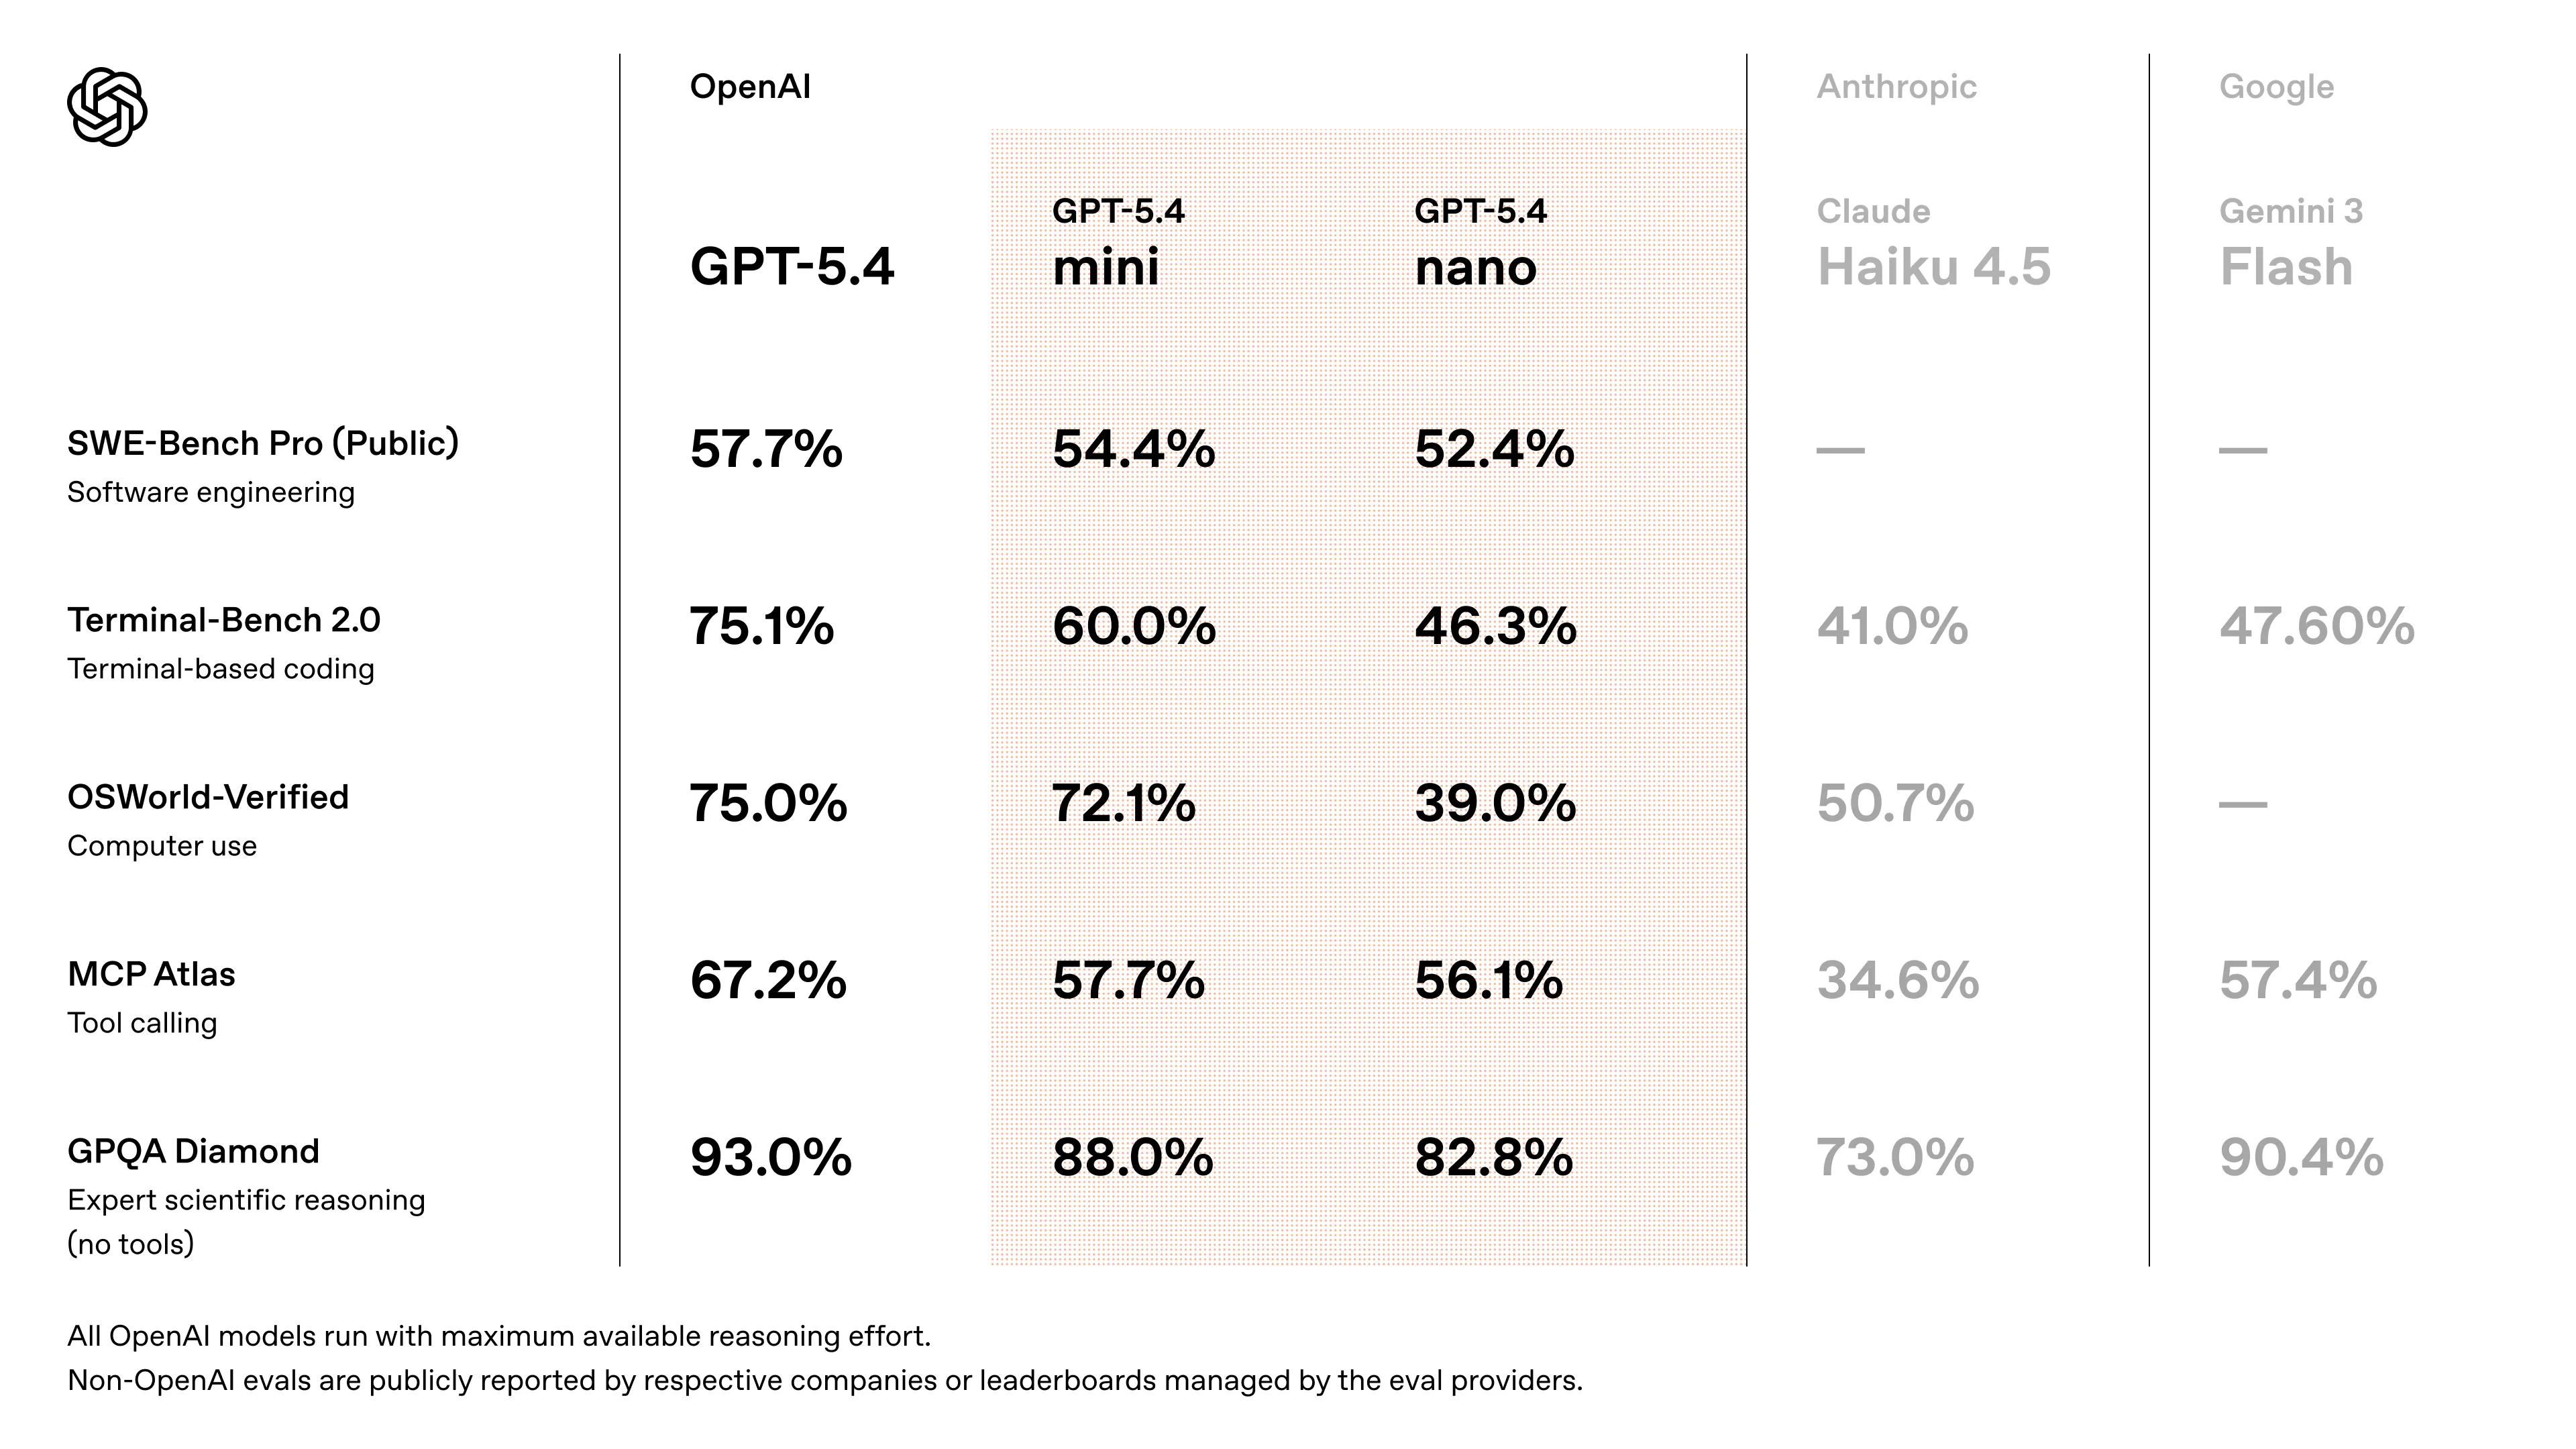
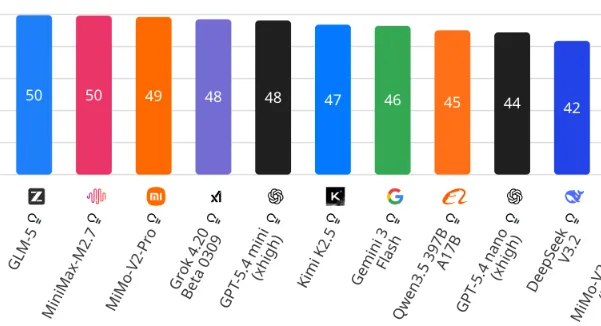
El modelo mini (al usar razonamiento extra alto) se sitúa cerca de Gemini 3 Flash y los modelos frontera chinos en términos de capacidades de benchmark. El problema es que cuando el razonamiento está tan elevado, la cantidad de tokens utilizados empieza a volverse ridícula.
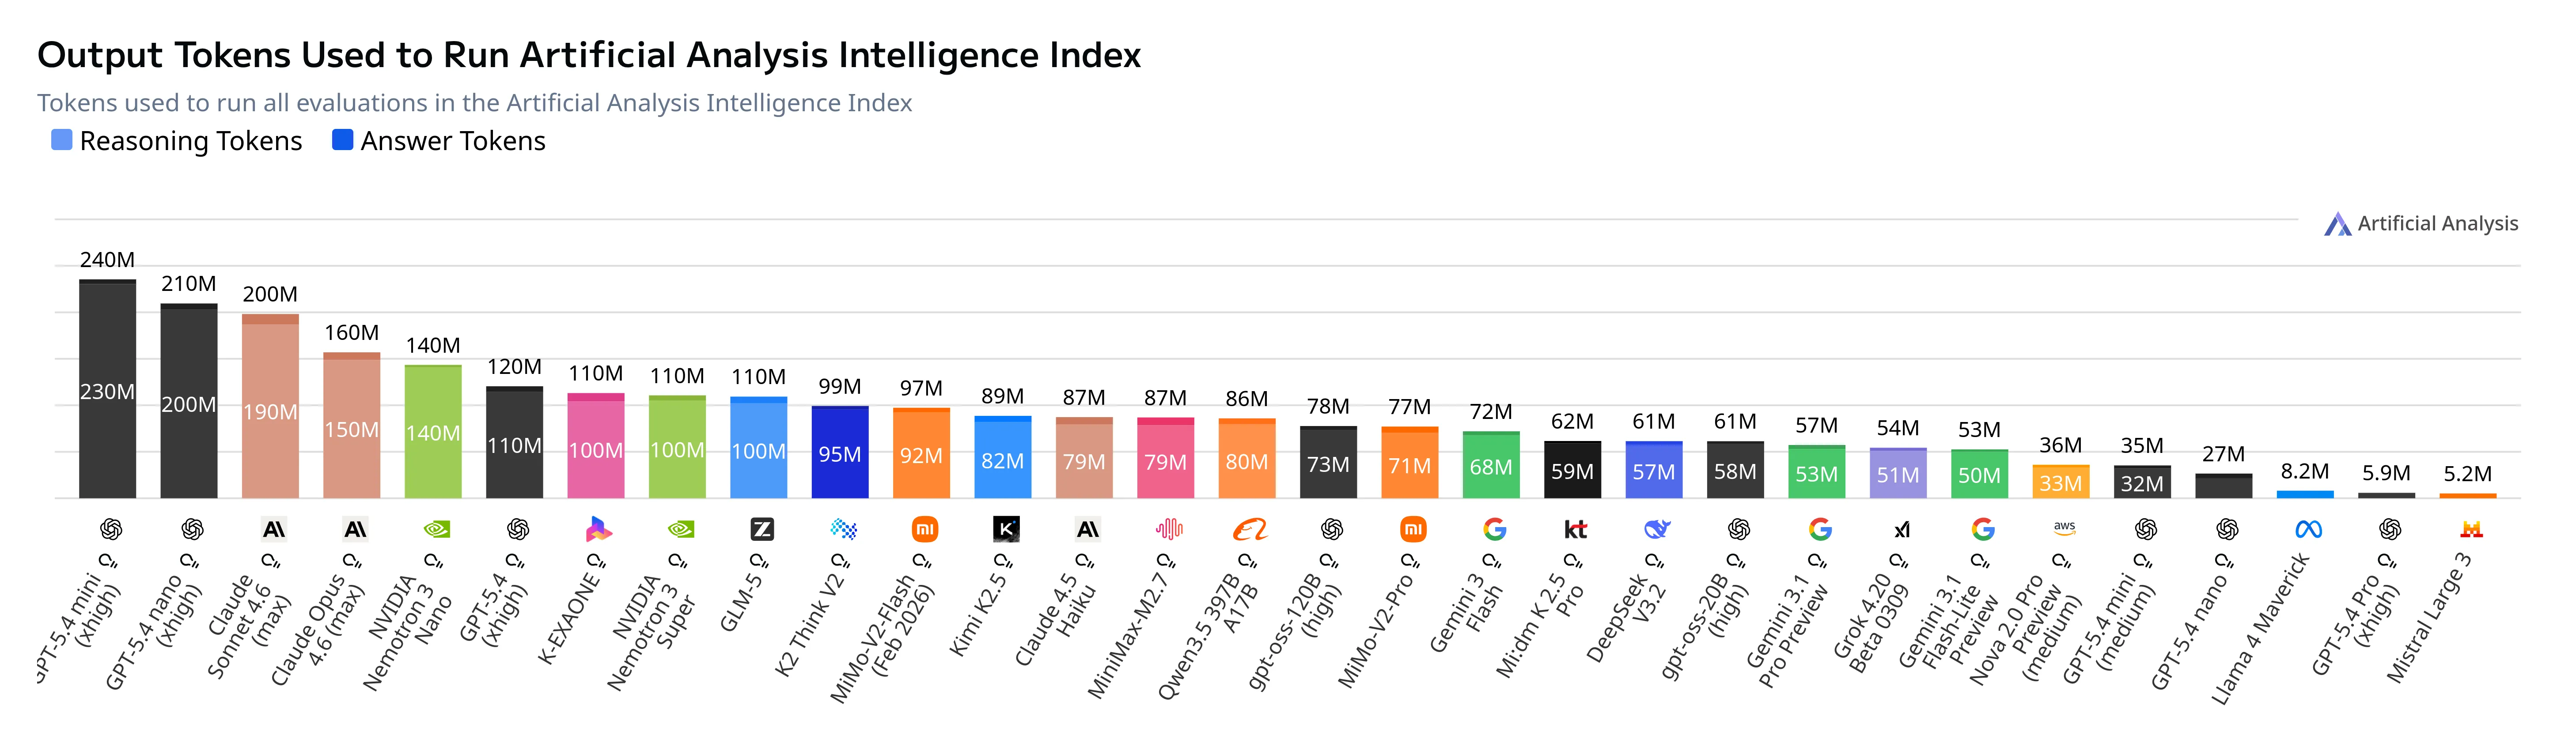
Con un razonamiento medio más sensato, los modelos rinden notablemente peor que sus contrapartes en la categoría de modelos “baratos pero buenos”.
Esta brecha se agrava aún más cuando se observa el precio de estos modelos “asequibles” de OpenAI, que han ~duplicado su precio en comparación con los modelos GPT 5 Mini y Nano.
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| GPT 5.4 | $2.50 | $15 | 50 |
| GPT 5.4 Mini | $0.75 | $4.5 | 62 |
| GPT 5.4 Nano | $0.20 | $1.25 | 57 |
| Claude Sonnet 4.6 | $3 | $15 | 37 |
| Gemini 3 Flash | $0.50 | $3 | 80 |
| GLM 5 | $1 | $3.20 | 30 |
| MiniMax M2.7 | $0.30 | $1.20 | 34 |
GPT 5.4 Mini usa 3 veces más tokens por pregunta para tener el mismo rendimiento que MiniMax M2.7, siendo además 3 veces más caro (sin contar los costos adicionales de 3 veces más tokens). Esto también significa que, aunque parezca 2 veces más rápido en tokens por segundo, en realidad es un 50% más lento para generar una respuesta.
Por todo esto, mi recomendación es evitar estos modelos en general, ya que se pueden obtener mejores modelos de otros proveedores nacionales (Gemini 3 Flash) o de laboratorios chinos.
Esto también plantea la pregunta: ¿realmente está OpenAI tan por delante? ¿O simplemente han escalado sus modelos más que los laboratorios chinos, dado que parece que en la categoría de menos de 1 billón de parámetros los modelos abiertos están igualando o incluso superando lo que OpenAI puede hacer?
MiniMax M2.7
Hablando de laboratorios chinos, hablemos del nuevo modelo de MiniMax que mencionamos antes.
MiniMax M2.7 se basa en su popular y rentable modelo anterior M2.5, siendo un modelo de mezcla de expertos relativamente ligero de 220B parámetros. A diferencia de OpenAI, no están aumentando el precio del modelo debido a su mayor rendimiento.
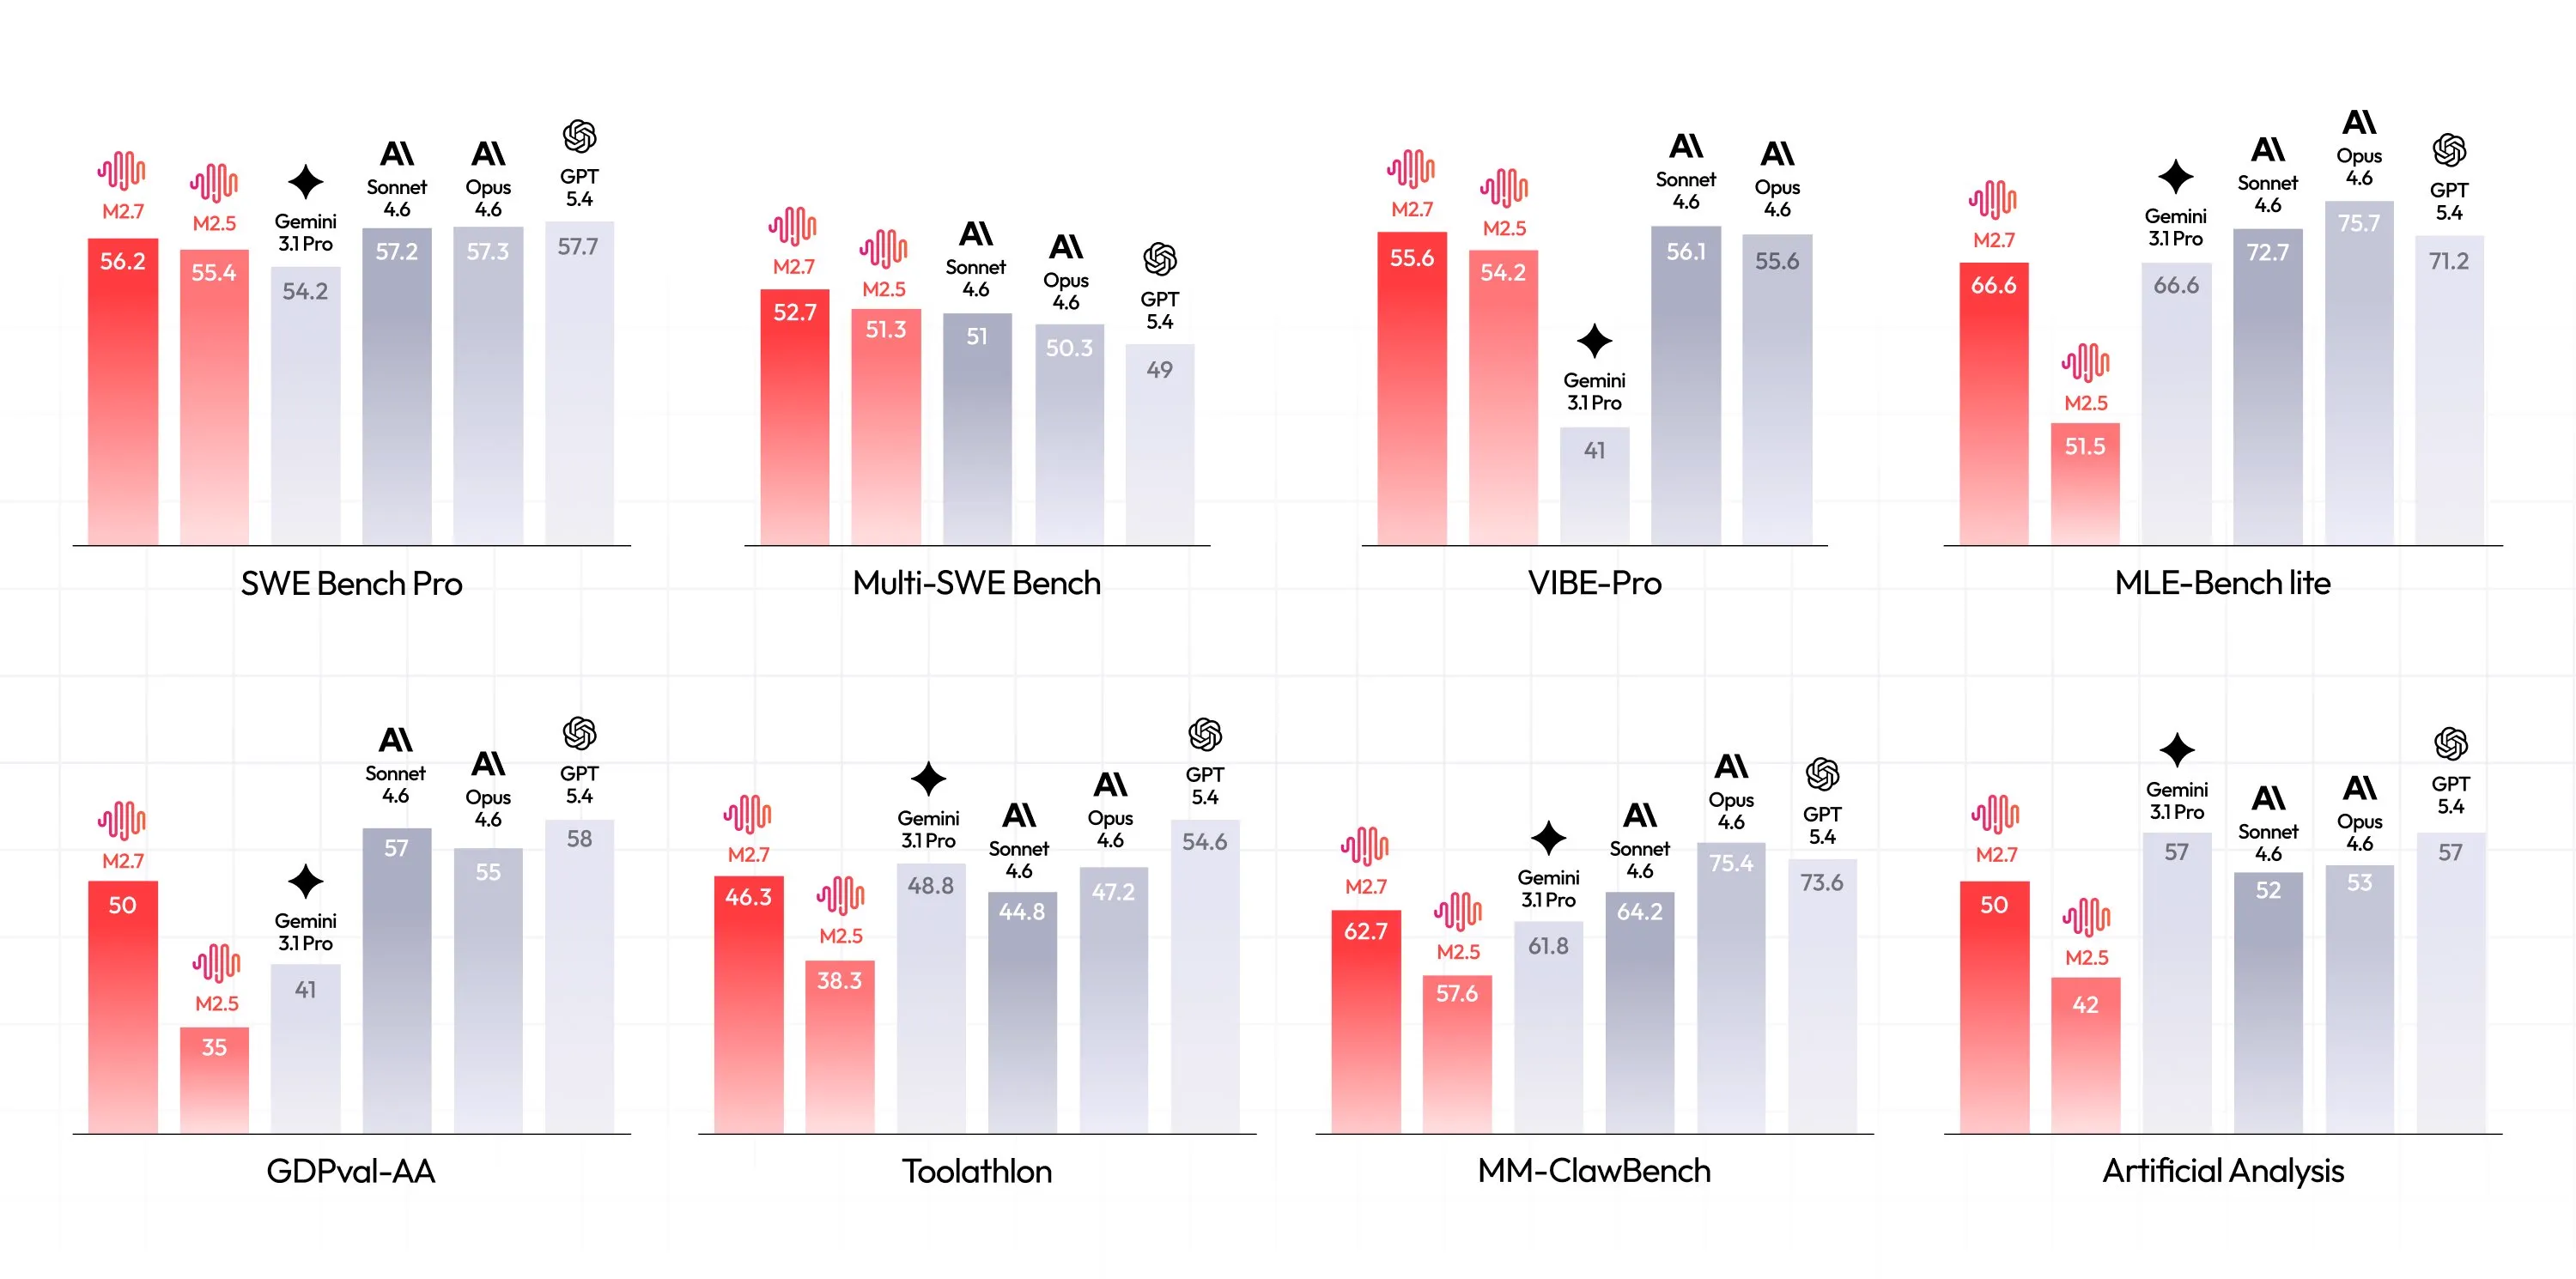
De manera similar a GPT 5.3 Codex, M2.7 fue utilizado para ayudar a construirse a sí mismo, con un checkpoint temprano ayudando en el 30-50% de los flujos de trabajo del equipo de aprendizaje por refuerzo, destacando sus capacidades para programación y tareas agentivas generales.
También han trabajado en el carácter y la personalidad del modelo, haciéndolo mucho más agradable para conversar. No creo que esté al mismo nivel de personalidad que Claude o Kimi, pero está justo por debajo de ellos y parecen estar dando grandes pasos.
Gracias a las mejoras en las capacidades agentivas, la personalidad y el muy bajo costo, probablemente sea el mejor modelo para usar con OpenClaw (ver tabla de precios arriba). Si eres un usuario avanzado, o simplemente prefieres un plan de suscripción mensual en lugar de usar la API, tienen un plan de $10/mes que te da 1500 solicitudes cada 5 horas (4 solicitudes por minuto).
Si buscas un modelo agentivo potente y rentable, MiniMax M2.7 parece ser la opción predilecta. Probablemente lo usaré como mi opción predeterminada para proyectos agentivos de ahora en adelante, en lugar de Gemini 3 Flash.
Noticias Rápidas
Cursor Composer 2
Cursor lanzó su propio modelo de programación agentiva entrenado internamente, Composer 2.
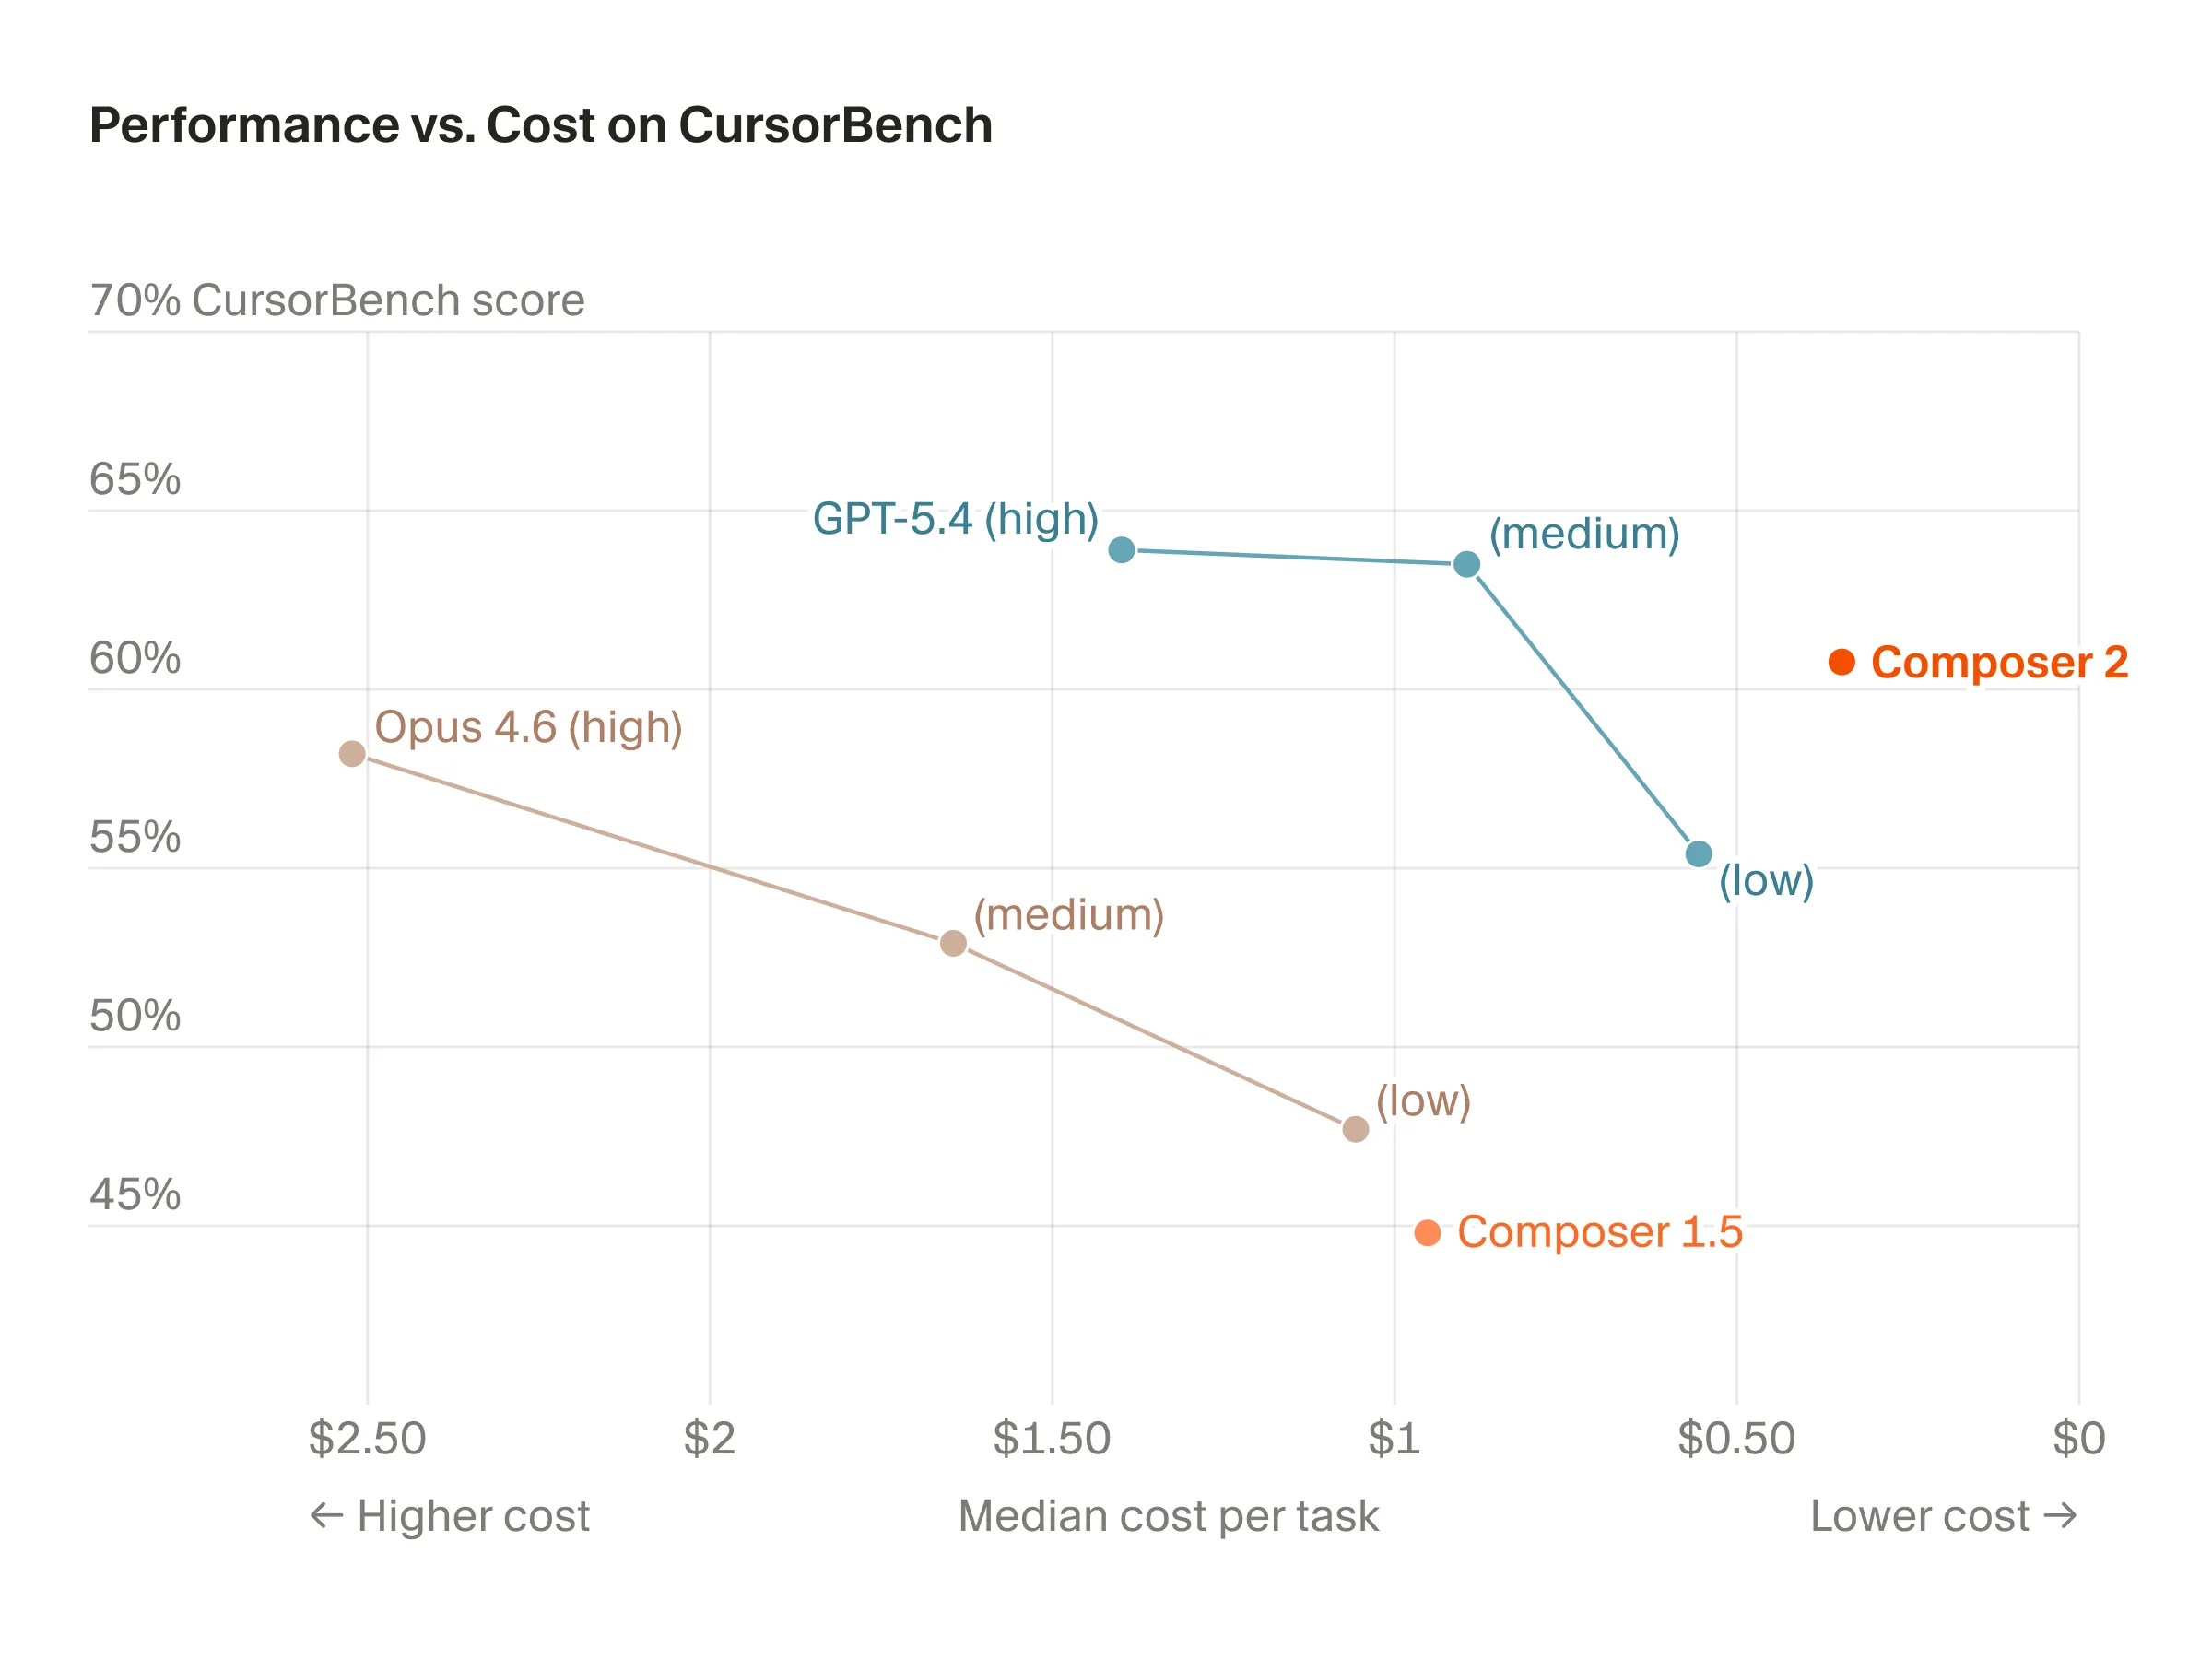
No entrenaron el modelo desde cero, sino que partieron de Kimi K2.5 como base, realizando preentrenamiento continuo sobre él y luego su propio ajuste fino. Esto fue algo polémico al principio, ya que no lo divulgaron, pero la comunidad pudo descubrirlo a partir de algunos nombres internos del modelo, y Cursor lo ha confirmado ellos mismos también.
Debido a todo el revuelo alrededor del modelo, he visto muy poco sobre sus capacidades hasta ahora (además, no tengo una suscripción a Cursor). Si la tienes, diría que lo pruebes: es muy barato (aunque solo accesible a través de Cursor, sin acceso por API) y algunos otros benchmarks que he visto parecen indicar que el modelo es bastante decente.
Mistral 4 Small
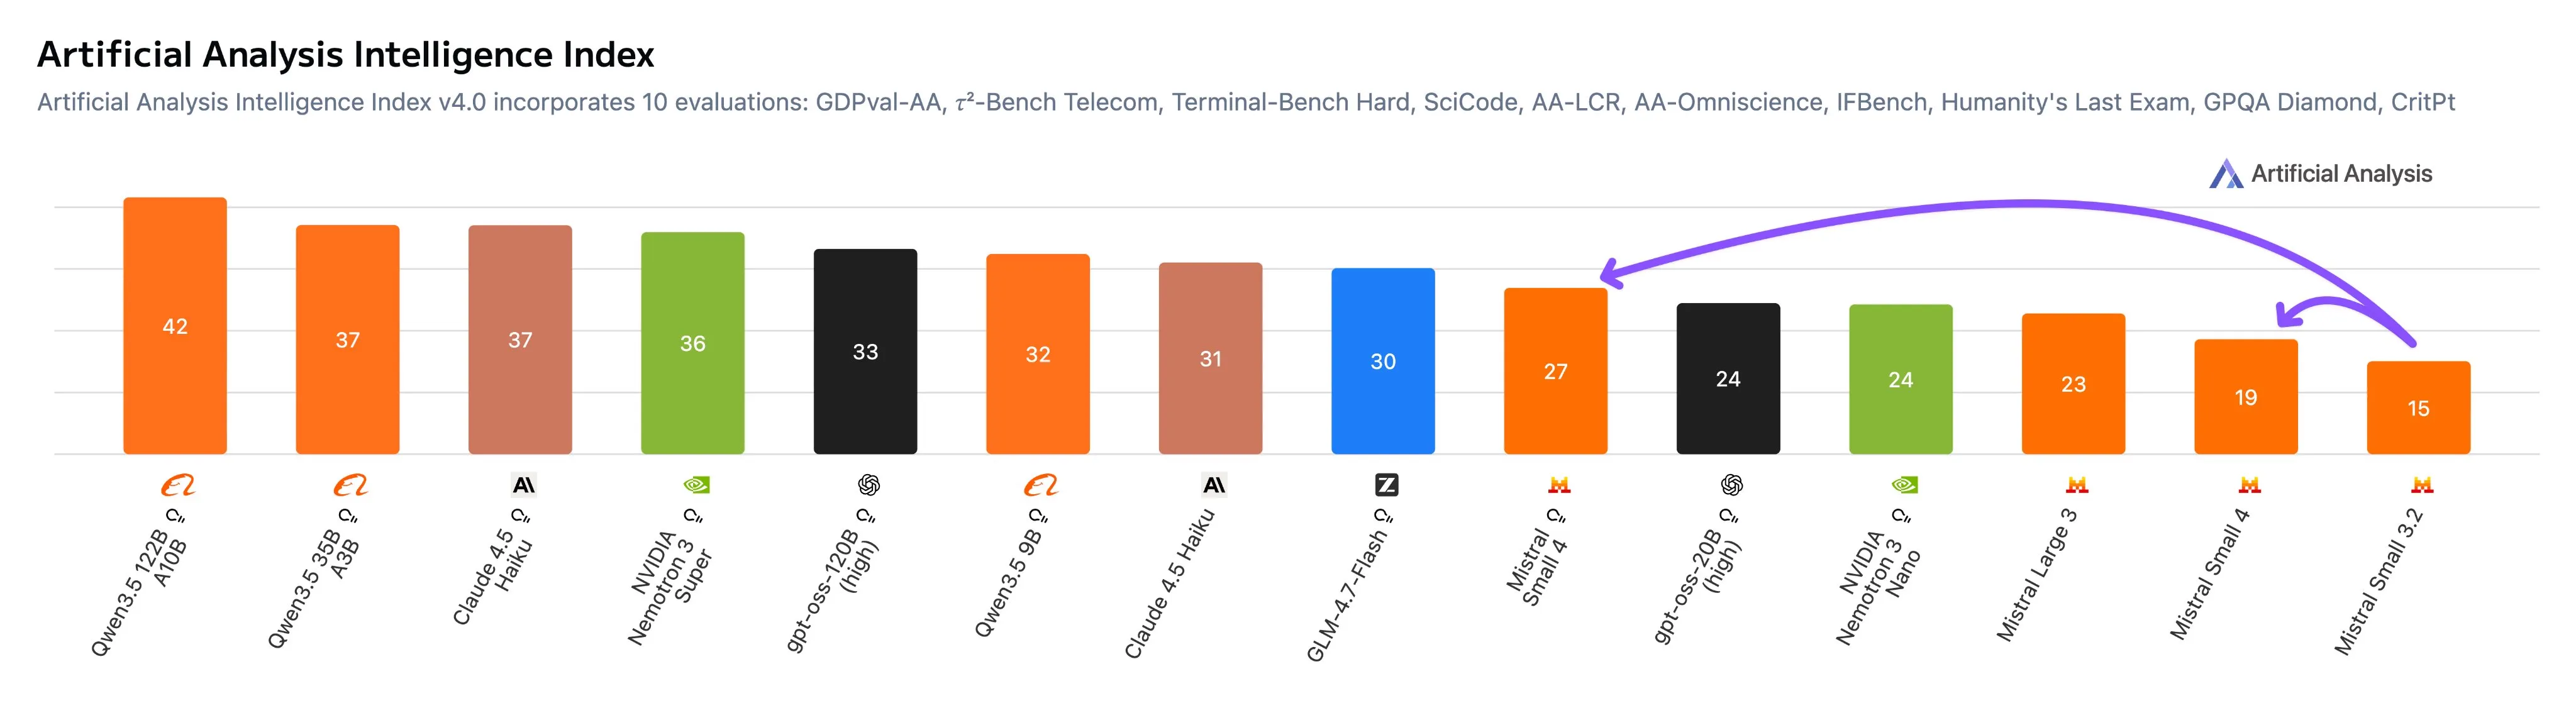
Mistral lanzó el primer modelo de su línea Mistral 4, llamado Mistral 4 Small. Es un modelo MoE de 110B parámetros, con 6.5B parámetros activos.
El nombre “small” es muy acertado, ya que es competitivo con los nuevos modelos Qwen3.5 Small. El único detalle es que los modelos Qwen 3.5 son 100 veces más pequeños. Lamentablemente para Mistral, este modelo llega muy muerto, sin siquiera superar a modelos de la mitad de su tamaño de hace 3 meses.
Cierre
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.