
Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
GPT 5.4 Mini e Nano
A OpenAI negligenciou a atualização de seus modelos menores, o GPT Mini e o Nano, nas últimas 3 versões. Esta semana finalmente recebemos uma atualização para eles com o lançamento do GPT 5.4 Mini e Nano.
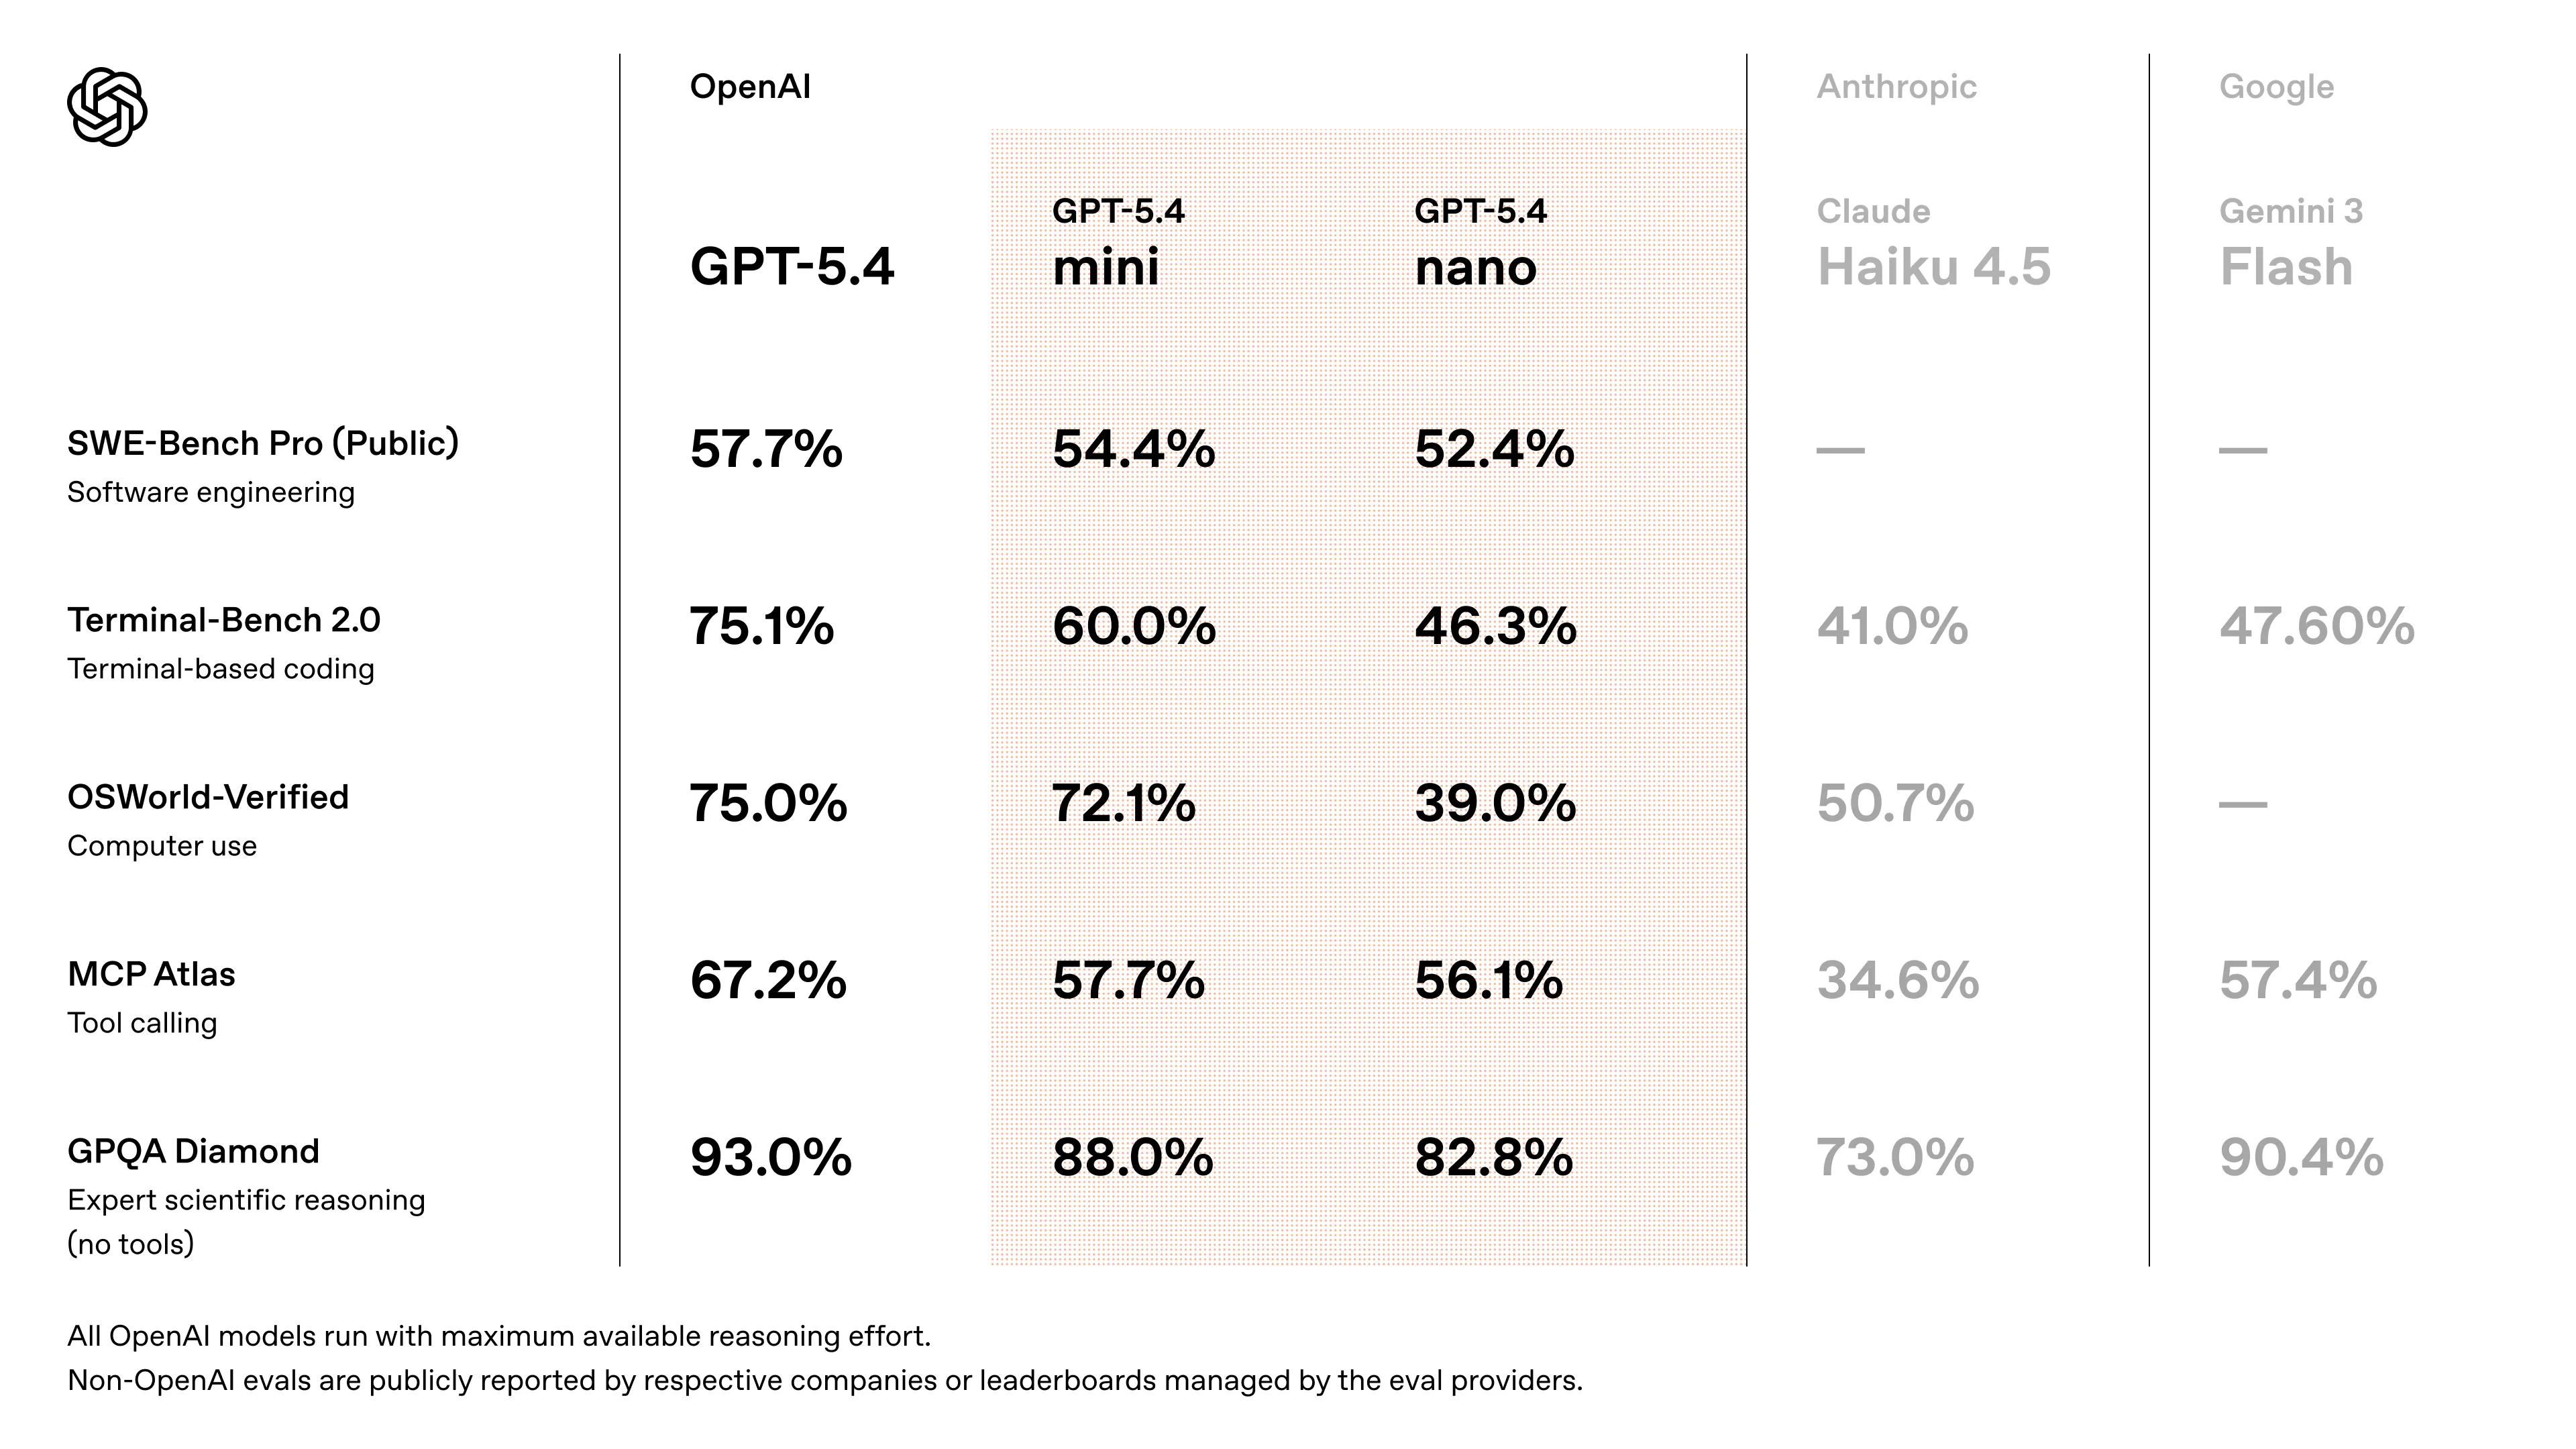
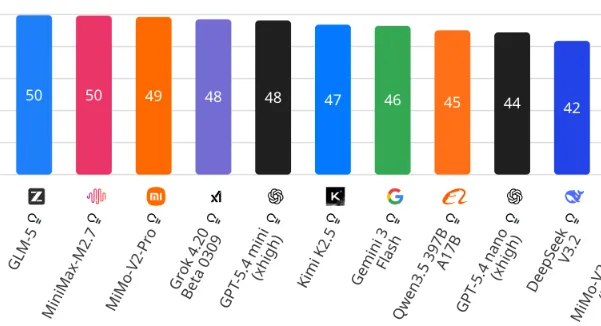
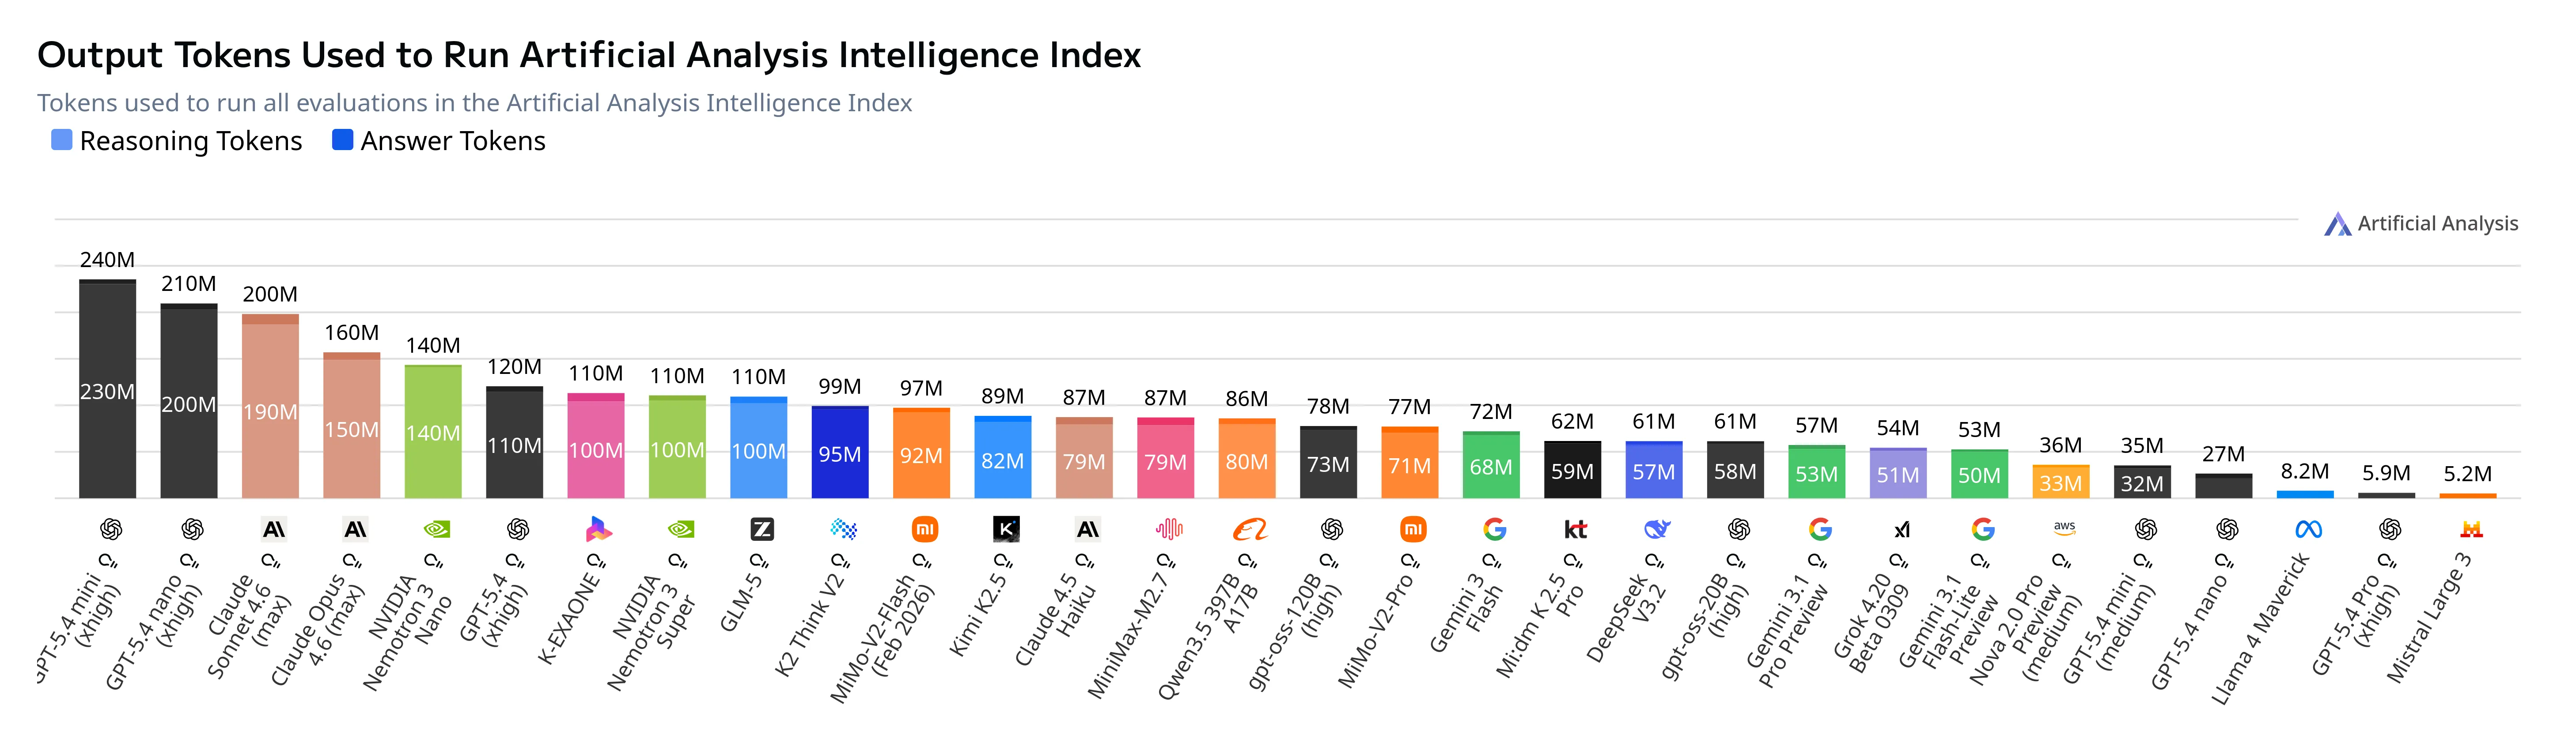
O modelo mini (com raciocínio extra elevado ativado) fica próximo do Gemini 3 Flash e dos modelos chineses de fronteira em termos de capacidades de benchmark. O problema é que quando o raciocínio está tão elevado, o número de tokens utilizados começa a ficar absurdo.
Com um nível de raciocínio médio mais sensato, os modelos apresentam desempenho visivelmente inferior ao de seus equivalentes na categoria de modelos “baratos, mas bons”.
Essa diferença é ainda maior quando se observa o preço desses modelos OpenAI “acessíveis”, que custam aproximadamente o dobro em relação aos modelos GPT 5 Mini e Nano.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| GPT 5.4 | $2,50 | $15 | 50 |
| GPT 5.4 Mini | $0,75 | $4,50 | 62 |
| GPT 5.4 Nano | $0,20 | $1,25 | 57 |
| Claude Sonnet 4.6 | $3 | $15 | 37 |
| Gemini 3 Flash | $0,50 | $3 | 80 |
| GLM 5 | $1 | $3,20 | 30 |
| MiniMax M2.7 | $0,30 | $1,20 | 34 |
O GPT 5.4 Mini usa 3x mais tokens por pergunta para ter o mesmo desempenho que o MiniMax M2.7, sendo 3x mais caro (sem contar os custos adicionais dos 3x mais tokens). Isso também significa que, embora pareça 2x mais rápido com base em tokens por segundo, na prática é 50% mais lento para gerar uma resposta.
Por causa disso, minha recomendação é evitar esses modelos em geral, já que você pode obter modelos melhores de outros provedores domésticos (Gemini 3 Flash) ou de laboratórios chineses.
Isso também levanta a questão: a OpenAI está realmente tão à frente? Ou será que eles apenas escalaram seus modelos mais do que os laboratórios chineses, já que parece que na categoria de menos de 1 trilhão de parâmetros os modelos abertos estão se mantendo ou até superando o que a OpenAI consegue fazer.
MiniMax M2.7
Falando em laboratórios chineses, vamos falar sobre o novo modelo da MiniMax que mencionamos anteriormente.
O MiniMax M2.7 aprimora o popular e eficiente modelo M2.5, sendo um modelo de mistura de especialistas relativamente leve com 220B de parâmetros. Ao contrário da OpenAI, eles não estão aumentando o preço do modelo por conta de seu desempenho superior.
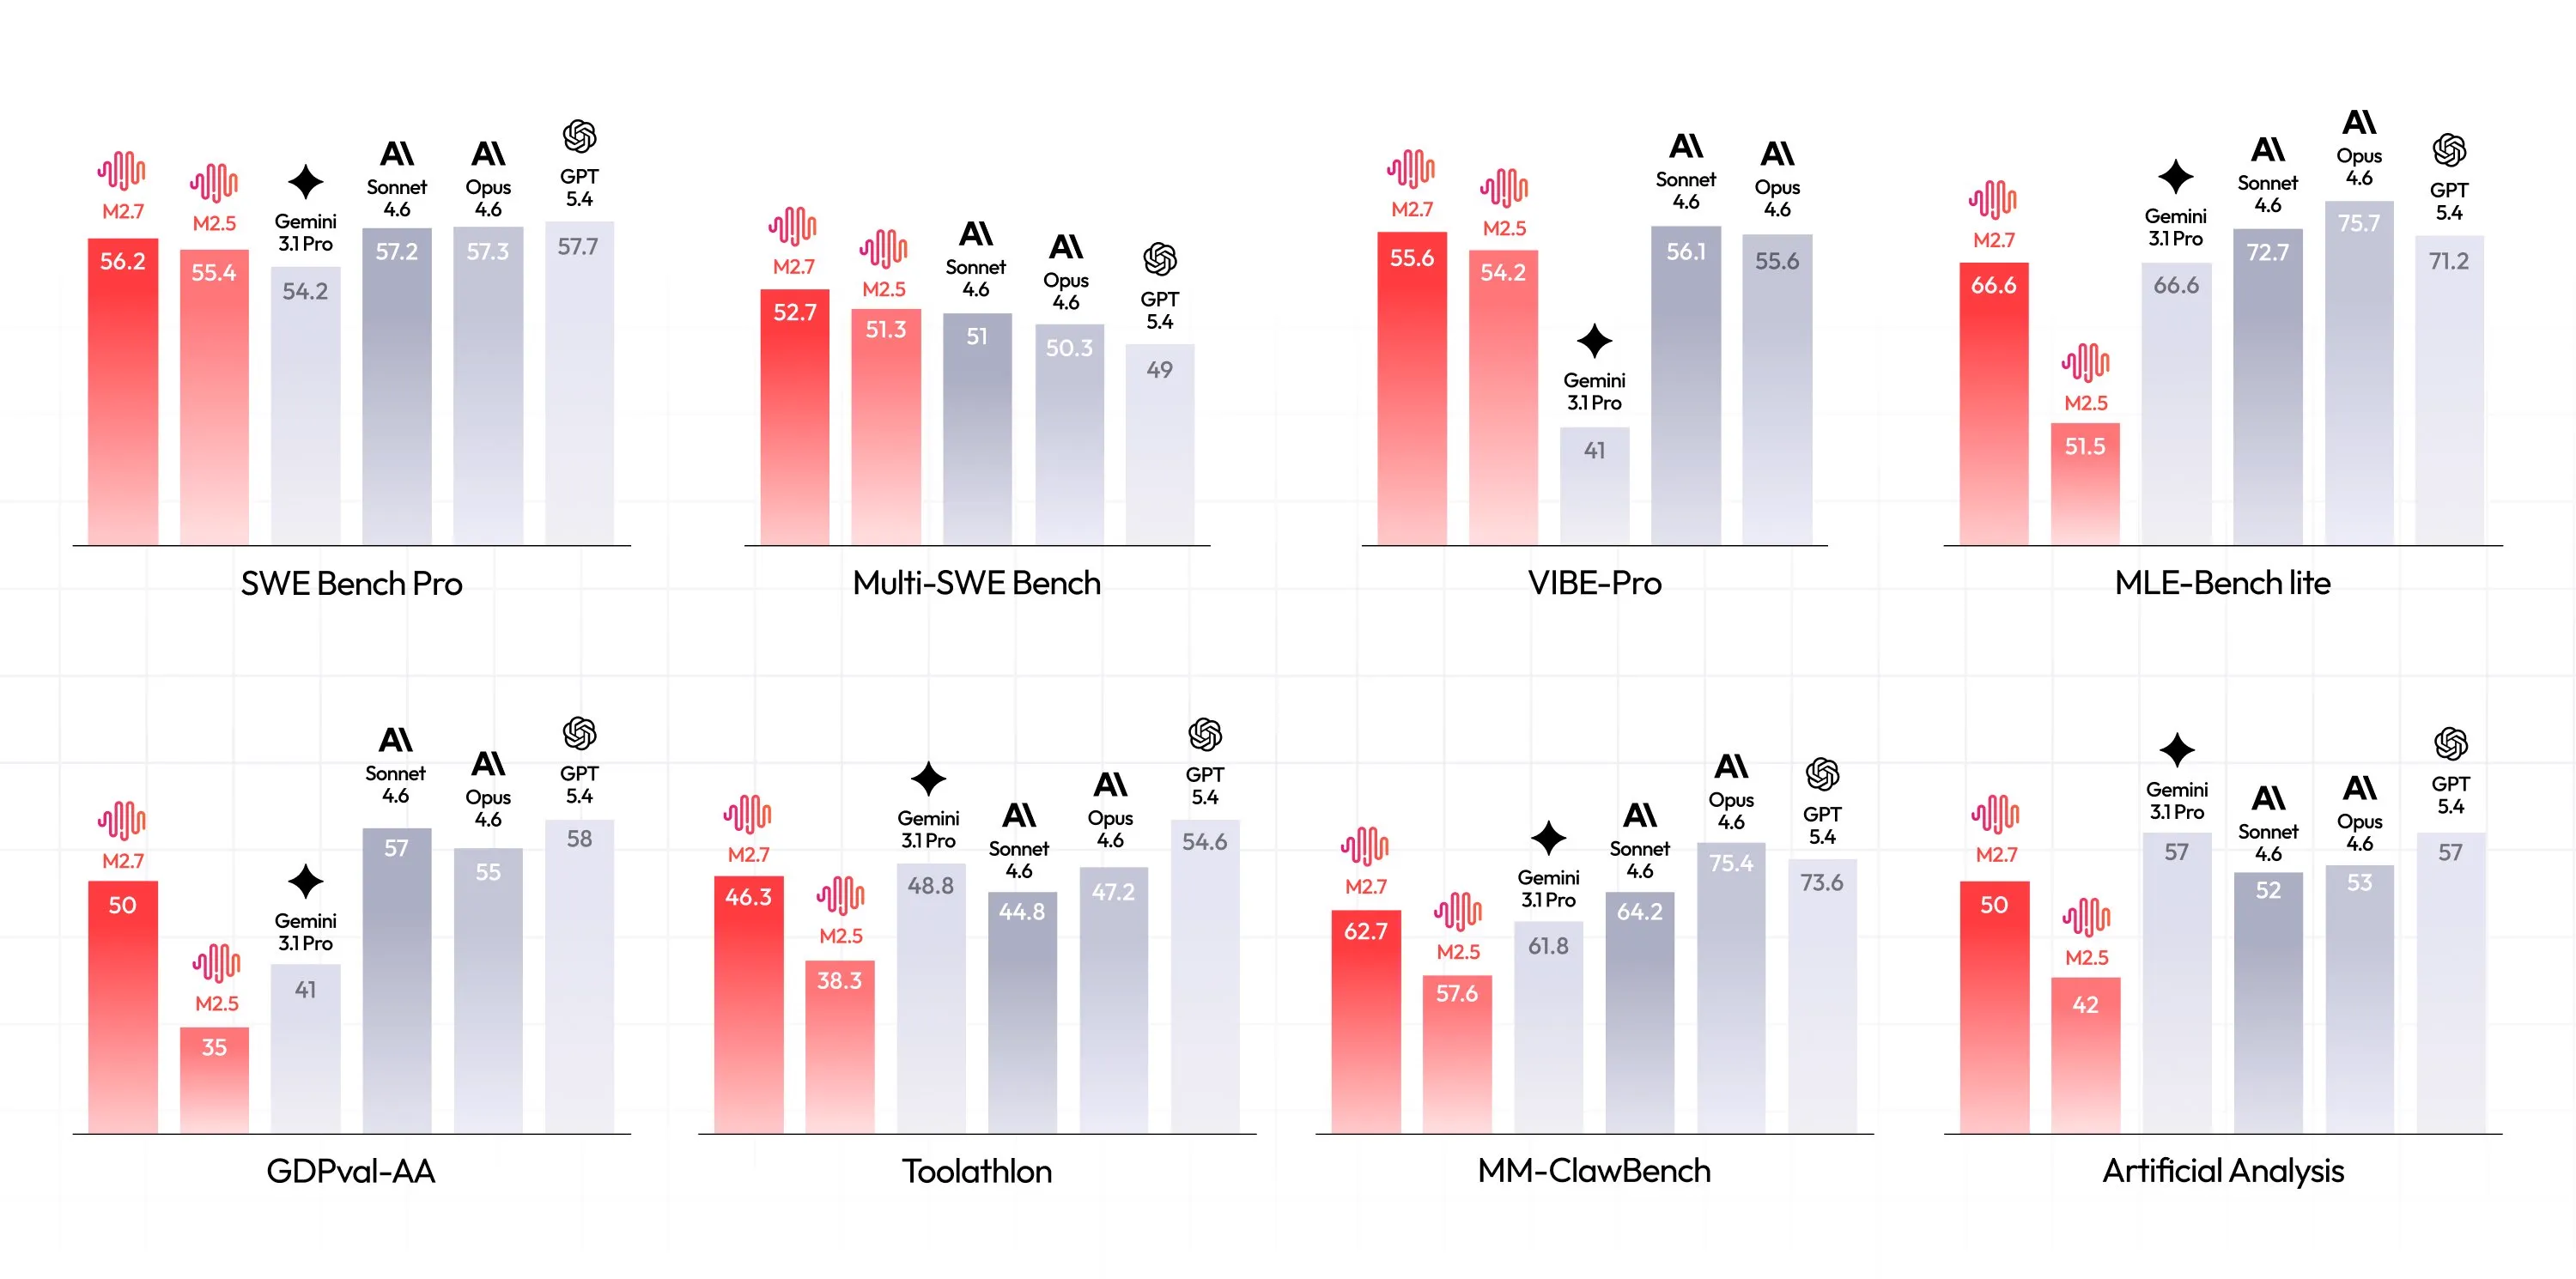
Semelhante ao GPT 5.3 Codex, o M2.7 foi utilizado para ajudar a construir a si mesmo, com um checkpoint inicial contribuindo com 30-50% dos fluxos de trabalho das equipes de aprendizado por reforço, destacando suas capacidades para programação e tarefas agênticas em geral.
Eles também trabalharam no caráter e na personalidade do modelo, tornando-o muito mais agradável para conversar. Não acho que ele esteja no mesmo nível de personalidade do Claude ou do Kimi, mas está logo abaixo deles e parece que estão avançando bastante.
Por causa das melhores capacidades agênticas, personalidade e custo muito baixo, é provavelmente o melhor modelo para usar com o OpenClaw (veja a tabela de preços acima). Se você é um usuário avançado, ou apenas prefere um plano de assinatura mensal em vez de usar a API, eles têm um plano de $10/mês que oferece 1500 requisições a cada 5 horas (4 requisições por minuto).
Se você quer um modelo agêntico robusto e econômico, o MiniMax M2.7 parece ser a melhor opção. Provavelmente vou usá-lo como meu padrão para projetos agênticos daqui para frente, em vez do Gemini 3 Flash.
Destaques Rápidos
Cursor Composer 2
A Cursor lançou seu próprio modelo de programação agêntica desenvolvido internamente, o Composer 2.
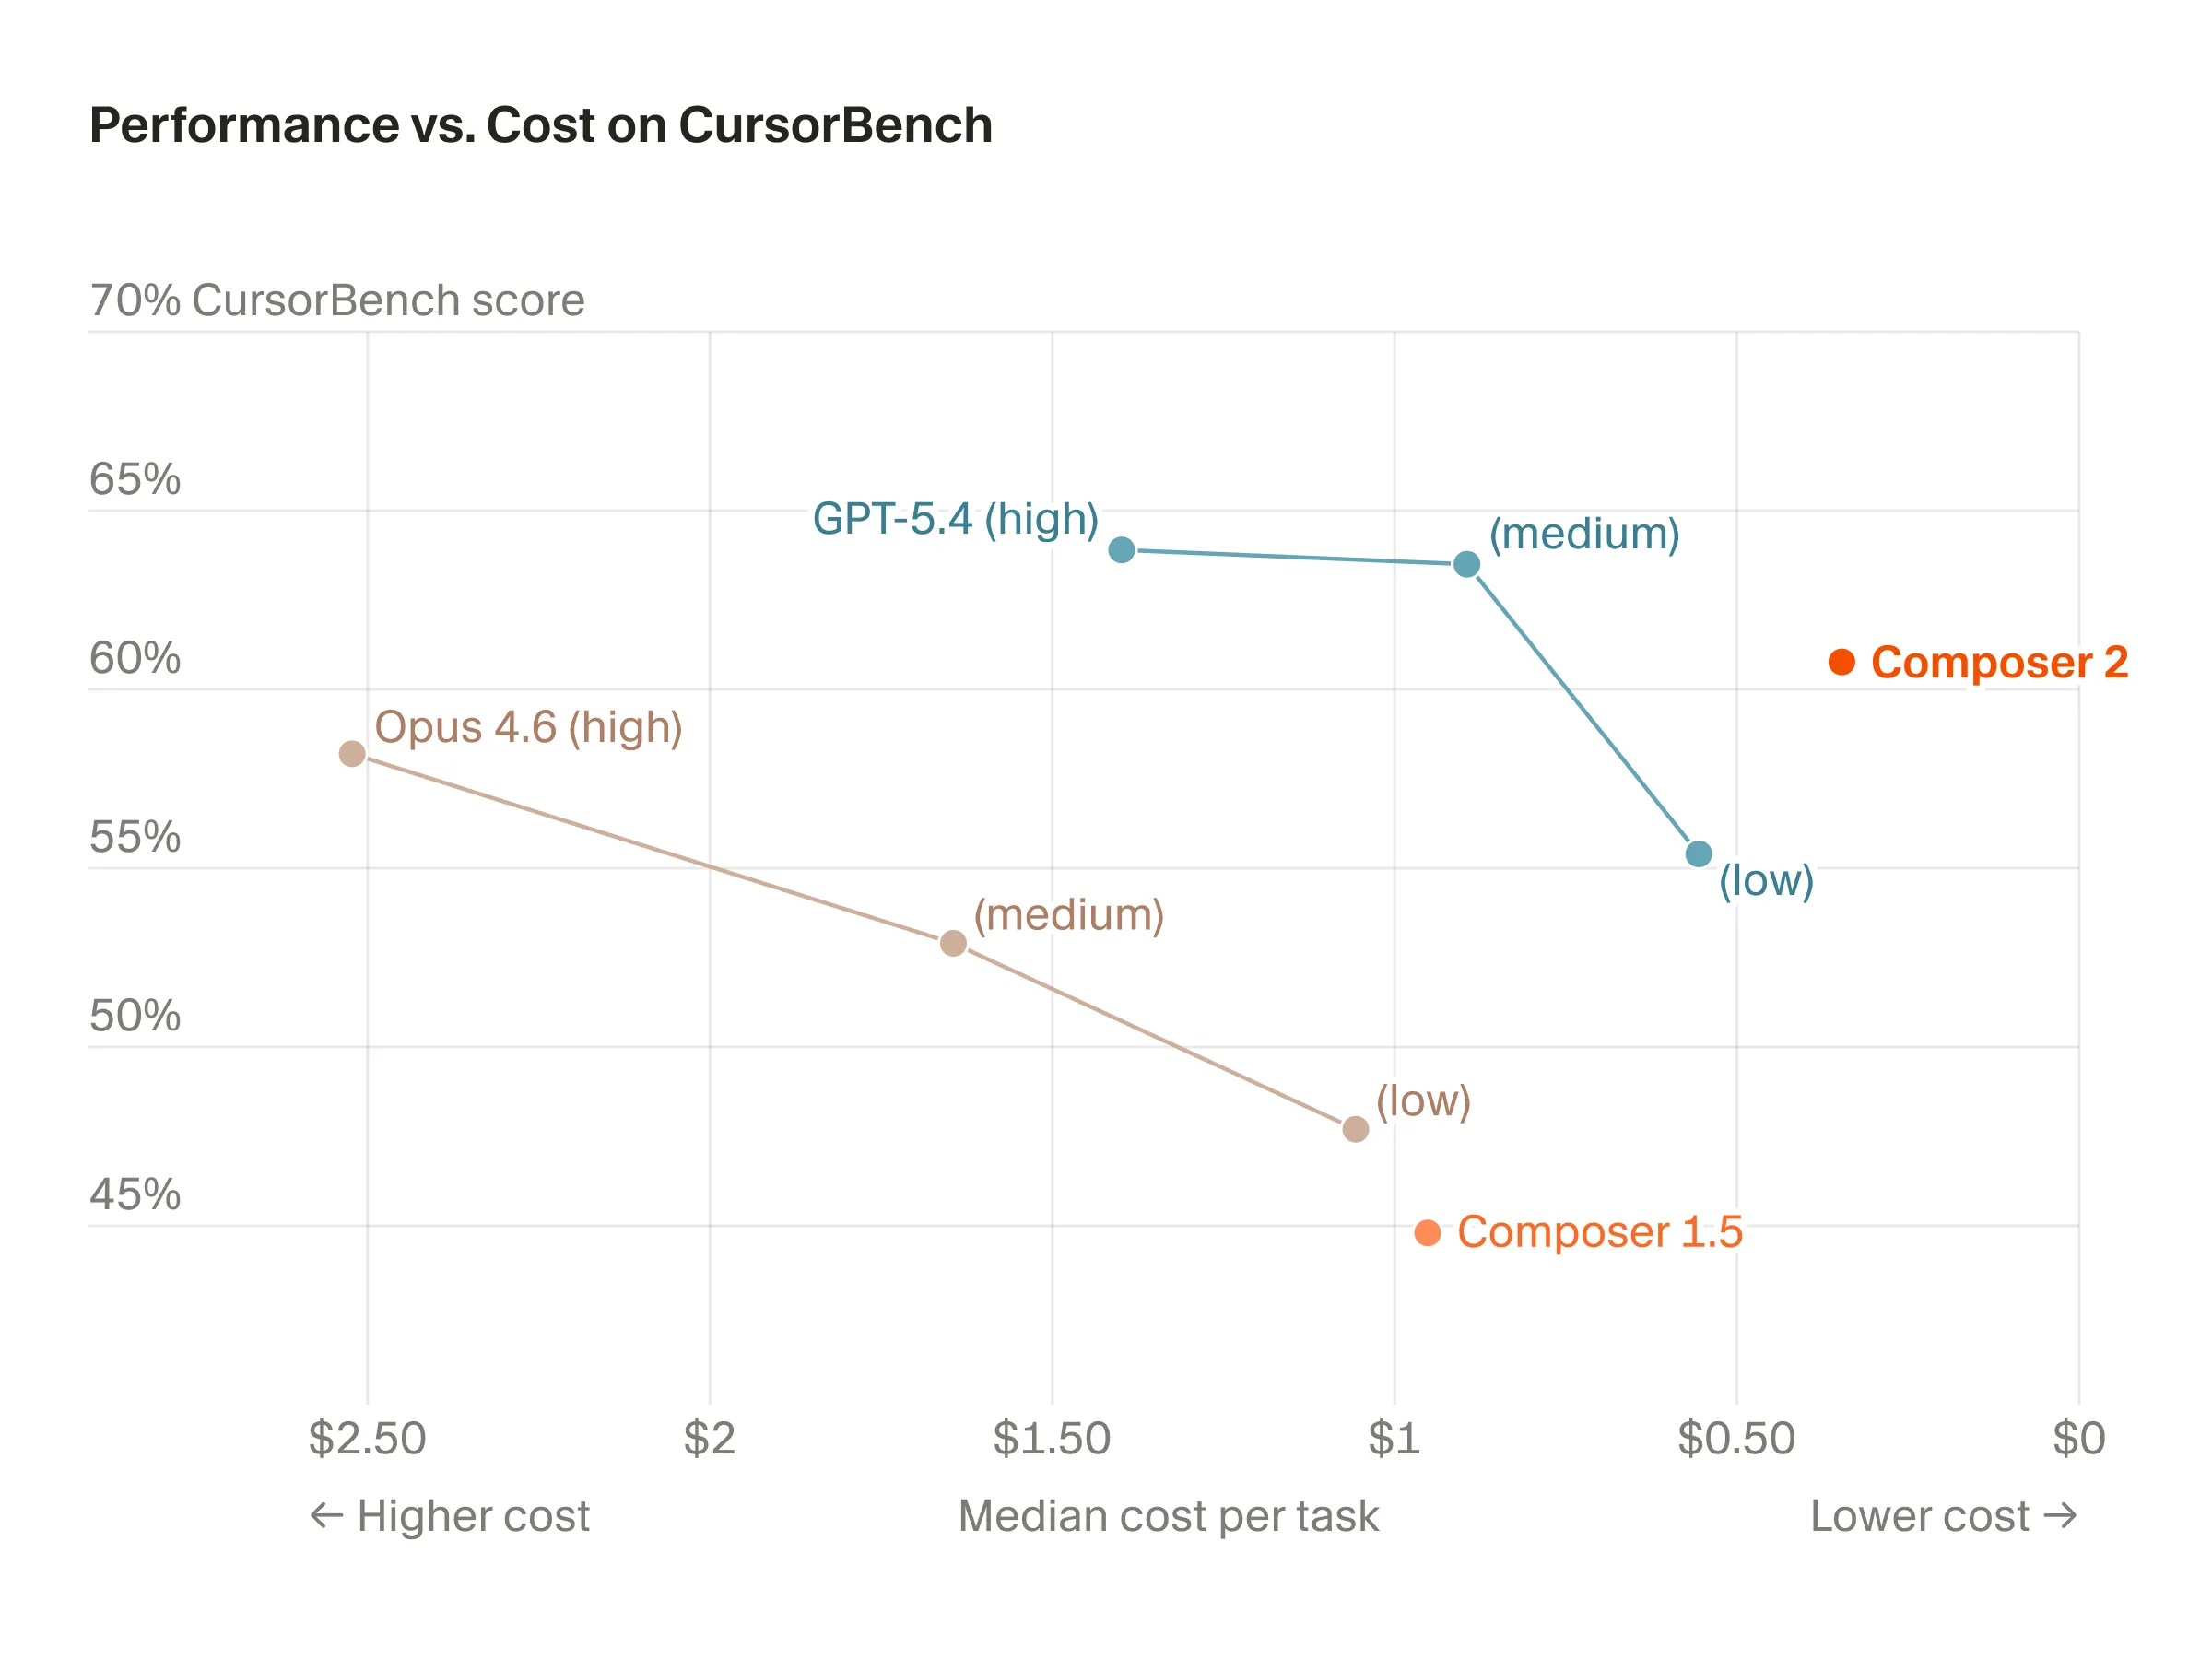
Eles não treinaram o modelo do zero, partindo em vez disso do Kimi K2.5 como base, realizando pré-treinamento continuado sobre ele e também seu próprio ajuste fino. Isso foi um pouco controverso no início, já que eles não divulgaram isso, mas a comunidade conseguiu descobrir a partir de alguns nomes internos de modelos, e a própria Cursor confirmou isso agora também.
Por causa de toda a polêmica em torno do modelo, vi muito pouco sobre suas capacidades até agora (também não tenho uma assinatura do Cursor). Se você tiver, eu diria para experimentá-lo: é muito barato (embora acessível apenas pelo Cursor, sem acesso via API) e alguns dos outros benchmarks que vi parecem indicar que o modelo é razoavelmente bom.
Mistral 4 Small
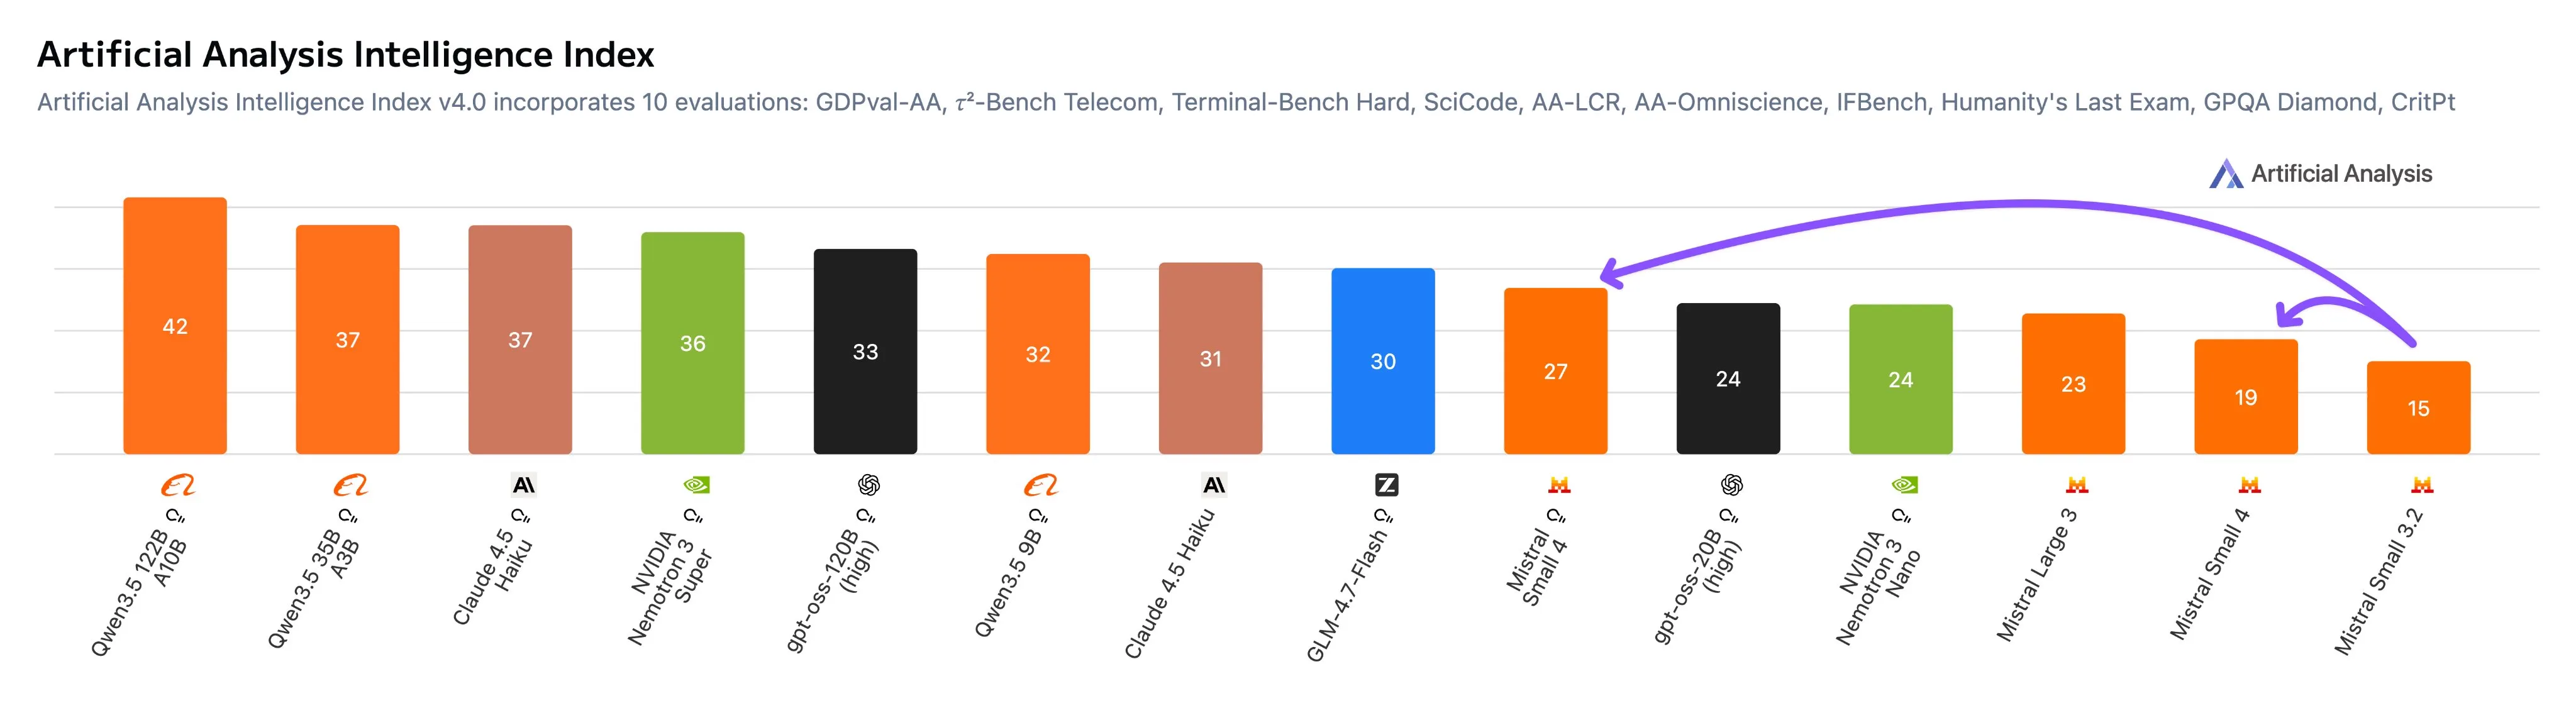
A Mistral lançou o primeiro modelo de sua linha Mistral 4, chamado Mistral 4 Small. É um modelo MoE com 110B de parâmetros e 6,5B de parâmetros ativos.
O nome “small” é bastante adequado, já que é competitivo com os novos modelos Qwen3.5 Small. O único detalhe é que os modelos Qwen 3.5 são 100x menores. Infelizmente para a Mistral, este modelo chega muito obsoleto, sem sequer superar modelos metade do seu tamanho lançados há 3 meses.
Encerramento
Espero que você tenha gostado das novidades desta semana. Se quiser receber as notícias toda semana, não deixe de se inscrever em nossa lista de e-mails abaixo.