
注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
GPT 5.4 Mini 和 Nano
过去 3 个版本中,OpenAI 一直没有更新旗下的小模型 GPT Mini 和 Nano。 本周,随着 GPT 5.4 Mini 和 Nano 的发布,我们终于等来了它们的升级。
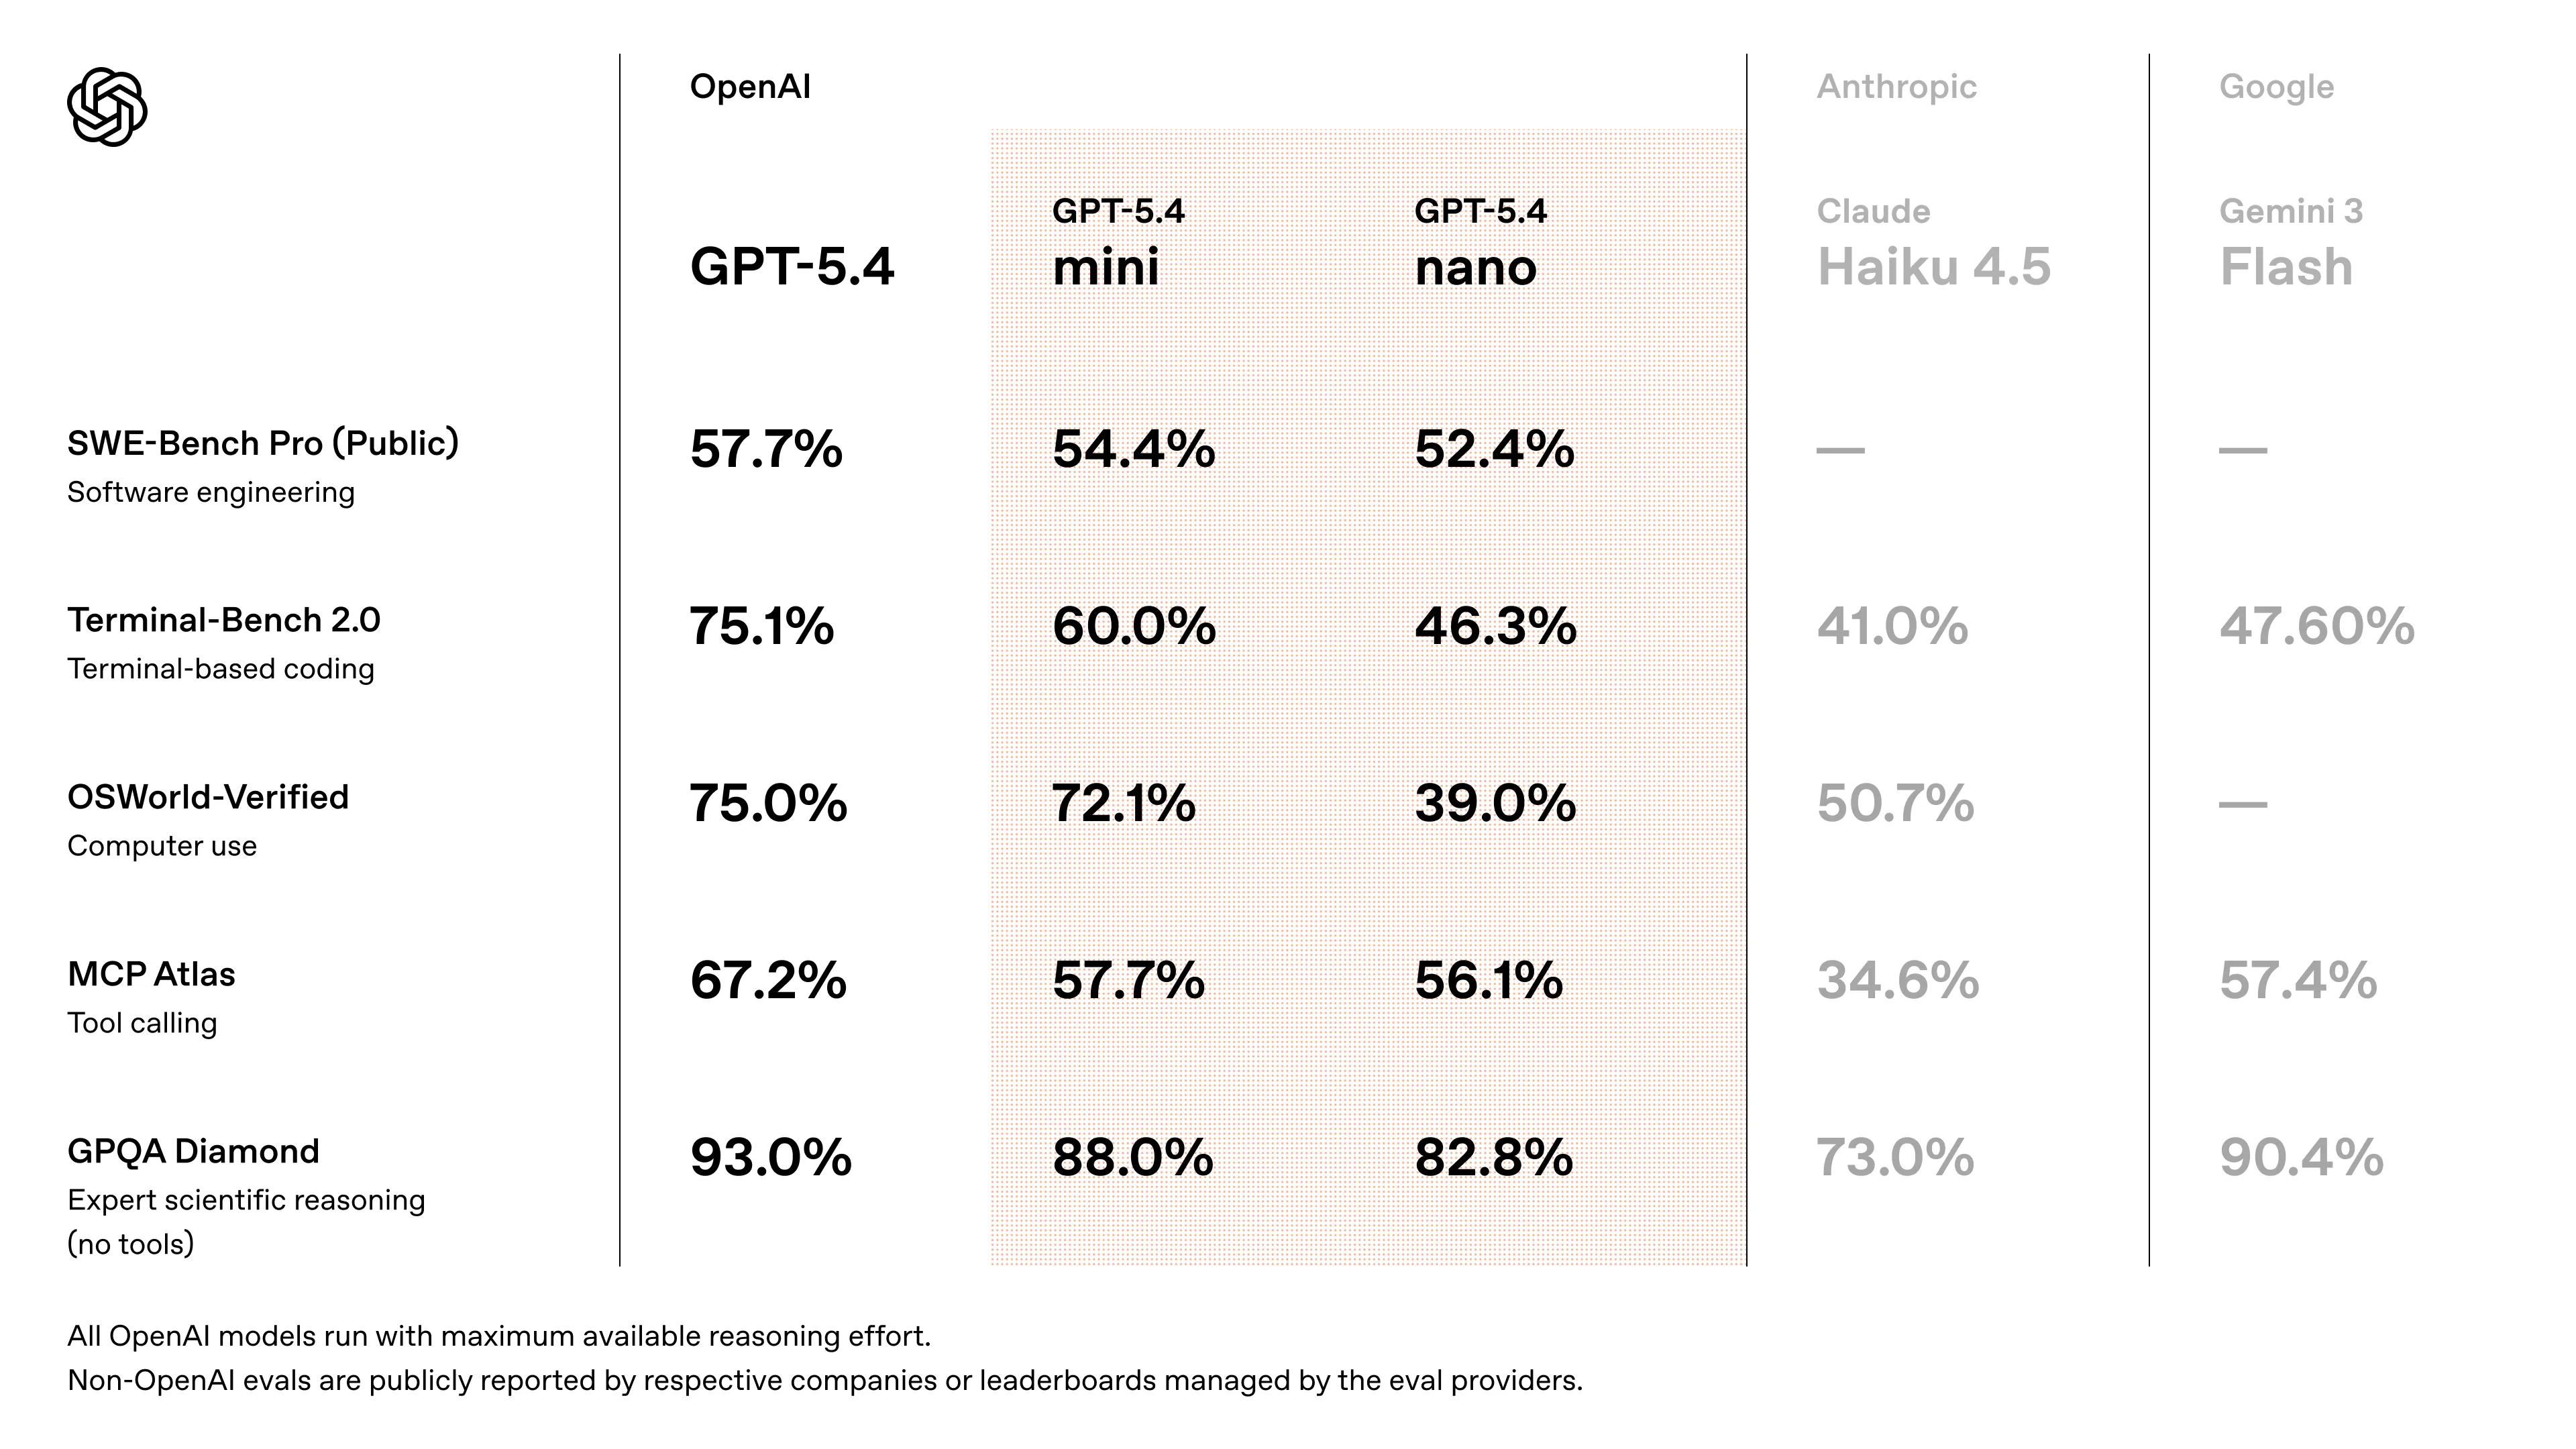
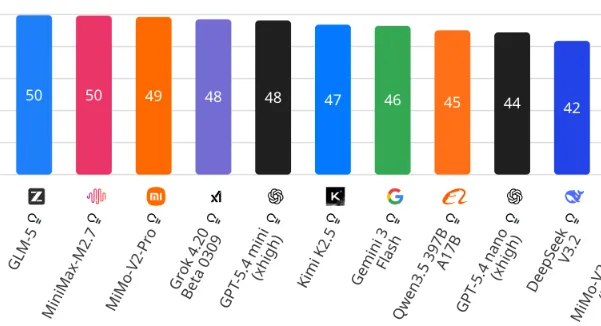
在使用超高推理强度时,Mini 模型的基准测试表现大致与 Gemini 3 Flash 和中国的前沿模型相当。 问题在于,把推理强度调到这么高,消耗的 token 数量就开始变得离谱了。
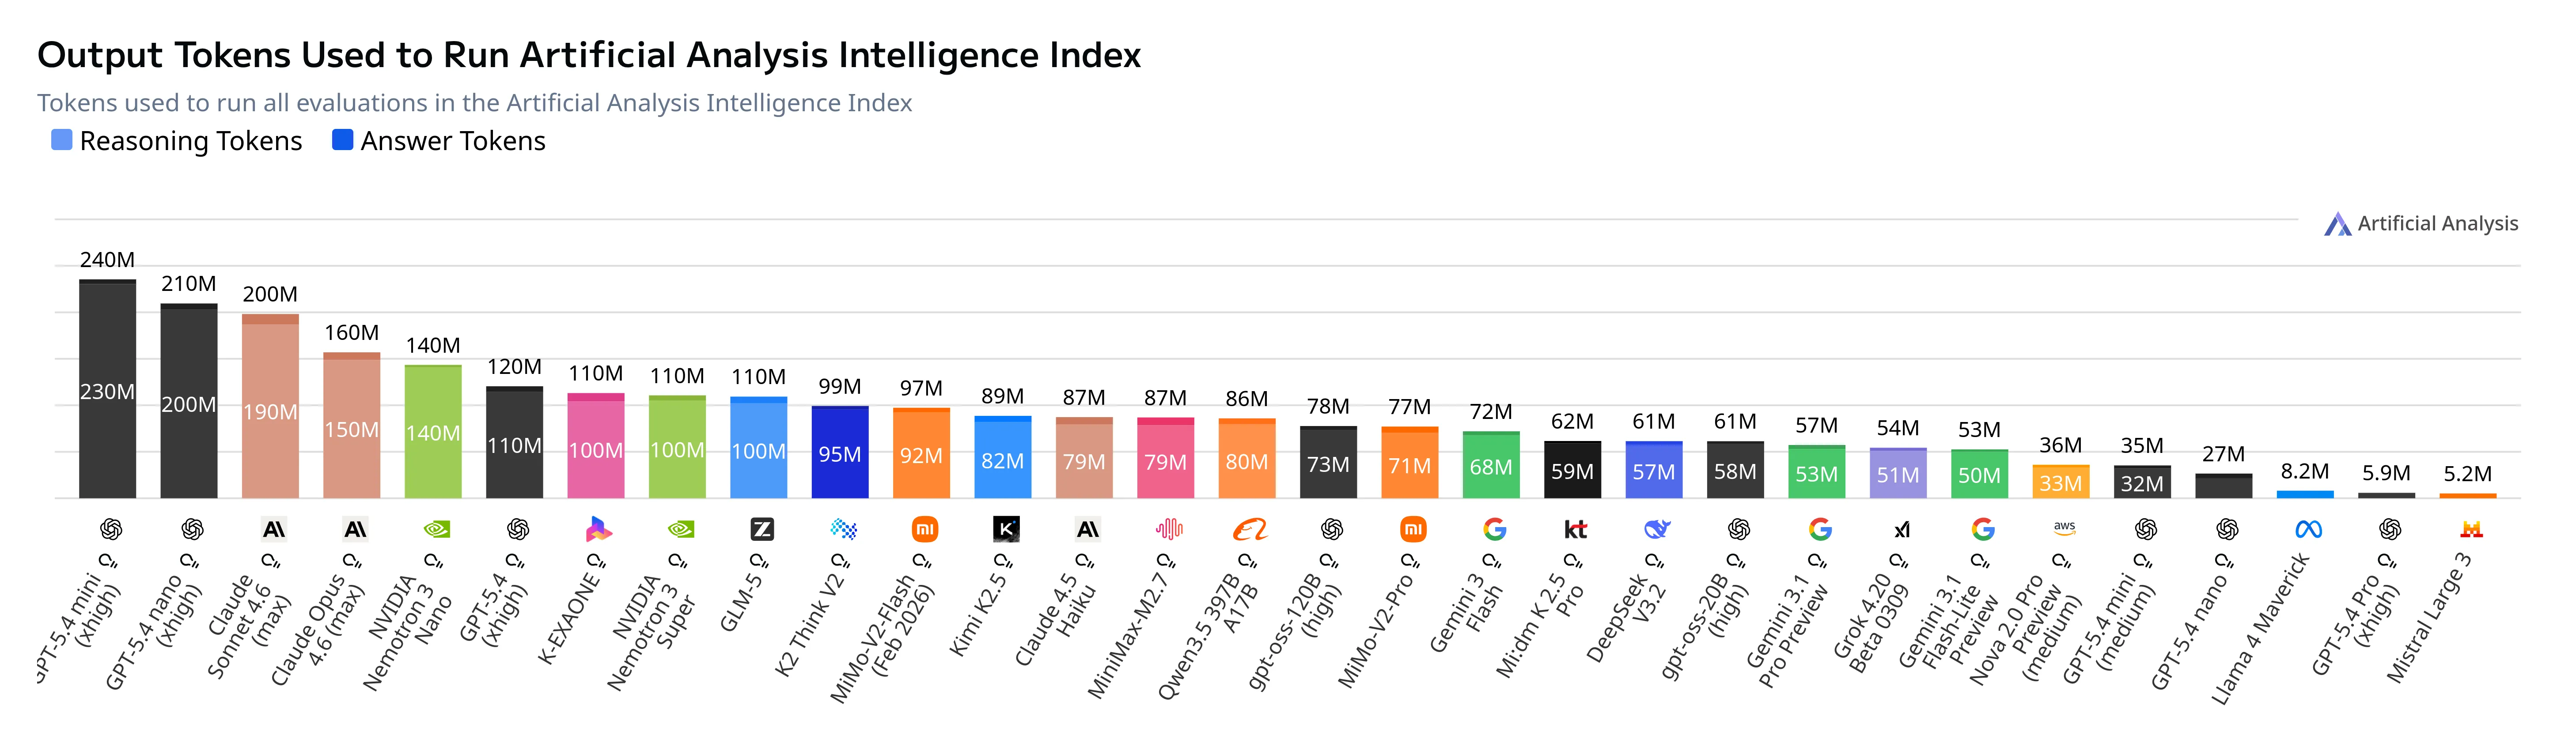
换成更合理的中等推理强度后,这些模型的表现就明显不如其他“便宜又好用”的同类模型了。
再看看这些“平价” OpenAI 模型的定价,差距就更明显了:与 GPT 5 Mini 和 Nano 相比,它们的价格涨到了约两倍。
| 模型 | 每百万输入 token 价格(美元) | 每百万输出 token 价格(美元) | 每秒 token 数 |
|---|---|---|---|
| GPT 5.4 | $2.50 | $15 | 50 |
| GPT 5.4 Mini | $0.75 | $4.5 | 62 |
| GPT 5.4 Nano | $0.20 | $1.25 | 57 |
| Claude Sonnet 4.6 | $3 | $15 | 37 |
| Gemini 3 Flash | $0.50 | $3 | 80 |
| GLM 5 | $1 | $3.20 | 30 |
| MiniMax M2.7 | $0.30 | $1.20 | 34 |
GPT 5.4 Mini 每道题要消耗 MiniMax M2.7 三倍的 token,才能达到相同的表现,而单价也高达后者的三倍(这还没算上 token 用量变成三倍带来的额外成本)。 这也意味着,虽然按每秒输出的 token 数量来看,它的速度似乎是后者的两倍,但实际生成一次回复却要多花 50% 的时间。
因此,我的建议是,通常没必要选这些模型,因为你可以从其他美国厂商(Gemini 3 Flash)或中国实验室那里找到更好的模型。
这也引出了一个问题:OpenAI 真的领先那么多吗?还是说,他们只是把模型规模做得比中国实验室更大?毕竟在参数量低于 1 万亿的级别,开放模型似乎已经能跟上,甚至超越 OpenAI 的水平。
MiniMax M2.7
说到中国实验室,就来聊聊前面提到的 MiniMax 新模型吧。
MiniMax M2.7 在此前广受欢迎、性价比很高的 M2.5 模型基础上进一步升级,是一个相对轻量的混合专家模型,参数量为 2200 亿。 与 OpenAI 不同,他们并没有因为模型性能提升就涨价。
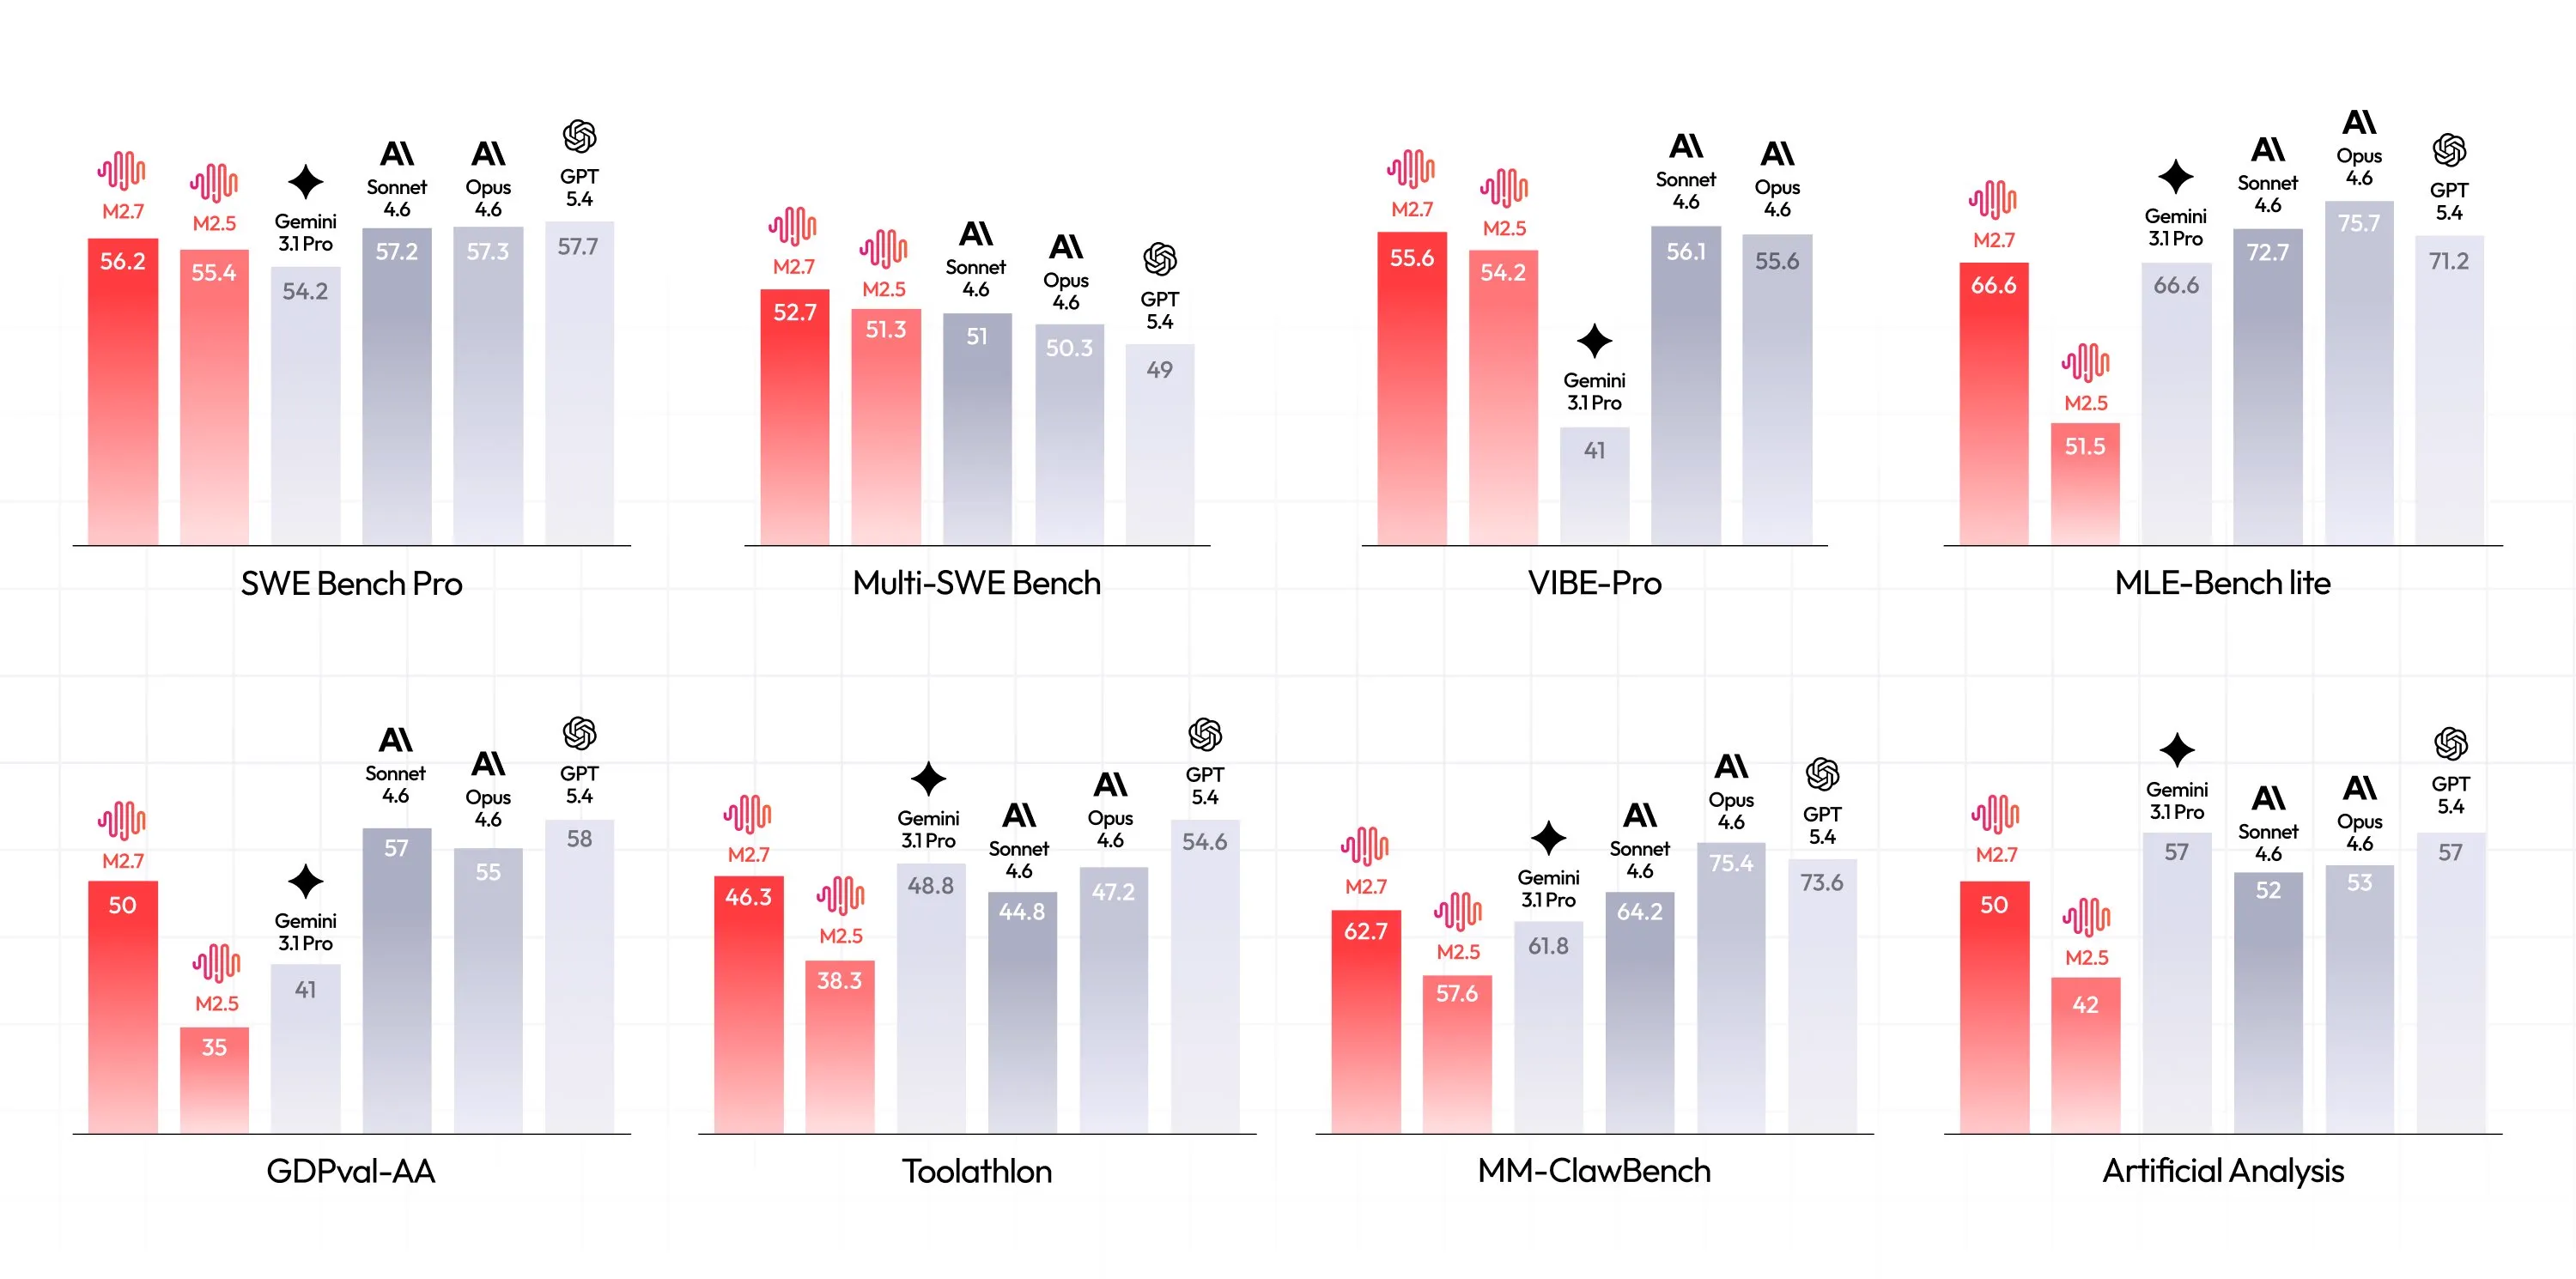
与 GPT 5.3 Codex 类似,M2.7 也参与了自身的开发。它的一个早期检查点版本协助完成了强化学习团队 30–50% 的工作流程,展现出了它在编程和通用智能体任务方面的能力。
他们也一直在打磨模型的性格与个性,让它聊起来舒服了很多。 我觉得它的个性还没达到 Claude 或 Kimi 的水平,但已经紧随其后,而且进步似乎相当大。
凭借更强的智能体能力、更讨喜的个性以及极低的成本,它可能是搭配 OpenClaw 使用的最佳模型(价格见上表)。 如果你是重度用户,或者只是更喜欢按月订阅,而不是按 API 用量付费,他们提供了一个每月 10 美元的套餐,每 5 小时可发起 1500 次请求(每分钟 4 次)。
如果你想找一个能力强、性价比高的智能体模型,MiniMax M2.7 看起来就是首选。 今后做智能体项目时,我大概会用它取代 Gemini 3 Flash,作为默认模型。
快讯
Cursor Composer 2
Cursor 发布了内部训练的智能体编程模型 Composer 2。
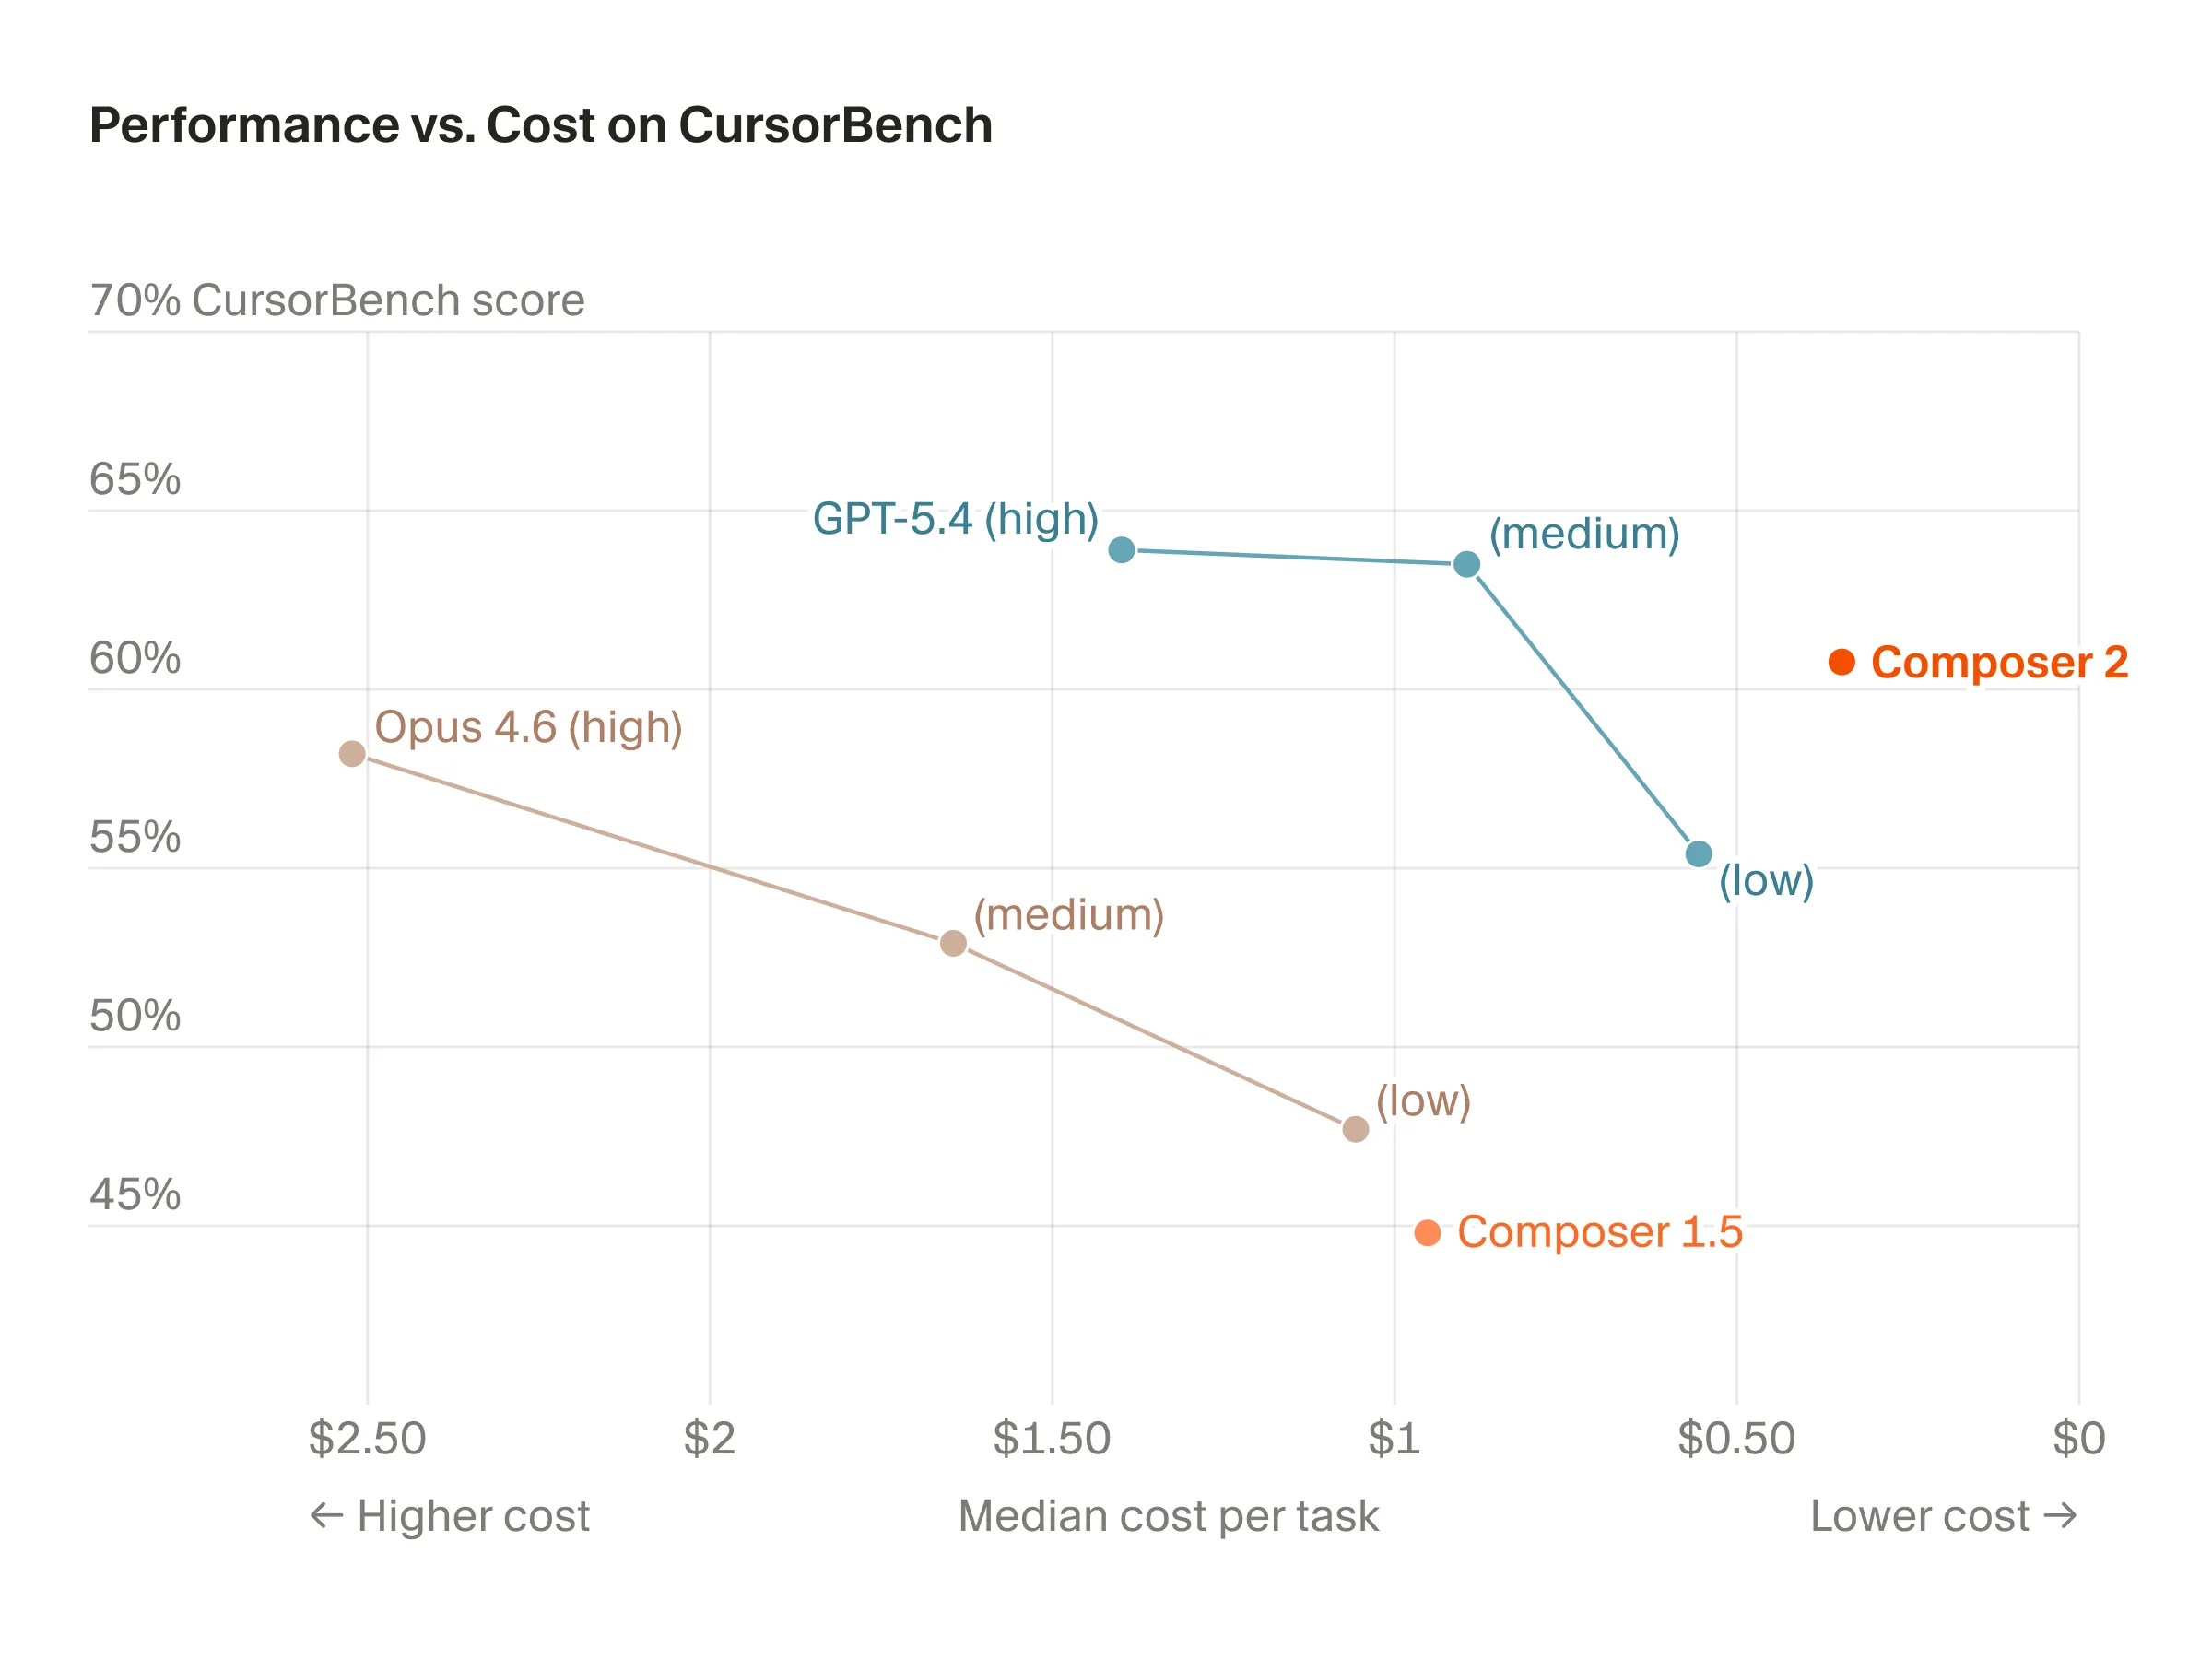
他们并没有从零开始训练这个模型,而是以 Kimi K2.5 为基础,先进行持续预训练,再做自己的微调。 这件事一开始引发了一些争议,因为他们没有披露这一点。但社区通过一些内部模型命名推断出了它的底座,现在 Cursor 自己也已经确认了。
围绕这个模型的风波太多,所以到目前为止,我几乎没看到多少关于它实际能力的讨论(我自己也没有订阅 Cursor)。 如果你订阅了,我建议试试看。它的价格很低(不过只能通过 Cursor 使用,没有 API),而且我看到的另外几项基准测试似乎也表明,这个模型还挺不错。
Mistral 4 Small
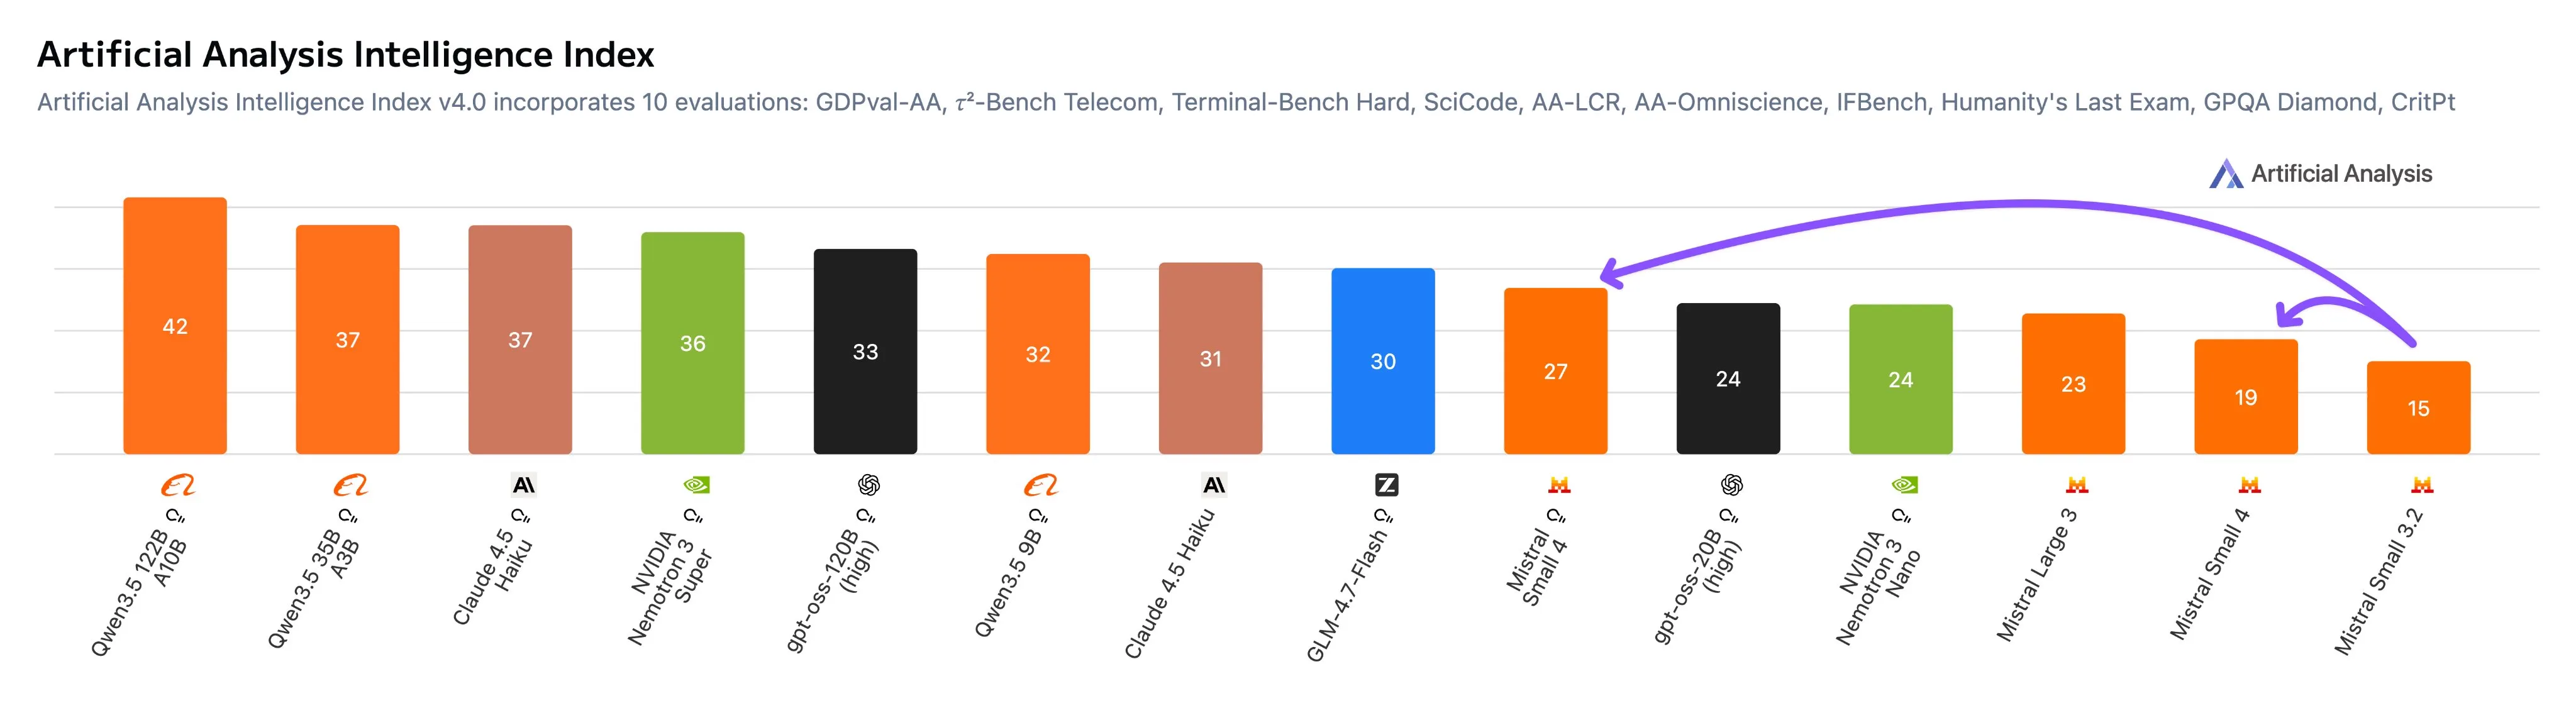
Mistral 发布了 Mistral 4 系列的首个模型,名为 Mistral 4 Small。 这是一个拥有 1100 亿参数的 MoE 模型,激活参数量为 65 亿。
Small 这个名字倒是很贴切,因为它能与新的 Qwen3.5 Small 模型一较高下。 唯一的问题是,那些 Qwen 3.5 模型的规模只有它的百分之一。 对 Mistral 来说,很遗憾,这个模型真的是一发布就凉了,甚至还打不过 3 个月前发布、规模只有它一半的模型。
结语
希望你喜欢本周的资讯。如果你想每周都收到这些资讯,记得在下方订阅我们的邮件列表。