Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
En resumen
- Claude Haiku recibe una actualización después de casi un año
- Veo 3.1 es bueno en imagen a video
- Nuevos benchmarks muestran qué tan malos son los LLM en tareas de contexto largo
- Y más modelos Qwen3 VL
Lanzamientos
Claude Haiku 4.5
Ha pasado casi un año desde el último lanzamiento de Claude Haiku, así que no te culpo si te has olvidado de este modelo. Haiku es el miembro más pequeño de la Trinidad Claude, y su actualización más reciente había sido de la serie de modelos Claude 3.5, lo que, dependiendo de cómo lo cuentes, significa que está 5 versiones detrás de sus hermanos Opus y Sonnet.
Haiku 4.5 se está promocionando como un reemplazo de Sonnet 4, lo que lo coloca directamente contra el modelo GLM 4.6, entonces ¿cómo se compara?
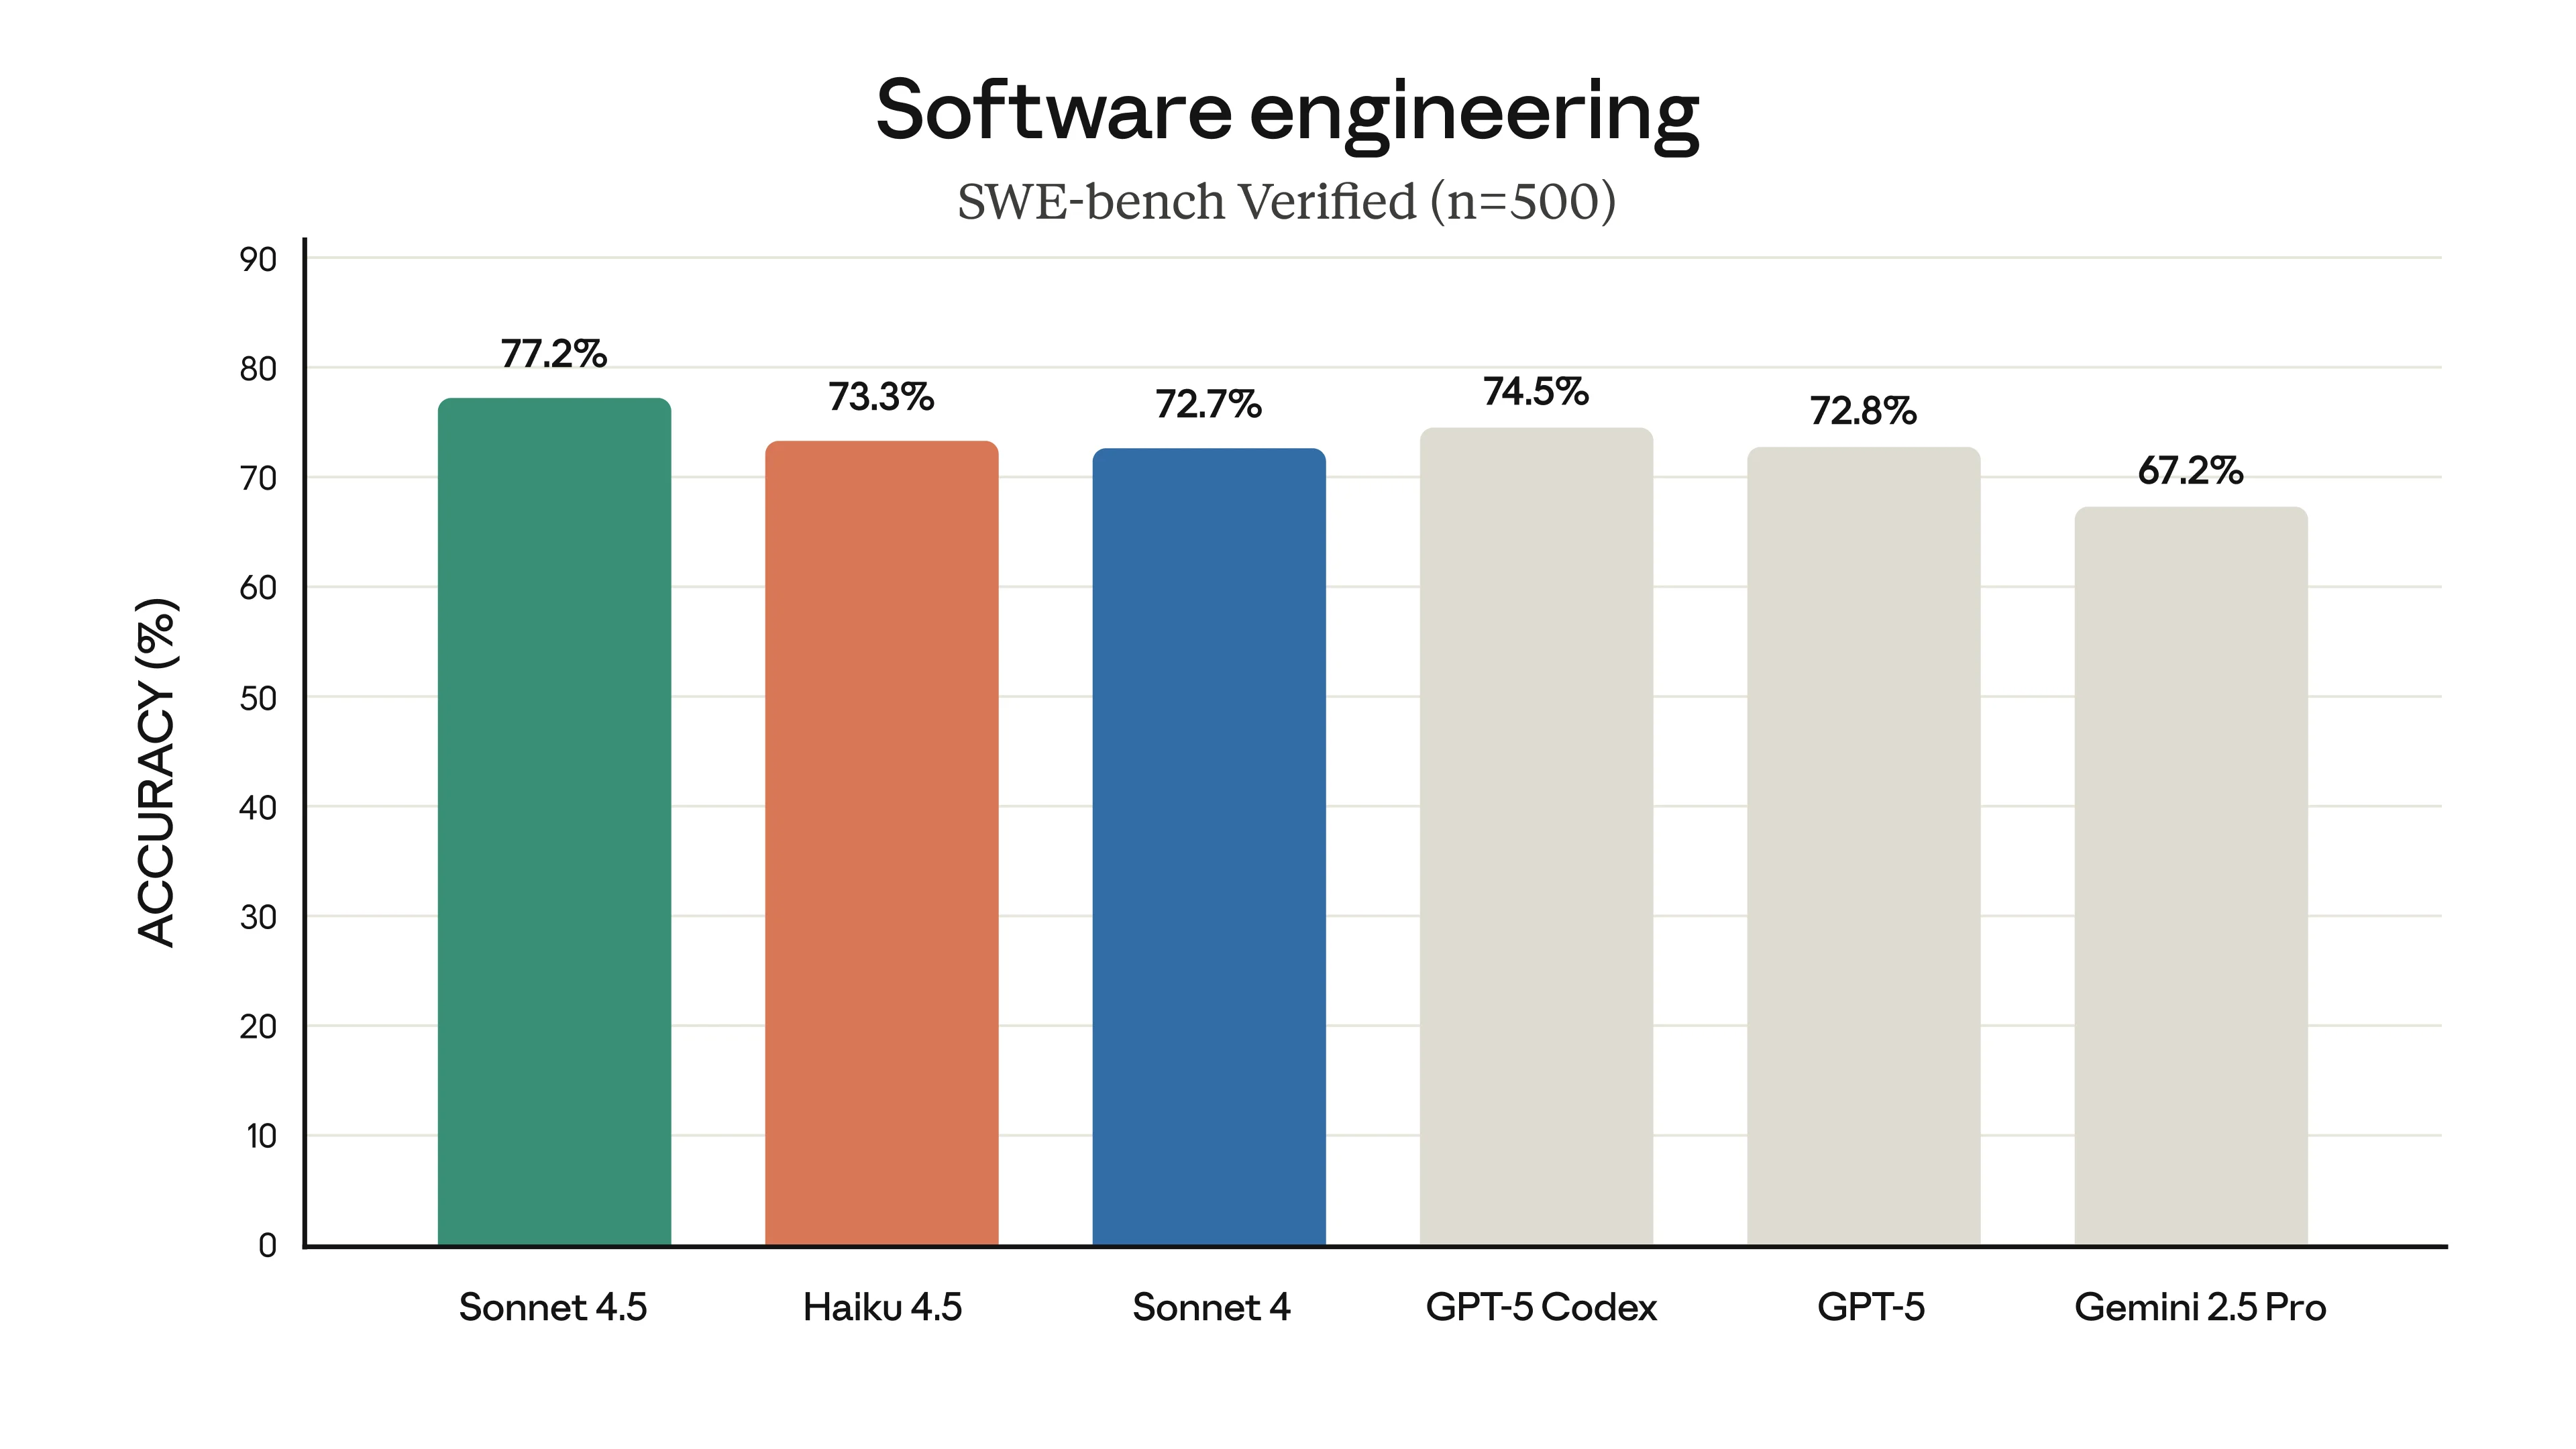
La respuesta es: no muy impresionantemente. Su principal punto de venta sobre GLM 4.6 es que es un poco más rápido, pero por lo demás es aproximadamente dos veces más caro de usar.
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| GLM 4.6 | $0.60 | $2.20 | 46 |
| Claude Haiku 4.5 | $1 | $5 | 106 |
Además, el consenso público parece colocarlo un poco por debajo de Sonnet 4, mientras que para GLM 4.6, la gente tiende a preferirlo sobre Sonnet 4.
Actualmente se desconoce cuáles son los límites de tasa para él en Claude code con la suscripción de Anthropic. Pero los límites tendrán que ser extremadamente generosos para que sea un mejor valor que GLM 4.6, especialmente considerando que la suscripción es casi 10 veces más cara.
Debido a esto, no creo que sea un lanzamiento muy interesante o único y no cambia el panorama de LLM en absoluto.
Qwen3 VL 4B y 8B
Qwen continúa lanzando modelos en su línea de visión, publicando VLMs de 4 y 8 mil millones de parámetros basados en sus modelos Qwen3.
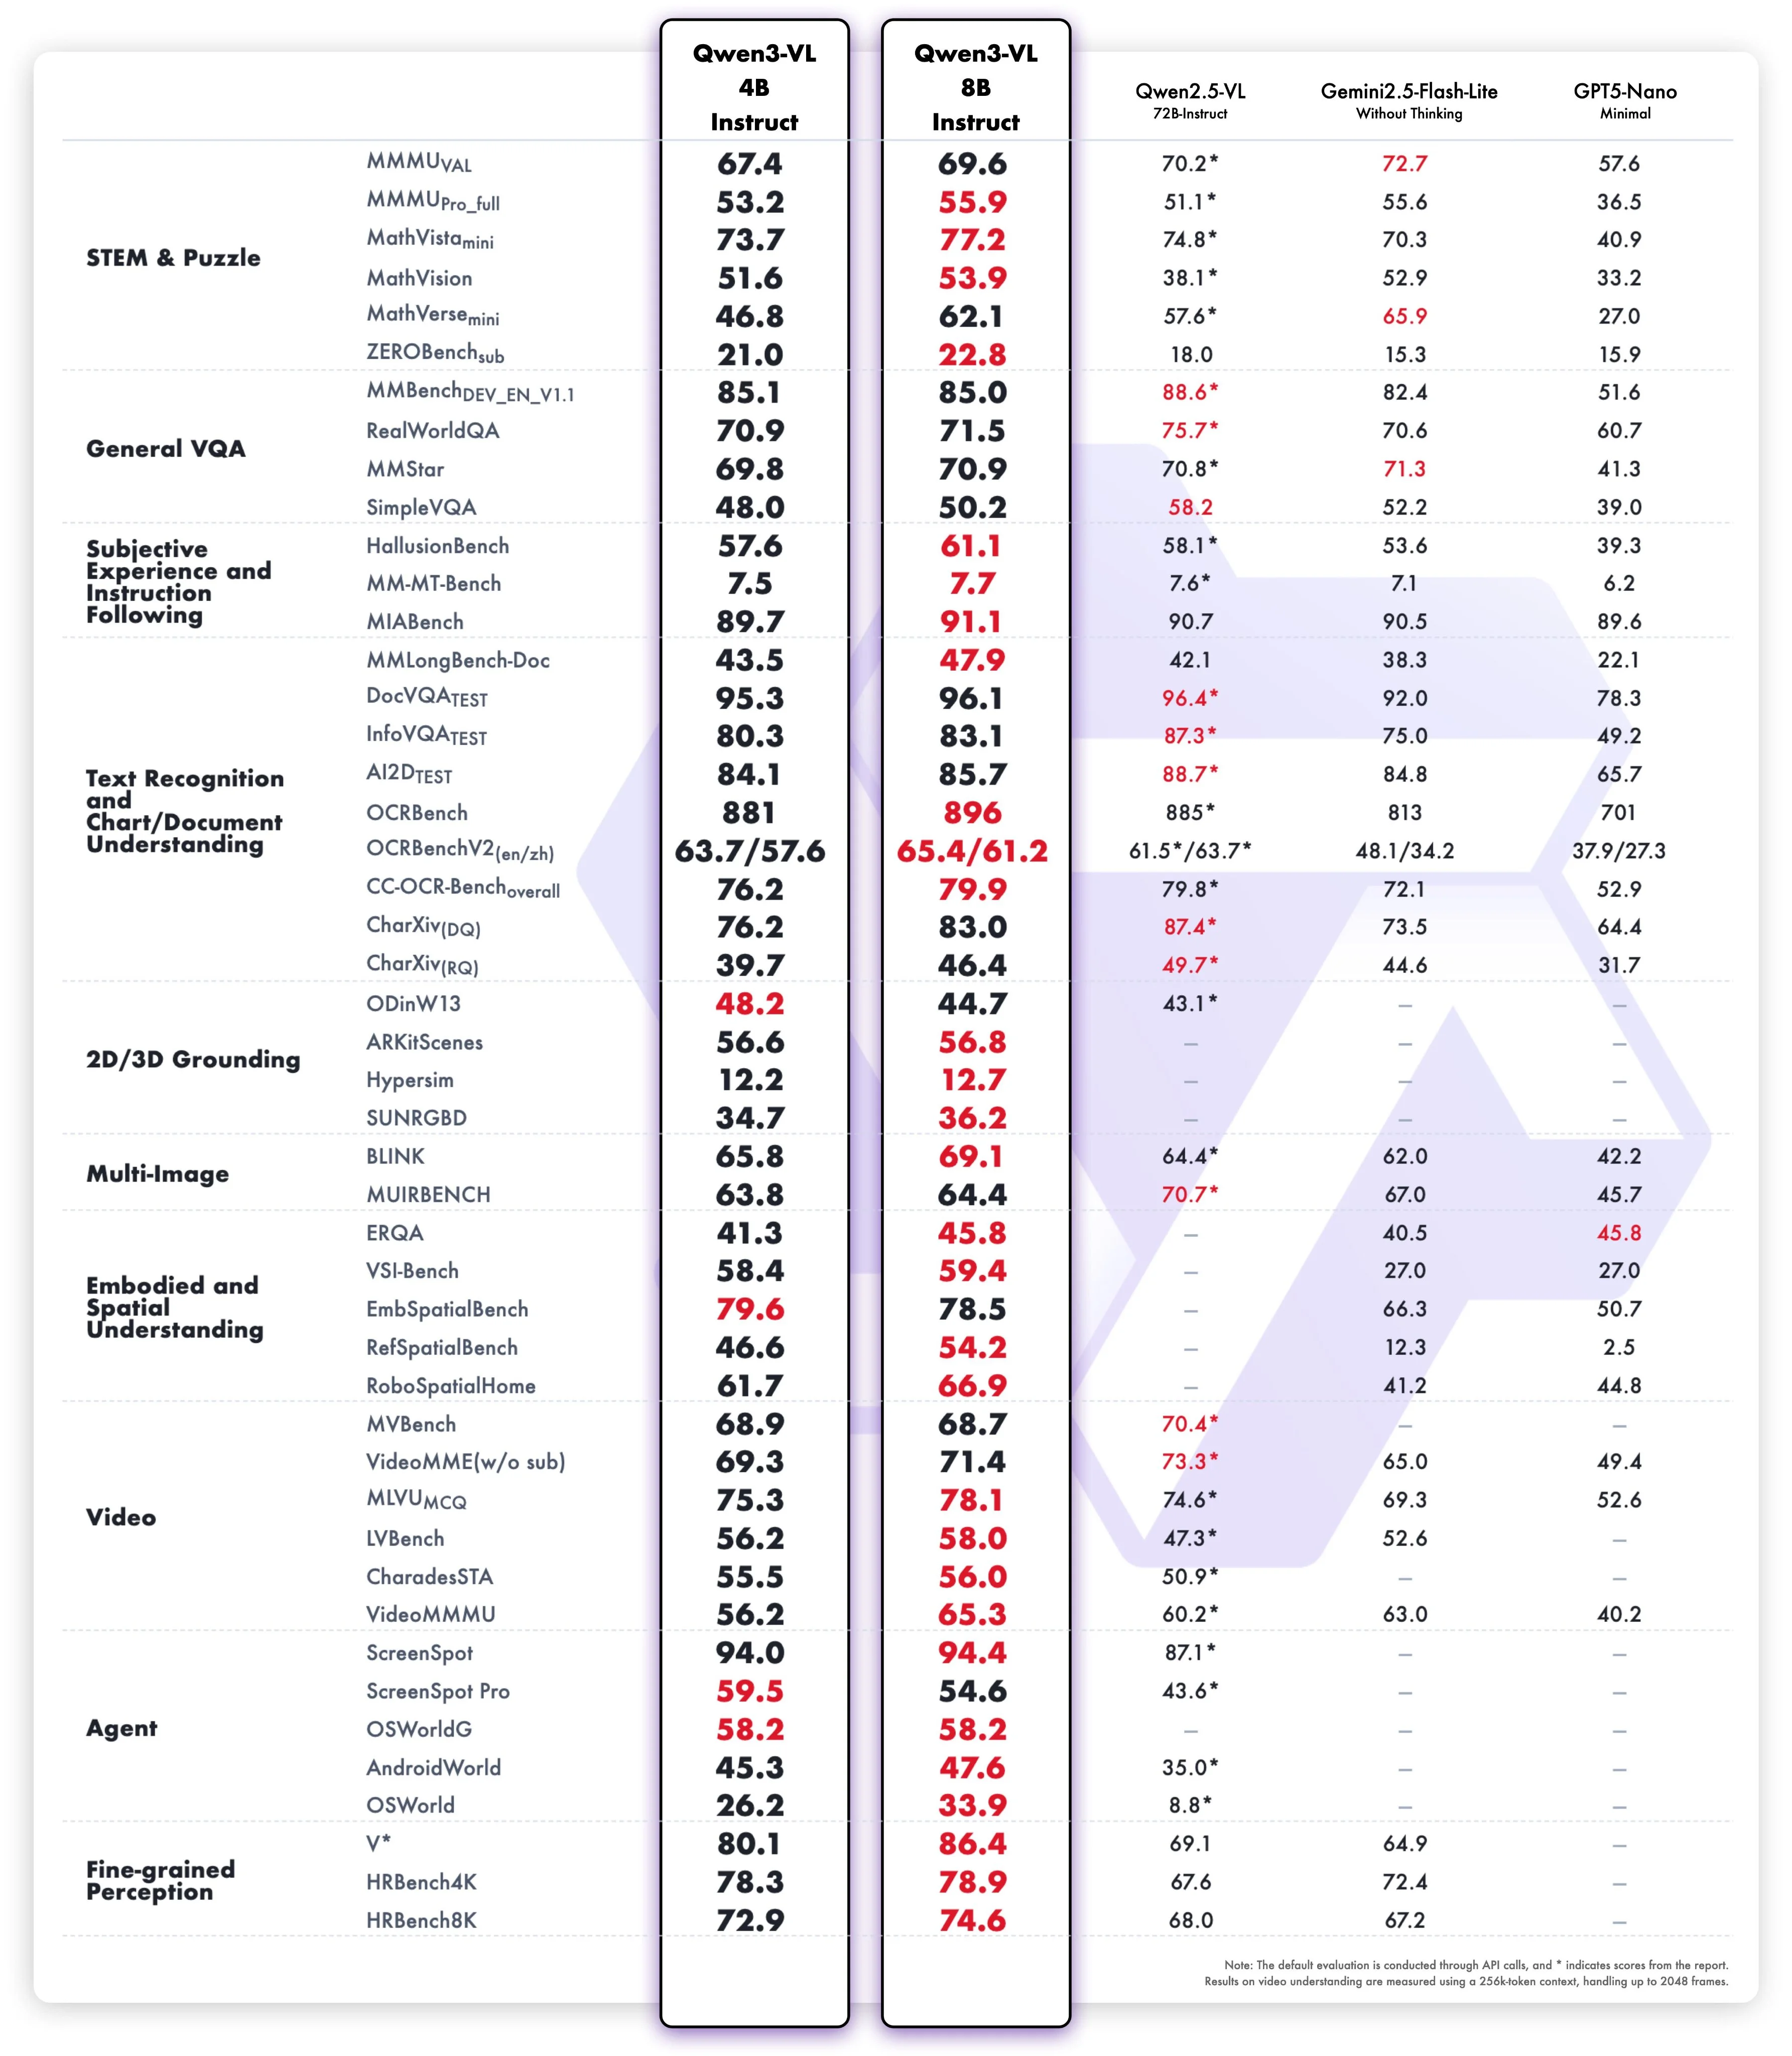
Como era de esperar, son número uno para sus tamaños respectivos. No es que eso realmente signifique mucho dado que no hay mucha competencia en el espacio de VLM de código abierto en este momento. A pesar de esto, siguen siendo modelos sólidos que son lo suficientemente buenos como para hacerlos utilizables en el mundo real para tareas básicas mientras pueden ser desplegados en el dispositivo.
De nota: los benchmarks sin visión disminuyeron un poco más de lo que lo hicieron para las variantes más grandes, pero la diferencia sigue siendo relativamente pequeña (caída del 1-2% en rendimiento absoluto)
Otro aspecto interesante es el lanzamiento de un modelo de 8 mil millones de parámetros. Anteriormente, en sus actualizaciones de Qwen 3, habían descuidado actualizar su modelo de 8 mil millones de parámetros junto con un par de otros. Pero ahora con este lanzamiento, han actualizado el post-entrenamiento de su modelo de 8 mil millones de parámetros y también le han agregado capacidades de visión, lo cual es bueno ver ya que el tamaño de ocho mil millones de parámetros es ideal para pequeños despliegues de GPU en casa.
Veo 3.1
Google ha lanzado una nueva versión de su ya muy potente modelo Veo 3.
Para esta versión, han mejorado enormemente el rendimiento de imagen a texto y la capacidad de hacer creaciones de video adecuadas para programas de televisión o películas. Por ejemplo, puedes subir una imagen de una ubicación y luego pedirle al modelo que genere video de un helicóptero volando sobre ella.
Los benchmarks habituales aún no han publicado puntuaciones para el modelo, pero por lo que he estado viendo, parece estar cerca de la cima para generación de imagen a video.
Investigación
Nuevos Benchmarks de Contexto Largo
El contexto largo suele ser muy difícil para los modelos. Solo con algunos de los lanzamientos de frontera recientes como GPT-5 han podido los modelos usar remotamente su ventana de contexto completa.
Los benchmarks de contexto largo “más difíciles” solo probaron qué tan bueno es un modelo para recuperar información de su contexto; ninguno de los benchmarks hizo que el modelo hiciera algo complejo con esta información.
Ahora tenemos un nuevo benchmark que busca llenar este vacío. LongCodeEdit es un benchmark que busca medir la capacidad de un LLM para encontrar, diagnosticar y corregir errores en un archivo grande.
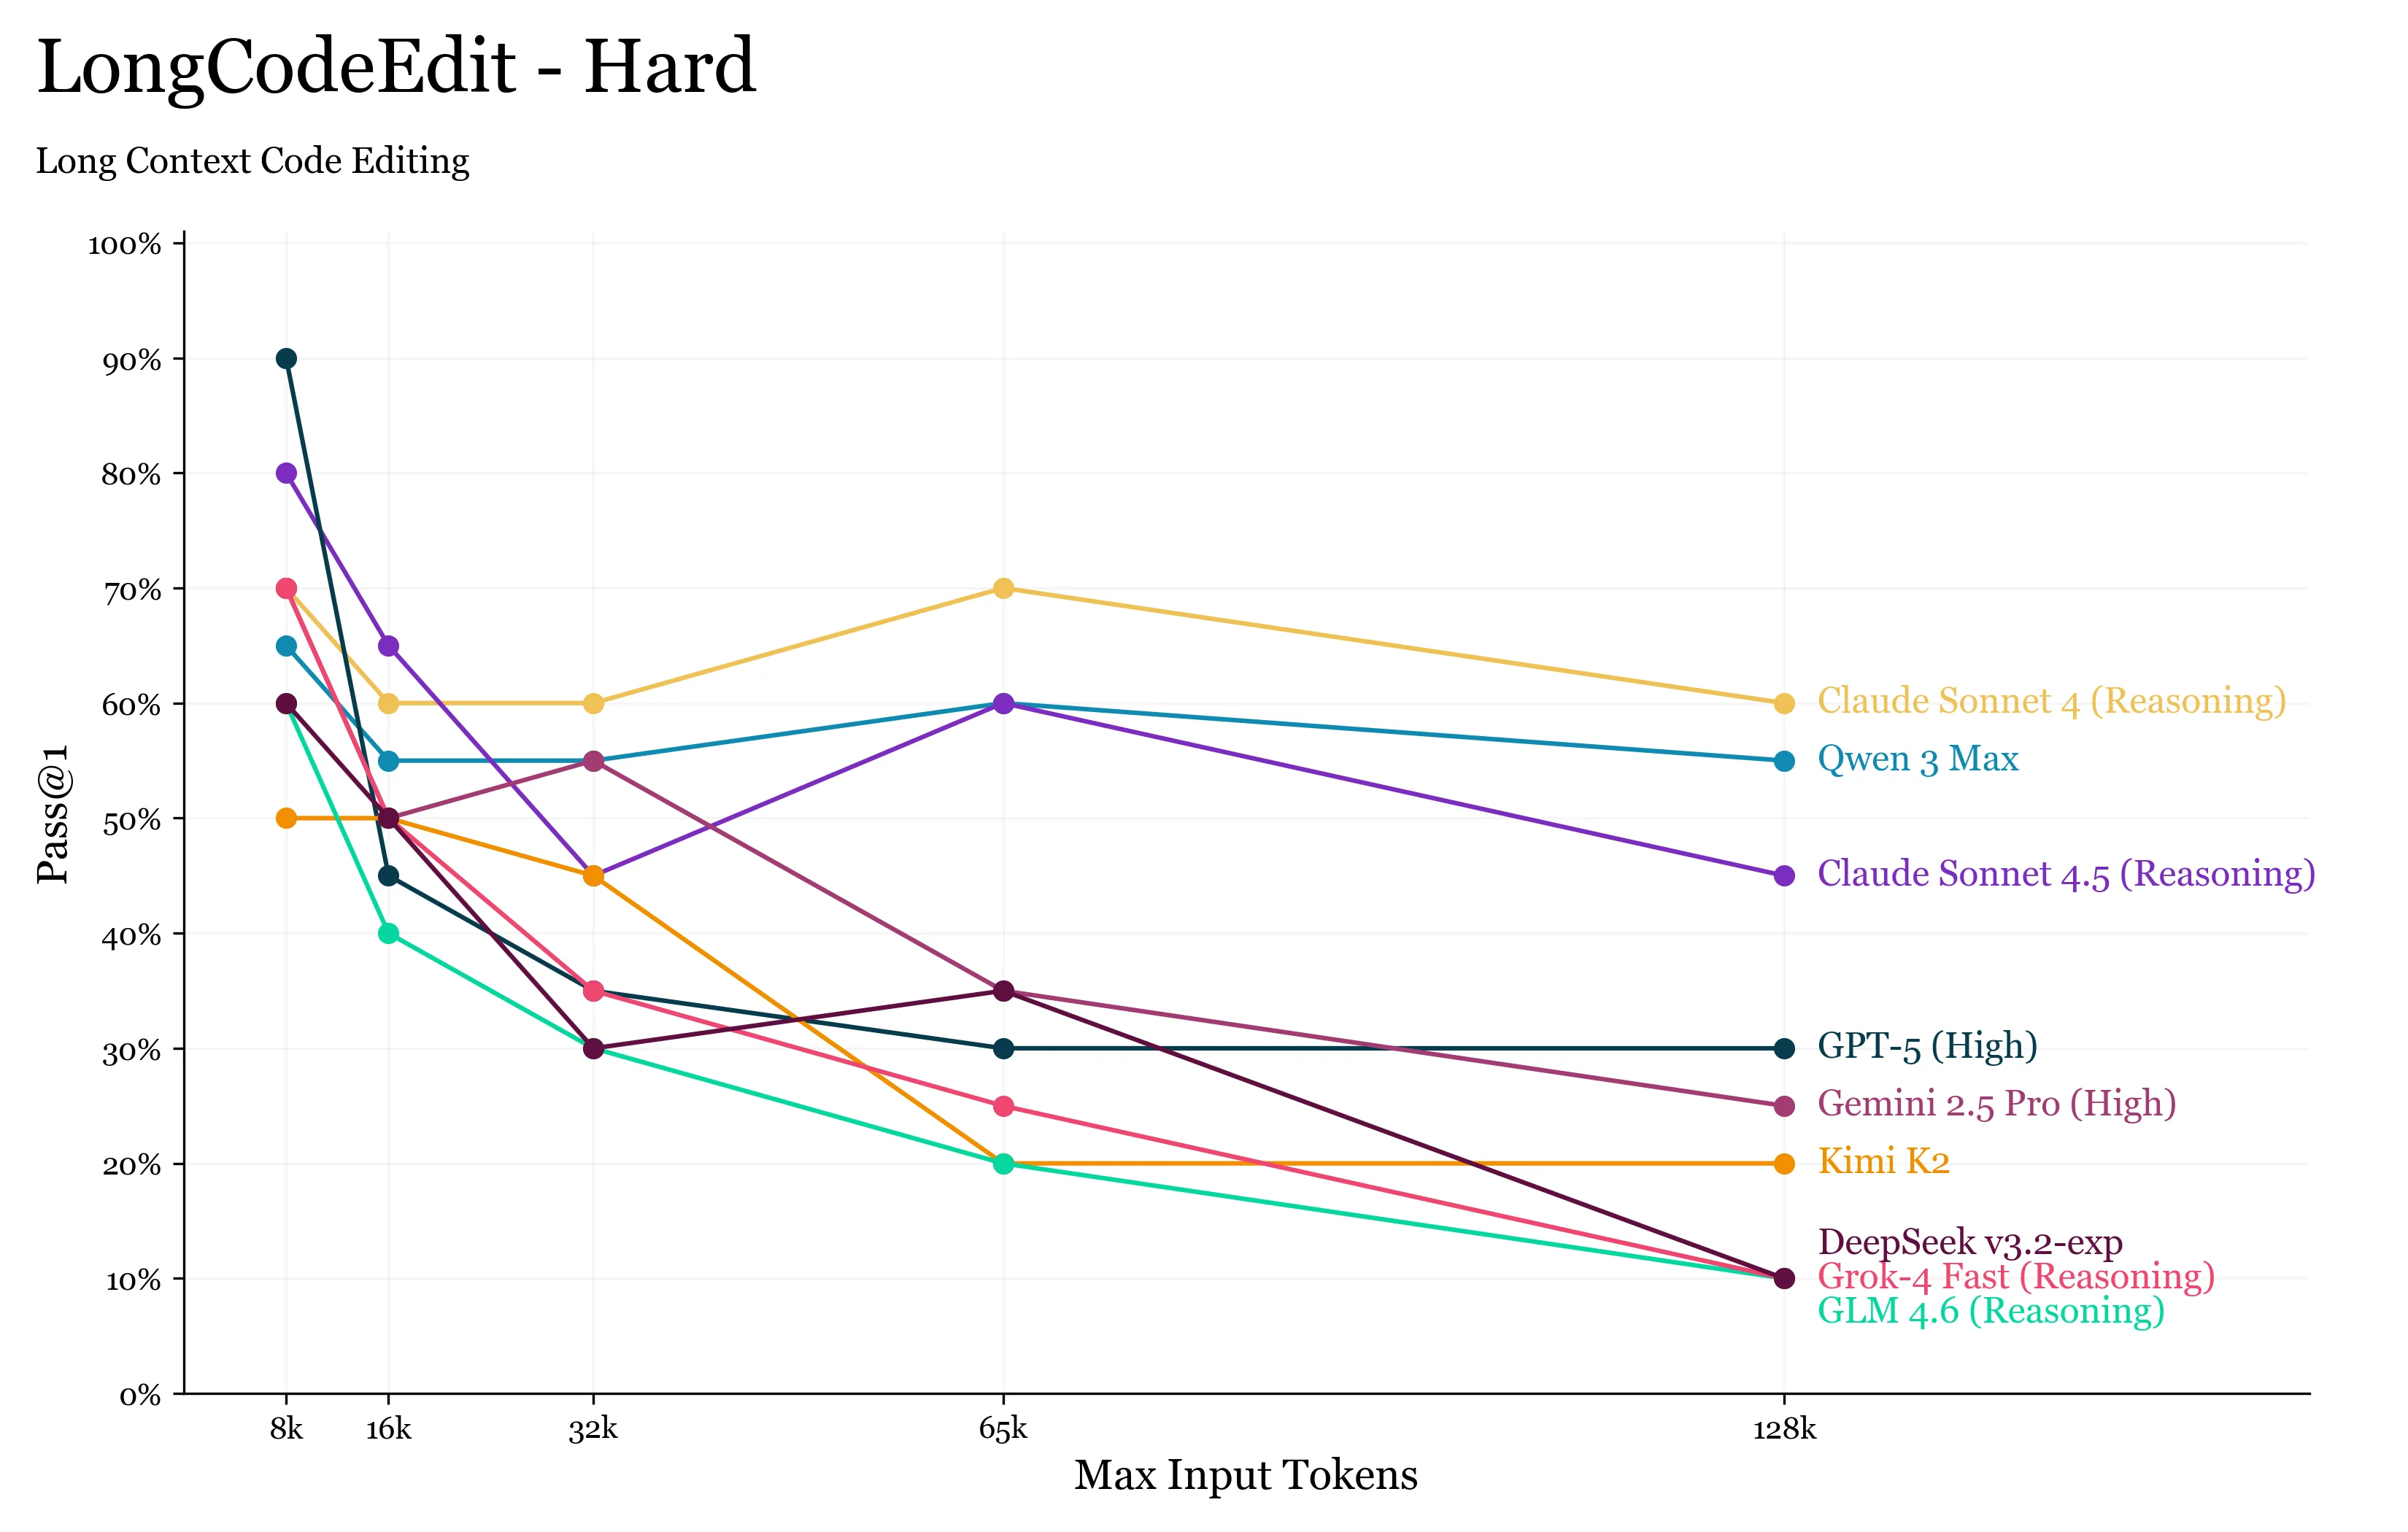
Lo que encontramos es más de lo mismo de los benchmarks de contexto largo anteriores: que los LLM son notablemente malos usando su ventana de contexto reportada, ya que incluso a 16k tokens vemos degradación de rendimiento no trivial en las tareas.
El benchmark toma una serie de funciones que funcionan de benchmarks de código existentes, corrompe una sola de ellas, y luego las pasa todas juntas en un solo “archivo” al LLM.
Sorprendentemente, encontramos que GPT-5 se degrada significativamente, mientras que Sonnet 4 y 4.5 son capaces de mantener aproximadamente sus capacidades. También es de notar que el equipo de Qwen está en el número 2, con su modelo insignia Qwen3 Max.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.