注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
Claude Haiku 4.5
距离上一次 Claude Haiku 发布已经过去了将近一年,所以如果你已经忘了这个模型,我也不怪你。Haiku 是 Claude 三大模型中最小的一个,此前最近的一次更新还停留在 Claude 3.5 系列。按某种算法,它已经落后兄弟模型 Opus 和 Sonnet 整整 5 个版本了。
Haiku 4.5 的定位是 Sonnet 4 的替代品,这让它与 GLM 4.6 正面交锋。那么,它的表现如何呢?
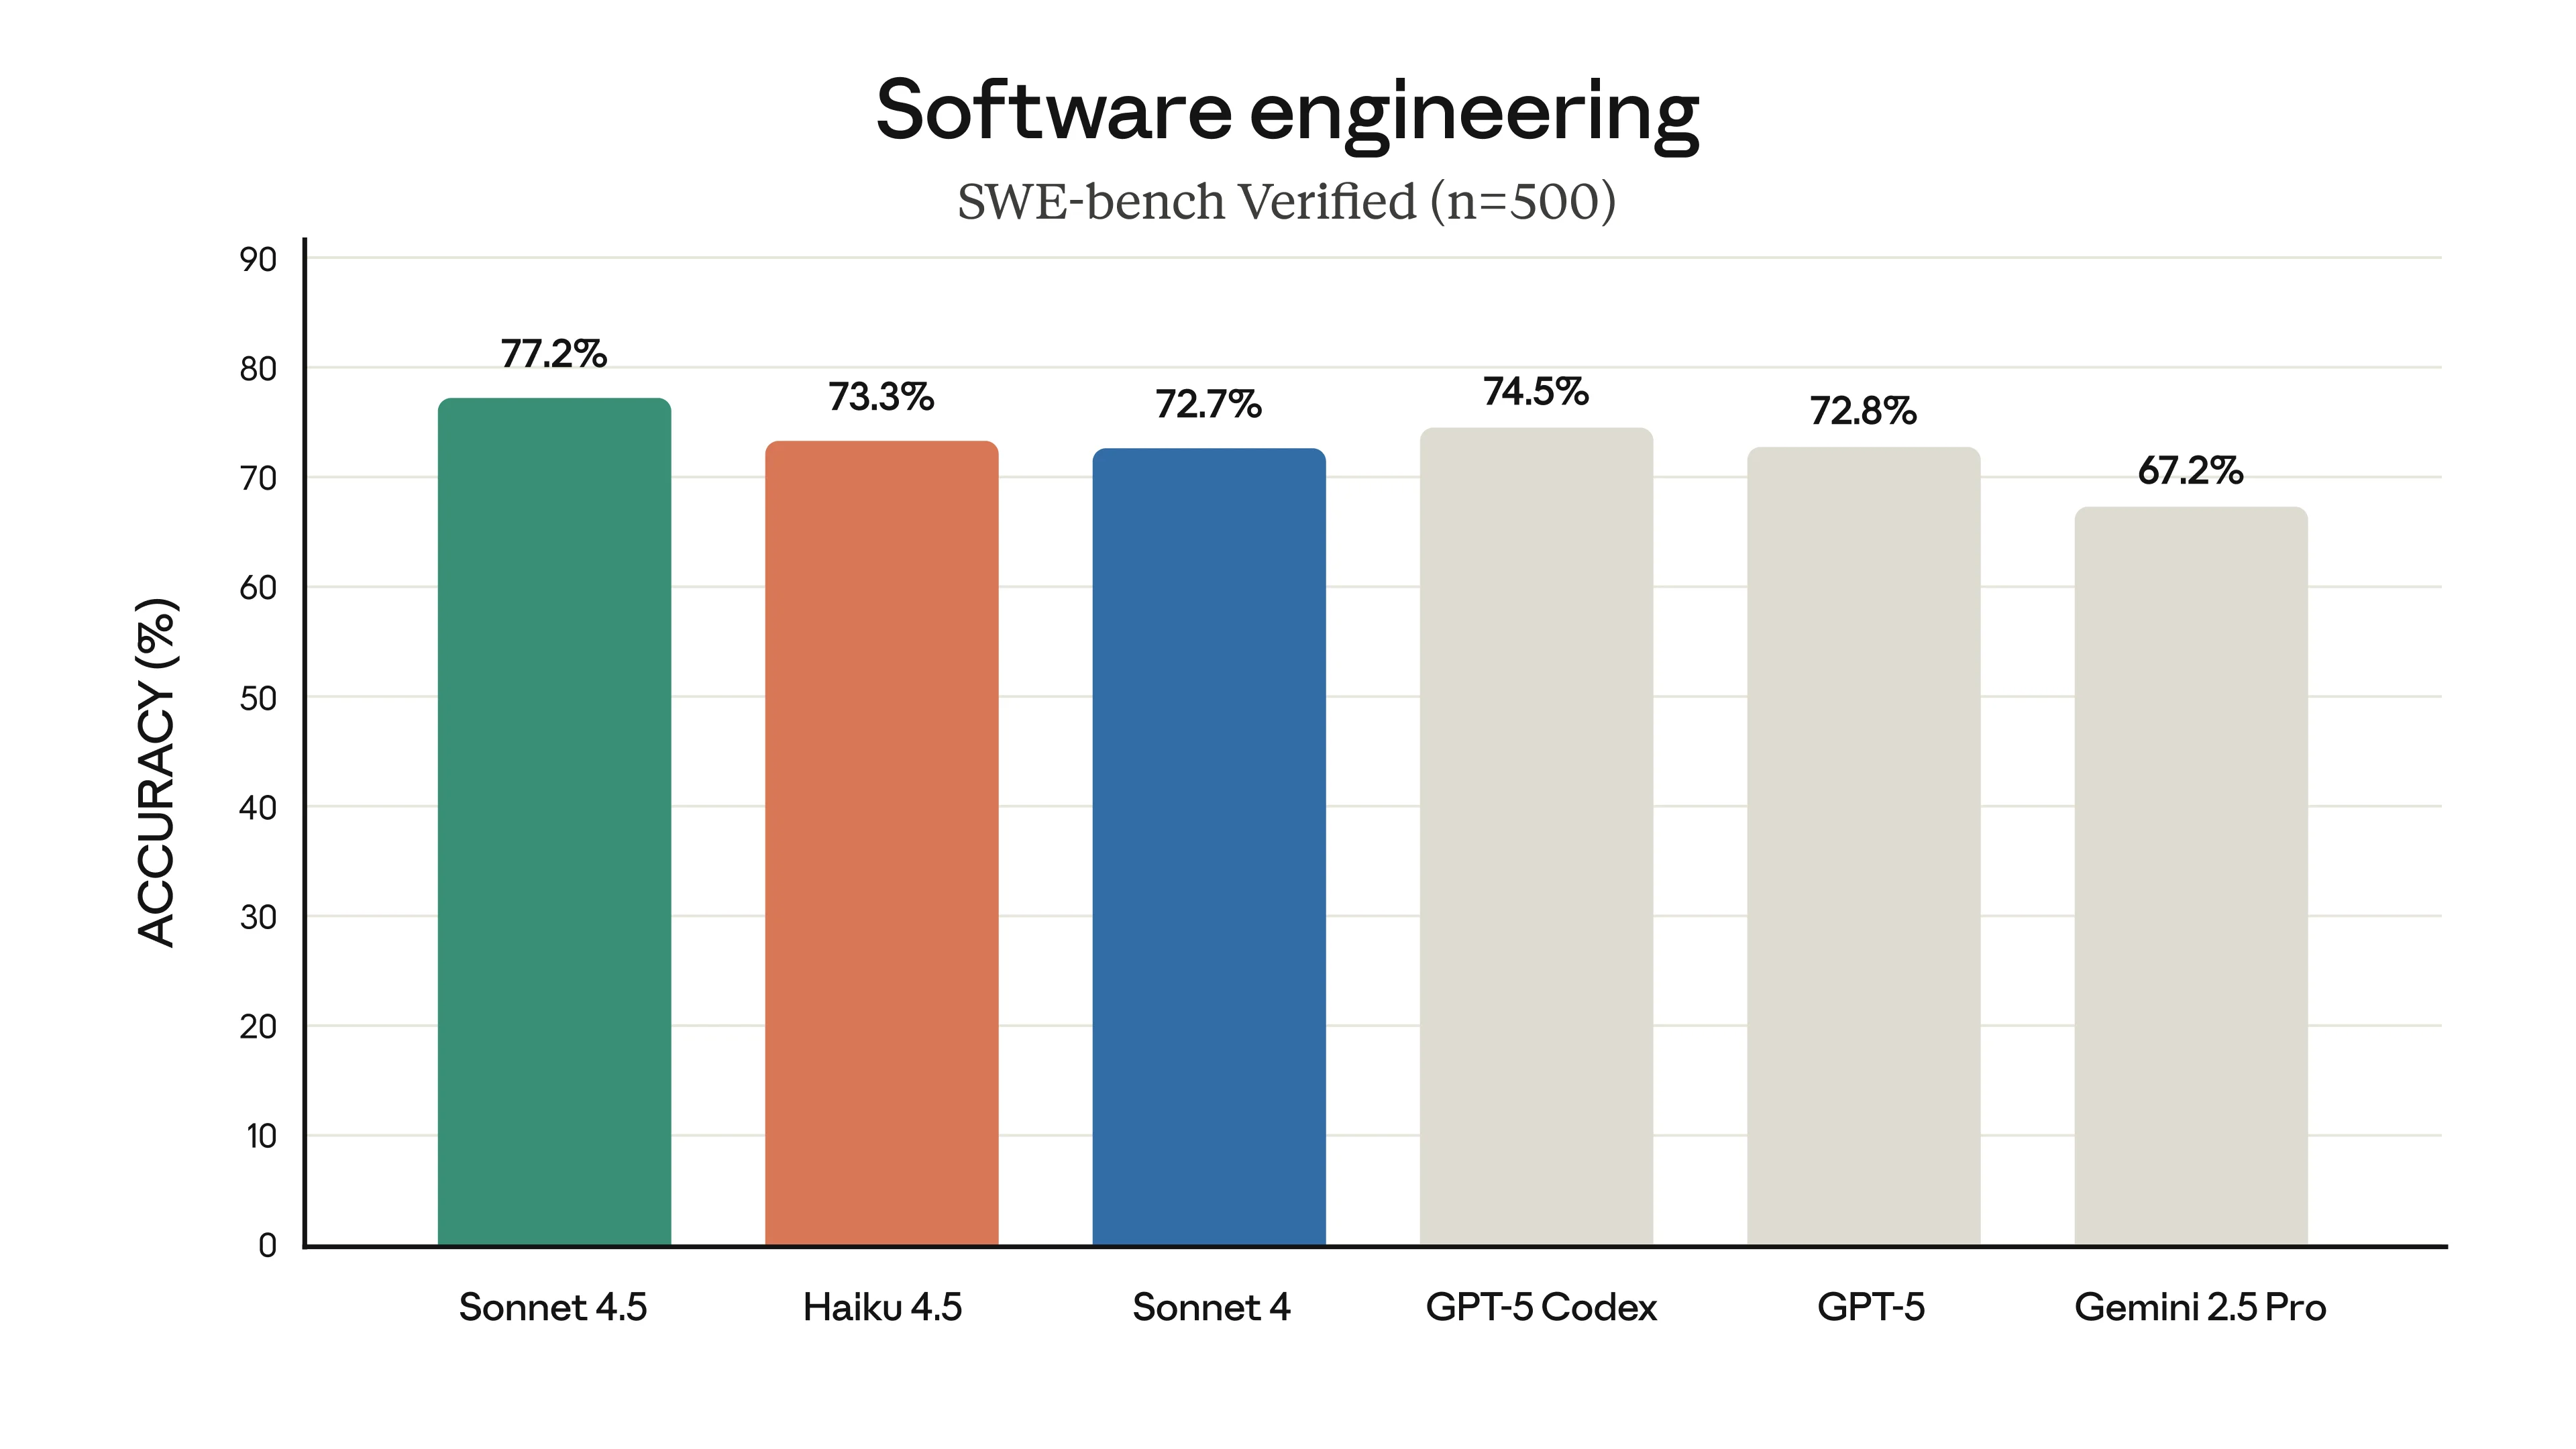
答案是,没什么亮眼之处。相比 GLM 4.6,它最主要的卖点是速度快一些,但使用成本却大约是对方的两倍。
| 模型 | 每百万输入 token 的价格(美元) | 每百万输出 token 的价格(美元) | 每秒 token 数 |
|---|---|---|---|
| GLM 4.6 | $0.60 | $2.20 | 46 |
| Claude Haiku 4.5 | $1 | $5 | 106 |
另外,大家的普遍评价似乎认为它略逊于 Sonnet 4,而对于 GLM 4.6,人们往往更喜欢它,胜过 Sonnet 4。
目前还不清楚,通过 Anthropic 订阅在 Claude Code 中使用它时,具体会有哪些速率限制。不过,要想比 GLM 4.6 更划算,它的额度就必须给得非常大方,尤其是考虑到订阅价格几乎是对方的 10 倍。
因此,我觉得这次发布既没什么趣味,也没什么独特之处,完全没有改变大语言模型领域的格局。
Qwen3 VL 4B 和 8B
Qwen 继续扩充视觉模型系列,发布了基于 Qwen3 的 40 亿和 80 亿参数视觉语言模型(VLM)。
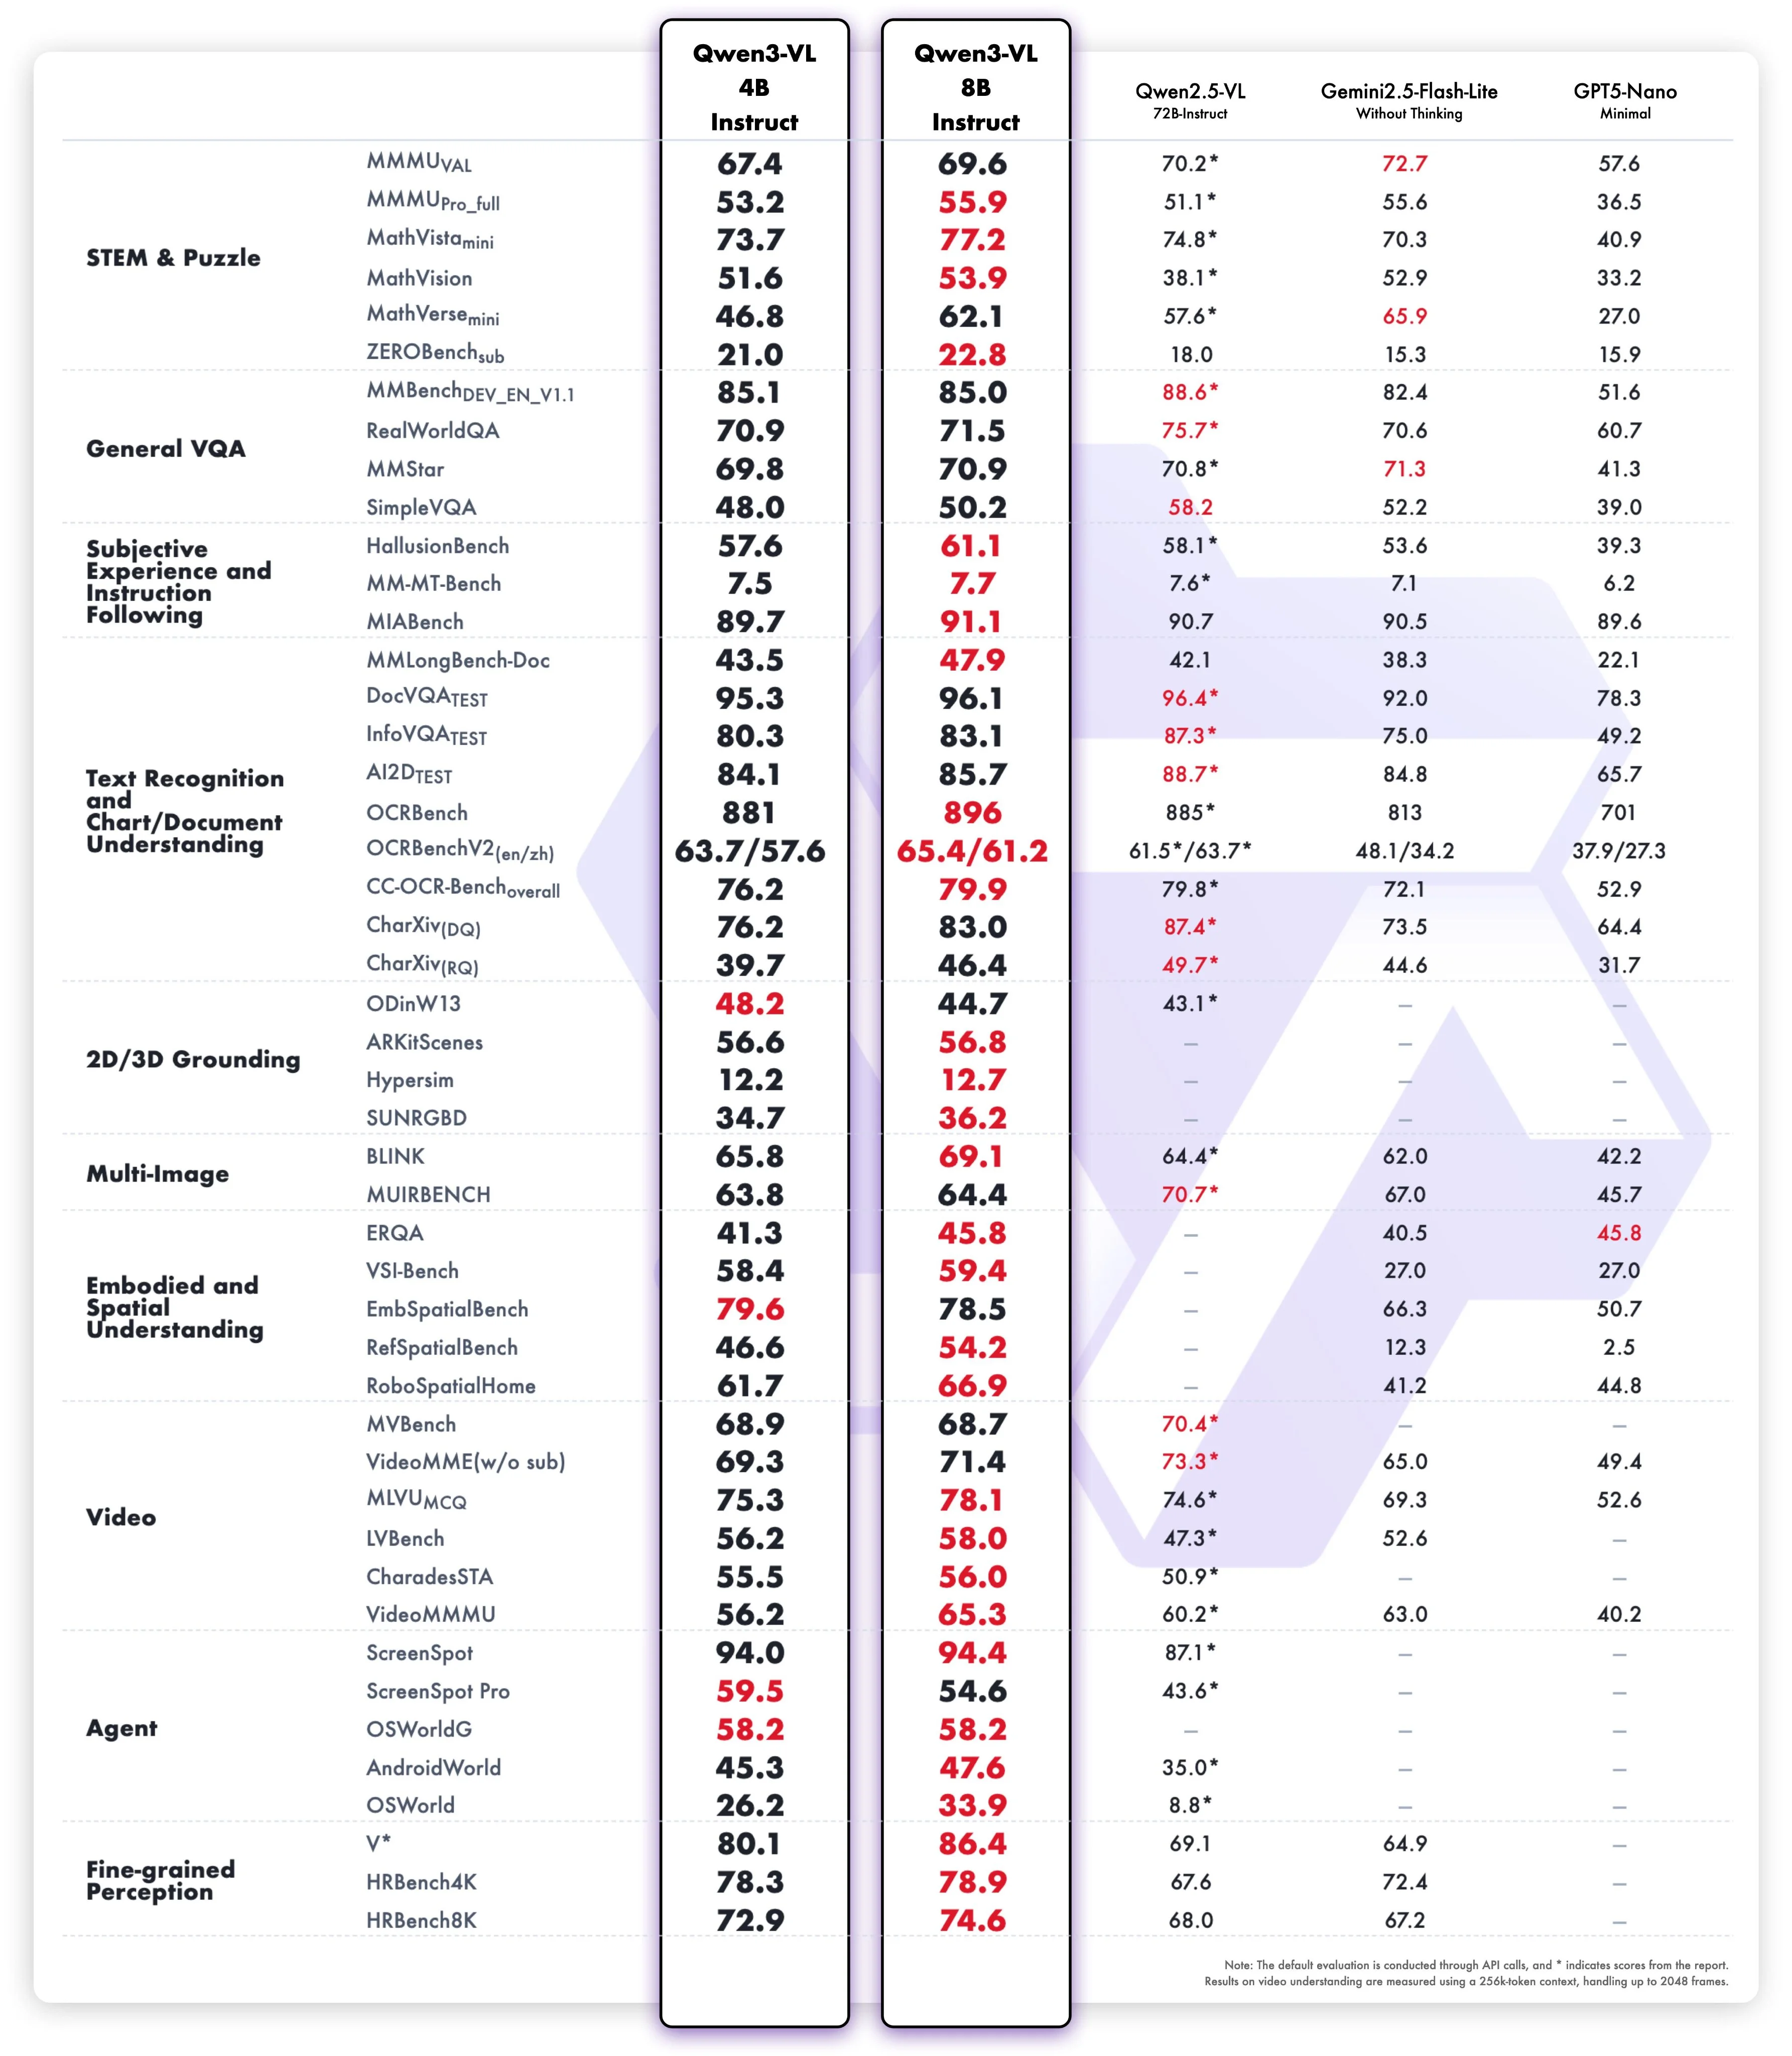
不出所料,它们在各自的参数规模中都排名第一。不过,考虑到目前开源 VLM 领域没多少竞争,这个第一也说明不了太多问题。尽管如此,它们依然是实力不错的模型,足以在实际场景中完成基础任务,而且还能在设备端部署。
值得注意的是:它们在非视觉基准测试中的表现降幅比更大参数版本稍大,但差距依然相对较小(绝对性能下降 1–2 个百分点)。
另一个有意思的地方是,这次发布了一个 80 亿参数模型。此前,在 Qwen3 的几轮更新中,他们一直没有更新 80 亿参数模型以及另外几个型号。而这次,他们既更新了 80 亿参数模型的后训练,也为其加入了视觉能力。这是个好消息,毕竟 80 亿参数的规模非常适合在家用 GPU 上进行小规模部署。
Veo 3.1
Google 为本就已经很强的 Veo 3 模型发布了新版本。
在这个版本中,他们大幅提升了图像转文本的表现,以及为电视剧、电影等作品制作像样视频的能力。比如,你可以上传一张某个地点的图片,然后让模型生成一段直升机从那里飞过的视频。
常见的基准测试还没有公布这个模型的分数,但从我目前看到的效果来看,它在图像生成视频方面应该接近顶尖水平。
研究
新的长上下文基准测试
长上下文通常是模型的一大难题。直到最近 GPT-5 等前沿模型发布,模型才算勉强能利用起完整的上下文窗口。
此前那些“最难”的长上下文基准测试,只是在测试模型从上下文中检索信息的能力;没有哪项测试要求模型利用这些信息完成复杂的任务。
现在,一个新的基准测试试图填补这个空白。LongCodeEdit 旨在衡量大语言模型在大型文件中查找、诊断和修复 bug 的能力。
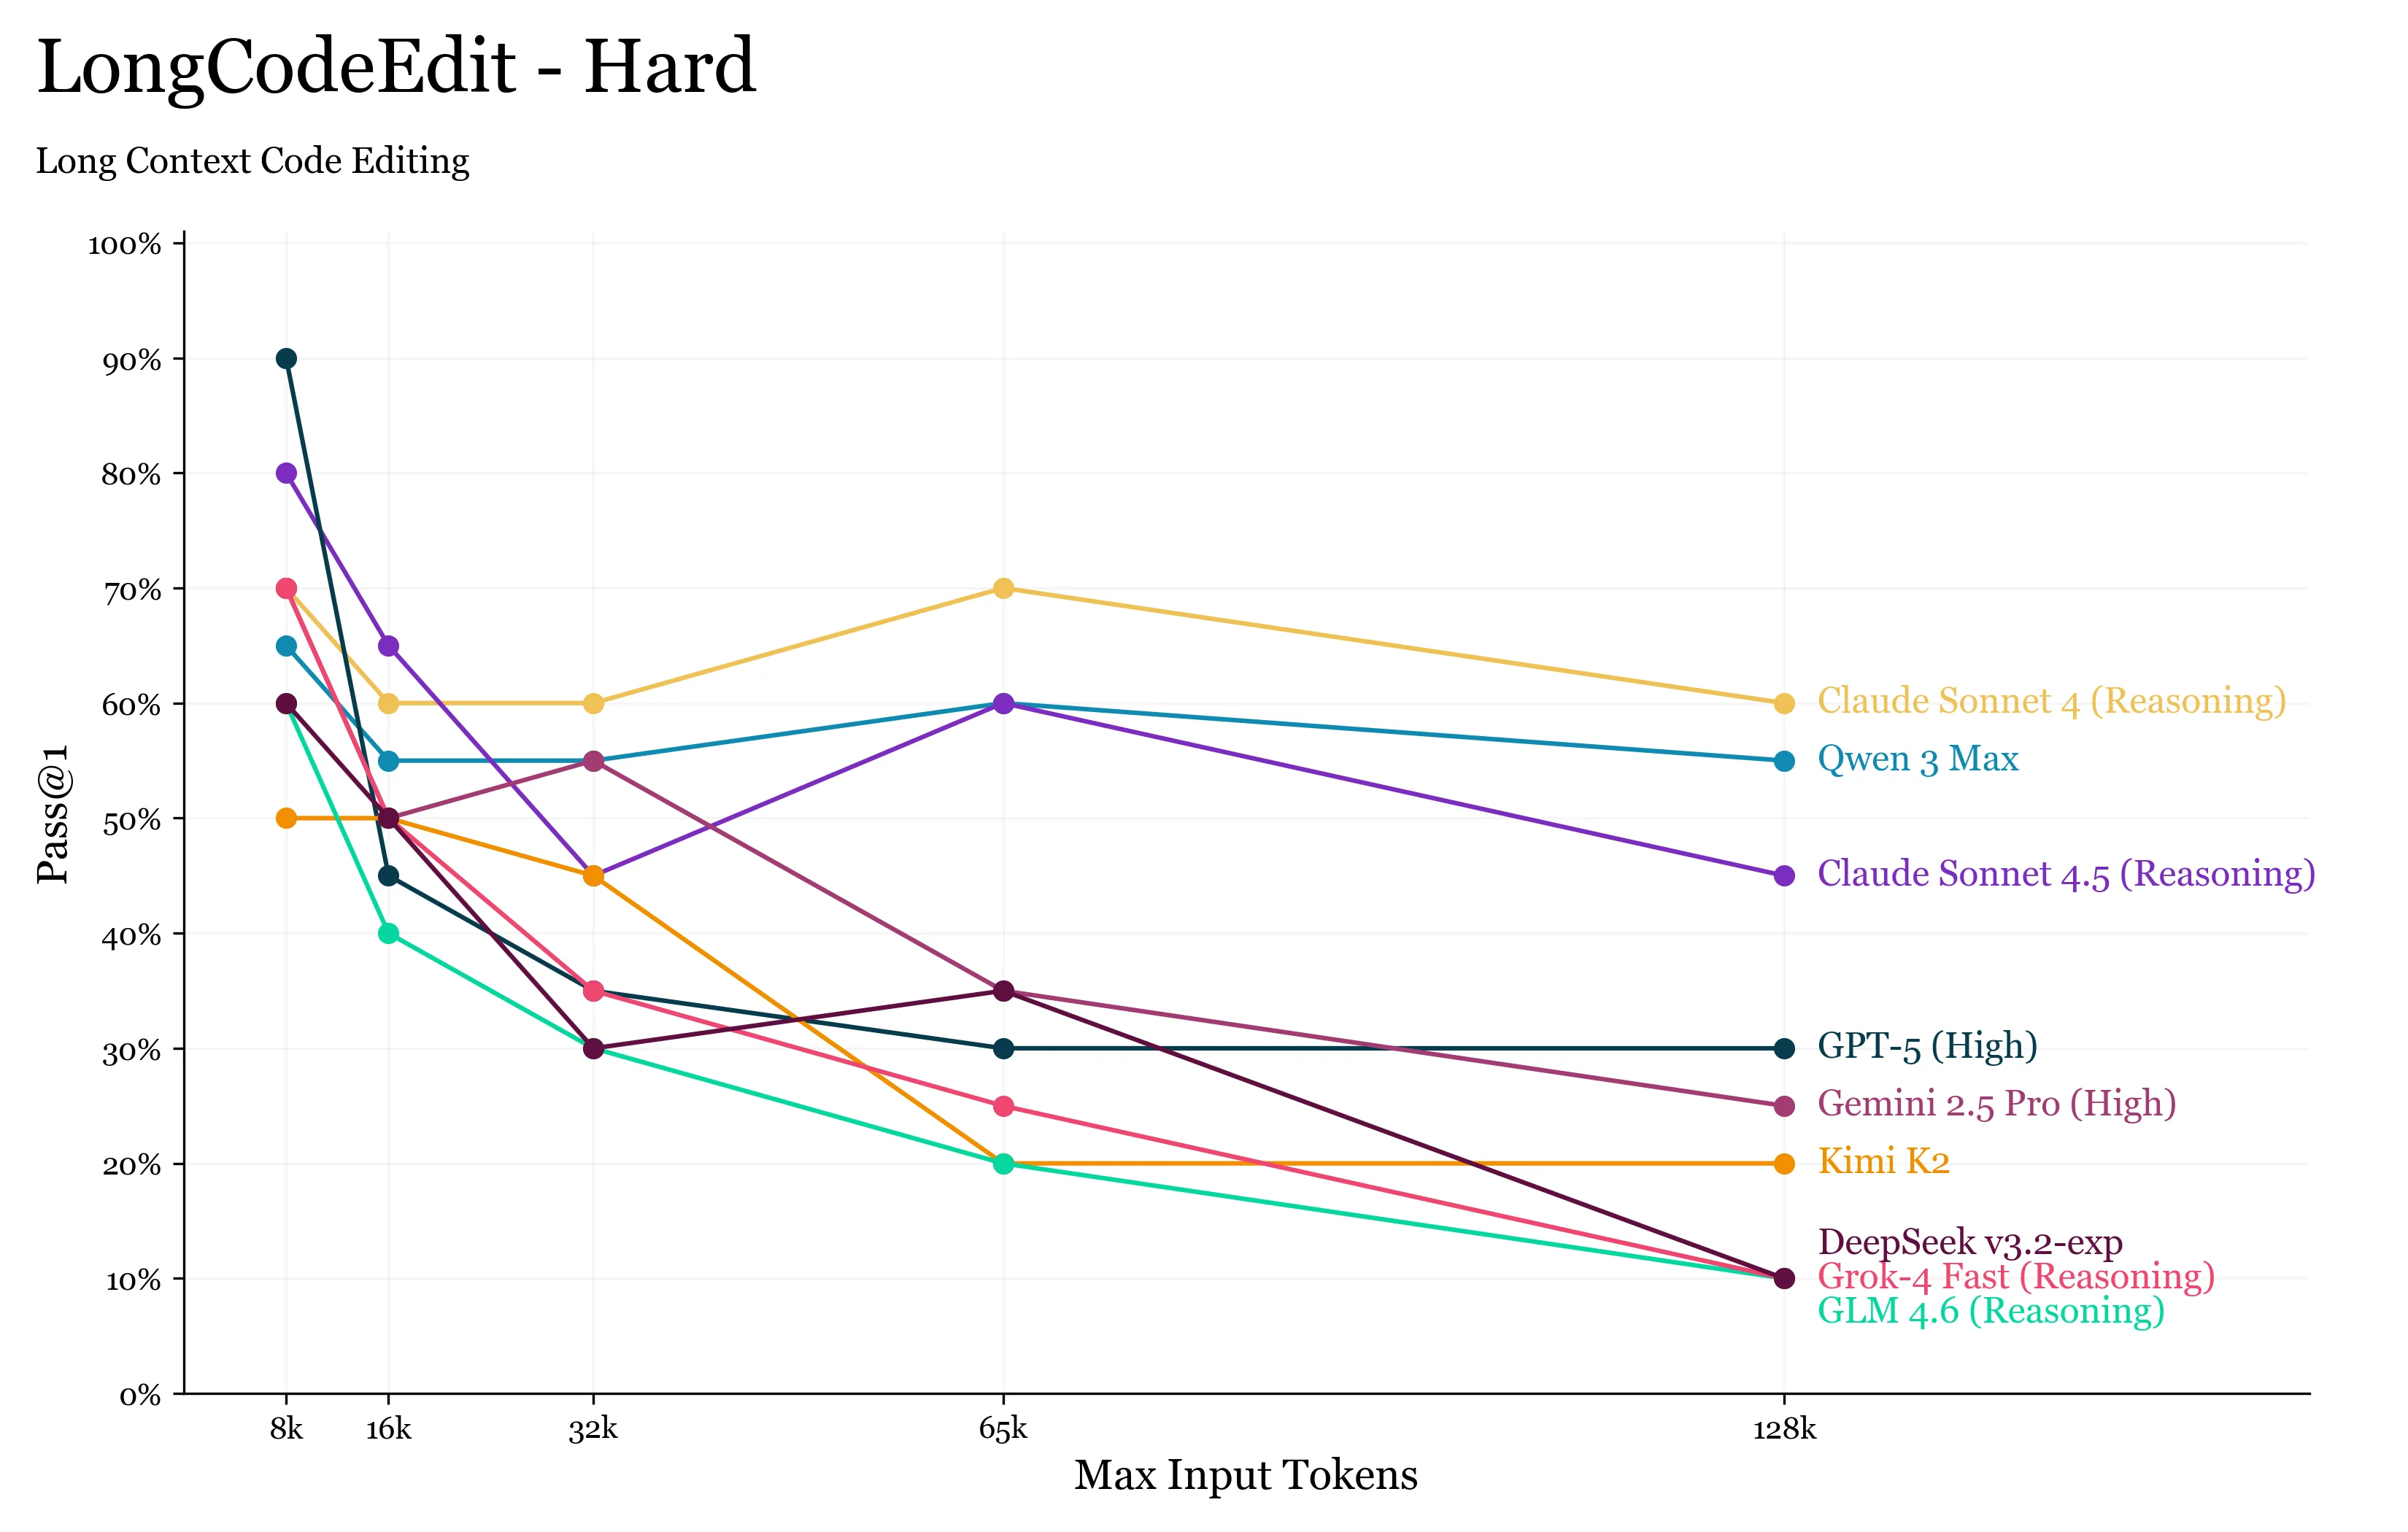
我们看到的结果与此前的长上下文基准测试如出一辙:大语言模型对其宣称的上下文窗口的利用能力差得惊人,即便只有 16k token,任务表现也会出现不可忽视的下降。
这个基准测试从现有代码基准测试中选取若干个能正常工作的函数,破坏其中一个,然后把所有函数放进同一个“文件”交给大语言模型。
令人意外的是,GPT-5 的表现明显下降,而 Sonnet 4 和 4.5 则基本能维持原有水平。 另外值得一提的是,Qwen 团队凭借旗舰模型 Qwen3 Max 拿到了第二名。
结语
希望你喜欢本周的新闻。如果你想每周都收到这些资讯,记得在下方订阅我们的邮件列表。