Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
resumo
- Claude Haiku recebe uma atualização depois de quase um ano
- Veo 3.1 é bom em conversão de imagem para vídeo
- Novos benchmarks mostram o quão ruins os LLMs são em tarefas de contexto longo
- E mais modelos Qwen3 VL
Lançamentos
Claude Haiku 4.5
Já faz quase um ano desde o último lançamento do Claude Haiku, então não te culpo se você esqueceu deste modelo. Haiku é o membro menor da Trindade Claude, e sua atualização mais recente tinha sido da série Claude 3.5 de modelos, que, dependendo de como você conta, significa que está 5 versões atrás de seus irmãos Opus e Sonnet.
Haiku 4.5 está sendo divulgado como um substituto do Sonnet 4, o que o coloca diretamente contra o modelo GLM 4.6, então como ele se compara?
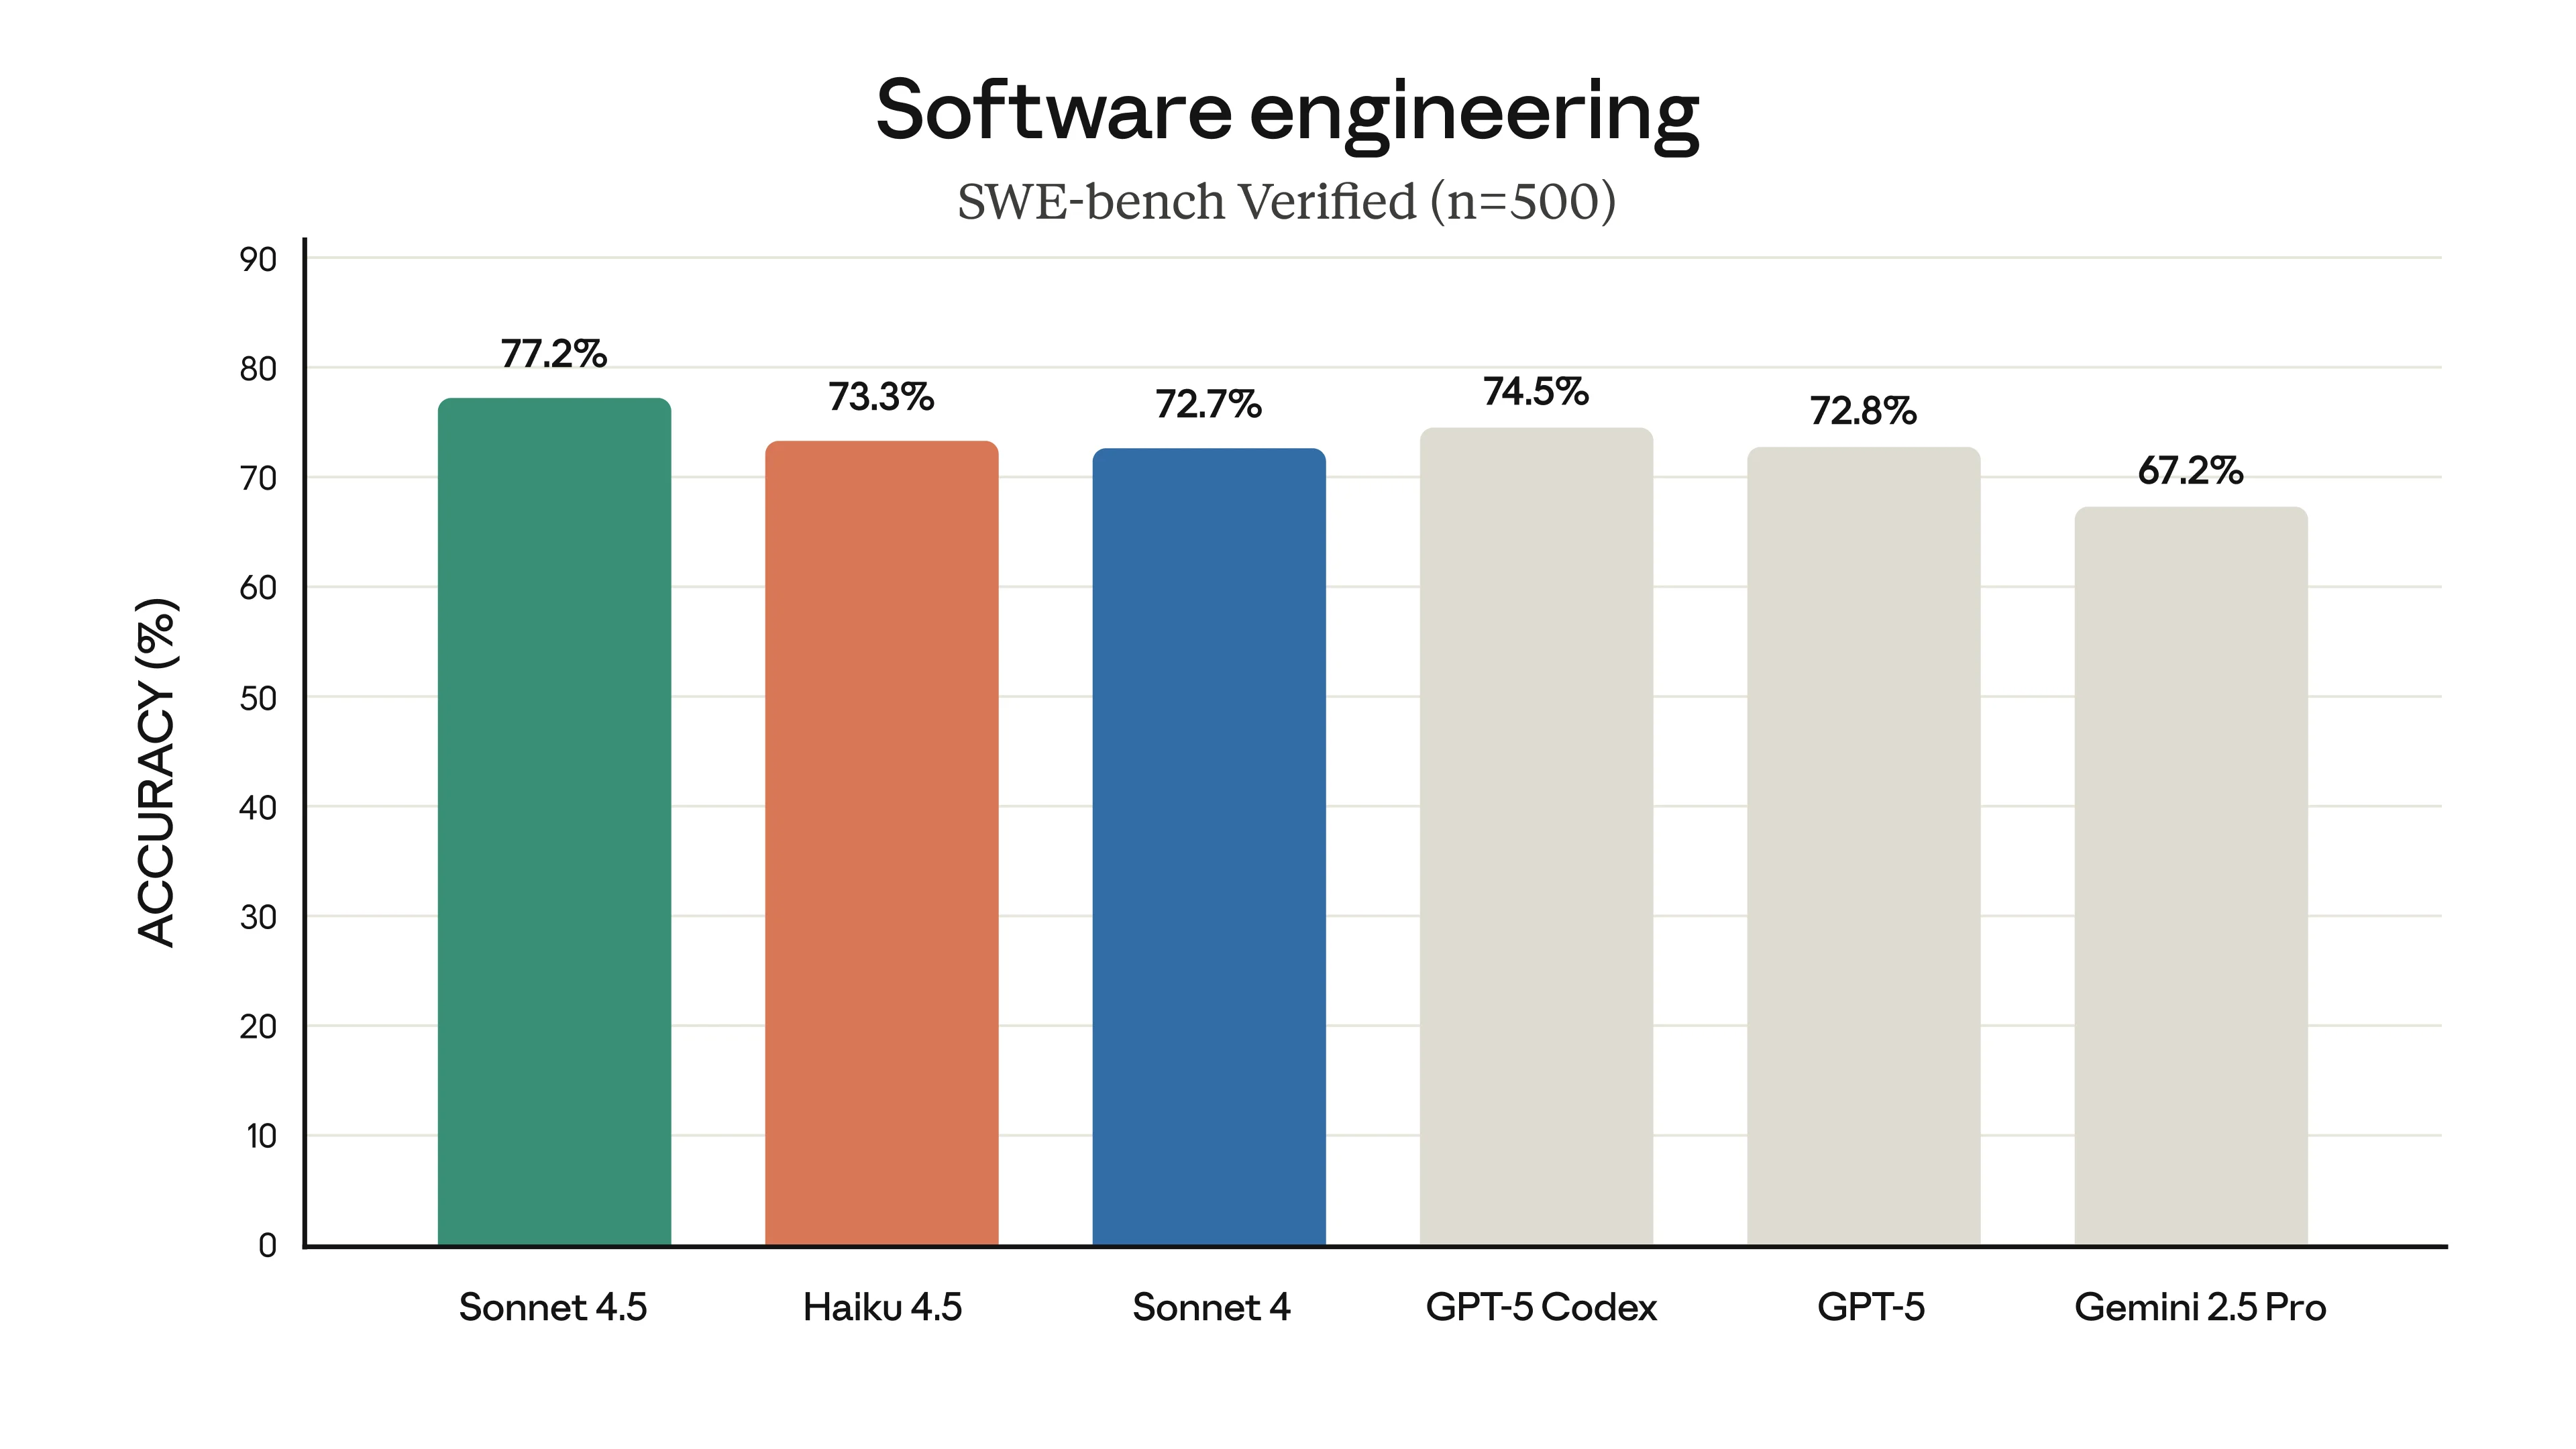
Não muito impressionante, é a resposta. Seu principal ponto de venda sobre o GLM 4.6 é que é um pouco mais rápido, mas por outro lado é cerca de duas vezes mais caro de usar.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| GLM 4.6 | $0.60 | $2.20 | 46 |
| Claude Haiku 4.5 | $1 | $5 | 106 |
Além disso, o consenso público parece colocá-lo um pouco abaixo do Sonnet 4, enquanto para o GLM 4.6, as pessoas tendem a preferi-lo ao Sonnet 4.
Atualmente não se sabe quais são os limites de taxa para ele no Claude code com a assinatura anthropic. Mas os limites terão que ser extremamente generosos para torná-lo um valor melhor que o GLM 4.6, especialmente considerando que a assinatura é quase 10 vezes mais cara.
Por causa disso, não acho que seja um lançamento muito interessante ou único e não muda o cenário de LLM de forma alguma.
Qwen3 VL 4B e 8B
Qwen continua a lançar modelos em sua linha de visão, liberando VLMs de 4 e 8 bilhões de parâmetros baseados em seus modelos Qwen3.
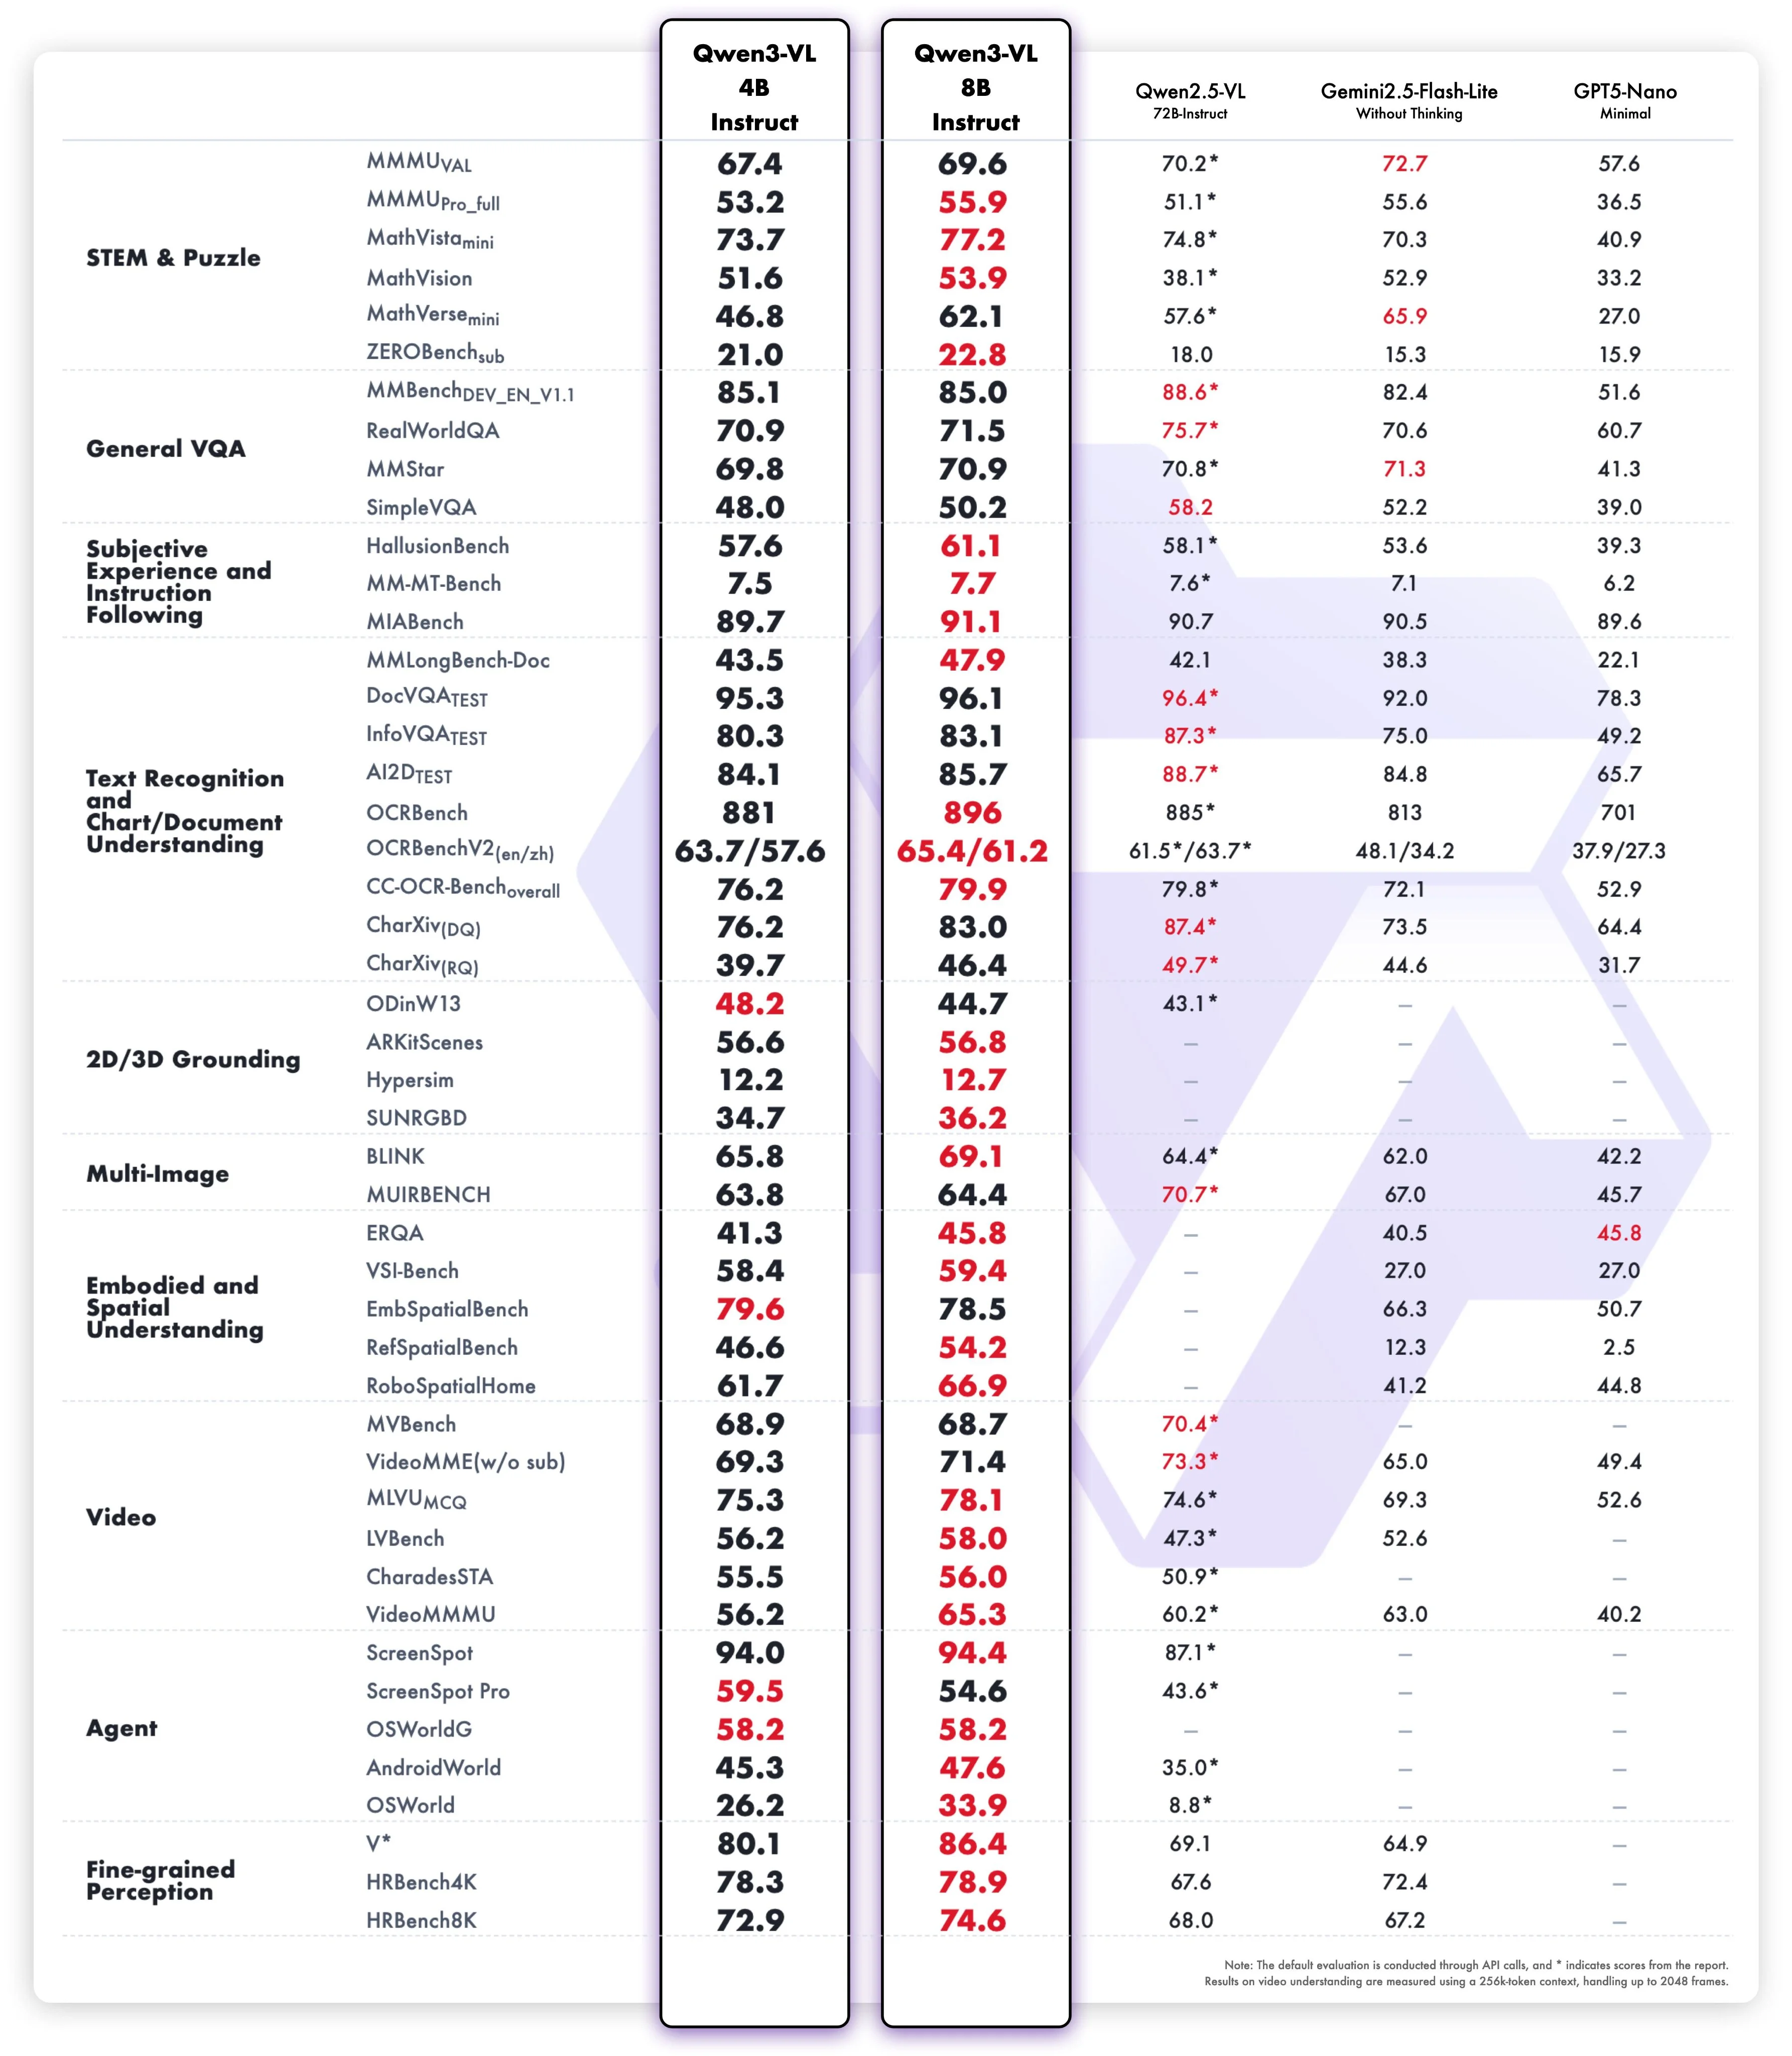
Como esperado, eles são número um para seus respectivos tamanhos. Não que isso realmente signifique muito, dado que não há muita competição no espaço VLM de código aberto agora. Apesar disso, eles ainda são modelos fortes o suficiente para torná-los utilizáveis no mundo real para tarefas básicas, podendo ser implantados no dispositivo.
Nota importante: os benchmarks sem visão diminuíram um pouco mais do que nas variantes maiores, mas a diferença ainda é relativamente pequena (queda de 1-2% no desempenho absoluto)
Outro aspecto interessante é o lançamento de um modelo de 8 bilhões de parâmetros. Anteriormente, em suas atualizações do Qwen 3, eles haviam negligenciado atualizar seu modelo de 8 bilhões de parâmetros junto com alguns outros. Mas agora com este lançamento, eles atualizaram o pós-treinamento de seu modelo de 8 bilhões de parâmetros e também adicionaram capacidades de visão a ele, o que é bom de ver, já que o tamanho de 8 bilhões de parâmetros é ideal para pequenas implantações de GPU domésticas.
Veo 3.1
Google lançou uma nova versão de seu já muito forte modelo Veo 3.
Para esta versão, eles melhoraram muito o desempenho de imagem para texto e a capacidade de fazer criações de vídeo adequadas para programas de TV ou filmes. Por exemplo, você pode enviar uma imagem de um local e então pedir ao modelo para gerar vídeo de um helicóptero voando sobre ele.
Os benchmarks usuais ainda não lançaram pontuações para o modelo, mas pelo que tenho visto, parece estar perto do topo para geração de imagem para vídeo.
Pesquisa
Novos Benchmarks de Contexto Longo
Contexto longo geralmente é muito difícil para os modelos. Apenas com alguns dos lançamentos de fronteira recentes como GPT-5 os modelos conseguiram usar remotamente sua janela de contexto completa.
Os benchmarks de contexto longo “mais difíceis” apenas testavam quão bom um modelo é em recuperar informações de seu contexto; nenhum dos benchmarks fazia o modelo fazer algo complexo com essas informações.
Agora temos um novo benchmark que busca preencher essa lacuna. LongCodeEdit é um benchmark que busca medir a capacidade de um LLM de encontrar, diagnosticar e corrigir bugs em um arquivo grande.
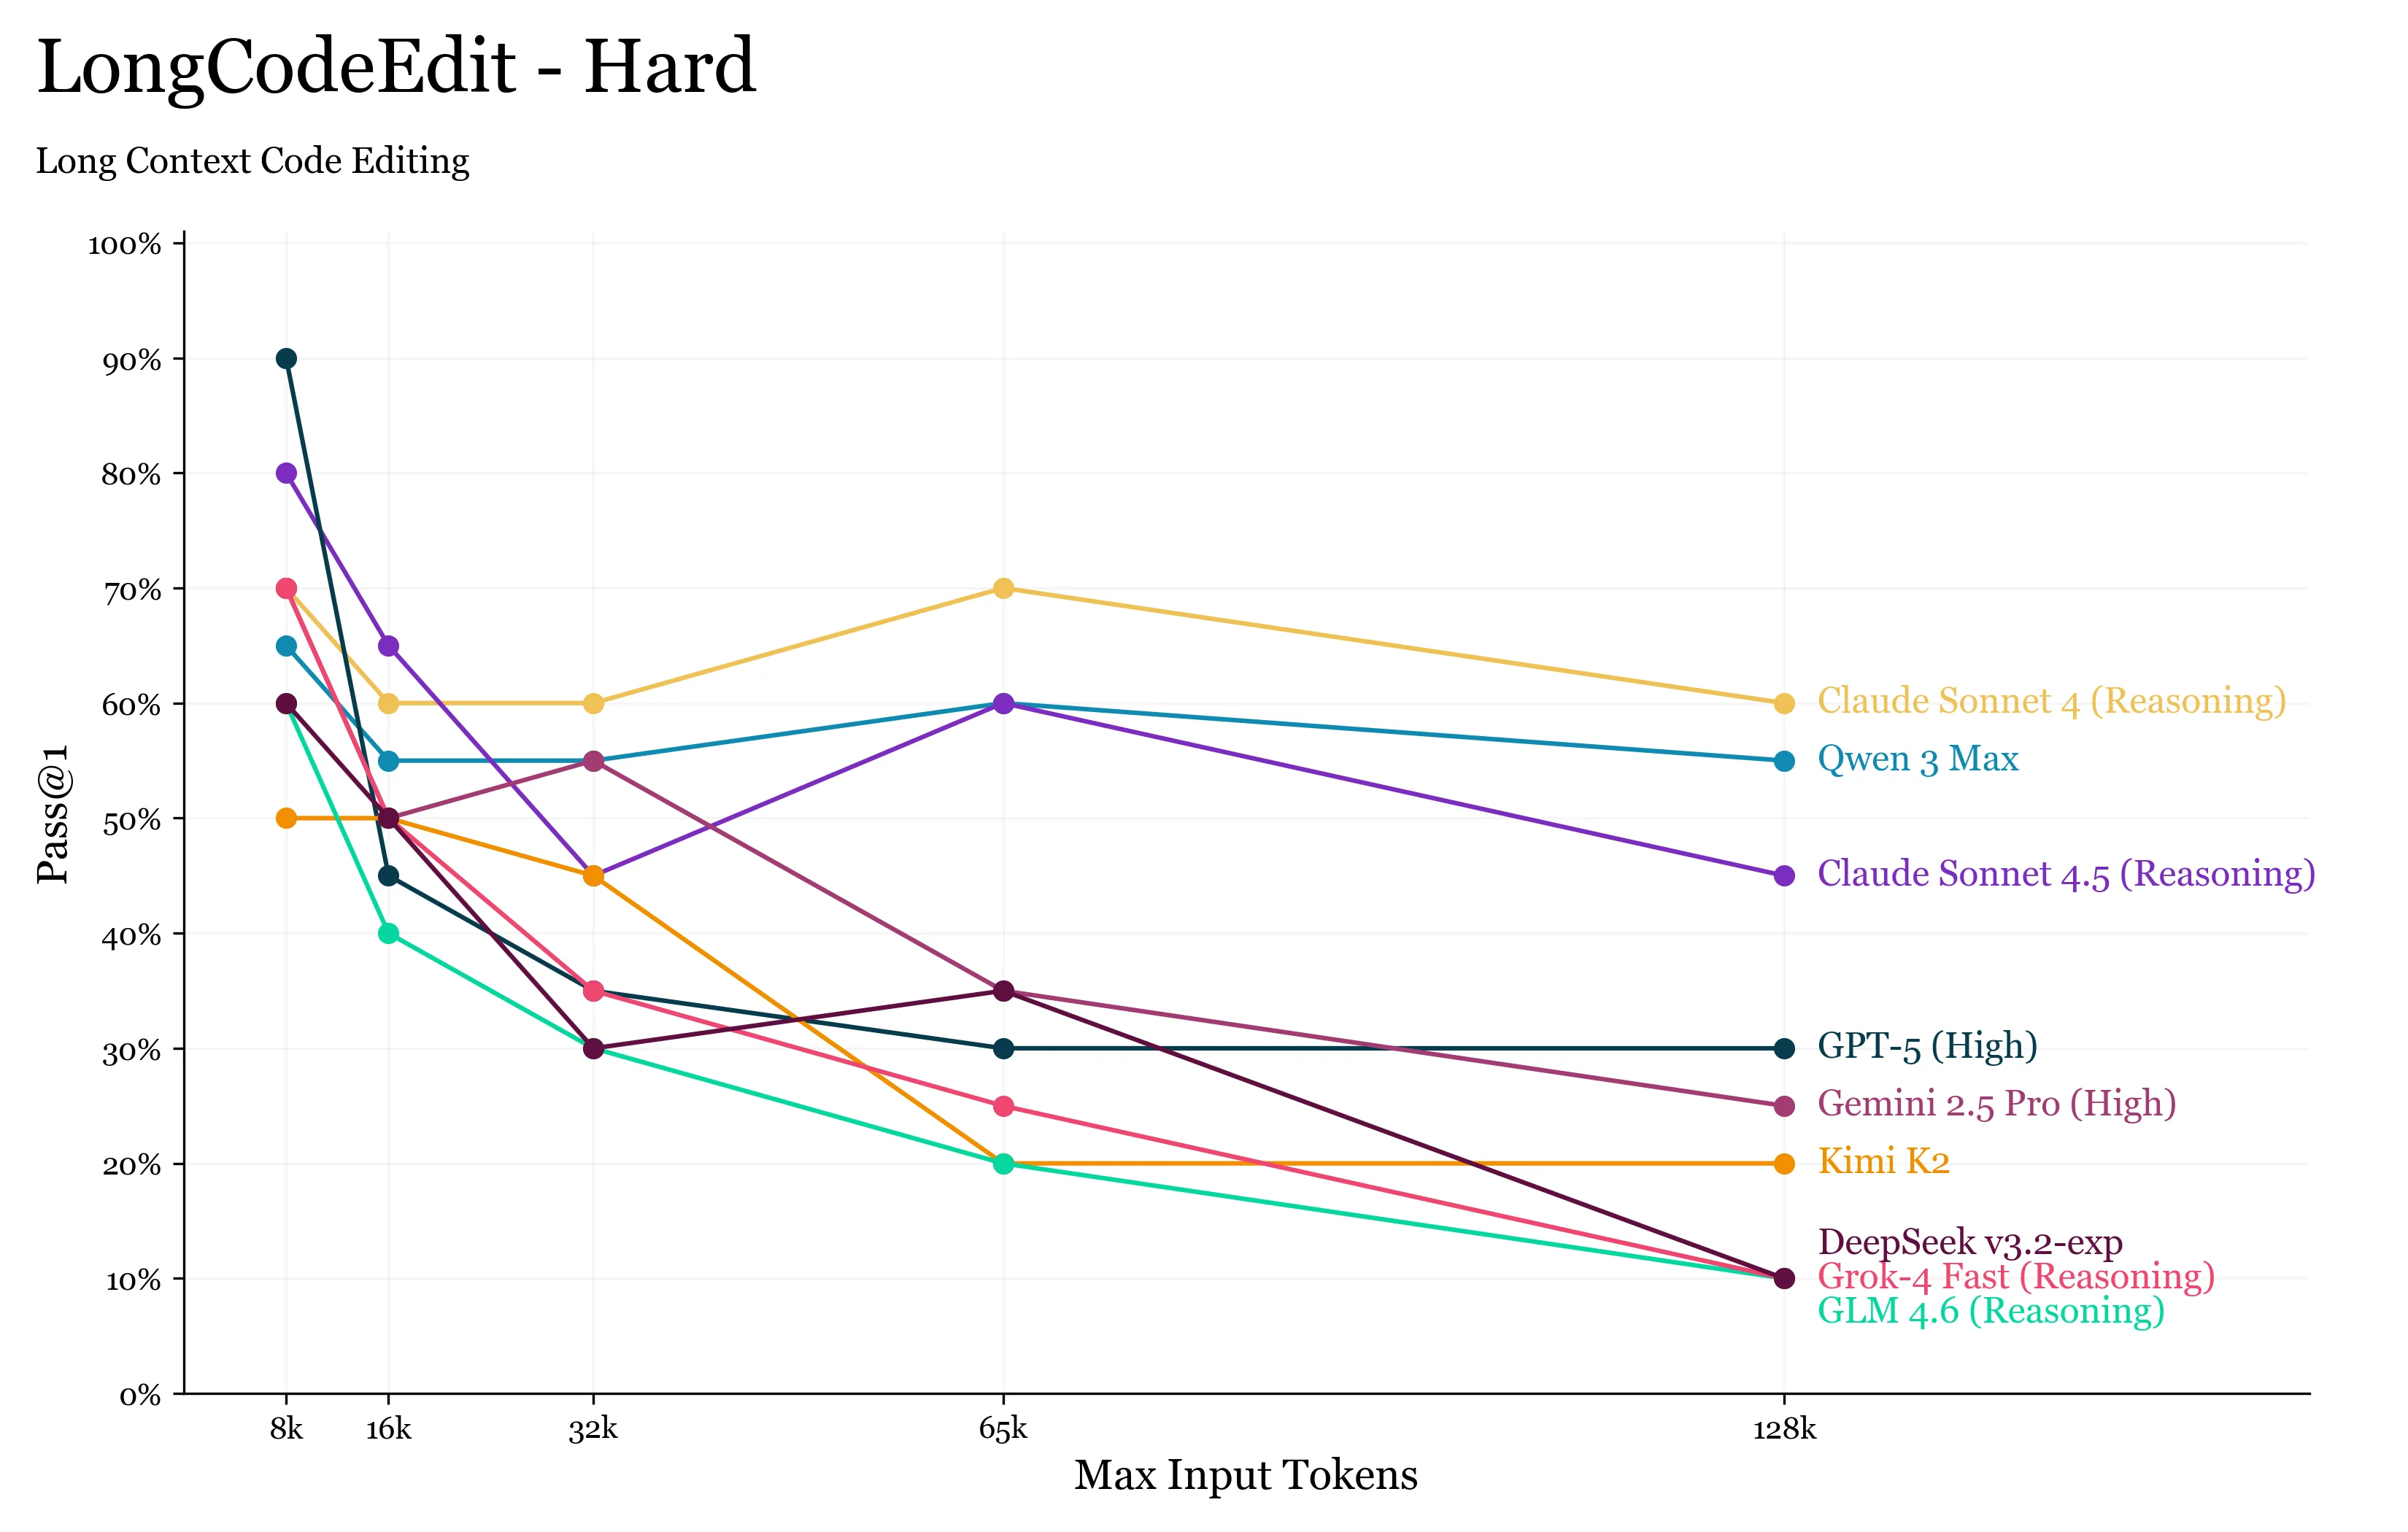
O que encontramos é mais do mesmo dos benchmarks de contexto longo anteriores: que os LLMs são notavelmente ruins em usar sua janela de contexto reportada, já que mesmo com 16k tokens vemos degradação de desempenho não trivial nas tarefas.
O benchmark pega várias funções funcionais de benchmarks de código existentes, corrompe uma única delas e então passa todas elas juntas em um único “arquivo” para o LLM.
Surpreendentemente, descobrimos que o GPT-5 degrada significativamente, enquanto Sonnet 4 e 4.5 conseguem manter aproximadamente suas capacidades. Também digno de nota é a equipe Qwen ficando em segundo lugar, com seu modelo carro-chefe Qwen3 Max.
Conclusão
Espero que você tenha gostado das notícias desta semana. Se você quiser receber as notícias toda semana, certifique-se de se juntar à nossa lista de e-mails abaixo.