Nota: Este artículo fue traducido automáticamente con OpenAI GPT-5.5 mediante Codex CLI; la calidad puede verse degradada, especialmente en la terminología técnica.
Noticias
OpenAI resuelve un problema del milenio
Los Problemas del Premio del Milenio son un conjunto de 7 problemas matemáticos extremadamente difíciles seleccionados por el Instituto Clay de Matemáticas en 2000. Son algunos de los problemas más famosos de las matemáticas, y resolver uno sería un logro culminante para cualquier matemático.
OpenAI ha afirmado que ha resuelto uno de estos problemas, el problema de Navier-Stokes, que pertenece a la dinámica de fluidos.
Usaron un modelo no lanzado que todavía están entrenando, utilizando 10.000 subagentes en paralelo, con un coste estimado de 6,5 millones de dólares en tokens (si se pagara usando precios de API).
Sin embargo, esta afirmación no ha estado exenta de controversia. Otro grupo también ha estado trabajando en ello, incluido Levent Alpöge, el empleado de Anthropic que recientemente encontró un contraejemplo a la conjetura jacobiana.
Habían estado trabajando en el mismo problema (fuera del trabajo) usando una mezcla de modelos de Anthropic y OpenAI, y habían logrado demostrar una afirmación que era uno de los bloques fundamentales para probar Navier-Stokes, pero todavía no habían podido resolver Navier-Stokes en sí. Afirmaron que OpenAI había estado espiando lo que deberían haber sido sus chats con retención de datos cero, usando sus resultados para ayudar a construir su propia demostración.
OpenAI niega estas acusaciones, y parece que tiene razón; la prueba que usaron era para una forma distinta (demostrándola para un sistema diferente). También dijeron que se pusieron en contacto y ofrecieron asociarse con el grupo de Levent, además de ofrecerles la autoría principal del artículo (excepto a Levent, ya que era empleado de Anthropic), lo cual rechazaron.
De cualquier manera, esto es muy importante para el futuro de las matemáticas, ya que uno de sus problemas más famosos cae ante un sistema de IA completamente automatizado. Hay rumores de que tanto OpenAI como Anthropic están trabajando en los otros cinco Problemas del Milenio que siguen sin resolverse, así que veremos qué laboratorio consigue el próximo.
Lanzamientos
GPT-6 Astra
La semana pasada comenté las primeras impresiones que me dejó el acceso de unas 24 horas que tuvimos a GPT-6 Astra, y ahora que tanto yo como la comunidad hemos tenido tiempo de probarlo a fondo, puedo dar una recomendación adecuada (¡o no!) sobre el modelo.
Empezando por lo bueno, sus capacidades de visión y uso de computadora son tan sólidas como parecían inicialmente la semana pasada. Es, con mucha diferencia, el mejor modelo en ambas áreas, haciendo que todos los demás modelos parezcan irrelevantes en comparación para esas tareas.
También es muy sólido en planificación y revisión de código. Su atención al detalle es impresionante: detecta errores complicados y piensa en escenarios que la mayoría de los otros modelos pasan por alto.
También parece estar bien alineado. En Vending Bench, que prueba modelos gestionando un negocio simulado de máquinas expendedoras, supera a los modelos Claude, que han usado comportamiento mal alineado, como mentir a clientes y a otras empresas contra las que compiten para salir adelante a cualquier coste. GPT-6 no solo supera a los modelos Claude y gana más dinero, sino que lo hace sin necesidad de perjudicar a ningún usuario por el camino.
Por desgracia, su capacidad para revisar código no se ha traducido en código propio consistentemente bueno. La gente está reportando código comprimido y difícil de mantener, especialmente cuando el modelo parece pensar que nadie lo va a leer. El código normalmente funciona, pero la mantenibilidad a largo plazo, incluso para otros LLMs, puede empeorar con el tiempo.
También tiene una tendencia molesta a rodear las herramientas de su entorno, usando scripts de Python y TypeScript para editar archivos incluso cuando hay herramientas dedicadas de edición disponibles. Esto hace que sea más difícil seguir qué está cambiando el modelo mientras trabaja, y me recuerda a los problemas que vimos con Gemini 3 Pro, donde parecía confundido por su propio entorno.
Luego están los límites de uso. Como esperaba la semana pasada, Astra está agotando los límites de las suscripciones mucho más rápido que los modelos anteriores de OpenAI. Esto ocurre incluso con razonamiento medio y modo rápido desactivado, así que no parece limitarse a quienes ejecutan el modelo con su configuración más cara.
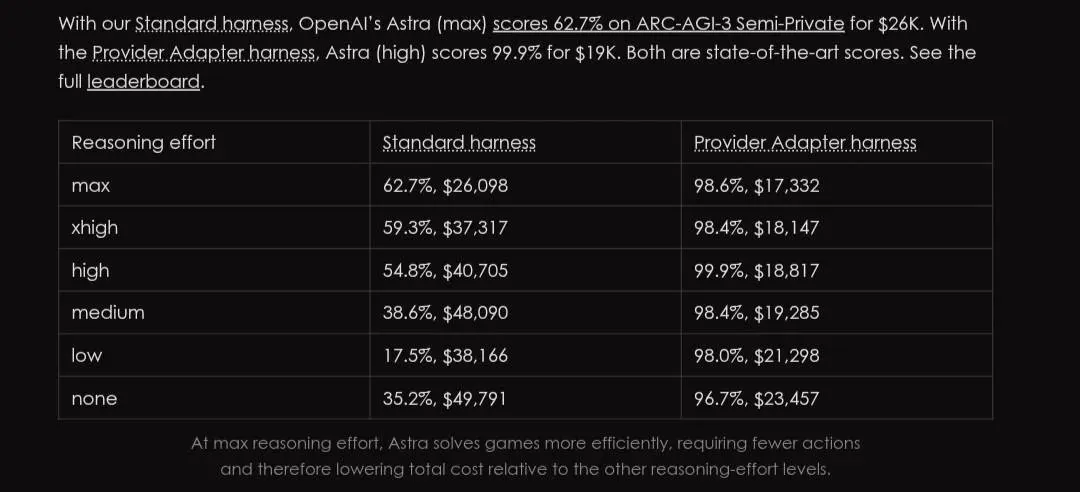
Curiosamente, bajar el esfuerzo de razonamiento quizá no sea la mejor manera de ahorrar tokens. Hay reportes de que Astra en realidad usa menos tokens con configuraciones de razonamiento más altas, y los resultados de ARC-AGI-3 que aparecen abajo muestran cómo un mayor esfuerzo puede llevar a un coste total menor. El modelo realiza menos acciones para resolver la tarea, así que darle más margen para pensar puede terminar siendo más barato en conjunto.
OpenAI ha reconocido estos problemas; con suerte, GPT-6.1 traerá el pulido que Astra necesita, pero habrá que ver cuánto de esto pueden resolver.
Por ahora, usaría Astra para visión y uso de computadora, junto con planificación y revisión de trabajos difíciles. Su calidad de código y sus límites de uso hacen que sea mucho más difícil recomendarlo como tu modelo de programación diario, incluso con la inteligencia adicional que aporta.
Apuntes rápidos
DeepSeek V4.1 Flash
DeepSeek ha lanzado una versión actualizada de su modelo flash más pequeño, V4.1.
A pesar del modesto aumento en el número de versión, este modelo tiene una arquitectura radicalmente distinta. Ya no es un modelo de lenguaje solo decodificador, que es lo que han sido casi todos los modelos desde el lanzamiento de ChatGPT.
En su lugar usa una arquitectura encoder-decoder, lo que significa que básicamente hay 2 modelos que hablan entre sí. El primer modelo se encarga de codificar y entender el prompt, y luego el segundo decide cuál debe ser el siguiente token a generar. Esto les permite usar un modelo ligero de mezcla de expertos para el encoder, y luego un modelo computacionalmente más pesado para el decoder.
También añaden una tabla de consulta Engram, que es algo parecido a una base de conocimiento integrada en los pesos del modelo, similar a Qwen 3.8 Flash Next.
Esta nueva arquitectura casi duplica el tamaño del modelo, pero en el proceso lo vuelve más eficiente y barato.
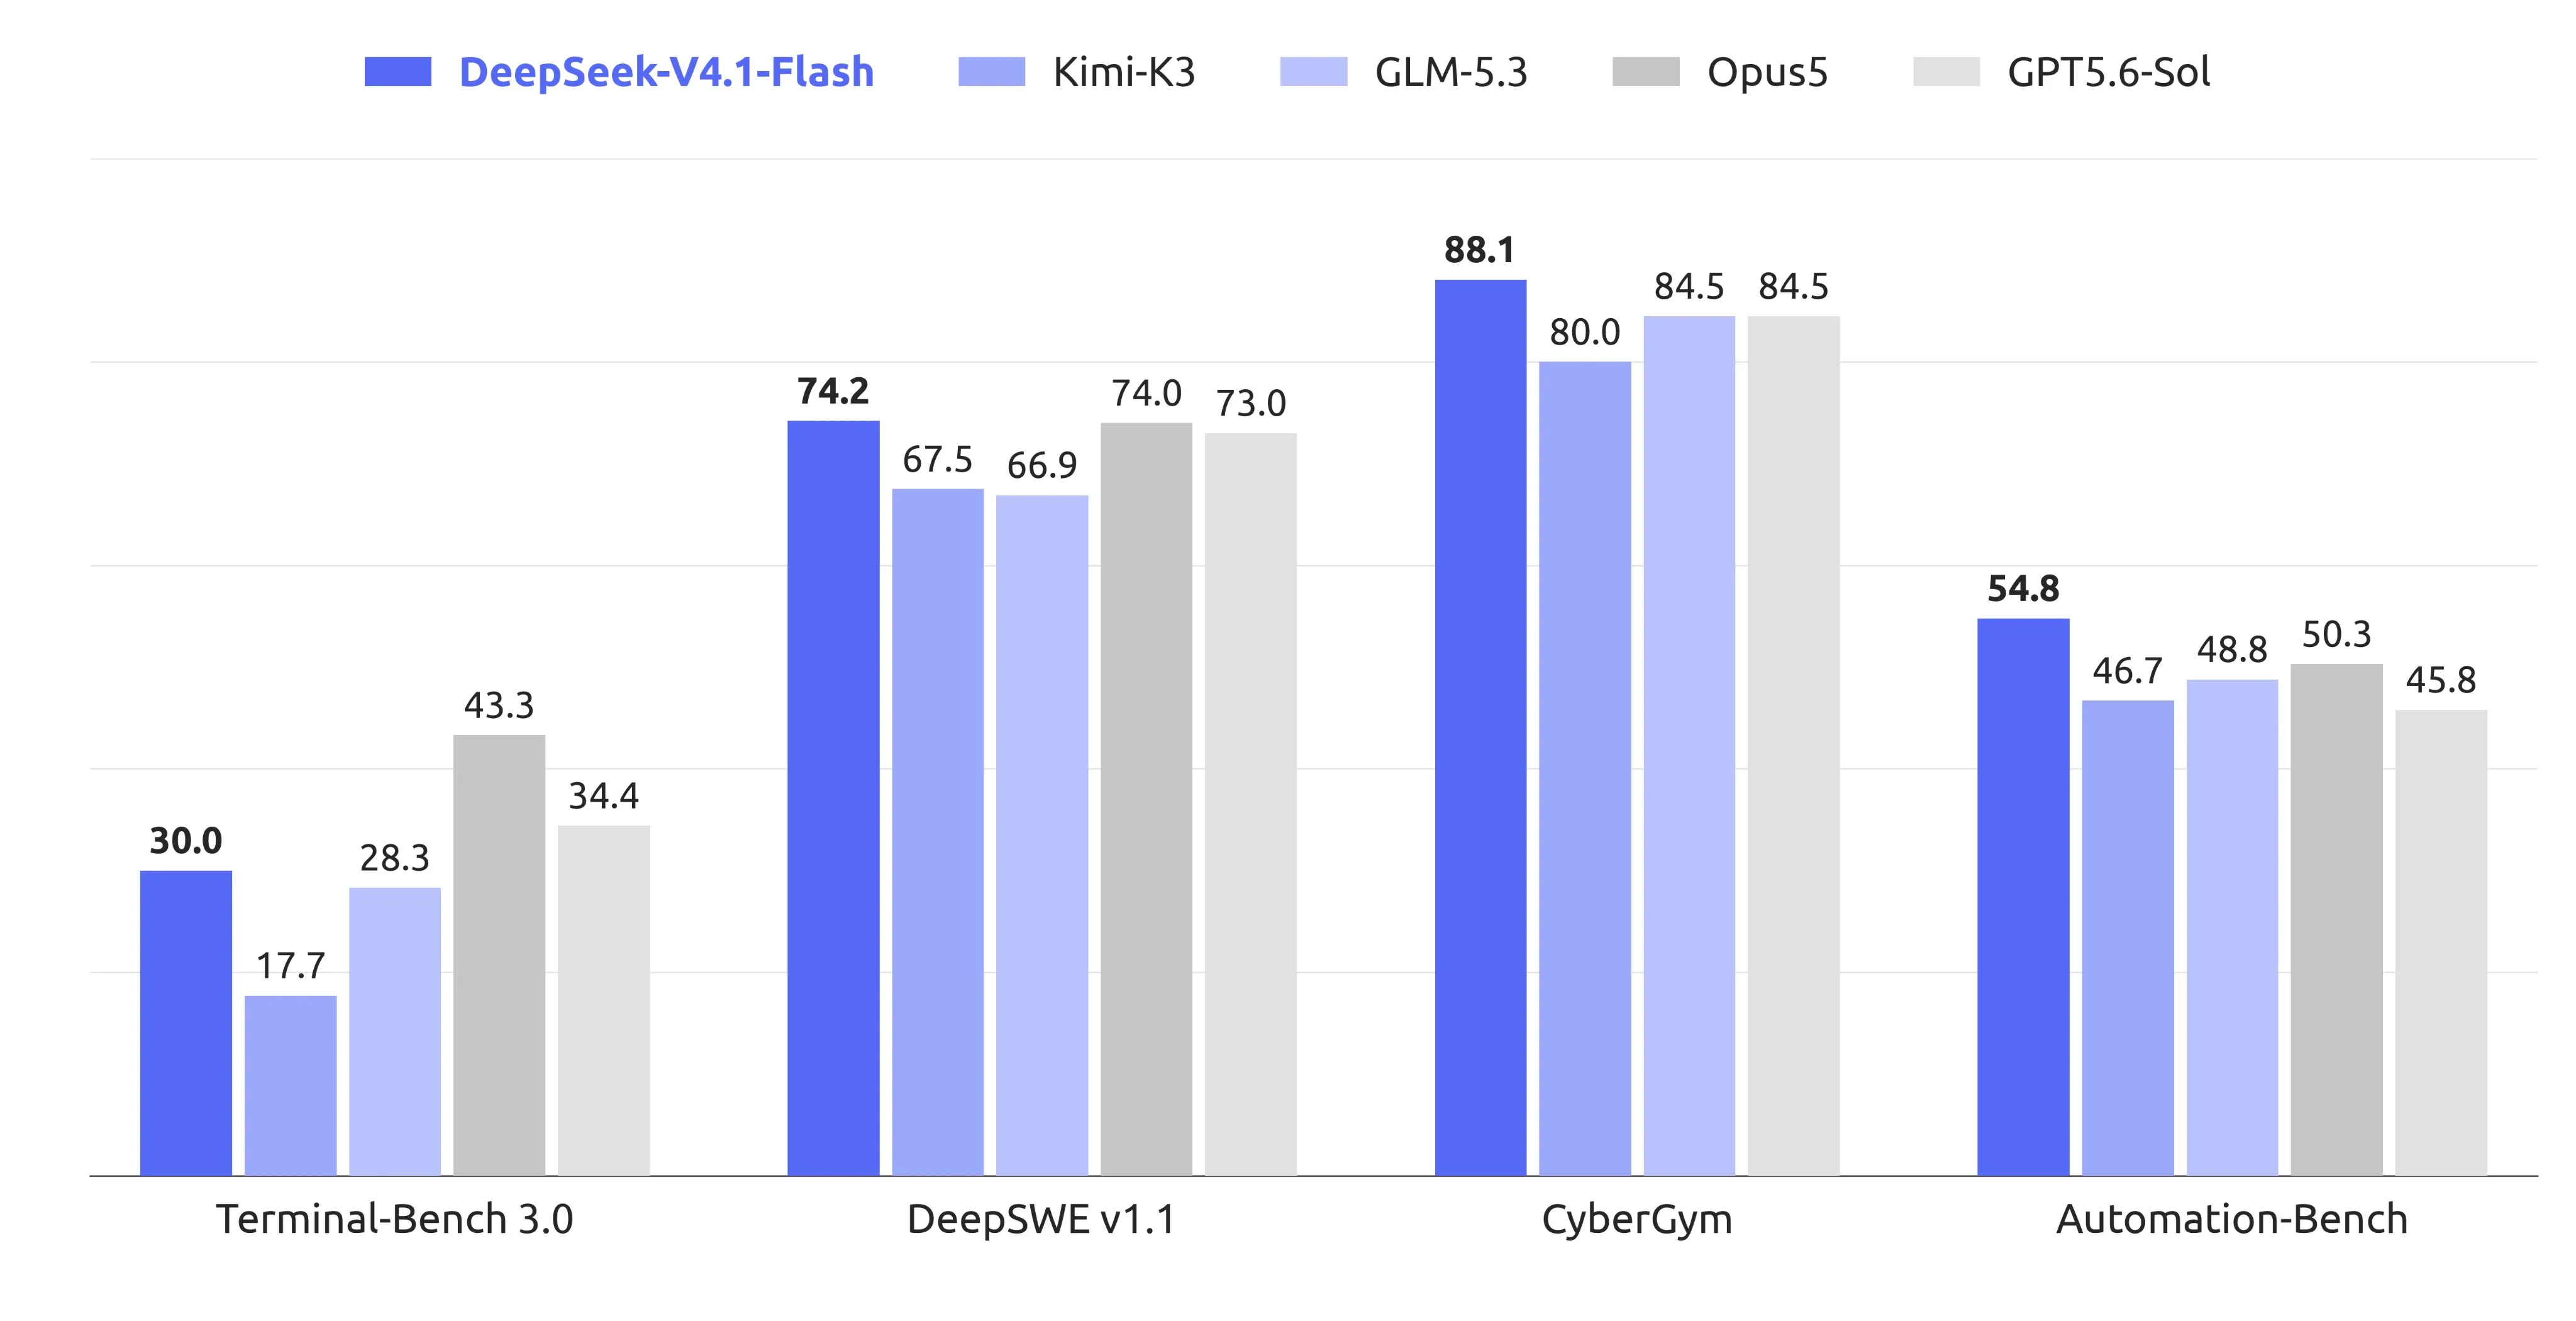
Combinan estos cambios con un aumento de rendimiento, superando al modelo anterior DeepSeek V4 Pro. Los benchmarks muestran que lo hace mejor que los modelos más grandes GLM 5.3 y Kimi K3, pero en el mundo real parece que solo obtuvo una mejora modesta, poniéndose de nuevo a la altura de GLM 5.3 Flash.
También parece seguir algo áspero en los bordes por ahora, así que me quedaría con GLM 5.3 Flash o con el modelo V4 Flash anterior, aunque sí espero con interés V4.2 si logran añadirle un poco más de pulido al modelo.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo abajo.