注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新闻
OpenAI 解出一道千禧年大奖难题
千禧年大奖难题是 Clay Mathematics Institute 于 2000 年选出的 7 道极具挑战性的数学难题。 它们是数学界最著名的一批难题,对任何数学家来说,解出其中一道都将是足以冠绝其职业生涯的成就。
OpenAI 宣称,他们已经解决了其中一道与流体力学有关的难题——纳维–斯托克斯问题。
他们使用了一个尚未发布、仍在训练中的模型,并行调用了 10,000 个子智能体,估计消耗了价值 650 万美元的 token(按 API 价格计算)。
不过,这一声明也引发了争议。 另一个团队也一直在研究这道难题,成员包括 Anthropic 员工 Levent Alpöge,他最近找到了雅可比猜想的一个反例。
他们利用业余时间,结合 Anthropic 和 OpenAI 的模型研究同一道难题,已经证明了一个可作为纳维–斯托克斯问题证明基础的命题,但尚未解决纳维–斯托克斯问题本身。 他们声称,OpenAI 偷看了本应受到零数据保留政策保护的聊天内容,并利用他们的研究结果来构建自己的证明。
OpenAI 否认了这些指控,而且看来他们的说法是对的;他们采用的证明针对的是另一种形式(证明的是另一个系统中的情形)。 他们还表示,曾主动联系 Levent 的团队,提出合作,并愿意让该团队成员担任论文第一作者(Levent 除外,因为他是 Anthropic 的员工),但对方拒绝了这一提议。
无论如何,这对数学的未来都意义重大:数学界最著名的难题之一,被一个全自动 AI 系统攻克了。 有传言称,OpenAI 和 Anthropic 都在着手研究另外五道尚未解决的千禧年大奖难题,接下来就看哪家实验室能率先拿下下一道了。
新品发布
GPT-6 Astra
上周,我聊了聊在拿到 GPT-6 Astra 约 24 小时后对它的初步感受。现在,我和社区都有时间对它进行充分测试,终于可以认真说说这款模型是否值得推荐了!
先说优点,它的视觉和计算机操作能力确实如上周初见时那样强大。 它在这两方面都遥遥领先,相比之下,其他模型在这些任务上几乎都没有什么存在感。
它在规划和代码审查方面也很强。 它对细节的关注令人印象深刻,能揪出棘手的小 bug,也能考虑到大多数其他模型会遗漏的情形。
它的对齐表现似乎也不错。 在测试模型经营模拟自动售货机业务能力的 Vending Bench 上,它的表现超过了 Claude 系列模型。后者曾采取不当行为,例如欺骗顾客和与其竞争的其他商家,为了取得优势不择手段。 GPT-6 不仅击败了 Claude 系列模型、赚到了更多钱,而且在此过程中无需伤害任何用户。
遗憾的是,它审查代码的能力,并没有转化为持续编写优质代码的能力。 有人反映,它生成的代码过于紧凑、难以维护,尤其是在模型似乎认为没人会阅读这些代码的时候。 代码通常能运行,但随着时间推移,长期可维护性可能会越来越差,即使让其他大语言模型接手维护也是如此。
它还有一个令人烦恼的倾向:绕过运行框架中提供的工具,即使有专门的编辑工具可用,也要用 Python 和 TypeScript 脚本来修改文件。 这让人更难跟上模型工作时具体改了什么,也让我想起了 Gemini 3 Pro 曾经出现的问题:它似乎搞不清自己所处的运行框架。
然后是使用额度限制。 正如我上周预料的那样,Astra 消耗订阅额度的速度,比之前的 OpenAI 模型快得多。 即使将推理强度设为中等,并关闭快速模式,也会出现这种情况,所以这似乎不只影响那些使用最昂贵设置的人。
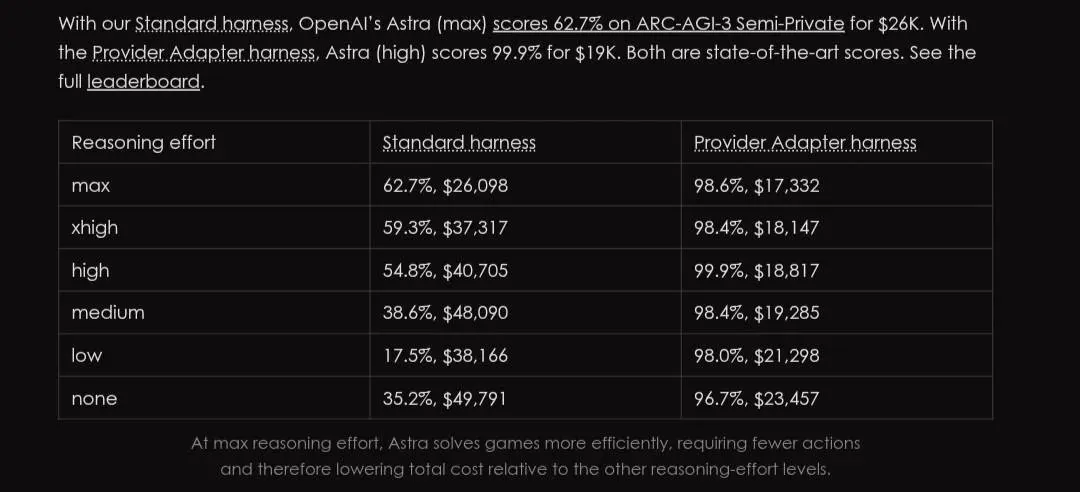
有意思的是,调低推理强度可能并不是节省 token 的最佳方式。 有报告称,Astra 在更高的推理强度设置下反而消耗更少的 token,下方的 ARC-AGI-3 结果也展示了,更高的推理强度如何降低总成本。 模型解决任务所需的操作更少,因此给它更多思考空间,最终反而可能更省钱。
OpenAI 已经承认了这些问题。希望 GPT-6.1 能把 Astra 打磨得更完善,但他们究竟能解决多少问题,还得再看看。
目前,我会用 Astra 来处理视觉和计算机操作任务,以及为复杂工作制定计划和进行审查。 尽管它更聪明,但它的代码质量和使用额度限制,让我很难推荐它作为日常编程模型。
快讯
DeepSeek V4.1 Flash
DeepSeek 发布了旗下较小的 Flash 模型的更新版本:V4.1。
虽然版本号只小幅提升,但这个模型的架构发生了巨大变化。 它不再采用仅解码器语言模型架构,而自 ChatGPT 发布以来,几乎所有模型都采用了这种架构。
它改用了编码器–解码器架构,基本上相当于两个相互通信的模型。 第一个模型负责编码和理解提示词,第二个模型则负责决定接下来应该生成哪个 token。 这让他们可以为编码器采用轻量级混合专家模型,再为解码器采用计算量更大的模型。
他们还加入了一张 Engram 查找表,有点像内置在模型权重中的知识库,类似于 Qwen 3.8 Flash Next 的做法。
这种新架构让模型规模几乎翻倍,却同时提高了效率、降低了成本。
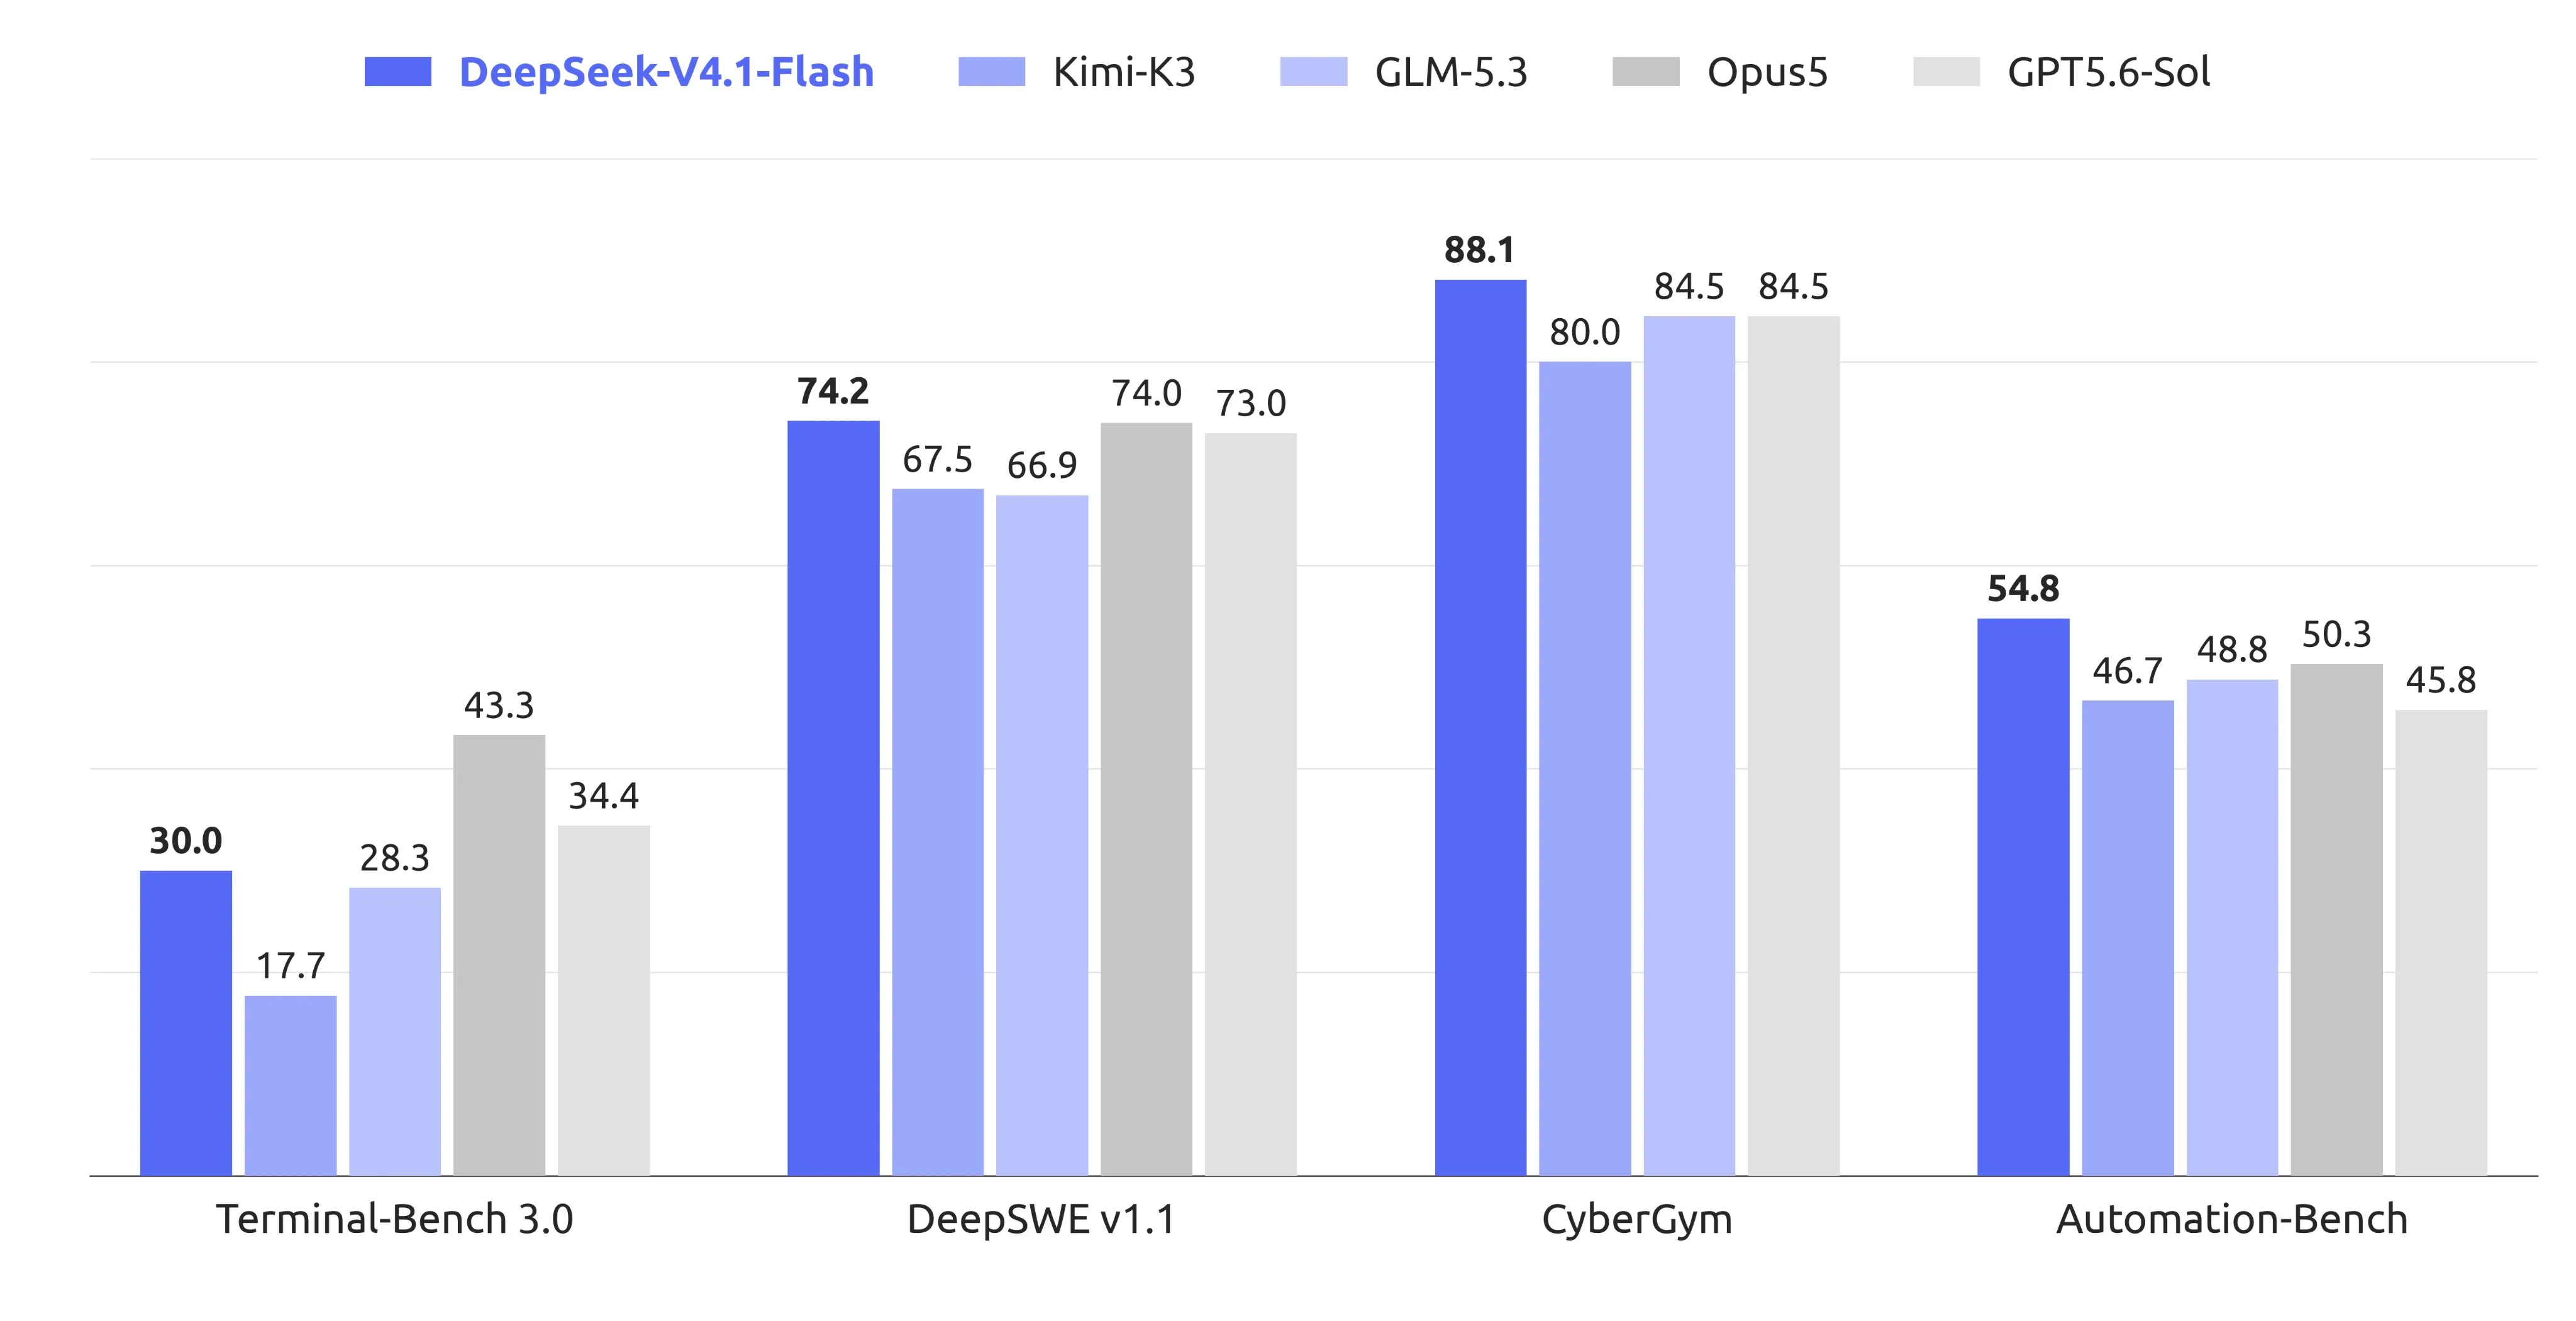
这些变化也伴随着性能提升,表现超过了之前的 DeepSeek V4 Pro 模型。 基准测试显示,它优于规模更大的 GLM 5.3 和 Kimi K3 模型,但在实际使用中,提升似乎比较有限,只是让它重新追上了 GLM 5.3 Flash。
目前它似乎还有些不够完善,所以我会继续使用 GLM 5.3 Flash 或之前的 V4 Flash 模型。不过,如果他们能再把模型打磨得更好一些,我还是很期待 V4.2 的。
结语
希望你喜欢本周的新闻。如果你想每周收到新闻,记得在下方订阅我们的邮件列表。