Nota: Este artigo foi traduzido automaticamente com OpenAI GPT-5.5 por meio do Codex CLI; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Resumo
- A OpenAI resolve um Problema do Milênio
- A análise completa do GPT-6
- A DeepSeek continua melhorando
Notícias
A OpenAI resolve um Problema do Milênio
Os Problemas do Prêmio do Milênio são um conjunto de 7 problemas matemáticos extremamente difíceis selecionados pelo Clay Mathematics Institute em 2000. Eles estão entre os problemas mais famosos da matemática, e resolver um deles seria uma conquista máxima para qualquer matemático.
A OpenAI afirmou que resolveu um desses problemas, o problema de Navier-Stokes, que diz respeito à dinâmica dos fluidos.
Eles usaram um modelo ainda não lançado, que segue em processo de treinamento, utilizando 10.000 subagentes paralelos, com um custo estimado de US$ 6,5 milhões em tokens (se pago usando os preços da API).
Essa afirmação, porém, não veio sem controvérsia. Outro grupo também vinha trabalhando nisso, incluindo Levent Alpöge, o funcionário da Anthropic que recentemente encontrou um contraexemplo para a Conjectura Jacobiana.
Eles estavam trabalhando no mesmo problema (fora do trabalho) usando uma combinação de modelos da Anthropic e da OpenAI, e conseguiram provar uma afirmação que era um dos blocos fundamentais para provar Navier-Stokes, mas ainda não haviam conseguido resolver Navier-Stokes em si. Eles alegaram que a OpenAI vinha bisbilhotando o que deveriam ter sido seus chats com retenção zero de dados, usando seus resultados para ajudar a construir sua própria prova.
A OpenAI nega essas alegações, e eles parecem estar corretos; a prova que usaram era para uma forma diferente (provando o resultado para um sistema diferente). Eles também disseram que entraram em contato e ofereceram uma parceria com o grupo de Levent, além de oferecer a eles a primeira autoria do artigo (exceto para Levent, já que ele era funcionário da Anthropic), oferta que eles recusaram.
De qualquer forma, isso é um grande acontecimento para o futuro da matemática, já que um de seus problemas mais famosos caiu diante de um sistema de IA totalmente automatizado. Há rumores de que tanto a OpenAI quanto a Anthropic estão trabalhando nos outros cinco Problemas do Milênio ainda sem solução, então veremos qual laboratório conseguirá o próximo.
Lançamentos
GPT-6 Astra
Na semana passada, discuti as impressões iniciais que tive nas cerca de 24 horas em que tivemos acesso ao GPT-6 Astra, e agora que tanto eu quanto a comunidade tivemos tempo para testá-lo a fundo, posso dar uma recomendação adequada (ou não!) para o modelo.
Começando pelo lado positivo, suas capacidades de visão e de uso do computador são tão fortes quanto pareciam inicialmente na semana passada. Ele é de longe o melhor modelo em ambas, fazendo todos os outros modelos parecerem irrelevantes em comparação para essas tarefas.
Ele também é muito forte em planejar e revisar código. Sua atenção aos detalhes é impressionante, encontrando bugs complicados e pensando em cenários que a maioria dos outros modelos deixa passar.
Ele também parece estar bem alinhado. No Vending Bench, que testa modelos administrando um negócio simulado de máquinas de venda automática, ele supera os modelos Claude, que usaram comportamento nocivo, como mentir para clientes e outras empresas contra as quais competem para levar vantagem a qualquer custo. O GPT-6 não só supera os modelos Claude e ganha mais dinheiro, como faz isso sem precisar prejudicar nenhum usuário no caminho.
Infelizmente, sua capacidade de revisar código não se traduziu em código próprio consistentemente bom. As pessoas estão relatando código comprimido e difícil de manter, particularmente quando o modelo parece achar que ninguém vai lê-lo. O código geralmente funciona, mas a manutenibilidade de longo prazo, mesmo para outros LLMs, pode piorar com o tempo.
Ele também tem uma tendência irritante de contornar as ferramentas do seu harness, usando scripts em Python e TypeScript para editar arquivos mesmo quando ferramentas dedicadas de edição estão disponíveis. Isso torna mais difícil acompanhar o que o modelo está alterando enquanto trabalha, e me lembra os problemas que vimos com o Gemini 3 Pro, quando ele parecia confuso com o próprio harness.
Depois há os limites de uso. Como eu esperava na semana passada, o Astra está consumindo os limites das assinaturas muito mais rápido do que os modelos anteriores da OpenAI. Isso está acontecendo mesmo com raciocínio médio e modo rápido desativado, então não parece estar limitado a pessoas executando o modelo em suas configurações mais caras.
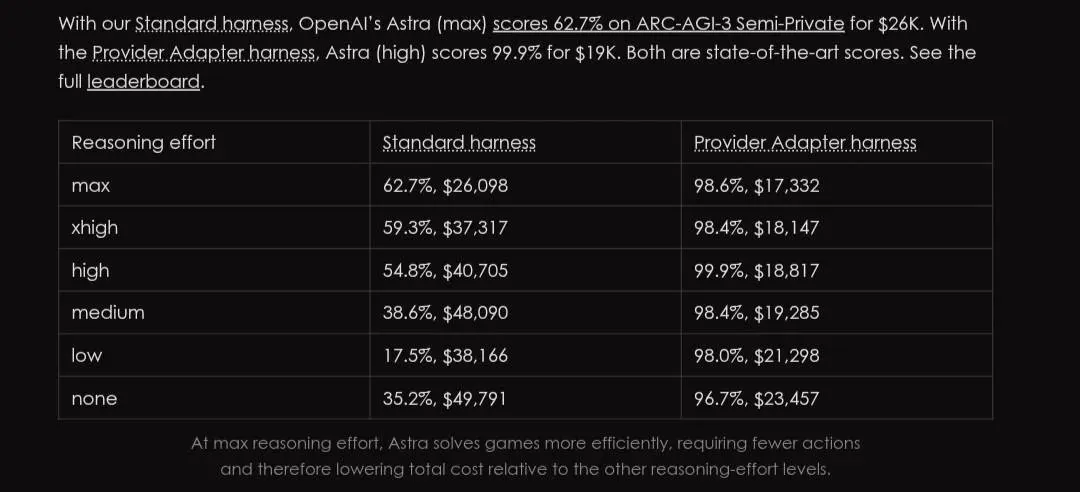
Curiosamente, reduzir o esforço de raciocínio pode não ser a melhor forma de economizar tokens. Há relatos de que o Astra na verdade usa menos tokens em configurações de raciocínio mais altas, e os resultados do ARC-AGI-3 abaixo mostram como um esforço maior pode levar a um custo total menor. O modelo realiza menos ações para resolver a tarefa, então dar mais espaço para ele pensar pode acabar sendo mais barato no geral.
A OpenAI reconheceu esses problemas; com sorte, o GPT-6.1 trará o polimento de que o Astra precisa, mas teremos que ver quanto disso eles conseguirão resolver.
Por enquanto, eu usaria o Astra para visão e uso do computador, além de planejamento e revisão de trabalhos difíceis. Sua qualidade de código e seus limites de uso tornam muito mais difícil recomendá-lo como seu modelo cotidiano de programação, mesmo com a inteligência extra que ele traz.
Notas rápidas
DeepSeek V4.1 Flash
A DeepSeek lançou uma versão atualizada de seu modelo flash menor, o V4.1.
Apesar do aumento modesto no número da versão, esse modelo tem uma arquitetura dramaticamente diferente. Ele não é mais um modelo de linguagem apenas decoder, que é o que quase todo modelo tem sido desde o lançamento do ChatGPT.
Em vez disso, ele usa uma arquitetura encoder-decoder, o que significa que há essencialmente 2 modelos conversando entre si. O primeiro modelo serve para codificar e entender o prompt, e então o segundo decide qual deve ser o próximo token a ser gerado. Isso permite que eles usem um modelo mixture of experts leve para o encoder e, depois, um modelo computacionalmente mais pesado para o decoder.
Eles também adicionam uma tabela de consulta Engram, que é meio como uma base de conhecimento incorporada aos pesos do modelo, semelhante ao Qwen 3.8 Flash Next.
Essa nova arquitetura quase dobra o tamanho do modelo, mas o torna mais eficiente e mais barato no processo.
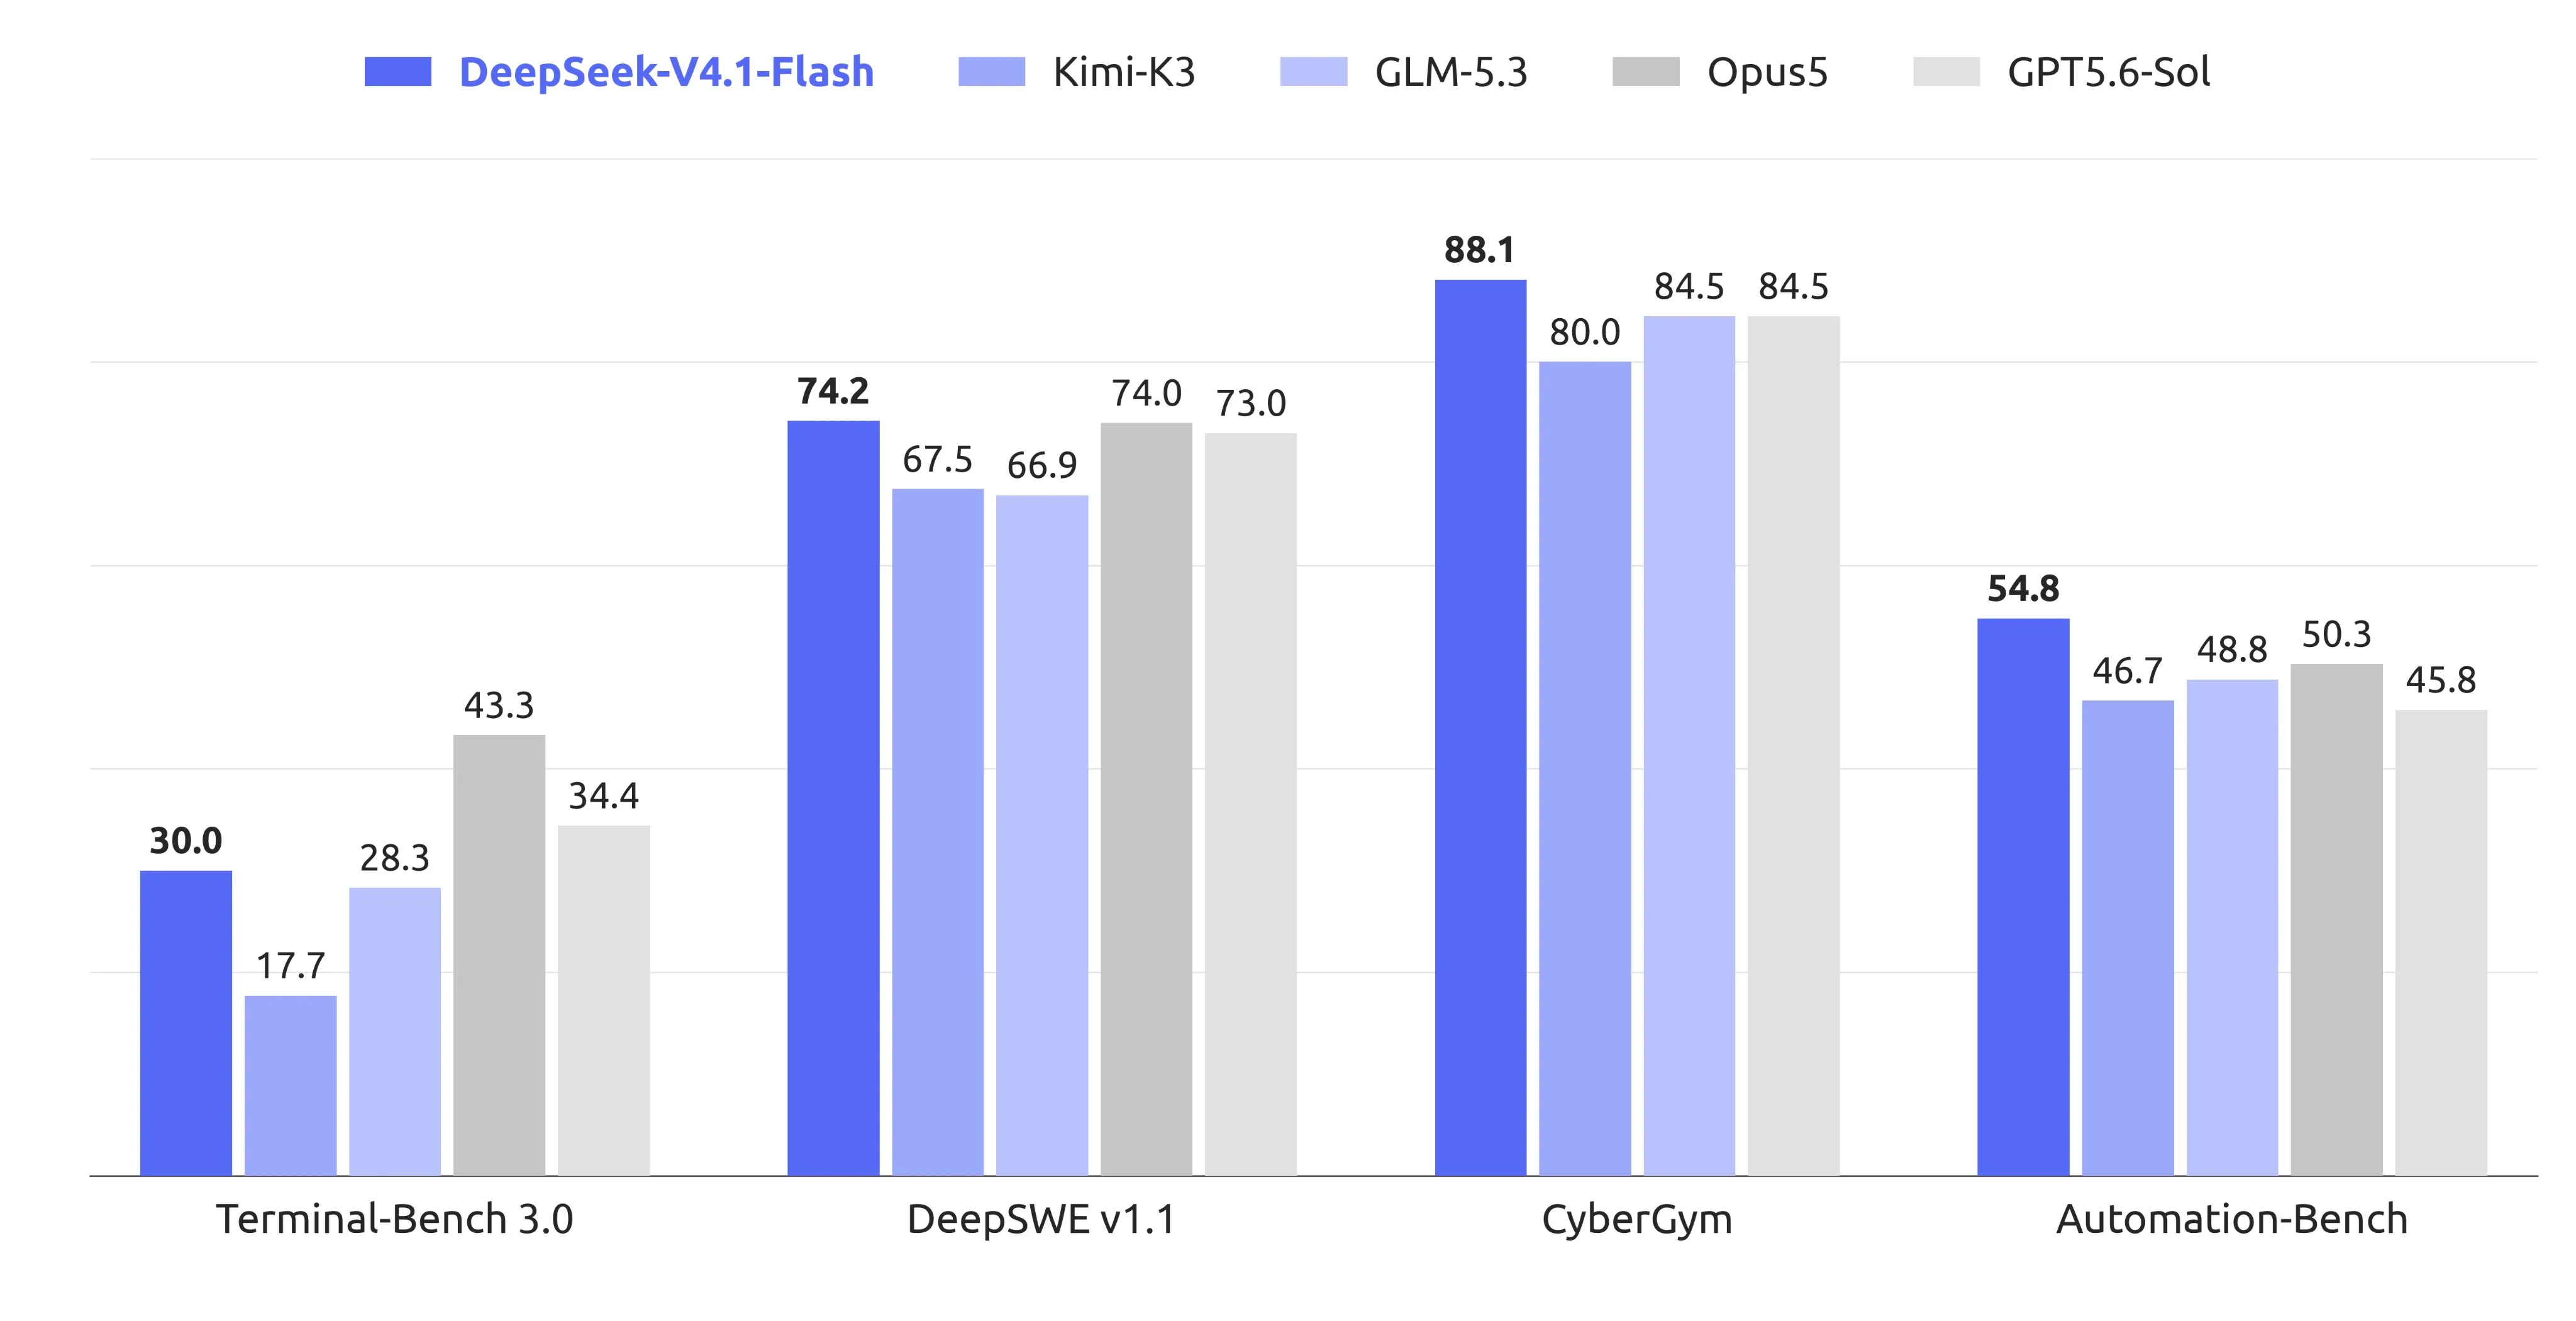
Eles combinam essas mudanças com maior desempenho, superando o modelo DeepSeek V4 Pro anterior. Os benchmarks mostram que ele se sai melhor do que os modelos maiores GLM 5.3 e Kimi K3, mas no mundo real parece ter recebido apenas um avanço modesto, alcançando novamente o GLM 5.3 Flash.
Ele também ainda parece um pouco áspero nas bordas neste momento, então eu ficaria com o GLM 5.3 Flash ou com o modelo V4 Flash anterior, mas estou ansioso pelo V4.2 se eles conseguirem adicionar um pouco mais de polimento ao modelo.
Final
Espero que você tenha gostado das notícias desta semana. Se quiser receber as notícias toda semana, não deixe de entrar na nossa lista de emails abaixo.