Nota: Este artículo fue traducido automáticamente con OpenAI gpt-6.1-sol mediante Codex CLI; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
GPT 6.1 Terra
En una decisión algo sorprendente, OpenAI ha recuperado Terra, un modelo que no se incluyó en los lanzamientos originales de GPT 6. Para quienes no lo recuerden, Terra es un modelo de tamaño medio, pensado para situarse entre Luna y Sol en la gama de OpenAI.
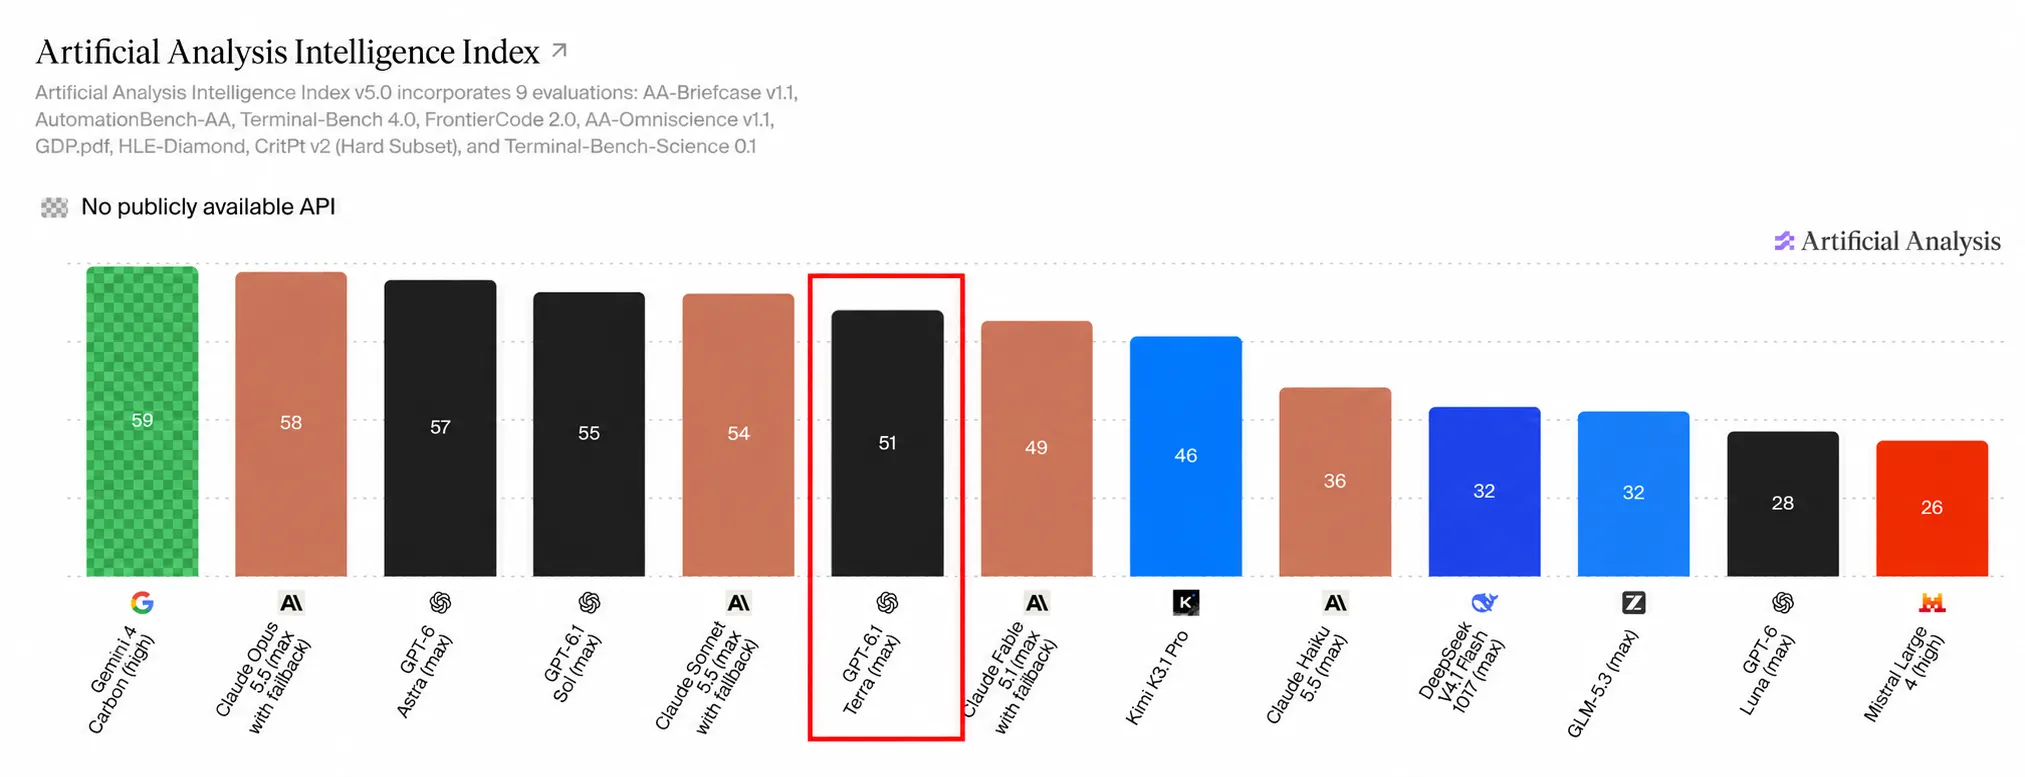
En cuanto a inteligencia y precio, el modelo está mucho más cerca de Sol 6.1 que de Luna: cuesta la mitad que Sol y solo es un poco inferior en inteligencia, mientras que Luna se queda muy atrás en ese aspecto.
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| GPT 6.1 Terra | $1 | $5 | 62 |
| GPT 6.1 Sol | $2 | $10 | 31 |
| GPT 6 Luna | $0.10 | $0.50 | 35 |
| Claude Haiku 5.5 | $0.10 | $0.50 | 152 |
| Claude Opus 5.5 | $4 | $20 | 68 |
| Claude Sonnet 5.5 | $2 | $10 | 84 |
Un ingeniero de OpenAI resumió muy bien la comparación con Sol y Astra: «Terra probablemente sea mejor que Astra y Sol en comunicación técnica, similar en visión y uso del ordenador —aunque más rápido y barato— y algo peor en la mayoría de las demás tareas».
Añade que no es un lanzamiento revolucionario, sino una buena opción de gama media para completar la oferta de OpenAI. Me alegra ver que OpenAI trabaja en las capacidades de comunicación del modelo, porque, en mi opinión, esa es una de las áreas en las que parece estar bastante por detrás de Opus 5.5.
Ten en cuenta que, según las puntuaciones en las pruebas, probablemente solo deberías usar Terra con el nivel de razonamiento extra alto o máximo. A diferencia de otros modelos de OpenAI, que no muestran grandes saltos entre niveles de razonamiento, Terra es muy sensible a este ajuste: con razonamiento bajo es básicamente equivalente a Luna, mientras que con el máximo queda justo por detrás de Sol. La diferencia es bastante amplia.
Investigación
Frontier Code 2.0
Es difícil encontrar buenas pruebas de evaluación. Para las pruebas de programación, antes me basaba en DeepSWE, ya que coincidía con mi percepción del rendimiento relativo de los modelos en el mundo real.
Por desgracia, era una prueba pública. Eso permitía a los desarrolladores de modelos ver todas las preguntas y cómo se evaluaban, y ajustar sus modelos en exceso a la prueba para que obtuvieran buenos resultados.
Por eso, solo tuvimos alrededor de un mes de puntuaciones útiles antes de que la prueba quedara obsoleta. Desde entonces, necesitaba una buena prueba de programación que pudiera usar como referencia.
Por suerte, el equipo de Cognition —responsable de Devin y Windsurf— ha llegado para cubrir ese vacío con su prueba Frontier Code 2.0.
No solo miden si la implementación es correcta, sino también si el código está listo para integrarse en el proyecto. Trabajaron con responsables de mantenimiento de proyectos de código abierto para crear un conjunto de preguntas y criterios de aceptación, junto con sistemas de evaluación. Estos sistemas no solo comprobaban que se hubiera añadido la nueva función o corregido el error, sino también que los cambios tuvieran en cuenta el contexto del resto del código y se hubieran realizado de forma mínima y eficiente.
Dedicaron más de 40 horas a cada pregunta. También crearon instrucciones en las que la tarea no estaba completamente definida —como suele ocurrir en el mundo real— y el modelo debía usar su criterio para decidir qué había que hacer realmente.
A diferencia de DeepSWE, que era pública, Frontier Code es totalmente privada. Por eso, a los laboratorios de IA les resultará mucho más difícil ajustar sus modelos en exceso a la prueba. Con suerte, podremos obtener información útil durante más de un mes.
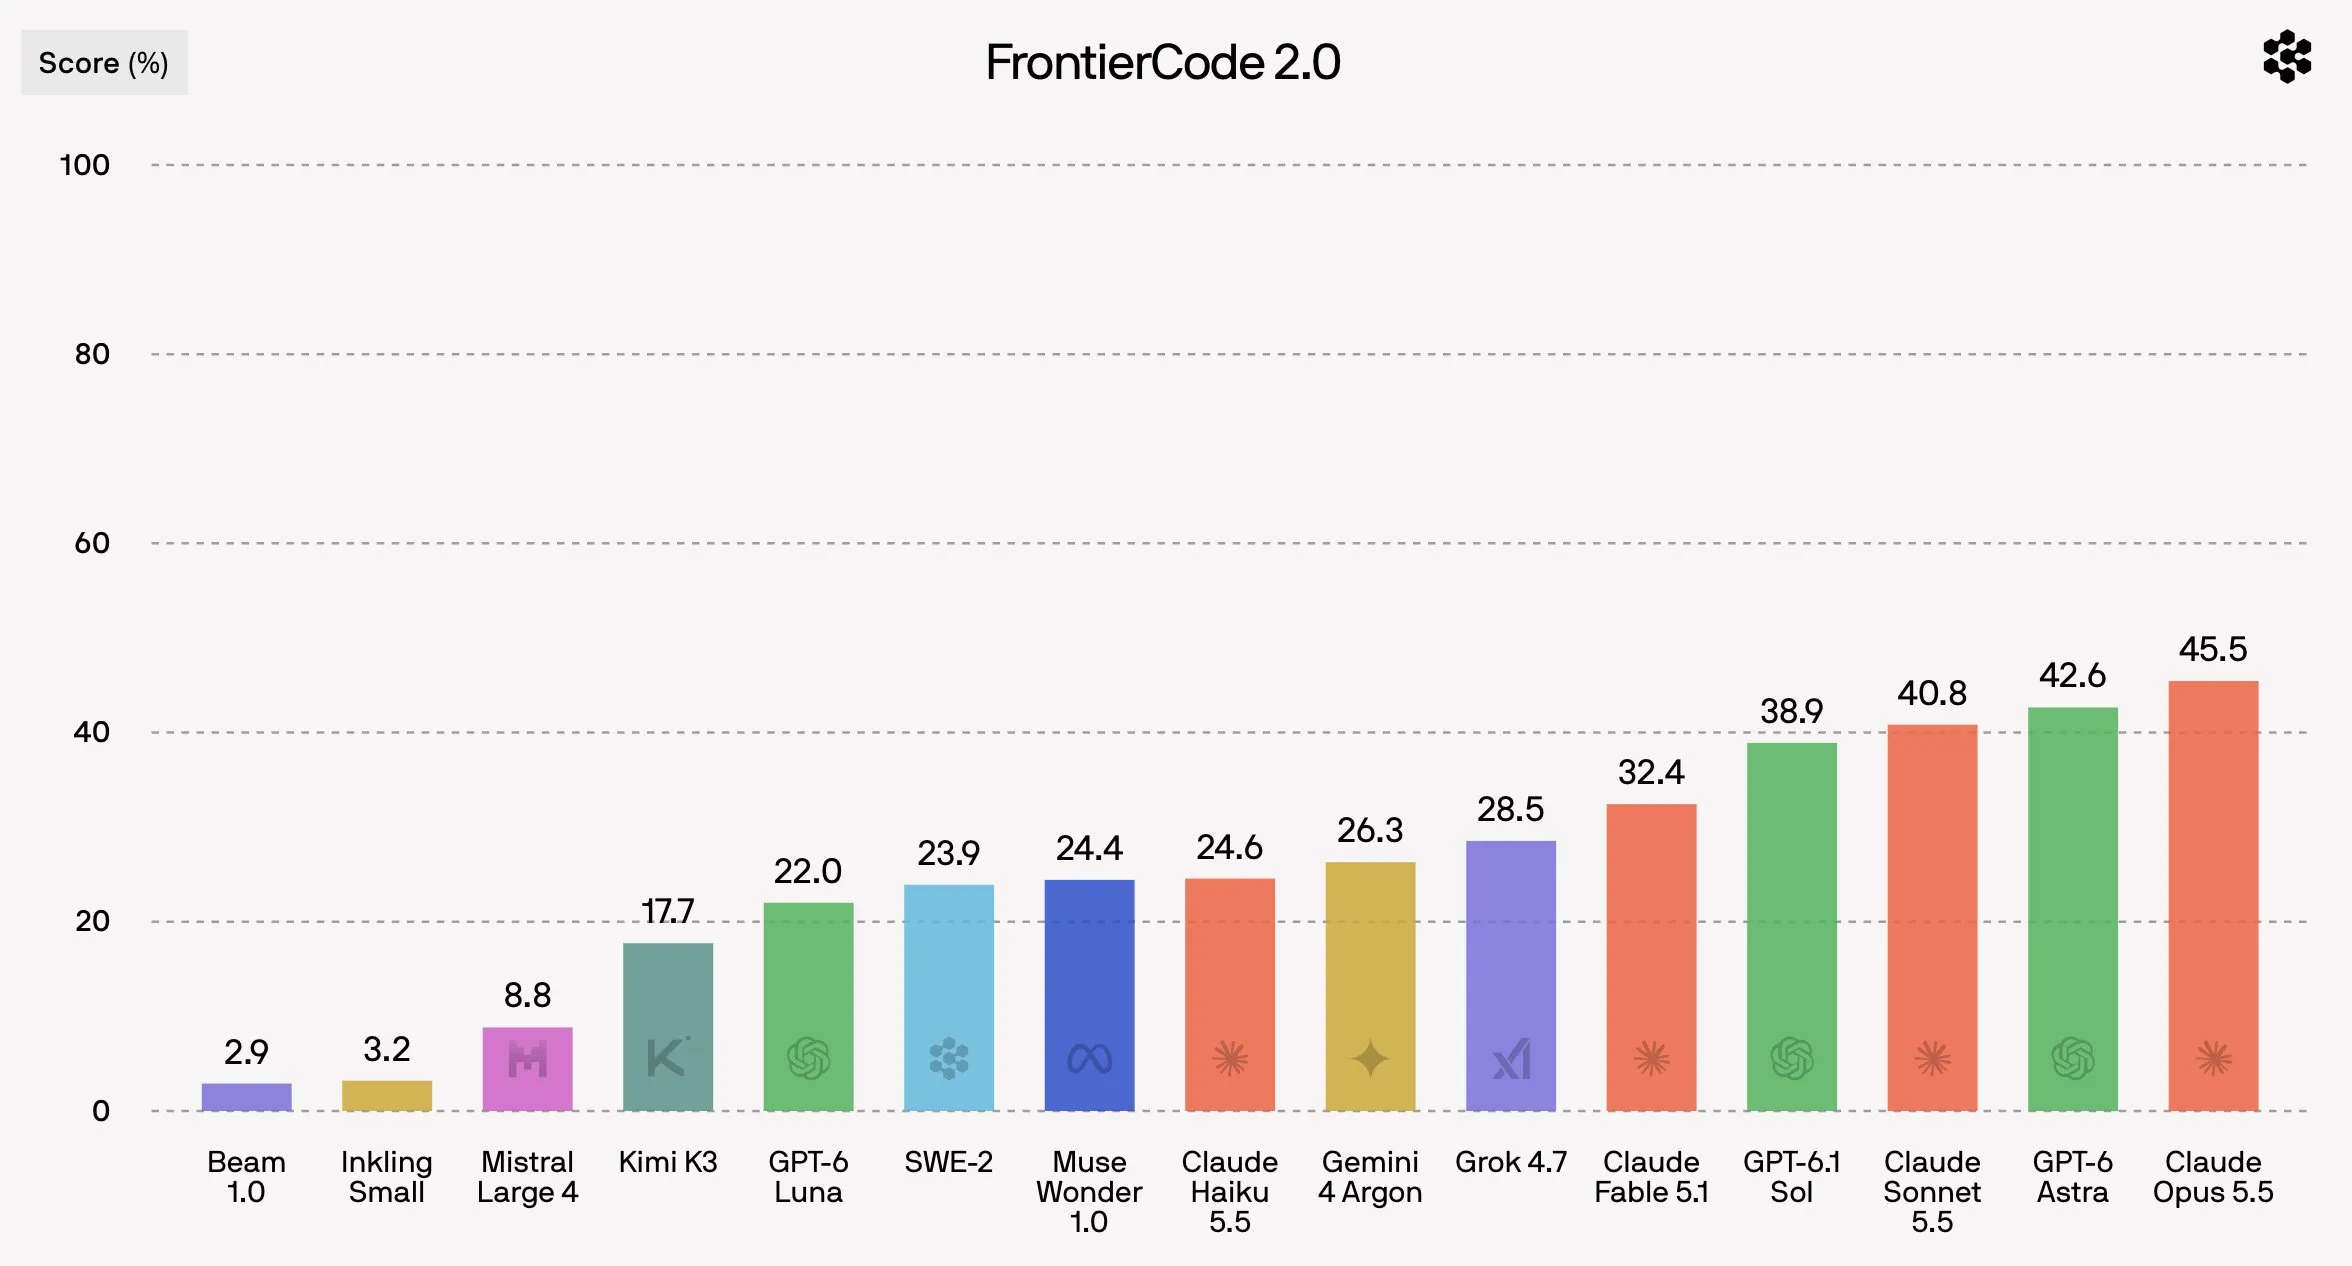
Todos los modelos que esperaba ver en los primeros puestos están ahí. Esta prueba favorece ligeramente a los modelos Claude, ya que suelen actuar con más autonomía que los modelos GPT. Estos últimos tienden a seguir las instrucciones de forma muy estricta, lo que puede ser bueno o malo según el uso que le des al modelo.
La prueba ya se ha incorporado al Artificial Analysis V5 Intelligence Index, y la usaré como referencia principal para evaluar las capacidades de programación en el futuro próximo.
Novedades breves
LFM 3
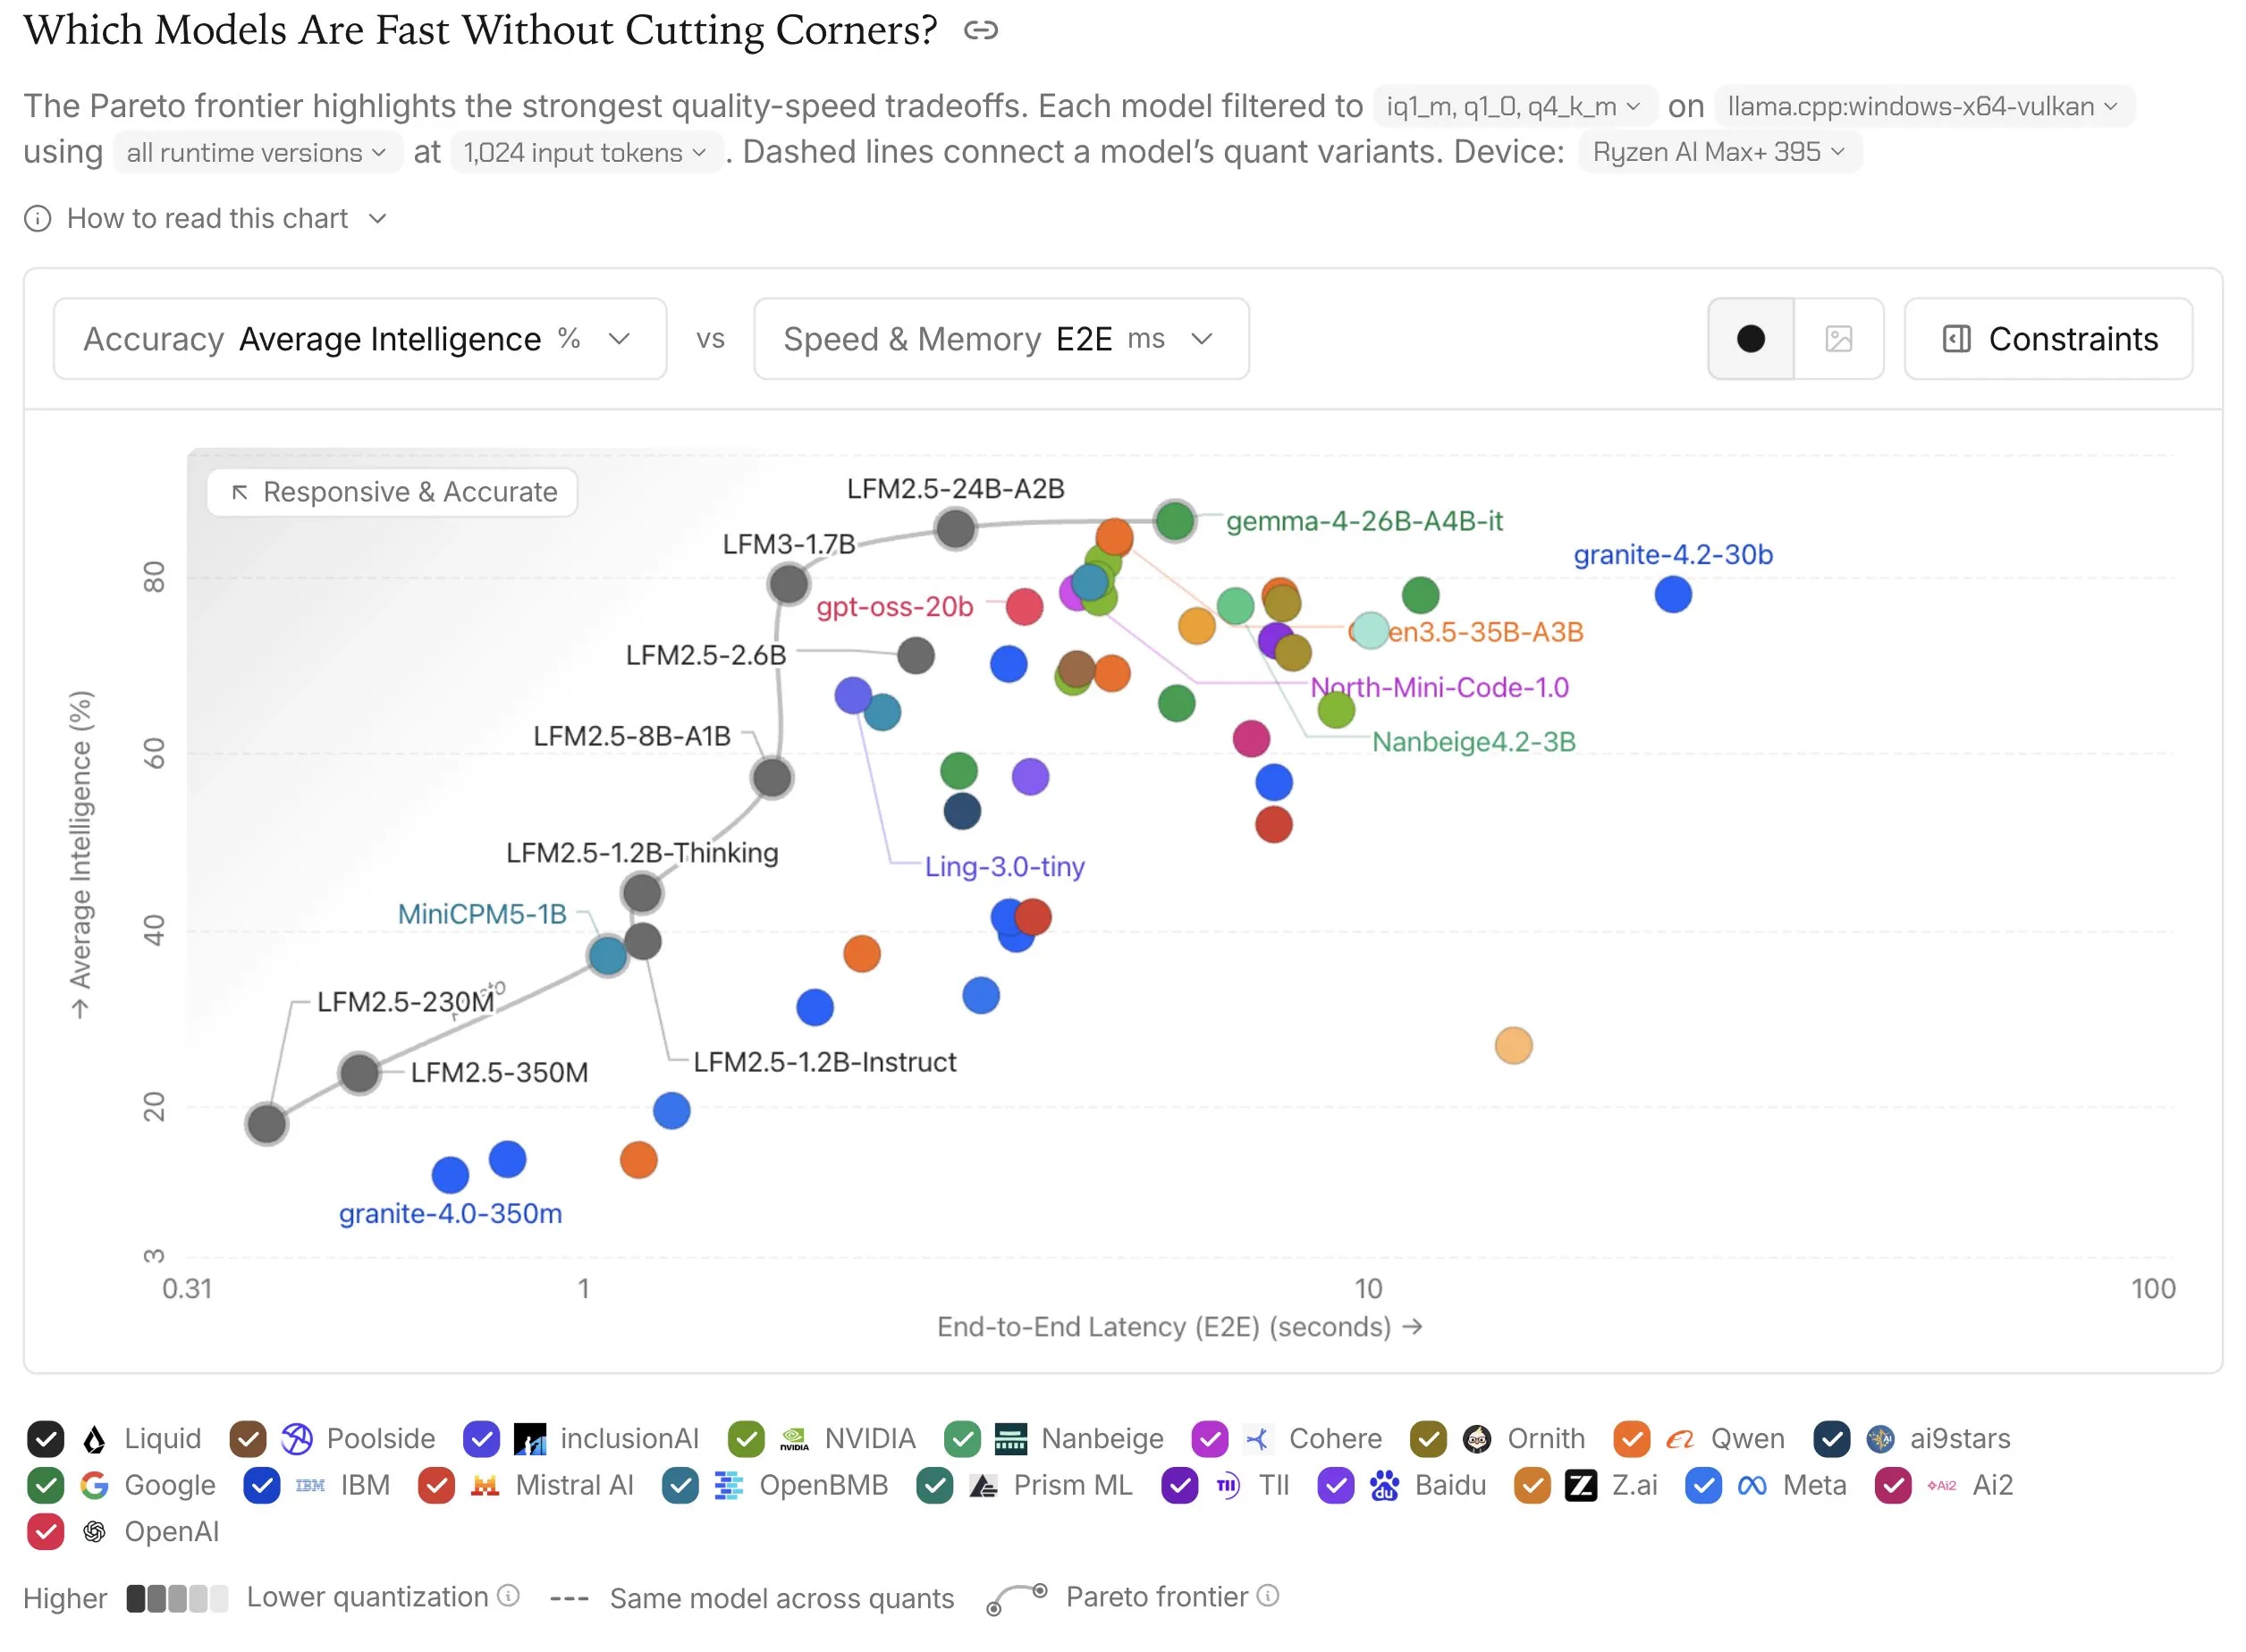
Los modelos LFM han sido los mejores para ejecutarse en dispositivos con pocos recursos, como teléfonos, o en el navegador del usuario mediante herramientas como Transformers.js. Ahora tienen una versión actualizada que amplía aún más su ventaja en este campo.
LFM 3 es un modelo de 1.700 millones de parámetros cuya arquitectura se ha optimizado específicamente para hardware móvil. No esperes que te deje con la boca abierta, pero tiene capacidad suficiente para realizar tareas básicas de agente con rapidez y de forma totalmente local.
Kimi K3.1 Pro
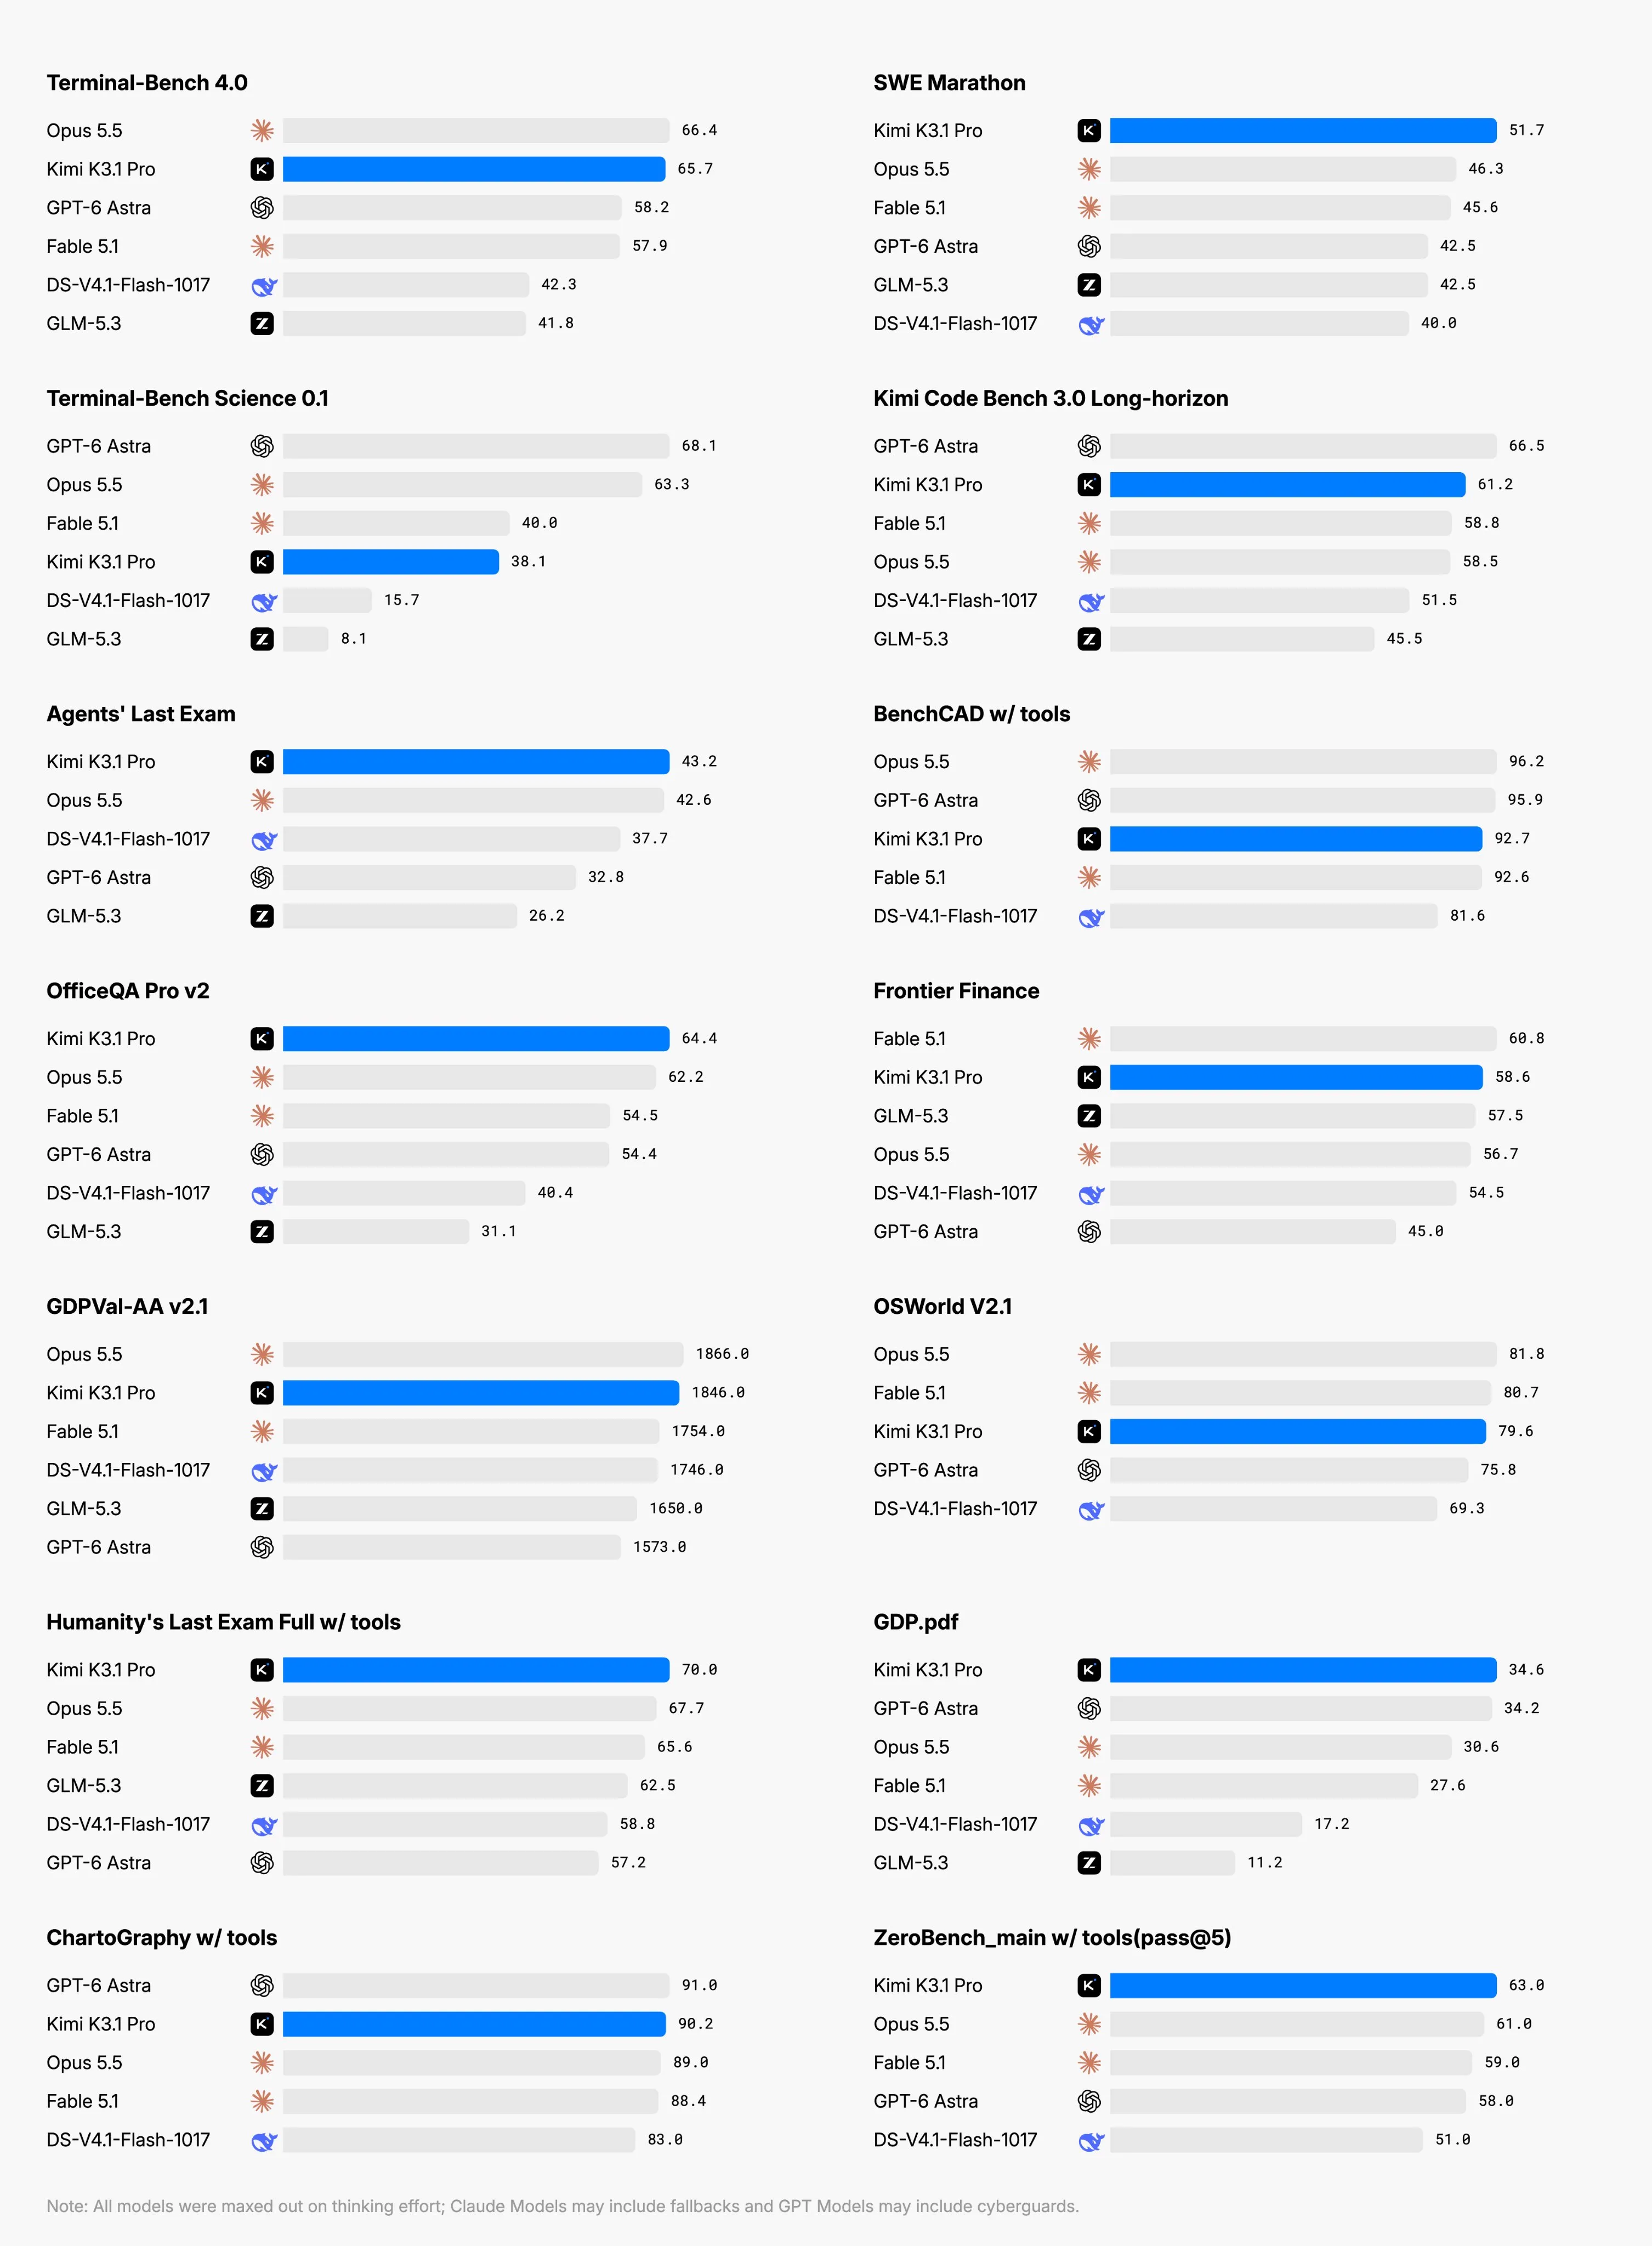
Moonshot AI lanzó la nueva versión de su modelo Kimi, pero, por desgracia, parece que no hay motivos para usarlo.
Su principal problema es el precio en relación con su rendimiento. Es un modelo aceptable, pero, a $10 por millón de tokens de salida y con un consumo de tokens bastante alto, es claramente menos inteligente que GPT 6.1 Sol y cuesta tres veces más.
En tareas de programación, DeepSeek V4.1 Flash 1017 lo supera y cuesta seis veces menos.
Es un modelo bastante competente, sin duda uno de los tres mejores de China —junto con GLM 5.3 y DeepSeek V4.1 Flash—, pero cuesta dos y seis veces más, respectivamente, lo que hace difícil recomendarlo.
Cierre
Espero que hayas disfrutado de las noticias de esta semana. Si quieres recibirlas cada semana, suscríbete a nuestra lista de correo a continuación.