注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
GPT 6.1 Terra
有些出人意料的是,OpenAI 重新推出了 Terra,这个模型并未出现在最初发布的 GPT 6 系列中。 如果你不记得了,Terra 是一款中等规模的模型,在 OpenAI 产品线中的定位介于 Luna 和 Sol 之间。
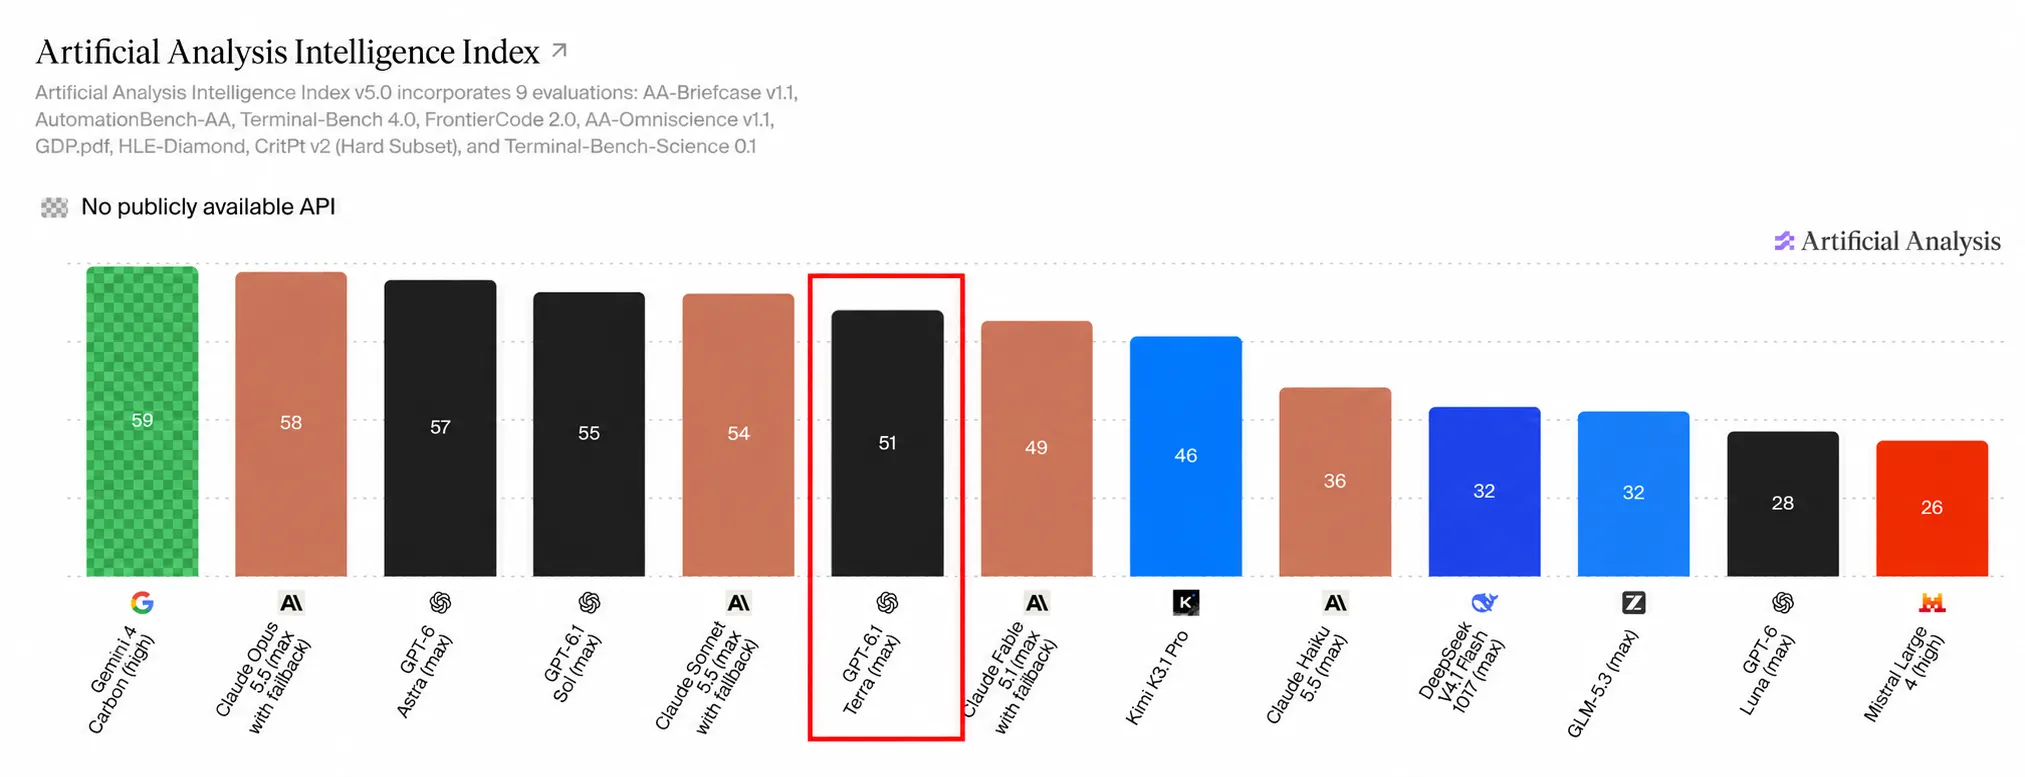
从智能水平和价格来看,这款模型与 Sol 6.1 更接近,而不是 Luna。它的价格只有 Sol 的一半,智能水平也只略逊一筹(相比之下,Luna 的智能水平落后很多)。
| 模型 | 每百万输入 token 的价格(美元) | 每百万输出 token 的价格(美元) | 每秒生成 token 数 |
|---|---|---|---|
| GPT 6.1 Terra | $1 | $5 | 62 |
| GPT 6.1 Sol | $2 | $10 | 31 |
| GPT 6 Luna | $0.10 | $0.50 | 35 |
| Claude Haiku 5.5 | $0.10 | $0.50 | 152 |
| Claude Opus 5.5 | $4 | $20 | 68 |
| Claude Sonnet 5.5 | $2 | $10 | 84 |
对于它与 Sol 和 Astra 的对比,一位 OpenAI 工程师的总结最为到位:“Terra 在技术沟通方面可能比 Astra 和 Sol 更好,在视觉和计算机操作方面表现相近(同时速度更快、价格更低),而在其他大多数方面略逊一筹。”
他接着表示,这次发布并非什么重磅突破,而是为 OpenAI 产品线补上了一个不错的中端选项。 很高兴看到 OpenAI 在改进模型的沟通能力,因为在我看来,这是它明显落后于 Opus 5.5 的领域之一。
需要注意的是,从基准测试得分来看,你可能应该只在超高(extra high)或最高(max)推理强度下使用 Terra。其他 OpenAI 模型在不同推理强度之间的表现差距似乎不大,但 Terra 对推理强度非常敏感:低推理强度下基本相当于 Luna,最高推理强度下则仅略逊于 Sol,跨度相当大。
研究
Frontier Code 2.0
好的基准测试很难找。 在编程基准测试方面,我之前一直依赖 DeepSWE,因为它的排名与我在实际使用中对各模型表现的感受一致。
遗憾的是,这是一个公开的基准测试。这意味着模型开发商可以看到所有题目及其评分方式,并针对基准测试过度优化模型,让模型在测试中取得好成绩。
结果,这个基准测试只提供了大约一个月的有效评分,就失去了参考价值。此后,我一直需要一个好的编程基准测试作为参考。
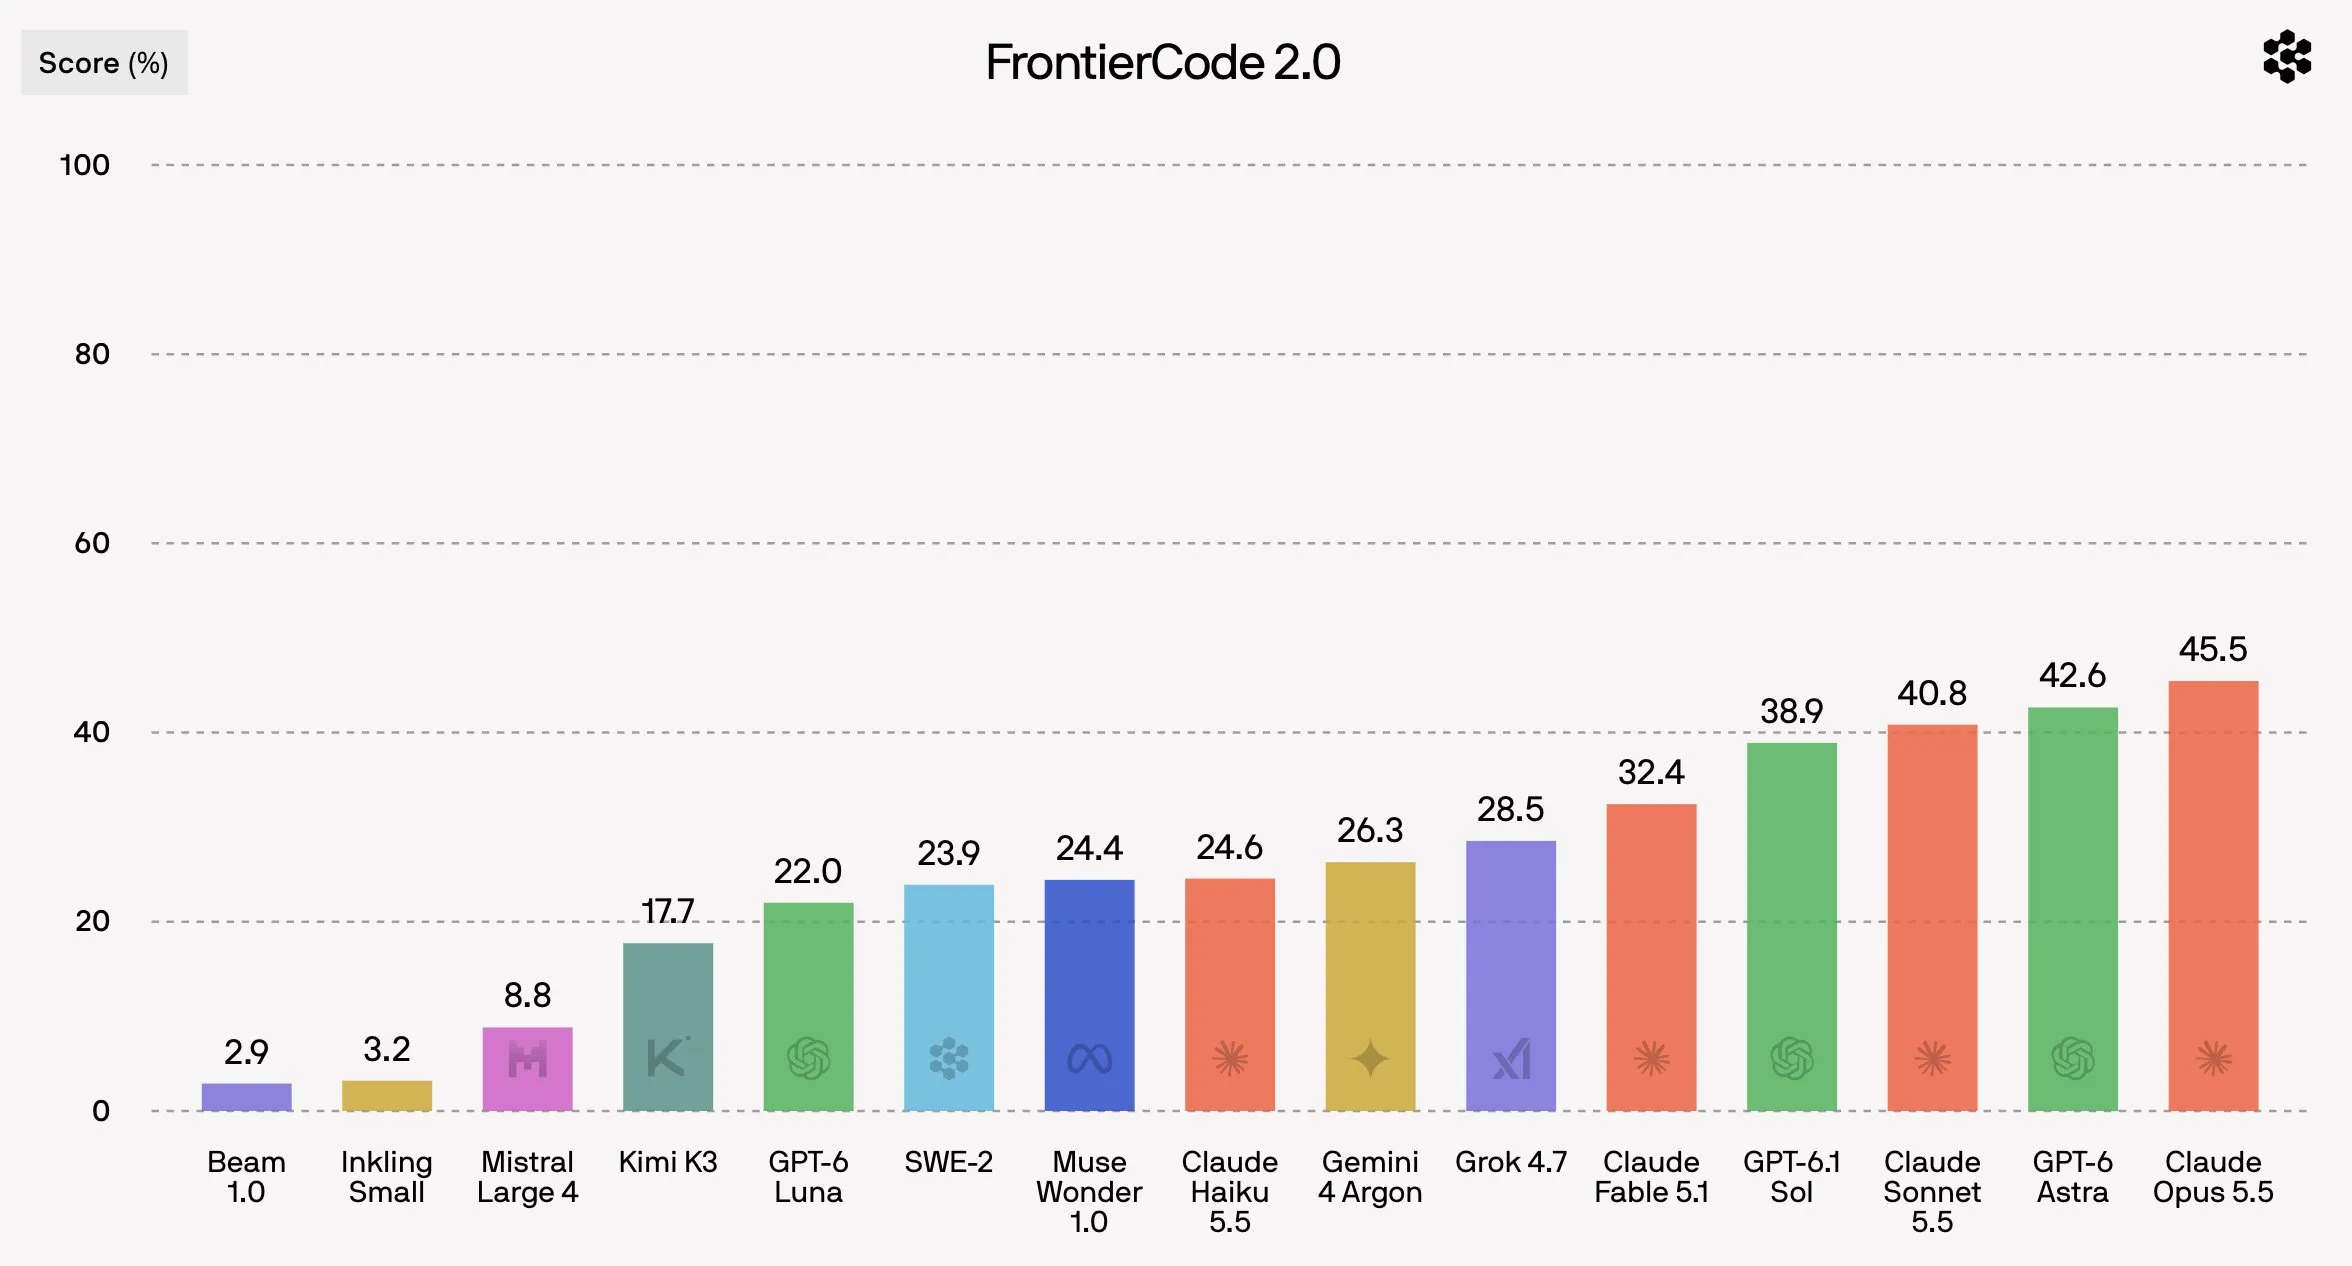
好在 Cognition 团队(Devin 和 Windsurf 背后的团队)推出了 Frontier Code 2.0 基准测试,填补了这一空缺。
它不仅衡量实现是否正确,还衡量代码是否具备合并条件。 团队与开源代码库的维护者合作,设计了一组题目、验收标准和评分程序。这些评分程序不仅检查新功能是否已添加、错误是否已修复,还检查改动是否考虑了代码库其他部分的上下文,以及实现方式是否精简、高效。
他们在每道题上投入了超过 40 个小时,还设计了一些任务要求不够明确的提示词(现实中往往也是如此),要求模型自行判断究竟需要完成哪些工作。
与公开的 DeepSWE 不同,Frontier Code 完全不公开,因此 AI 实验室更难针对它过度优化模型。希望这次我们能从中获得持续超过一个月的有效参考信息。
我预期会位居前列的模型,都出现在了榜单前列。 这个基准测试略微偏向 Claude 模型,因为它们通常更善于自主执行任务,而 GPT 模型通常更严格地遵循指令。这可能是优点,也可能是缺点,具体取决于你用模型来做什么。
这项基准测试已被纳入 Artificial Analysis V5 智能指数。在未来一段时间里,我会将它作为判断编程能力的主要依据。
快讯
LFM 3
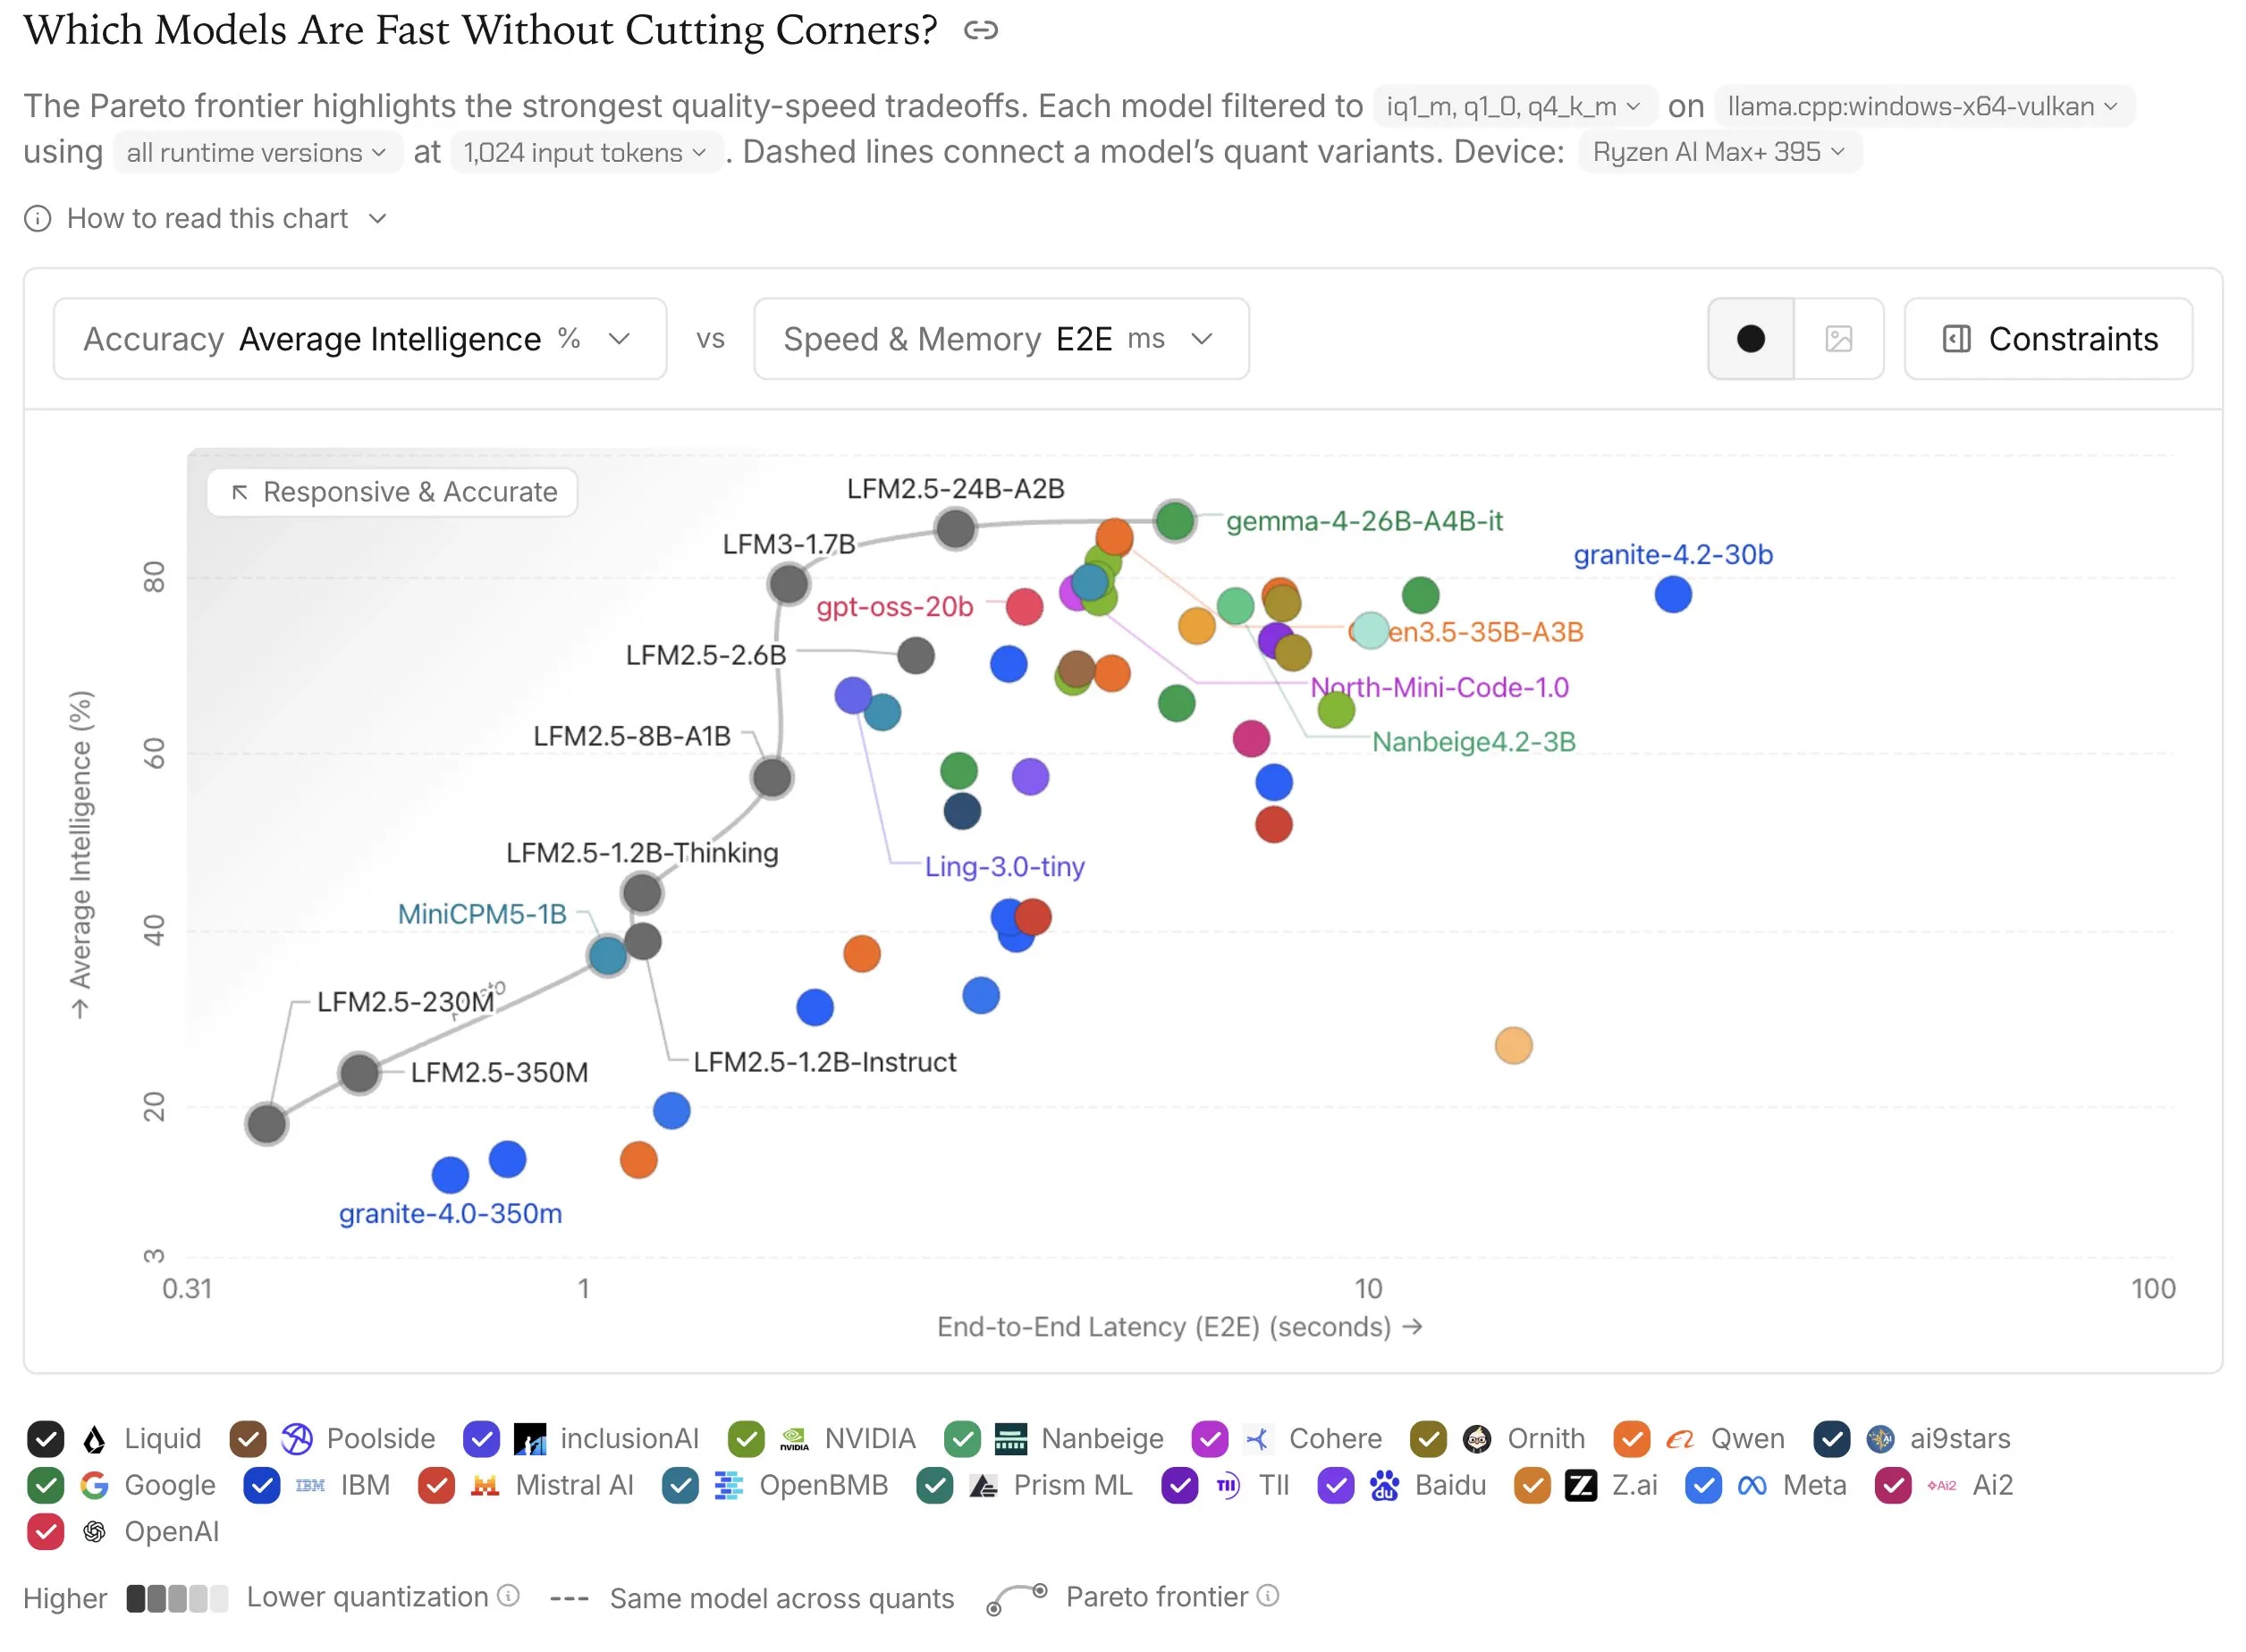
在手机等资源有限的设备上,或通过 Transformers.js 等工具在用户的浏览器中运行模型时,LFM 系列一直是最佳选择。如今,该系列推出了新版本,进一步扩大了在这一领域的领先优势。
LFM 3 是一款拥有 17 亿参数的模型,其架构专门针对移动硬件进行了优化。 别指望它能让你惊艳,但它的能力足以完全在本地运行,并及时完成基本的智能体任务。
Kimi K3.1 Pro
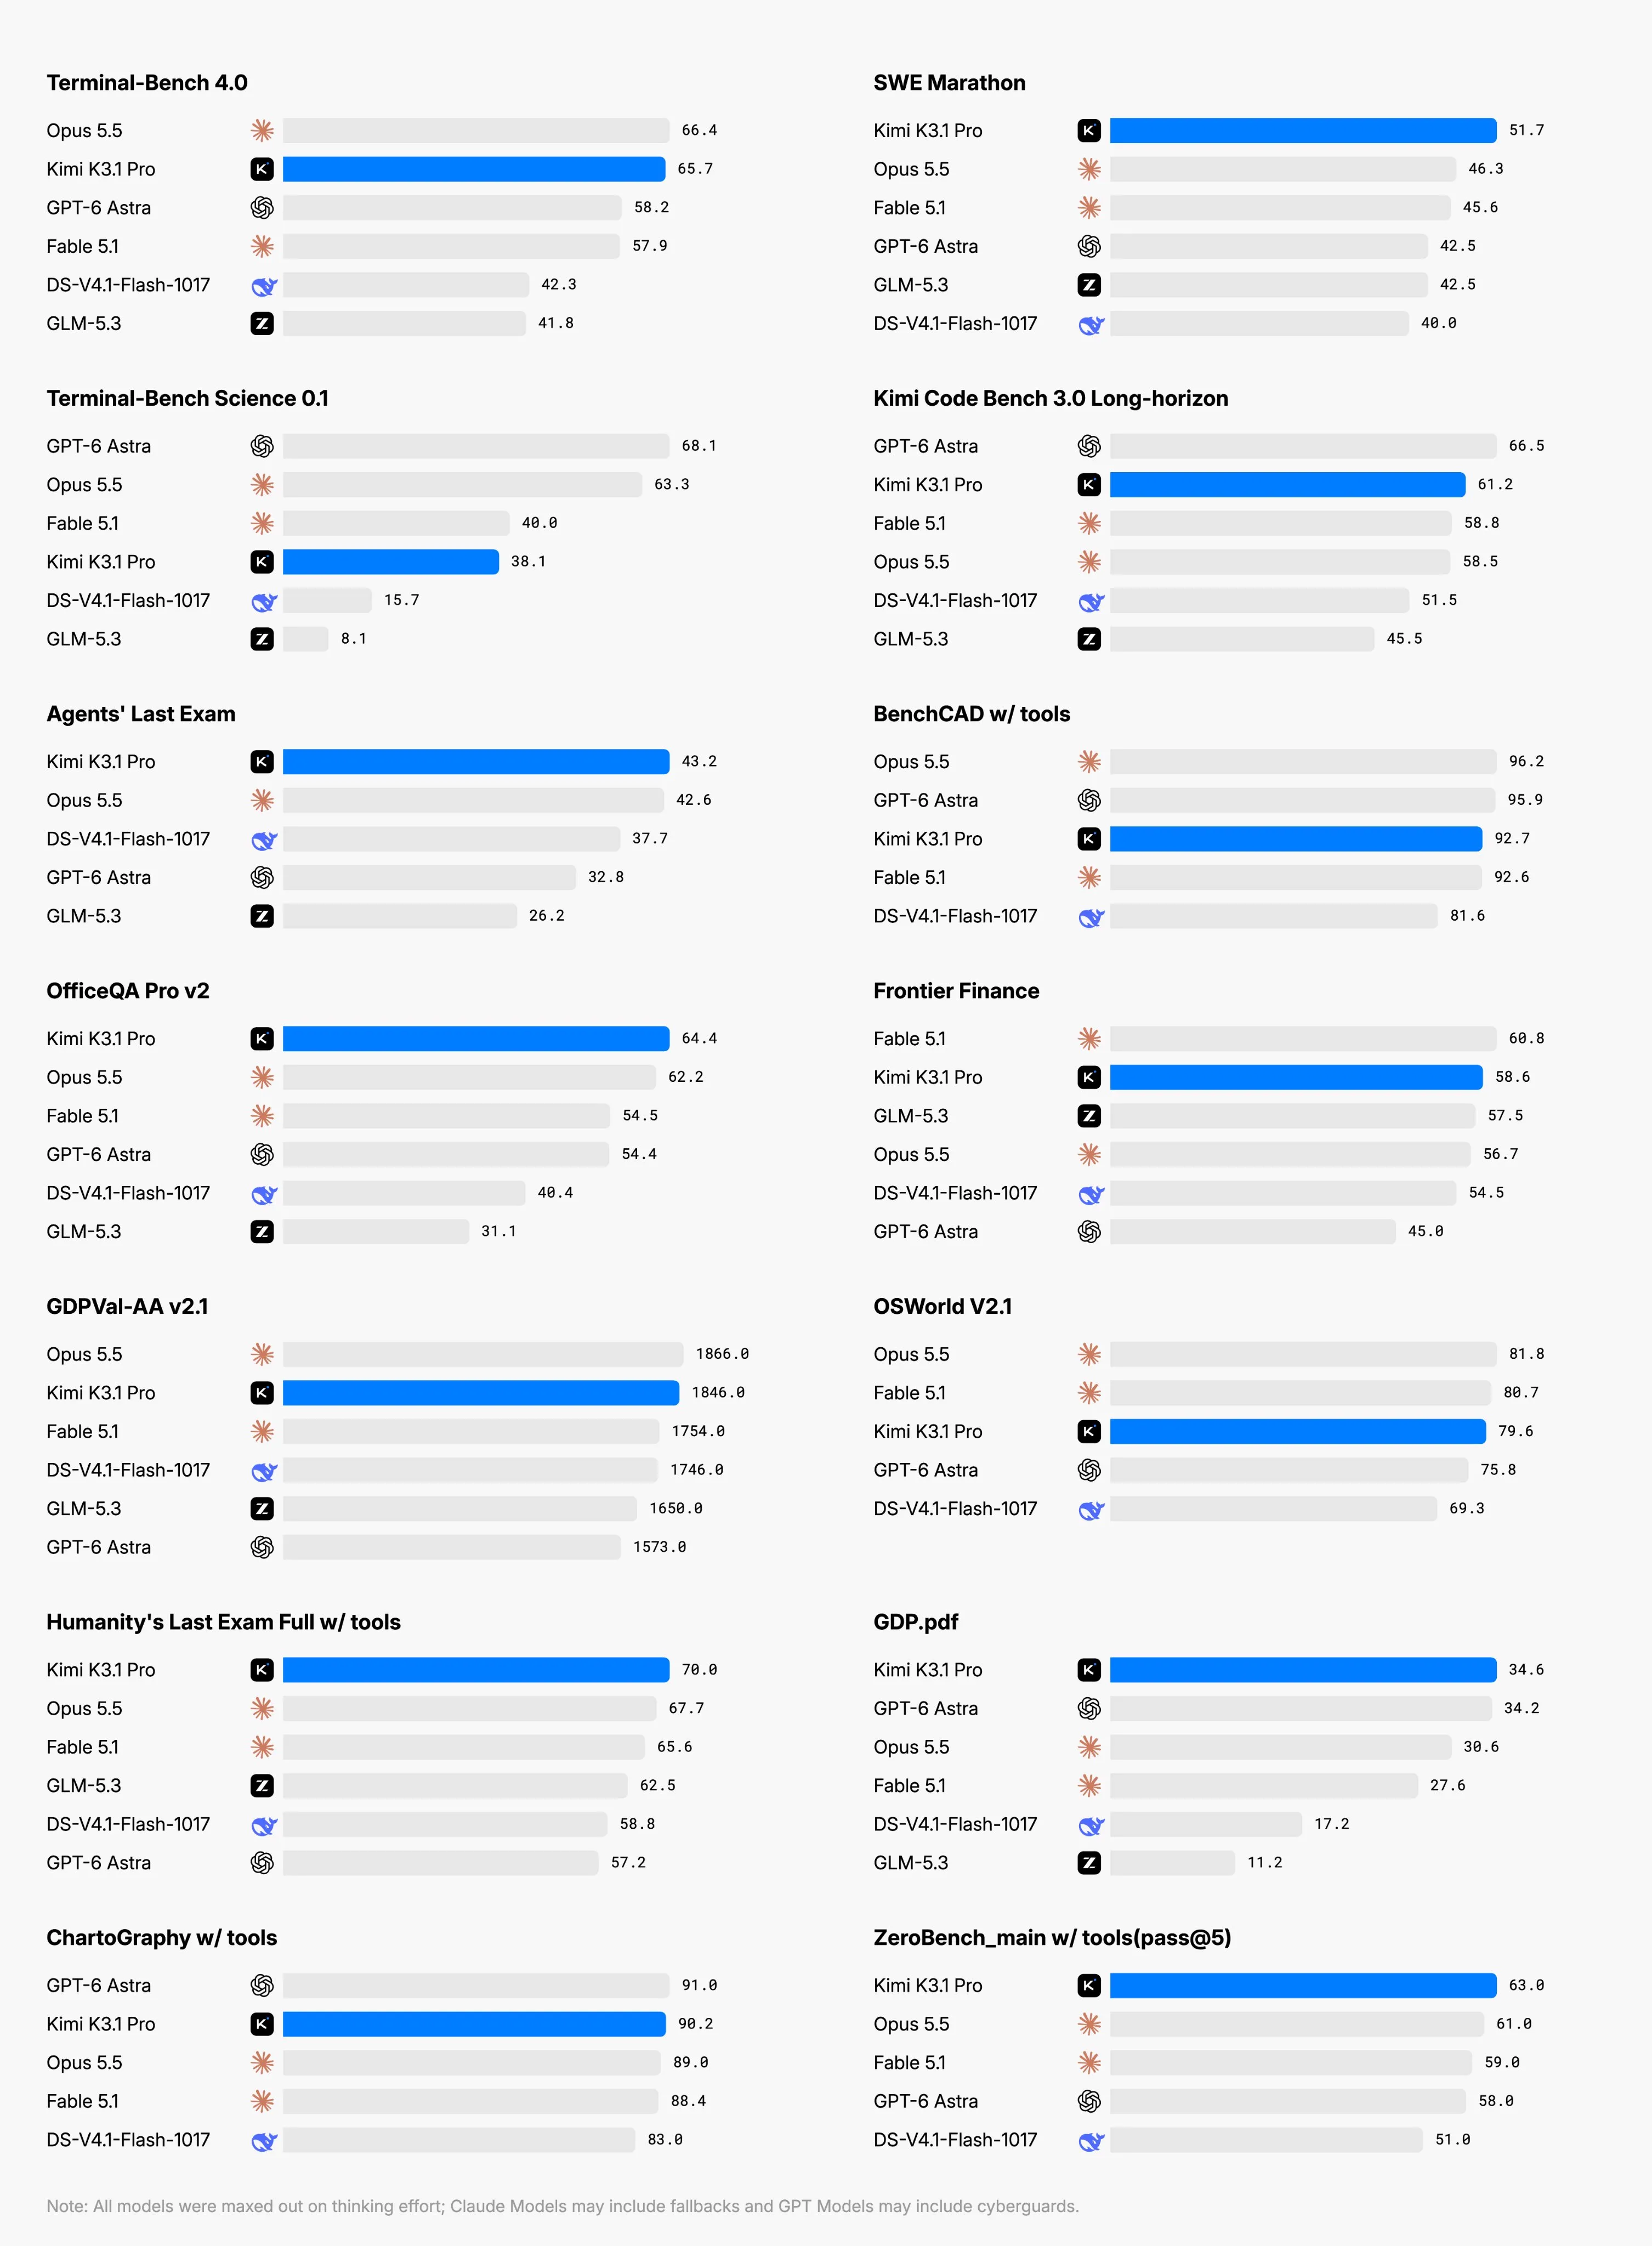
Moonshot AI 发布了新版 Kimi 模型,但遗憾的是,看起来没有什么理由选择它。
它的主要问题在于,价格与性能不匹配。 这款模型还不错,但每百万输出 token 的价格为 10 美元,而且 token 用量相当高。它的智能水平明显不如 GPT 6.1 Sol,使用成本却是后者的 3 倍。
在编程任务上,DeepSeek V4.1 Flash 1017 的表现优于它,价格却只有它的六分之一。
它是一款相当不错的模型,绝对能跻身中国模型前三,与 GLM 5.3 和 DeepSeek V4.1 Flash 并列。但它的价格分别是这两款模型的 2 倍和 6 倍,因此很难推荐。
结语
希望你喜欢本周的资讯。如果你想每周收到这些资讯,记得在下方订阅我们的邮件列表。