Nota: Este artigo foi traduzido automaticamente com OpenAI gpt-6.1-sol por meio do Codex CLI; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
GPT 6.1 Terra
Em uma surpresa e tanto, a OpenAI trouxe de volta o Terra, um modelo que ficou de fora dos lançamentos originais do GPT 6. Para quem não se lembra, o Terra é um modelo de porte médio, feito para ocupar o espaço entre o Luna e o Sol na linha da OpenAI.
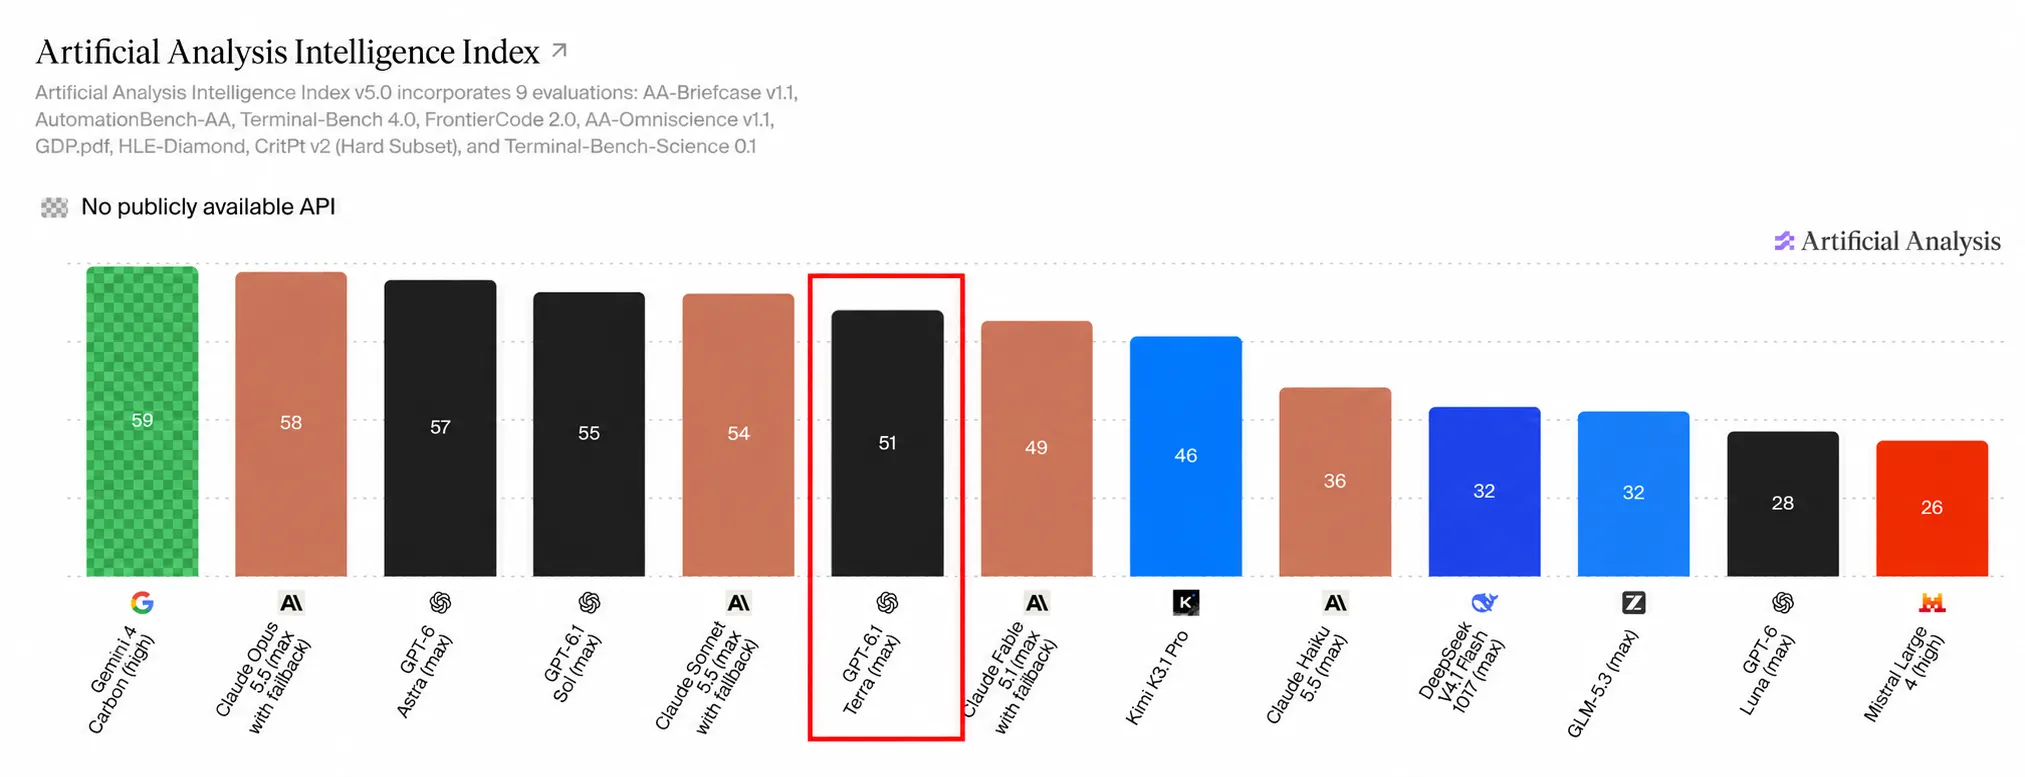
Em termos de inteligência e preço, o modelo está muito mais próximo do Sol 6.1 do que do Luna: custa metade do preço do Sol e fica apenas um pouco atrás em inteligência, enquanto o Luna está bem mais distante nesse aspecto.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| GPT 6.1 Terra | $1 | $5 | 62 |
| GPT 6.1 Sol | $2 | $10 | 31 |
| GPT 6 Luna | $0,10 | $0,50 | 35 |
| Claude Haiku 5.5 | $0,10 | $0,50 | 152 |
| Claude Opus 5.5 | $4 | $20 | 68 |
| Claude Sonnet 5.5 | $2 | $10 | 84 |
Um engenheiro da OpenAI fez o melhor resumo da comparação com o Sol e o Astra: “O Terra provavelmente é melhor que o Astra e o Sol em comunicação técnica, semelhante em visão e uso do computador (sendo mais rápido e barato) e um pouco pior na maioria das outras coisas.”
Ele acrescenta que este não é um lançamento bombástico, mas uma boa opção intermediária para completar a linha da OpenAI. É bom ver a OpenAI trabalhar na capacidade de comunicação do modelo, porque, na minha opinião, essa é uma das áreas em que ela parece estar bem atrás do Opus 5.5.
Vale observar que, com base nas pontuações dos benchmarks, você provavelmente só deve usar o Terra com o nível de raciocínio extra-alto ou máximo. Ao contrário de outros modelos da OpenAI, que não apresentam grandes saltos entre os níveis de raciocínio, o Terra é muito sensível a essa configuração: no nível baixo, ele é basicamente equivalente ao Luna; no máximo, fica logo atrás do Sol. Portanto, a diferença é bastante grande.
Pesquisa
Frontier Code 2.0
É difícil encontrar bons benchmarks. Para benchmarks de programação, eu usava o DeepSWE, pois seus resultados correspondiam à minha percepção de como os modelos se comparavam no uso real.
Infelizmente, era um benchmark público, o que significa que os criadores dos modelos podiam ver todas as questões e os critérios de avaliação. Assim, conseguiam ajustar seus modelos especificamente ao benchmark para que eles apresentassem bons resultados.
Isso nos deu apenas cerca de um mês de pontuações úteis antes de o benchmark se tornar obsoleto. Desde então, eu precisava de um bom benchmark de programação para usar como referência.
Felizmente, a equipe da Cognition, responsável pelo Devin e pelo Windsurf, chegou para preencher essa lacuna com seu benchmark Frontier Code 2.0.
Eles não avaliam apenas se a implementação está correta, mas também se o código está pronto para ser integrado ao projeto. Trabalharam com mantenedores de projetos de código aberto para criar um conjunto de questões e critérios de aceitação, além de avaliadores que verificavam se a nova funcionalidade havia sido adicionada ou o bug corrigido. Também verificavam se as alterações consideravam o contexto presente no restante do código e se eram feitas com o mínimo de mudanças e de forma eficiente.
Eles dedicaram mais de 40 horas a cada questão e também criaram prompts com tarefas que não estavam totalmente especificadas, como costuma acontecer no mundo real, nas quais o modelo precisa usar seu próprio julgamento para decidir o que de fato deve ser feito.
Ao contrário do DeepSWE, que era público, o Frontier Code é totalmente privado. Isso torna muito mais difícil para os laboratórios de IA ajustar seus modelos especificamente ao benchmark. Espero, portanto, que ele forneça resultados úteis por mais de um mês.
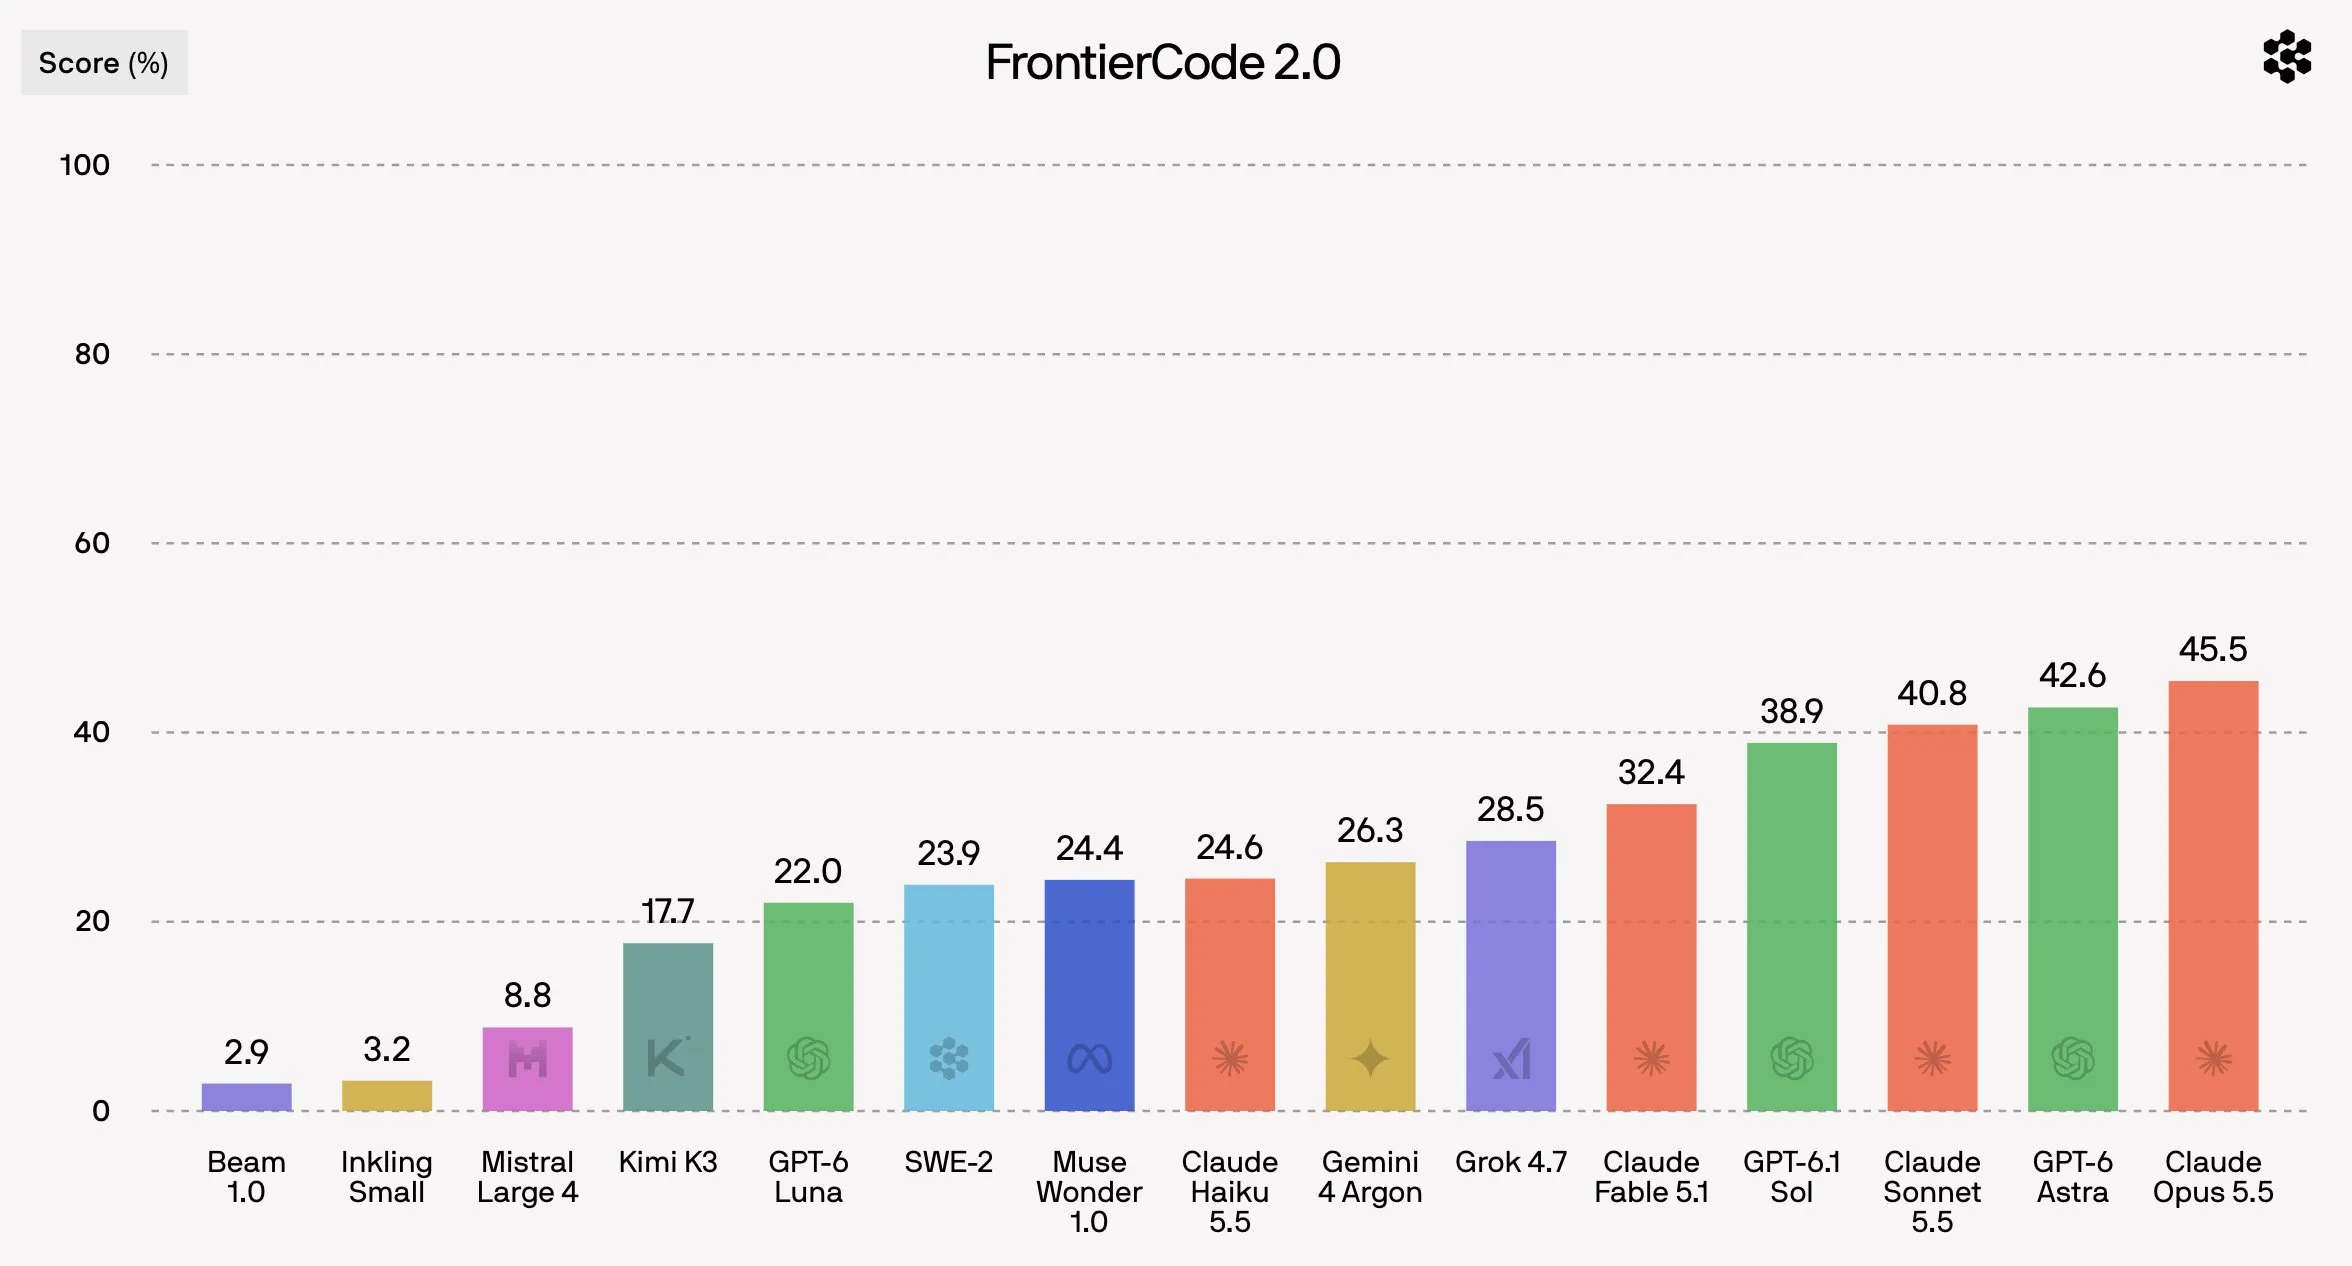
Todos os modelos que eu esperava ver no topo do benchmark estão lá. Este benchmark favorece um pouco os modelos Claude, pois eles tendem a agir de forma mais autônoma do que os modelos GPT, que costumam seguir as instruções de maneira muito rígida. Isso pode ser bom ou ruim, dependendo de como você usa o modelo.
O benchmark já foi incorporado ao Artificial Analysis V5 Intelligence Index, e pretendo usá-lo como minha principal referência para avaliar a capacidade de programação dos modelos daqui em diante.
Notas rápidas
LFM 3
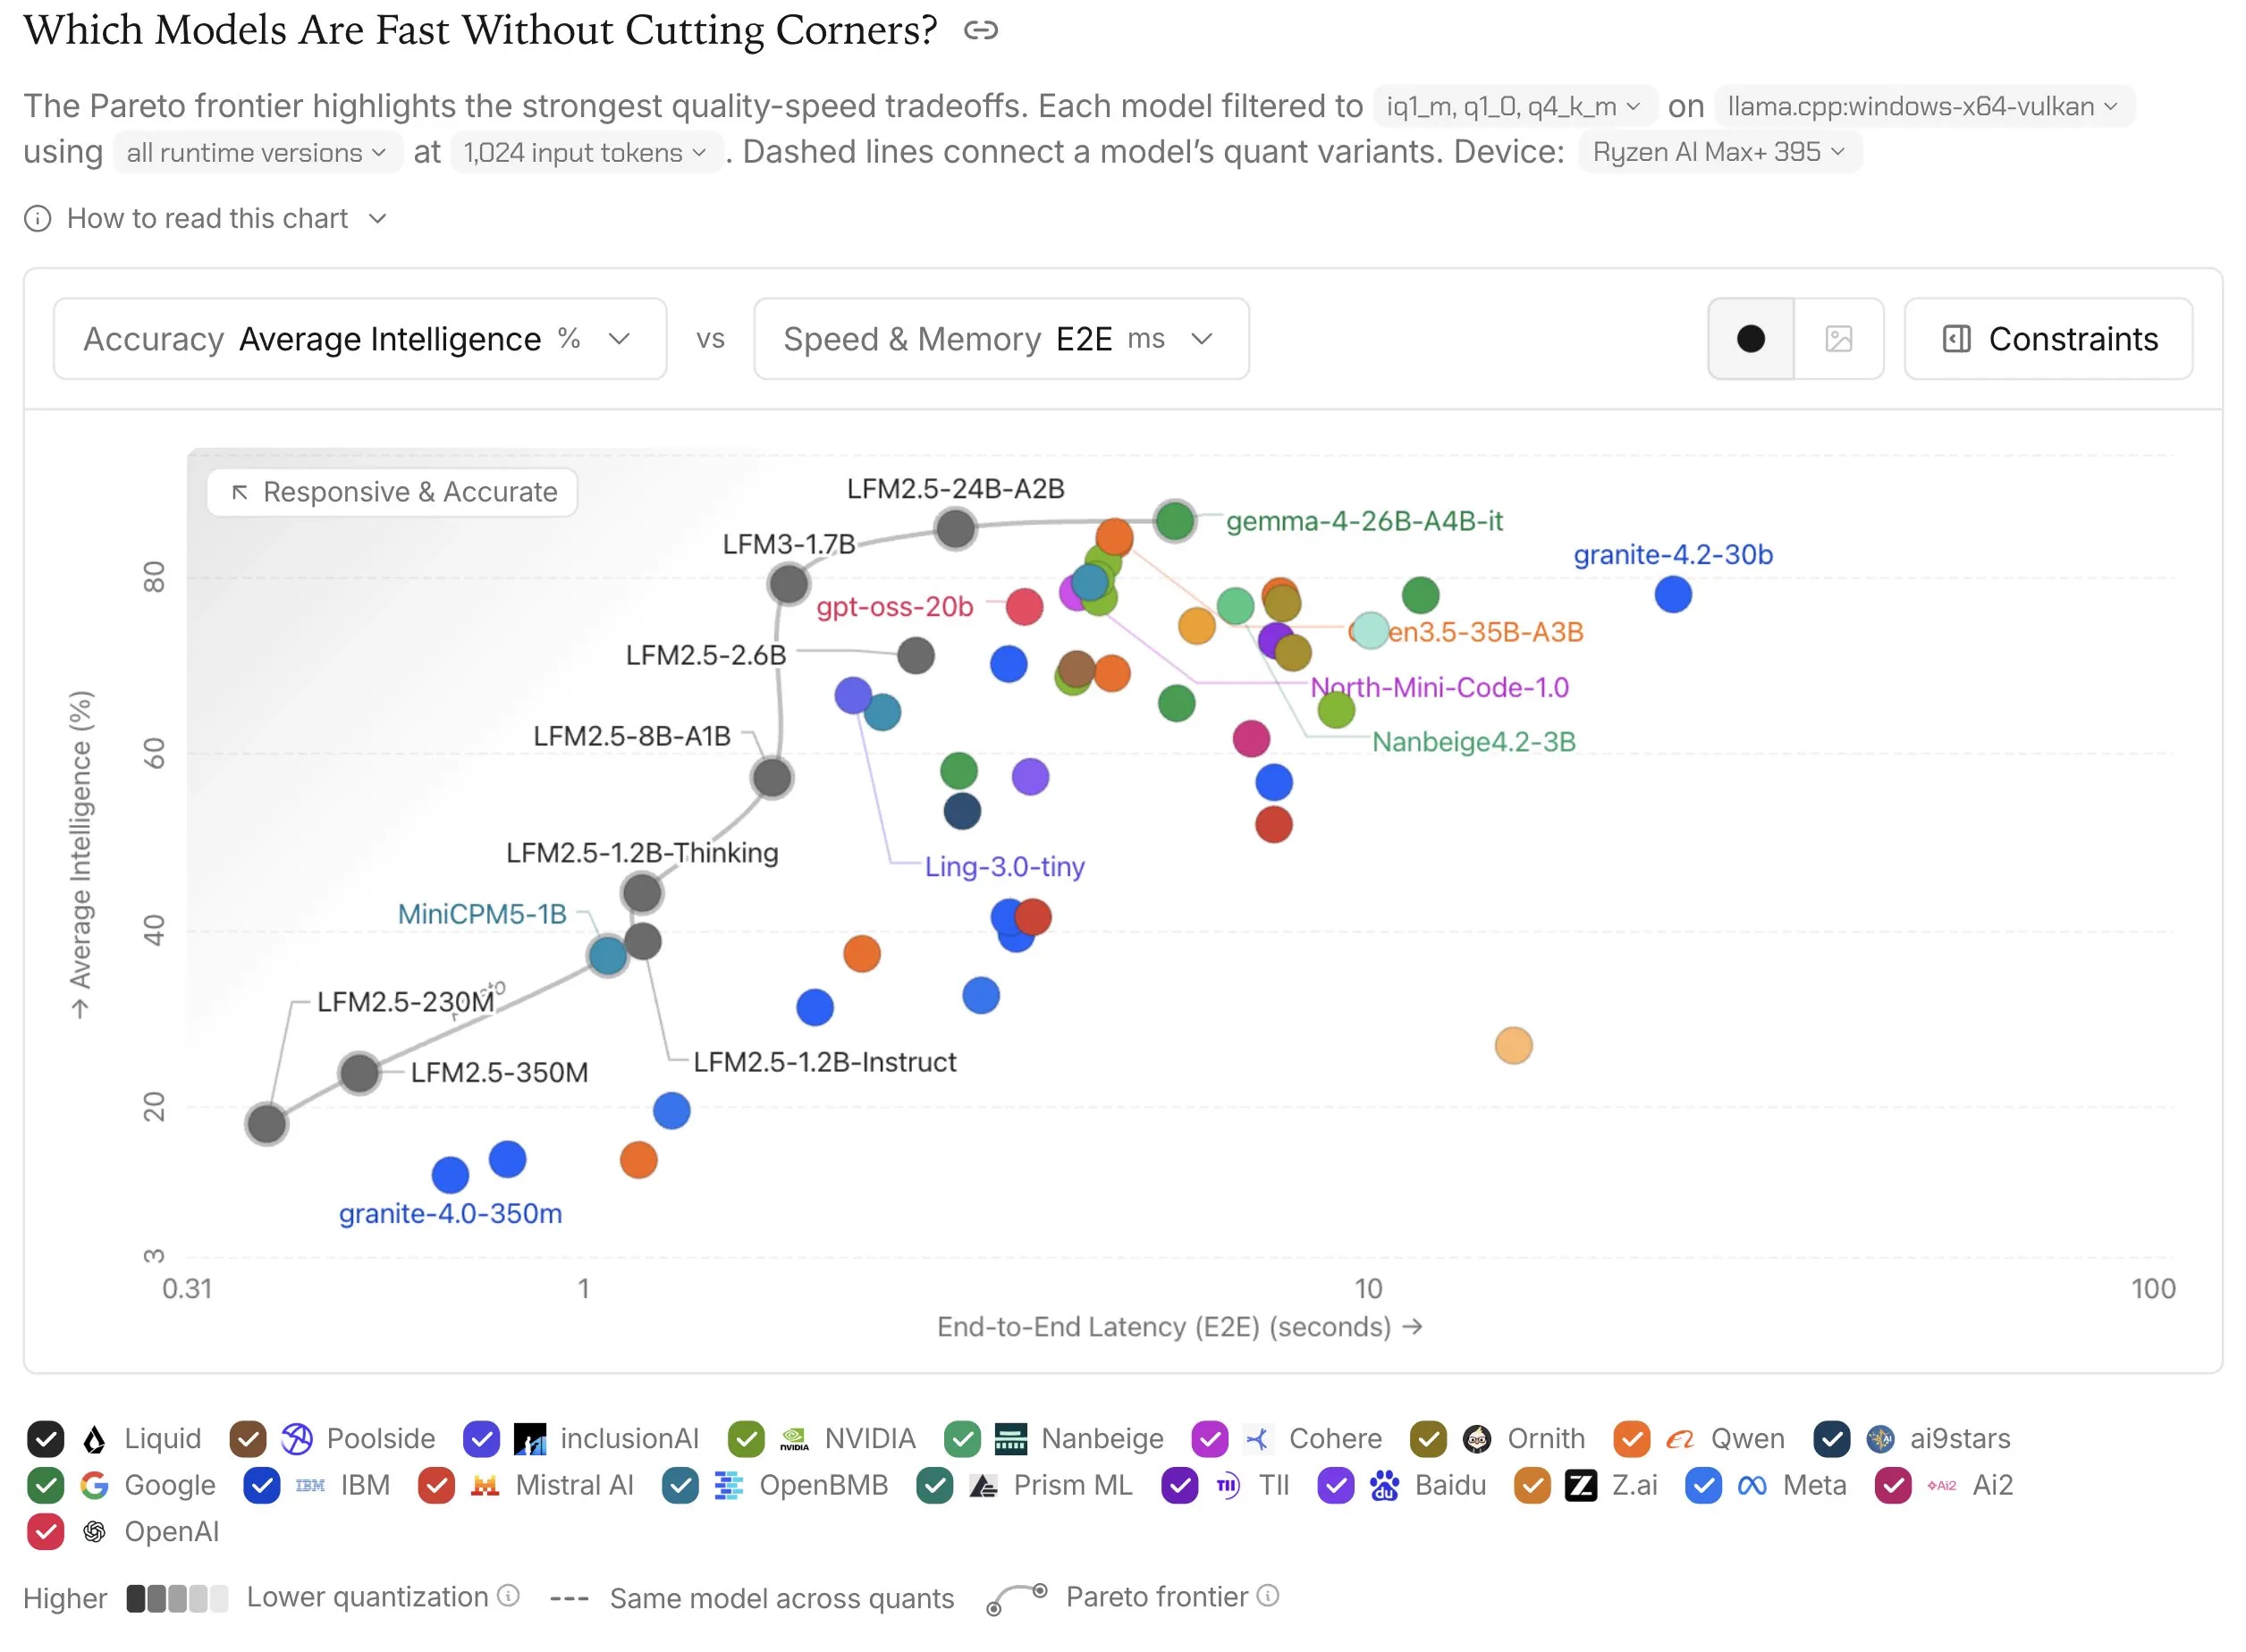
Os modelos LFM têm sido os melhores para rodar em dispositivos com poucos recursos, como celulares, ou no navegador do usuário com ferramentas como o Transformers.js. Agora, eles têm uma versão atualizada para ampliar ainda mais sua vantagem nessa área.
O LFM 3 é um modelo de 1,7 bilhão de parâmetros cuja arquitetura foi otimizada especificamente para hardware de dispositivos móveis. Não espere ficar de queixo caído, mas ele é capaz de executar tarefas básicas de agentes em tempo hábil, de forma totalmente local.
Kimi K3.1 Pro
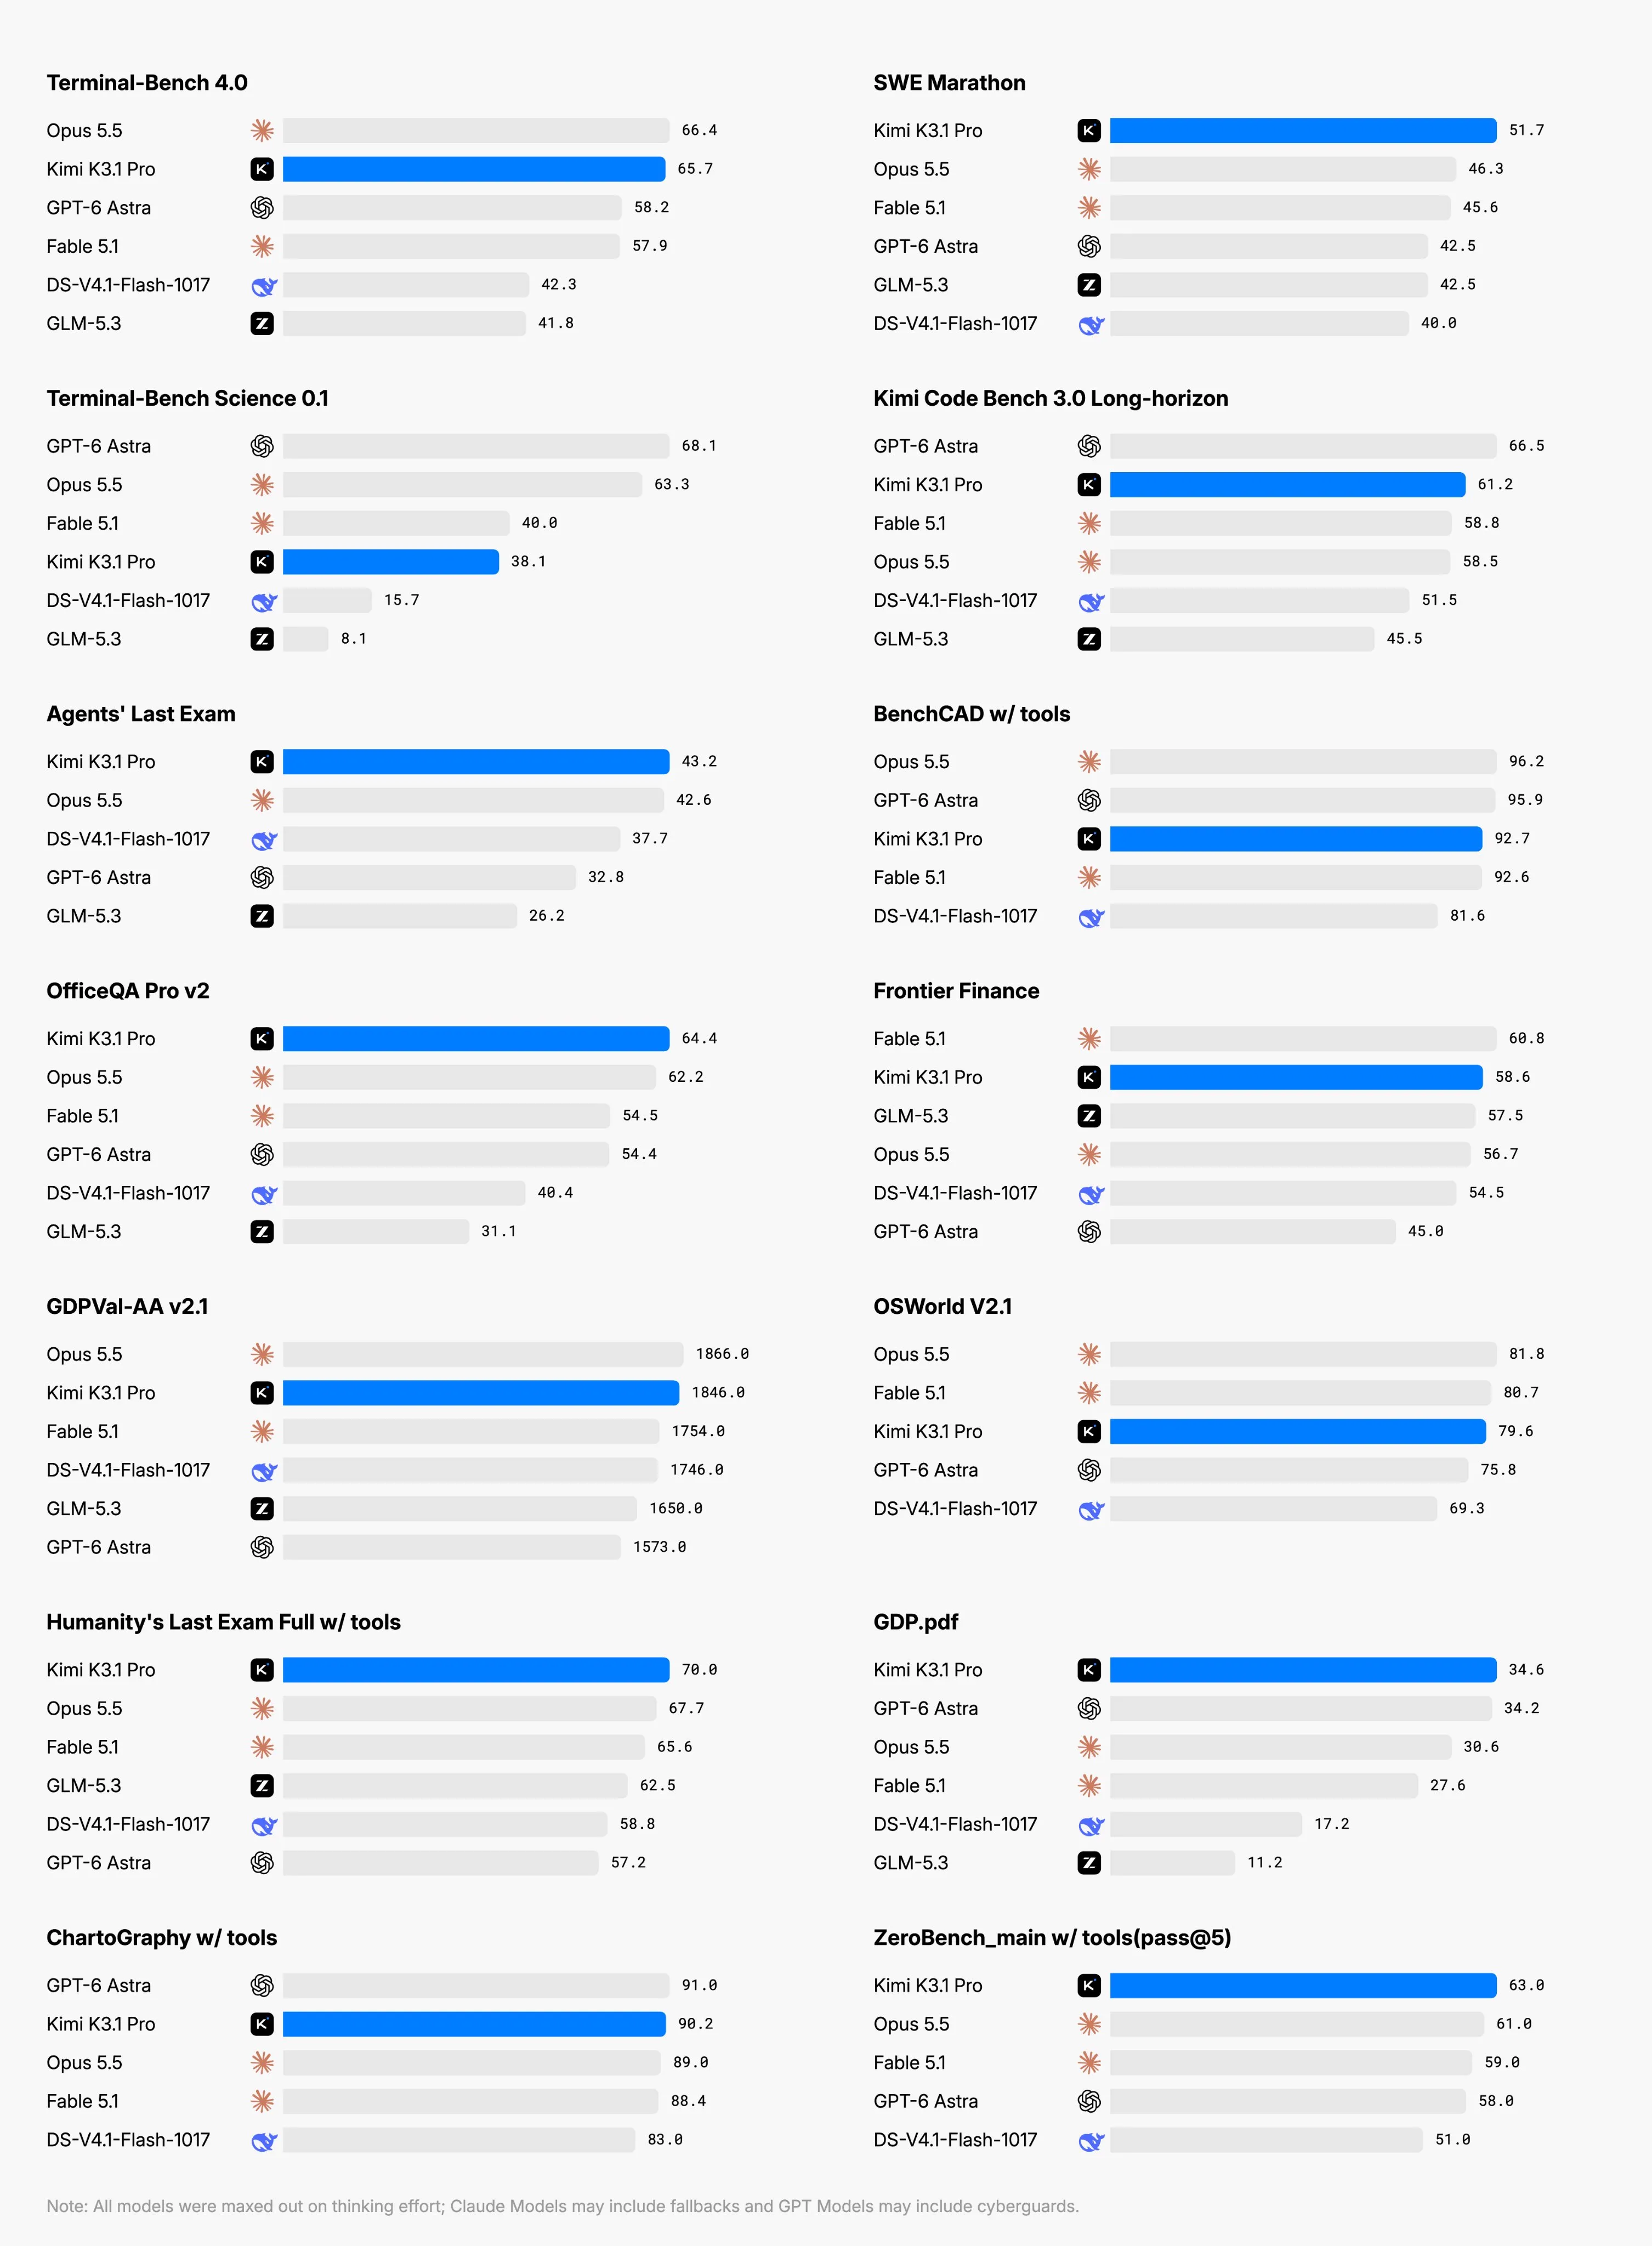
A Moonshot AI lançou a nova versão de seu modelo Kimi, mas, infelizmente, parece não haver motivo para usá-lo.
Seu principal problema é o preço em relação ao desempenho. É um modelo razoável, mas, a $10 por milhão de tokens de saída e com um consumo de tokens bastante alto, ele é visivelmente menos inteligente que o GPT 6.1 Sol, embora custe três vezes mais.
Em tarefas de programação, o DeepSeek V4.1 Flash 1017 o supera e custa seis vezes menos.
É um modelo bastante razoável, certamente entre os três melhores da China, ao lado do GLM 5.3 e do DeepSeek V4.1 Flash. Mas custa duas e seis vezes mais que eles, respectivamente, o que torna difícil recomendá-lo.
Encerramento
Espero que você tenha gostado das notícias desta semana. Se quiser receber as notícias toda semana, inscreva-se na nossa lista de e-mails abaixo.