
Nota: Este artículo fue traducido automáticamente con OpenAI GPT-5.5 mediante Codex CLI; la calidad puede verse degradada, especialmente en la terminología técnica.
Noticias
OpenAI se divorcia de Cursor
OpenAI anunció esta semana que pondrá fin a su asociación con Cursor, lo que hará que los usuarios de Cursor pierdan acceso a los modelos de OpenAI. Se espera que la asociación termine el 12 de noviembre de este año.
Contexto importante para quienes no lo sepan: Cursor fue comprado por SpaceX, y el acuerdo se cerró hace 2 semanas.
Según OpenAI, esto se debe a una falta de confianza en las empresas de Elon Musk:
Estamos tomando esta decisión porque no podemos confiar en que SpaceX usará nuestra tecnología dentro de nuestros términos de servicio, según nuestra experiencia con empresas de Elon Musk que han incumplido contratos.
Creo que las razones subyacentes aquí son dos; la primera es el odio entre Sam Altman y Elon Musk. Recientemente tuvieron una batalla judicial muy pública (de la que en realidad no salió mucho), derivada de la reestructuración de OpenAI de una organización sin fines de lucro a una empresa con fines de lucro, algo que Elon (uno de los fundadores de OpenAI, pero que se fue en 2018) objetó.
La segunda razón, y más importante, es que OpenAI parece estar insinuando que SpaceXAI está destilando sus modelos mediante Cursor y otros entornos para entrenar Grok. Este tipo de destilación es útil, pero no suficiente, para entrenar un modelo frontier. Históricamente, Anthropic es quien se ha preocupado por esto (sobre todo en relación con los laboratorios de IA chinos), pero ahora OpenAI parece preocuparse también, aunque por competencia nacional.
Curiosamente, Anthropic reforzó su compromiso con Cursor, diciendo que seguirá aumentando el cómputo para dar soporte a Claude en Cursor. Es muy probable que esta actitud amistosa no se deba al amor de Anthropic por Cursor, sino al hecho de que tienen un contrato de cómputo de 45 mil millones de dólares con SpaceX.
Cursor ha dicho que están hablando ahora mismo con el equipo de OpenAI para intentar resolver esto, y subrayó que OpenAI solo representa el 5% del tráfico de Cursor.
Si eres usuario de Cursor y usas modelos de OpenAI, no necesitas abandonar el barco todavía, pero yo estaría preparado mentalmente para hacerlo en los próximos meses (de todos modos, obtienes mucho mejor valor con un plan de suscripción de OpenAI que con un plan de Cursor, así que recomendaría cambiar solo por esa razón).
Lanzamientos
GLM 5.3 Flash
Ha habido bastante expectativa en torno a un modelo anónimo llamado Ox Alpha durante las últimas semanas, y se ha revelado que era GLM 5.3 Flash el que se estaba probando.
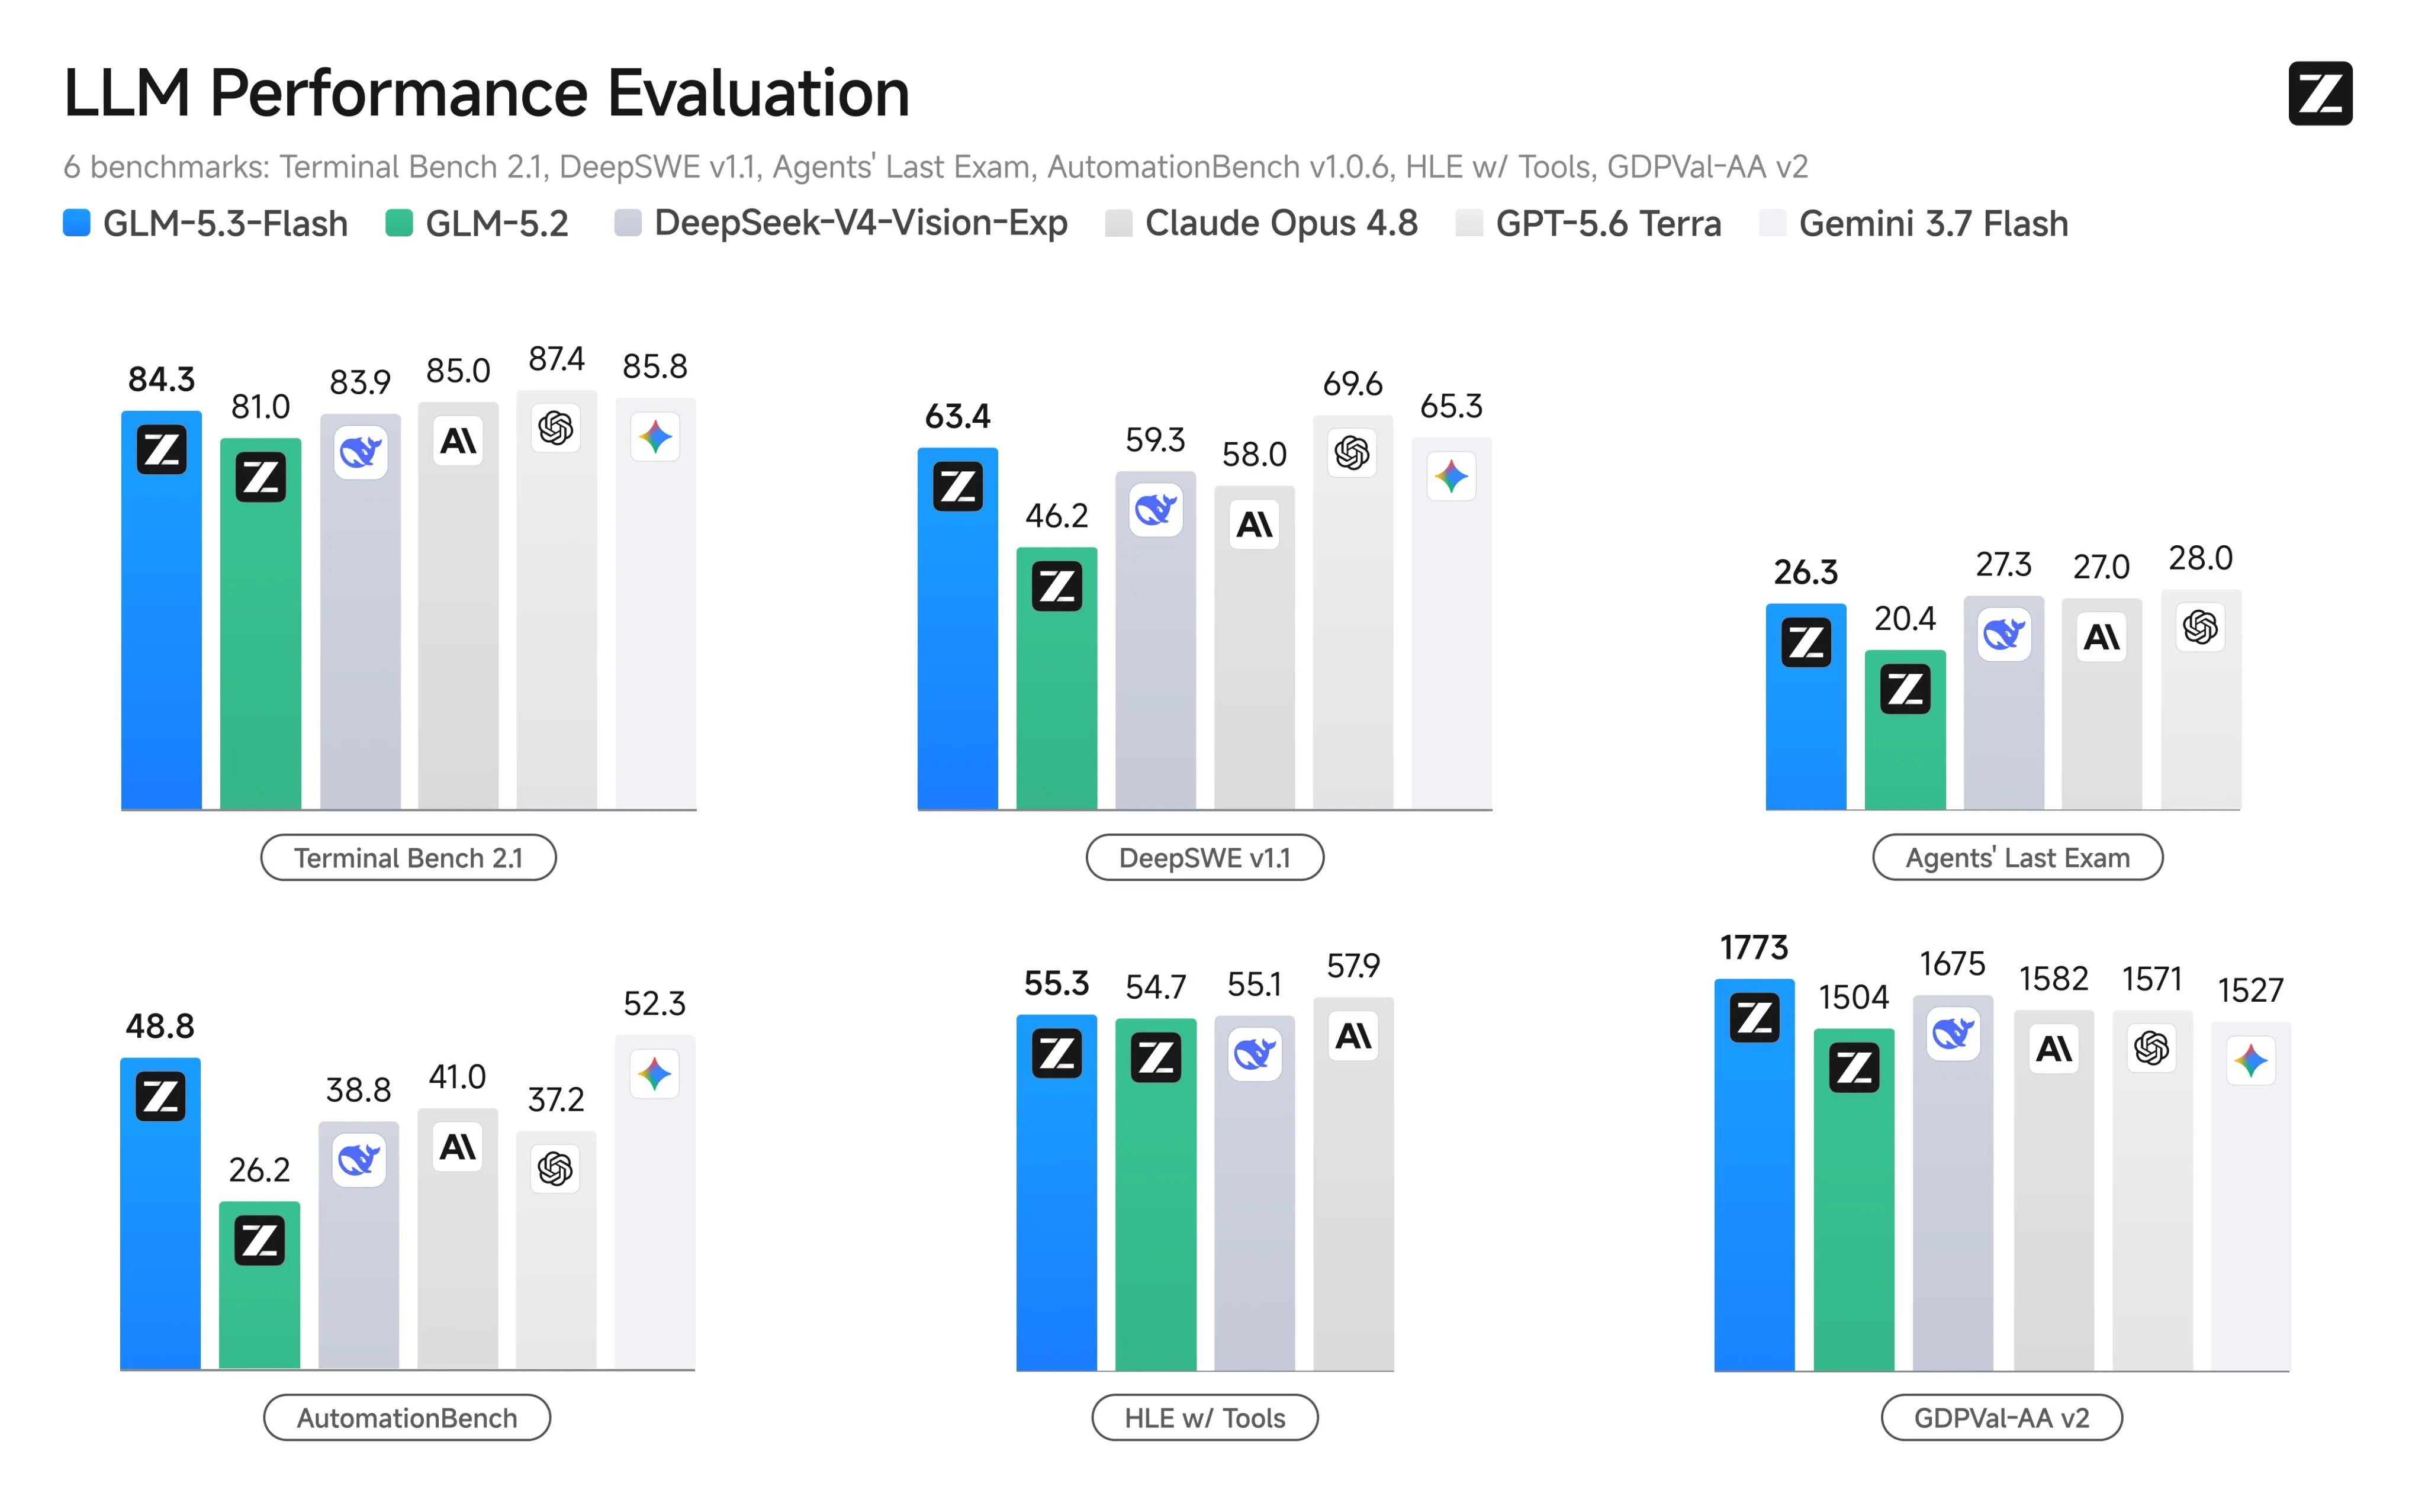
A pesar de ser un modelo flash “más pequeño”, 3 veces menor (320B-A18B) que su hermano mayor, es un modelo muy capaz. Pasa la prueba práctica en el mundo real y parece estar un paso por encima de DeepSeek V4 Flash y GPT 5.6 Luna, que son los principales modelos “pequeños” que tenemos ahora mismo.
Normalmente, con estos modelos más pequeños, usan una gran cantidad de tokens, lo que compensa parcialmente su menor precio, pero Z.ai ha hecho un buen trabajo limitando la longitud del razonamiento en GLM 5.3 Flash. Todavía no está al mismo nivel de uso eficiente de tokens que Luna, pero lo compensa con más inteligencia.
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| GLM 5.3 Flash | $0.15 | $0.50 | 28 |
| DeepSeek V4 Flash | $0.44 | $1.32 | 82 |
| GPT 5.6 Luna | $1 | $6 | 84 |
| Grok 4.6 | $2 | $6 | 57 |
| GLM 5.2 | $1.40 | $4.40 | 47 |
El modelo también tiene capacidades de visión, pero no son para nada impresionantes, y no están al mismo nivel que sus capacidades de texto.
Un punto interesante es que Z.ai está sirviendo el modelo usando solo GPUs chinas, lo que es la primera vez que un laboratorio chino de primer nivel lo hace (públicamente). Parece que Nvidia empieza a tener competencia importante desde China, lo que con suerte debería ser bueno para los precios de las GPUs en el futuro.
El modelo es open source (junto con el modelo grande GLM 5.3), pero es demasiado grande para ejecutarlo en hardware que no sea de centro de datos.
Este es otro modelo muy sólido, inteligente y rentable que recomendaría probar. Las mejores formas de acceder a él son OpenCode Go o el plan de coding de Z.ai.
Noticias rápidas
Qwen 3.8 Flash
Qwen 3.8 Flash es un vistazo al futuro de cómo será la arquitectura del modelo Qwen 4.
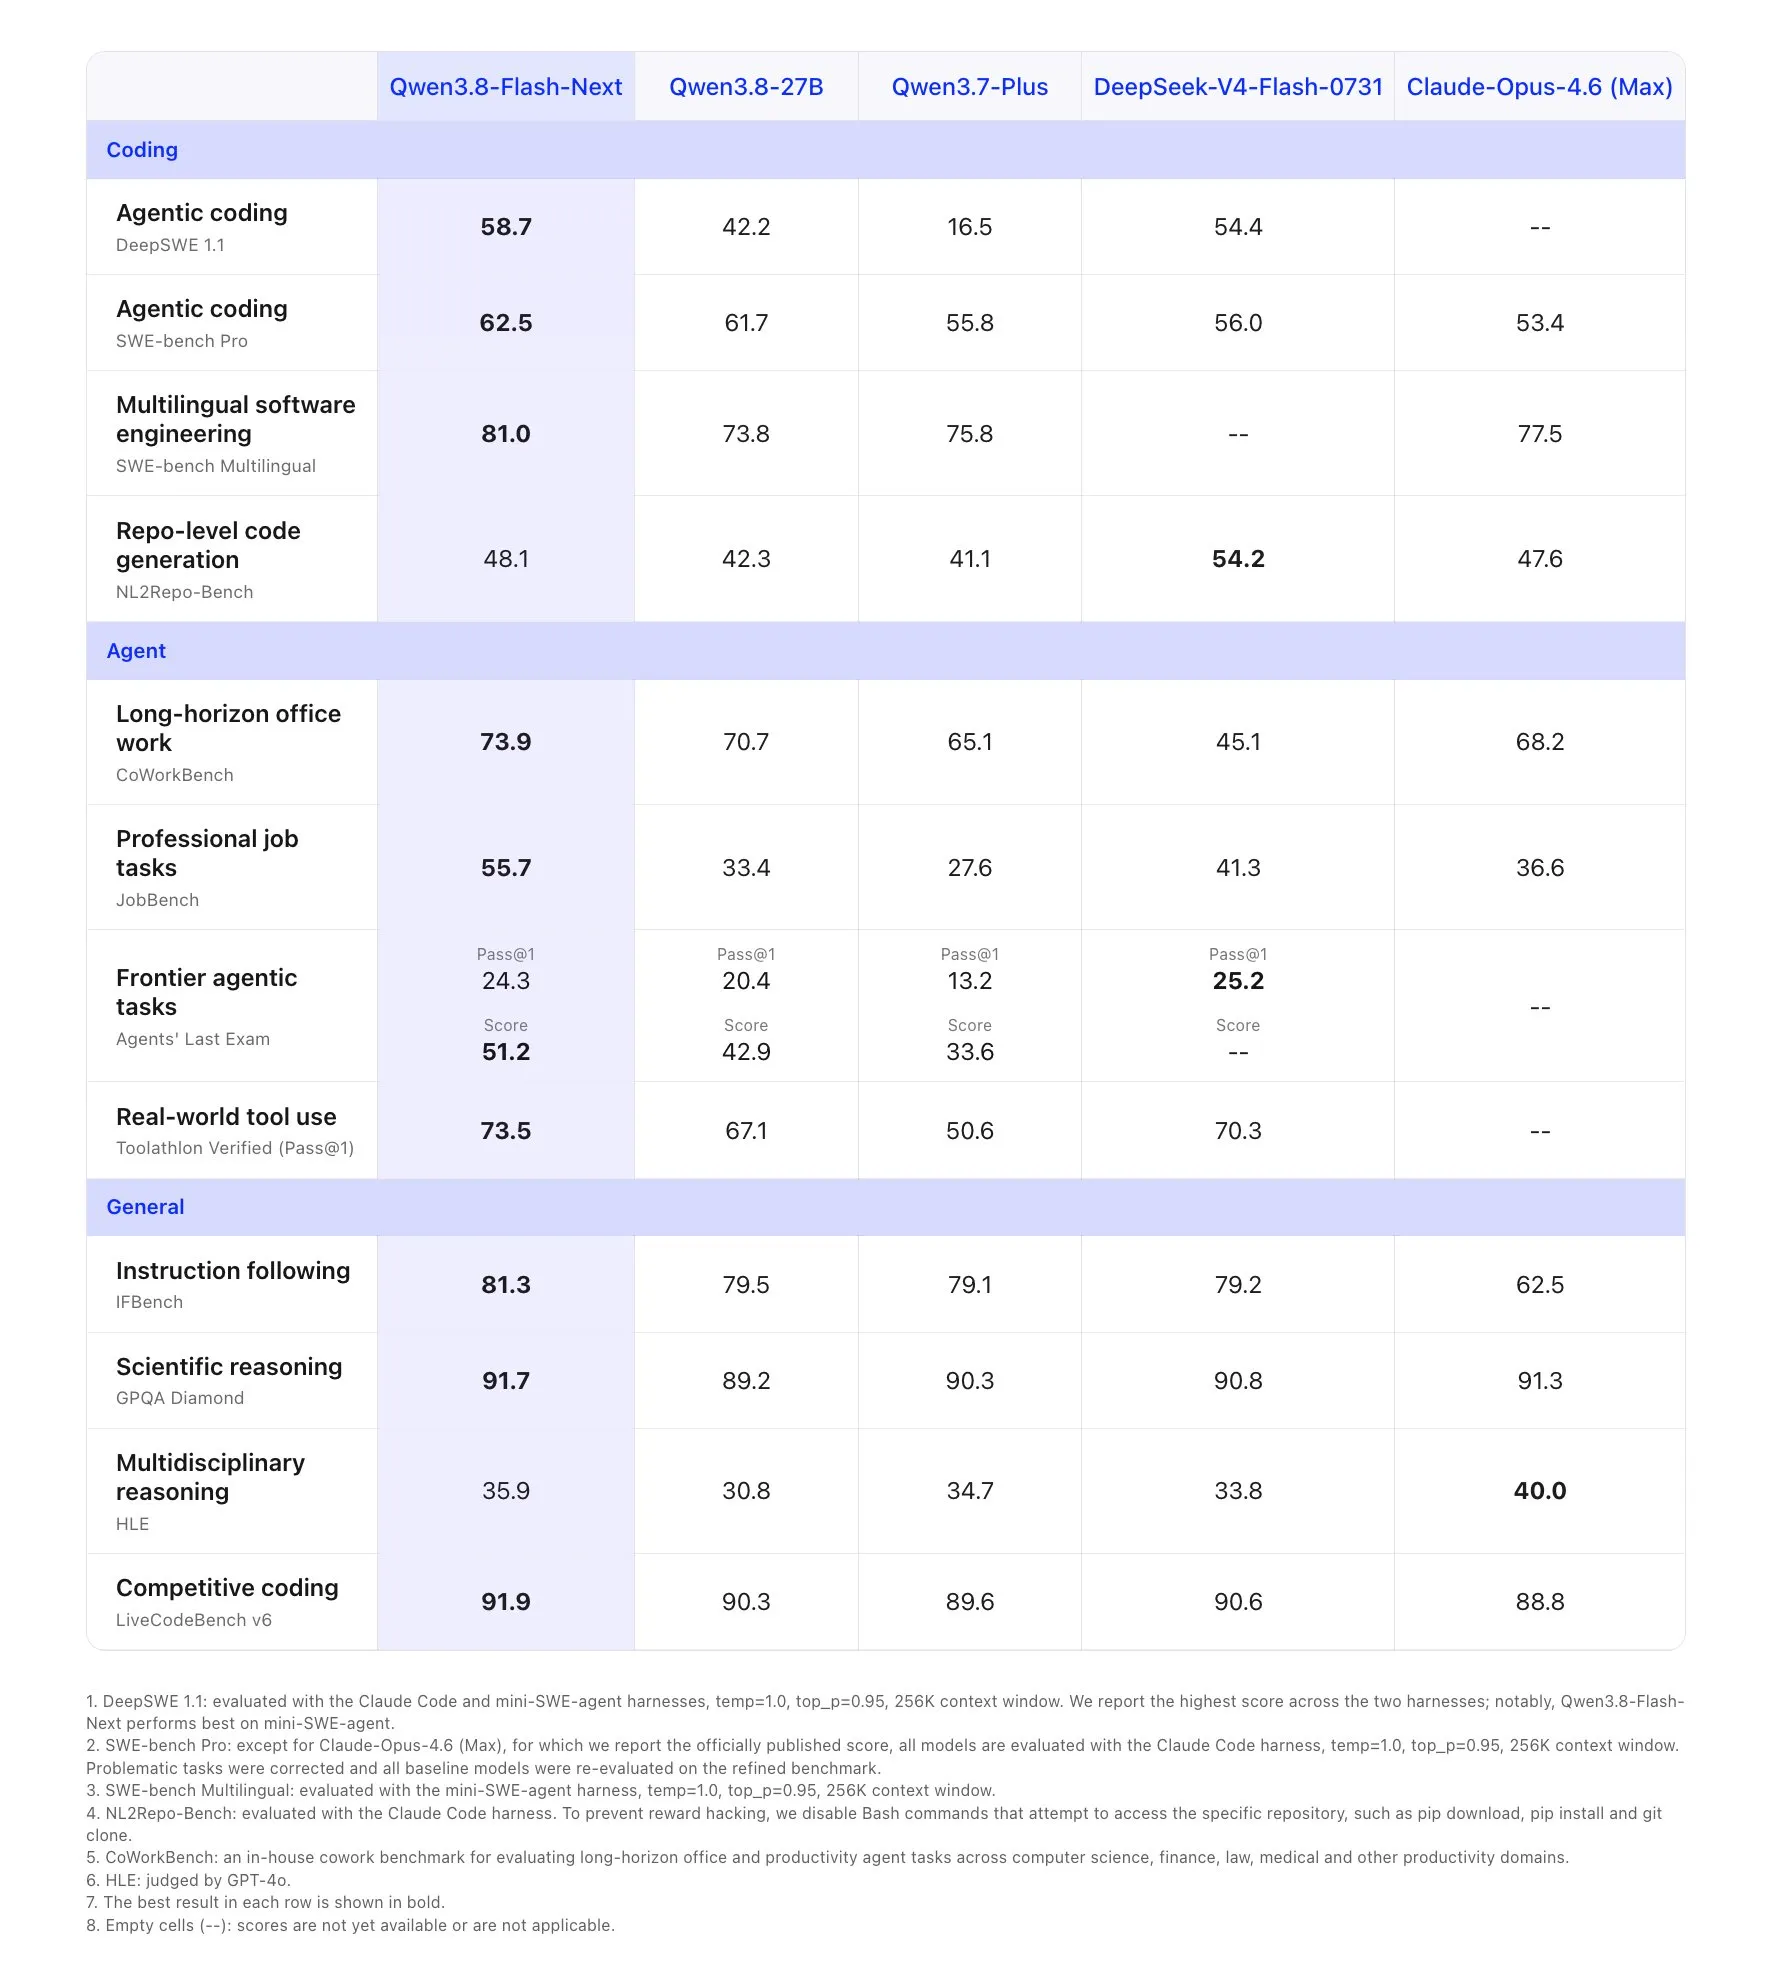
Están usando una arquitectura de estilo Engram. Esto significa que, en lugar de tener un gran modelo transformer que debe almacenar información y hechos además de aprender razonamiento correcto, hay dos módulos separados. El primero es el transformer habitual que conocemos y queremos, y luego un segundo módulo de “memoria” engram que actúa como una tabla de consulta de hechos (algo así como una base de datos para el cerebro del LLM).
El módulo engram requiere muy poco cómputo, y solo necesita memoria para cargarse, así que el modelo puede dividirse efectivamente en dos: el módulo transformer se carga en una GPU, y el módulo engram reside en la memoria del sistema (CPU). Esto te permitirá ejecutar modelos más grandes localmente, ya que no necesitarás GPUs con mucha memoria.
Este lanzamiento está pensado principalmente para dar tiempo a la comunidad a implementar y optimizar el modelo en distintos motores de inferencia de LLMs, pero probablemente también sea el mejor modelo que puedes ejecutar ahora mismo en un DGX Spark, aunque deberías estar preparado para algunos errores si lo haces.
H3 Max
MiniMax H3 ha subido hasta convertirse en uno de los mejores modelos de generación de video, y también es open source.
Uno de los mayores proveedores de inferencia de imagen y video, Fal.ai, tomó el modelo y le hizo finetuning para obtener todavía más calidad y también velocidad, lo que produjo H3 Max.
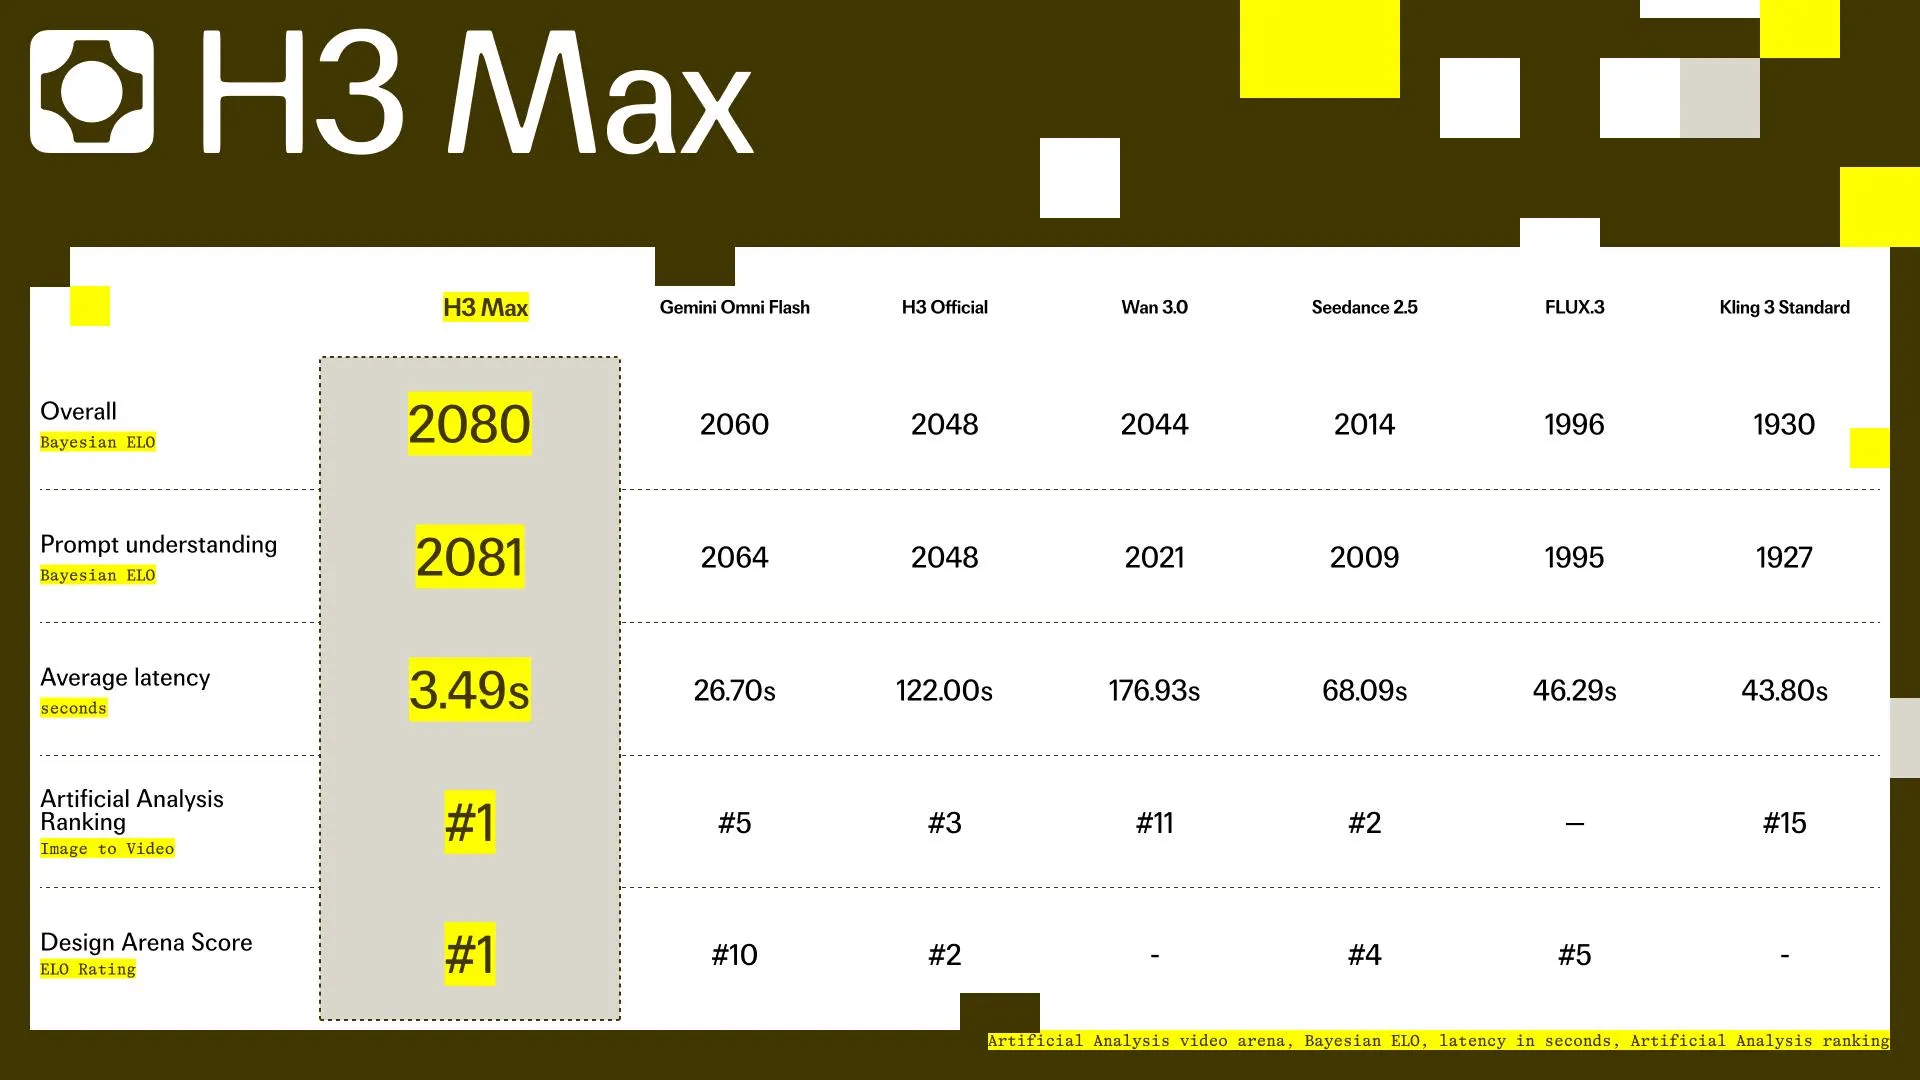
Esto da como resultado el mejor modelo de generación de video que hemos visto, y es capaz de generar video más rápido que en tiempo real: tarda 3 segundos en generar un video de 5 segundos a 768p, lo que significa que puedes obtener de él un flujo de video continuo, a un coste muy bajo ($0.20 por video de 5 segundos).
Puedes probarlo gratis ahora mismo en el sitio web de Fal.
Benchmark de IA en dispositivo
Muchas veces me han preguntado antes cuál es el mejor modelo para ejecutar en un teléfono, y ahora tenemos un ranking hecho para responder específicamente a esta pregunta, creado por Artificial Analysis.
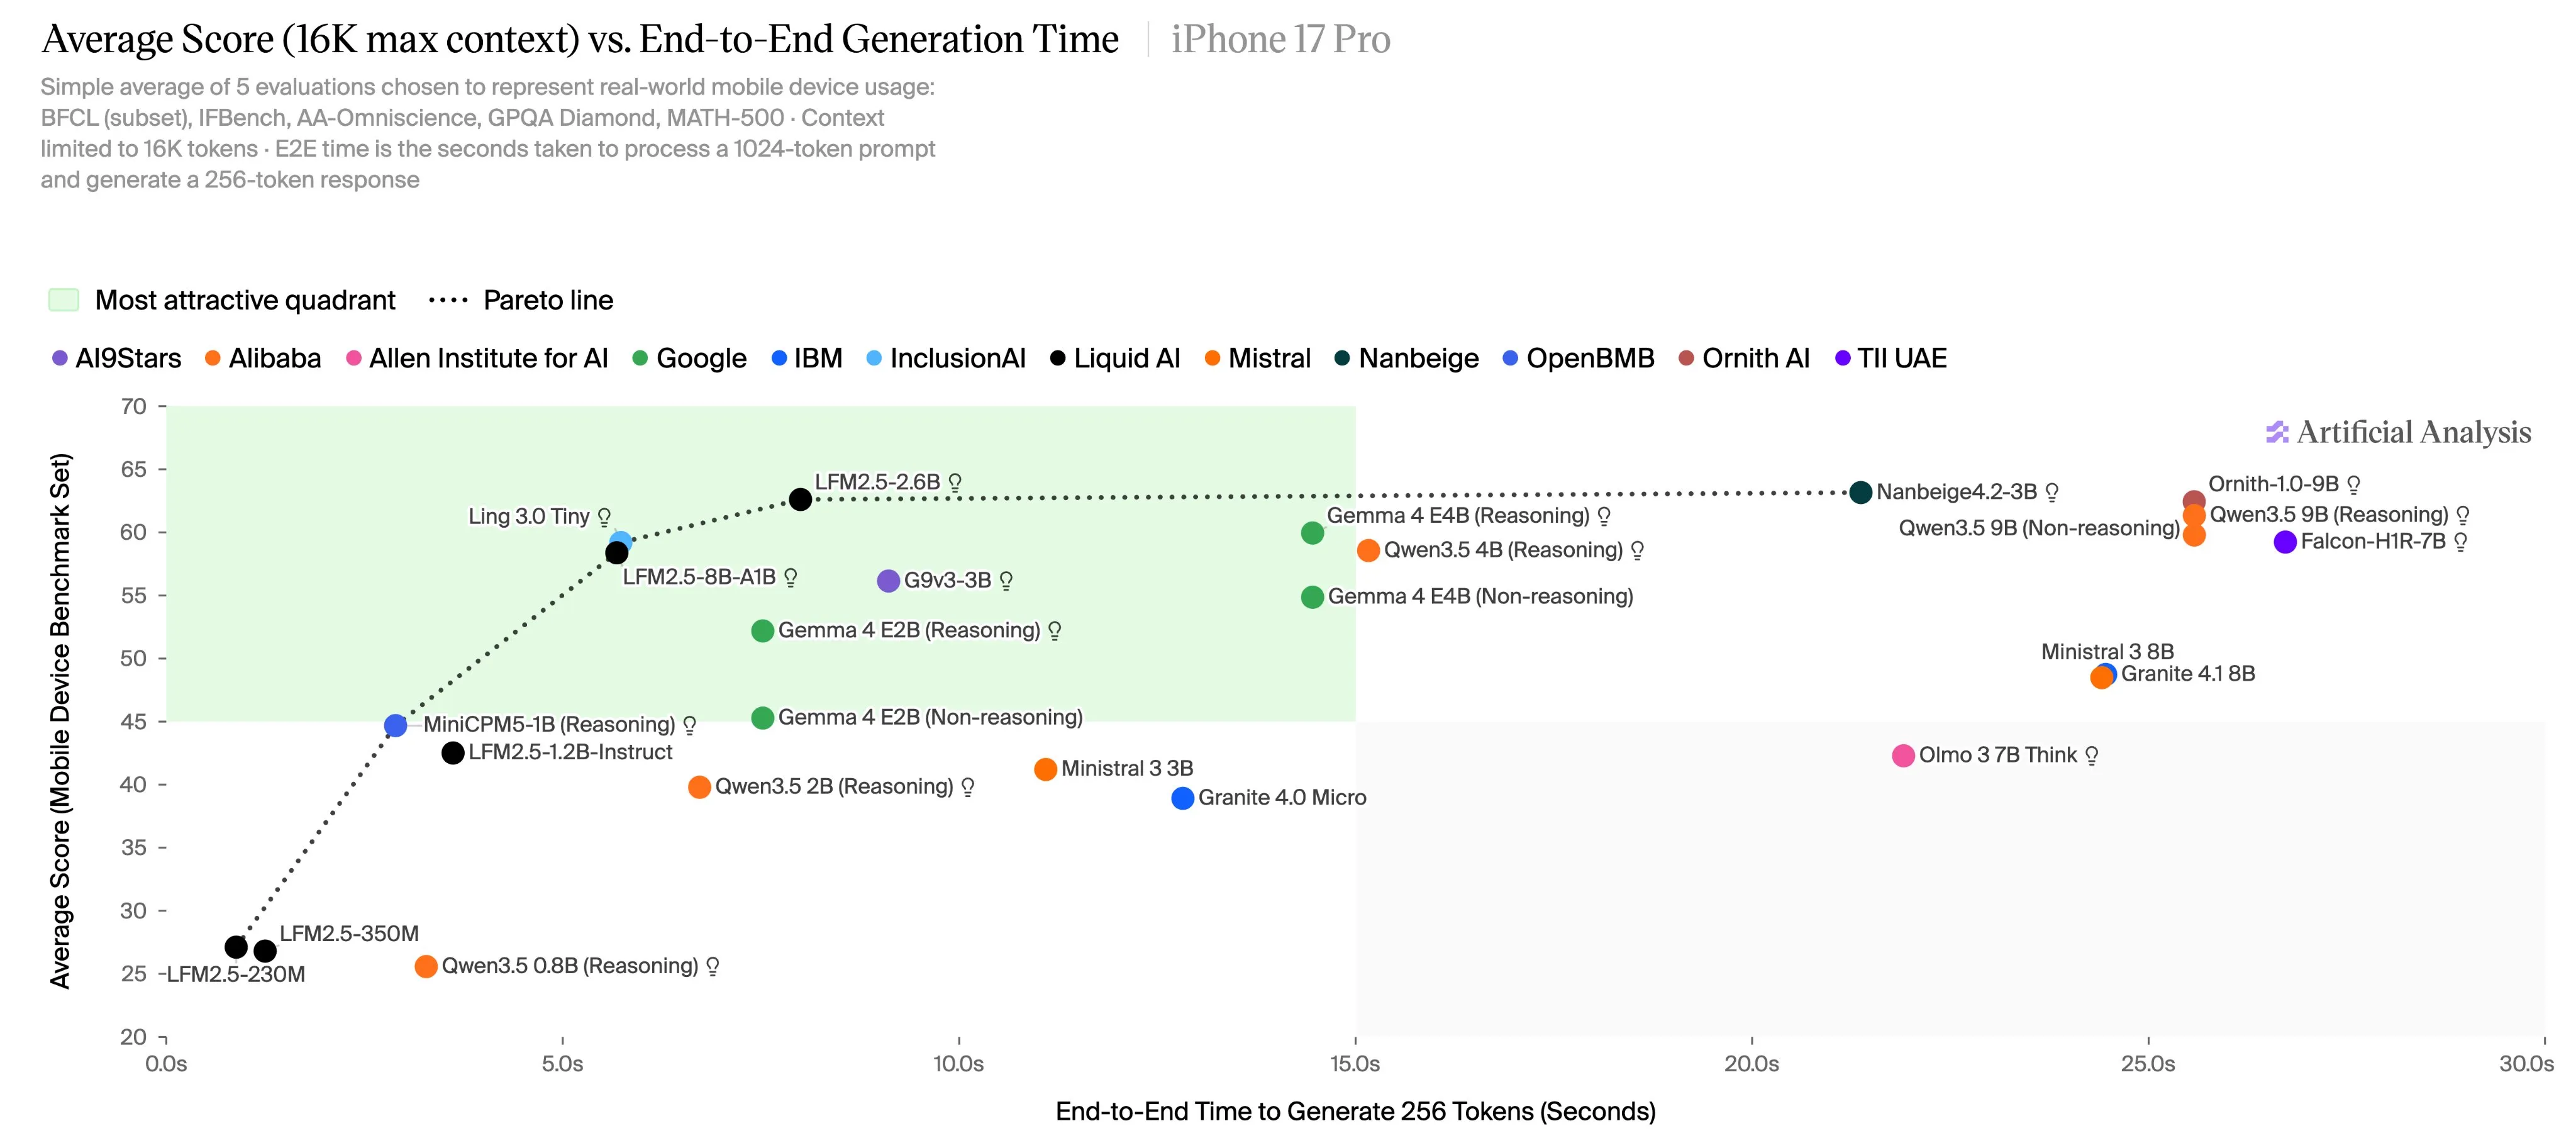
El benchmark agrega puntuaciones de pruebas básicas de tool calling, alucinación y razonamiento para obtener una puntuación final, y también mide el uso de tokens y la velocidad de extremo a extremo en teléfonos modernos.
Para responder a la pregunta de cuál es el mejor modelo para teléfono ahora mismo, LFM2.5 2.6B parece ser la respuesta. Está cerca de los primeros puestos en todos los benchmarks y logra el equilibrio correcto entre velocidad, baja tasa de alucinación e inteligencia.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo abajo.