
注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新闻
OpenAI 与 Cursor 分道扬镳
OpenAI 本周宣布将结束与 Cursor 的合作,这将导致 Cursor 用户无法再使用 OpenAI 模型。 双方的合作预计将于今年 11 月 12 日终止。
给不了解情况的读者补充一个重要背景:Cursor 已被 SpaceX 收购,交易于两周前正式完成。
据 OpenAI 表示,这是因为他们不信任 Elon Musk 旗下的公司:
我们作出这一决定,是因为根据我们以往与 Elon Musk 旗下公司打交道时遭遇违约的经历,我们无法确信 SpaceX 会遵守我们的服务条款来使用我们的技术。
我认为,这背后的原因有两个;首先是 Sam Altman 和 Elon Musk 之间的相互敌视。 两人最近打了一场备受关注的官司(并没有产生什么实质性结果),起因是 OpenAI 从非营利组织转型为营利性公司,而 Elon 对此表示反对。Elon 是 OpenAI 的创始人之一,但已于 2018 年离开。
第二个,也是更重要的原因,是 OpenAI 似乎在暗示,SpaceXAI 正通过 Cursor 和其他智能体运行框架蒸馏其模型,以训练 Grok。 这种蒸馏方式有用,但仅靠它还不足以训练出前沿模型。 过去,一直是 Anthropic 比较在意这件事(主要针对中国 AI 实验室),但现在 OpenAI 似乎也开始在意了,只不过这次针对的是美国本土的竞争对手。
有意思的是,Anthropic 进一步重申了对 Cursor 的支持,表示将继续增加算力,支持 Cursor 中的 Claude。 这种友好态度很可能不是因为 Anthropic 有多喜欢 Cursor,而是因为他们与 SpaceX 签有一份价值 450 亿美元的算力合同。
Cursor 表示,他们目前正在与 OpenAI 团队沟通,试图解决此事,并强调 OpenAI 仅占 Cursor 流量的 5%。
如果你是 Cursor 用户,而且在使用 OpenAI 模型,目前还不必急着换平台,但我建议你做好在未来几个月内迁移的心理准备(反正 OpenAI 订阅方案的性价比要高得多,单凭这一点,我就建议换过去)。
新品发布
GLM 5.3 Flash
过去几周,一个名为 Ox Alpha 的匿名模型引发了不少热议,如今已经揭晓,当时接受测试的其实就是 GLM 5.3 Flash。
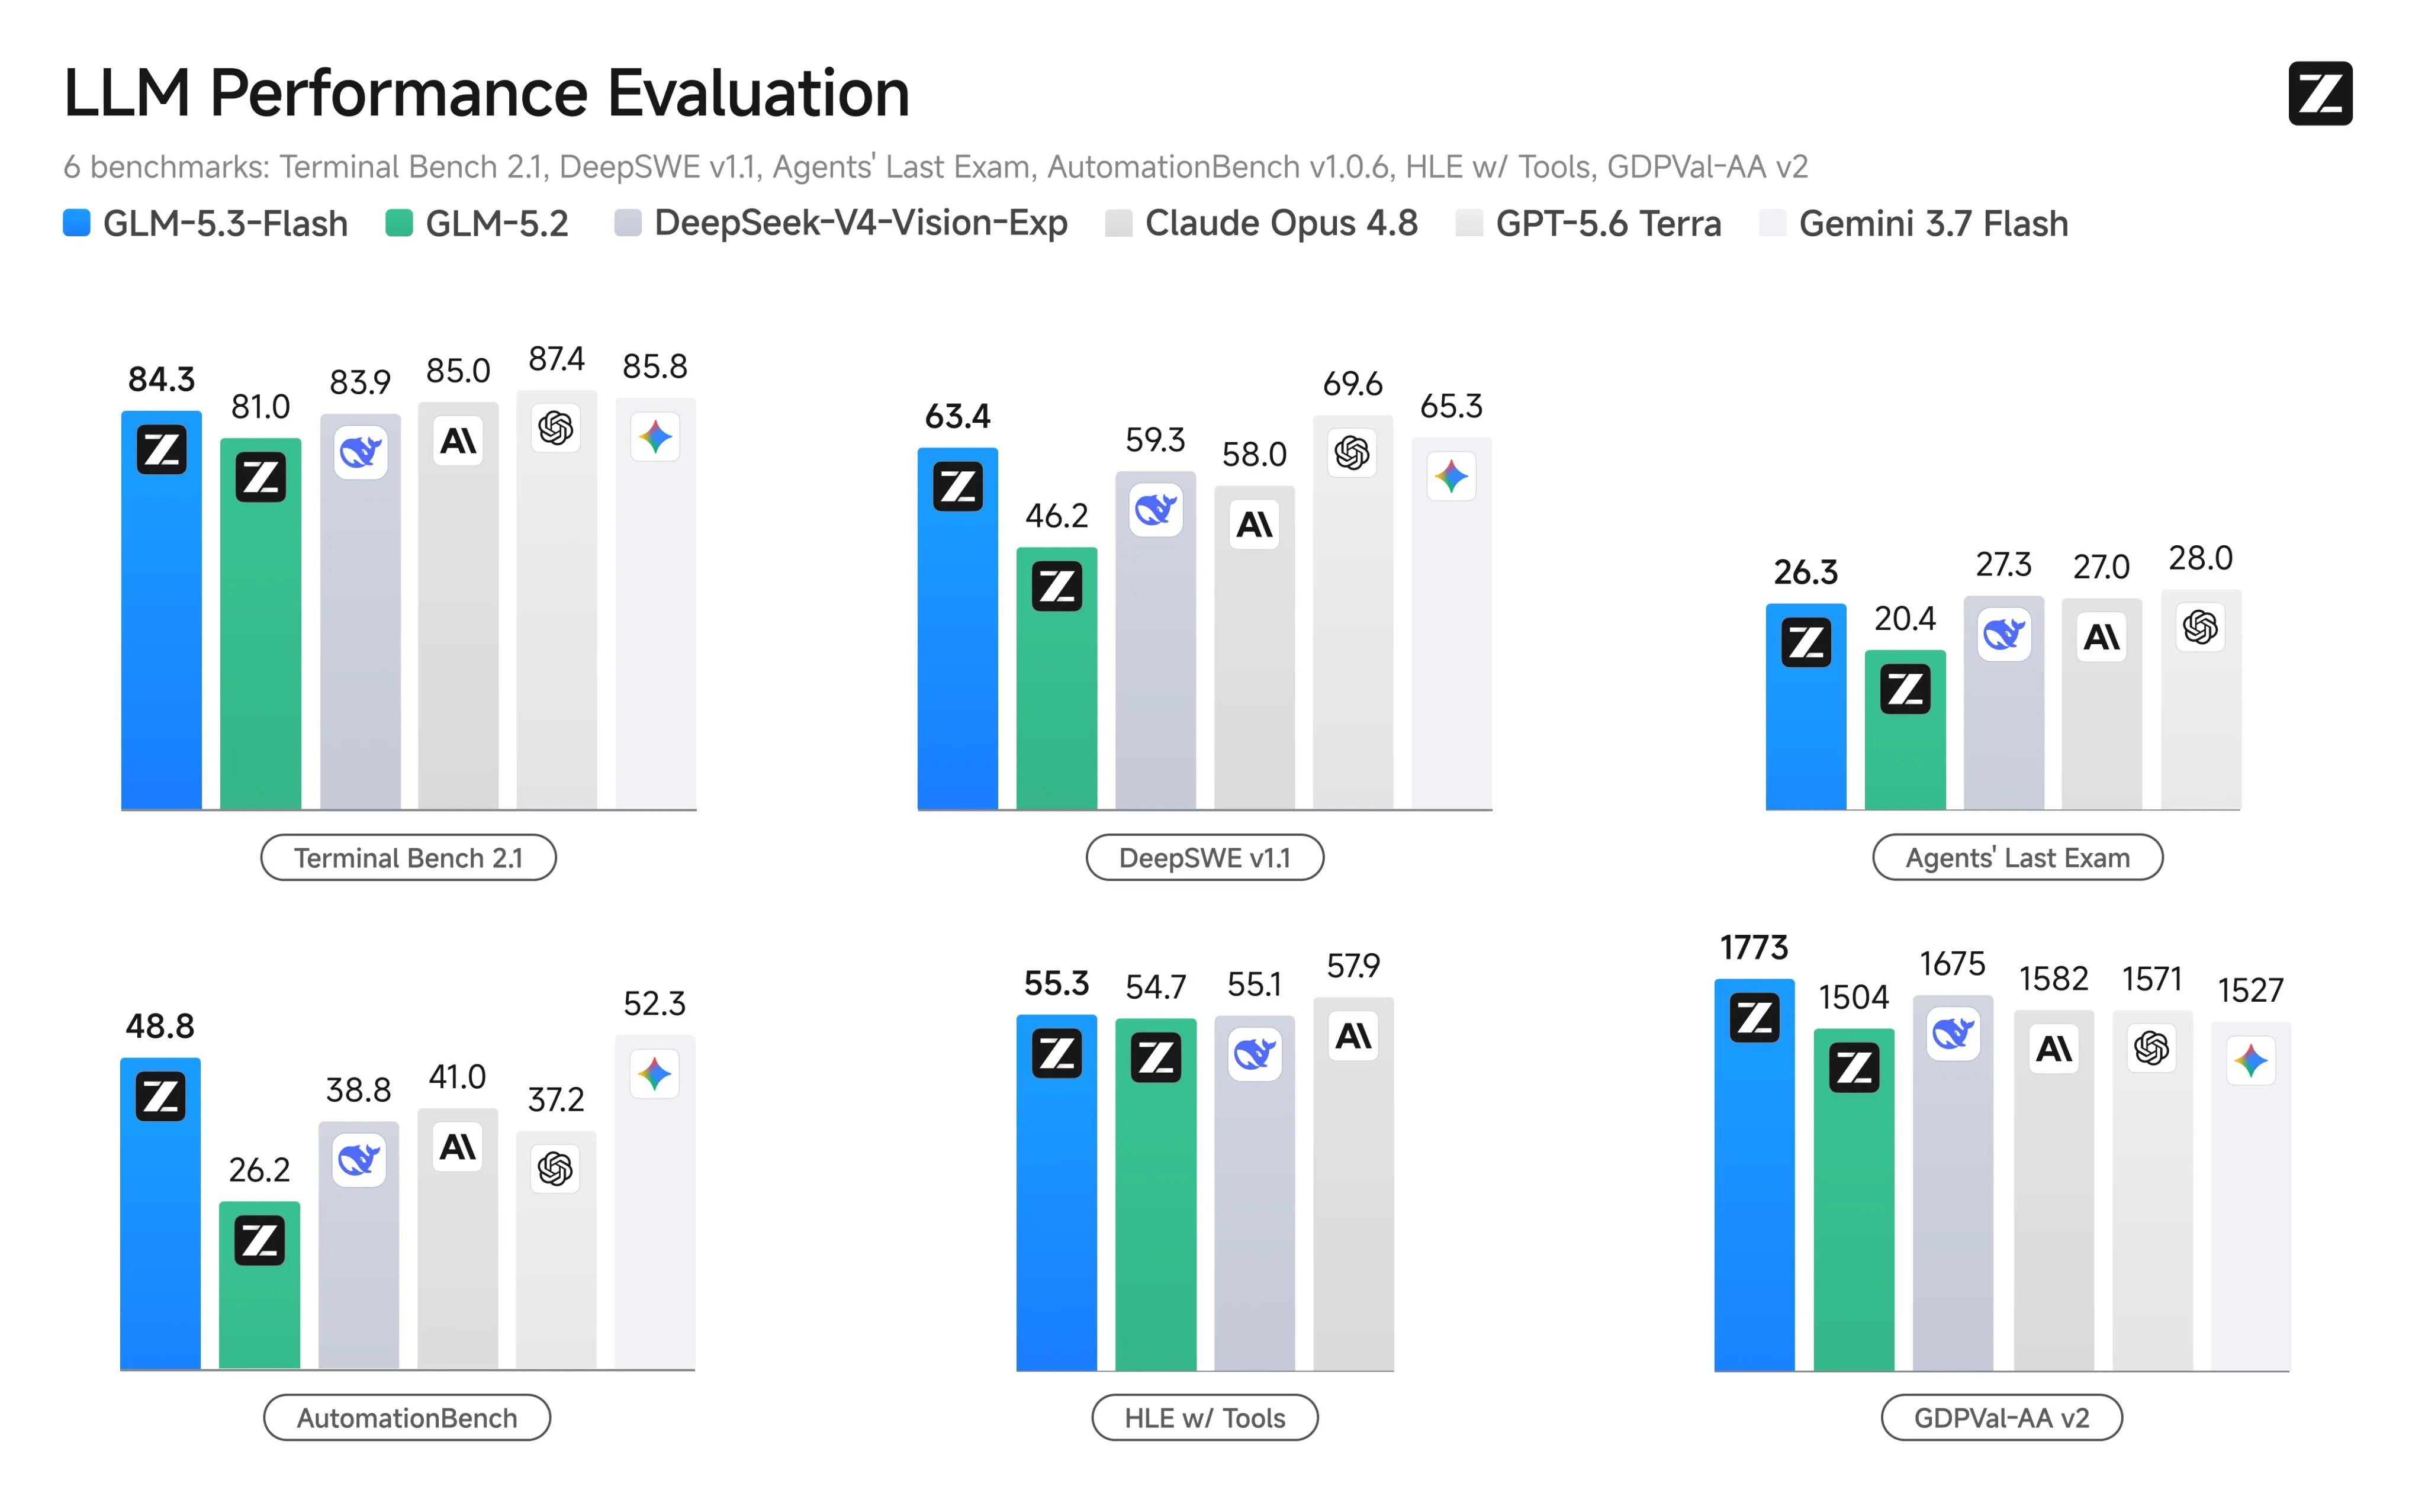
尽管它是一个规模“较小”的 Flash 模型,参数规模(320B-A18B)只有其大哥的三分之一,但能力相当强。 它在实际使用中的表现经得起检验,似乎比 DeepSeek V4 Flash 和 GPT 5.6 Luna 还要高出一档,而后两者已经是目前最顶尖的“小”模型了。
通常,这类小模型会消耗大量 token,部分抵消了低定价带来的优势,但 Z.ai 在控制 GLM 5.3 Flash 的推理长度方面做得不错。它的 token 使用效率仍然不及 Luna,但更高的智能水平弥补了这一点。
| 模型 | 每百万输入 token 价格(美元) | 每百万输出 token 价格(美元) | 每秒 token 数 |
|---|---|---|---|
| GLM 5.3 Flash | $0.15 | $0.50 | 28 |
| DeepSeek V4 Flash | $0.44 | $1.32 | 82 |
| GPT 5.6 Luna | $1 | $6 | 84 |
| Grok 4.6 | $2 | $6 | 57 |
| GLM 5.2 | $1.40 | $4.40 | 47 |
这个模型也具备视觉能力,但表现完全谈不上出色,与它的文本能力不在同一水平。
值得一提的是,Z.ai 完全使用中国 GPU 来提供这个模型的推理服务,这是中国顶级实验室首次公开这样做。 看来 Nvidia 开始面临来自中国的强劲竞争,希望这能推动未来 GPU 价格下降。
这个模型已经开源(更大的 GLM 5.3 模型也一并开源了),但规模还是有些大,难以在数据中心以外的硬件上运行。
这又是一个能力强、聪明且性价比很高的模型,我推荐大家试试。体验它的最佳途径是 OpenCode Go 或 Z.ai 编程订阅方案。
快讯
Qwen 3.8 Flash
Qwen 3.8 Flash 让我们得以提前一窥 Qwen 4 未来的模型架构。
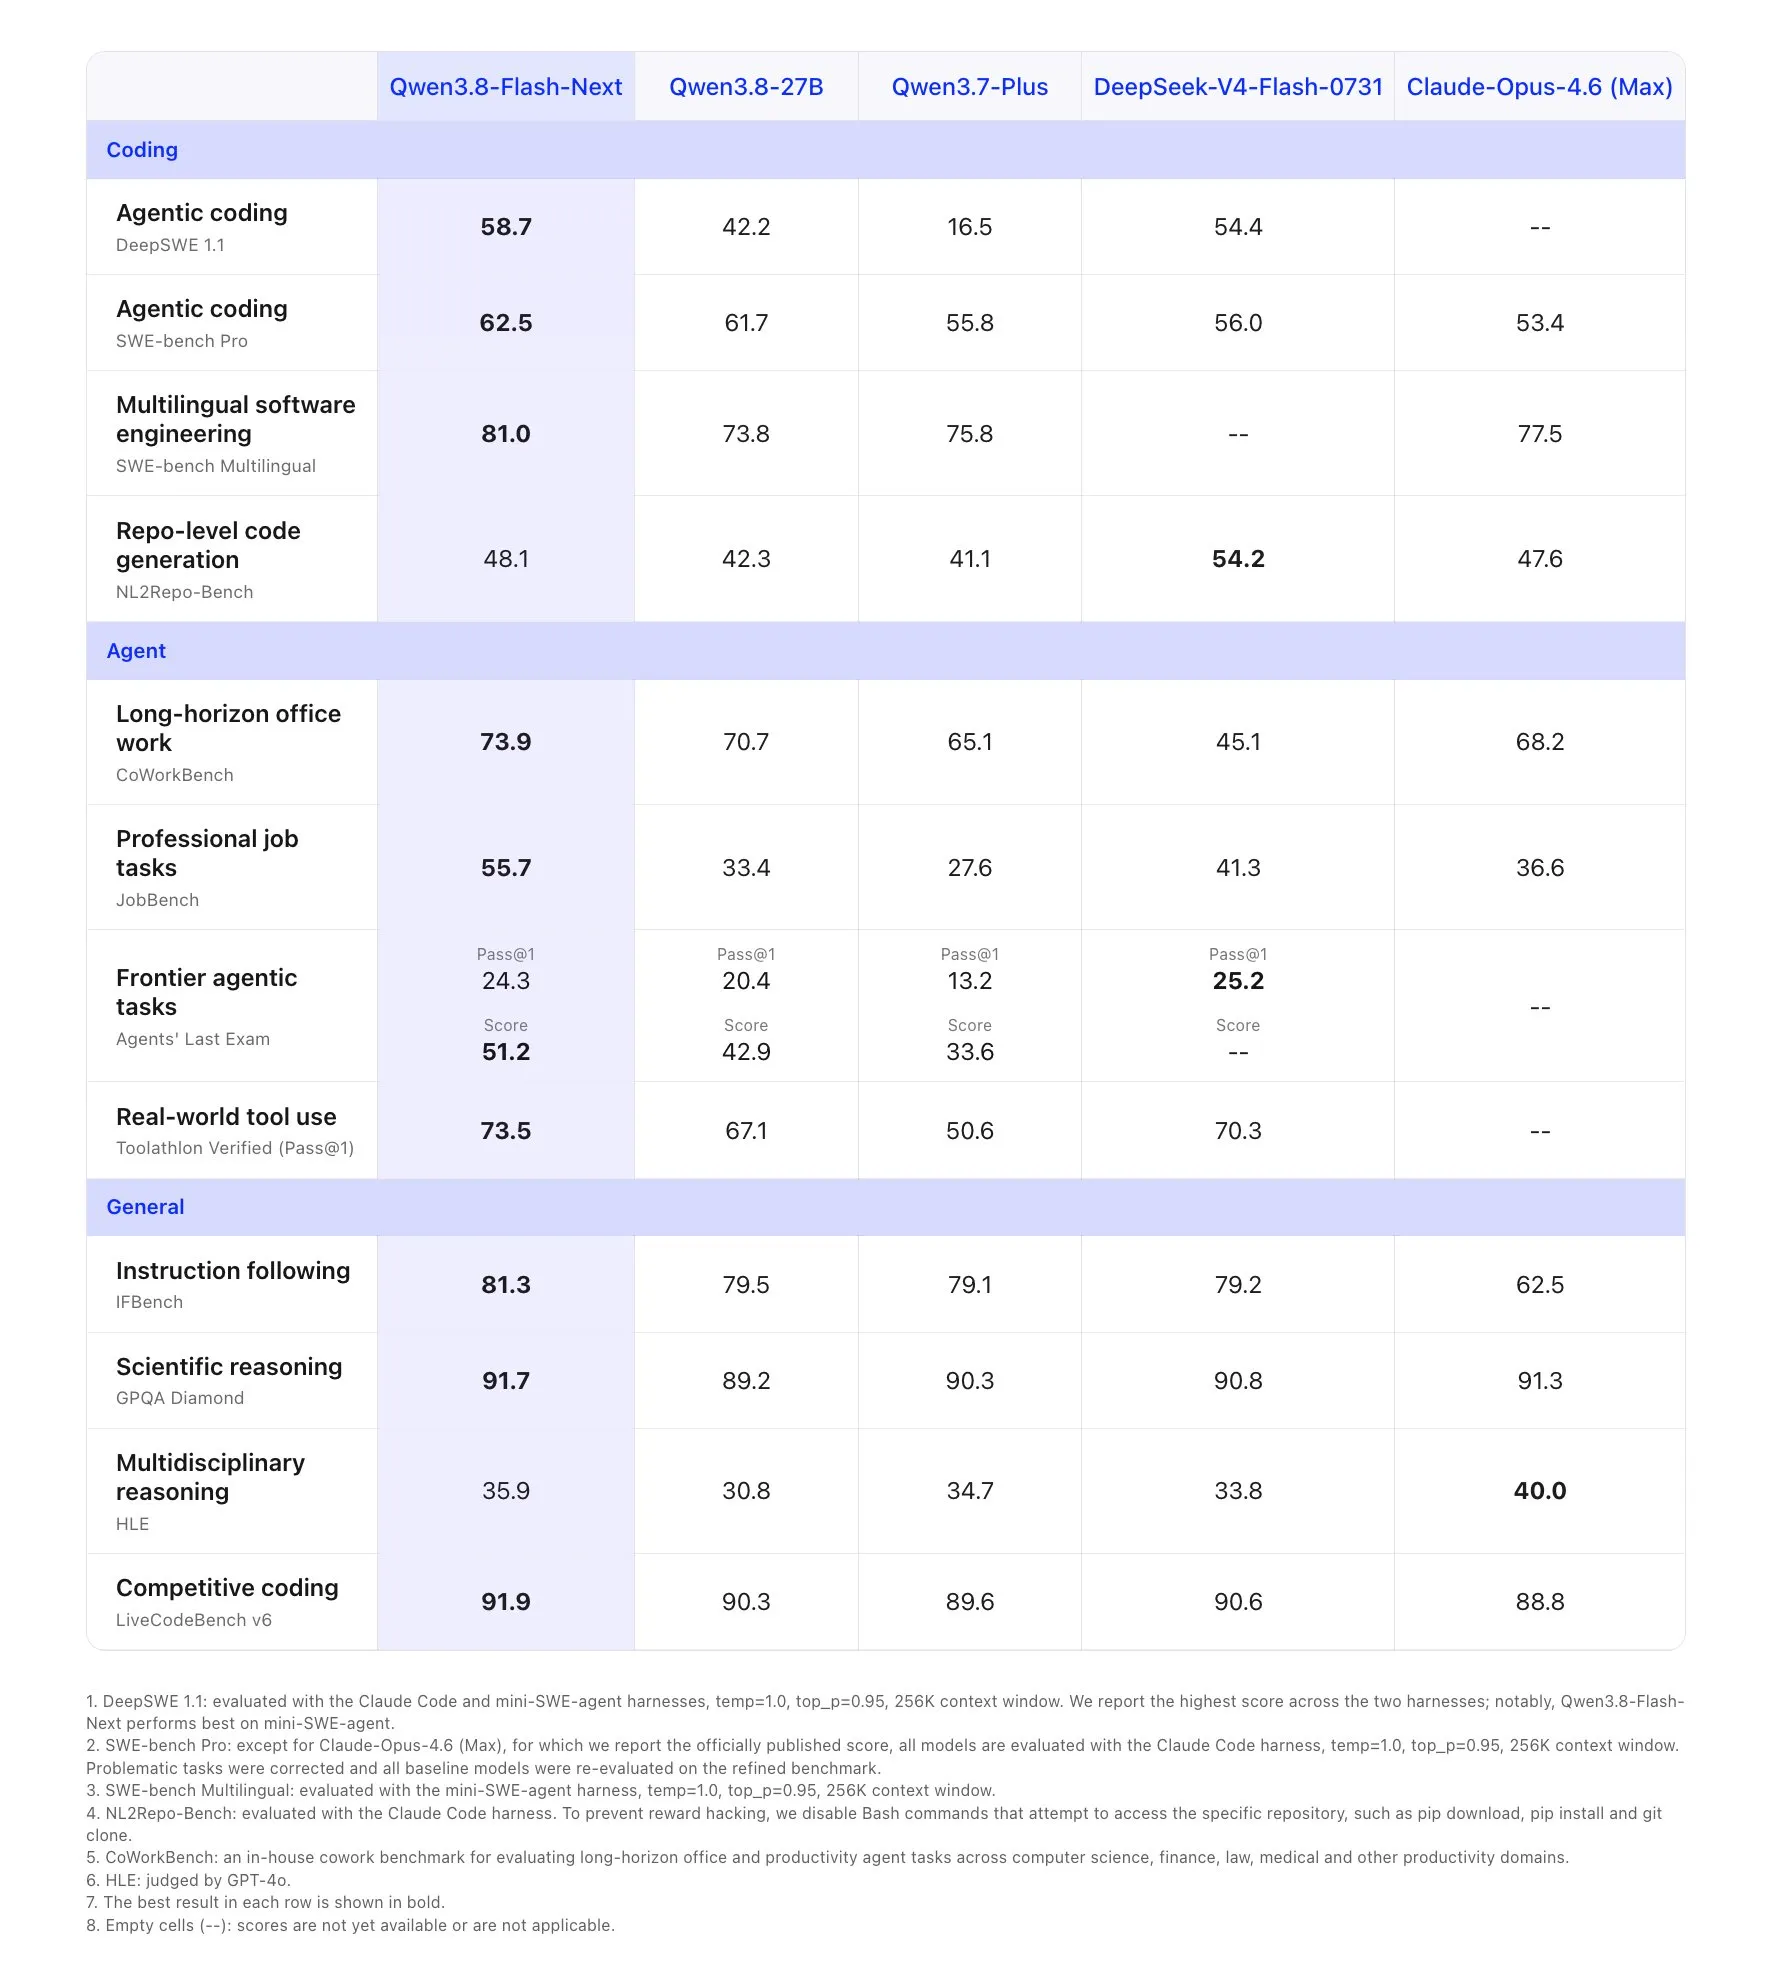
他们采用了类似 Engram 的架构。 这意味着,模型不再让一个庞大的 Transformer 同时承担存储知识事实和学习正确推理的任务,而是将两者拆分成独立的模块。 第一个是我们熟悉且喜爱的常规 Transformer,第二个则是充当事实查找表的 Engram“记忆”模块(有点像给大语言模型的大脑配了一个数据库)。
Engram 模块所需的计算量很小,只需要有足够的内存来加载,因此模型实际上可以分成两部分:Transformer 模块加载到 GPU 上,Engram 模块则放在系统内存(CPU 内存)中。 这样一来,你就能在本地运行更大的模型,因为不再需要配备大容量显存的 GPU。
这次发布的主要目的是给社区留出时间,在不同的大语言模型推理引擎中实现并优化对该模型的支持。不过,它可能也是目前在 DGX Spark 上能运行的最佳模型,只是如果你打算尝试,得做好遇到一些 bug 的准备。
H3 Max
MiniMax H3 已跻身最优秀的视频生成模型之列,而且还是开源的。
作为最大的图像和视频推理服务提供商之一,Fal.ai 对这个模型进行了微调,进一步提升了质量和速度,由此推出了 H3 Max。
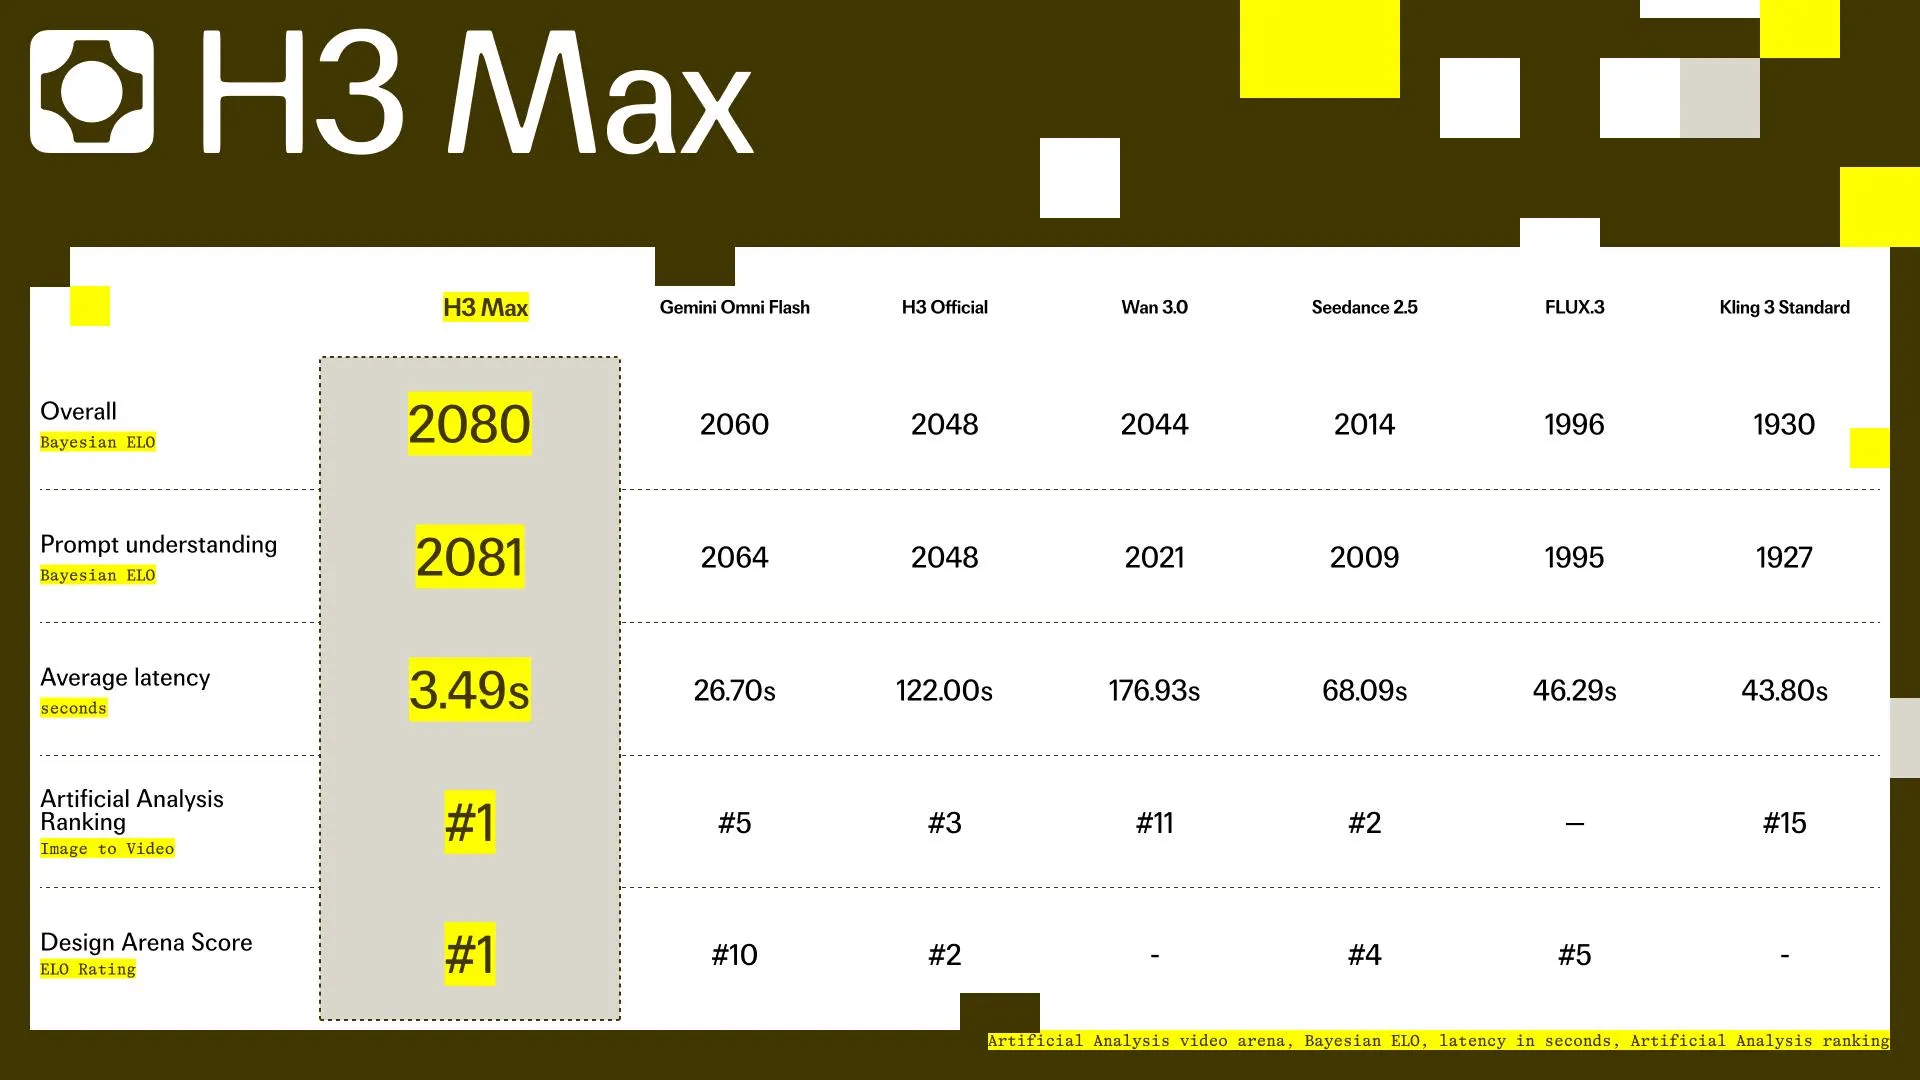
最终得到的是我们迄今见过的最佳视频生成模型,而且它的生成速度超过实时播放速度:生成一段 5 秒的 768p 视频只需 3 秒。这意味着,你可以用它生成连续的视频流,而且成本非常低(每段 5 秒视频仅需 0.20 美元)。
现在就可以在 Fal 网站上免费试用。
端侧 AI 基准测试
以前经常有人问我,在手机上运行哪个模型最好。现在,Artificial Analysis 推出了一个专门回答这个问题的排行榜。
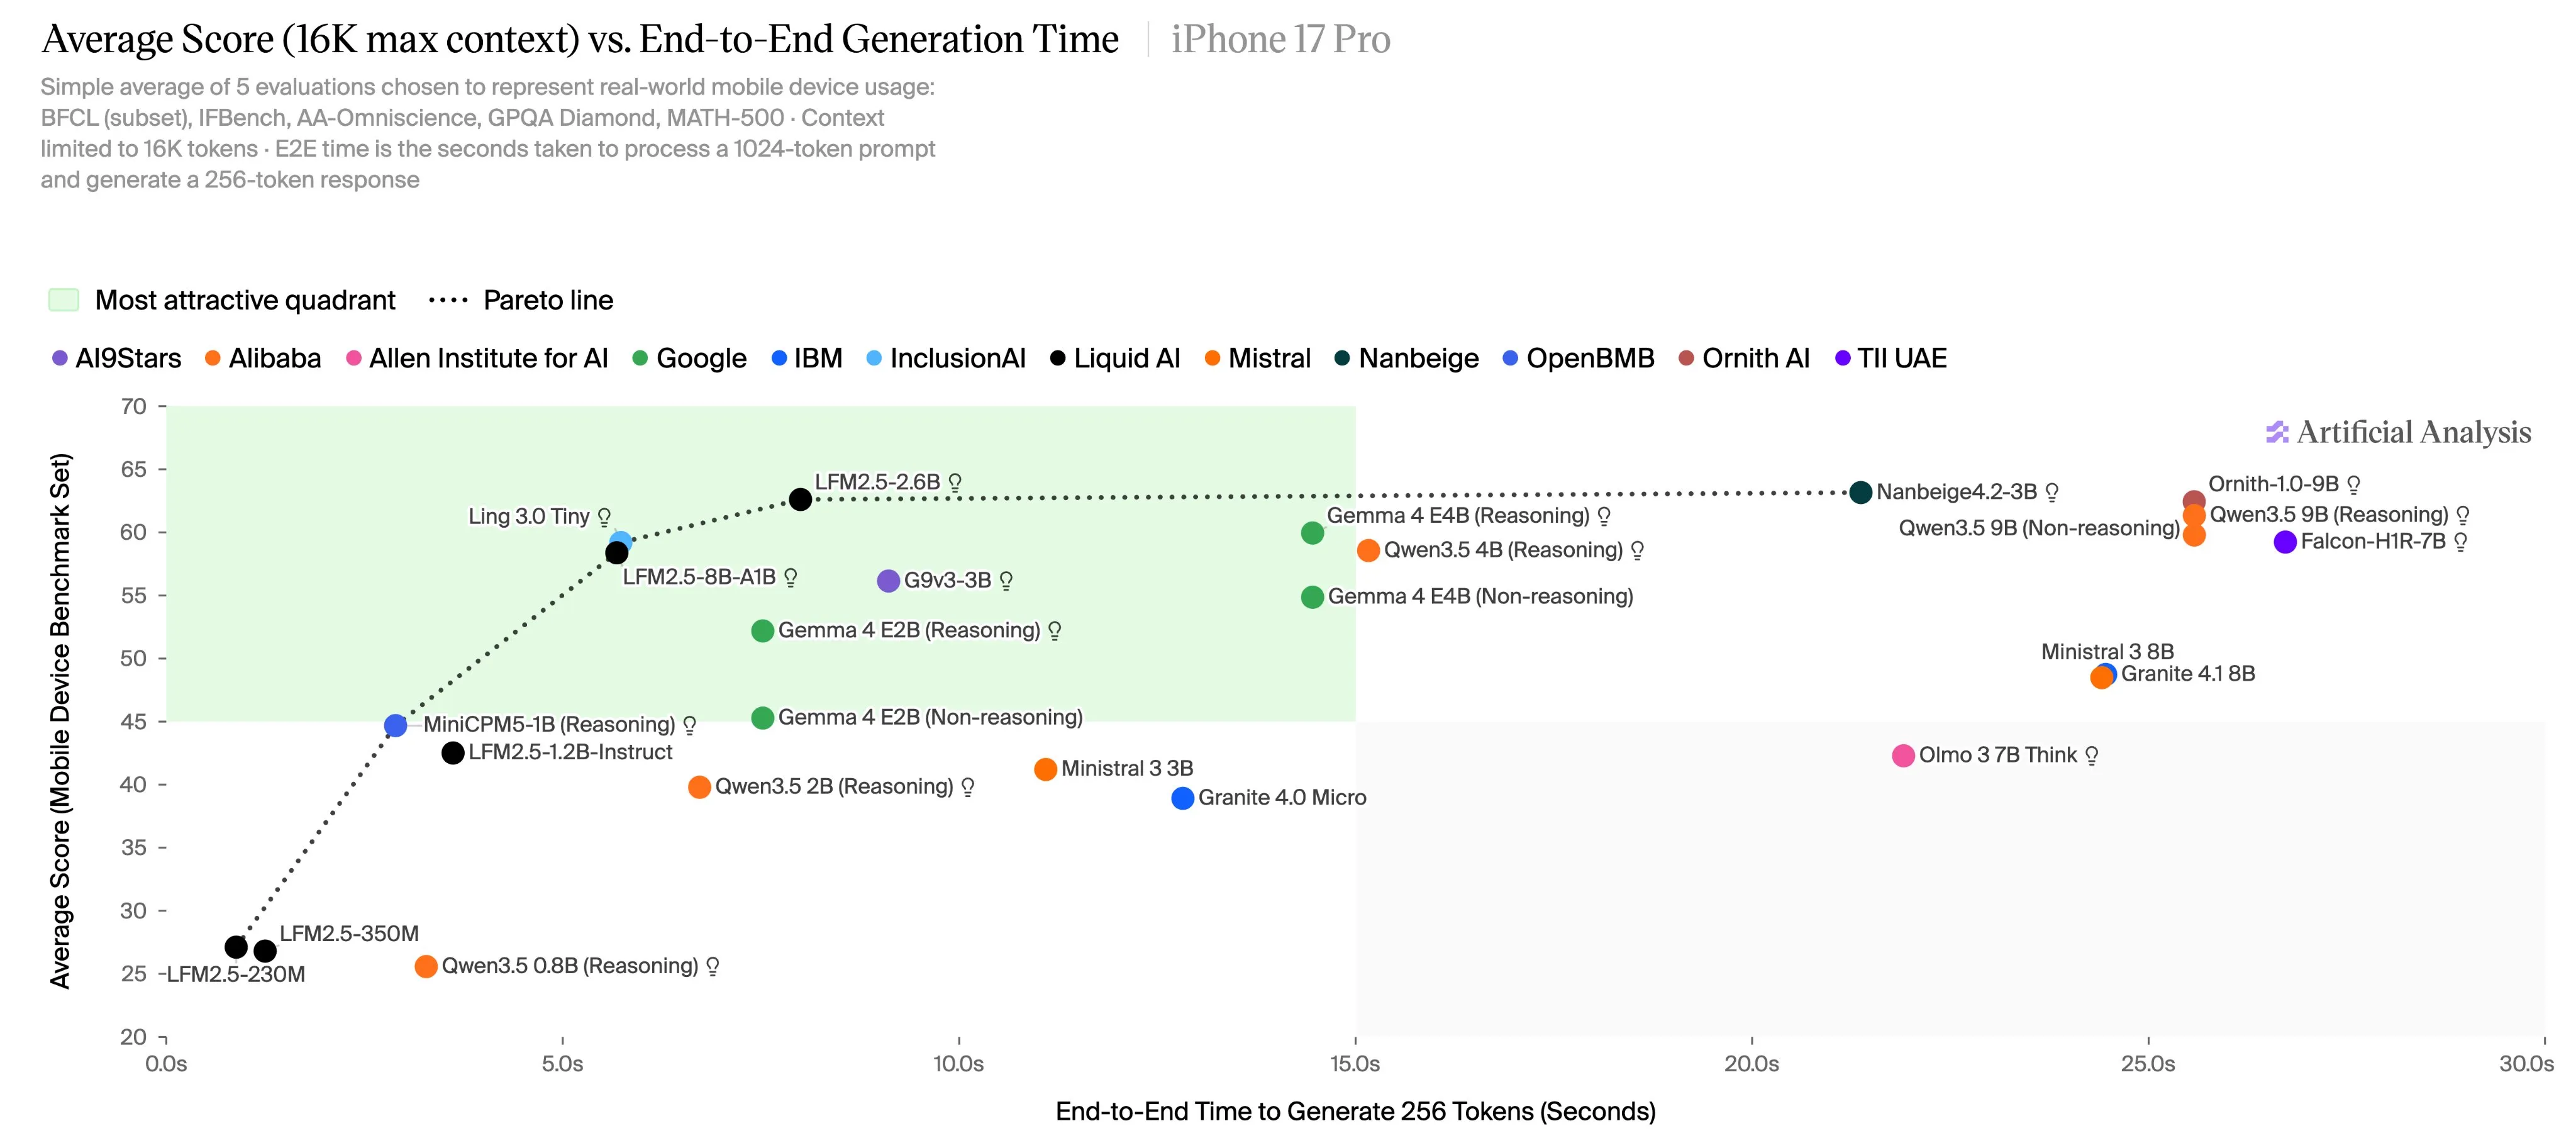
这项基准测试汇总了基础工具调用、幻觉和推理基准测试的成绩,得出最终评分,同时还会测量模型在现代手机上的 token 用量和端到端速度。
要回答目前最适合在手机上运行的模型是什么,LFM2.5 2.6B 似乎就是答案。 它在所有基准测试中都接近榜首,在速度、低幻觉率和智能水平之间取得了恰当的平衡。
结语
希望你喜欢本周的新闻。如果你想每周收到新闻更新,记得在下方订阅我们的邮件列表。