
Nota: Este artigo foi traduzido automaticamente com OpenAI GPT-5.5 por meio do Codex CLI; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Notícias
OpenAI se divorcia do Cursor
A OpenAI anunciou esta semana que encerrará sua parceria com o Cursor, o que fará com que usuários do Cursor percam acesso aos modelos da OpenAI. A expectativa é que a parceria termine em 12 de novembro deste ano.
Contexto importante para quem não sabe: o Cursor foi comprado pela SpaceX, com o acordo finalizado há 2 semanas.
Segundo a OpenAI, isso ocorre por falta de confiança nas empresas de Elon Musk:
Estamos fazendo esta escolha porque não podemos ter confiança de que a SpaceX usará nossa tecnologia dentro dos nossos termos de serviço, com base na nossa experiência com empresas de Elon Musk violando contratos.
Acredito que as razões subjacentes aqui sejam duas; a primeira é o ódio entre Sam Altman e Elon Musk. Eles tiveram recentemente uma batalha judicial muito pública (nada realmente saiu dela), decorrente da reestruturação da OpenAI de uma organização sem fins lucrativos para uma empresa com fins lucrativos, algo de que Elon (que é um dos fundadores da OpenAI, mas saiu em 2018) discordou.
A segunda razão, mais importante, é que a OpenAI parece estar insinuando que a SpaceXAI está destilando seus modelos por meio do Cursor e de outros ambientes para treinar o Grok. Esse tipo de destilação é útil, mas não suficiente, para treinar um modelo de fronteira. Historicamente, a Anthropic era quem se importava com isso (principalmente em relação a laboratórios chineses de IA), mas agora a OpenAI também parece se importar, só que por causa da concorrência doméstica.
Curiosamente, a Anthropic reforçou seu compromisso com o Cursor, dizendo que continuará aumentando a computação para dar suporte ao Claude no Cursor. Essa cordialidade provavelmente não se deve ao amor da Anthropic pelo Cursor, mas sim ao fato de ela ter um contrato de computação de 45 bilhões de dólares com a SpaceX.
O Cursor disse que está conversando agora com a equipe da OpenAI para tentar resolver isso, destacando que a OpenAI atende apenas 5% do tráfego do Cursor.
Se você é usuário do Cursor e usa modelos da OpenAI, ainda não precisa abandonar o barco, mas eu ficaria mentalmente preparado para fazer isso nos próximos meses (de qualquer forma, você obtém muito mais valor com um plano de assinatura da OpenAI do que com um plano do Cursor, então eu recomendaria a troca só por esse motivo).
Lançamentos
GLM 5.3 Flash
Houve bastante hype em torno de um modelo anônimo chamado Ox Alpha nas últimas semanas, e foi revelado que ele era o GLM 5.3 Flash em teste.
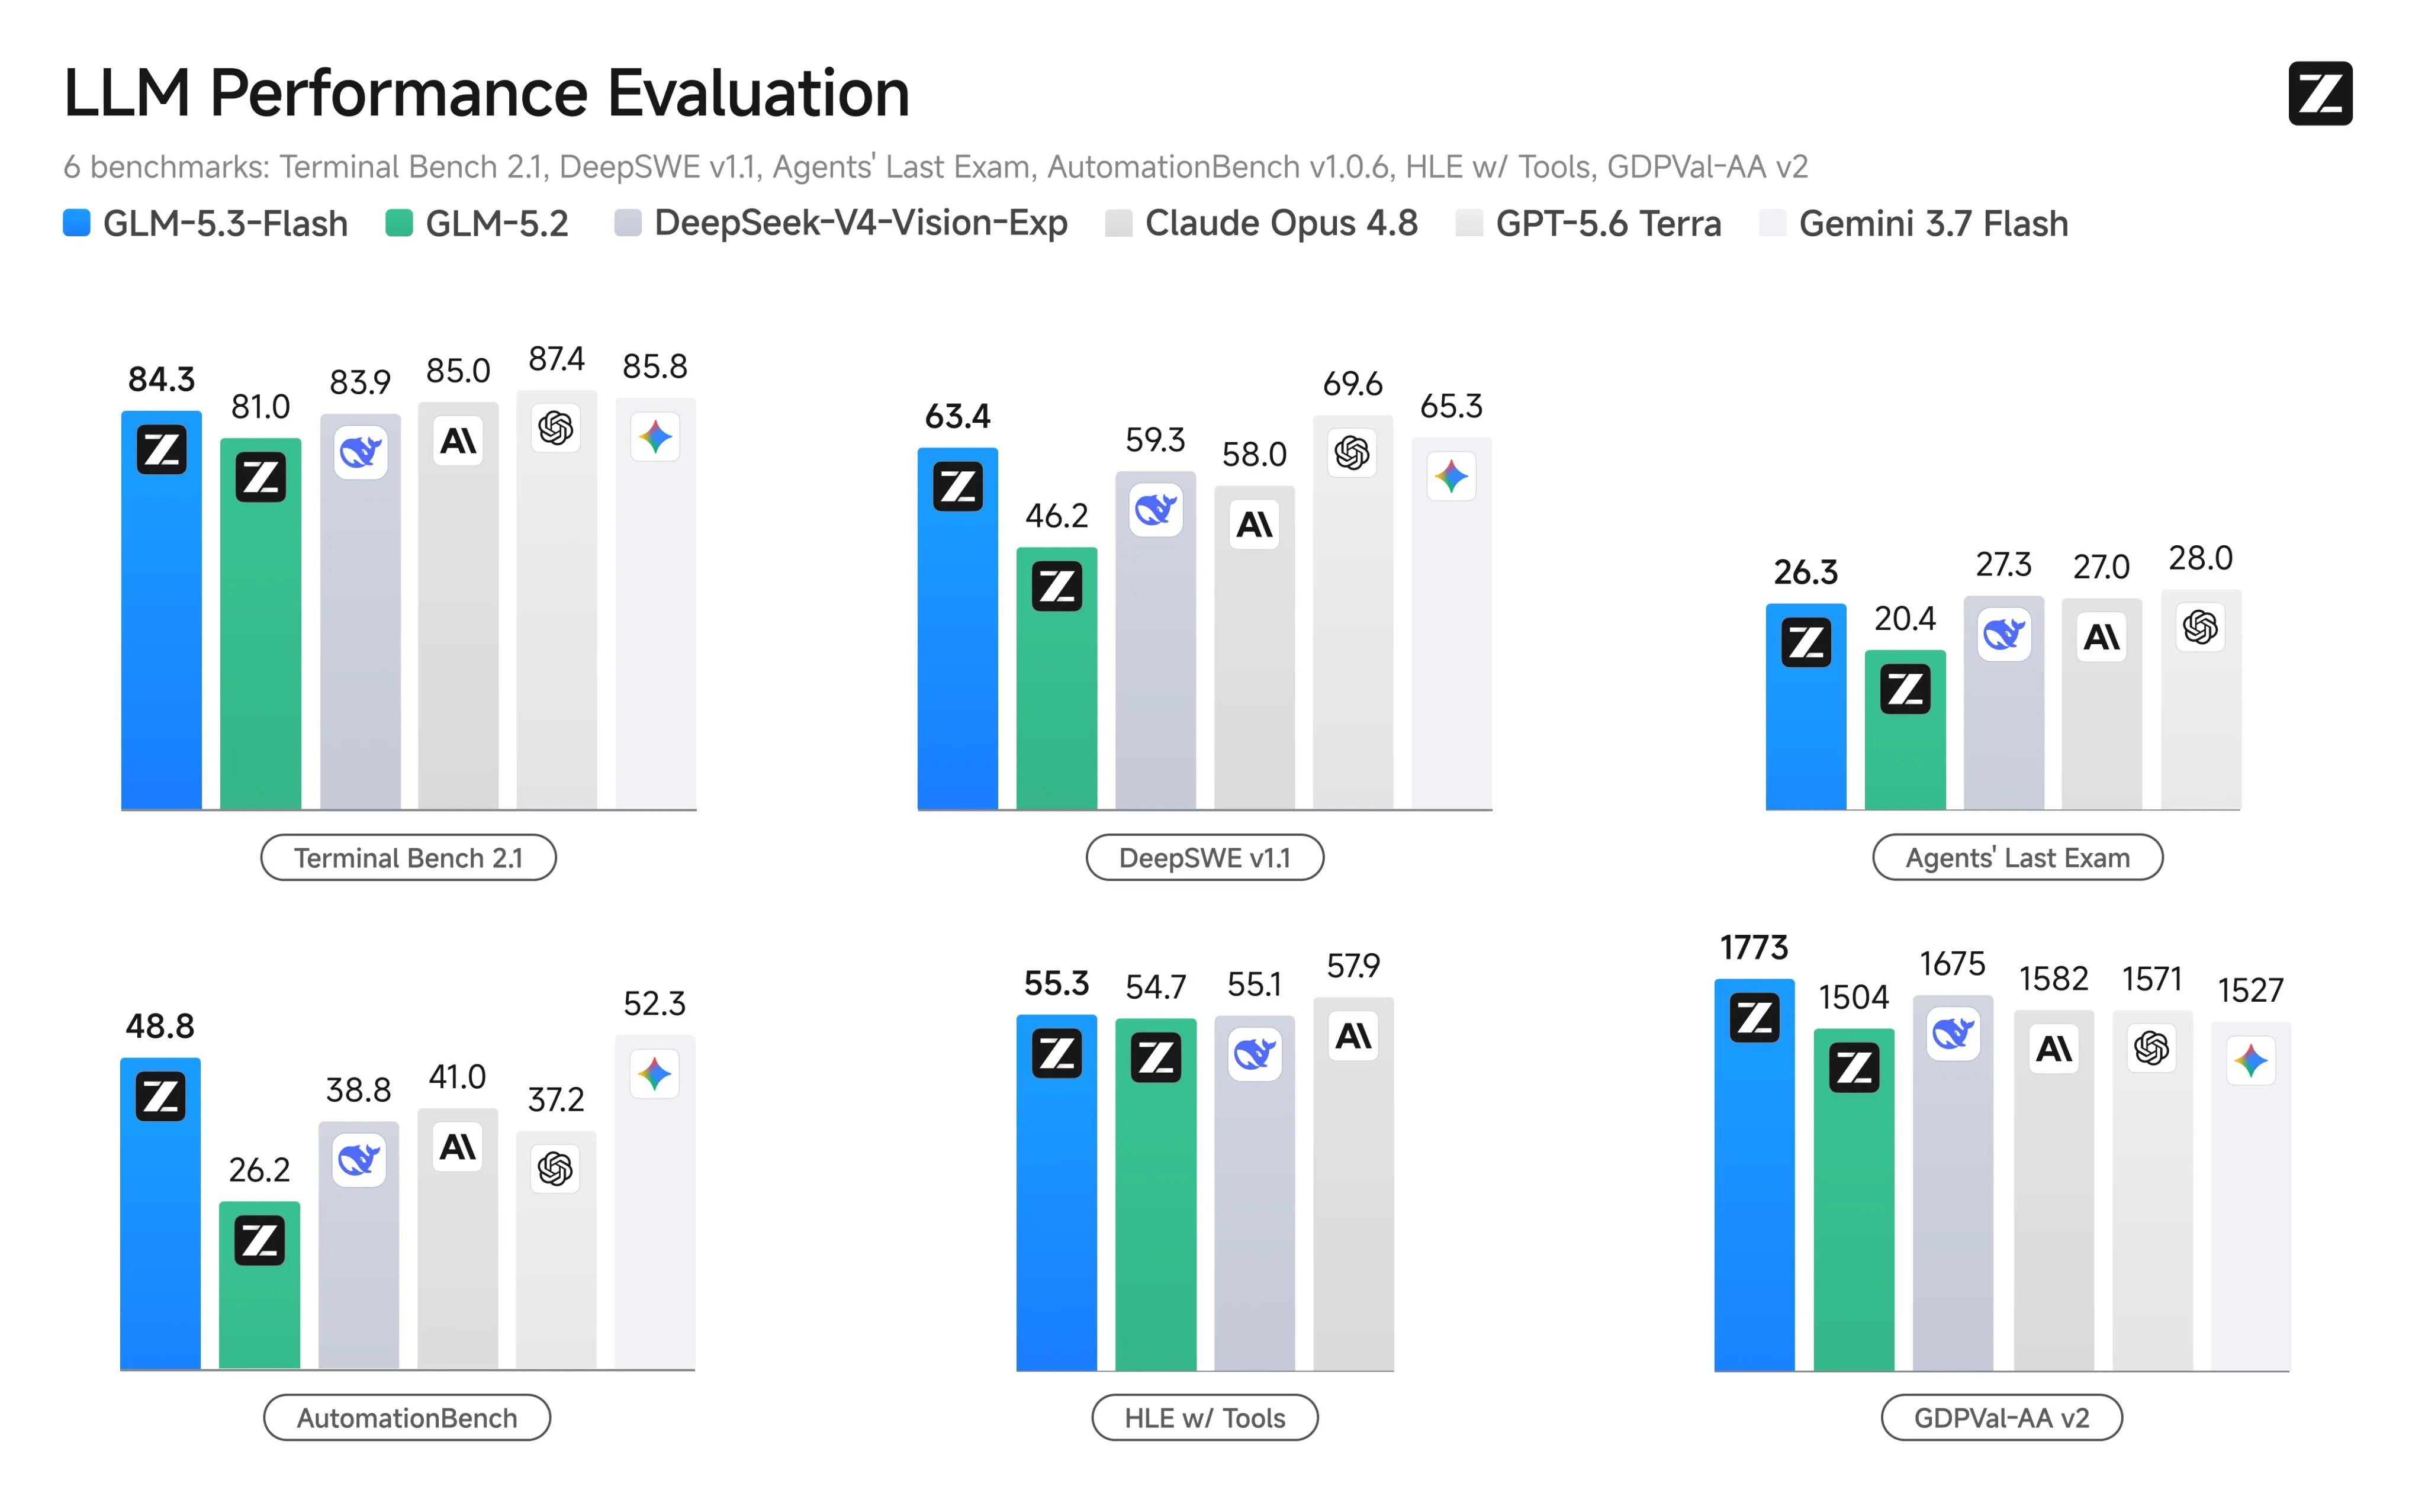
Apesar de ser um modelo flash “menor”, 3x menor (320B-A18B) do que seu irmão maior, ele é um modelo muito capaz. Ele passa no teste prático do mundo real e parece estar um degrau acima do DeepSeek V4 Flash e do GPT 5.6 Luna, que são os principais modelos “pequenos” que temos agora.
Normalmente, com esses modelos menores, eles usam um grande número de tokens, o que compensa parcialmente seu preço menor, mas a Z.ai fez um bom trabalho ao restringir o comprimento do raciocínio do GLM 5.3 Flash. Ele ainda não está no mesmo nível de uso eficiente de tokens do Luna, mas compensa isso com maior inteligência.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| GLM 5.3 Flash | $0.15 | $0.50 | 28 |
| DeepSeek V4 Flash | $0.44 | $1.32 | 82 |
| GPT 5.6 Luna | $1 | $6 | 84 |
| Grok 4.6 | $2 | $6 | 57 |
| GLM 5.2 | $1.40 | $4.40 | 47 |
O modelo também tem capacidades de visão, mas elas não são impressionantes de forma alguma, e não estão no mesmo nível de suas capacidades de texto.
Um ponto interessante é que o modelo está sendo servido pela Z.ai usando somente GPUs chinesas, o que é a primeira vez que um laboratório chinês de ponta fez isso (publicamente). Parece que a Nvidia começa a ter uma concorrência importante vinda da China, o que, espera-se, deve ser bom para os preços de GPUs no futuro.
O modelo é open source (junto com o grande modelo GLM 5.3 também), mas é um pouco grande demais para rodar em hardware que não seja de datacenter.
Este é mais um modelo muito forte, inteligente e custo-eficiente que eu recomendaria testar. As melhores formas de acessá-lo são pelo OpenCode Go ou pelo plano de coding da Z.ai.
Notas rápidas
Qwen 3.8 Flash
Qwen 3.8 Flash é uma prévia do futuro da arquitetura do modelo Qwen 4.
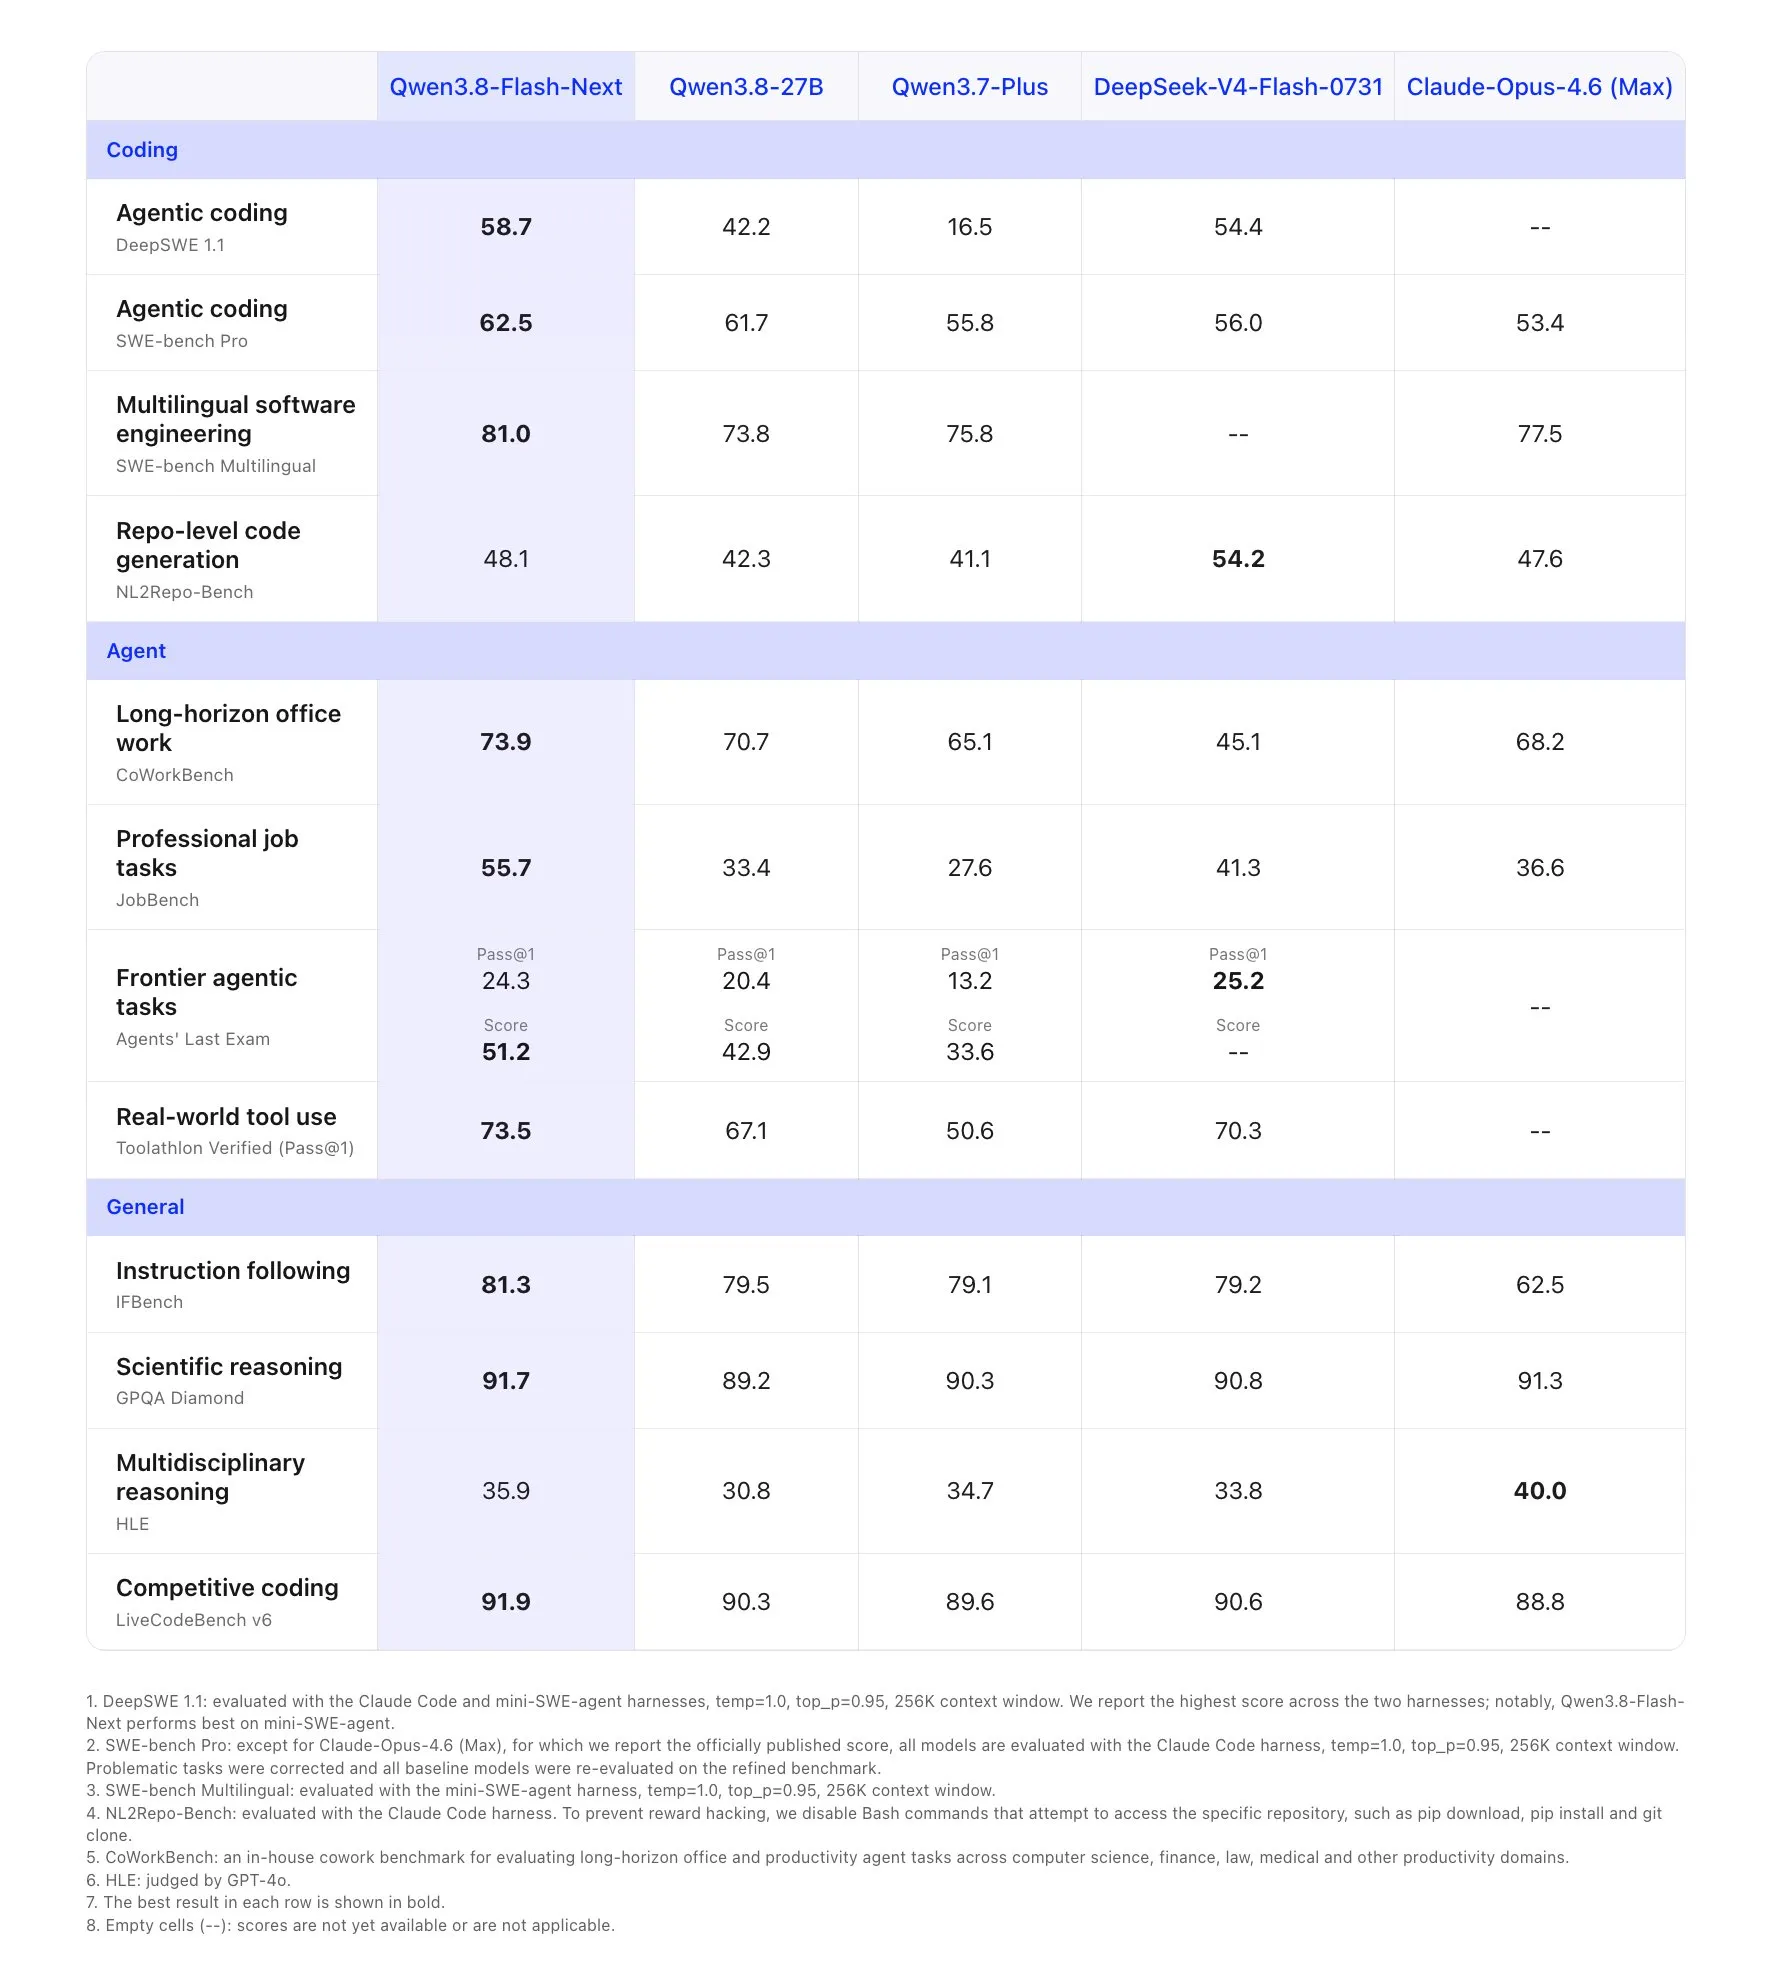
Eles estão usando uma arquitetura no estilo Engram. Isso significa que, em vez de ter um grande modelo transformer que precisa armazenar informações e fatos enquanto aprende raciocínio adequado, há dois módulos separados. O primeiro é o transformer usual que conhecemos e amamos, e depois há um segundo módulo de “memória” engram que atua como uma tabela de consulta de fatos (mais ou menos como um banco de dados para o cérebro do LLM).
O módulo engram exige muito pouca computação e só precisa de memória para carregar a si mesmo, então o modelo pode efetivamente ser dividido em dois: o módulo transformer é carregado em uma GPU, e o módulo engram fica na memória do sistema (CPU). Isso permitirá que você rode modelos maiores localmente, pois não precisará de GPUs com muita memória.
Este lançamento tem como objetivo principal dar à comunidade tempo para implementar e otimizar o modelo em diferentes motores de inferência de LLM, mas ele também é provavelmente o melhor modelo que você pode rodar agora em um DGX Spark, embora você deva estar preparado para alguns bugs se fizer isso.
H3 Max
MiniMax H3 subiu ao topo como um dos melhores modelos de geração de vídeo, e também é open source.
Um dos maiores provedores de inferência de imagem e vídeo, a Fal.ai, pegou o modelo e fez fine-tuning nele para ainda mais qualidade e também velocidade, produzindo o H3 Max.
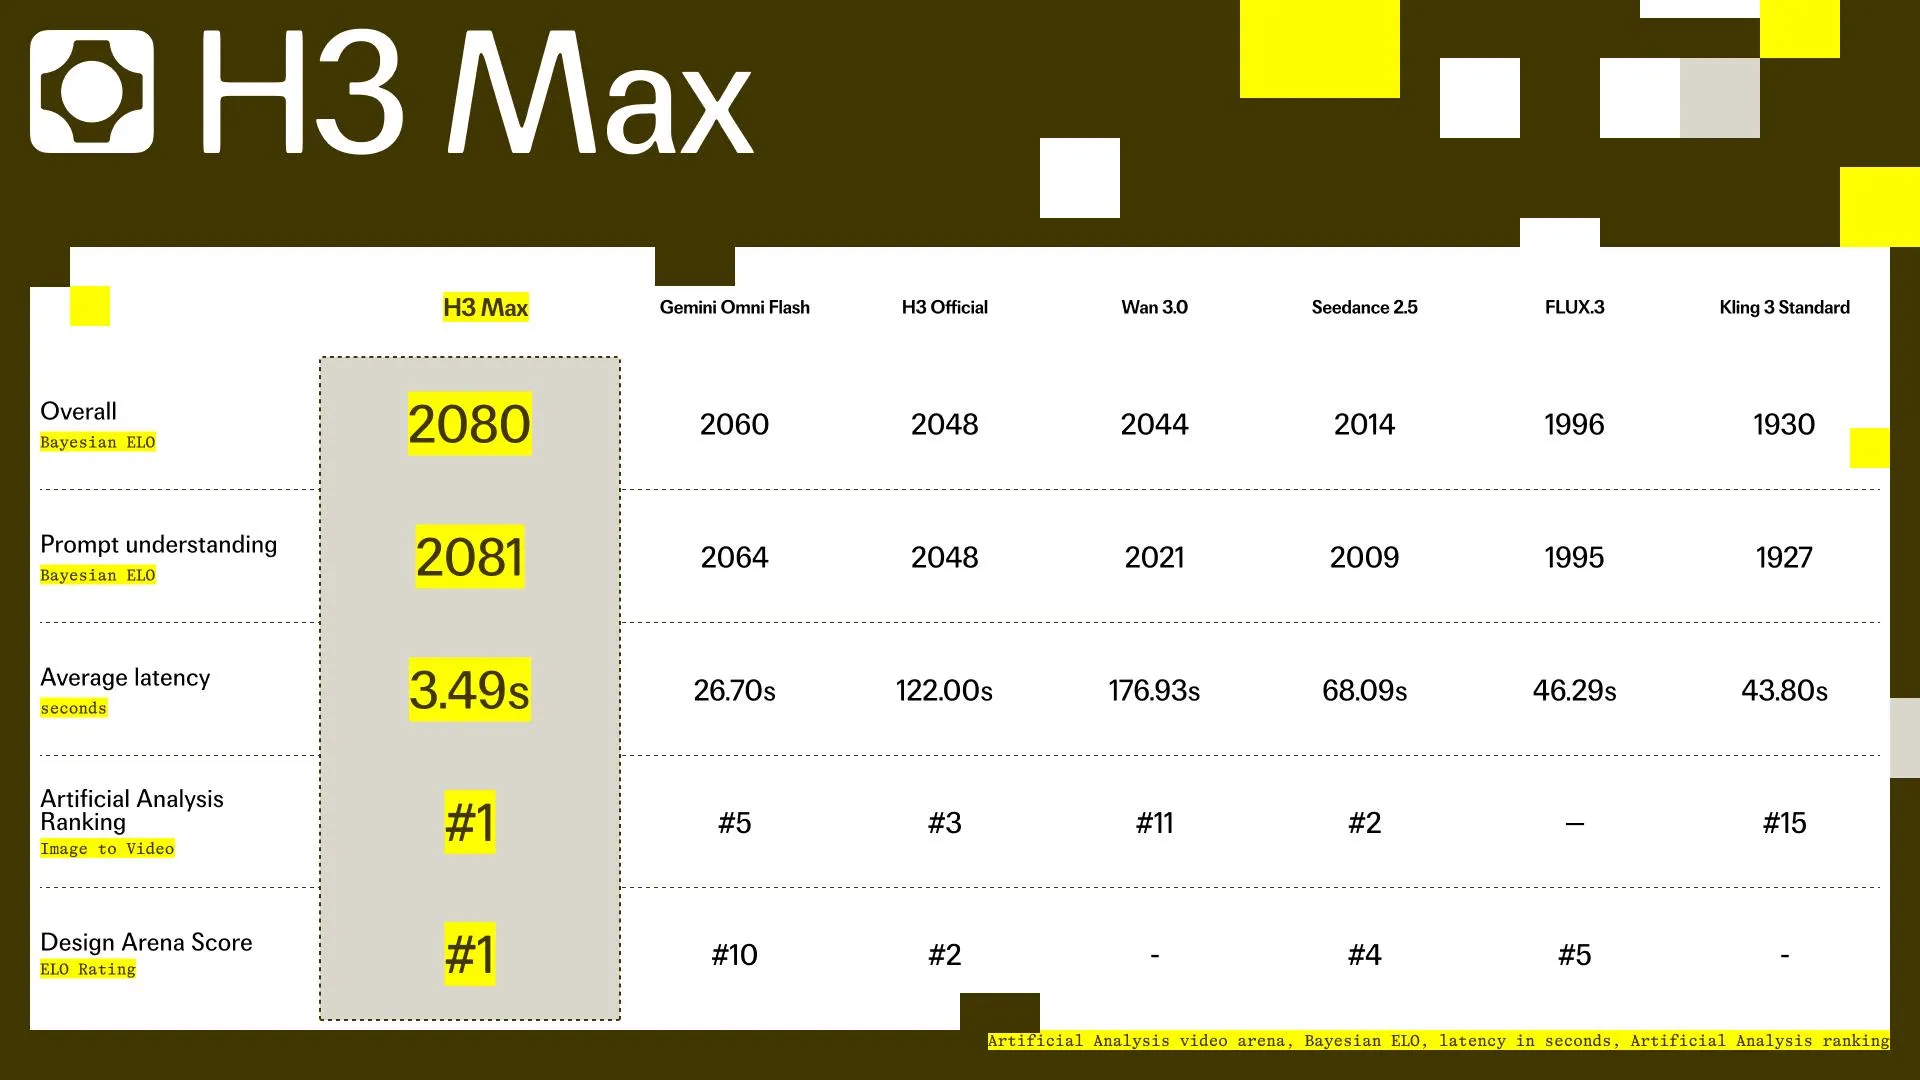
Isso resulta no melhor modelo de geração de vídeo que vimos, e ele é capaz de gerar vídeo mais rápido do que em tempo real: leva 3 segundos para gerar um vídeo de 5 segundos em 768p, o que significa que você pode ter um stream de vídeo contínuo a partir dele, por um custo muito baixo ($0.20 por vídeo de 5 segundos).
Você pode testá-lo de graça agora no site da Fal.
Benchmark de IA no dispositivo
Já me perguntaram muitas vezes qual é o melhor modelo para rodar em um telefone, e agora temos um ranking feito para responder exatamente a essa pergunta, da Artificial Analysis.
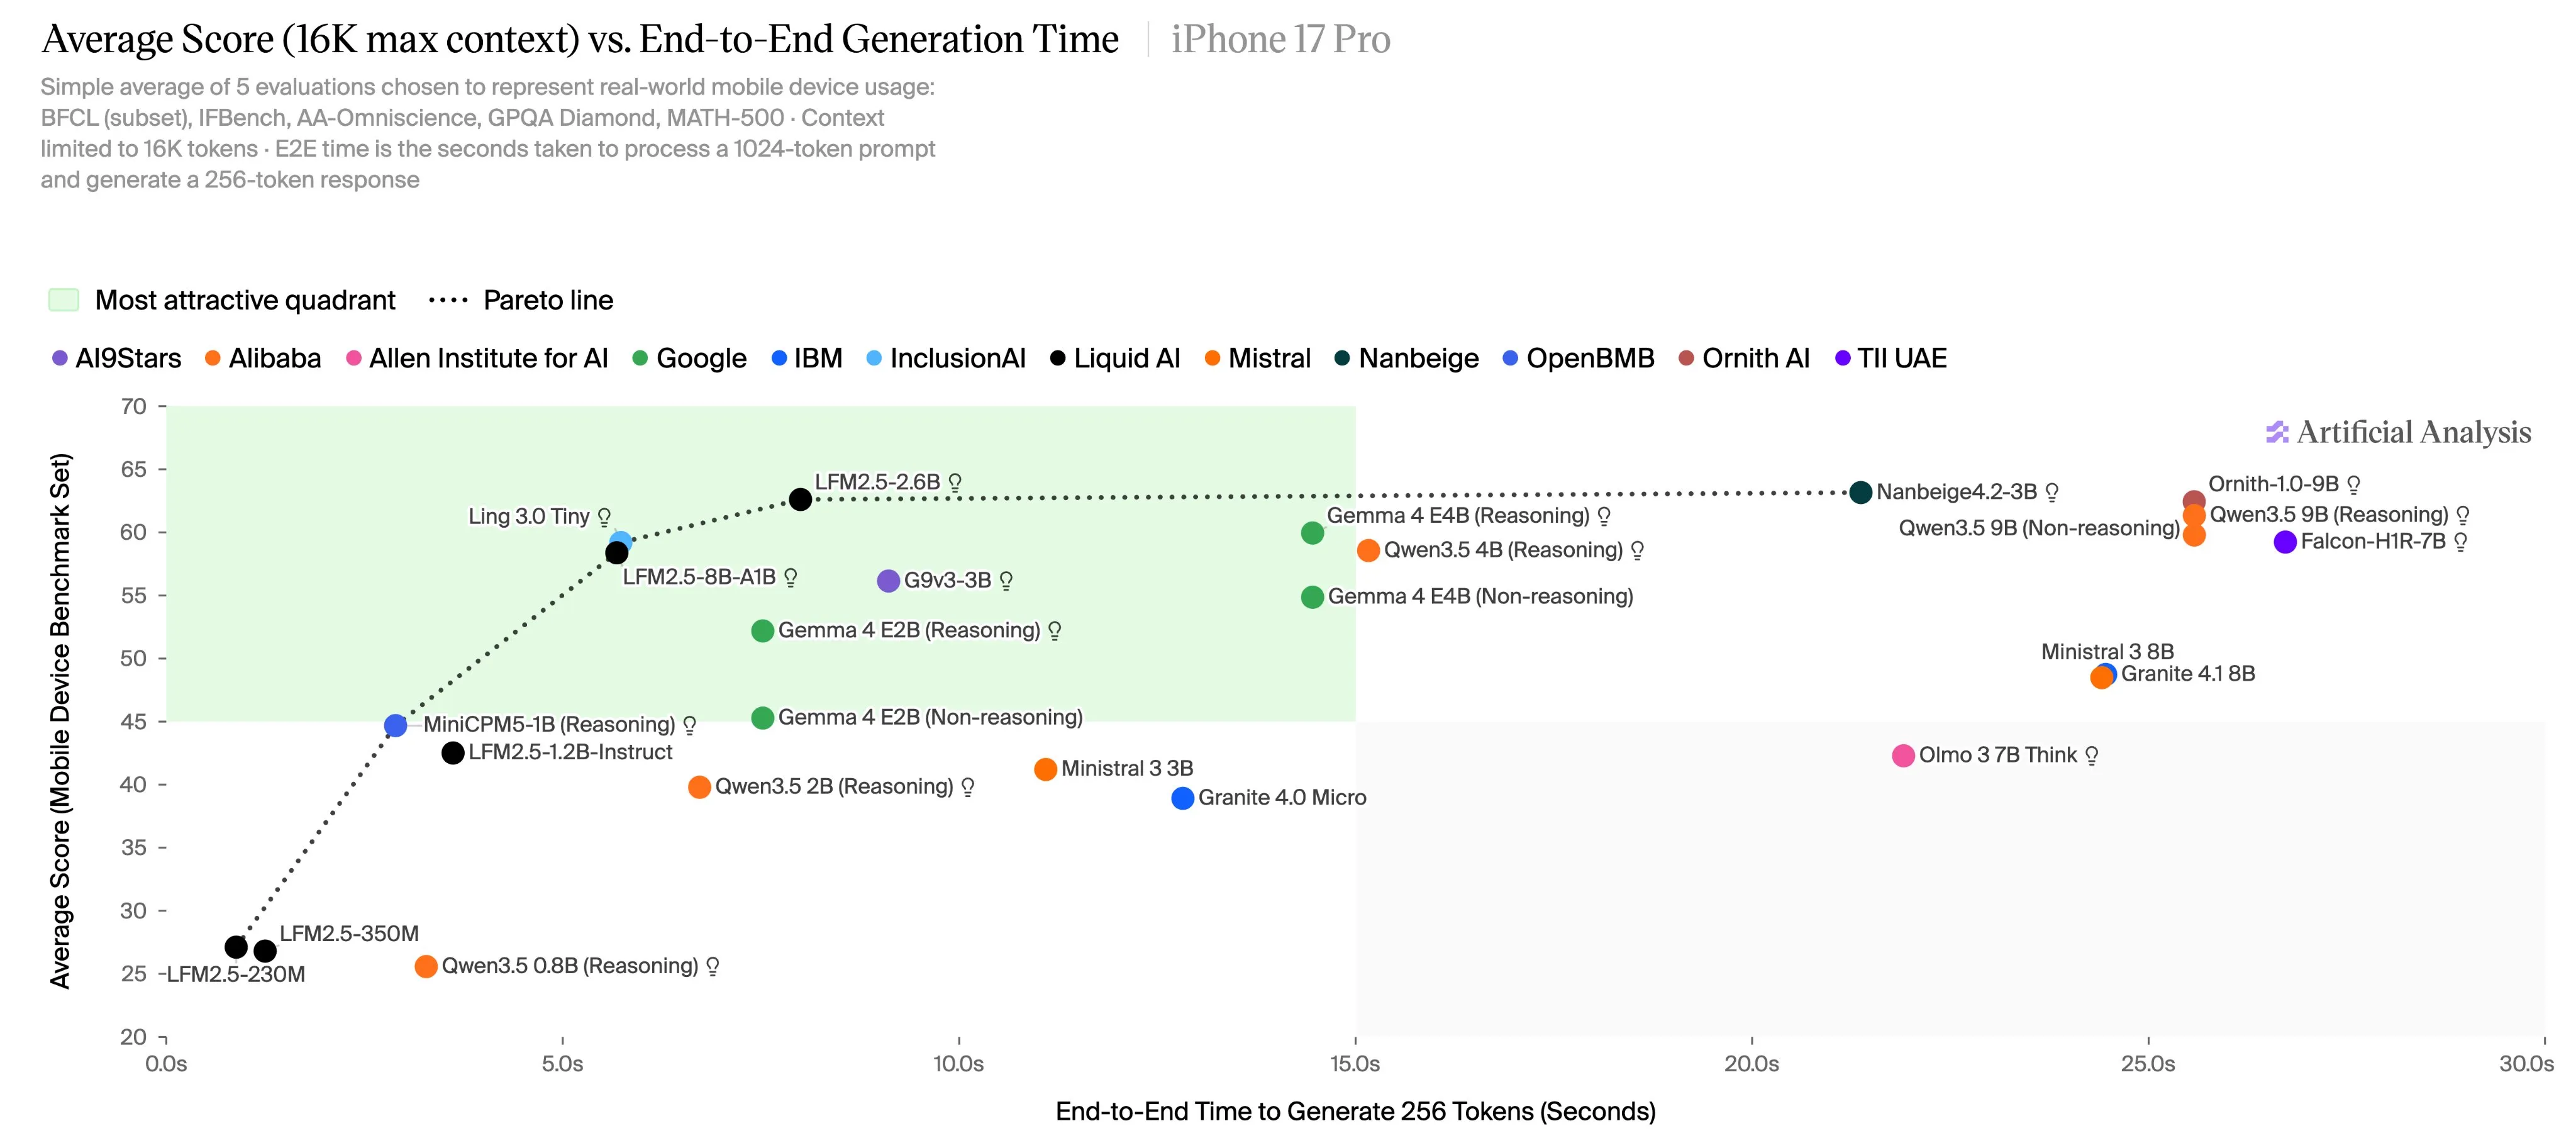
O benchmark agrega pontuações de chamadas de ferramentas básicas, alucinação e benchmarks de raciocínio para obter uma pontuação final, e também mede uso de tokens e velocidade de ponta a ponta em telefones modernos.
Para responder à pergunta sobre qual é o melhor modelo para telefone agora, LFM2.5 2.6B parece ser a resposta. Ele fica perto do topo em todos os benchmarks e atinge o equilíbrio certo entre velocidade, baixa taxa de alucinação e inteligência.
Encerramento
Espero que você tenha gostado das notícias desta semana. Se quiser receber as notícias toda semana, entre na nossa mailing list abaixo.