Nota: Este artículo fue traducido automáticamente con OpenAI GPT-5.5 mediante Codex CLI; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
DeepSeek V4 Pro
Hace unas semanas, DeepSeek lanzó la versión actualizada del modelo V4 Flash, que incluía un post-entrenamiento mucho mejor que su predecesor, lo que lo convirtió en una de las mejores opciones de bajo costo para tareas diarias con LLM.
Su actualización DeepSeek V4 Pro busca competir en la gama alta junto con GPT 5.6 y Fable, y no ser solo el rey del valor.
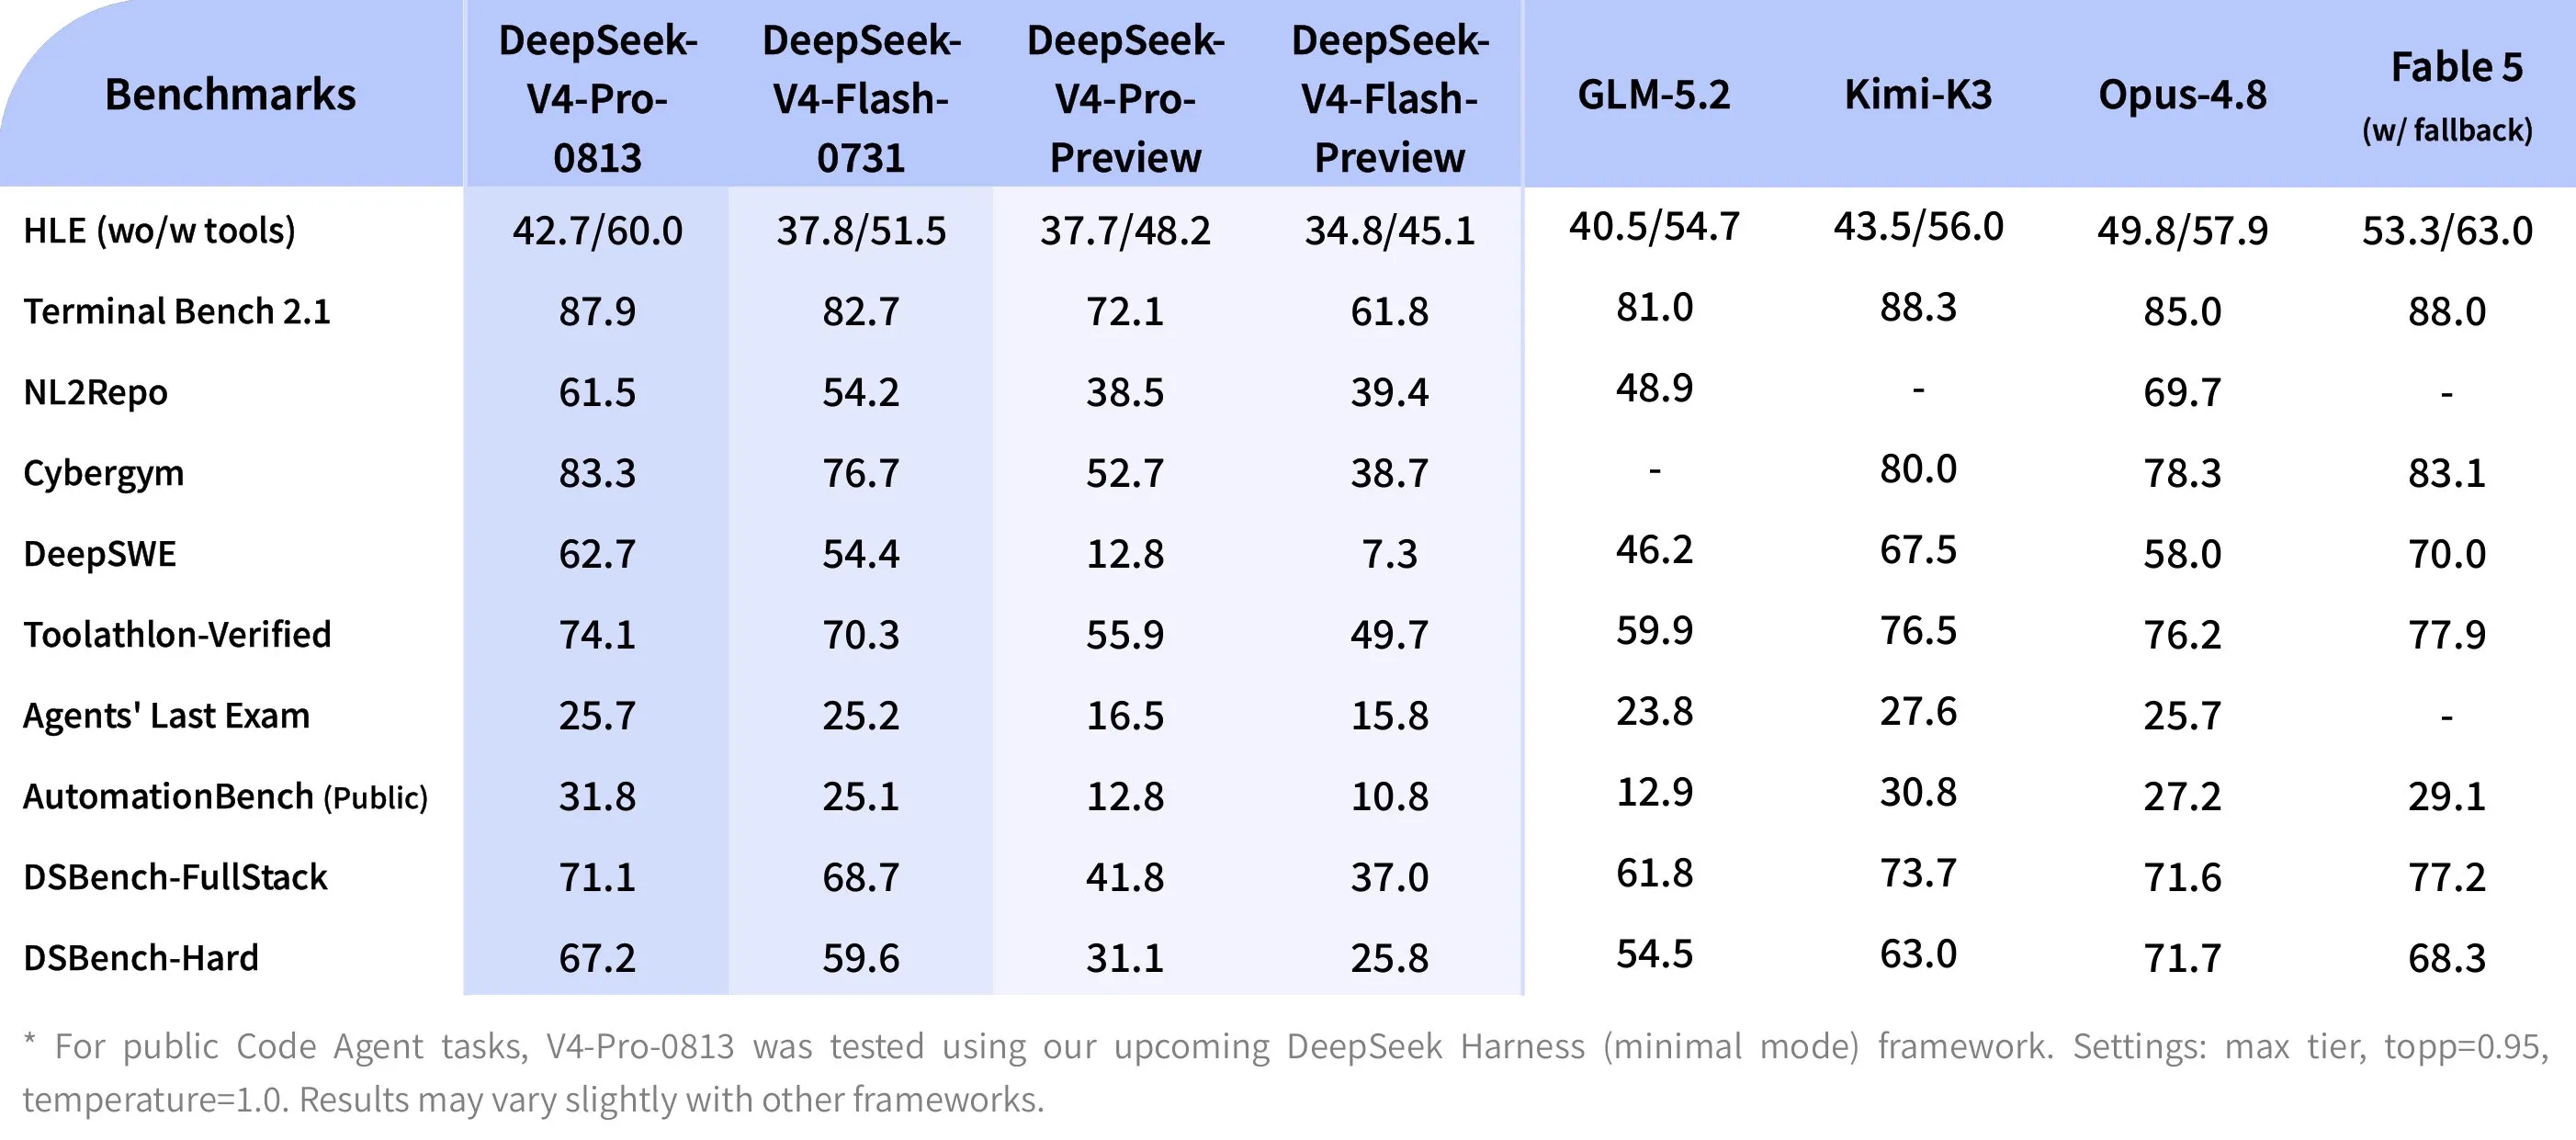
En comparación con la impresionante cantidad de inteligencia que se incluyó en el modelo V4 Flash, V4 Pro es un pequeño fracaso. En Artificial Analysis apenas obtiene una puntuación mejor que Flash, aunque cuesta ~2.5 veces más. Al igual que Flash, no es multimodal, algo que al propio modelo no le gusta.
En el mundo real, parece funcionar mejor al gestionar la planificación de tareas agénticas de mayor duración, pero su rendimiento real en programación no es muy diferente.
El modelo también se ve perjudicado por los aumentos de precios que están aplicando (alrededor de 3 veces para Flash y 4 veces para Pro). Esto los pone directamente a competir con GPT 5.6 Luna y Terra en términos de precio, una vez que se toma en cuenta la mayor cantidad de tokens que los modelos DeepSeek usan en promedio.
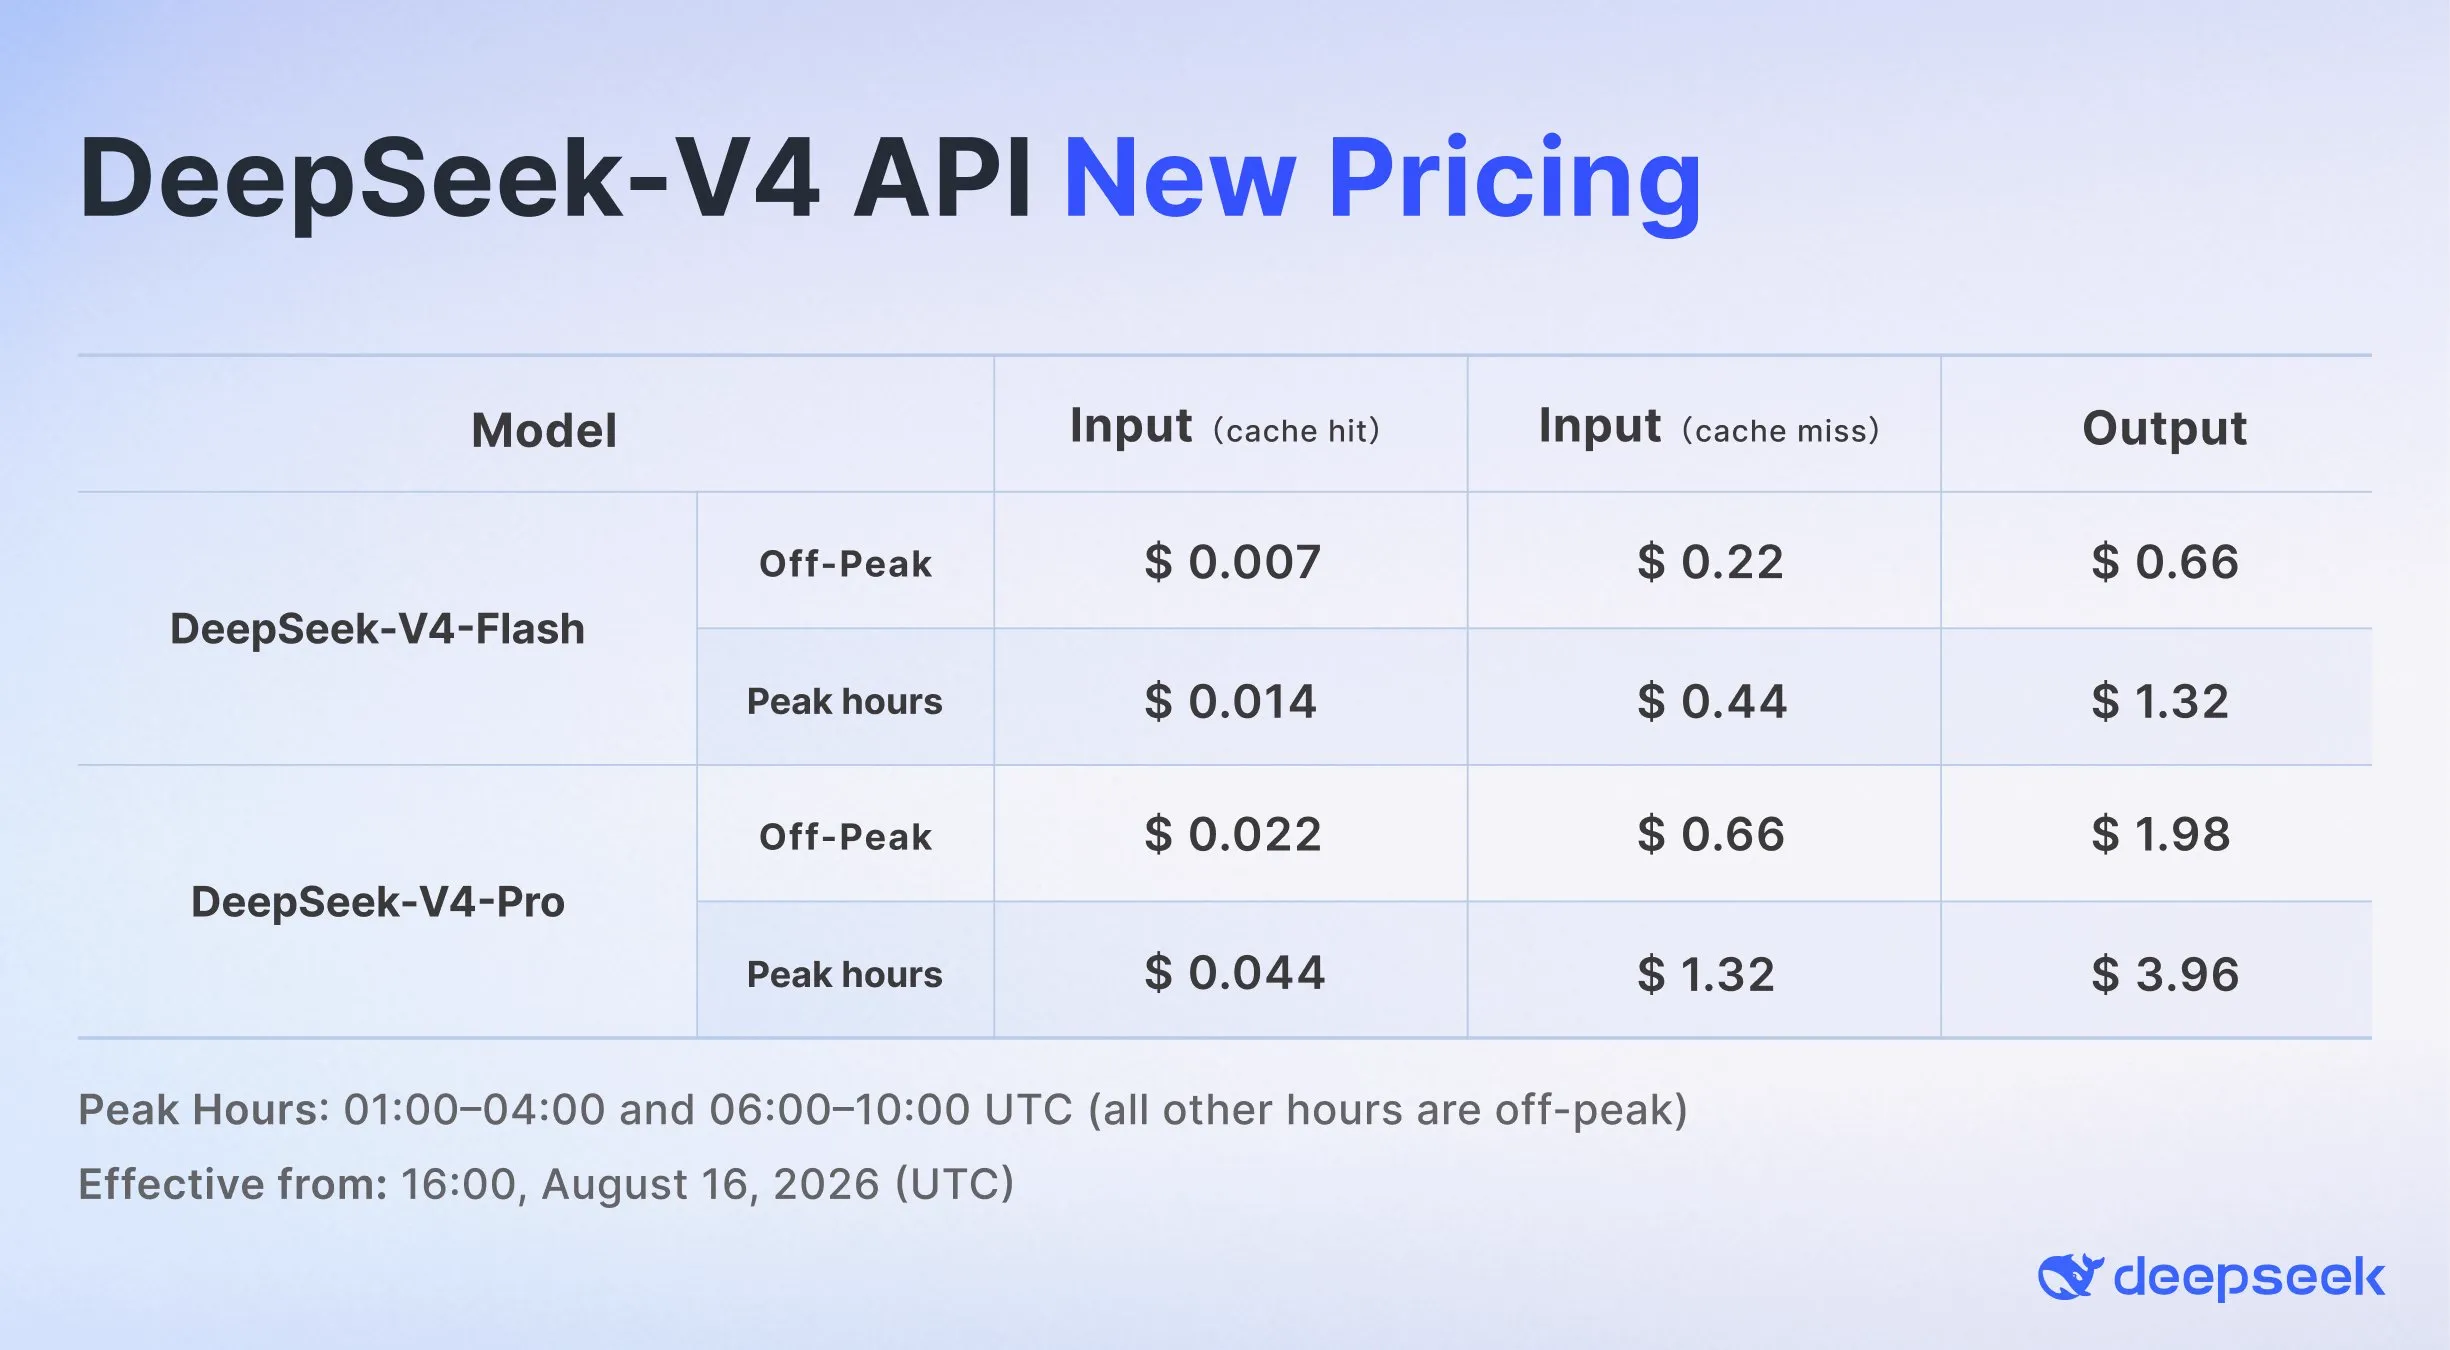
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| DeepSeek V4 Pro | $1.32 | $3.96 | 55 |
| DeepSeek V4 Flash | $0.44 | $1.32 | 82 |
| Grok 4.6 | $2 | $6 | 57 |
| Claude Fable 5 | $10 | $50 | 40 |
| Claude Opus 4.8 | $5 | $25 | 60 |
| GPT 5.6 Sol | $5 | $30 | 45 |
| GPT 5.6 Terra | $2.50 | $15 | 63 |
| GPT 5.6 Luna | $1 | $6 | 84 |
| Kimi K3 | $3 | $15 | 27 |
| GLM 5.2 | $1.40 | $4.40 | 47 |
Sin embargo, hay un lado positivo. Lo más probable es que Flash haya sido destilado a partir de una versión temprana del modelo Pro, y la paridad relativa que tiene con Pro significa que DeepSeek probablemente sea el mejor del mundo en destilar sus modelos a un tamaño más pequeño. Esto es parte de por qué este lanzamiento resulta tan decepcionante.
Si esto continúa a largo plazo, significa que DeepSeek podrá compactar inteligencia de nivel frontera en modelos más pequeños y baratos que podremos usar y, potencialmente, ejecutar nosotros mismos en casa.
Yo evitaría V4 Pro por ahora. Si necesitas un modelo barato, mira V4 Flash, pero Pro queda en un punto medio confuso donde no es ni el más barato ni el más inteligente, lo que me dificulta recomendarlo.
Grok 4.6
Después de mucho tiempo en la categoría de modelos “meh”, parece que Grok por fin está haciéndose un nombre con la iteración 4.6.
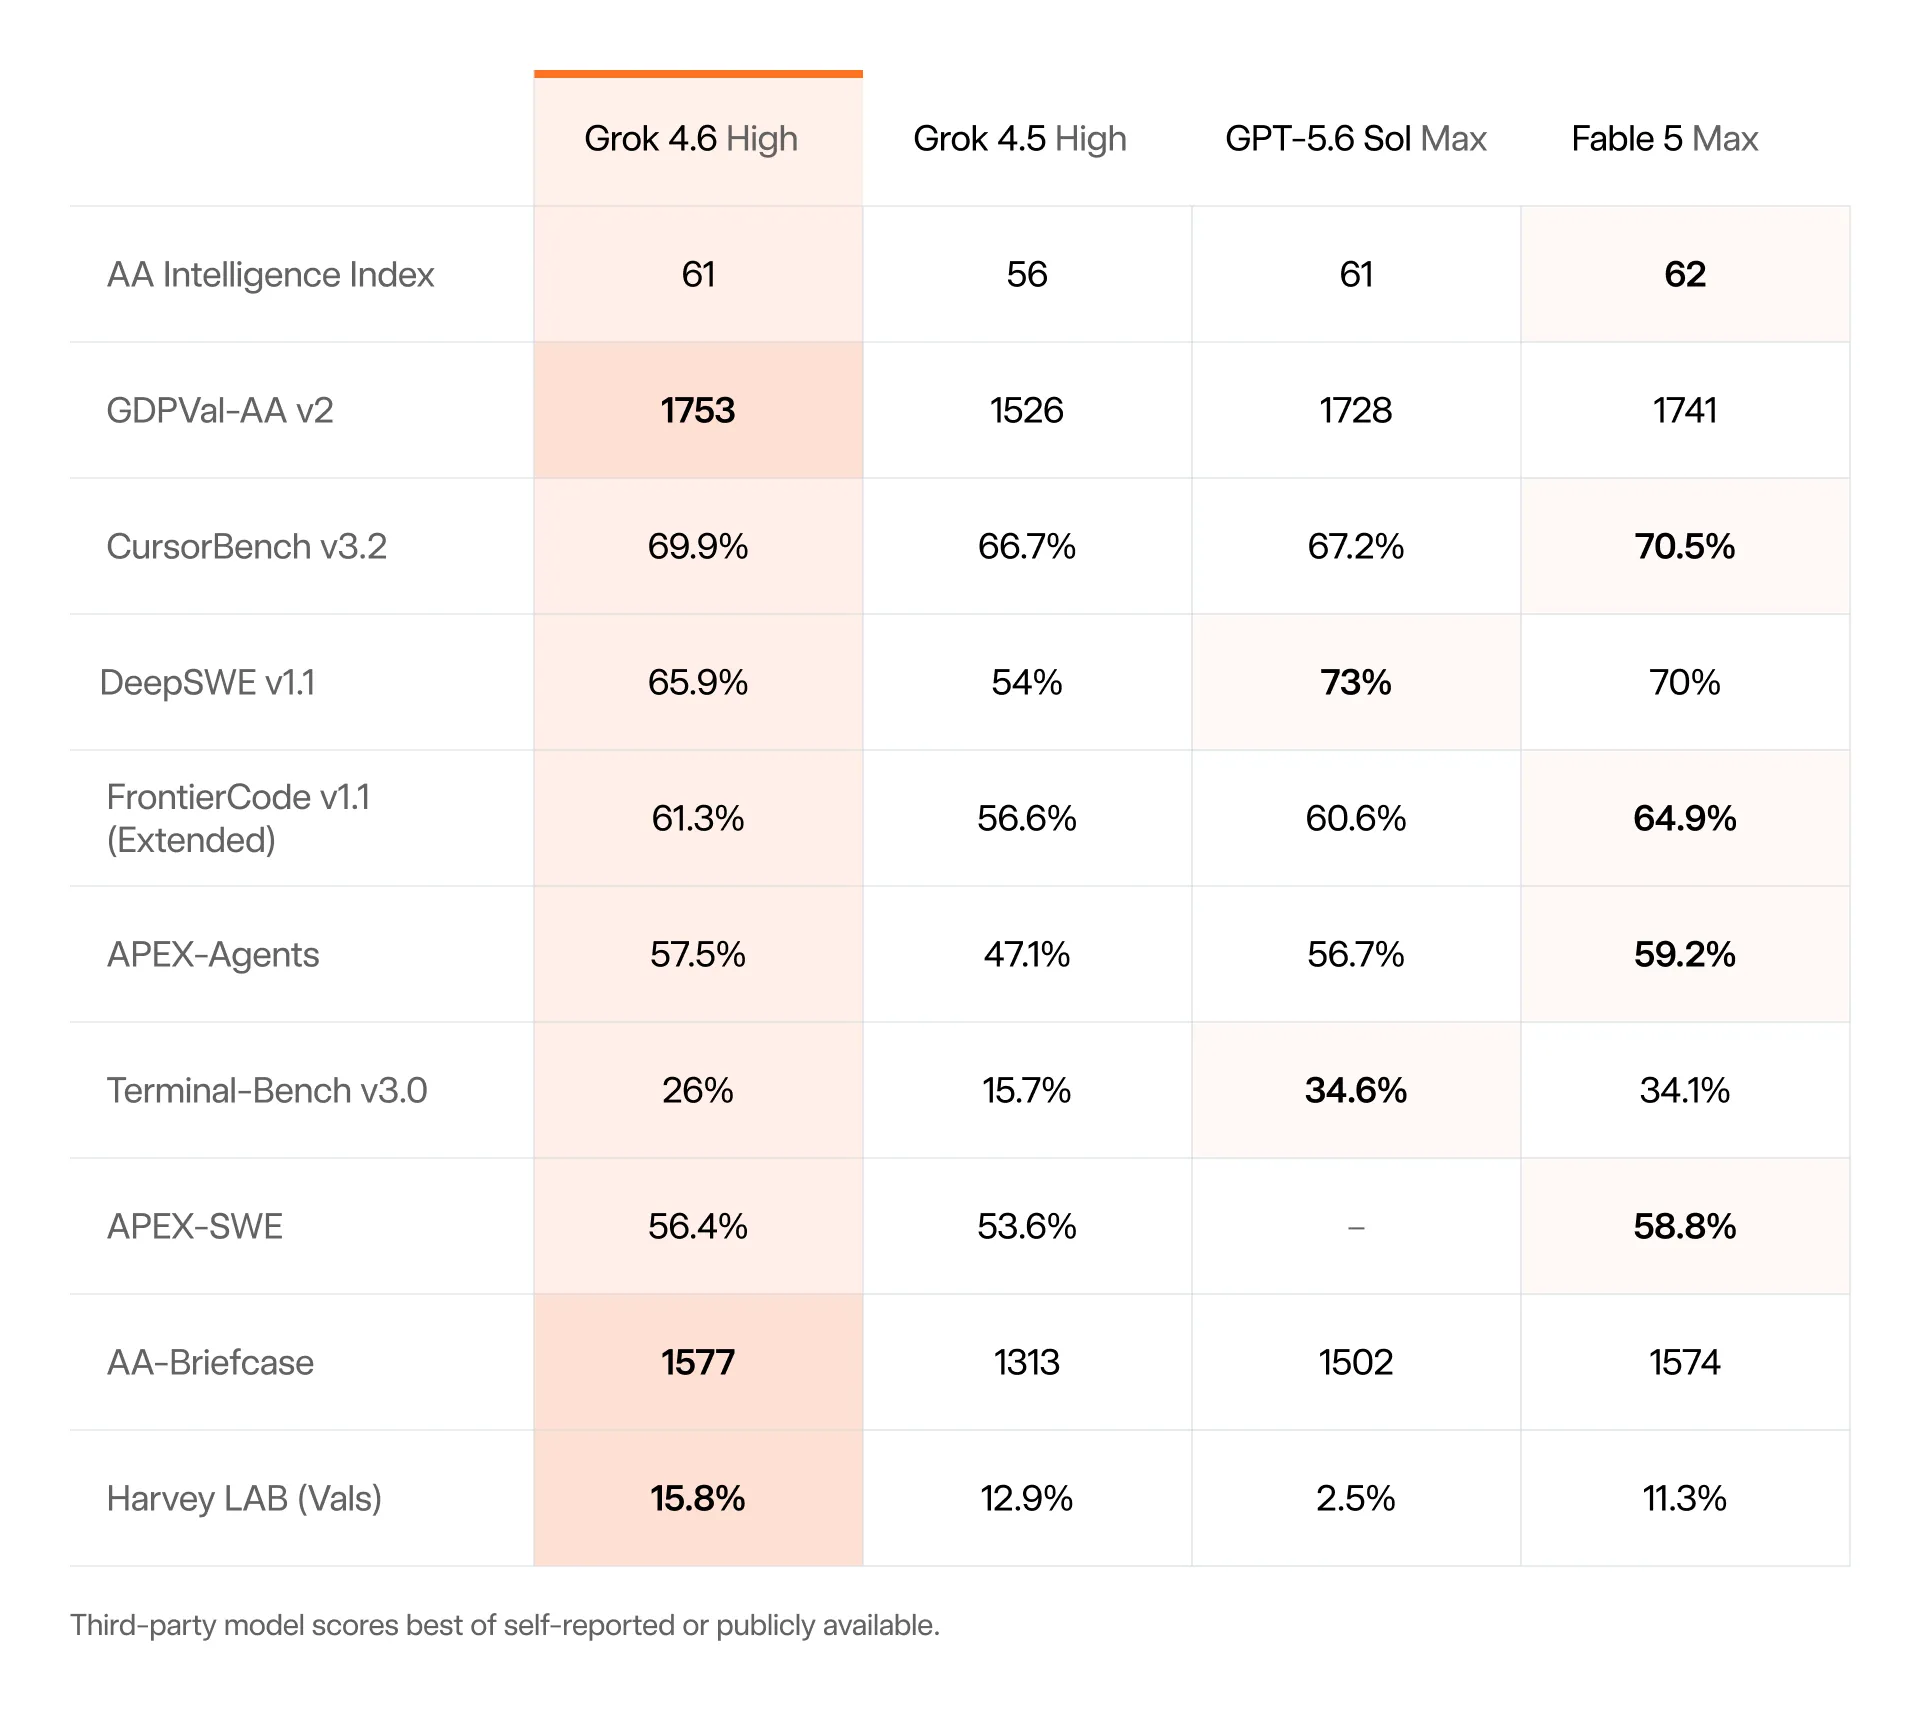
Para tareas diarias de programación, por lo que he visto, parece estar a la par de GPT 5.6 Sol y Fable, y las primeras impresiones parecen ubicarlo por encima de la mayoría de los modelos chinos, probablemente alrededor del nivel de Kimi K3 o mejor. Para tareas a gran escala y capacidad de razonamiento en bruto, queda por detrás de los modelos de frontera, así que no es un reemplazo completo de GPT 5.6 y Fable, pero para la mayoría de las personas esto probablemente no será un problema.
Al igual que su predecesor, muchas personas han comentado lo ágil que se siente el modelo frente a la competencia, especialmente cuando se usa la configuración de razonamiento “low”.
También es muy impresionante ver la velocidad a la que el equipo de SpaceXAI está iterando ahora mismo. Grok 4.5 se lanzó un mes antes, y ya han anunciado que Grok 4.7 se lanzará en un mes. Esto es rápido incluso para los ritmos vertiginosos del mundo de la IA actual, ya que la mayoría de los otros laboratorios tardan entre 2 y 3 meses en lanzar nuevos modelos.
Grok 4.6 no es imprescindible ahora mismo, pero recomendaría probarlo si tienes la oportunidad para ver cómo funciona con lo que haces, con la expectativa de que veremos más de ellos en el futuro cercano.
Noticias breves
Qwen 3.8 27B
La serie Qwen 3.6 ha sido la opción principal para quienes intentan ejecutar LLM en hardware local de consumo, y el último modelo Qwen 3.8 perpetúa esto.
El modelo 27B es un modelo denso multimodal, lo que significa que probablemente querrás una GPU dedicada para ejecutarlo (lo siento, usuarios de Mac, aunque se rumorea que la variante mixture of experts también saldrá pronto).
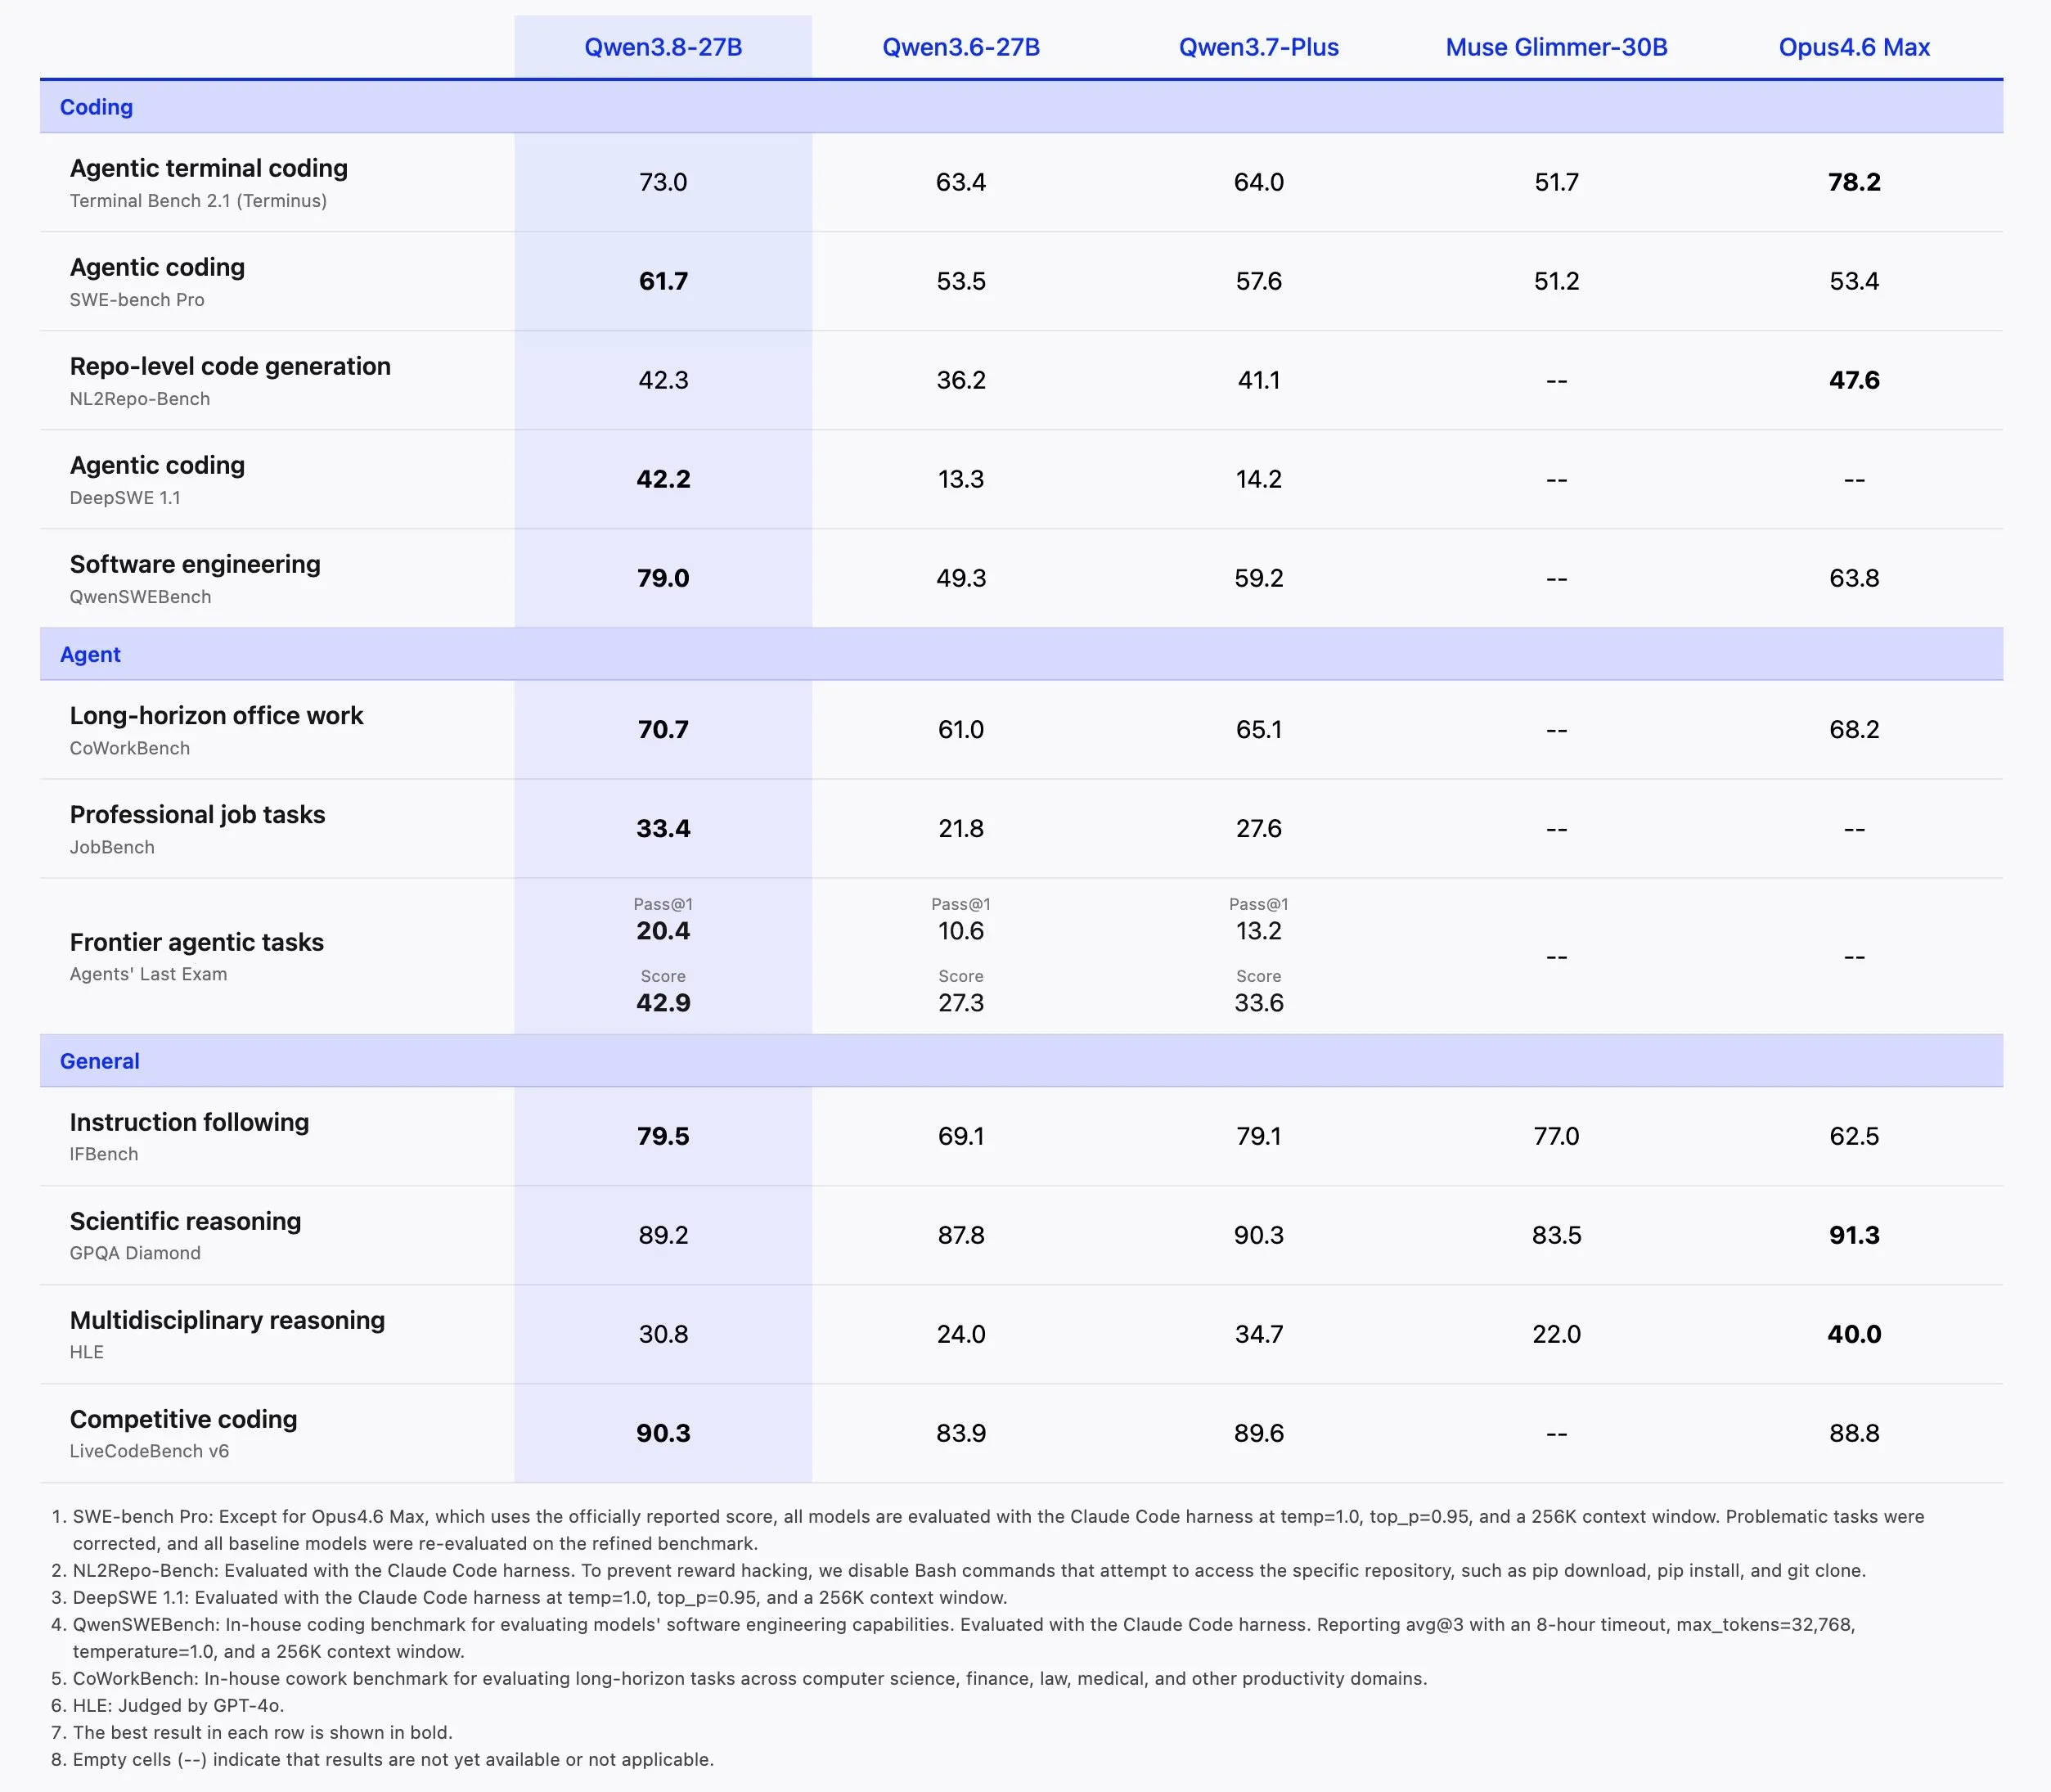
Todavía no he tenido mucho tiempo para probarlo (¿por qué los laboratorios han empezado a lanzar modelos los viernes?), pero la impresión inicial parece ser un salto bastante decente en capacidades agénticas. Aun así, sus límites todavía no se han explorado, por ejemplo, si puede reemplazar a DeepSeek V4 Flash como subagente capaz.
Cabe destacar que tiene modos de razonamiento variables (de low a xhigh), similar a la mayoría de los otros modelos modernos de razonamiento. En la configuración xhigh, usa sustancialmente más tokens que su predecesor, así que tenlo en cuenta.
Si ejecutas modelos locales, lo más probable es que ya estés usando Qwen, y esta parece ser una actualización segura.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.