Nota: Este artigo foi traduzido automaticamente com OpenAI GPT-5.5 por meio do Codex CLI; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
DeepSeek V4 Pro
Há algumas semanas, a DeepSeek lançou a versão atualizada do modelo V4 Flash, que incluiu um pós-treinamento muito melhor em comparação com seu antecessor, tornando-o uma das melhores opções de baixo custo para tarefas diárias com LLMs.
A atualização DeepSeek V4 Pro busca competir no topo, ao lado de GPT 5.6 e Fable, e não ser somente o rei do custo-benefício.
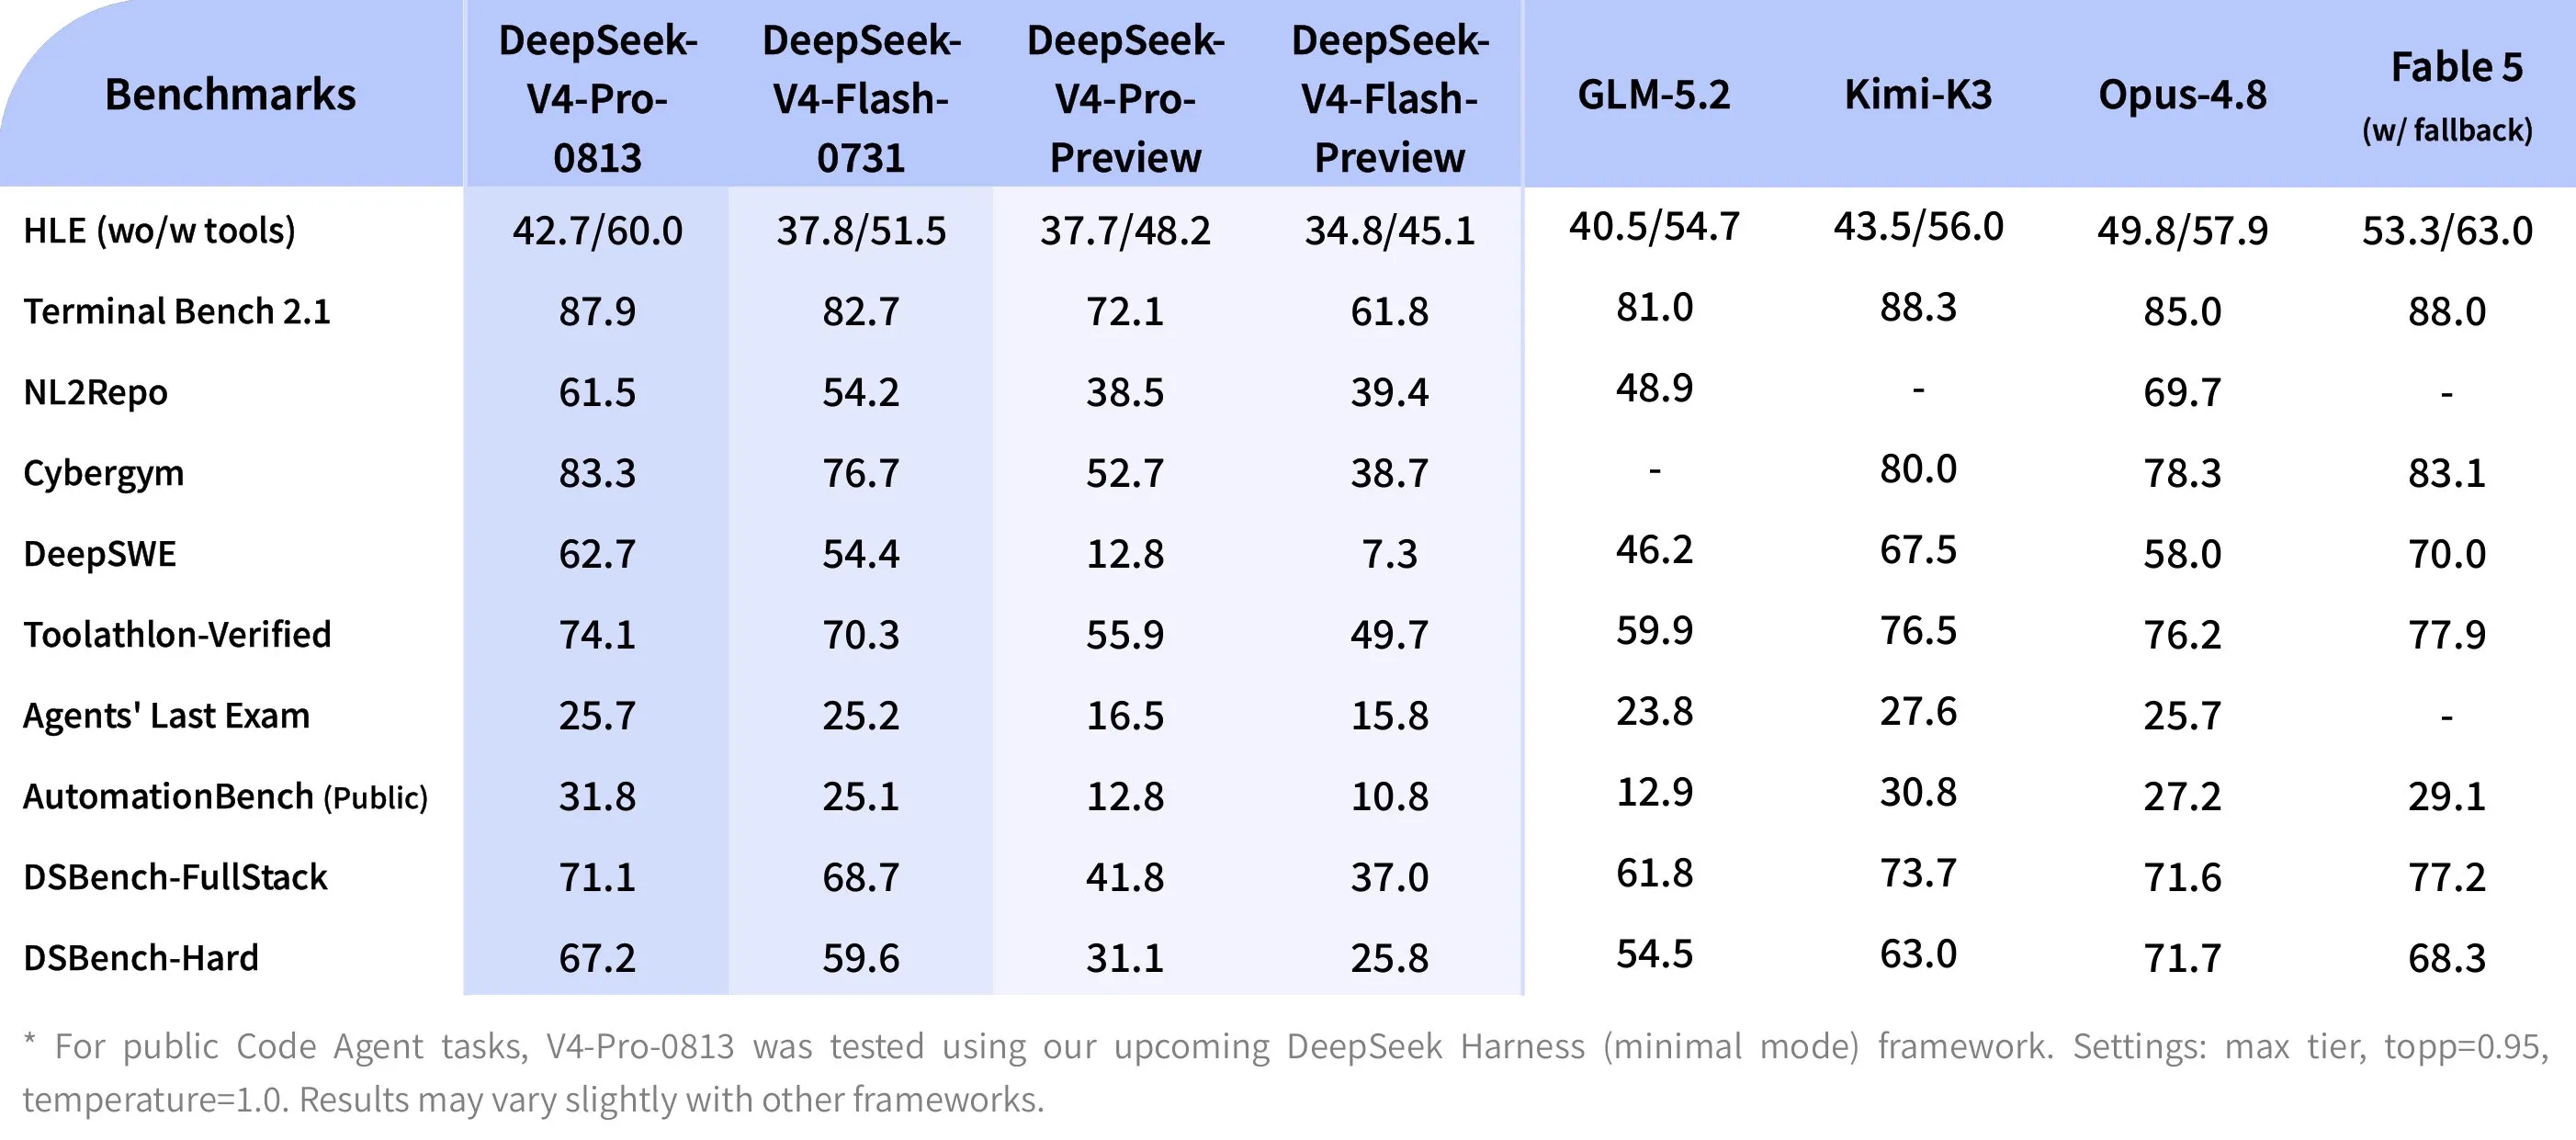
Comparado com a quantidade impressionante de inteligência que foi colocada no modelo V4 Flash, o V4 Pro é um pouco decepcionante. No Artificial Analysis, ele pontua só um pouco melhor que o Flash, embora seja cerca de 2,5x mais caro. Assim como o Flash, ele não é multimodal, algo de que o próprio modelo não gosta.
No mundo real, ele parece lidar melhor com o planejamento de tarefas agênticas de maior duração, mas seu desempenho real em programação não é tão diferente assim.
Outro fator que prejudica o modelo são os aumentos de preço que eles estão implementando (cerca de 3x para o Flash e 4x para o Pro). Isso os coloca em competição direta com os preços do GPT 5.6 Luna e Terra, quando se considera o número maior de tokens que os modelos da DeepSeek usam em média.
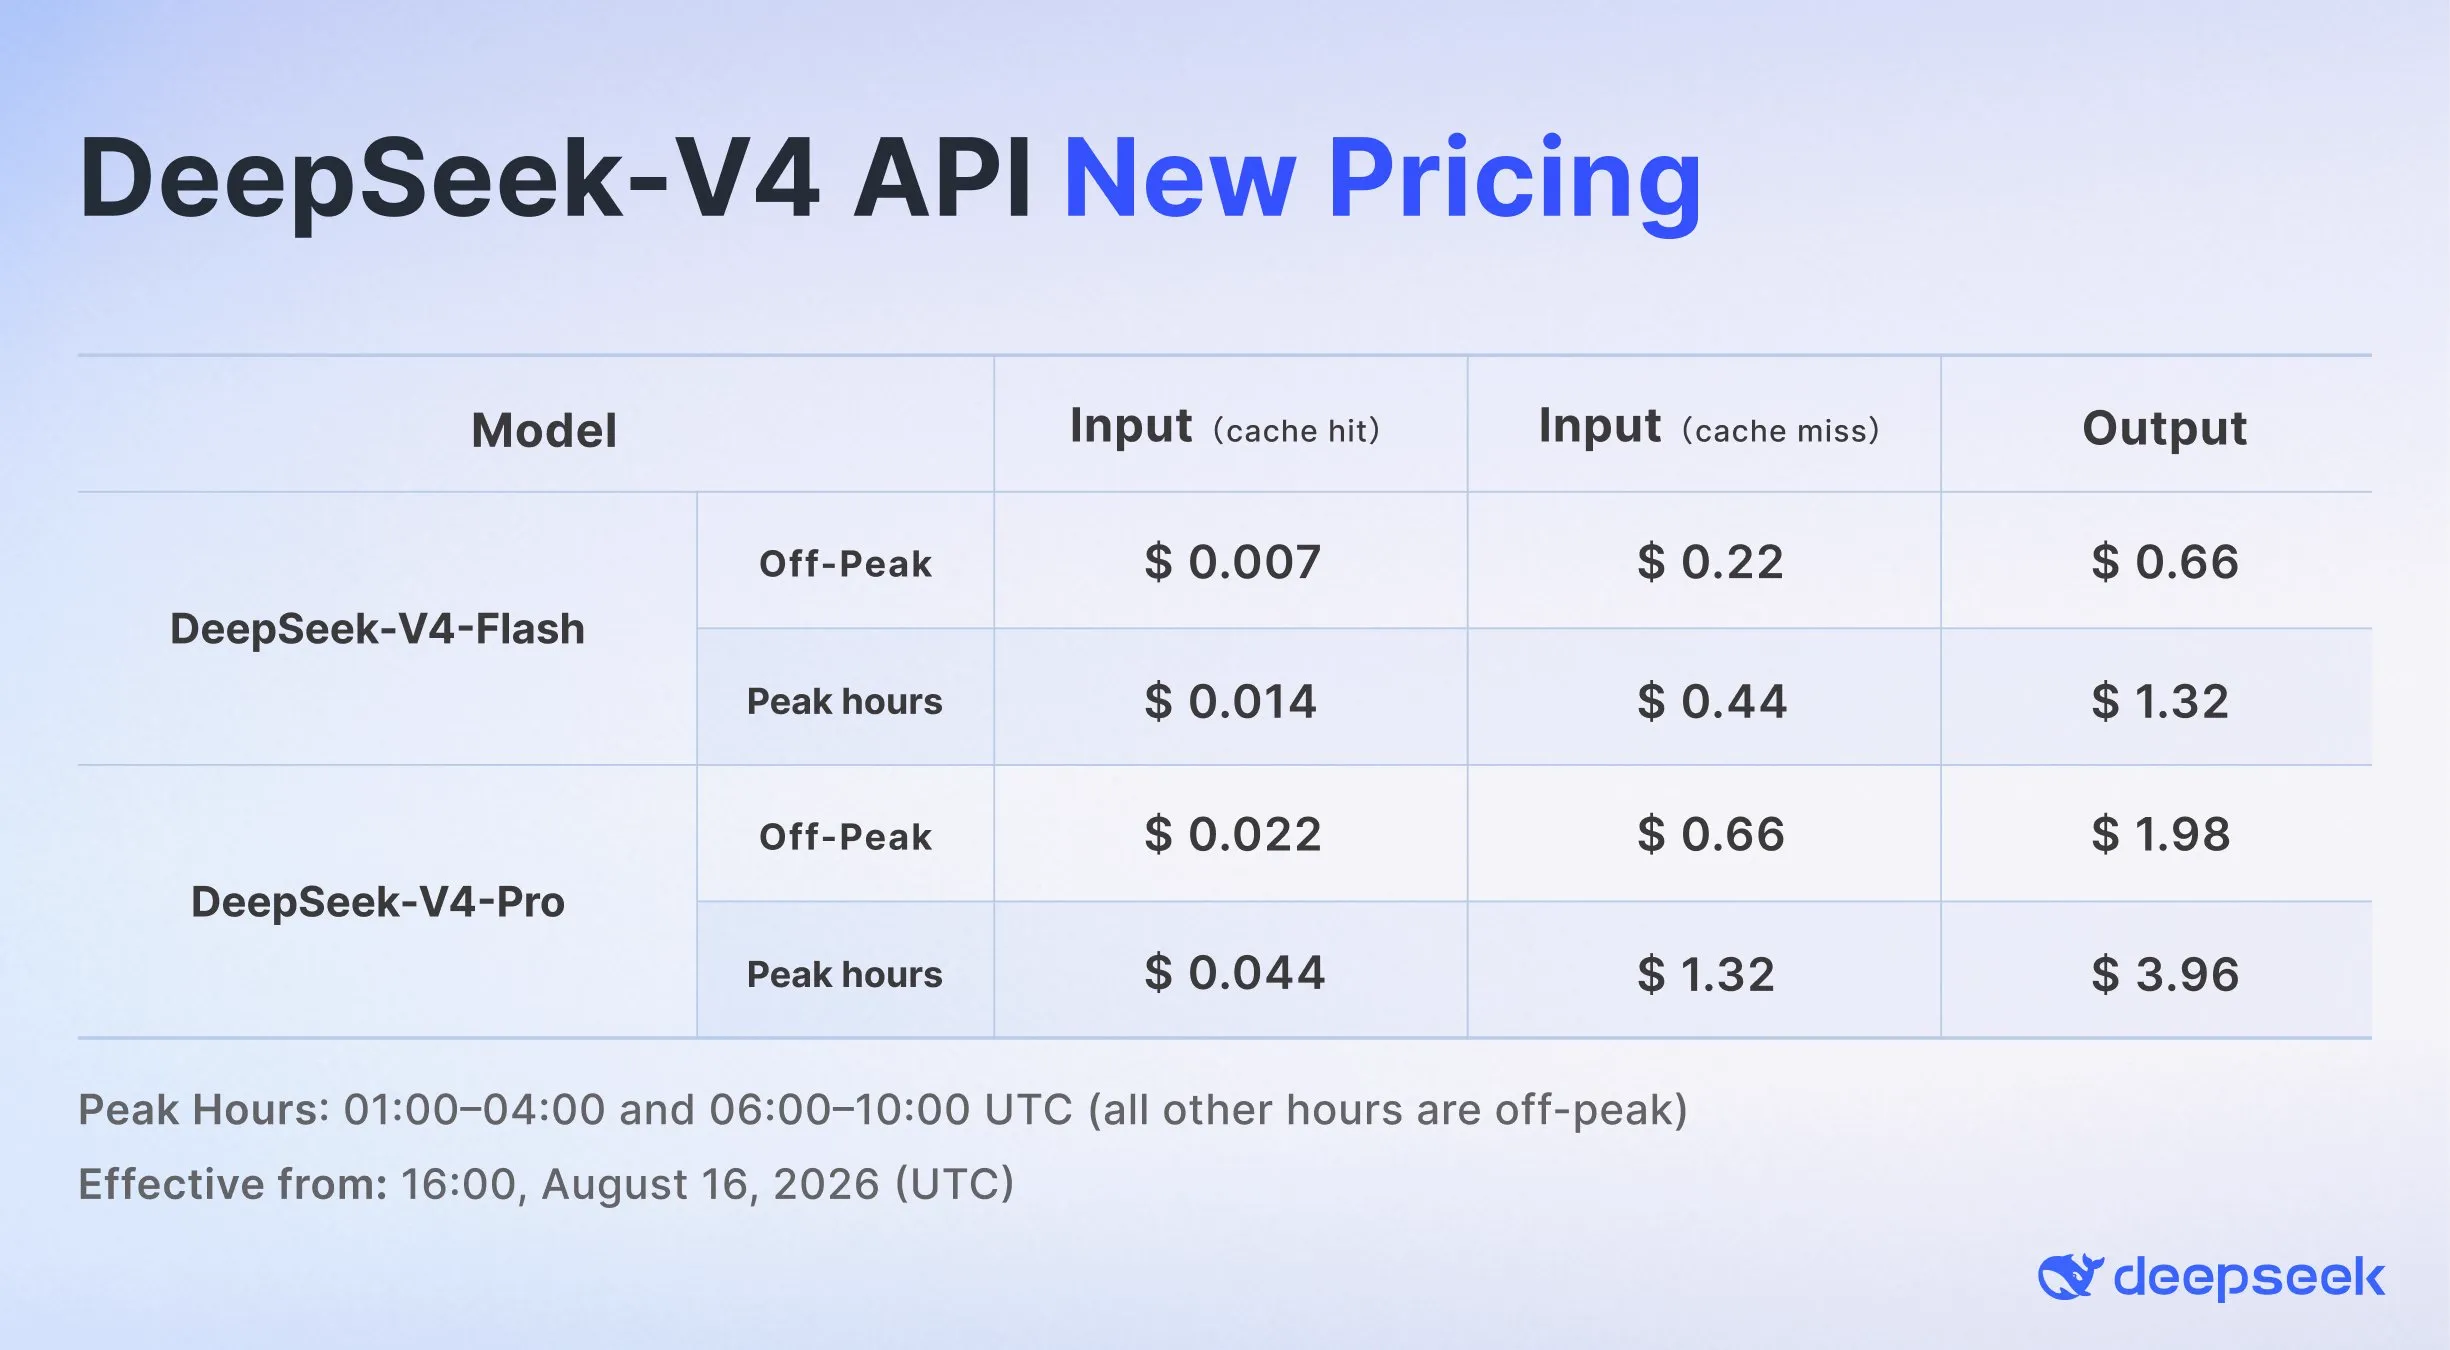
| Modelo | US$ por milhão (entrada) | US$ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| DeepSeek V4 Pro | $1.32 | $3.96 | 55 |
| DeepSeek V4 Flash | $0.44 | $1.32 | 82 |
| Grok 4.6 | $2 | $6 | 57 |
| Claude Fable 5 | $10 | $50 | 40 |
| Claude Opus 4.8 | $5 | $25 | 60 |
| GPT 5.6 Sol | $5 | $30 | 45 |
| GPT 5.6 Terra | $2.50 | $15 | 63 |
| GPT 5.6 Luna | $1 | $6 | 84 |
| Kimi K3 | $3 | $15 | 27 |
| GLM 5.2 | $1.40 | $4.40 | 47 |
Há, porém, um lado positivo nisso. O Flash provavelmente foi destilado de uma versão inicial do modelo Pro, e a paridade relativa que ele tem com o Pro significa que a DeepSeek provavelmente é a melhor do mundo em destilar seus modelos para um tamanho menor. Isso é parte do motivo pelo qual este lançamento é tão pouco empolgante.
Se isso continuar no longo prazo, significa que a DeepSeek poderá compactar inteligência de nível frontier em modelos menores e mais baratos, que poderemos usar e talvez executar em casa.
Eu pularia o V4 Pro por enquanto. Se você precisa de um modelo barato, veja o V4 Flash, mas o Pro fica no meio indefinido, onde não é nem o mais barato nem o mais inteligente, o que dificulta minha recomendação.
Grok 4.6
Depois de muito tempo na categoria “meh” dos modelos, parece que o Grok finalmente está criando uma reputação com a iteração 4.6.
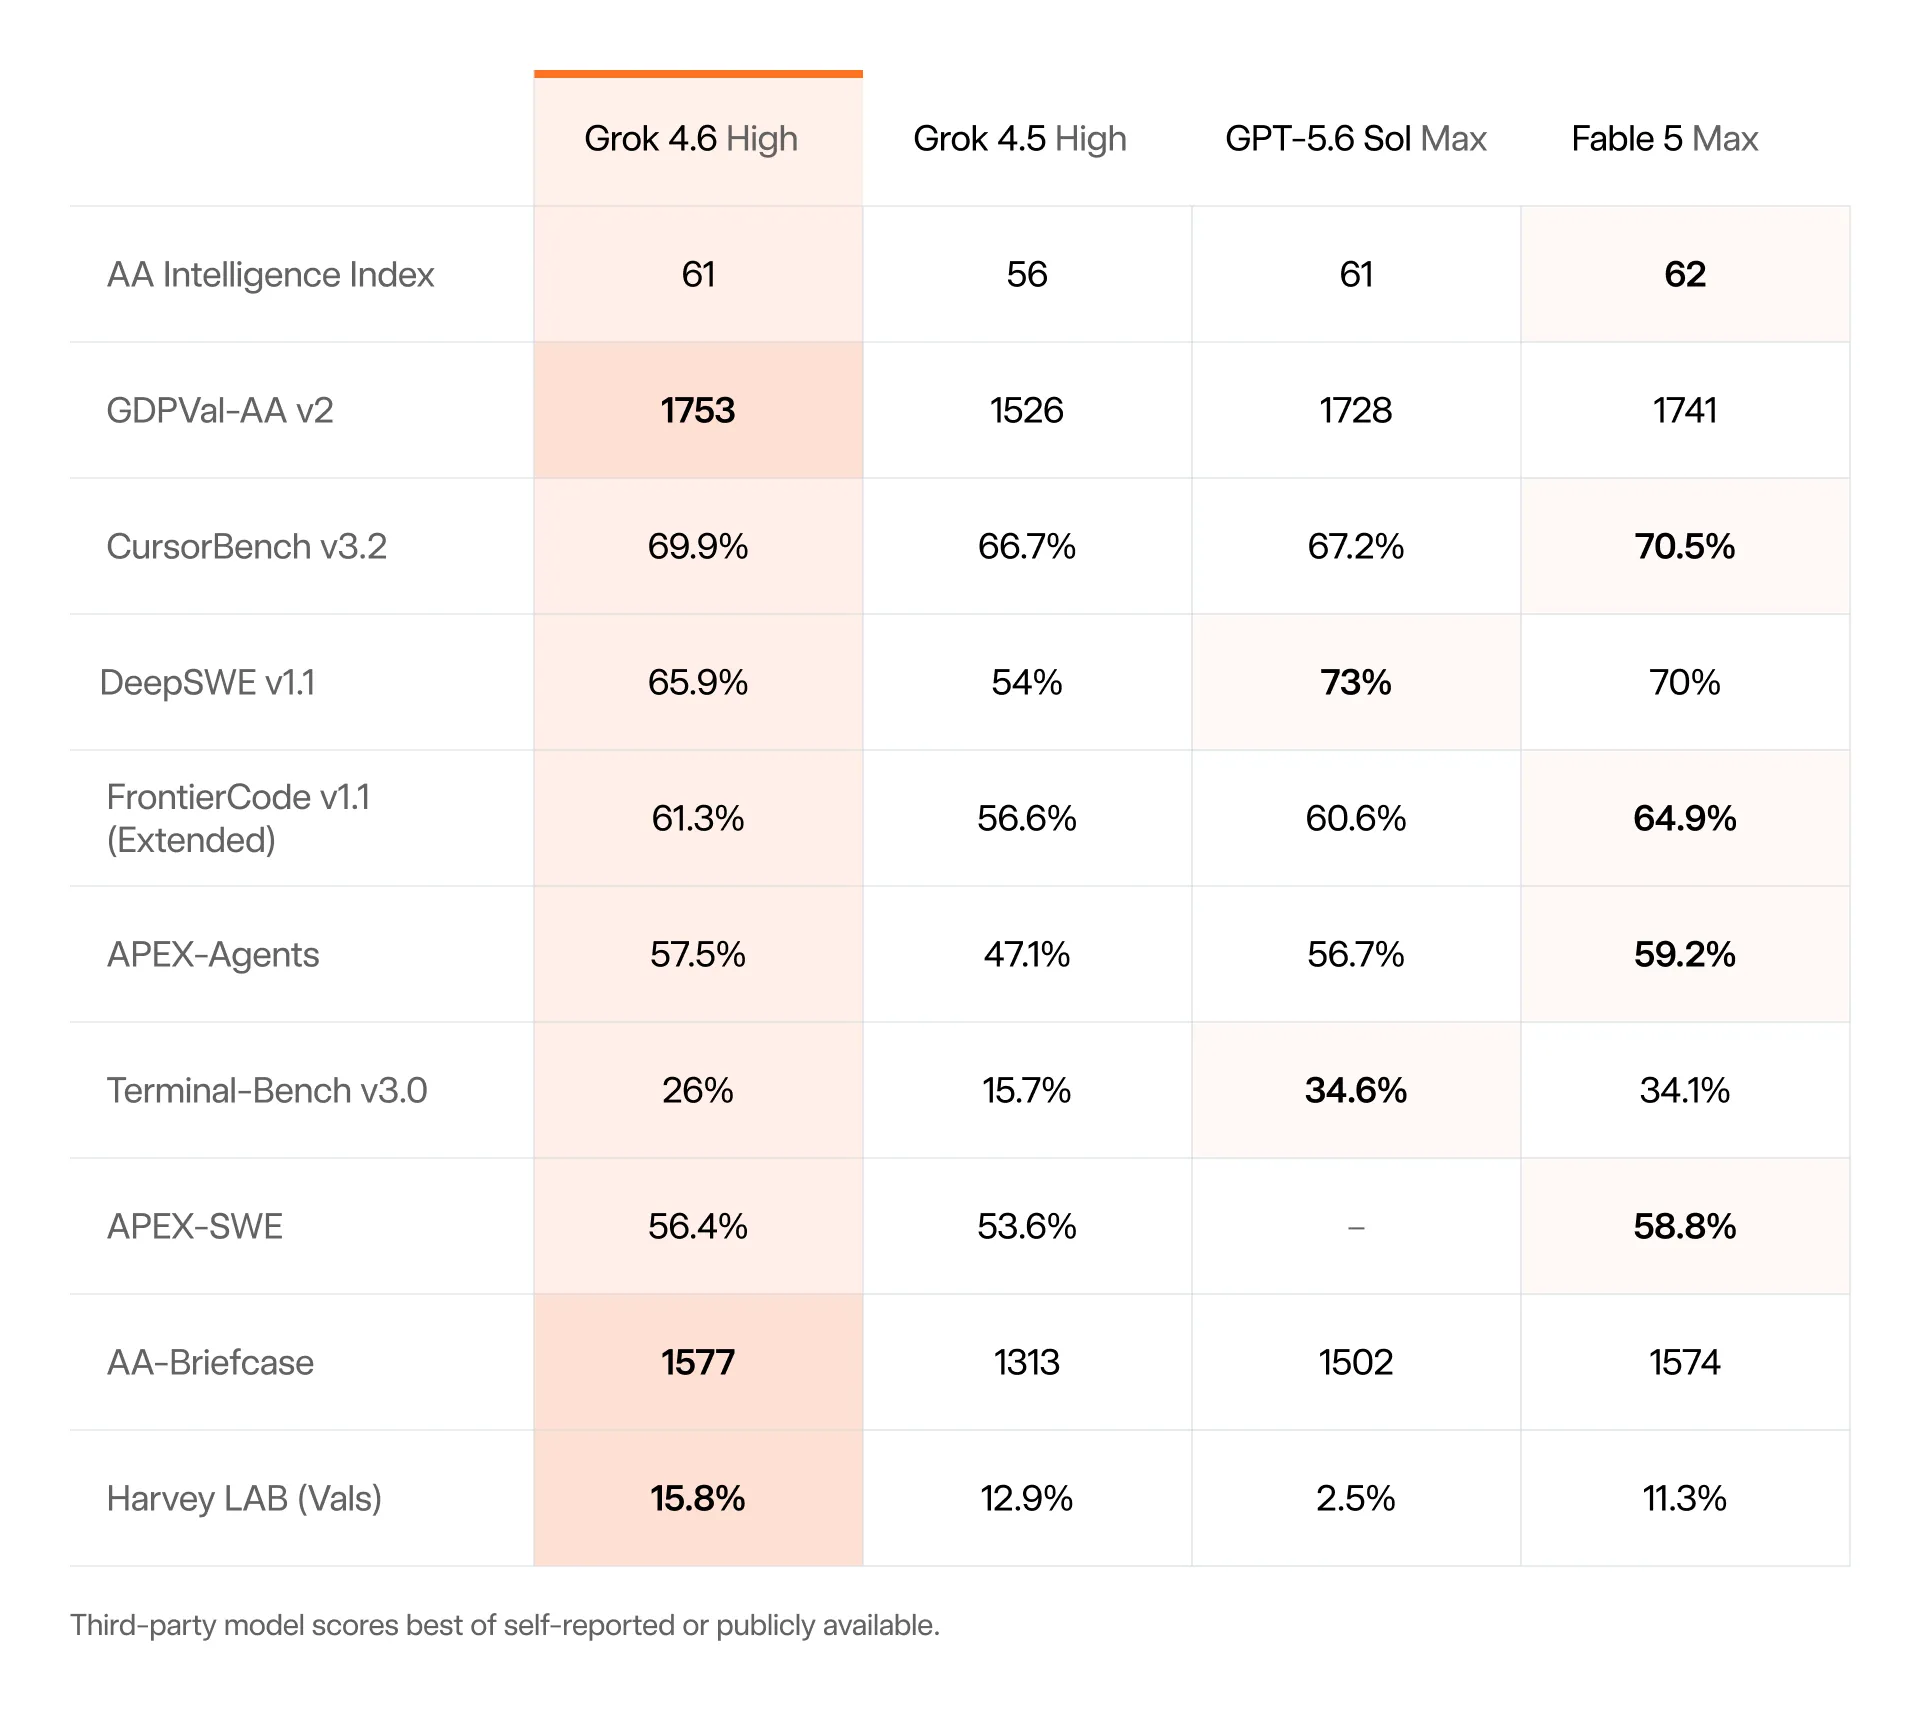
Para tarefas diárias de programação, pelo que vi, ele parece estar no mesmo nível do GPT 5.6 Sol e do Fable, e as impressões iniciais parecem colocá-lo acima da maioria dos modelos chineses, provavelmente em torno do nível do Kimi K3 ou melhor. Para tarefas em grande escala e capacidade bruta de raciocínio, ele fica atrás dos modelos frontier, então não é um substituto completo para GPT 5.6 e Fable, mas para a maioria das pessoas isso provavelmente não será um problema.
Assim como seu antecessor, muitas pessoas falaram sobre como o modelo parece ágil em uso quando comparado à concorrência, especialmente ao usar a configuração de raciocínio “low”.
Também é muito impressionante ver a velocidade com que a equipe da SpaceXAI está iterando agora. O Grok 4.5 foi lançado um mês antes, e eles já anunciaram que o Grok 4.7 será lançado em um mês. Isso é rápido mesmo para as velocidades vertiginosas do mundo da IA agora, já que a maioria dos outros laboratórios leva 2 a 3 meses para lançar novos modelos.
O Grok 4.6 não é indispensável no momento, mas eu recomendaria testá-lo se você tiver a chance, para ver como ele funciona com o que você faz, com a expectativa de que veremos mais deles no futuro próximo.
Notas Rápidas
Qwen 3.8 27B
A série Qwen 3.6 tem sido a escolha padrão para pessoas que tentam executar LLMs em hardware local de consumo, e o modelo mais recente Qwen 3.8 continua isso.
O modelo 27B é um modelo denso multimodal, o que significa que você provavelmente vai querer uma GPU dedicada para executá-lo (desculpe, usuários de Mac, embora haja rumores de que a variante mixture of experts também será lançada em breve).
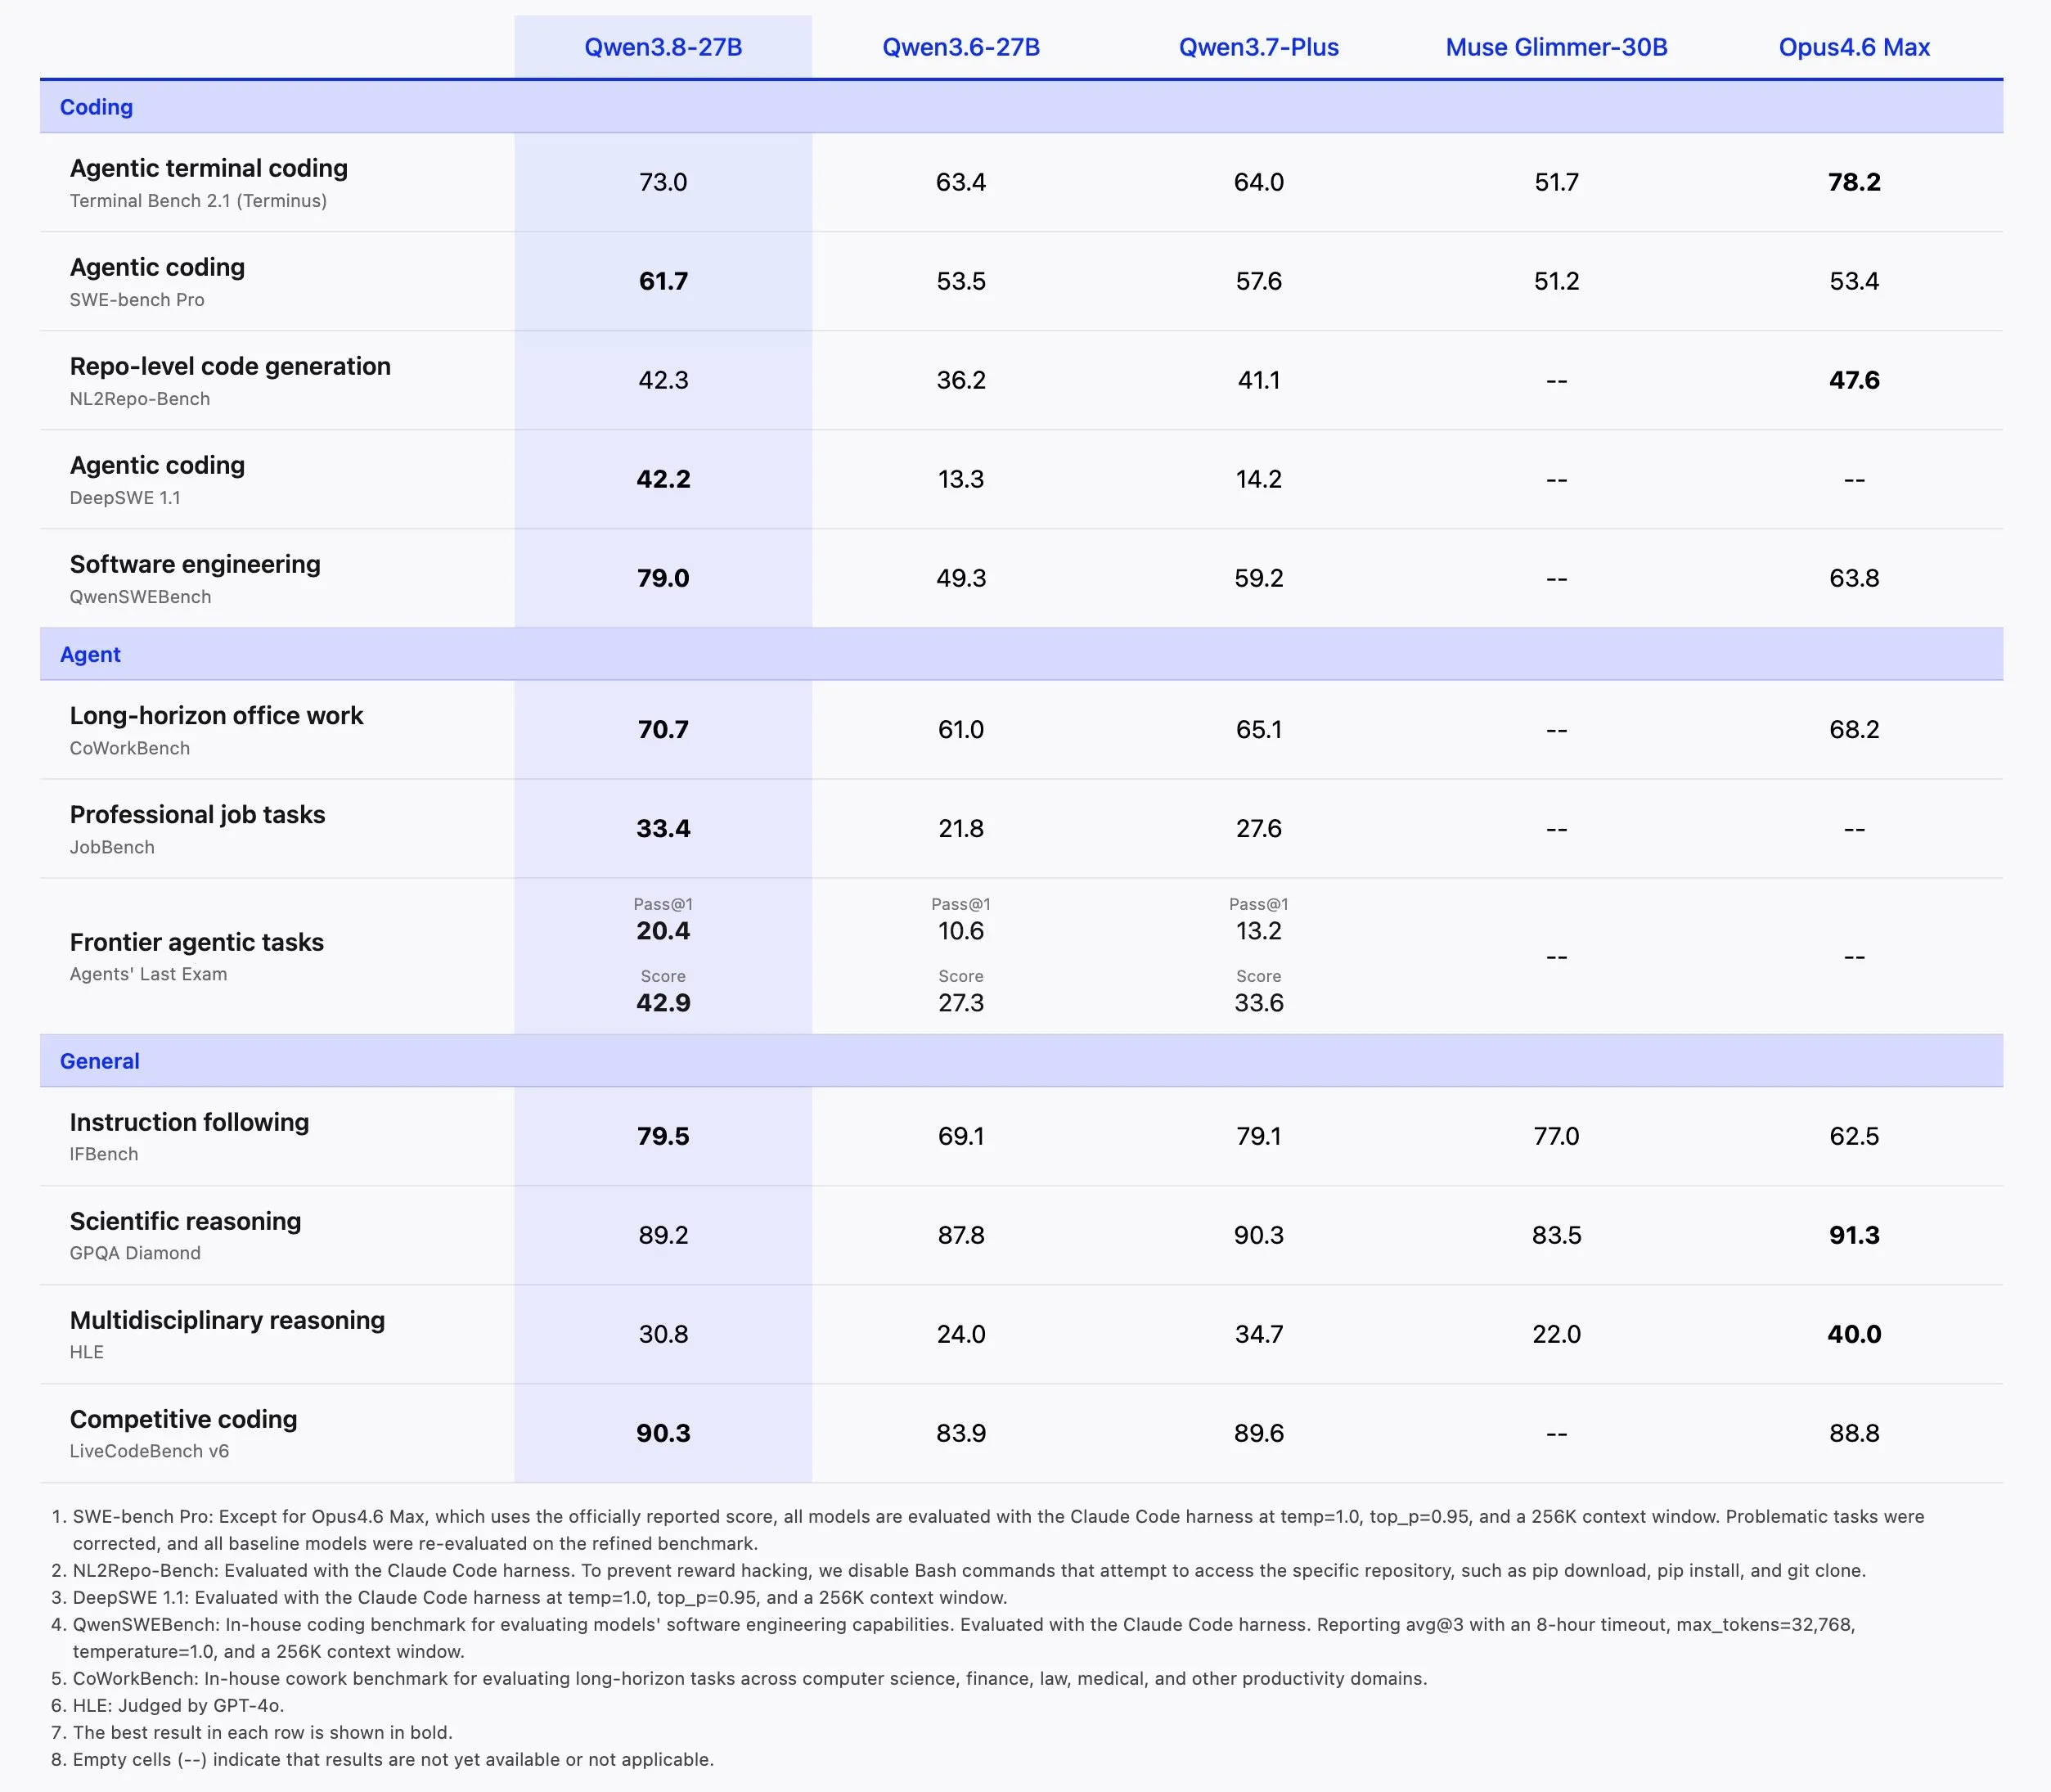
Ainda não tive muito tempo para testá-lo (por que os laboratórios começaram a lançar modelos às sextas-feiras?), mas a impressão inicial parece ser a de um salto razoavelmente bom nas capacidades agênticas. Porém, os limites disso ainda precisam ser explorados, por exemplo, se ele pode substituir o DeepSeek V4 Flash como um subagente capaz.
Um ponto importante é que ele tem modos de raciocínio variáveis (de low a xhigh), de forma semelhante à maioria dos outros modelos modernos de raciocínio. Na configuração xhigh, ele usa substancialmente mais tokens do que seu antecessor, então tenha cuidado com isso.
Se você executa modelos locais, provavelmente já está usando Qwen, e esta parece ser uma atualização segura.
Encerramento
Espero que você tenha gostado das notícias desta semana. Se quiser receber as notícias toda semana, entre na nossa lista de emails abaixo.