注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新模型发布
DeepSeek V4 Pro
几周前,DeepSeek 发布了 V4 Flash 模型的更新版本。相比前代,新版的后训练有了大幅改进,使其成为日常大语言模型任务中性价比最高的选择之一。
这次 DeepSeek V4 Pro 更新的目标,是与 GPT 5.6 和 Fable 一同争夺顶尖模型的位置,而不只是当个性价比之王。
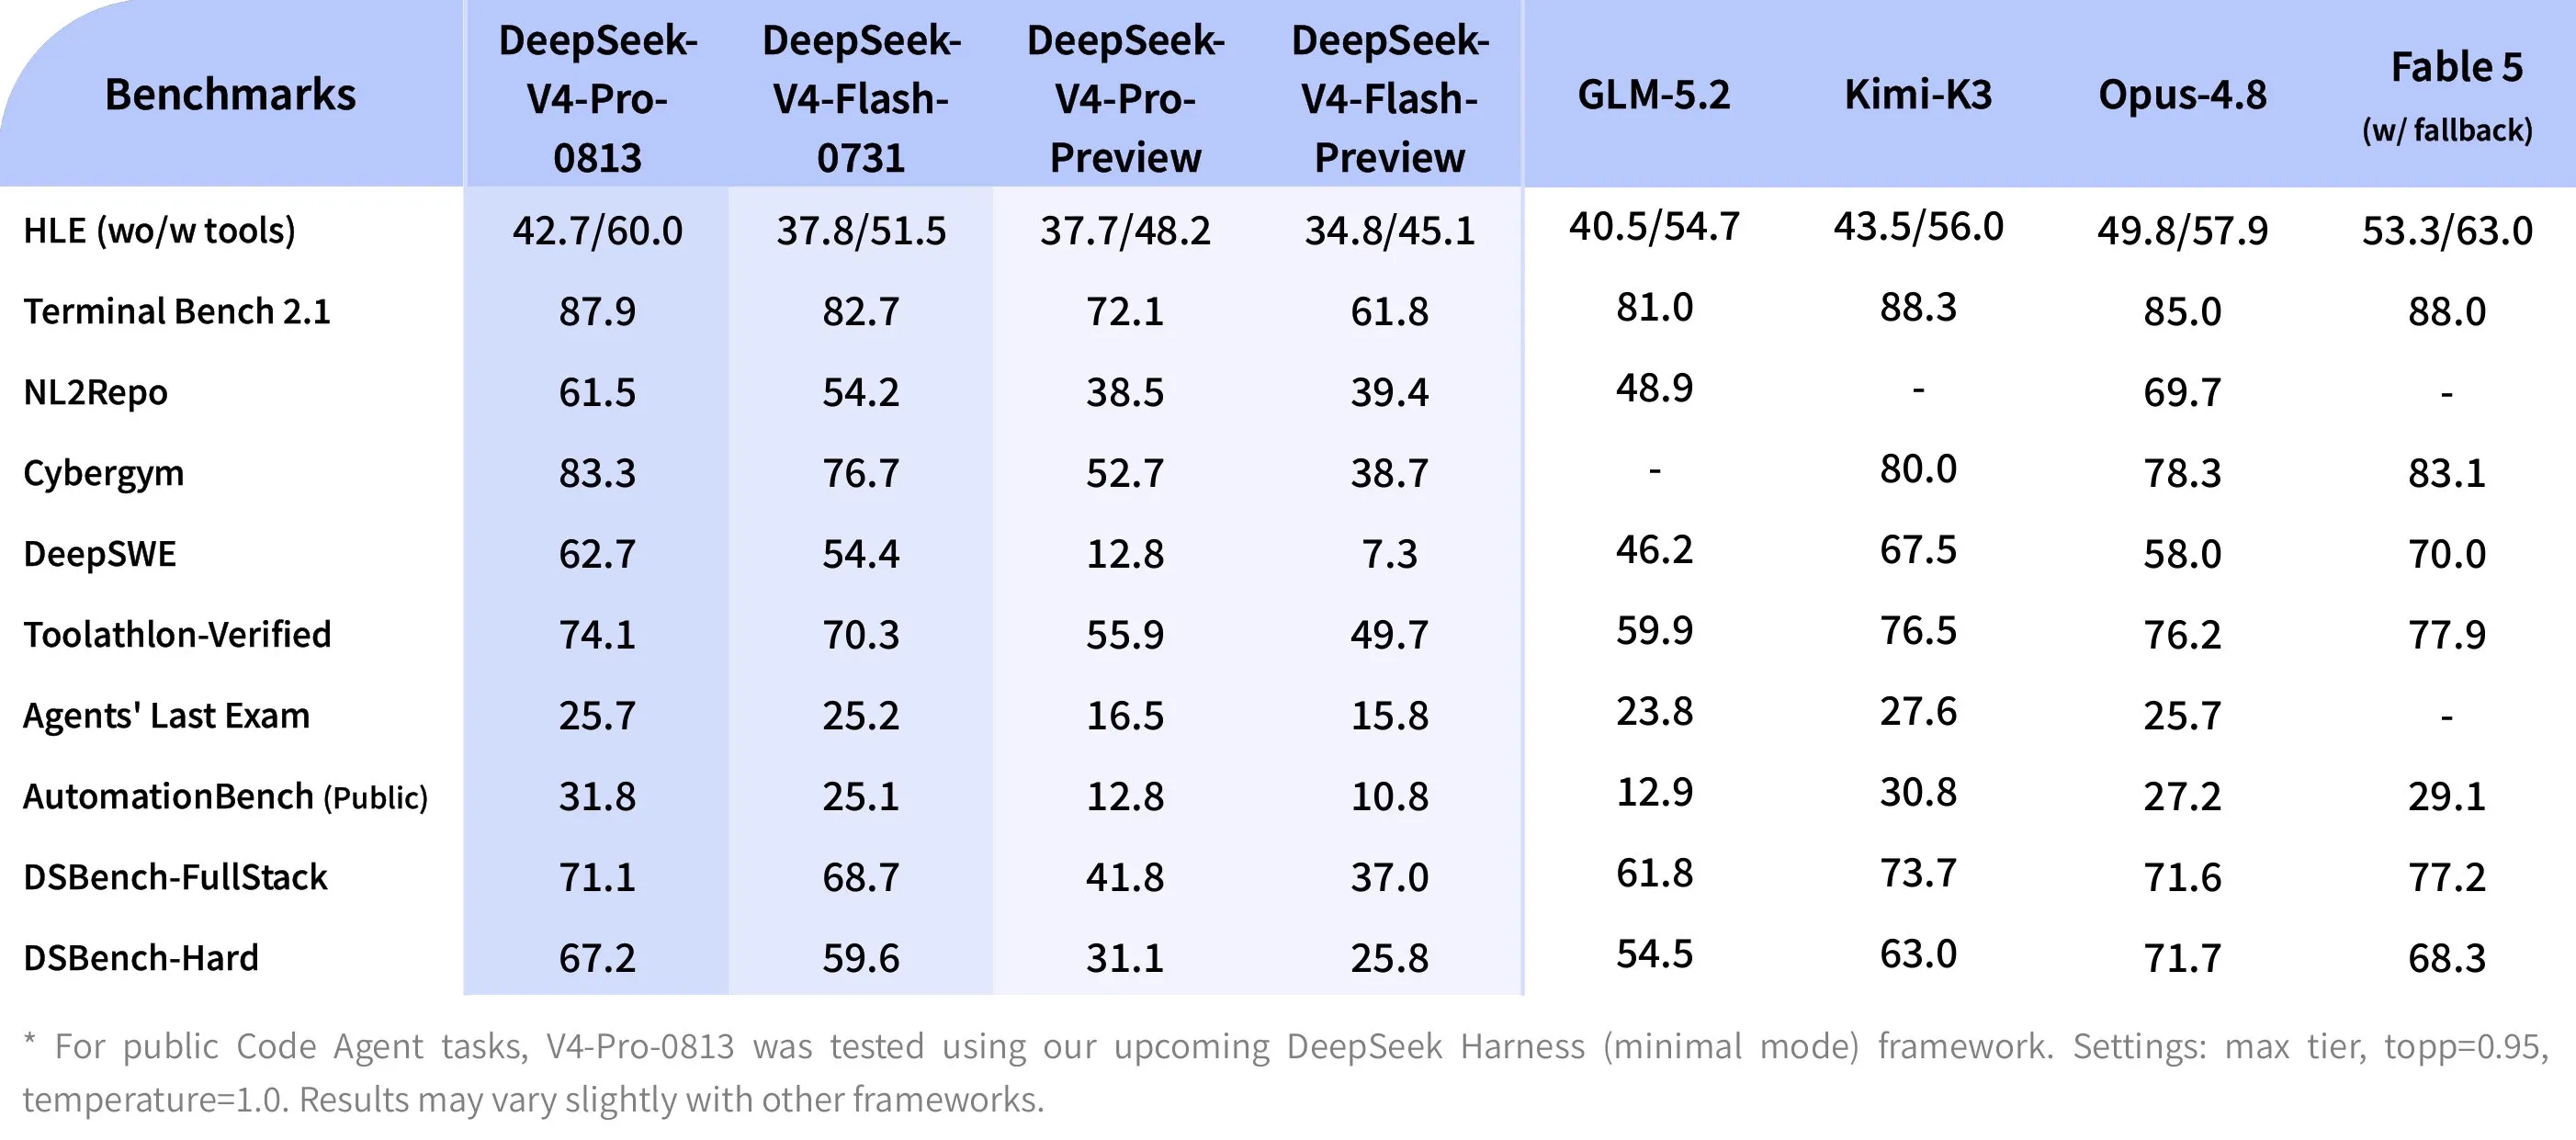
V4 Flash 在那么小的模型里塞进了令人印象深刻的智能水平,相比之下,V4 Pro 就有些令人失望了。 在 Artificial Analysis 上,它的得分仅略高于 Flash,价格却约为后者的 2.5 倍。 和 Flash 一样,它不支持多模态,连模型自己都对此不太满意。
在实际使用中,它似乎更擅长为耗时较长的智能体任务做规划,但实际编程表现并没有太大差别。
另一个拖后腿的因素是他们正在实施的涨价(Flash 的价格约为此前的 3 倍,Pro 则约为 4 倍)。 考虑到 DeepSeek 模型平均会使用更多 token,它们的实际使用成本已经与 GPT 5.6 Luna 和 Terra 正面撞上了。
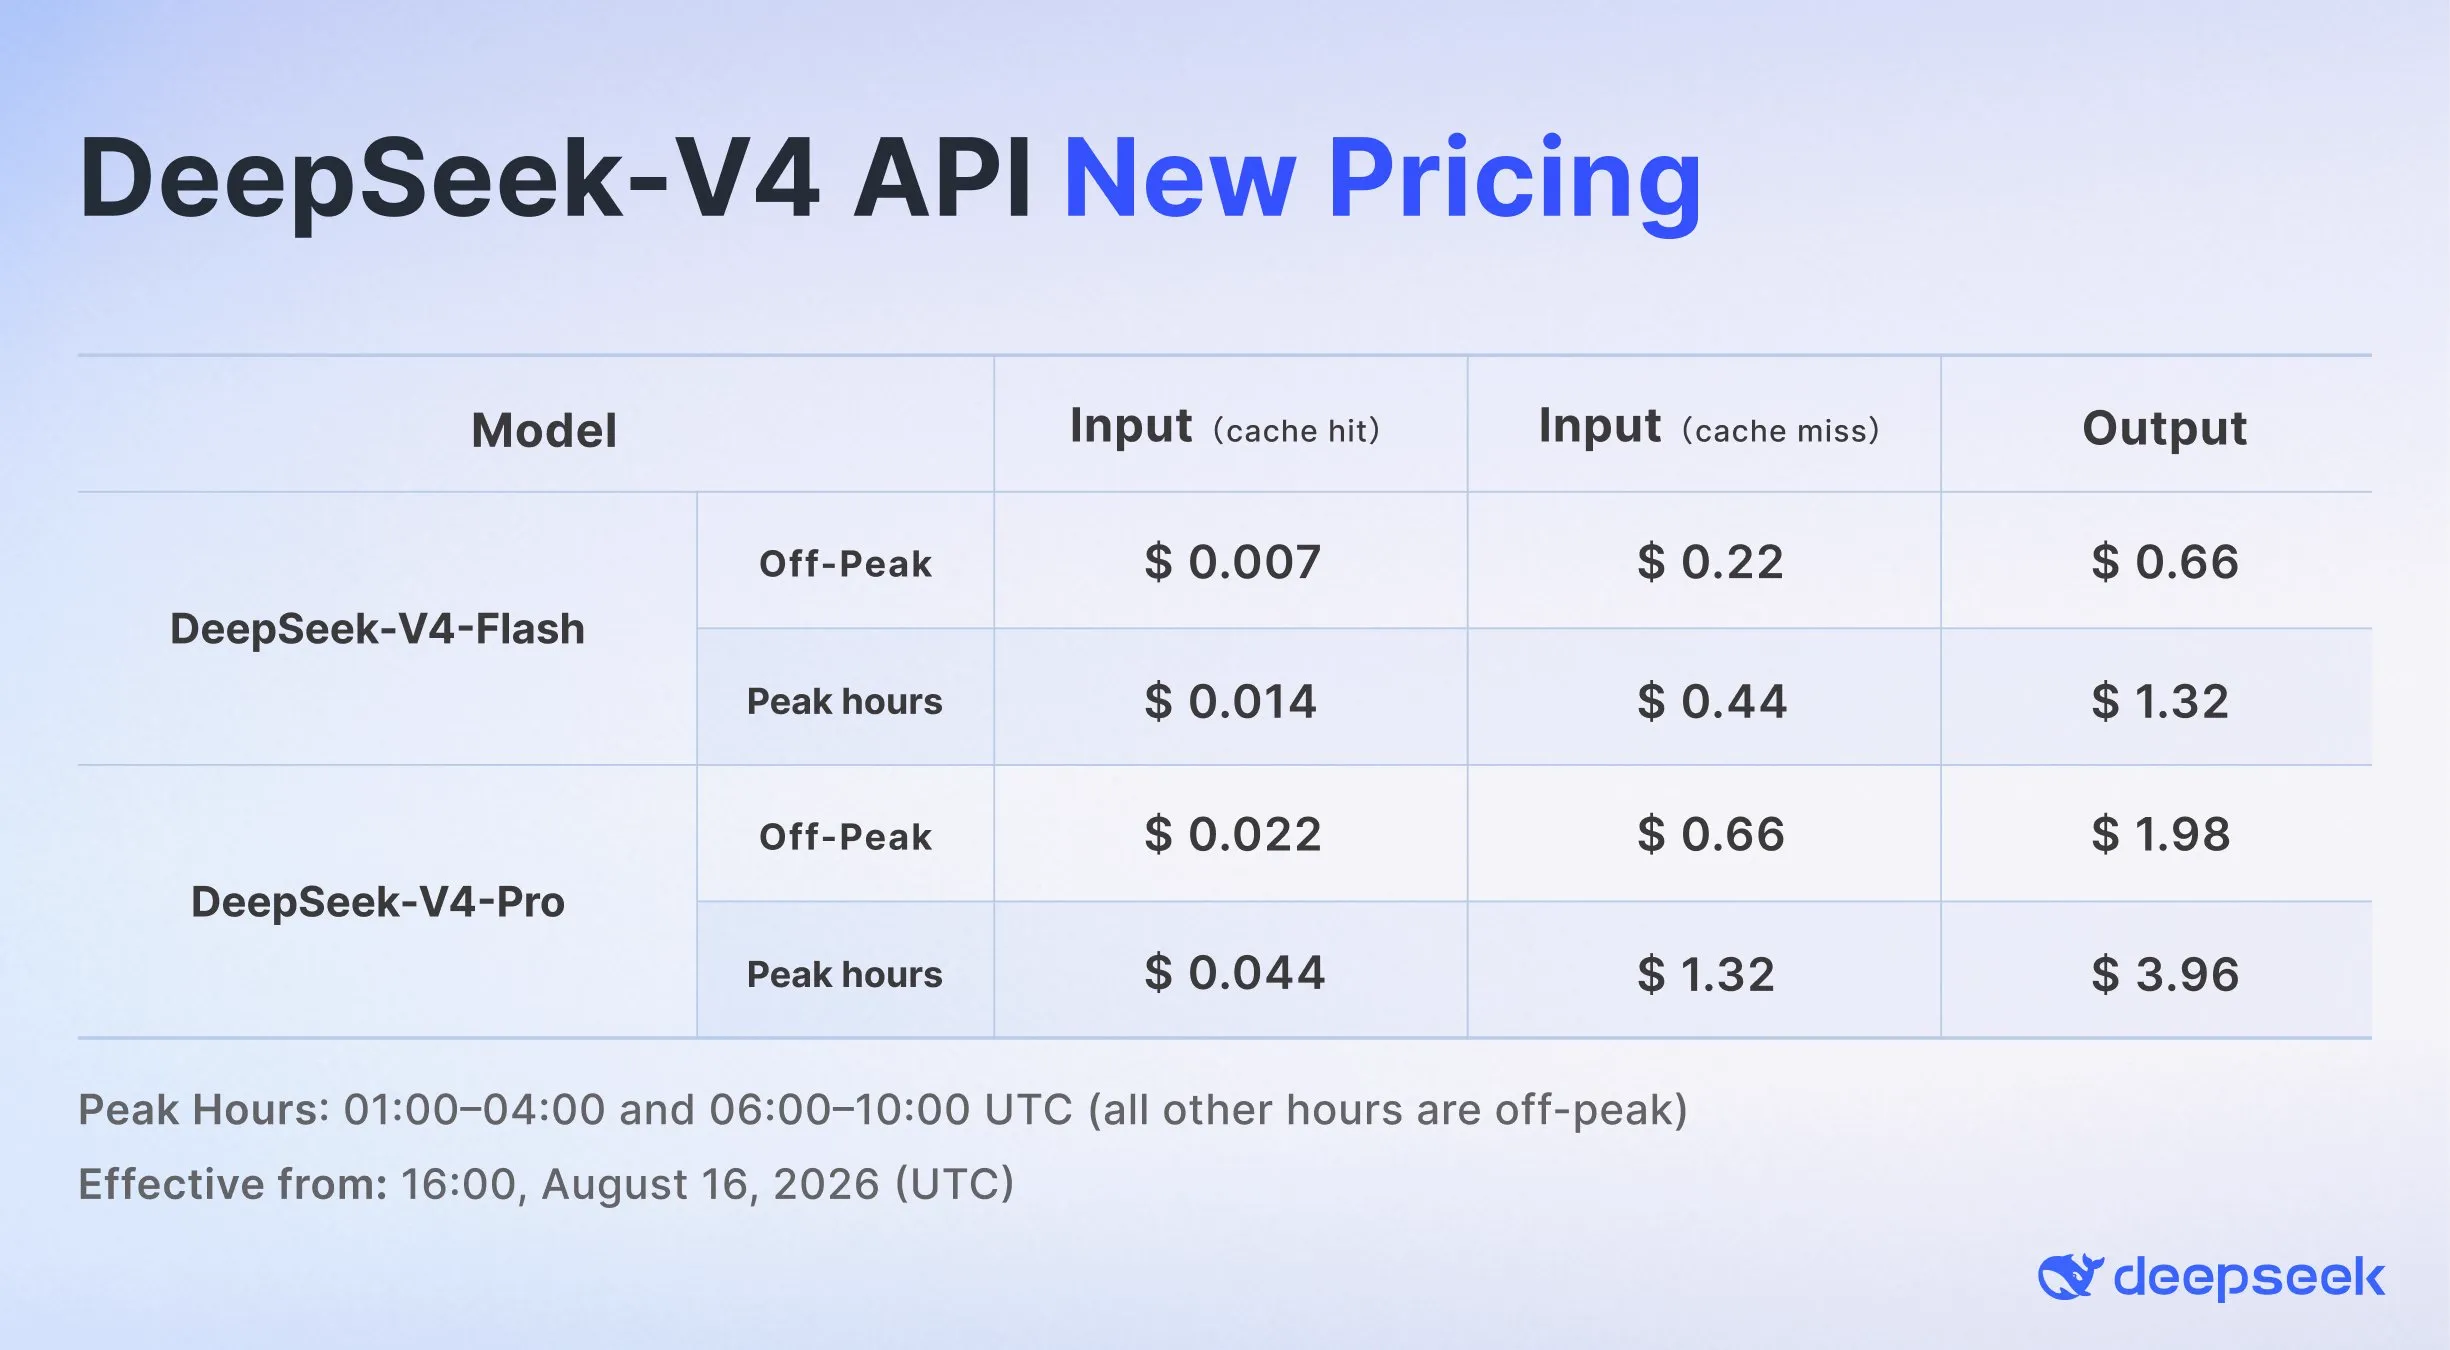
| 模型 | 每百万输入 token 价格(美元) | 每百万输出 token 价格(美元) | 每秒 token 数 |
|---|---|---|---|
| DeepSeek V4 Pro | $1.32 | $3.96 | 55 |
| DeepSeek V4 Flash | $0.44 | $1.32 | 82 |
| Grok 4.6 | $2 | $6 | 57 |
| Claude Fable 5 | $10 | $50 | 40 |
| Claude Opus 4.8 | $5 | $25 | 60 |
| GPT 5.6 Sol | $5 | $30 | 45 |
| GPT 5.6 Terra | $2.50 | $15 | 63 |
| GPT 5.6 Luna | $1 | $6 | 84 |
| Kimi K3 | $3 | $15 | 27 |
| GLM 5.2 | $1.40 | $4.40 | 47 |
不过,这里面也有值得乐观的地方。 Flash 很可能是从 Pro 的早期版本蒸馏而来的,而它的表现能与 Pro 大致持平,说明 DeepSeek 在将模型蒸馏成更小规模这件事上,可能是全球最强的。这也是这次发布显得如此平淡的部分原因。
如果这种趋势能长期持续下去,就意味着 DeepSeek 能够把前沿水平的智能压缩到更小、更便宜的模型中,让我们不仅能用上,甚至有机会自己在家运行。
目前我会跳过 V4 Pro。如果你需要便宜的模型,可以看看 V4 Flash;但 Pro 卡在了一个尴尬的中间位置,既不是最便宜的,也不是最聪明的,我很难推荐它。
Grok 4.6
Grok 在“也就那样”的模型行列里待了很久,如今似乎终于凭借 4.6 版本打出了名堂。
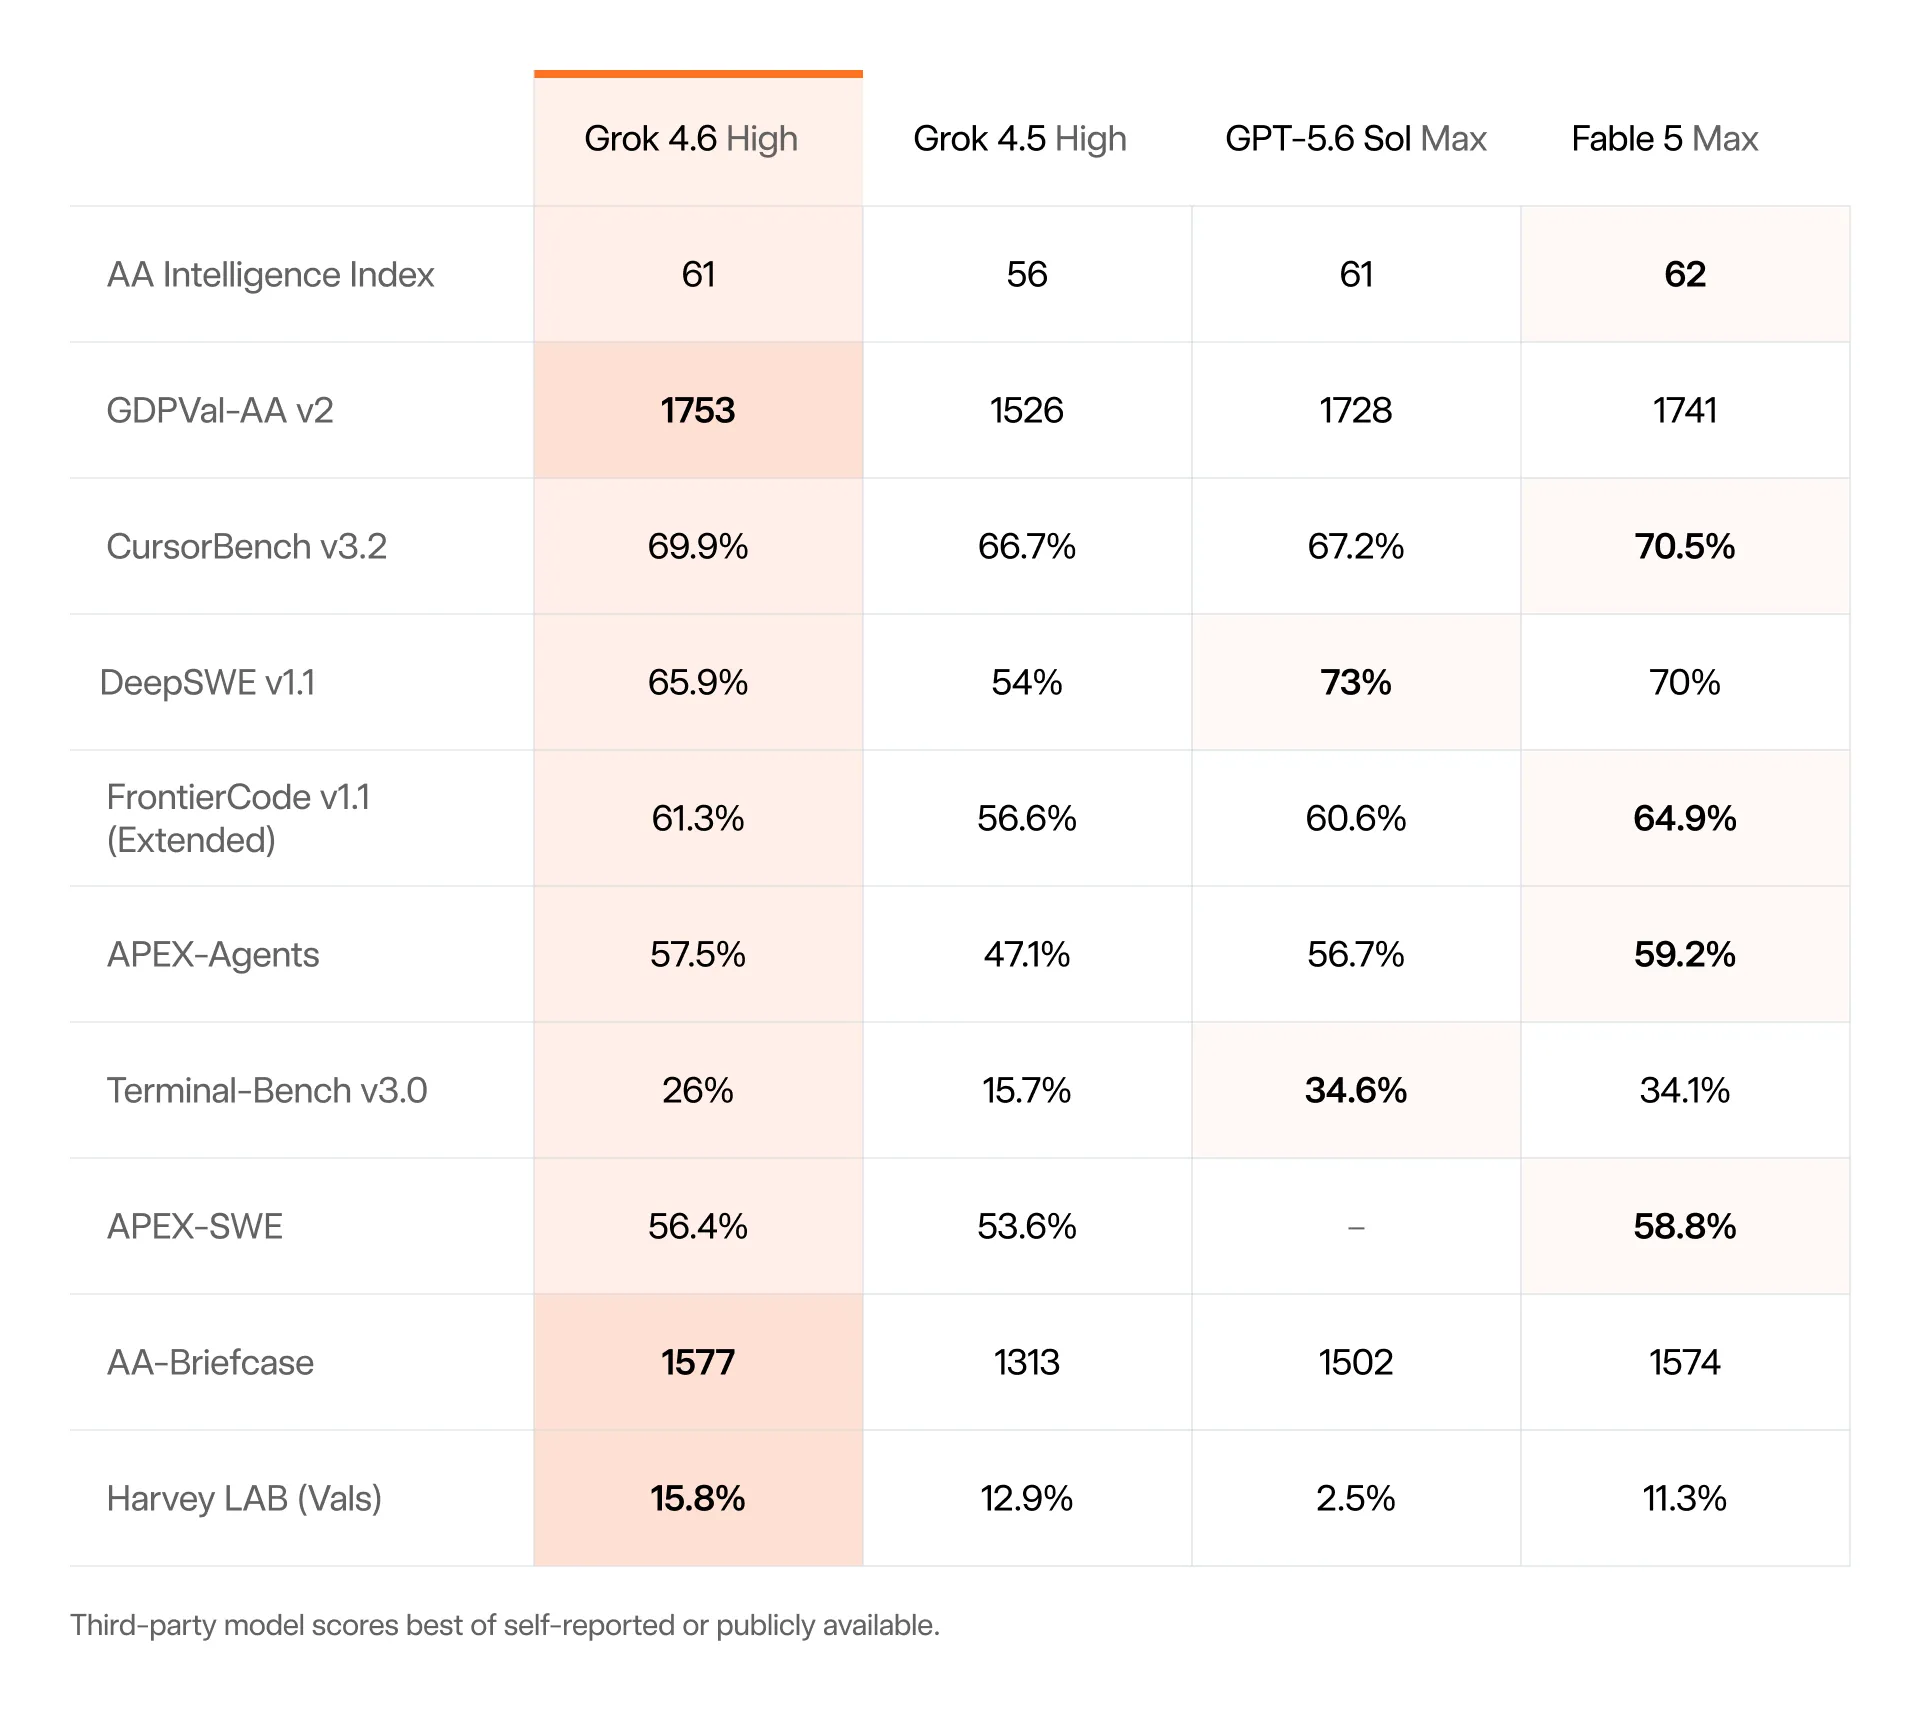
就我目前看到的表现而言,在日常编程任务上,它似乎能与 GPT 5.6 Sol 和 Fable 打个平手。初步体验也让人觉得,它超过了大多数中国模型,大概在 Kimi K3 的水平,甚至更好。 在大规模任务和纯推理能力上,它仍然落后于前沿模型,因此还不能完全替代 GPT 5.6 和 Fable,不过对大多数人来说,这可能不是什么问题。
与它的前代类似,很多人都提到,相比竞争对手,这个模型用起来响应很利落,尤其是在使用“low”推理设置时。
SpaceXAI 团队目前的迭代速度也相当惊人。 Grok 4.5 一个月前才刚发布,他们就已经宣布,Grok 4.7 将在一个月后推出。 即使放在如今飞速发展的 AI 行业里,这个节奏也算很快了,毕竟其他大多数实验室发布新模型的间隔都在 2 至 3 个月。
Grok 4.6 目前还算不上非用不可的模型,但如果有机会,我建议你试试看它在自己的任务中表现如何,也可以期待他们在不久的将来带来更多进展。
快讯
Qwen 3.8 27B
对于想在本地消费级硬件上运行大语言模型的人来说,Qwen 3.6 系列一直是首选,而最新的 Qwen 3.8 模型延续了这一优势。
27B 版本是一款多模态稠密模型,这意味着你大概需要一块独立显卡来运行它(Mac 用户,抱歉了,不过据传混合专家版本也快要发布了)。
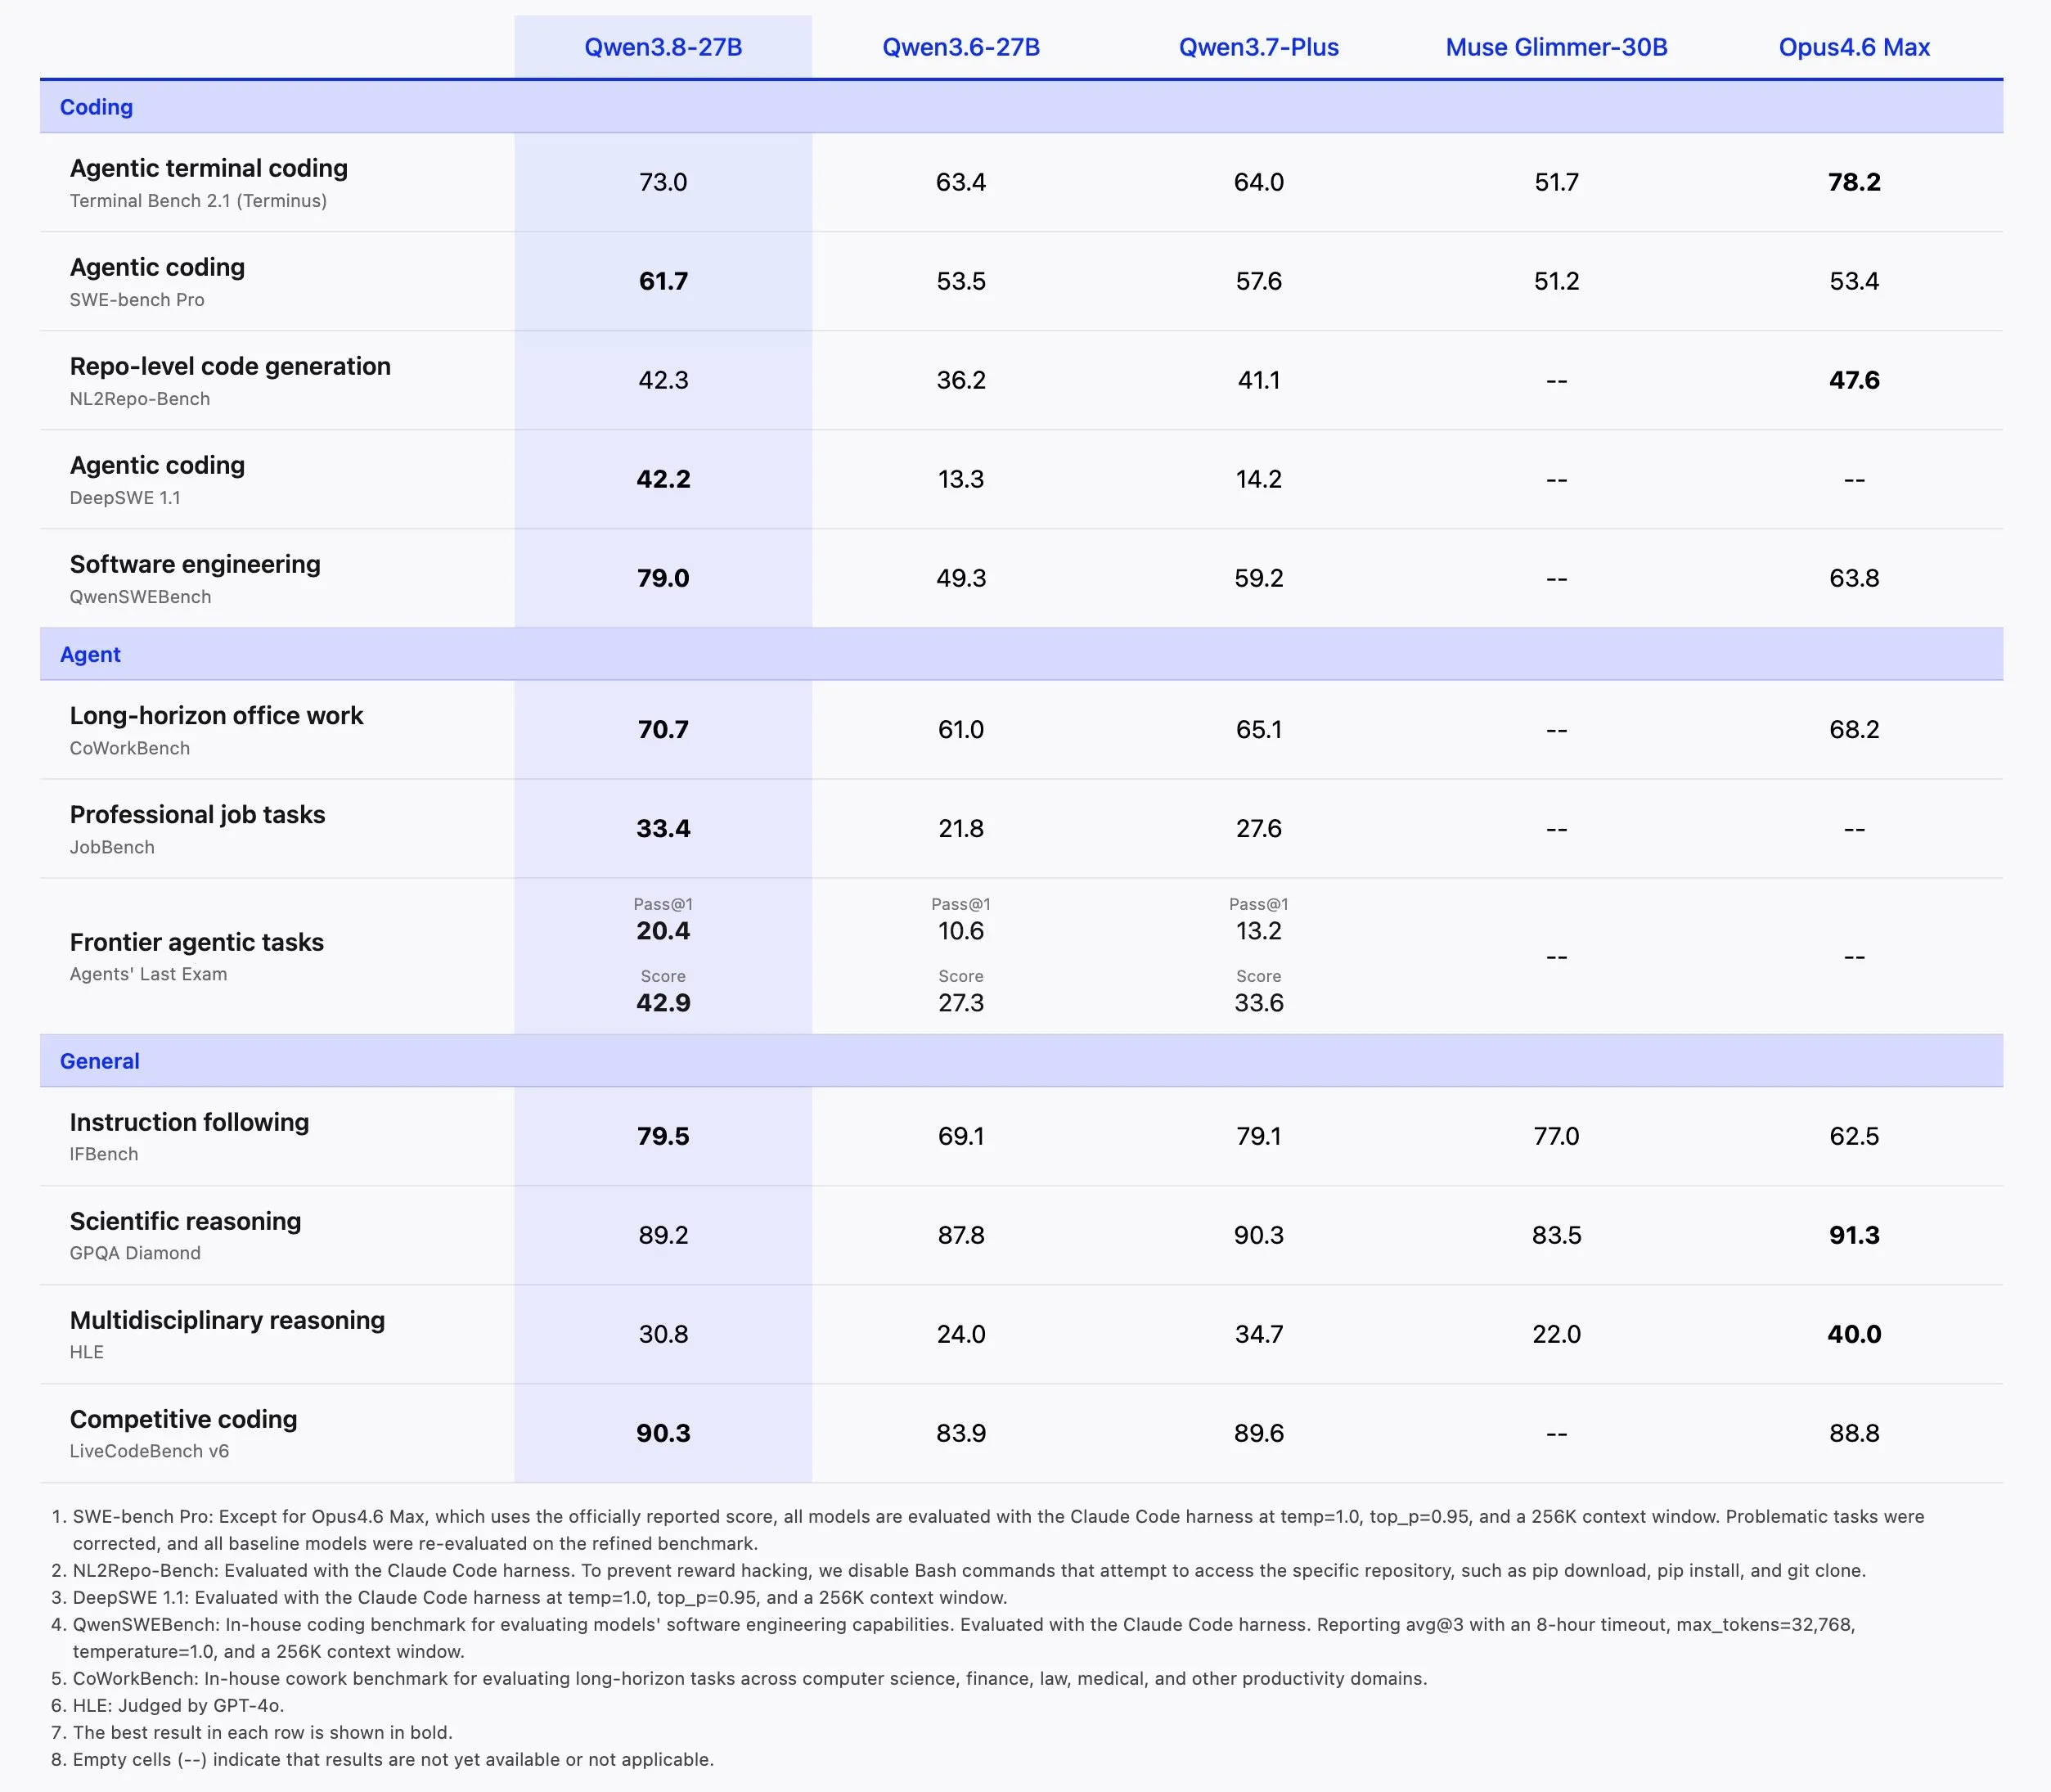
我还没来得及充分测试它(各家实验室怎么都开始在周五发模型了?),不过初步感觉是,它的智能体能力有了相当不错的提升。至于能力上限,目前还没有摸清,比如它能否取代 DeepSeek V4 Flash,成为一个能干的子智能体。
值得一提的是,和其他大多数现代推理模型一样,它也支持不同的推理强度设置(从 low 到 xhigh)。 在 xhigh 设置下,它使用的 token 比前代多得多,这一点要留意。
如果你在运行本地模型,那你很可能已经在用 Qwen 了,而这次看起来是个稳妥的升级选择。
结语
希望你喜欢本周的新闻。如果想每周都收到新闻,记得在下方订阅我们的邮件列表。