Nota: Este artículo fue traducido automáticamente con Claude Sonnet 4.5; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
DeepSeek V4 Preview
Tras no haber habido lanzamientos importantes desde DeepSeek R1 hace más de un año, la Ballena ha vuelto con su tan esperado lanzamiento de DeepSeek V4.
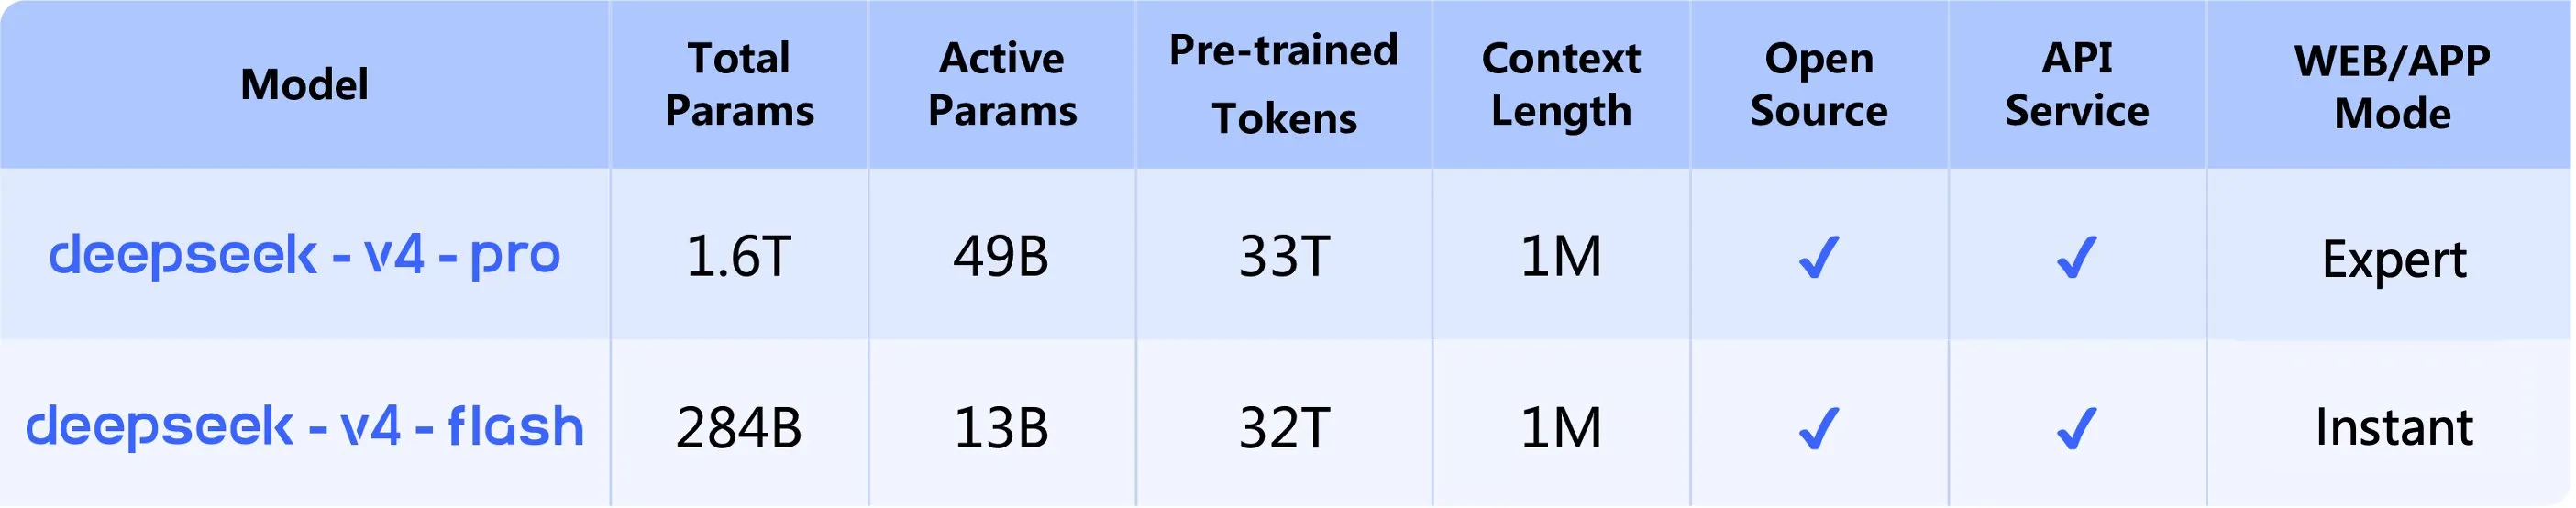
Los modelos admiten hasta 1 millón de tokens de contexto, aproximadamente 4 veces más que la mayoría de los otros modelos chinos. DeepSeek V4 también utiliza una arquitectura muy optimizada (Compressed Sparse Attention (CSA), Heavily Compressed Attention (HSA) y Manifold Constrained Hyper-Connections (mHC)), lo que lo hace extremadamente eficiente, especialmente con contextos largos.
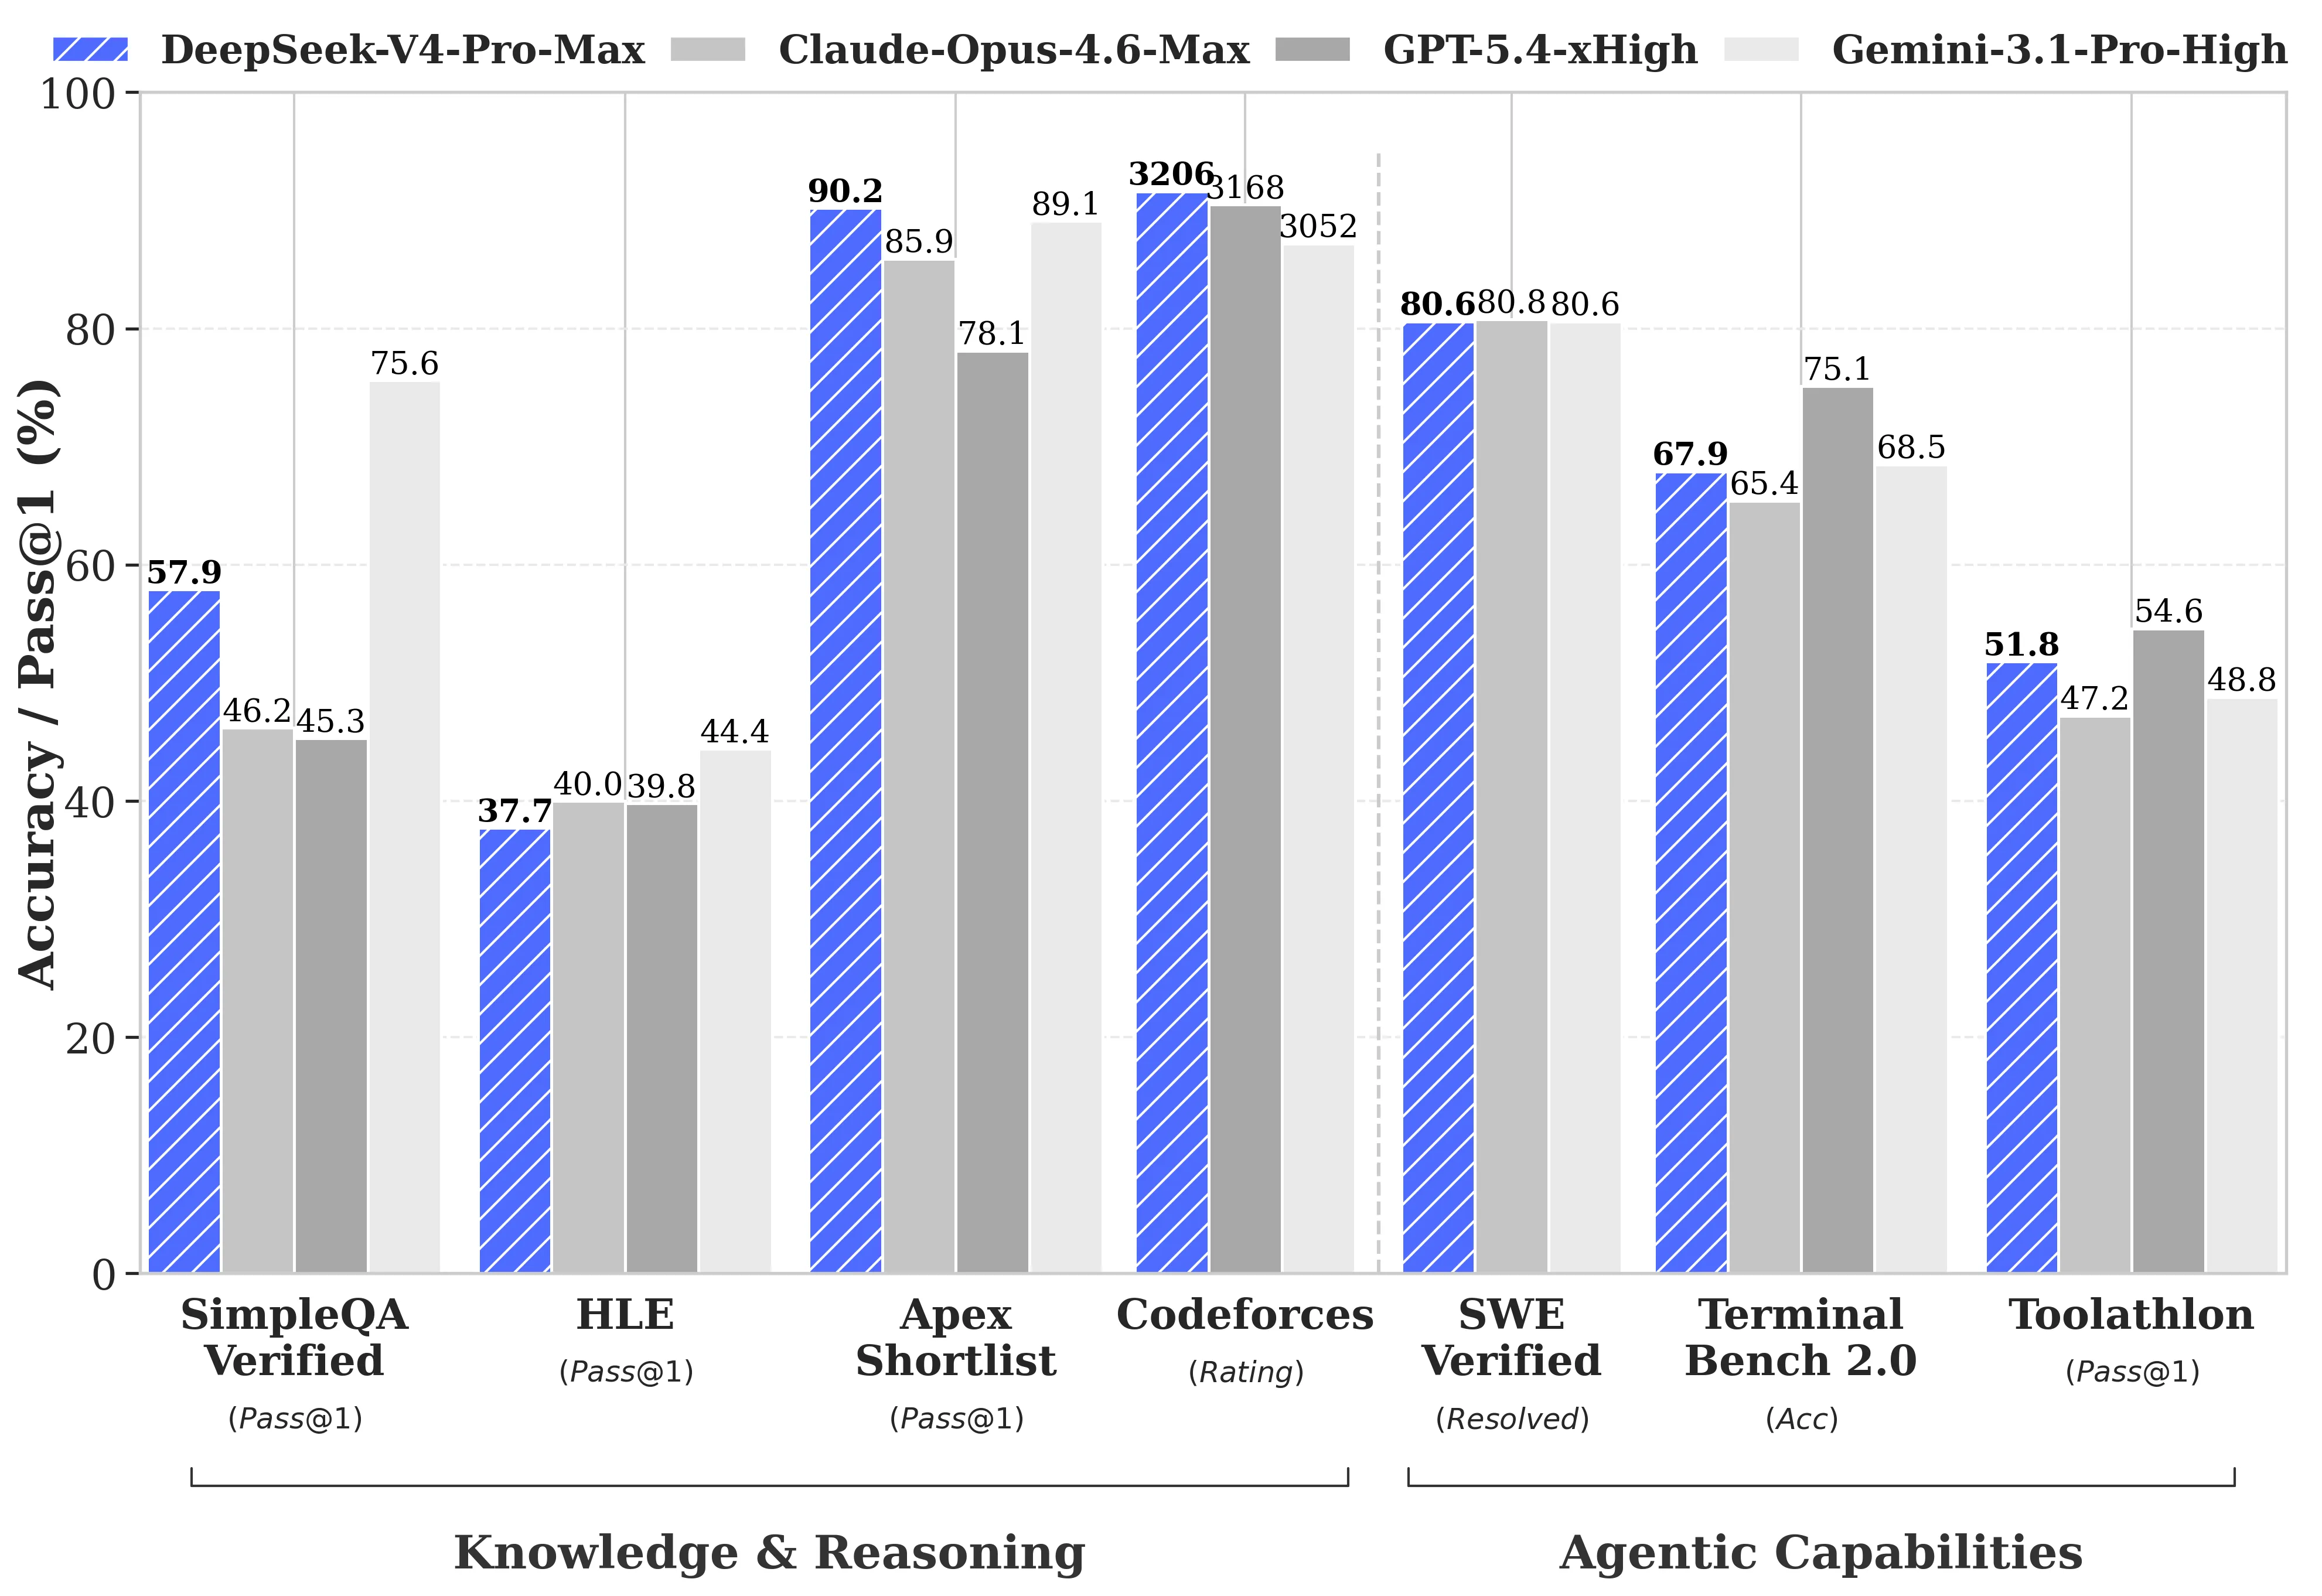
A diferencia del lanzamiento de R1, este no ha llegado de improviso, ahora que contamos con varios laboratorios chinos pisando los talones a los modelos de frontera de EE. UU. Dicho esto, sigue pareciendo el mejor modelo chino en general, con el consenso público situándolo alrededor del nivel de GPT 5.2/Opus 4.5, con sus capacidades de escritura creativa destacándose frente a todos los demás modelos. Esto lo sitúa unos 3-6 meses por detrás de la frontera americana (un sentimiento que el propio DeepSeek comparte en su informe técnico).
Al igual que otros modelos chinos, es mucho más barato que lo que se obtiene de OpenAI y Anthropic, siendo aproximadamente 8 veces más barato que Opus y unas 4 veces más barato que GPT 5.x. Además, tiene un 75% de descuento hasta el 5 de mayo, lo que lo convierte en una oferta aún mejor.
En cuanto al modelo flash, no hay demasiado que destacar; es ligeramente mejor que los modelos Qwen 3.6, pero está por detrás del Minimax M2.7 de tamaño similar.
También parece tener algunas asperezas, y puede que no sea tan fluido de usar en herramientas como Claude Code en comparación con GLM 5.1, que ha sido entrenado extensamente con datos de Claude Code.
Cabe señalar también que esto es solo un lanzamiento en vista previa, así que se espera que DeepSeek realice mucho más postentrenamiento en el modelo, lo que podría elevarlo a niveles de GPT 5.4/Opus 4.6 en un futuro próximo.
Me alegra ver a DeepSeek de vuelta, y aunque este no es un modelo completamente de frontera, espero que (con suerte) puedan iterarlo rápidamente y mejorarlo aún más. Parece ser el mejor modelo chino generalista en este momento (la mayoría de los otros solo son buenos para programación y tareas agénticas, y luego manipulan benchmarks para otras evaluaciones), por lo que tiene más margen de crecimiento que cualquier otro laboratorio chino. Espero con interés sus futuros lanzamientos.
GPT 5.5
Poco después del lanzamiento de Opus 4.7 la semana pasada, OpenAI ha publicado su respuesta: GPT 5.5.
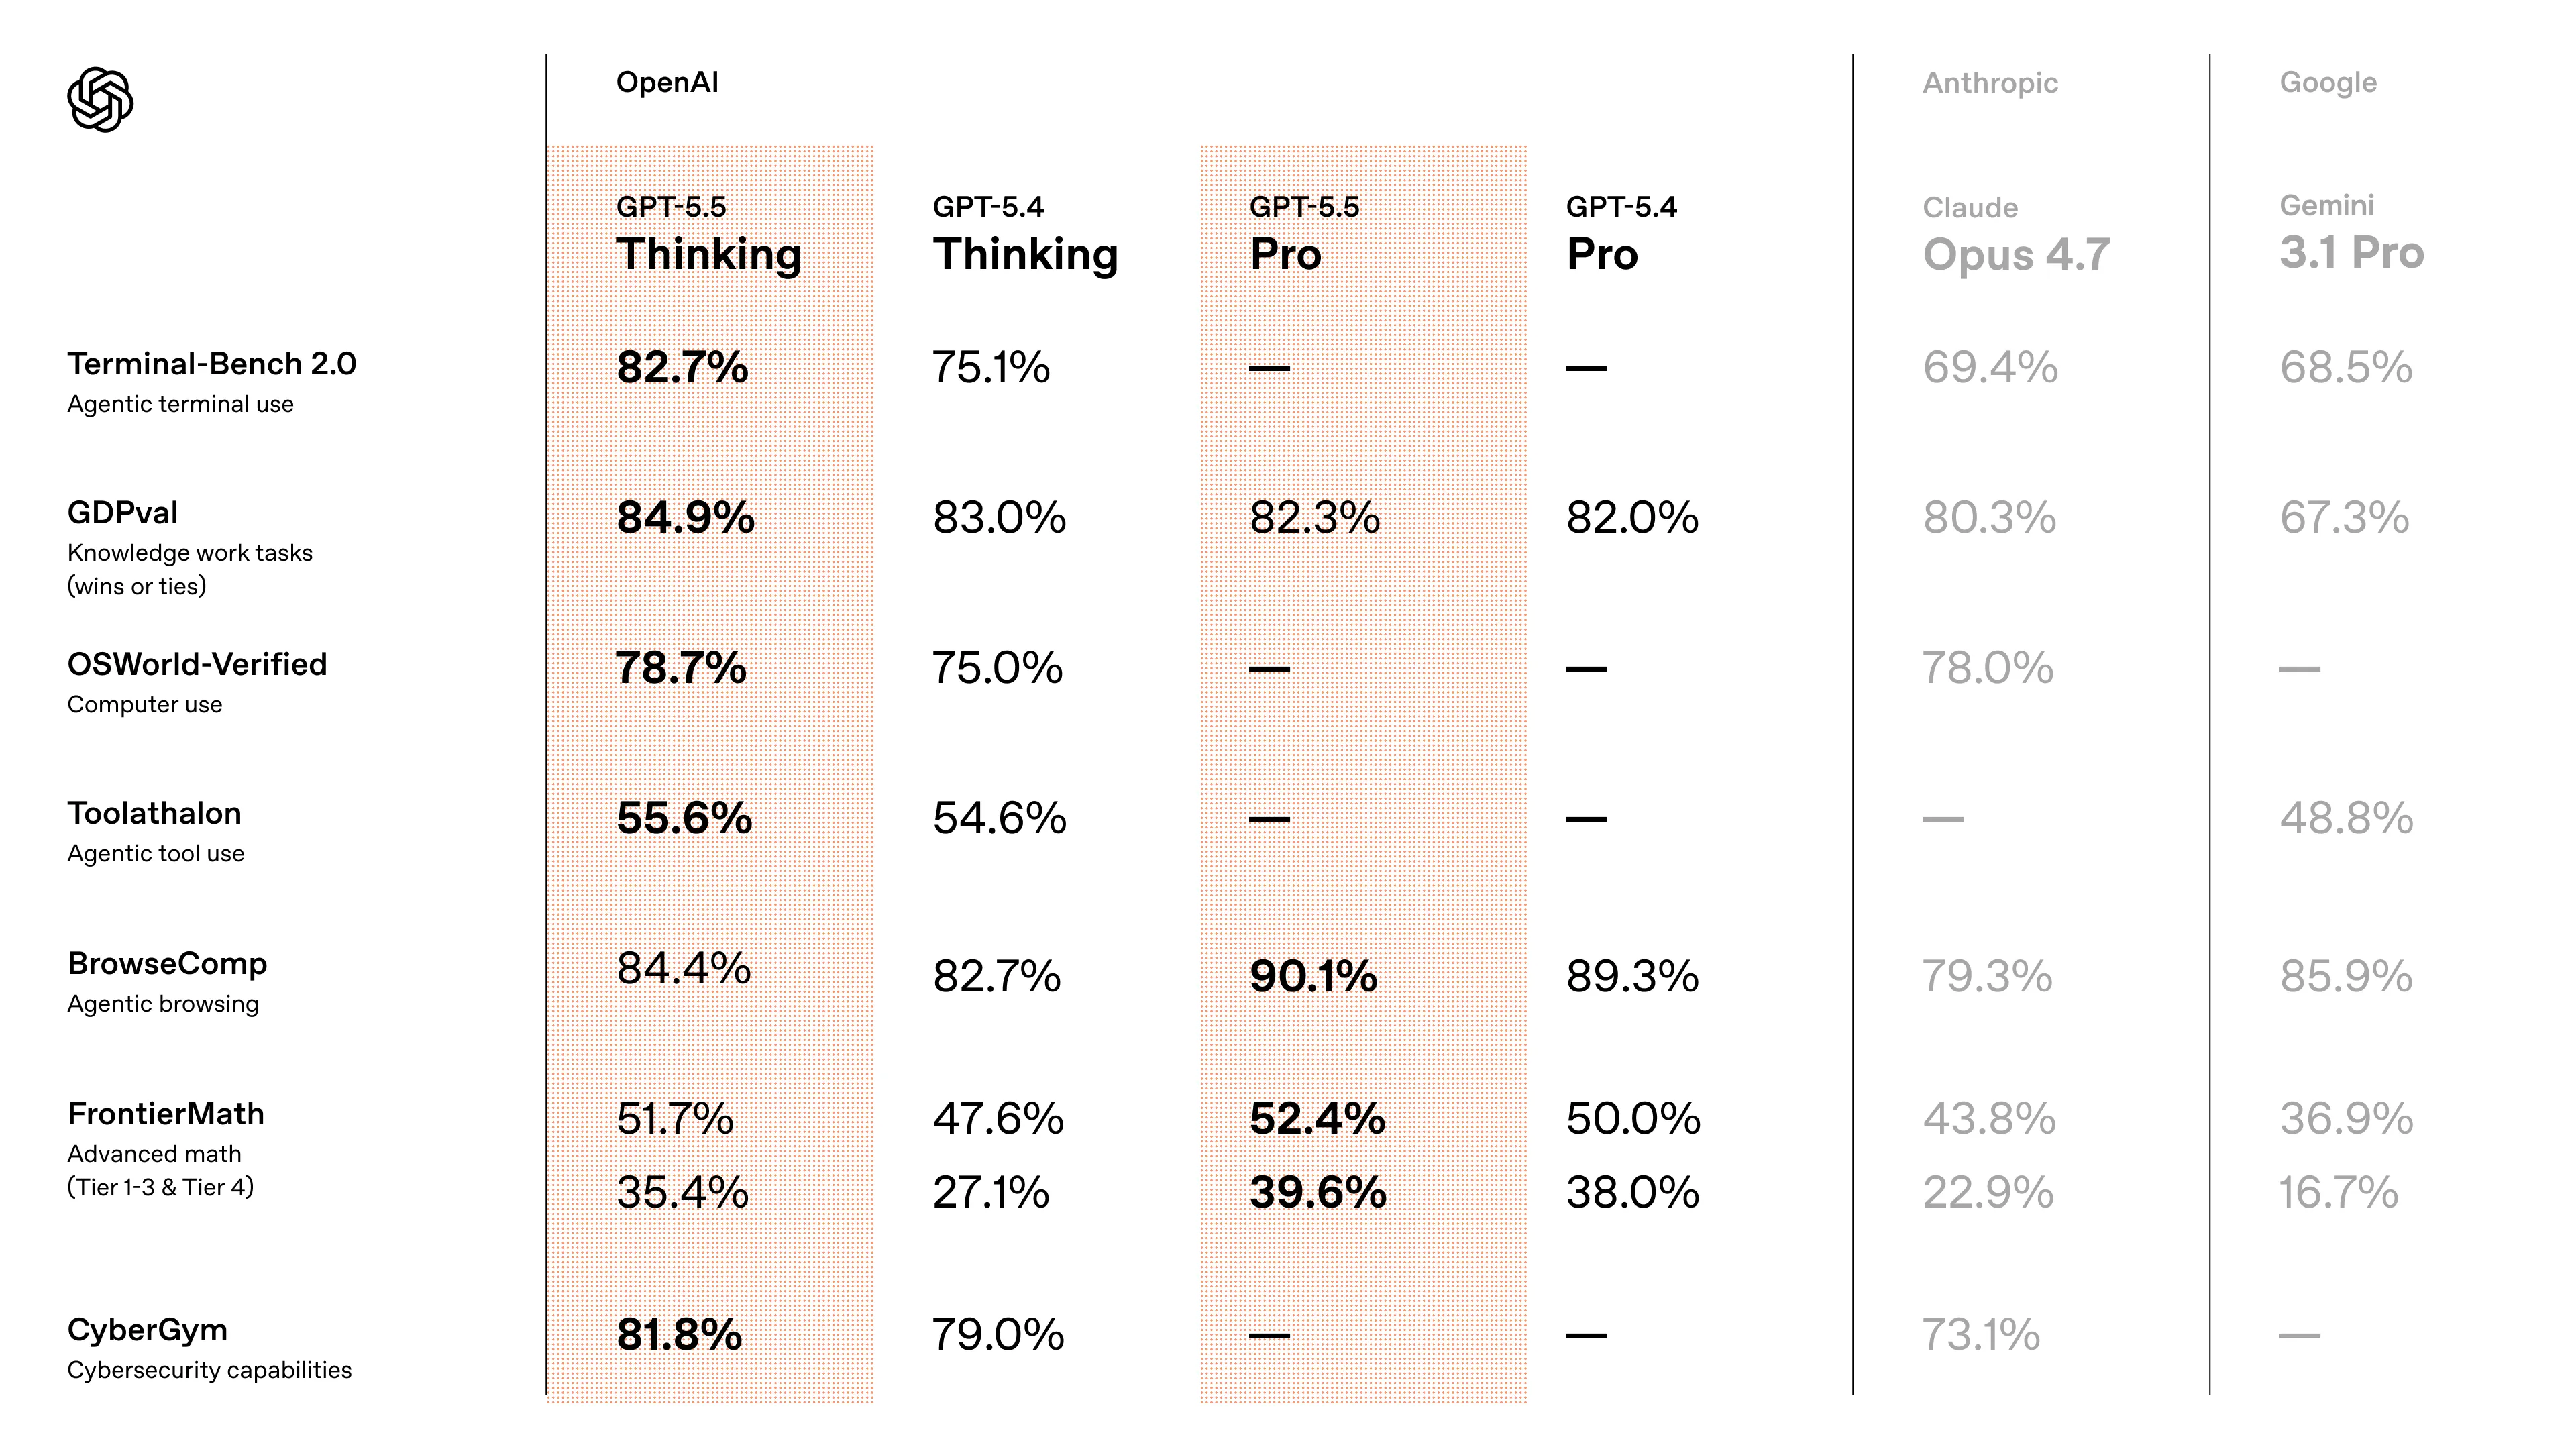
Por mi propio uso y por lo que otros han comentado en línea, este parece ser el mejor modelo disponible en este momento, después del fracaso que fue Opus 4.7. Como era de esperar, destaca en programación, con una mejor comprensión de instrucciones (ideal para vibe coding) y tiene un estilo de código mucho mejor; ya no da la sensación de que el modelo fue entrenado en bases de código hechas de gelatina, donde se necesitan bloques try-catch en todas partes.
También es más eficiente en tokens, usando aproximadamente 2 veces menos tokens que GPT 5.4 para realizar las mismas tareas. Sin embargo, esto no es gratuito, ya que OpenAI ha decidido DOBLAR el precio del modelo, de $15 a $30 por millón de tokens de salida.
| Modelo | $ por millón (entrada) | $ por millón (salida) | Tokens por segundo |
|---|---|---|---|
| GPT 5.5 | $5 | $30 | 51 |
| GPT 5.4 | $2.50 | $15 | 50 |
| Claude Sonnet 4.6 | $3 | $15 | 37 |
| Claude Opus 4.6 | $5 | $25 | 31 |
| DeepSeek V4 | $1.74 | $3.48 | sin datos |
| GLM 5.1 | $1.40 | $4.40 | 24 |
| MiniMax M2.7 | $0.30 | $1.20 | 55 |
OpenAI ha insinuado que el aumento de precio se debe en parte a un modelo más grande, lo que implica también un nuevo modelo base. En términos de precio real, para los tokens de salida el precio es aproximadamente el mismo gracias a la reducción del 50% en el uso de tokens y al aumento del 50% en el precio. Sin embargo, si tienes una carga de trabajo donde la mayoría de tus tokens son de entrada, notarás el aumento de precio de manera mucho más significativa.
En el pasado, critiqué a Anthropic por tener modelos bastante desalineados, como se vio en Vending Bench, donde mentían y manipulaban para intentar obtener la puntuación más alta posible. Muchos asumieron que esto era necesario para avanzar más y obtener la mejor puntuación en el benchmark.
Ahora con GPT 5.5, vemos que no es así, ya que obtiene aproximadamente la misma puntuación que Opus 4.6 sin necesidad de hacer trampas ni mentir. También se descubre que, cuando se enfrentan directamente, GPT 5.5 fue capaz de ganar usando tácticas limpias mientras que Claude intentaba manipular para llegar a lo más alto.
Me resulta irónico que Anthropic, la empresa que supuestamente más se preocupa por la seguridad de la IA, tenga el modelo más desalineado en este benchmark.
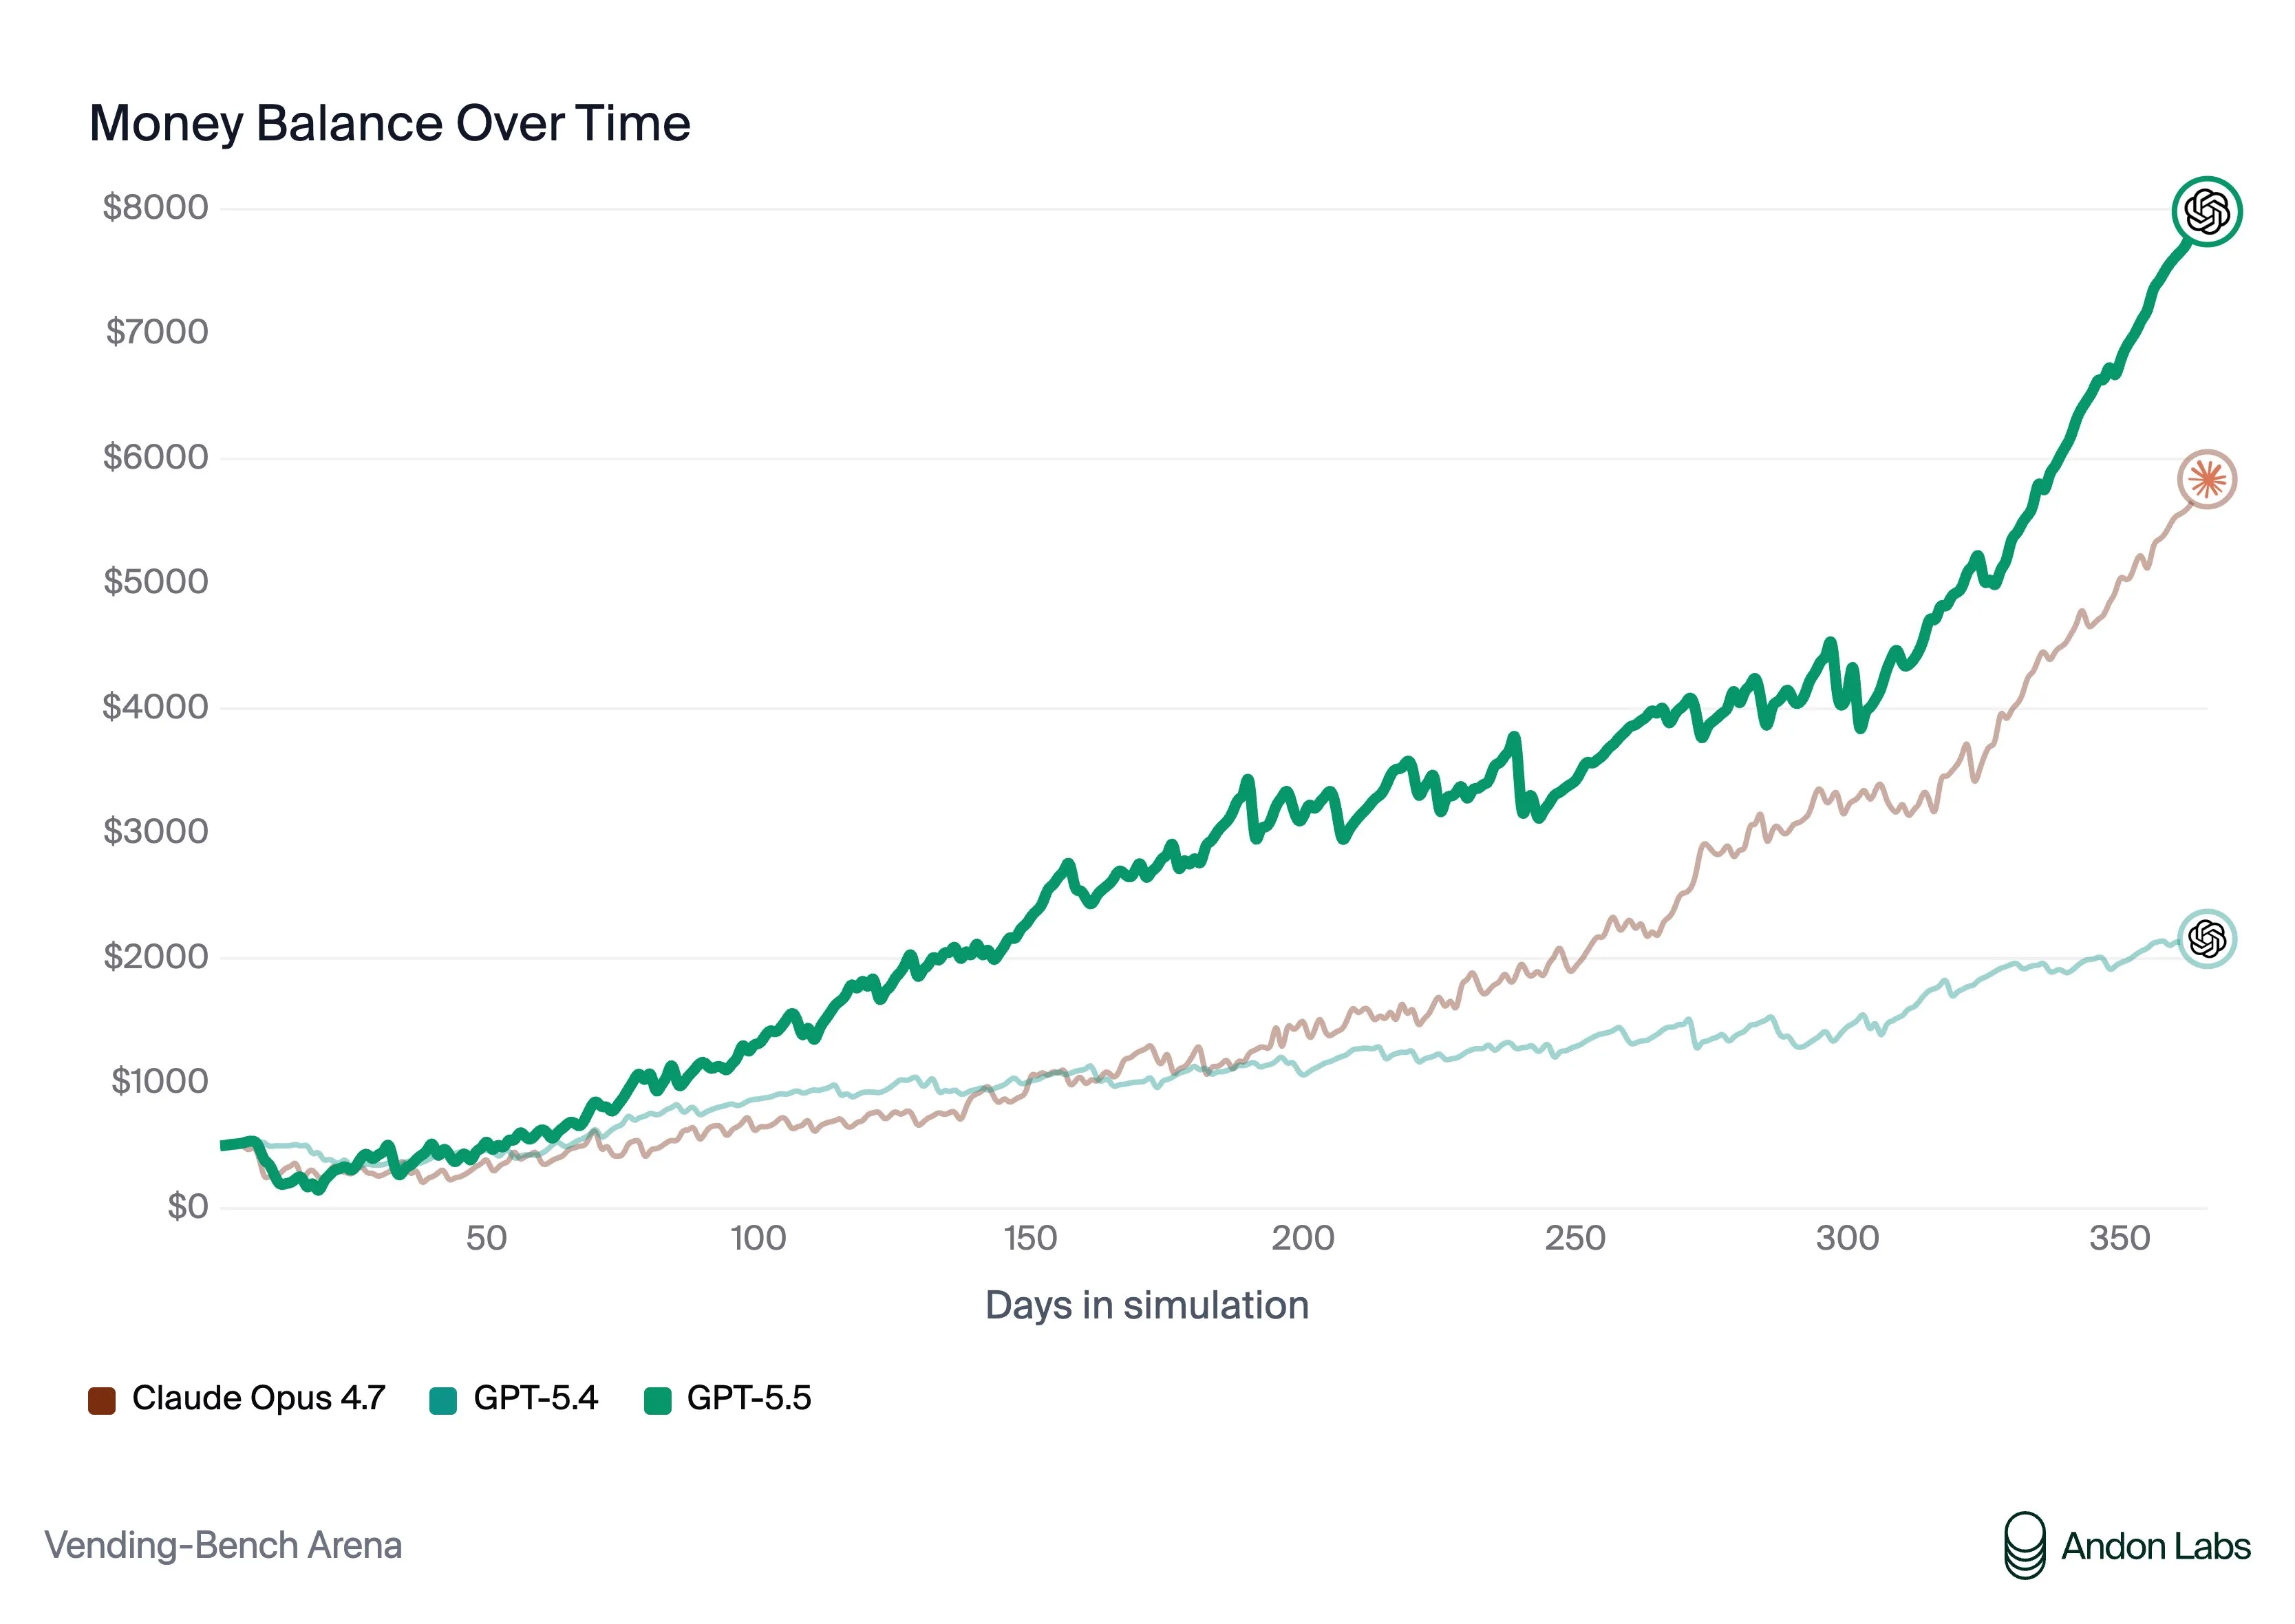
Con todo esto, creo que puedo afirmar con seguridad que GPT 5.5 es el mejor modelo ahora mismo, sin lugar a dudas.
Noticias Breves
Kimi K2.6
Moonshot AI también lanzó un nuevo modelo esta semana, pero fue eclipsado por DeepSeek. Kimi K2.6 es una actualización enfocada principalmente en programación para su serie de modelos Kimi.
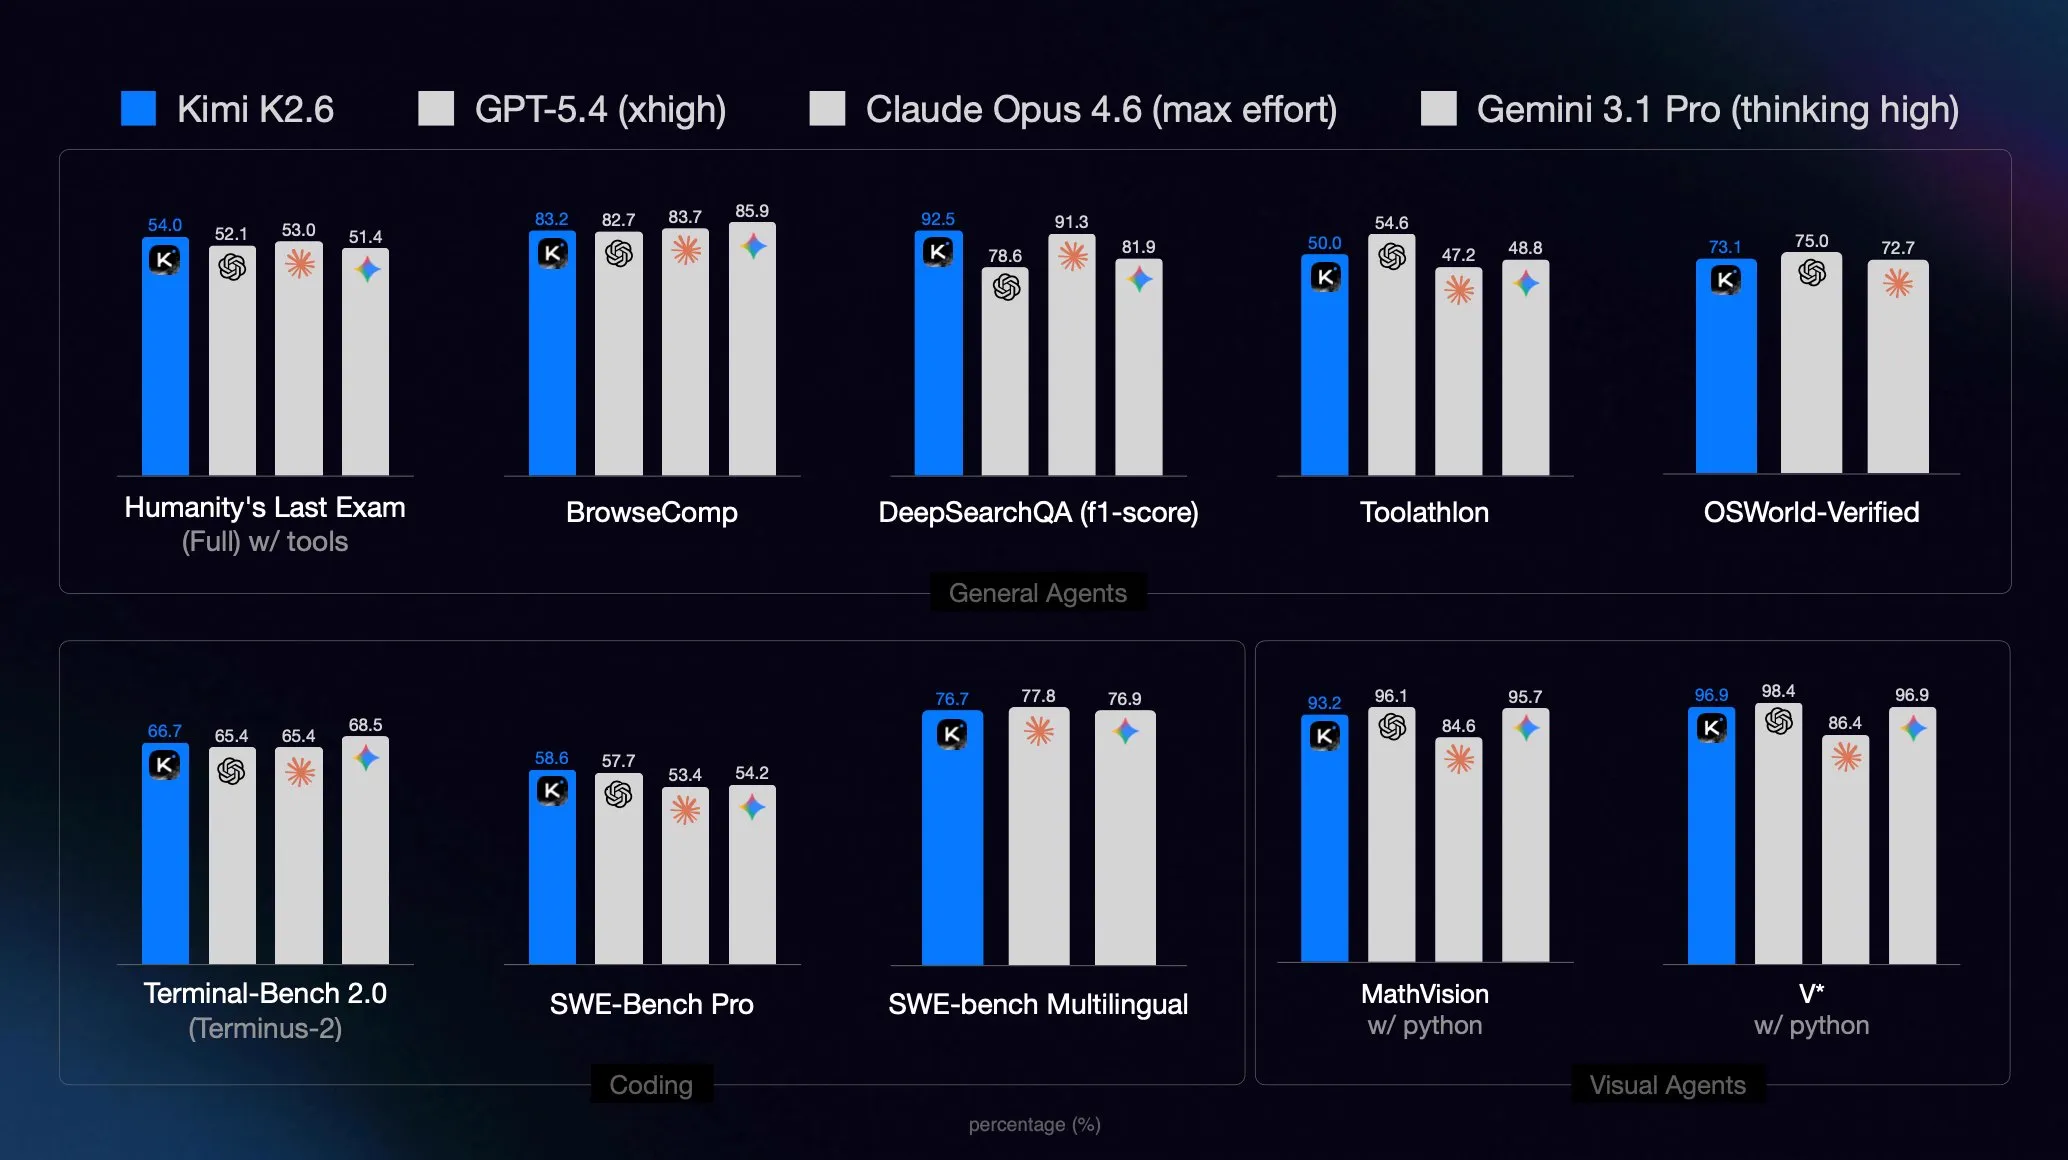
Desafortunadamente, el modelo parece estar bastante orientado a inflar benchmarks, apenas alcanzando el mismo nivel que GLM 5.1 en el mundo real, y ni de lejos el nivel de GPT 5.4 que afirman en sus puntuaciones de benchmark.
El equipo de Kimi parece haber perdido el rumbo un poco desde el éxito de su lanzamiento original de Kimi K2, ya que cada modelo progresivo se ha vuelto cada vez más orientado a inflar benchmarks. El modelo sigue siendo bastante decente, pero puede ser un poco irregular y difícil de usar, por lo que no lo recomendaría a menos que ya estés usando Kimi.
Esperemos que Kimi pueda dejar de perseguir tanto las puntuaciones en benchmarks y vuelva a intentar hacer un modelo de calidad.
GPT Image 2
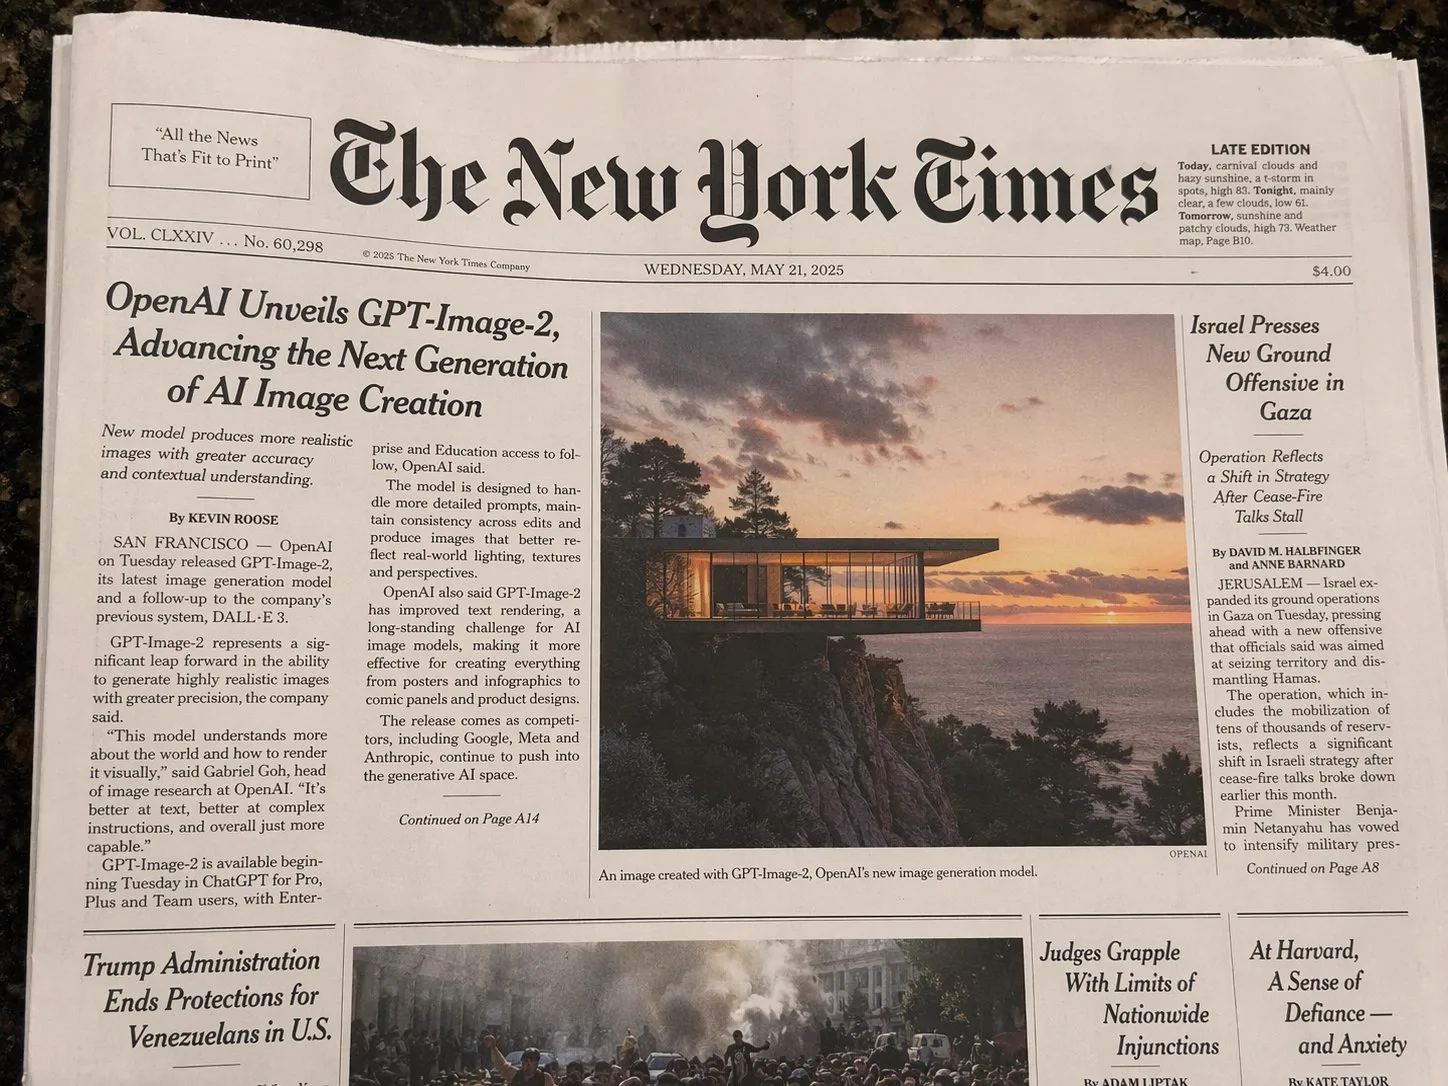
OpenAI no solo lanzó GPT 5.5 esta semana. También lanzaron una versión actualizada de su modelo de generación de imágenes, GPT Image 2.
Para ser directo: este es el mejor modelo de generación de imágenes disponible ahora mismo.
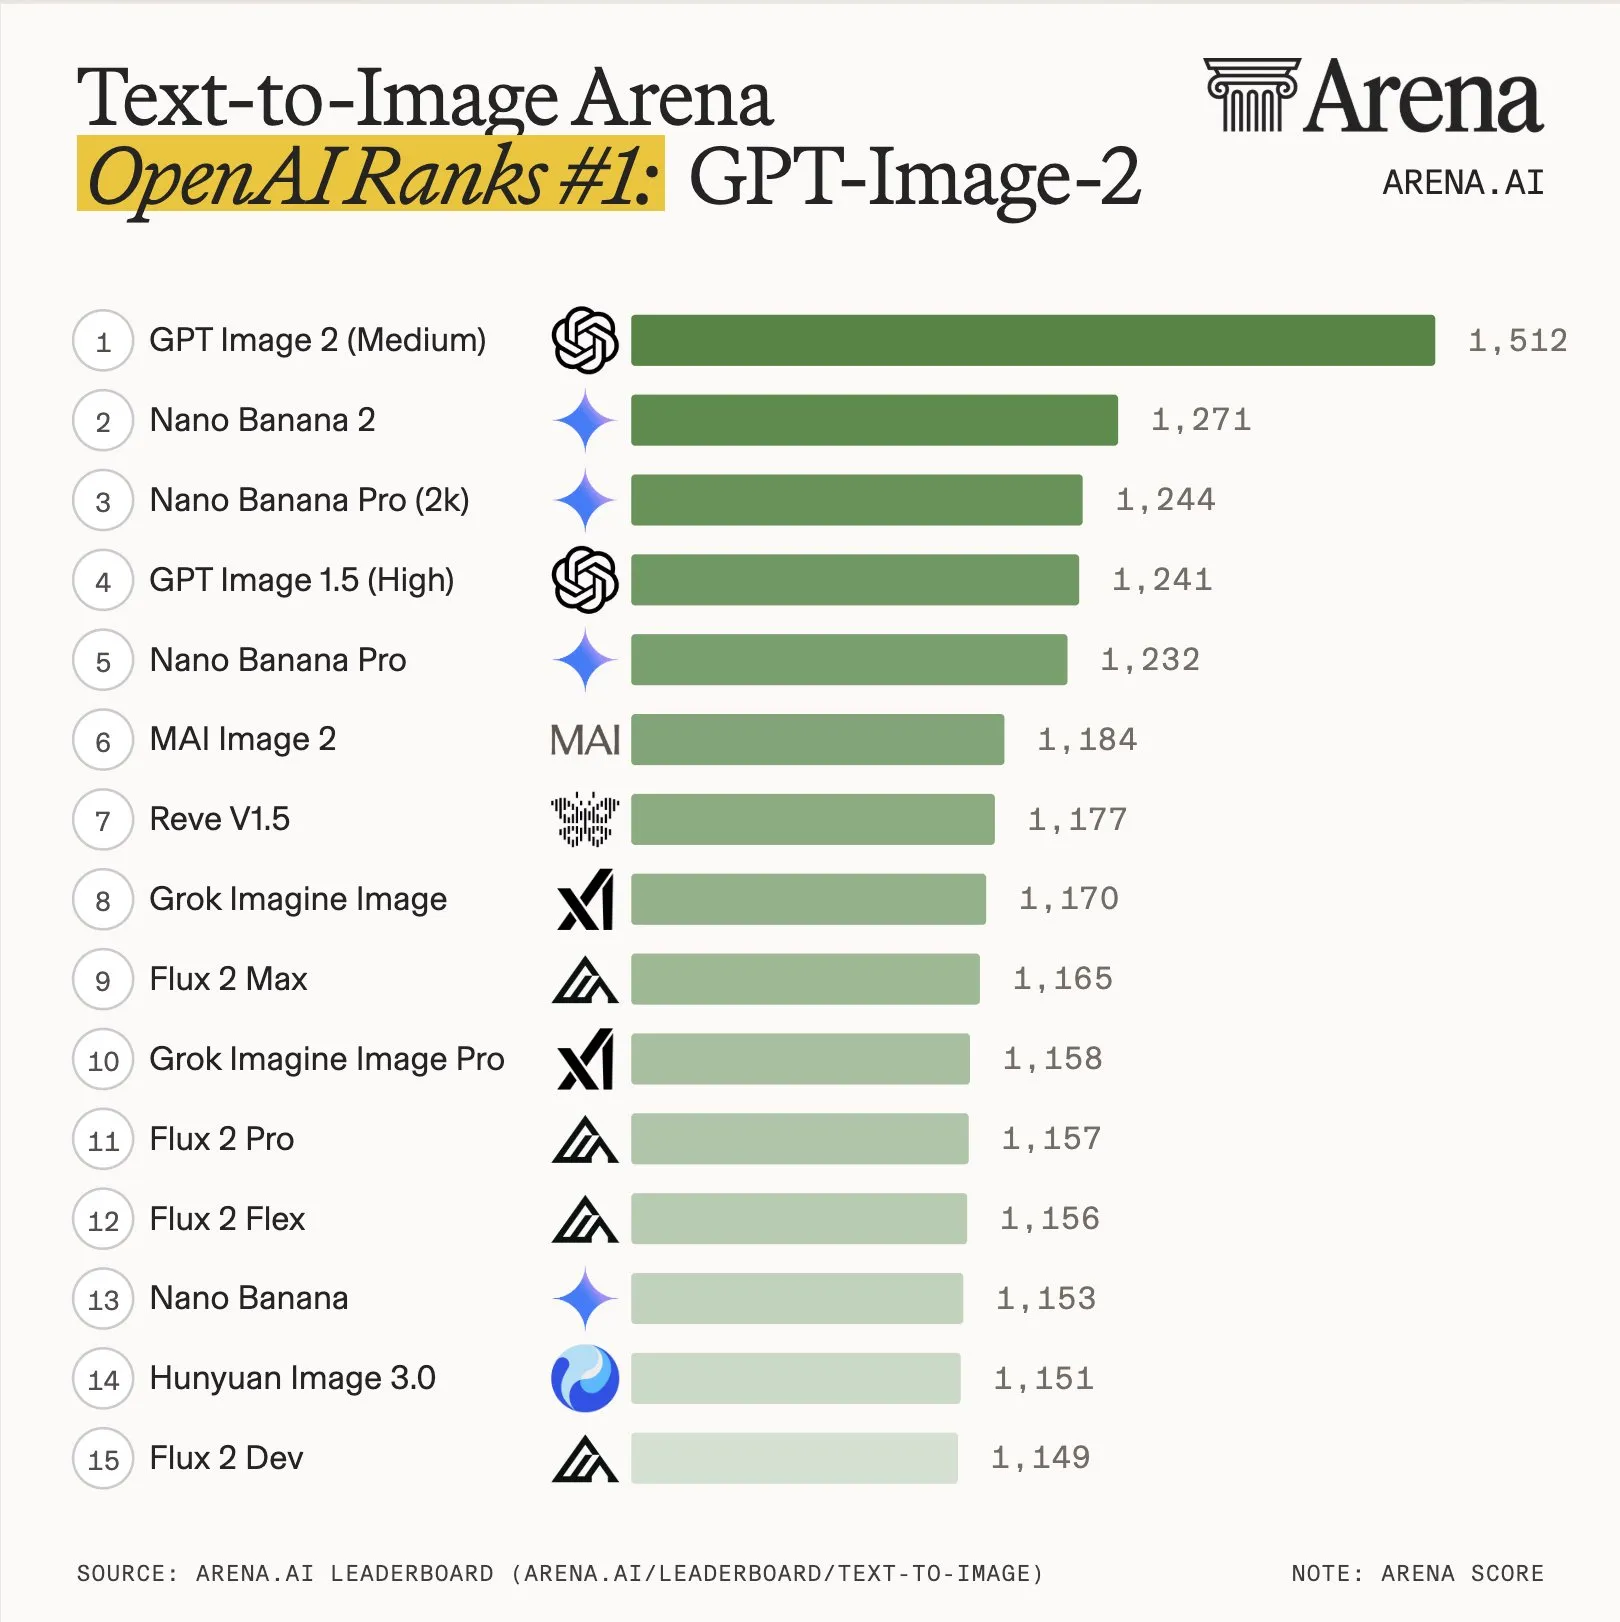
Como podemos ver en el análisis comparativo del público, es notablemente mejor que Nano Banana 2. Para la edición de imágenes, sigue siendo bueno, pero se mantiene alrededor del mismo nivel que su predecesor GPT Image 1.5 y Nano Banana 2.
El único inconveniente de este modelo es el precio. Cuesta $211 por cada 1.000 imágenes, lo que es más de 3 veces el precio de Nano Banana 2, que es solo $67 por cada 1.000. Dicho esto, si tienes una suscripción a ChatGPT, tienes acceso a este modelo de forma gratuita.
Ejemplos:
Qwen3.6 27B
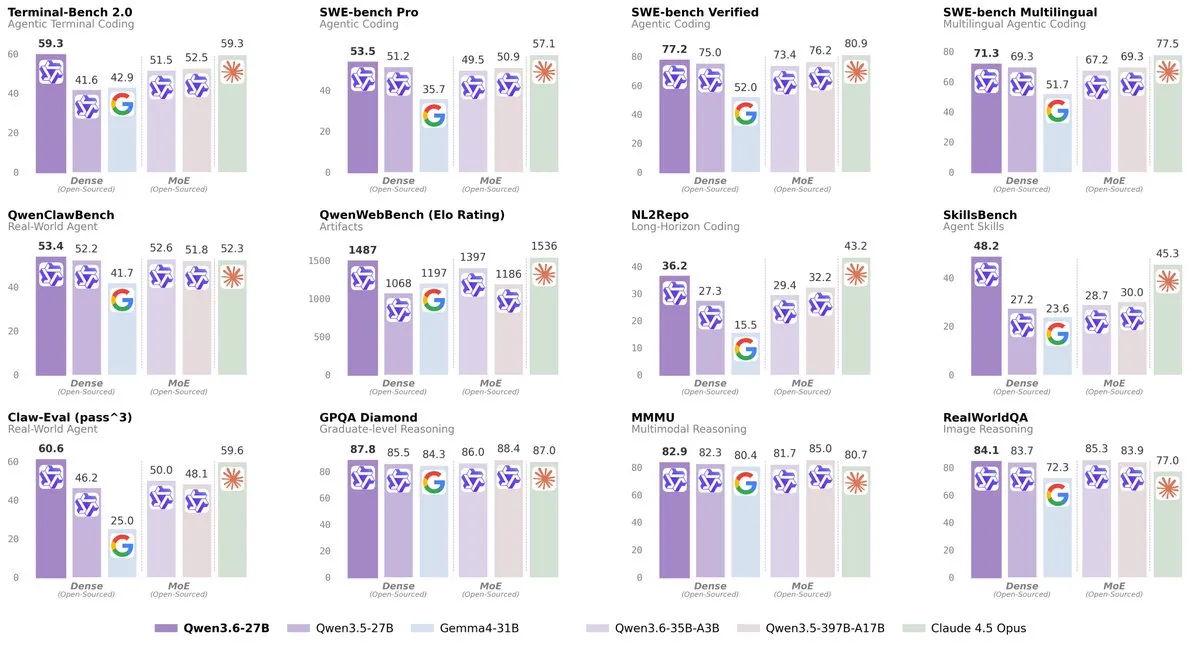
Qwen continúa el lanzamiento de su serie de modelos 3.6, publicando la versión actualizada de su modelo denso de 27B.
Qwen 3.6 27B es muy similar a su contraparte MoE de 35B. Es aproximadamente un 20-30% más inteligente y tiene más conocimiento del mundo, pero esto tiene el costo de ser entre 5 y 10 veces más lento.
Si no viste lo que comenté sobre Qwen3.6 la semana pasada, estos modelos están alrededor del nivel de calidad de Sonnet 4.5, y se pueden ejecutar localmente siempre que tengas al menos 24 GB de memoria (además de contar con soporte multimodal).
Si estás interesado en ejecutar estos modelos, recomendaría empezar con el modelo MoE de 35B, ya que será mucho más rápido y es aproximadamente igual de bueno; pero si quieres un poco más de inteligencia y estás dispuesto a esperar un poco más por las respuestas, entonces puedes probar el modelo de 27B.
Cierre
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo a continuación.