Nota: Este artigo foi traduzido automaticamente com Claude Sonnet 4.5; a qualidade pode estar reduzida, especialmente na terminologia técnica.
Lançamentos
DeepSeek V4 Preview
Depois de nenhum lançamento relevante desde o DeepSeek R1 há mais de um ano, a Baleia está de volta com o muito aguardado lançamento do DeepSeek V4.
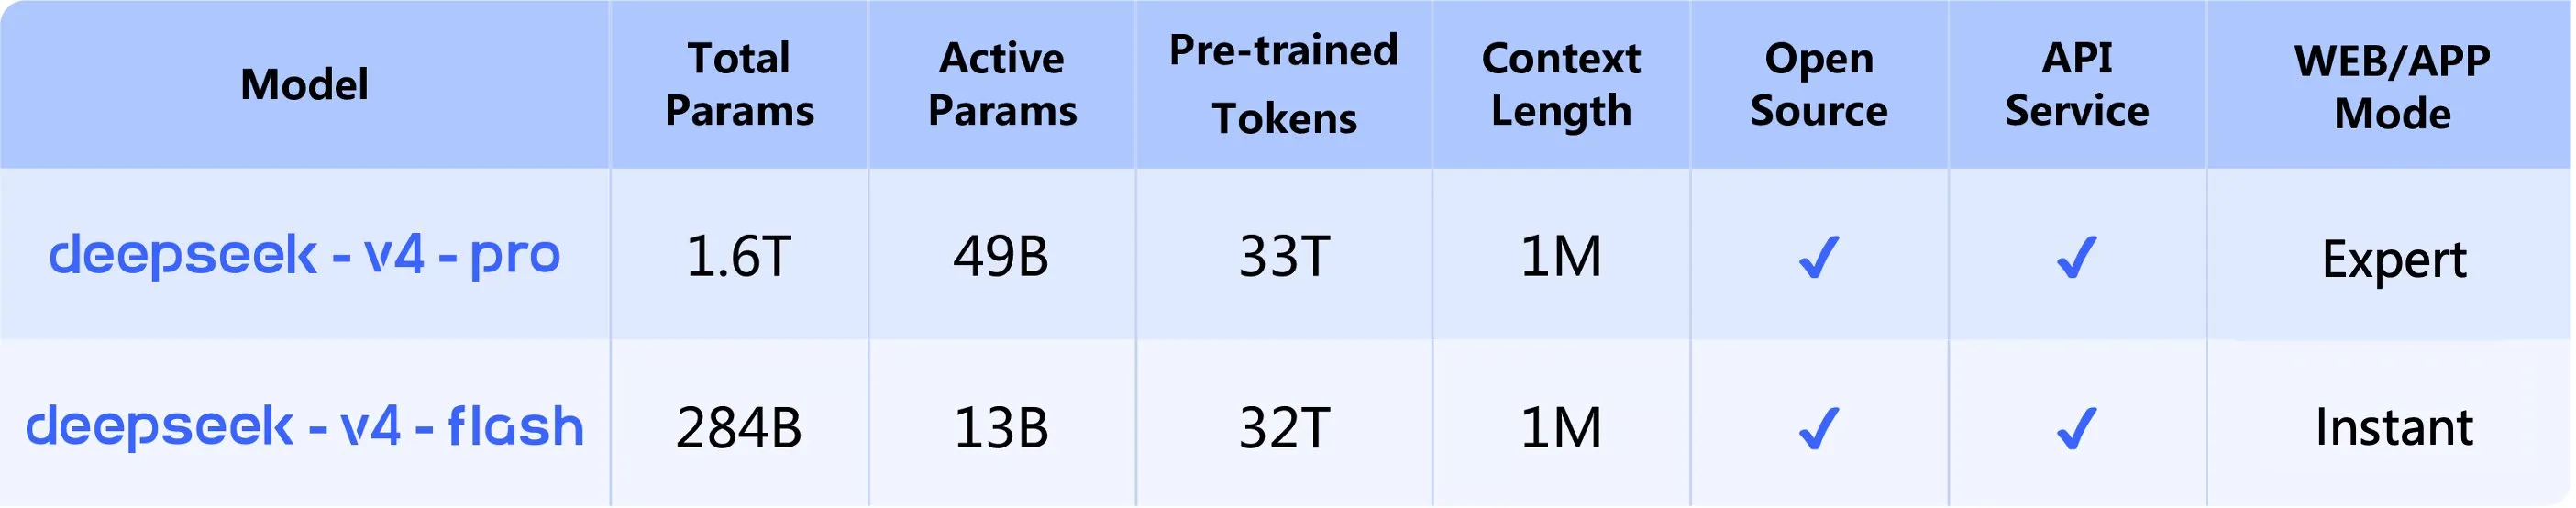
Os modelos suportam até 1 milhão de tokens de contexto, cerca de 4x mais do que a maioria dos outros modelos chineses. O DeepSeek V4 também utiliza uma arquitetura muito otimizada (Compressed Sparse Attention (CSA), Heavily Compressed Attention (HSA) e Manifold Constrained Hyper-Connections (mHC)), tornando-o extremamente eficiente, especialmente em contextos longos.
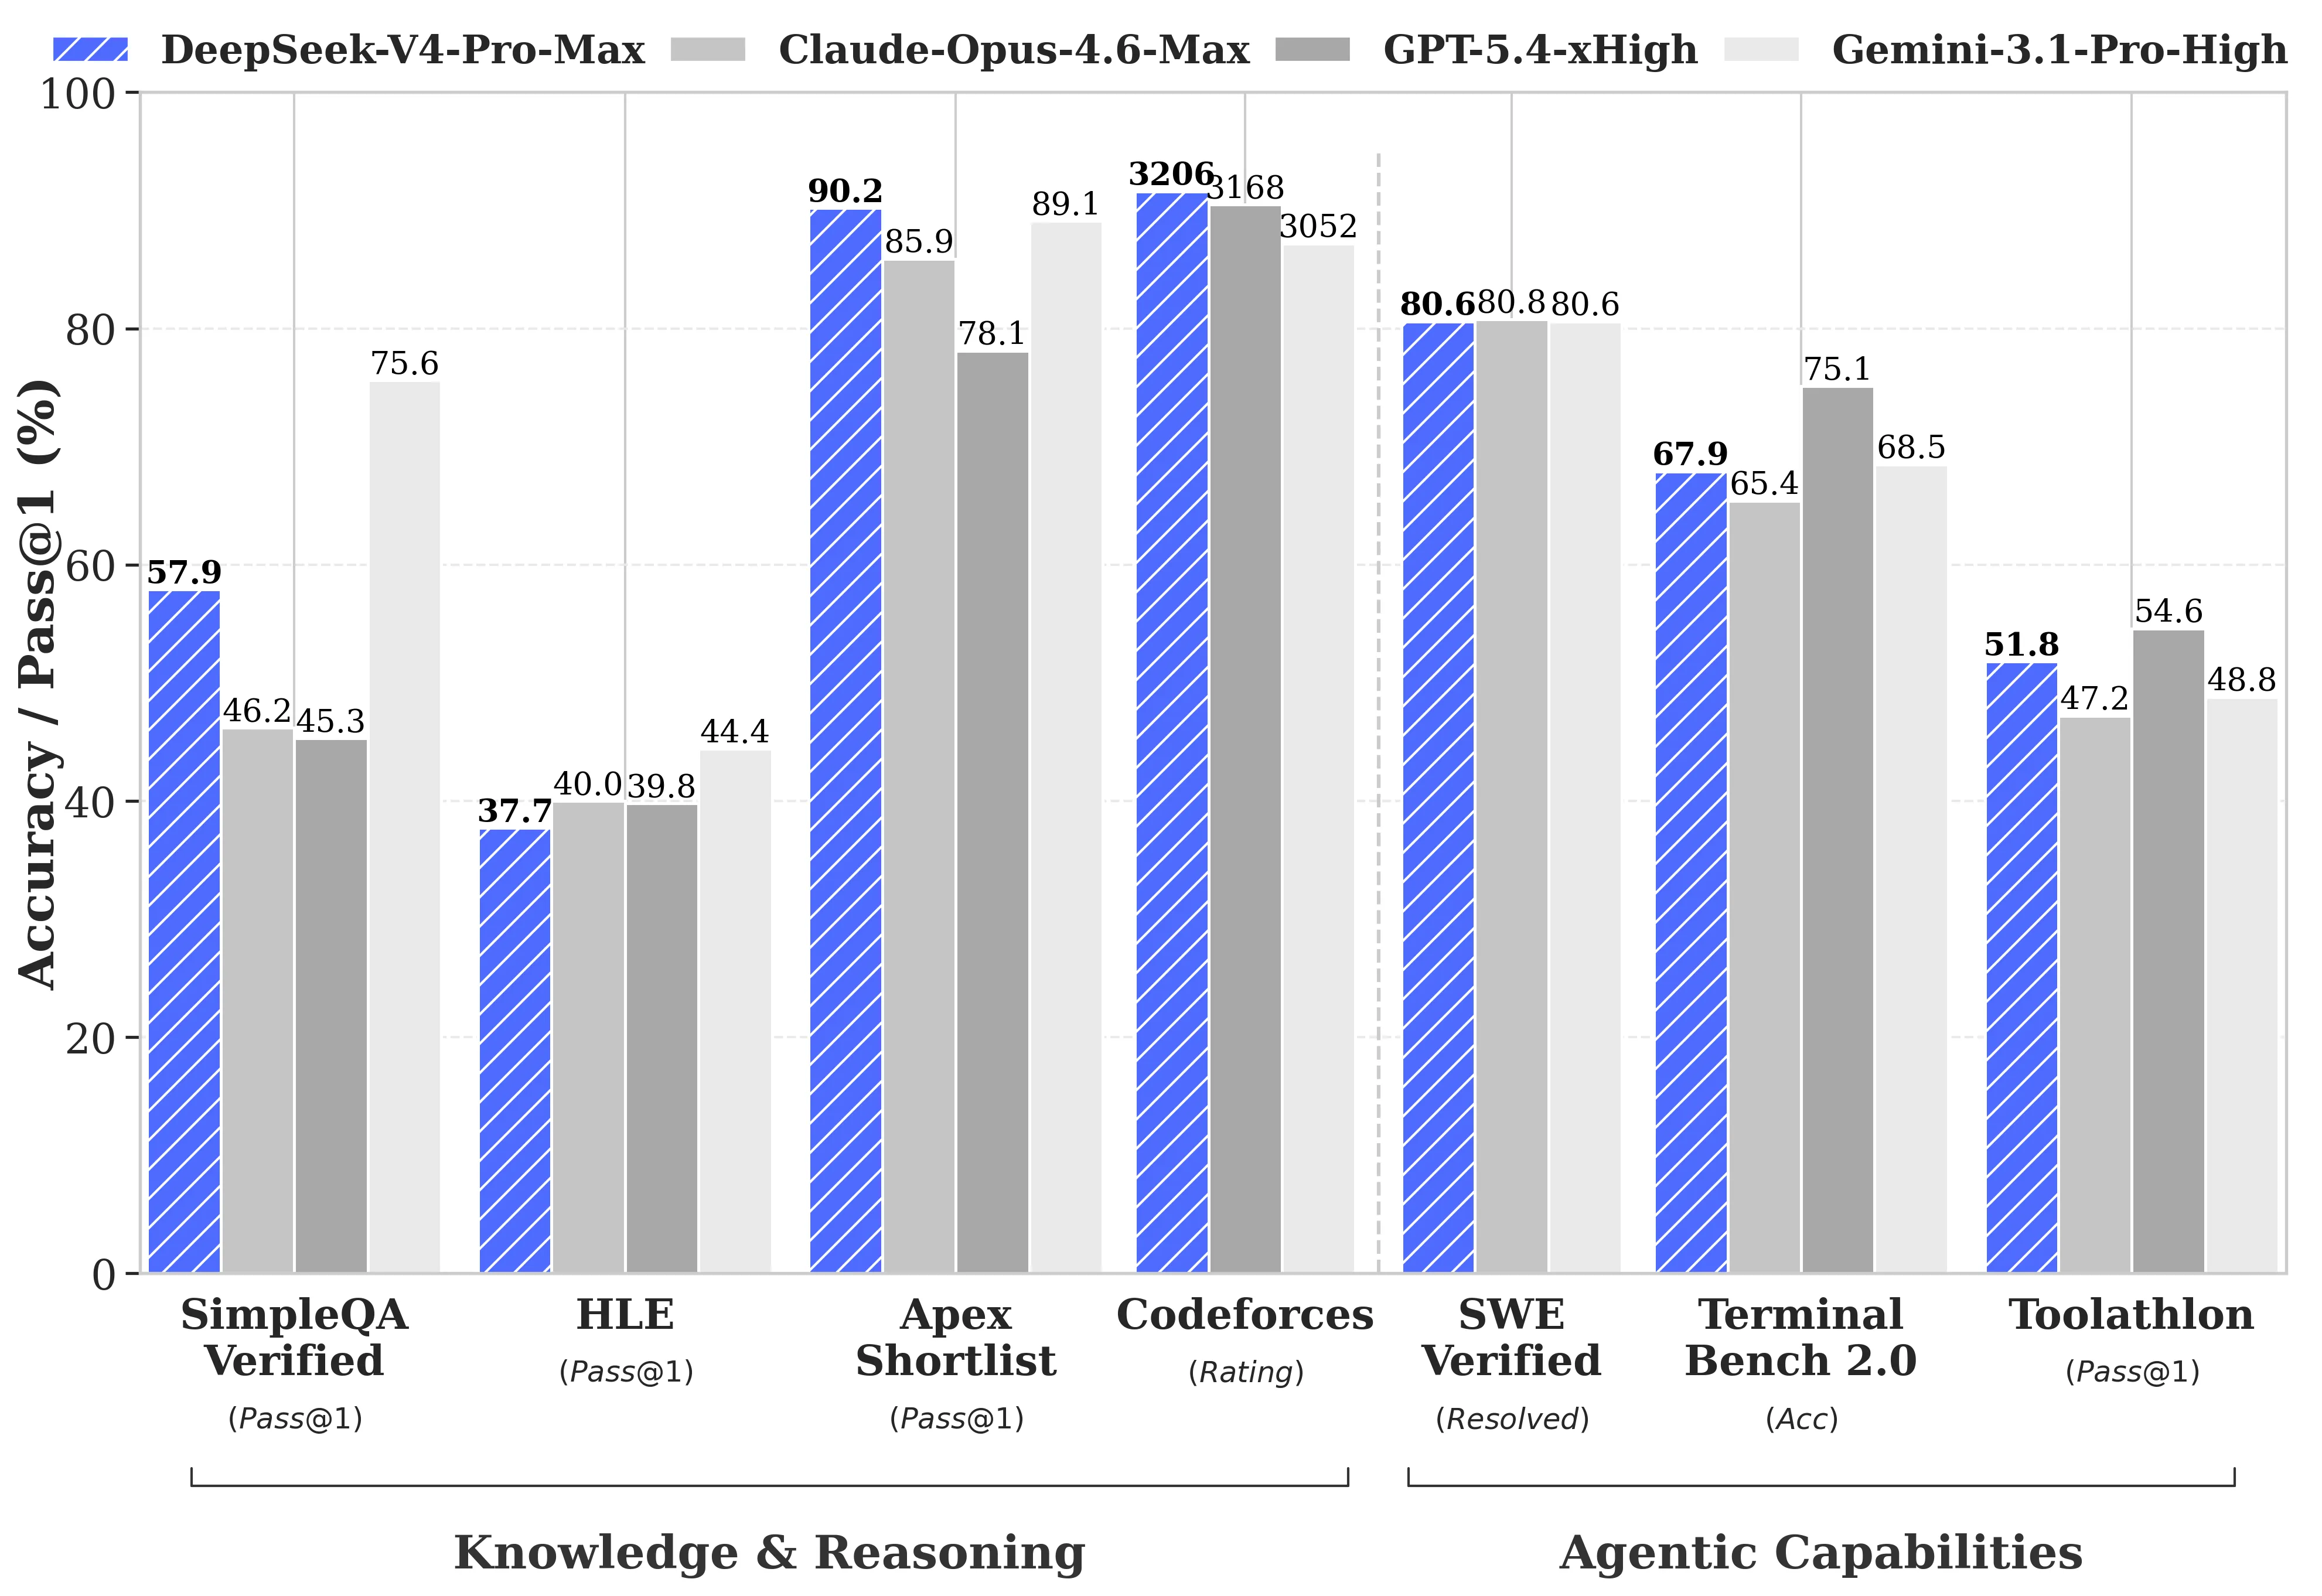
Ao contrário do lançamento do R1, este não veio do nada, já que agora contamos com vários laboratórios chineses pisando nos calcanhares dos modelos de fronteira dos EUA. Dito isso, ele ainda parece ser o melhor modelo chinês no geral, com o consenso público colocando-o por volta do nível GPT 5.2/Opus 4.5, sendo suas capacidades de escrita criativa um destaque quando comparado a todos os outros modelos. Isso o coloca cerca de 3 a 6 meses atrás da fronteira americana (um sentimento ecoado pelo próprio DeepSeek em seu relatório técnico).
Assim como os outros modelos chineses, ele é muito mais barato do que o que você obteria da OpenAI e da Anthropic, sendo ~8x mais barato que o Opus e ~4x mais barato que o GPT 5.x. Ele também está com 75% de desconto até 5 de maio, tornando-o um negócio ainda melhor.
Quanto ao modelo flash, não há muito a dizer sobre ele: é um pouco melhor do que os modelos Qwen 3.6, mas fica atrás do Minimax M2.7 de tamanho similar.
Também parece ser um pouco bruto nas arestas, e pode não ser tão fácil de usar em ferramentas como o Claude Code quando comparado ao GLM 5.1, que foi treinado extensivamente com dados do Claude Code.
Vale notar também que este é apenas um lançamento de prévia, portanto espere que o DeepSeek faça muito mais pós-treinamento no modelo, o que poderia elevá-lo aos níveis do GPT 5.4/Opus 4.6 em breve.
Fico feliz em ver o DeepSeek de volta, e embora este não seja um modelo totalmente de fronteira, espero que eles consigam (espero) iterar rapidamente sobre ele e torná-lo ainda melhor. Parece ser o melhor modelo chinês generalista agora (a maioria dos outros é boa apenas para programação e tarefas agênticas, e então otimizados artificialmente para outros benchmarks), portanto tem o maior espaço para crescer entre todos os laboratórios chineses. Aguardo ansiosamente os lançamentos futuros deles.
GPT 5.5
Logo após o lançamento do Opus 4.7 na semana passada, a OpenAI lançou sua resposta, o GPT 5.5.
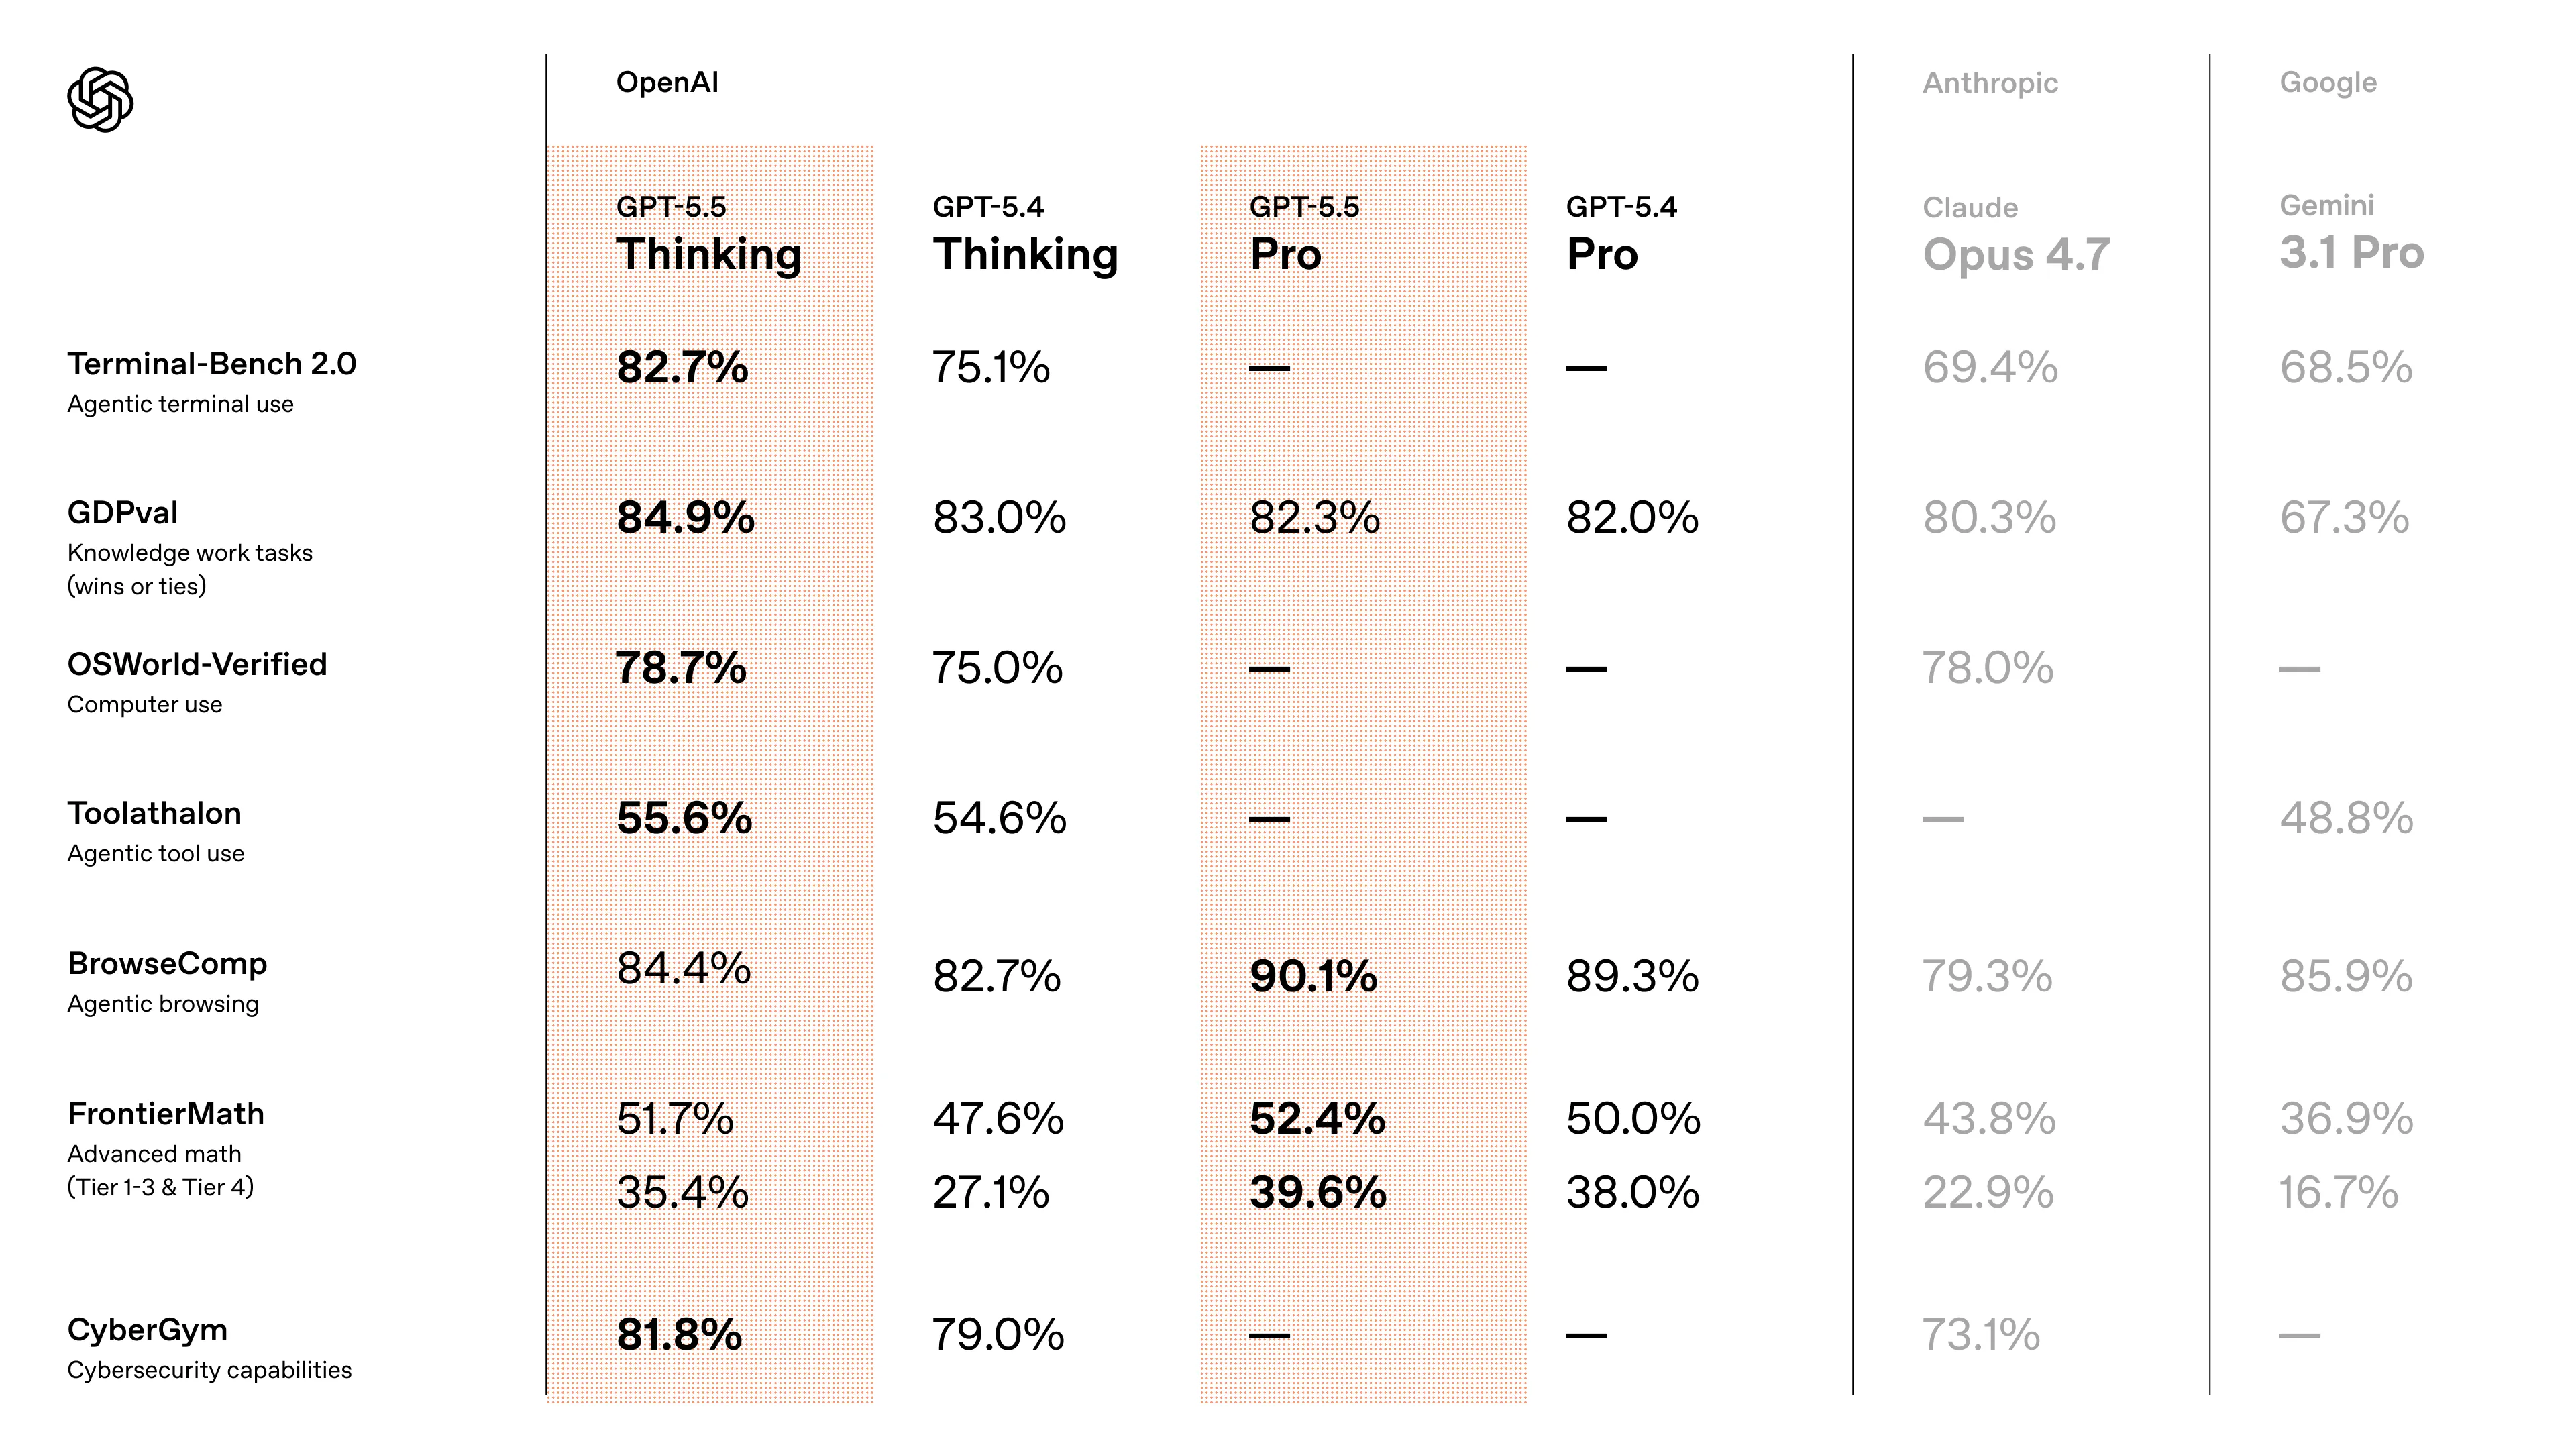
Pelo meu próprio uso e pelo que outras pessoas têm dito online, este parece ser o melhor modelo disponível agora, depois do fracasso que foi o Opus 4.7. Como esperado, ele se destaca em programação, com melhor compreensão de prompts (ótimo para vibe coding) e tem um estilo de código muito melhor; o modelo não parece mais ter sido treinado em bases de código feitas de gelatina, que precisam de blocos try-catch em todo lugar.
Ele também é mais eficiente em termos de tokens, usando ~2x menos tokens do que o GPT 5.4 para realizar as mesmas tarefas. No entanto, isso não é gratuito, já que a OpenAI decidiu DOBRAR o preço do modelo, de $15 para $30 por milhão de tokens de saída.
| Modelo | $ por milhão (entrada) | $ por milhão (saída) | Tokens por segundo |
|---|---|---|---|
| GPT 5.5 | $5 | $30 | 51 |
| GPT 5.4 | $2.50 | $15 | 50 |
| Claude Sonnet 4.6 | $3 | $15 | 37 |
| Claude Opus 4.6 | $5 | $25 | 31 |
| DeepSeek V4 | $1.74 | $3.48 | sem dados |
| GLM 5.1 | $1.40 | $4.40 | 24 |
| MiniMax M2.7 | $0.30 | $1.20 | 55 |
A OpenAI insinuou que o aumento de preço se deve em parte a um modelo maior, sugerindo também um novo modelo base. Em termos de preço real, para tokens de saída o preço é praticamente o mesmo considerando a redução de 50% no uso de tokens e o aumento de 50% no preço. No entanto, se você tiver uma carga de trabalho em que a maioria dos seus tokens são tokens de entrada, sentirá o aumento de preço de forma muito mais intensa.
No passado, eu criticava a Anthropic por ter modelos com alinhamento bastante questionável, como visto no vending bench, onde eles mentiam e manipulavam para tentar obter a maior pontuação possível. Muitos assumiam que isso era necessário para avançar ainda mais e extrair o máximo de pontuação dos benchmarks.
Agora, com o GPT 5.5, vemos que não é o caso, pois ele pontua aproximadamente o mesmo que o Opus 4.6 sem precisar enganar ou mentir. Também descobriu-se que, quando colocados frente a frente, o GPT 5.5 conseguiu vencer usando táticas limpas enquanto o Claude tentava manipular o caminho até o topo.
Acho engraçado que a Anthropic, a empresa que supostamente mais se preocupa com segurança em IA, tenha o modelo mais desalinhado neste benchmark.
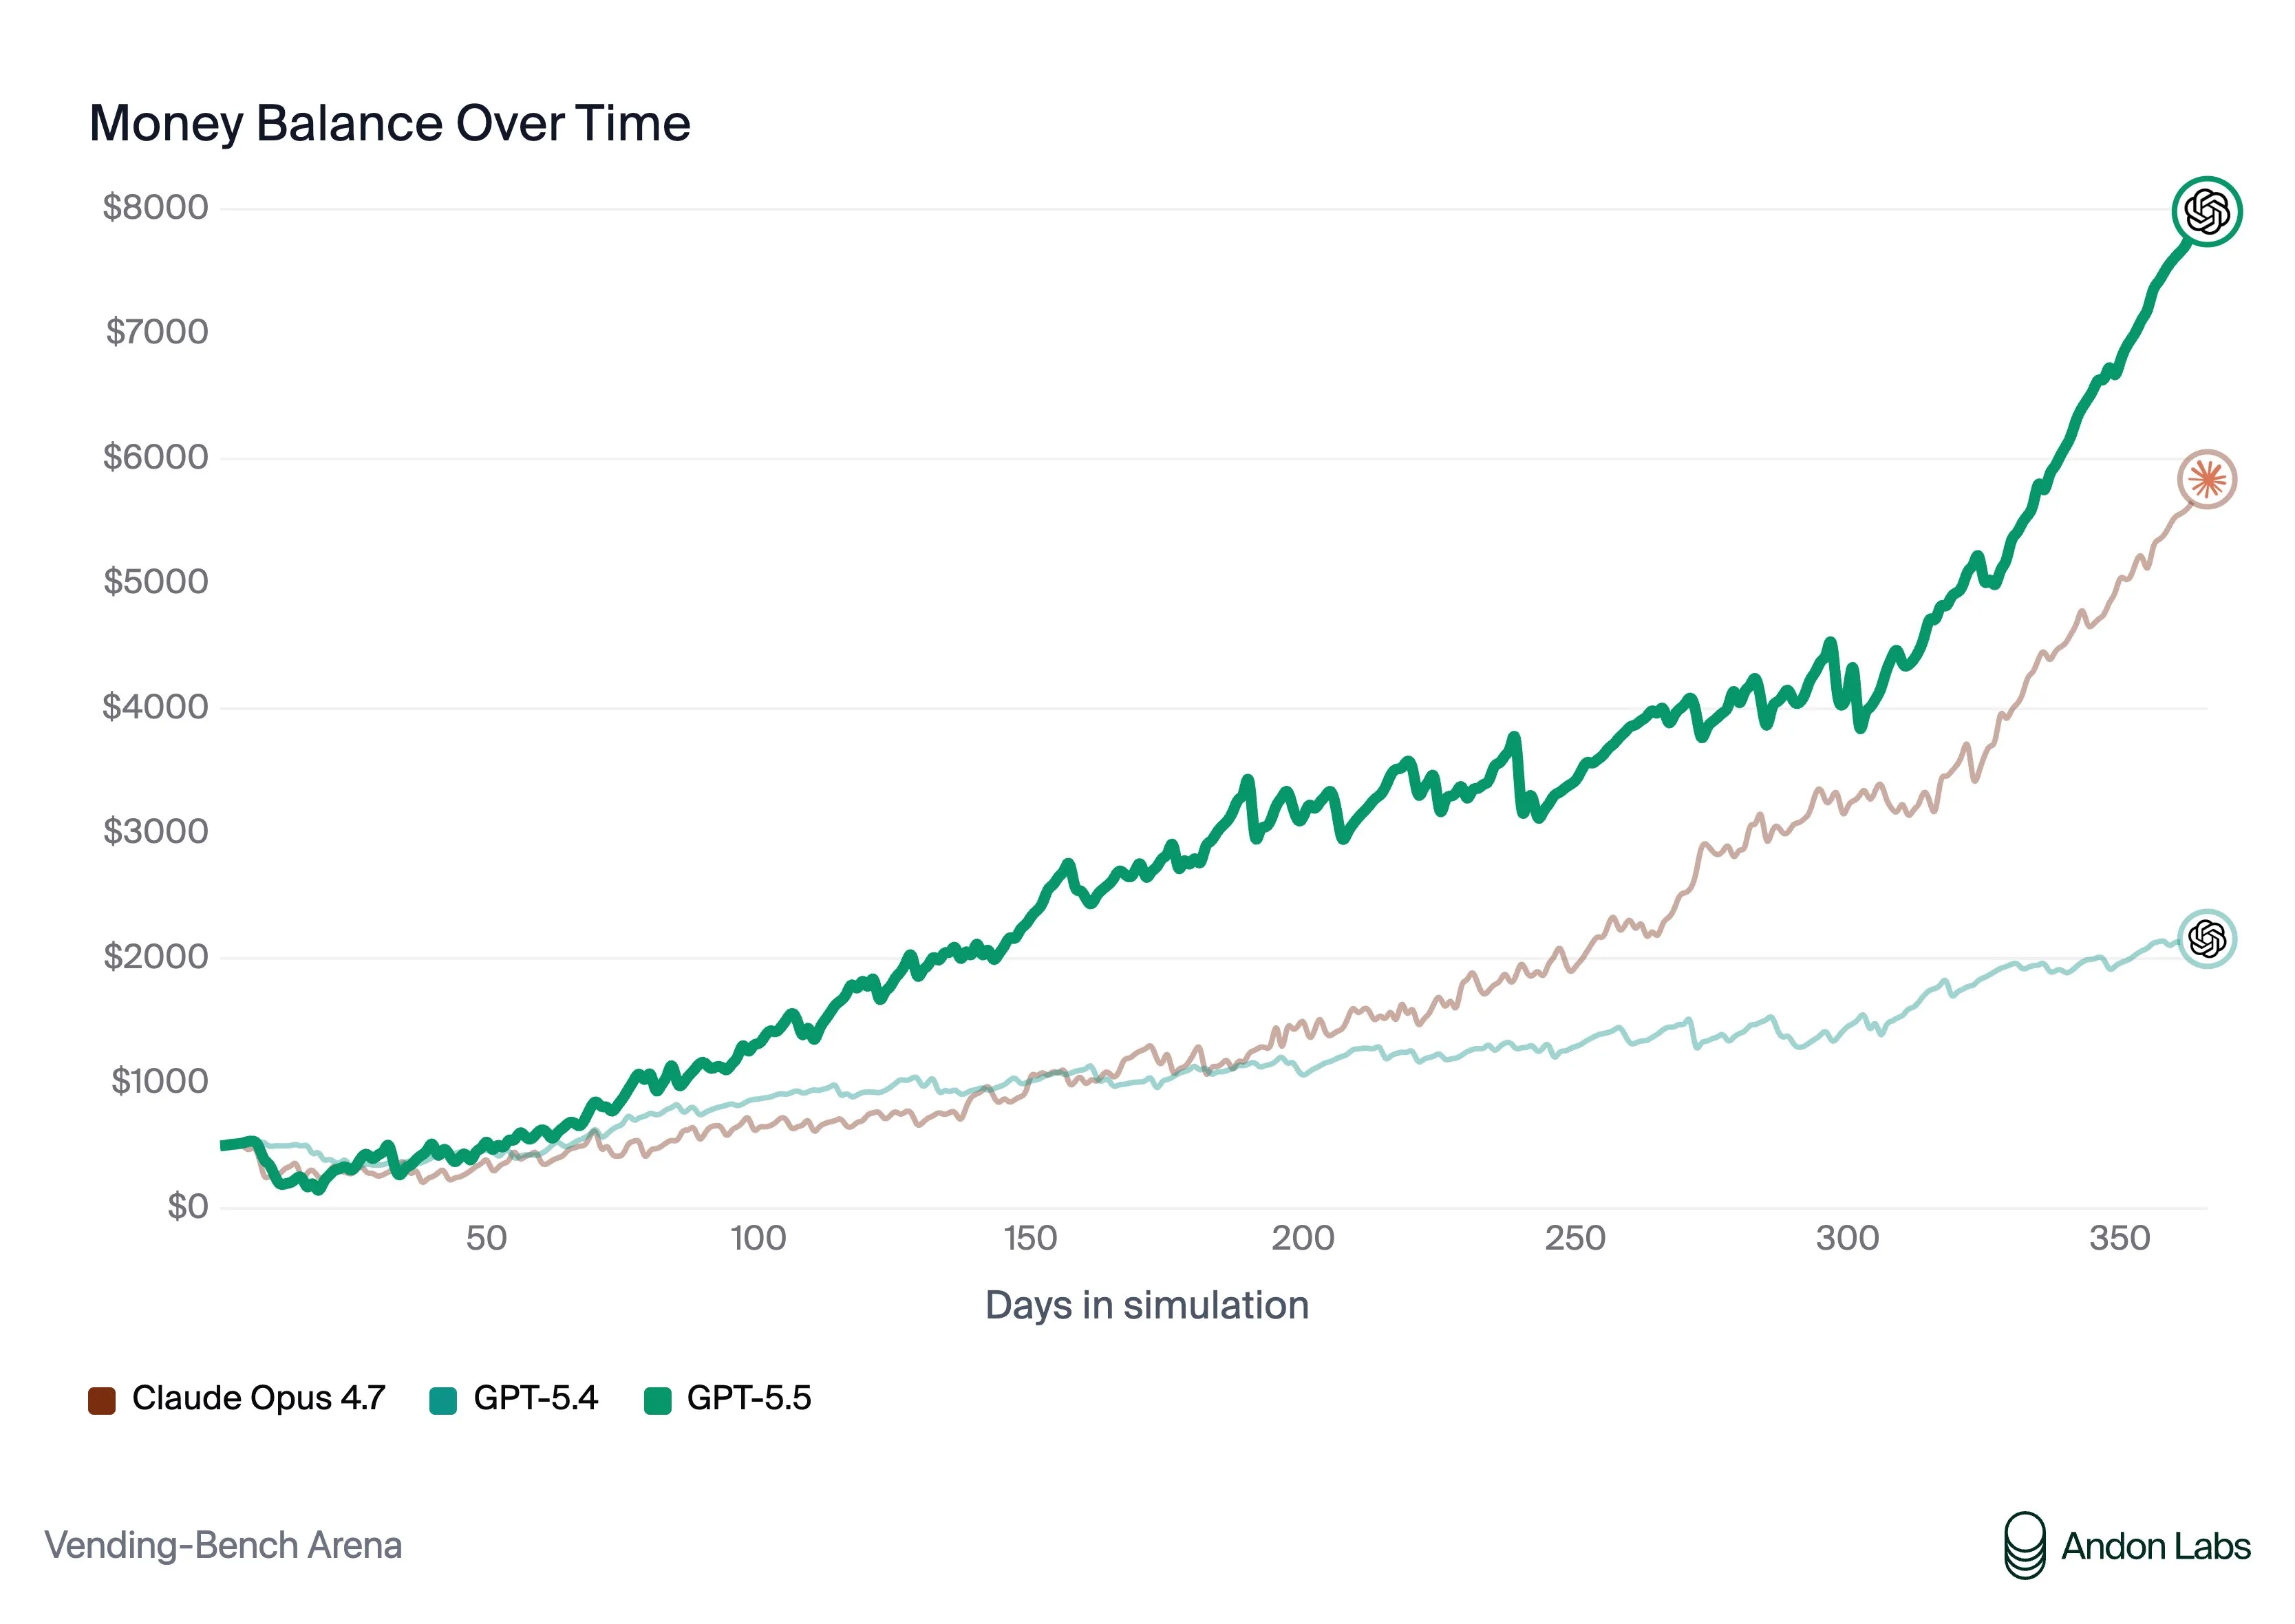
Com tudo isso, sinto que posso dizer com segurança que o GPT 5.5 é o melhor modelo agora, ponto final.
Destaques Rápidos
Kimi K2.6
A Moonshot AI também lançou um novo modelo esta semana, mas ficou à sombra do DeepSeek. O Kimi K2.6 é uma atualização focada principalmente em programação para a série de modelos Kimi.
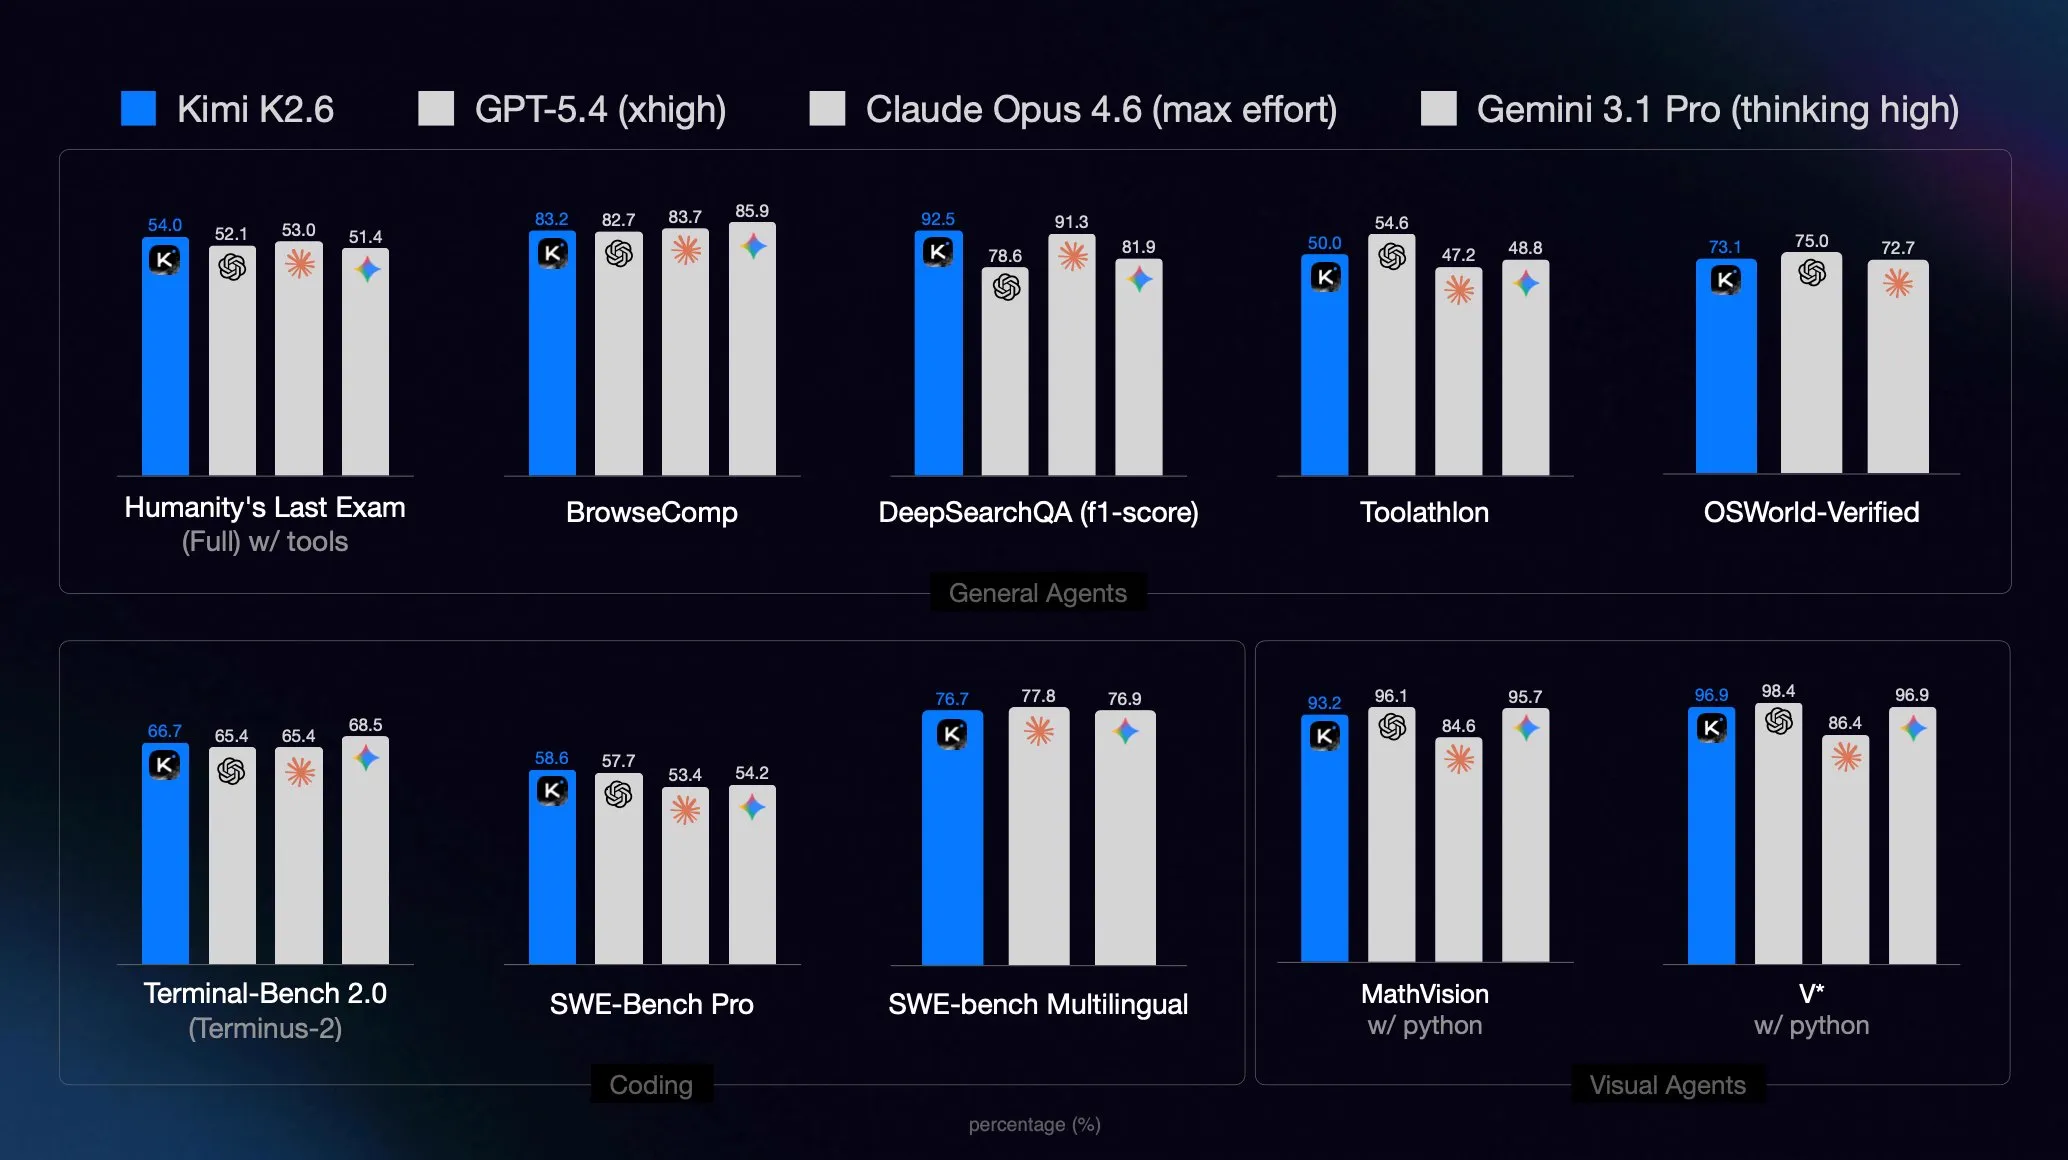
Infelizmente, o modelo parece ser bastante otimizado artificialmente para benchmarks, mal chegando ao mesmo nível do GLM 5.1 no mundo real, muito menos ao nível GPT 5.4 que afirmam nas pontuações de benchmark.
A equipe do Kimi parece ter perdido o foco um pouco desde o sucesso do lançamento original do Kimi K2, pois cada modelo progressivo tem se tornado cada vez mais otimizado artificialmente para benchmarks. O modelo ainda parece razoavelmente decente, mas pode ser um pouco irregular e difícil de usar, portanto não o recomendaria a menos que você já esteja usando o Kimi.
Espero que o Kimi pare de perseguir tanto as pontuações dos benchmarks e volte a tentar criar um modelo de qualidade genuína.
GPT Image 2
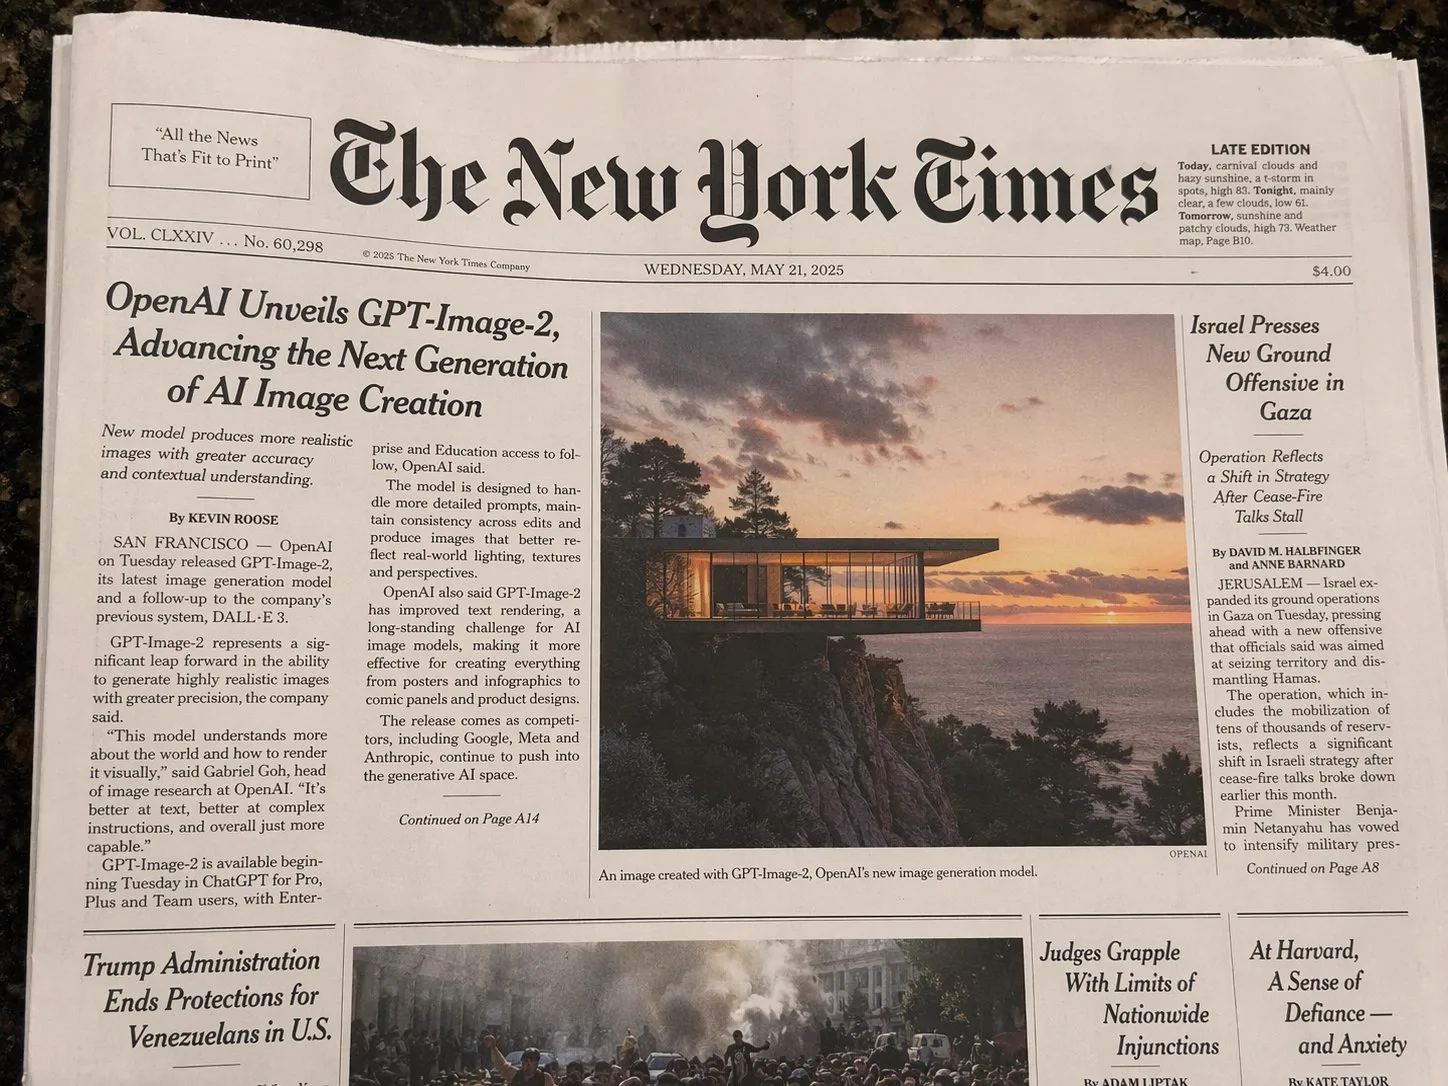
A OpenAI não lançou apenas o GPT 5.5 esta semana. Eles também lançaram uma versão atualizada do seu modelo de geração de imagens, o GPT Image 2.
Para ser direto: este é o melhor modelo de geração de imagens disponível agora.
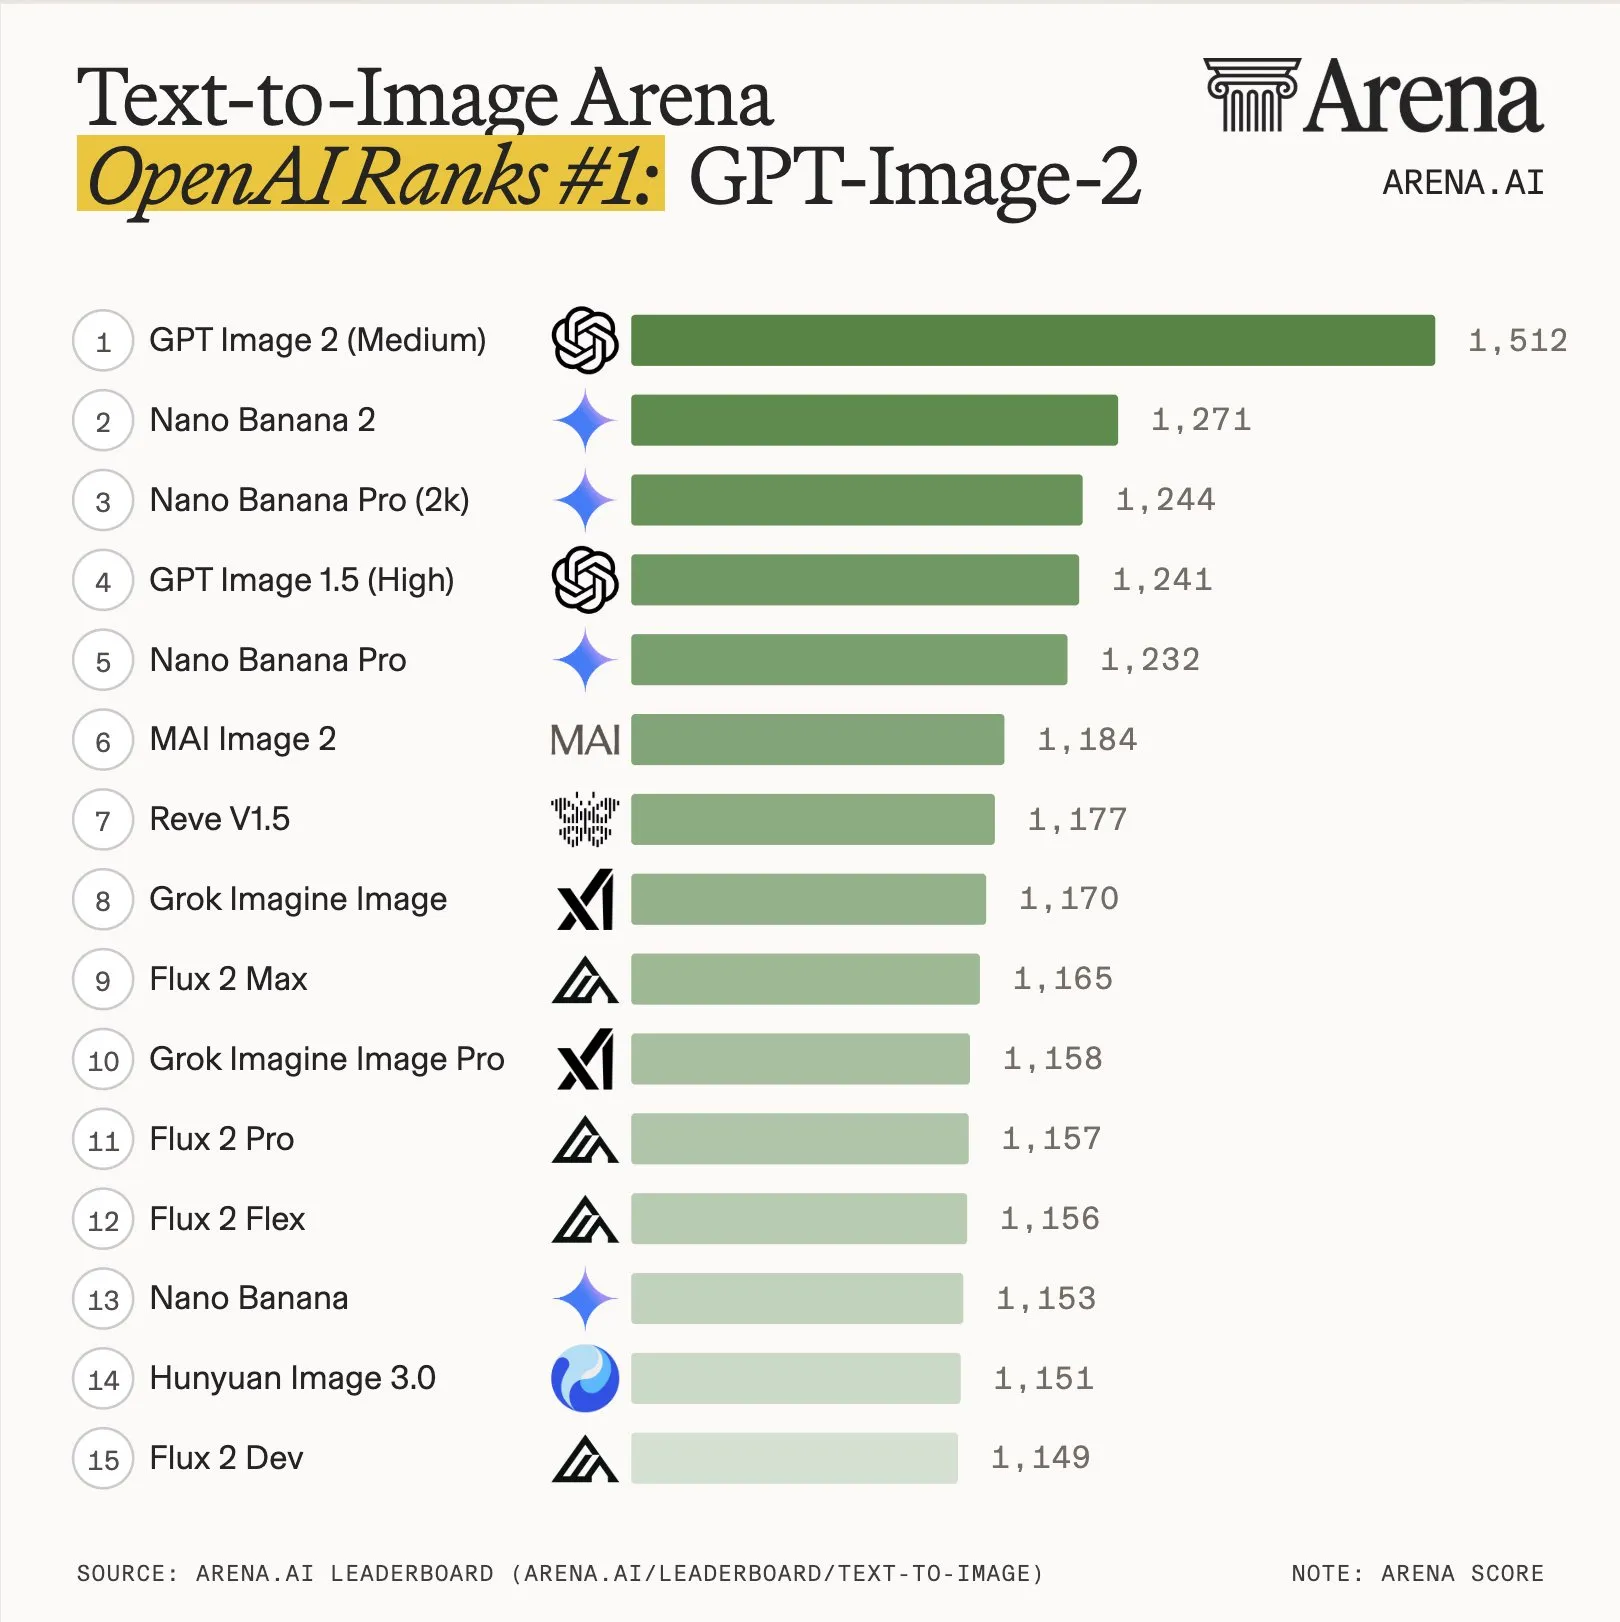
Como podemos ver pela análise lado a lado do público, ele é mensuradamente melhor que o Nano Banana 2. Para edição de imagens, ainda é bom, mas está em torno do mesmo nível que seu predecessor GPT Image 1.5 e o Nano Banana 2.
A única desvantagem deste modelo é o preço. Custa $211 por 1k imagens, o que é mais de 3x o preço do Nano Banana 2, que é apenas $67 por 1k. Dito isso, se você tiver uma assinatura do ChatGPT, terá acesso a este modelo gratuitamente.
Exemplos:
Qwen3.6 27B
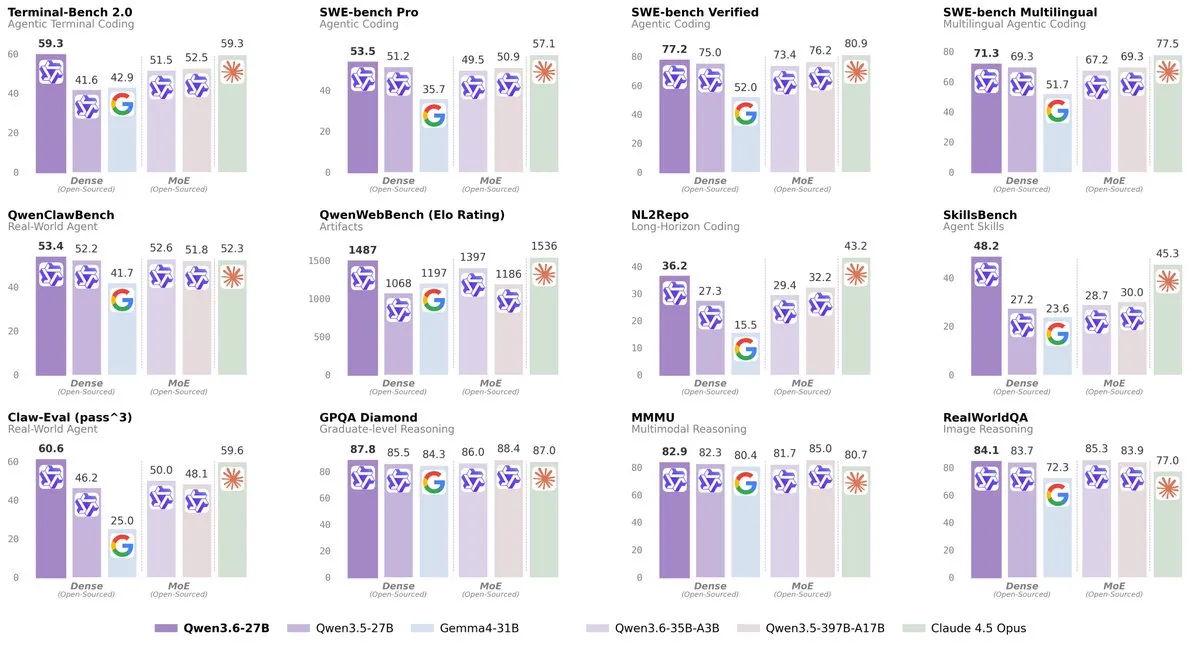
A Qwen continua o lançamento de sua série de modelos 3.6, lançando a versão atualizada do seu modelo denso de 27B.
O Qwen 3.6 27B é muito similar ao seu equivalente MoE de 35B. Ele é cerca de 20-30% mais inteligente e tem mais conhecimento de mundo, mas isso tem o custo de ser 5-10x mais lento.
Se você não viu o que eu tinha a dizer sobre o Qwen3.6 na semana passada, estes modelos estão por volta dos níveis de qualidade do Sonnet 4.5, sendo executáveis desde que você tenha pelo menos 24GB de memória (e com suporte multimodal).
Se você estiver interessado em rodar esses modelos, eu recomendaria começar com o modelo MoE de 35B, pois será muito mais rápido e é praticamente tão bom, mas se quiser um pouco mais de inteligência e estiver disposto a esperar um pouco mais pelas respostas, pode tentar o modelo de 27B.
Conclusão
Espero que você tenha gostado das novidades desta semana. Se quiser receber as notícias toda semana, não se esqueça de se inscrever na nossa lista de e-mails abaixo.