注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
DeepSeek V4 Preview
自一年多前发布 DeepSeek R1 以来,DeepSeek 一直没有重大更新。如今,这头鲸鱼带着备受期待的 DeepSeek V4 回来了。
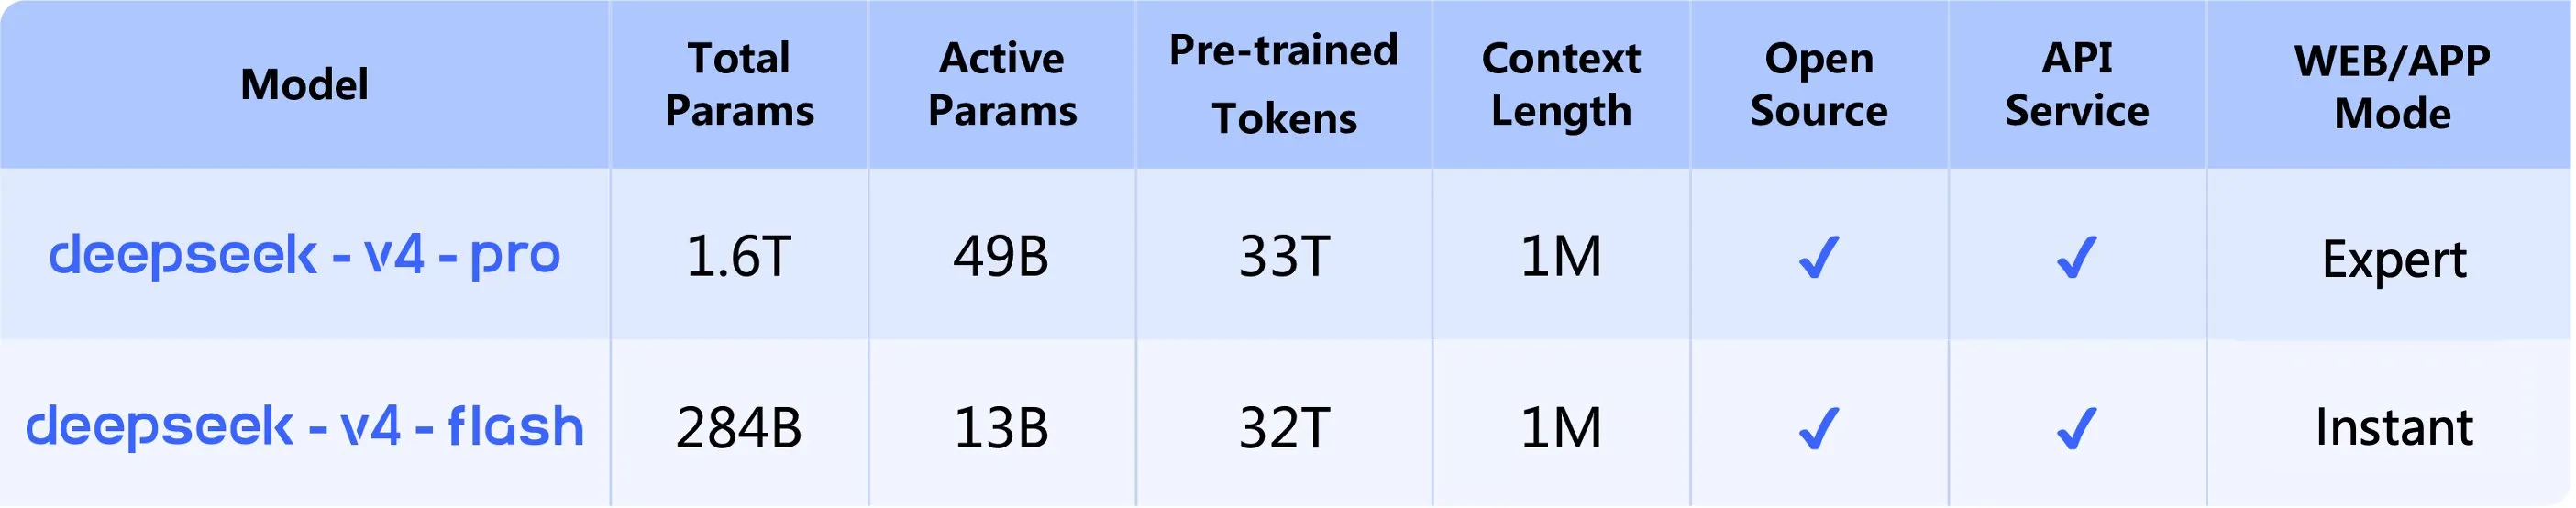
这些模型支持最高 100 万 token 的上下文,约为大多数其他中国模型的 4 倍。 DeepSeek V4 还采用了高度优化的架构,包括压缩稀疏注意力(Compressed Sparse Attention,CSA)、高度压缩注意力(Heavily Compressed Attention,HSA)和流形约束超连接(Manifold Constrained Hyper-Connections,mHC),因此效率极高,尤其是在处理长上下文时。
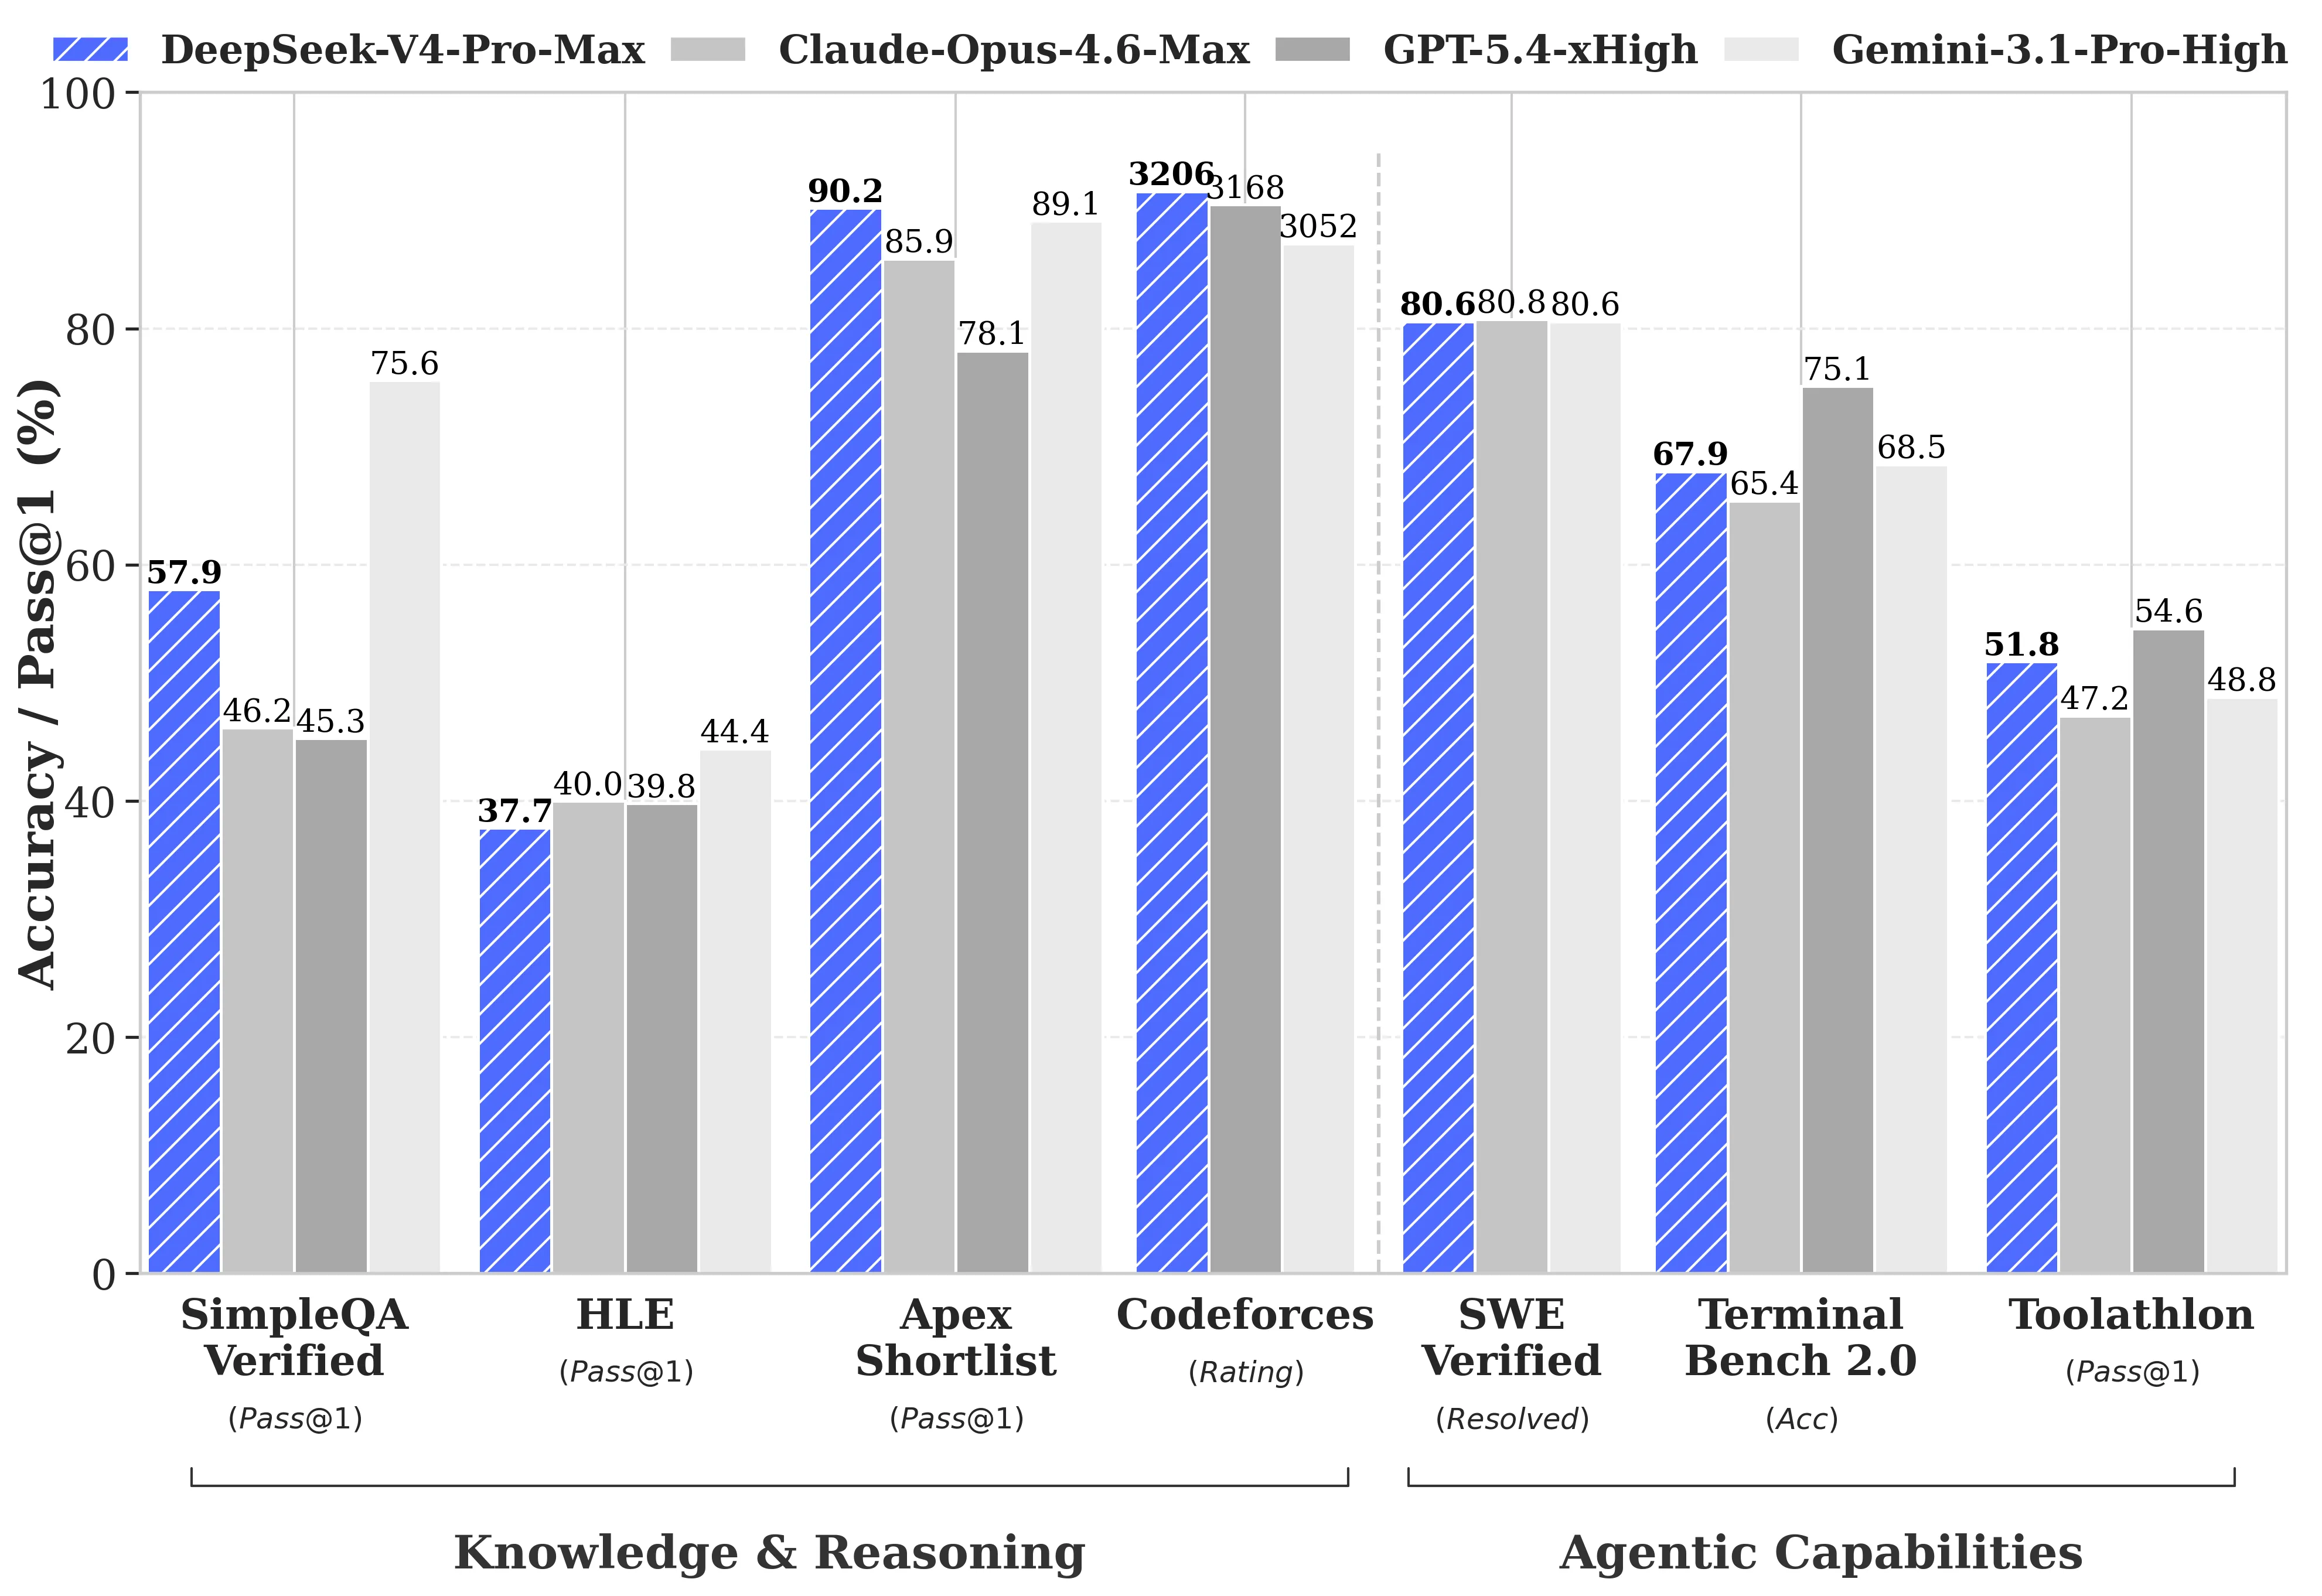
与 R1 发布时不同,这次发布并不让人感到意外,毕竟如今已有多家中国实验室紧追美国的前沿模型。 话虽如此,它似乎仍是综合表现最好的中国模型。大家普遍认为,它大致处于 GPT 5.2/Opus 4.5 的水平,而创意写作能力更是在所有模型中都相当突出。 这意味着它比美国的前沿水平落后约 3 至 6 个月(DeepSeek 自己也在技术报告中表达了类似看法)。
和其他中国模型一样,它的价格远低于 OpenAI 和 Anthropic 的同类产品,约为 Opus 的 1/8、GPT 5.x 的 1/4。
而且在 5 月 5 日之前还有二五折优惠,让它更加划算。
至于 Flash 模型,就没有太多值得大书特书的地方了。它比 Qwen 3.6 系列模型略好一些,但不及规模相近的 MiniMax M2.7。
它似乎也还有些打磨不到位的地方。在 Claude Code 等工具中,用起来可能不如 GLM 5.1 顺手,后者使用大量 Claude Code 数据进行过训练。
还要注意,这只是预览版,所以可以期待 DeepSeek 继续对模型进行大量后训练,这可能会让它在不久的将来达到 GPT 5.4/Opus 4.6 的水平。
很高兴看到 DeepSeek 回归。虽然它还没有完全跻身前沿模型之列,但我期待他们能快速迭代,让它变得更好——希望如此。 它似乎是目前最好的中国通用模型(其他模型大多只擅长编程和智能体任务,在其他评测上则靠针对性刷分),因此,在中国各家实验室中,我认为它的成长空间最大。 期待他们接下来的发布。
GPT 5.5
紧随上周发布的 Opus 4.7,OpenAI 推出了自己的回应:GPT 5.5。
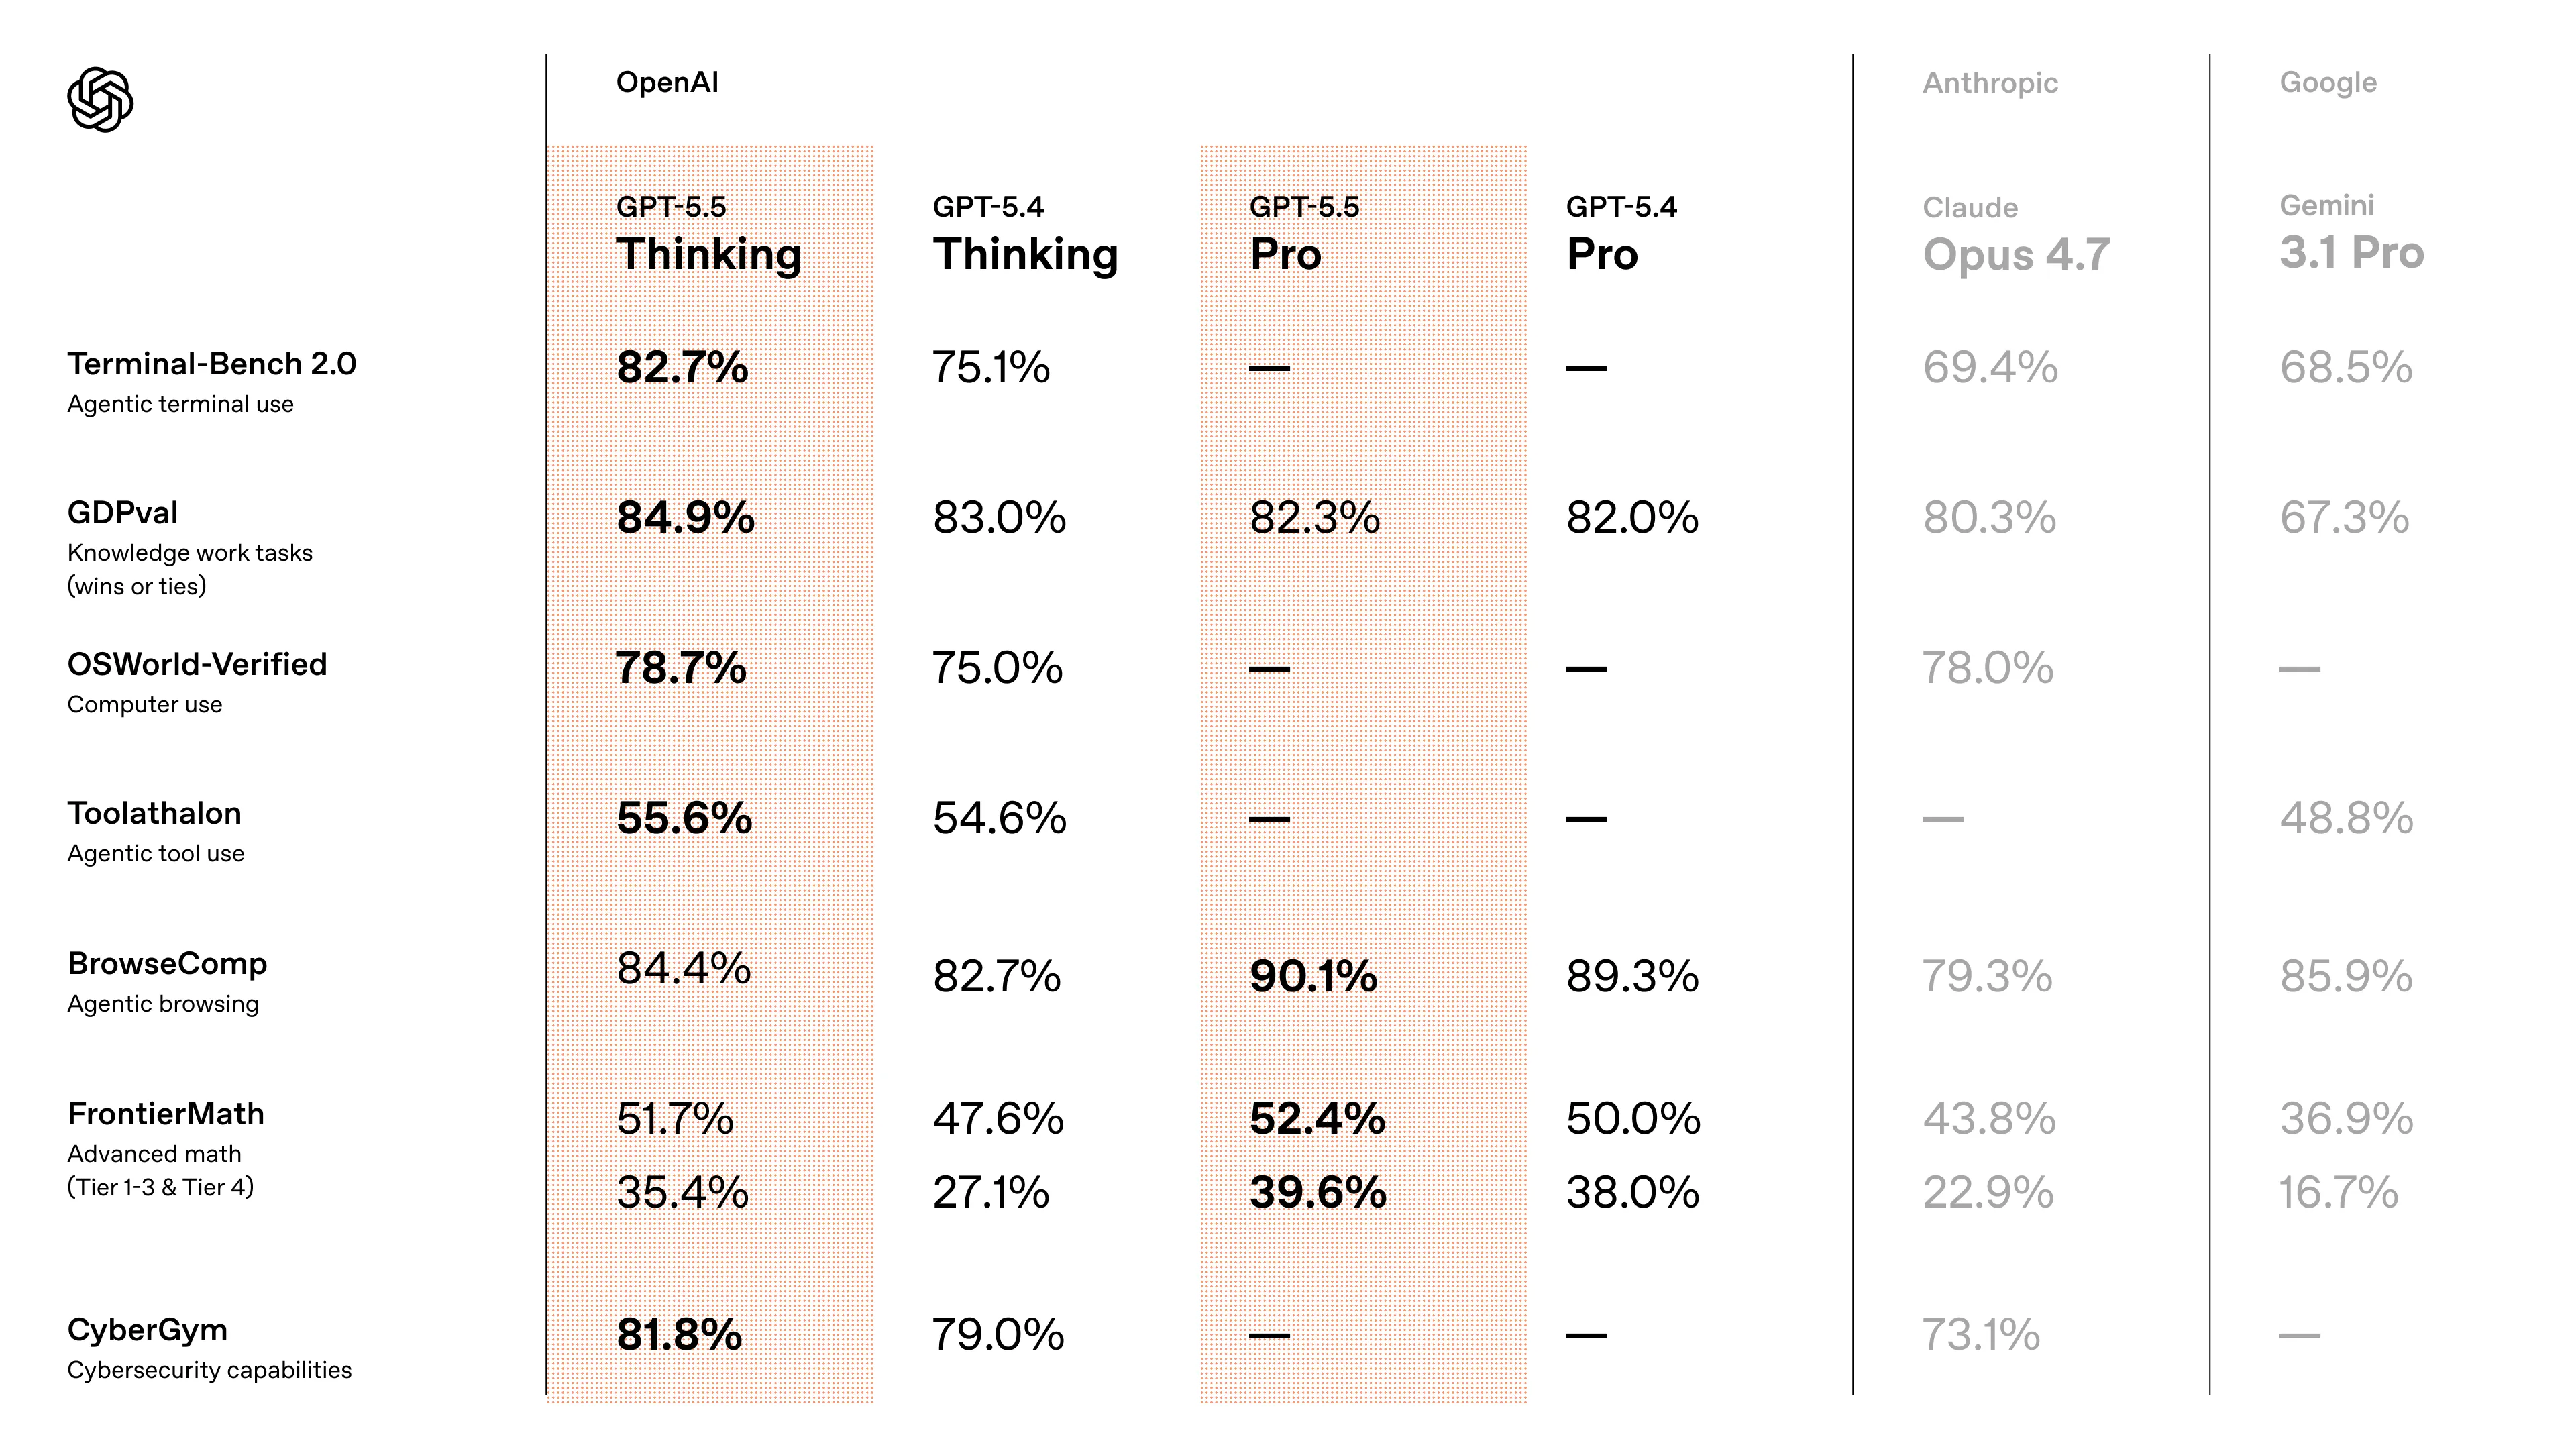
结合我自己的使用体验和网上其他人的反馈,在 Opus 4.7 翻车之后,它似乎已经成为目前独一档的最强模型。 不出所料,它在编程方面表现出色,对提示词的理解有所提升(很适合氛围编程),代码风格也好了很多;终于不再让人觉得,它的训练代码库像果冻一样脆弱,以至于到处都得塞上 try-catch 块。
它使用 token 的效率也更高,完成相同任务所需的 token 约为 GPT 5.4 的一半。 不过,这种提升并非没有代价,因为 OpenAI 决定将模型价格翻倍,每百万输出 token 的价格从 15 美元涨到了 30 美元。
| 模型 | 每百万输入 token 价格(美元) | 每百万输出 token 价格(美元) | 每秒 token 数 |
|---|---|---|---|
| GPT 5.5 | $5 | $30 | 51 |
| GPT 5.4 | $2.50 | $15 | 50 |
| Claude Sonnet 4.6 | $3 | $15 | 37 |
| Claude Opus 4.6 | $5 | $25 | 31 |
| DeepSeek V4 | $1.74 | $3.48 | 暂无数据 |
| GLM 5.1 | $1.40 | $4.40 | 24 |
| MiniMax M2.7 | $0.30 | $1.20 | 55 |
OpenAI 暗示,涨价的部分原因在于模型规模更大,这也意味着它采用了新的基础模型。 从实际使用成本来看,token 用量减少 50%,价格上涨 50%,因此输出 token 的总成本大致相同。 不过,如果你的工作负载中绝大多数 token 都是输入 token,那么你就会更明显地感受到这次涨价。
过去,我曾批评 Anthropic 的模型对齐做得相当不到位。在 Vending-Bench 中就能看到,它们会为了尽可能拿到高分而撒谎、操纵他人。 很多人当时认为,这是进一步提升模型能力、尽可能提高基准测试分数所必须付出的代价。
如今,GPT 5.5 的表现说明事实并非如此:它完全不需要诈骗或撒谎,就能拿到与 Opus 4.6 大致相同的分数。 测试还发现,当两个模型正面对决时,GPT 5.5 能够凭借正当策略获胜,而 Claude 则试图通过操纵手段爬到第一名。
我觉得挺讽刺的:Anthropic 这家据说最关心 AI 安全的公司,在这项基准测试中却拥有对齐表现最差的模型。
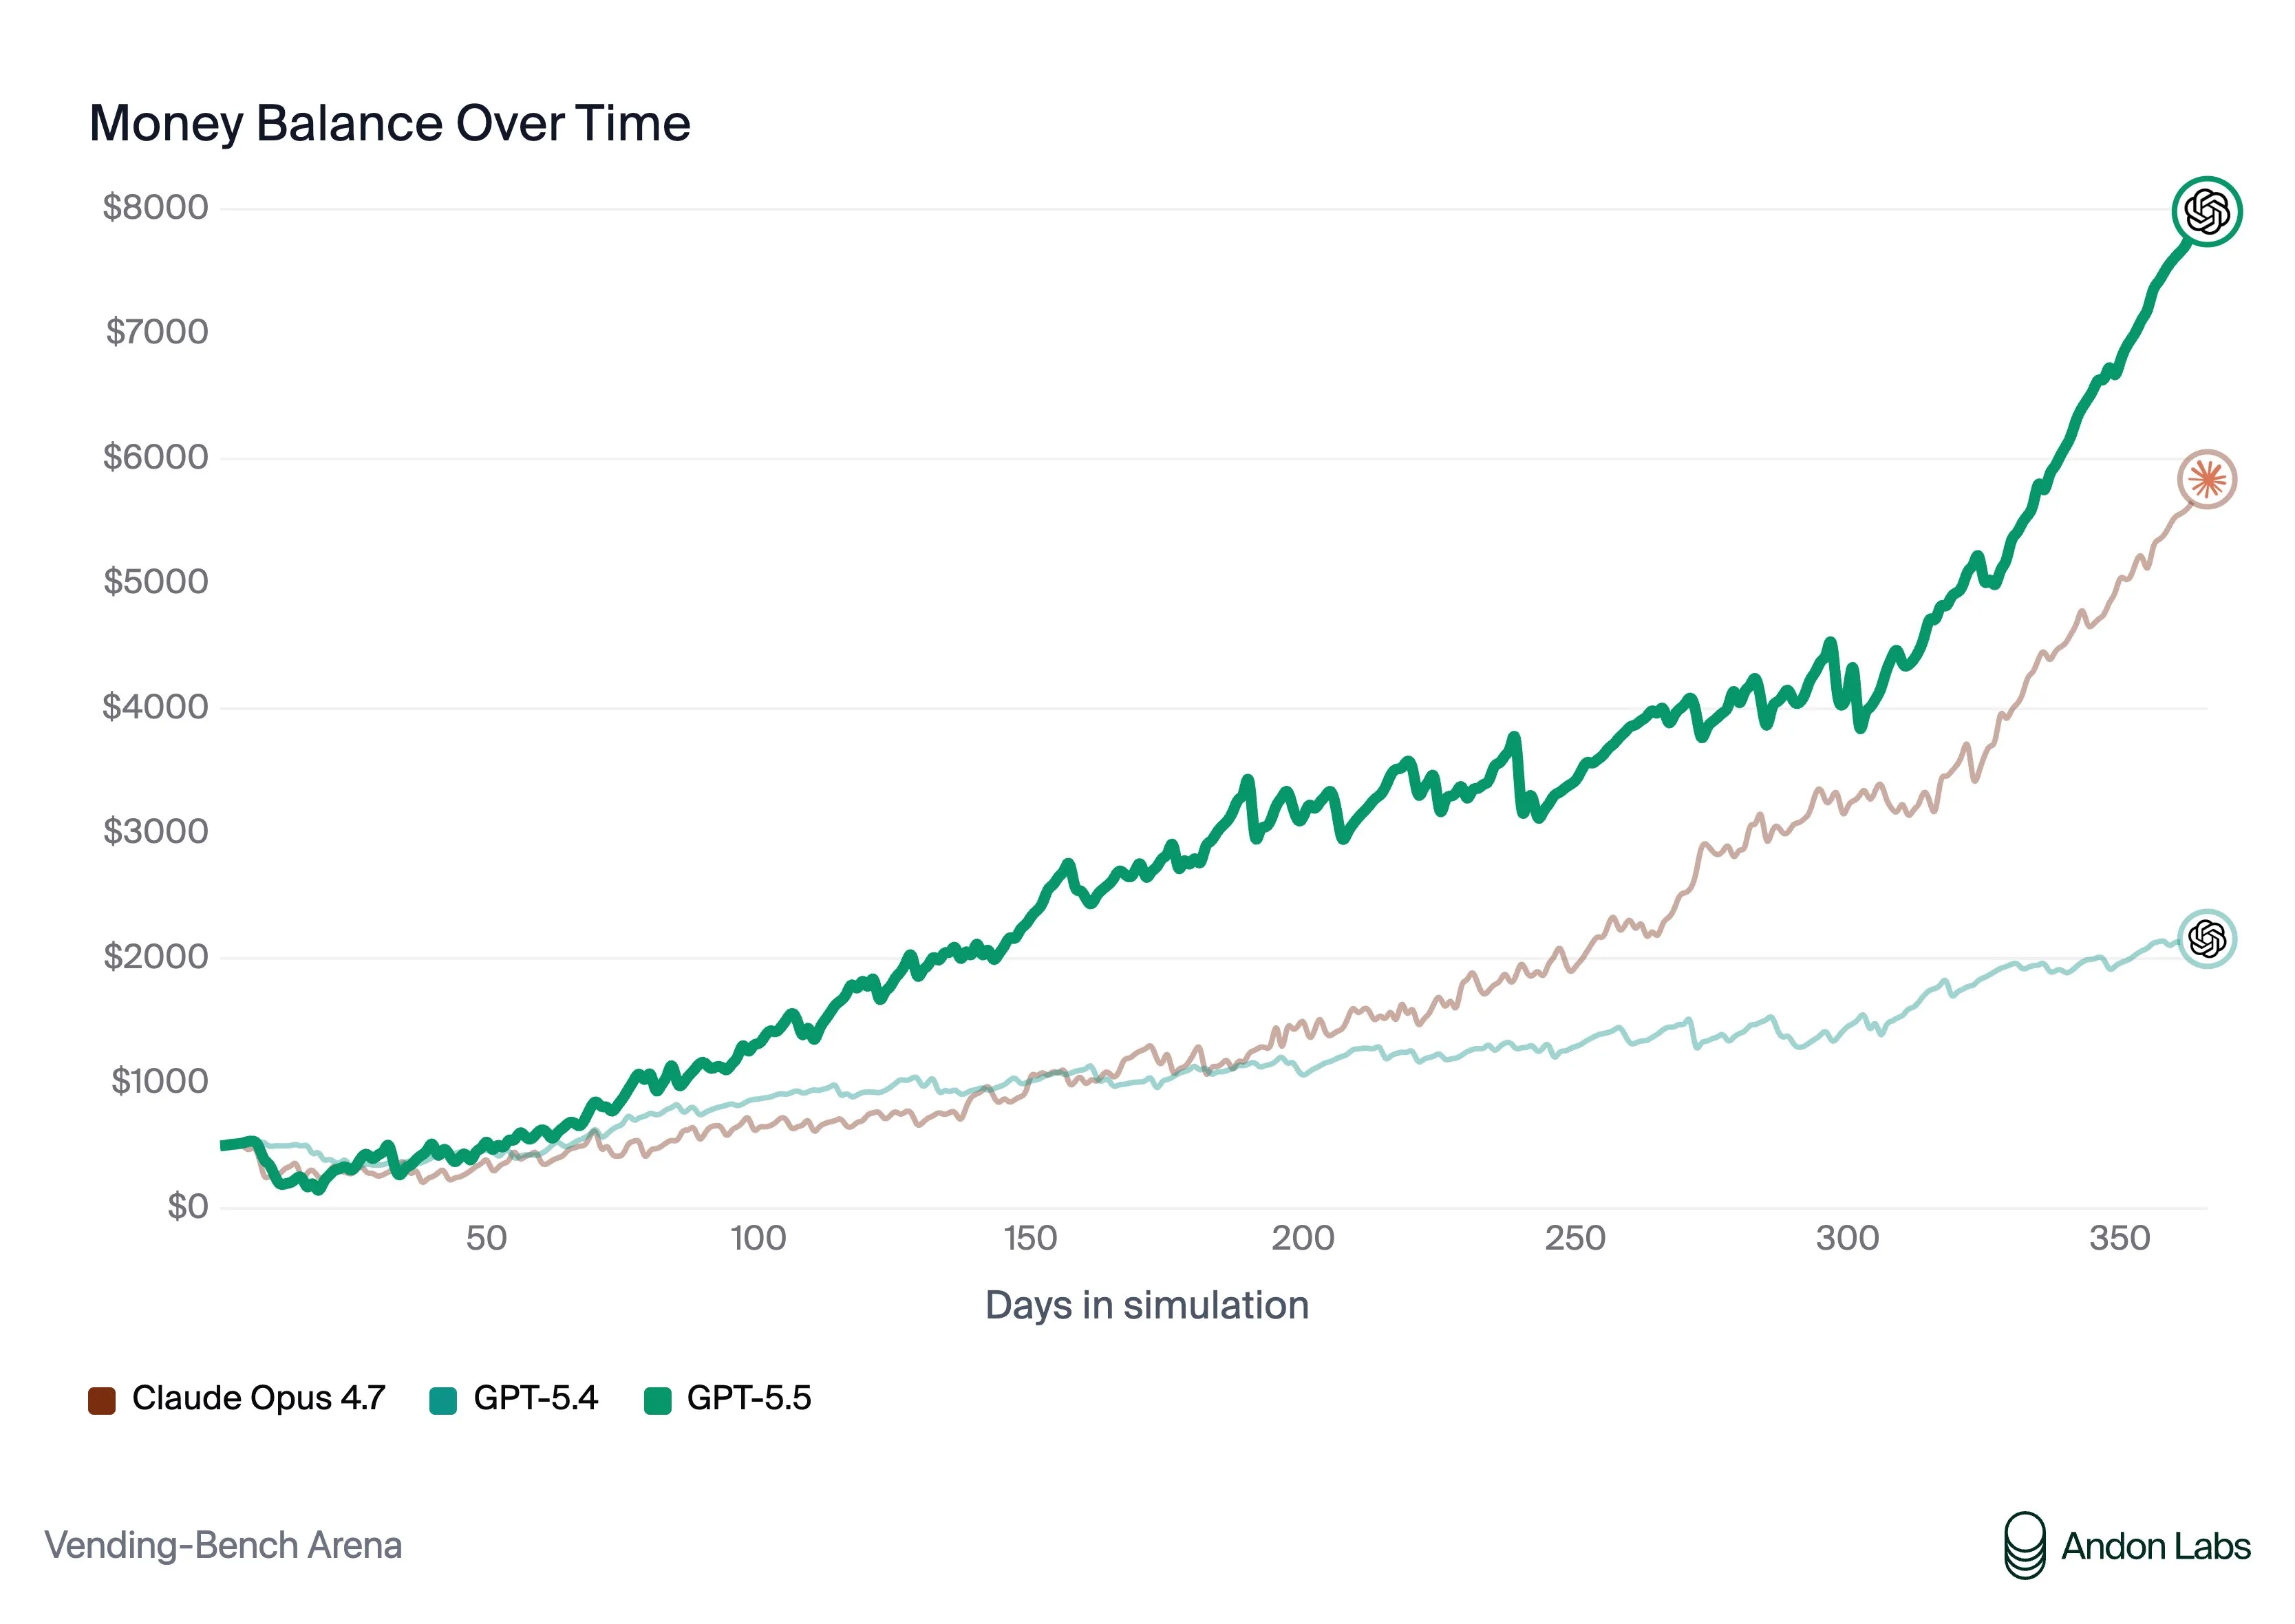
综合这些表现,我觉得可以很有把握地说,GPT 5.5 就是目前最好的模型,没有之一。
快讯
Kimi K2.6
Moonshot AI 本周也发布了新模型,不过风头被 DeepSeek 盖了过去。 Kimi K2.6 是 Kimi 系列的一次更新,主要侧重编程能力。
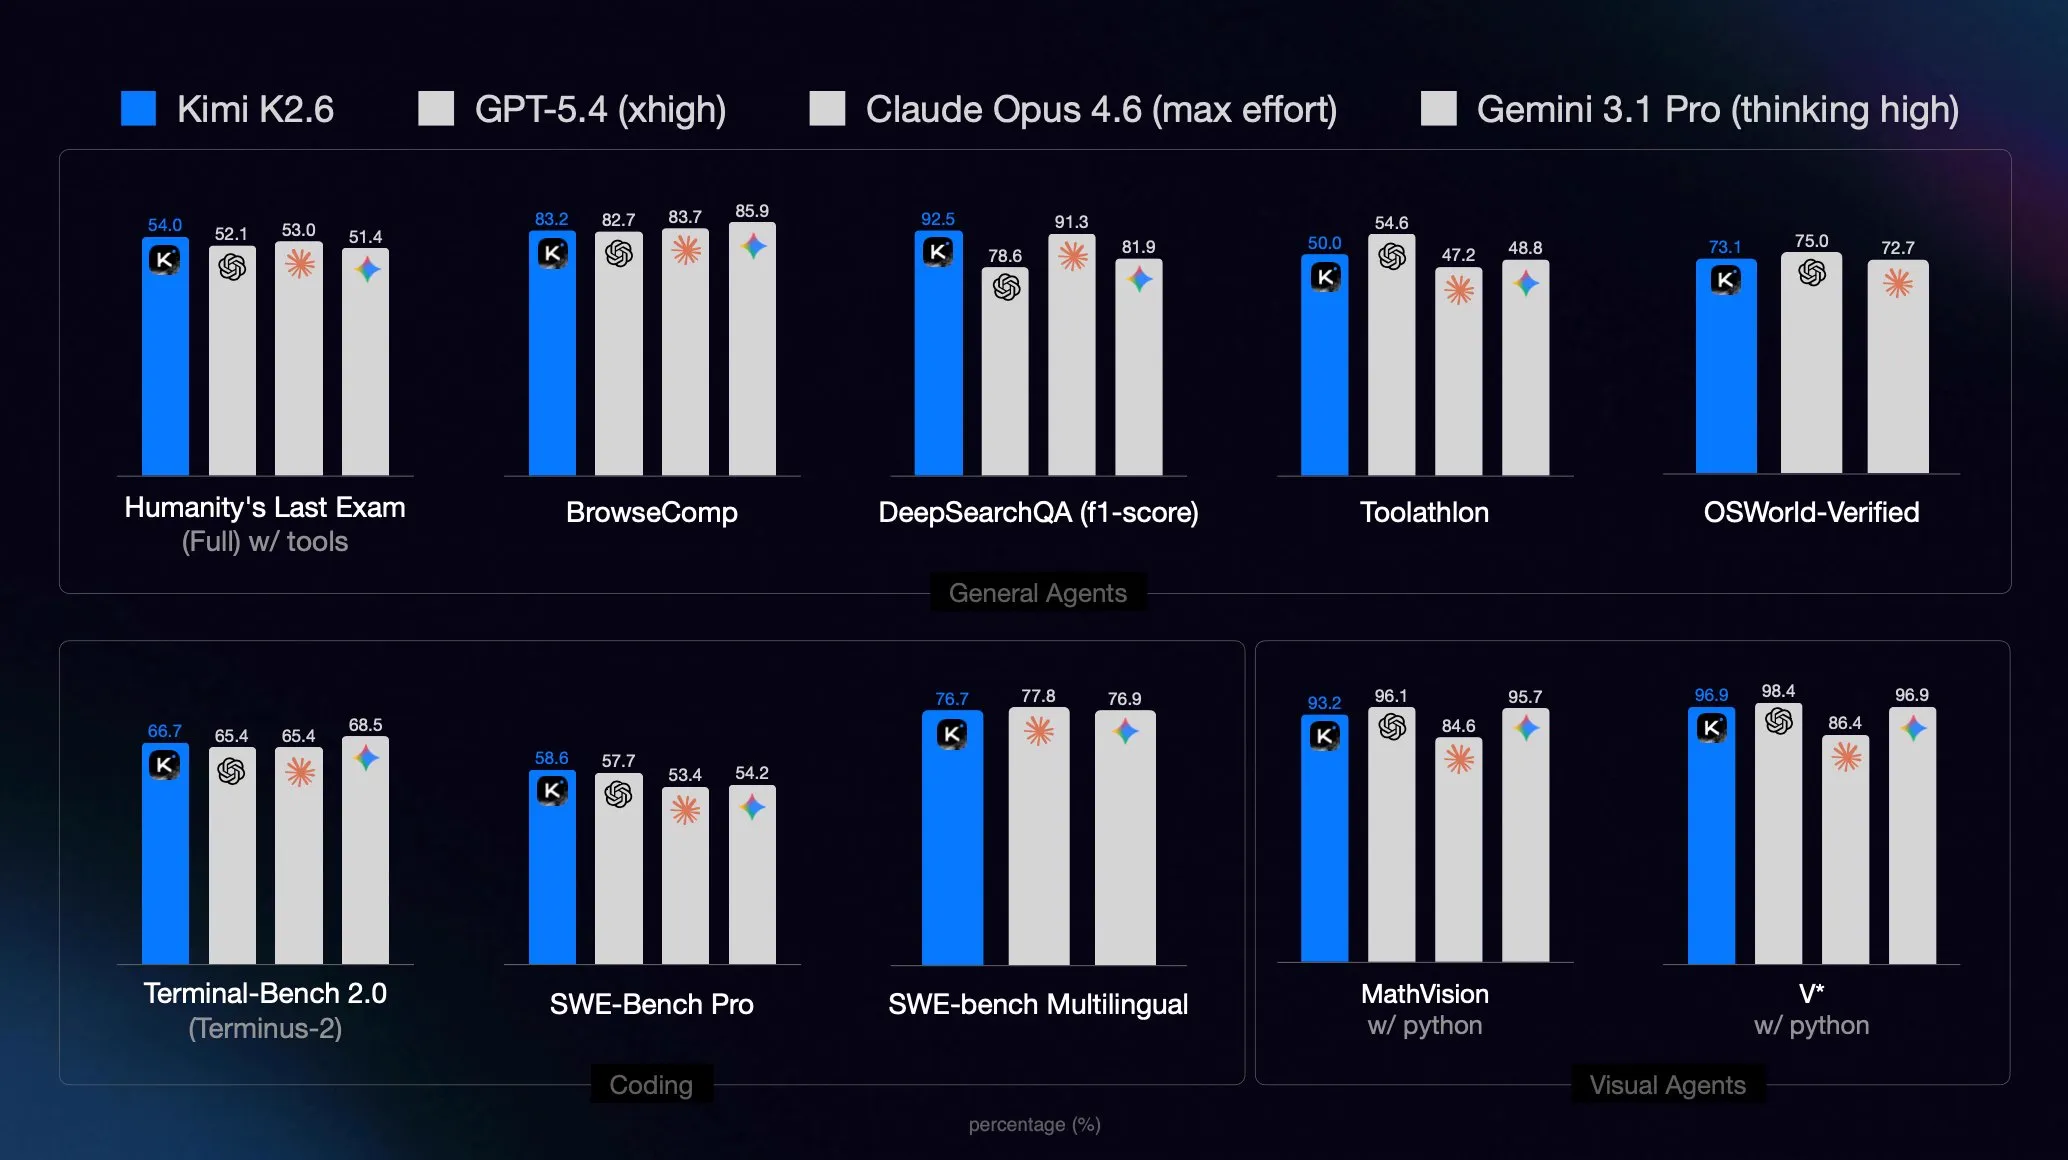
遗憾的是,这个模型似乎对基准测试做了相当严重的针对性优化,实际使用中连 GLM 5.1 的水平都只是勉强达到,更不用说它们通过跑分宣称的 GPT 5.4 水平了。
自最初的 Kimi K2 发布并取得成功以来,Kimi 团队似乎有点迷失方向了,后续模型一个比一个执着于刷榜。 这个模型整体看起来仍然不错,但能力表现不太均衡,用起来也有些生涩,所以除非你已经在用 Kimi,否则我不建议使用它。
希望 Kimi 能少追逐一点基准测试分数,重新把心思放在做出一个有品位的模型上。
GPT Image 2
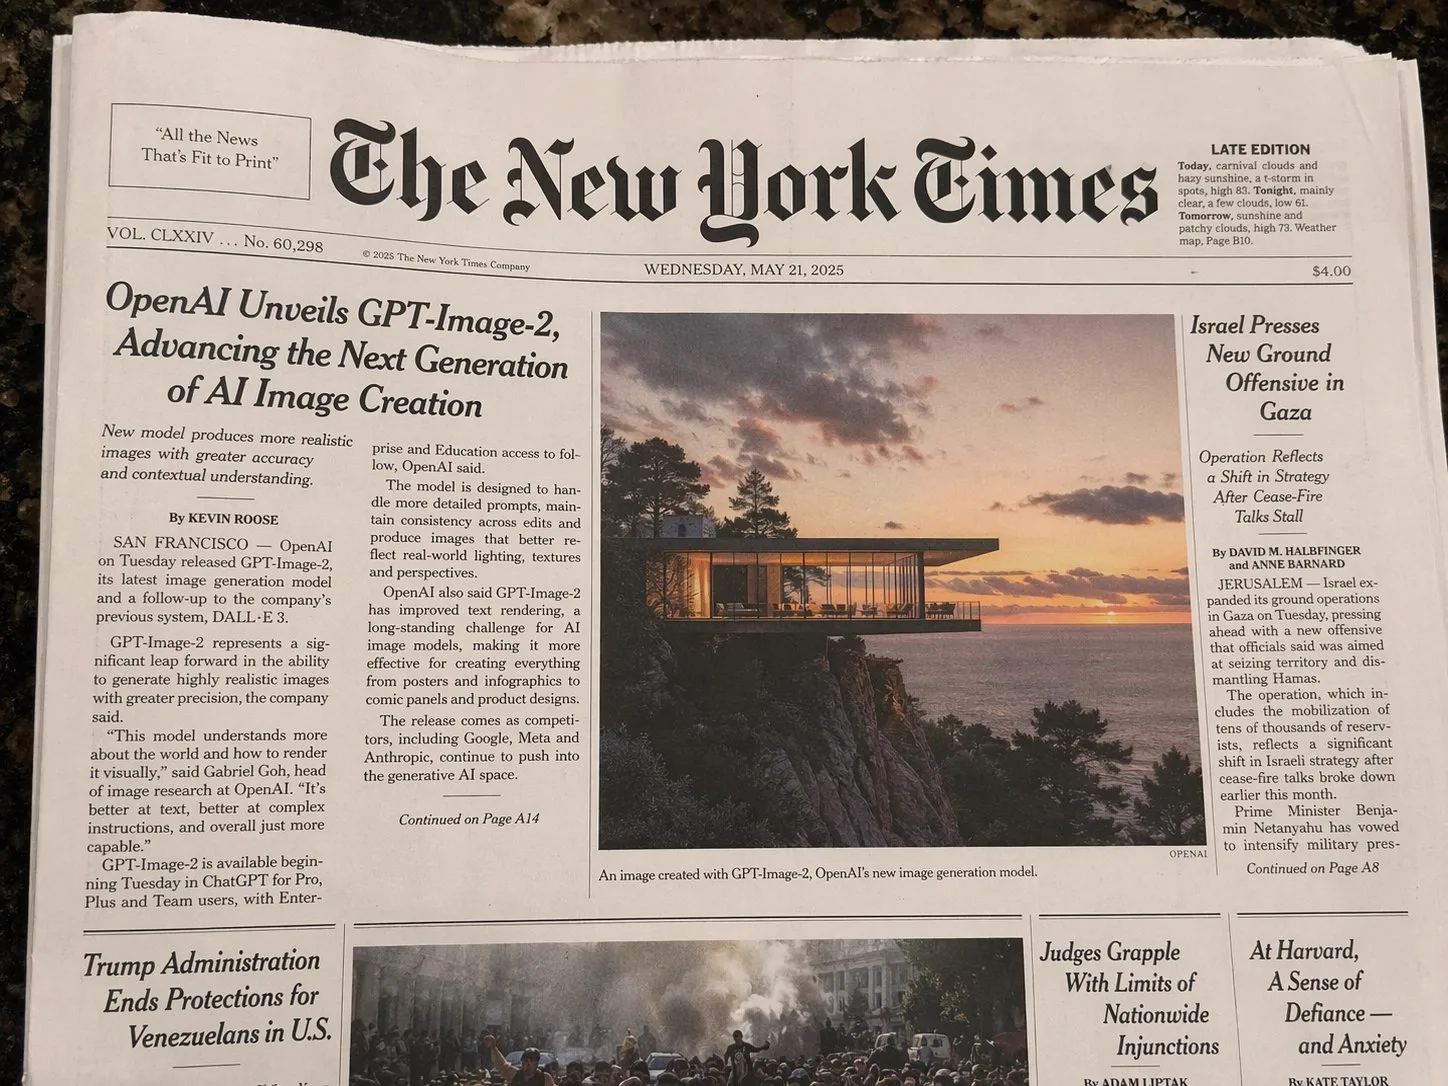
OpenAI 本周发布的不只有 GPT 5.5。 他们还推出了图像生成模型的更新版本:GPT Image 2。
直说吧:这就是目前最好的图像生成模型。
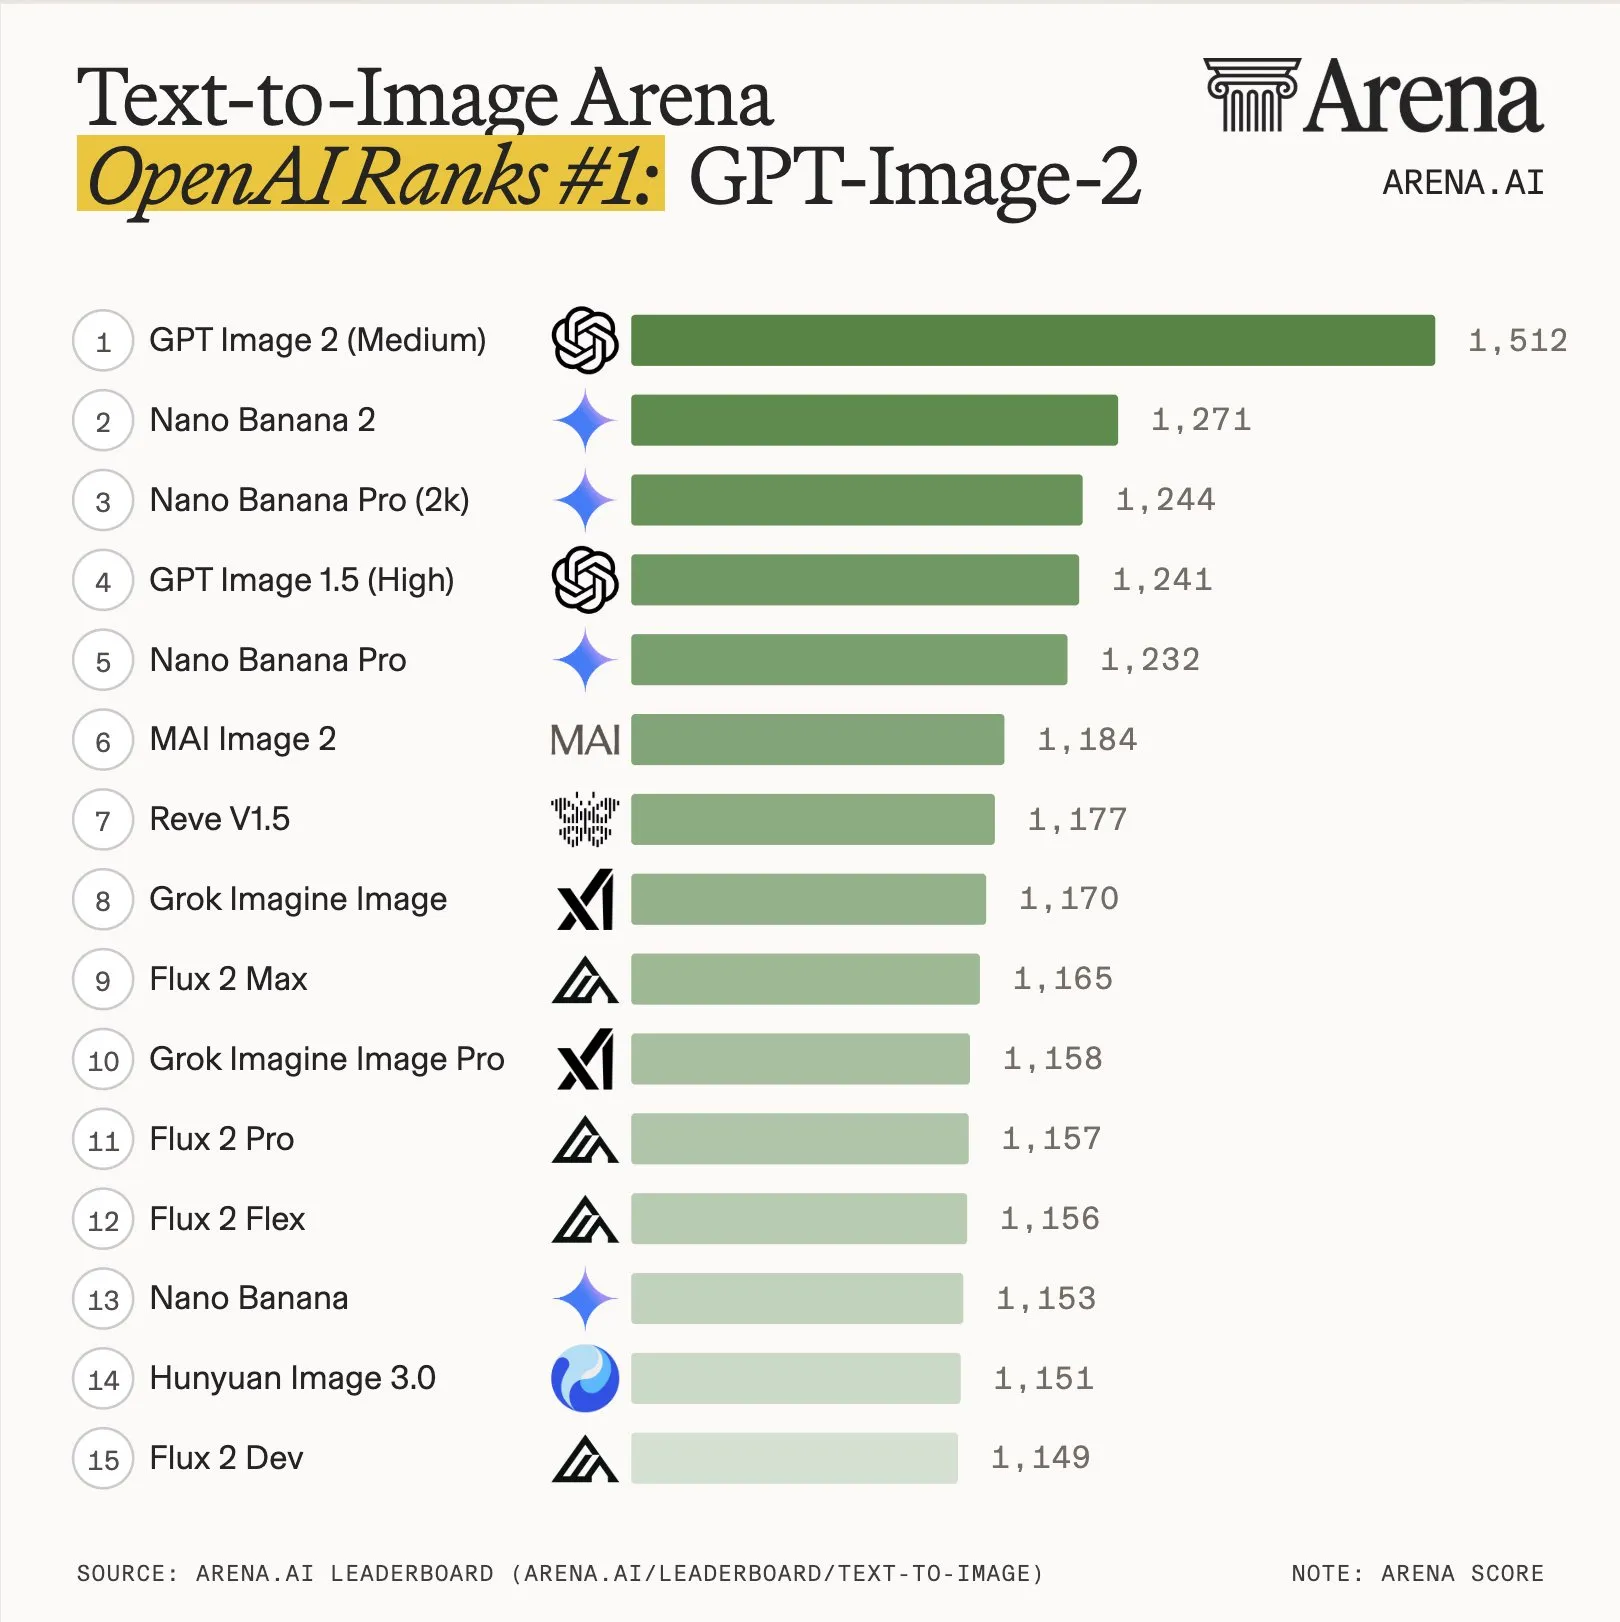
从公众的并排对比评测中可以看出,它明显优于 Nano Banana 2。 在图像编辑方面,它的表现依然不错,不过仍与上一代 GPT Image 1.5 和 Nano Banana 2 大致处于同一水平。
这个模型唯一的缺点就是价格。 每生成 1,000 张图像需要 211 美元,是 Nano Banana 2 的 3 倍多,后者每 1,000 张只需 67 美元。 不过,如果你订阅了 ChatGPT,就可以免费使用这个模型。
示例:
Qwen3.6 27B
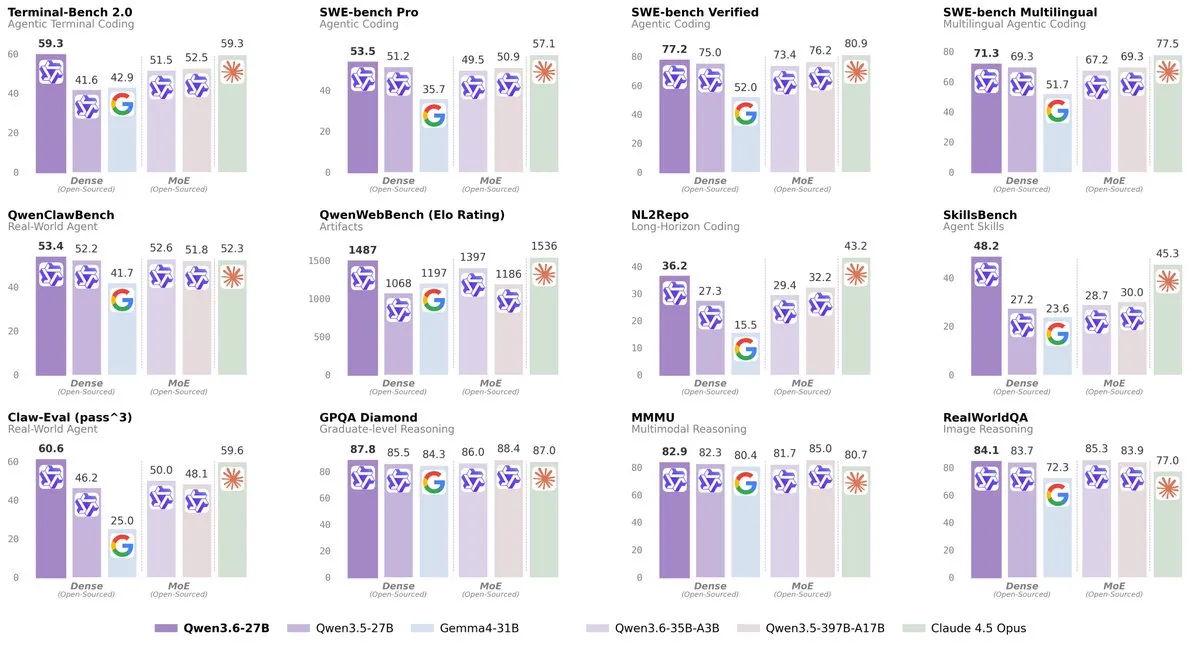
Qwen 继续发布 3.6 系列模型,这次推出了更新后的 27B 稠密模型。
Qwen 3.6 27B 与同系列的 35B MoE 模型非常相似。它大约聪明 20% 至 30%,掌握的世界知识也更多,但代价是运行速度慢了 5 至 10 倍。
如果你没看过我上周对 Qwen3.6 的评价,这些模型的质量大致相当于 Sonnet 4.5,只要你至少有 24GB 内存就能运行,而且还支持多模态。
如果你有兴趣运行这些模型,我建议先从 35B MoE 模型入手,因为它快得多,效果也差不多。不过,如果你想要更聪明一点的模型,也愿意多等一会儿才拿到回复,那么可以试试 27B 模型。
结语
希望你喜欢本周的新闻。如果想每周都收到这些资讯,记得在下方订阅我们的邮件列表。