注:本文由 OpenAI gpt-6.1-sol 通过 Codex CLI 自动翻译;翻译质量可能有所欠缺,尤其是技术术语。
新品发布
多模态嵌入模型
嵌入模型让我们能够比较两段内容的“感觉”是否相近。在搜索文档时,如果你不知道该用哪些具体关键词,这就很有用了。
以往,优秀的嵌入模型通常只能处理一种模态,比如文本或图像,却无法打通不同模态。 理论上,多模态嵌入模型可以让你上传一张花的图片,然后从数据库中找到一首写花的诗、一段讲解如何养花的视频,或者一期讨论哪些花最香的播客。
Gemini Embedding 2
本周一开始,Gemini 就推出了 Gemini Embedding 2 模型。
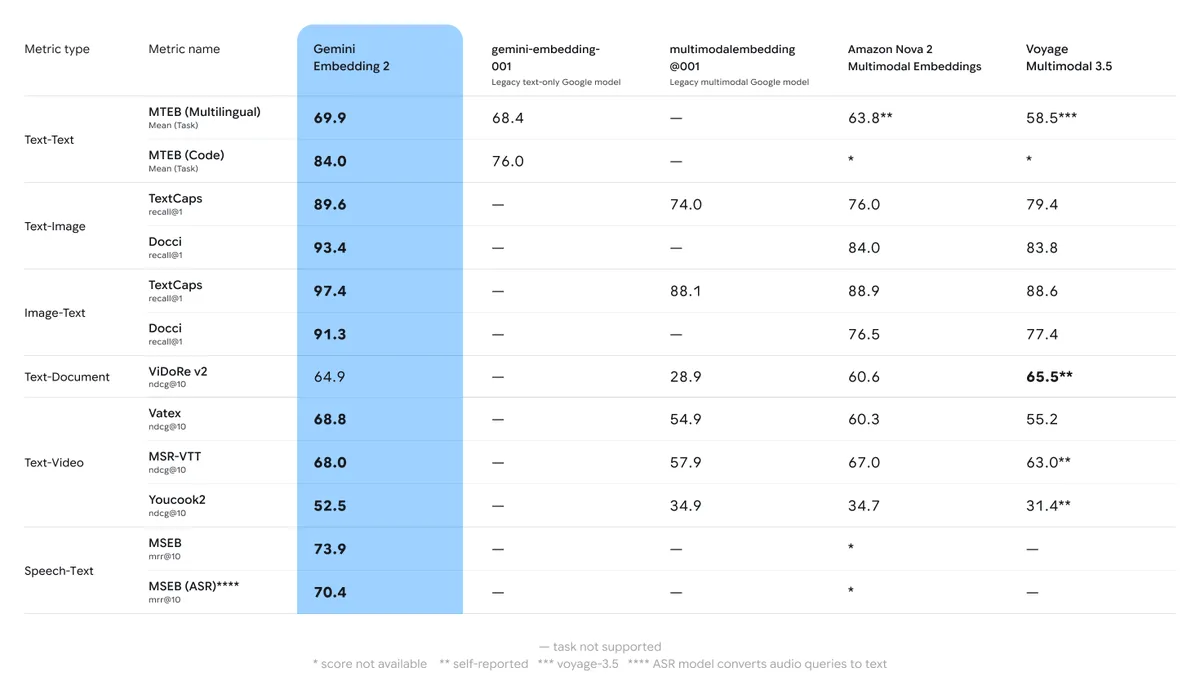
虽然发布时只与其他多模态嵌入模型进行了比较,但它面对专用于特定模态的模型也表现得非常出色。与目前最强的纯文本开源模型相比,它也能排进前五。
正如开头所说,可供比较的多模态嵌入模型非常少,因此它在其他所有类别中都轻松拿下了第一。
MixedBread WholeEmbed V3
不到两天,Google 就迎来了竞争对手:搜索初创公司 MixedBread AI(这公司名字起得真不错)发布了 WholeEmbed V3 模型。
在很多使用场景下,它似乎比 Google 的模型更好,但这并不意味着两者的使用方式也一样。
Google 的接口采用传统方式:你把内容交给它,它返回一个向量(也就是一组数字,比如 [1.12, 2.97, -3.2, 0.49]),然后你可以将其用于任何你喜欢的向量数据库。
而 MixedBread 不会返回向量。他们自己维护搜索引擎,所以你只需上传数据,就能进行查询。如果你想要完全托管的解决方案,这很方便,但它缺少 Google 提供的灵活性。 他们还(很可能)使用了后期交互嵌入模型,这意味着搜索延迟也会比较高。
快讯
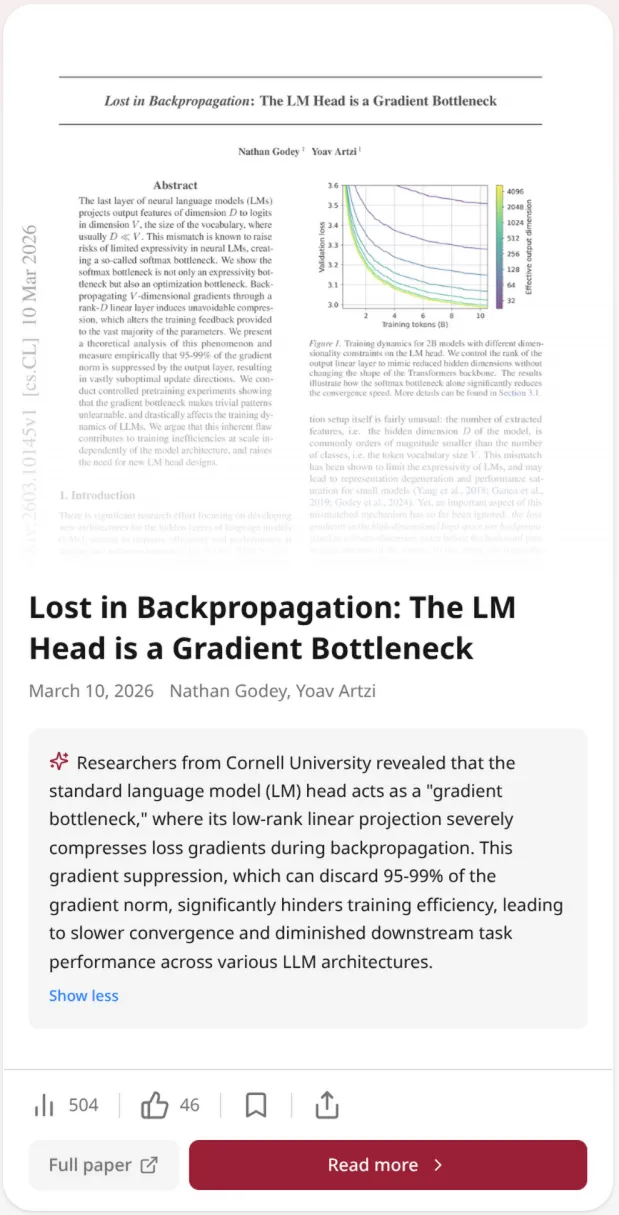
研究论文版 TikTok
每周都有数百篇 AI 研究论文发布,要跟上所有论文,简直就是一份全职工作。
为了缓解这个问题,Alphaxiv 推出了一款名为 Briefs 的 TikTok 风格应用,为你展示相关论文,并附上摘要(一段话版和一页版)。
Claude 的 100 万 token 上下文窗口
过去几个月,Anthropic 一直以测试版形式提供最高 100 万 token 的上下文窗口。
本周,他们觉得目前的表现已经令人满意,于是决定结束测试,将其正式开放。
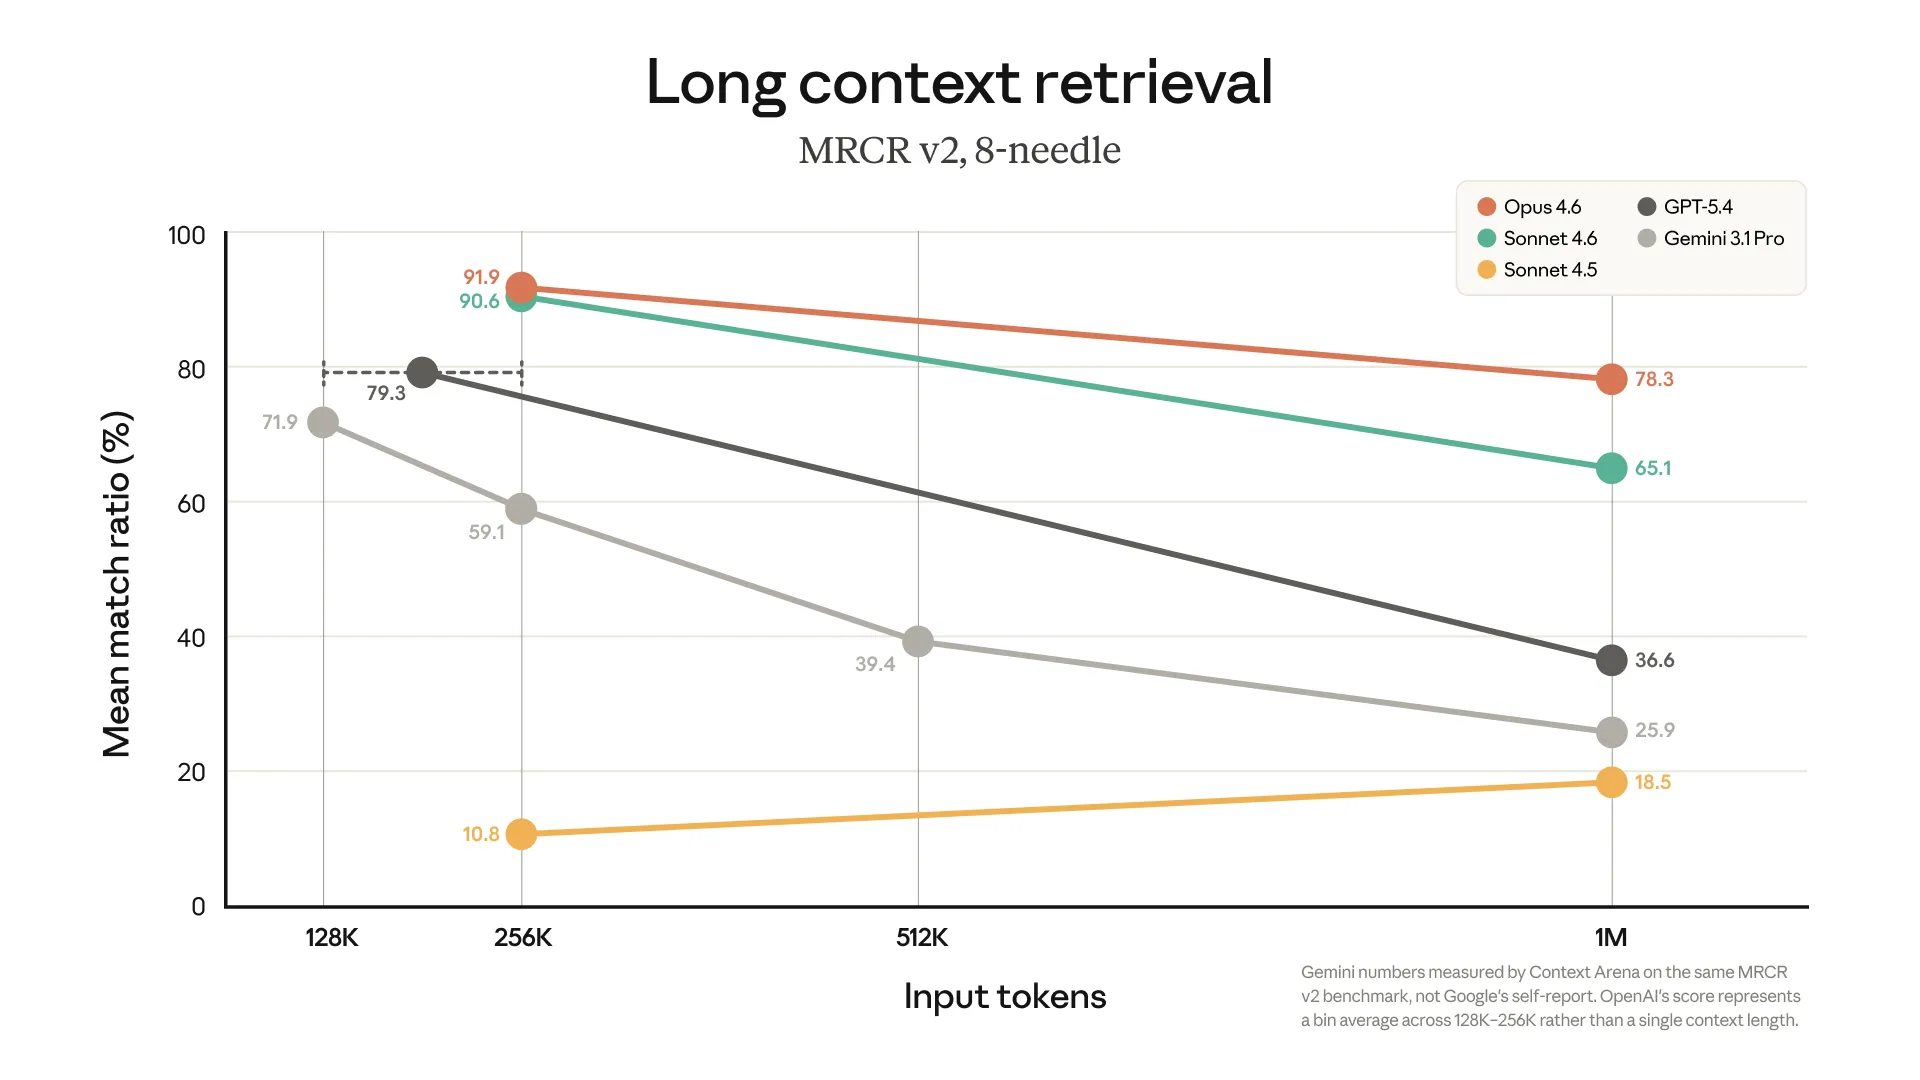
根据他们的基准测试(大海捞针式检索),他们在长上下文任务上的表现远超 Gemini 和 GPT。
他们也没有选择为长上下文涨价;OpenAI 和 Google 对超过 256K 的 token 都收取双倍费用,而 Anthropic 要么找到了压低成本的方法,要么就是愿意自行承担额外成本,好让其他实验室相形见绌。 不管怎样,受益的都是用户。
收尾
希望你喜欢本周的新闻。如果你想每周收到这些资讯,记得在下方订阅我们的邮件列表。