
Nota: Este artículo fue traducido automáticamente con OpenAI GPT-5.5 mediante Codex CLI; la calidad puede verse degradada, especialmente en la terminología técnica.
Lanzamientos
Jev
Una nueva startup llamada TypeSafe AI causó revuelo esta semana con el lanzamiento de su modelo llamado Jev. A pesar de recibir muchísima atención como si fuera un LLM, en realidad no lo es.
En cambio, es lo que se conoce como un modelo de clasificación zero-shot. Esto significa que le das un fragmento de texto y un conjunto de categorías, y te dará una probabilidad para el texto en cada categoría.
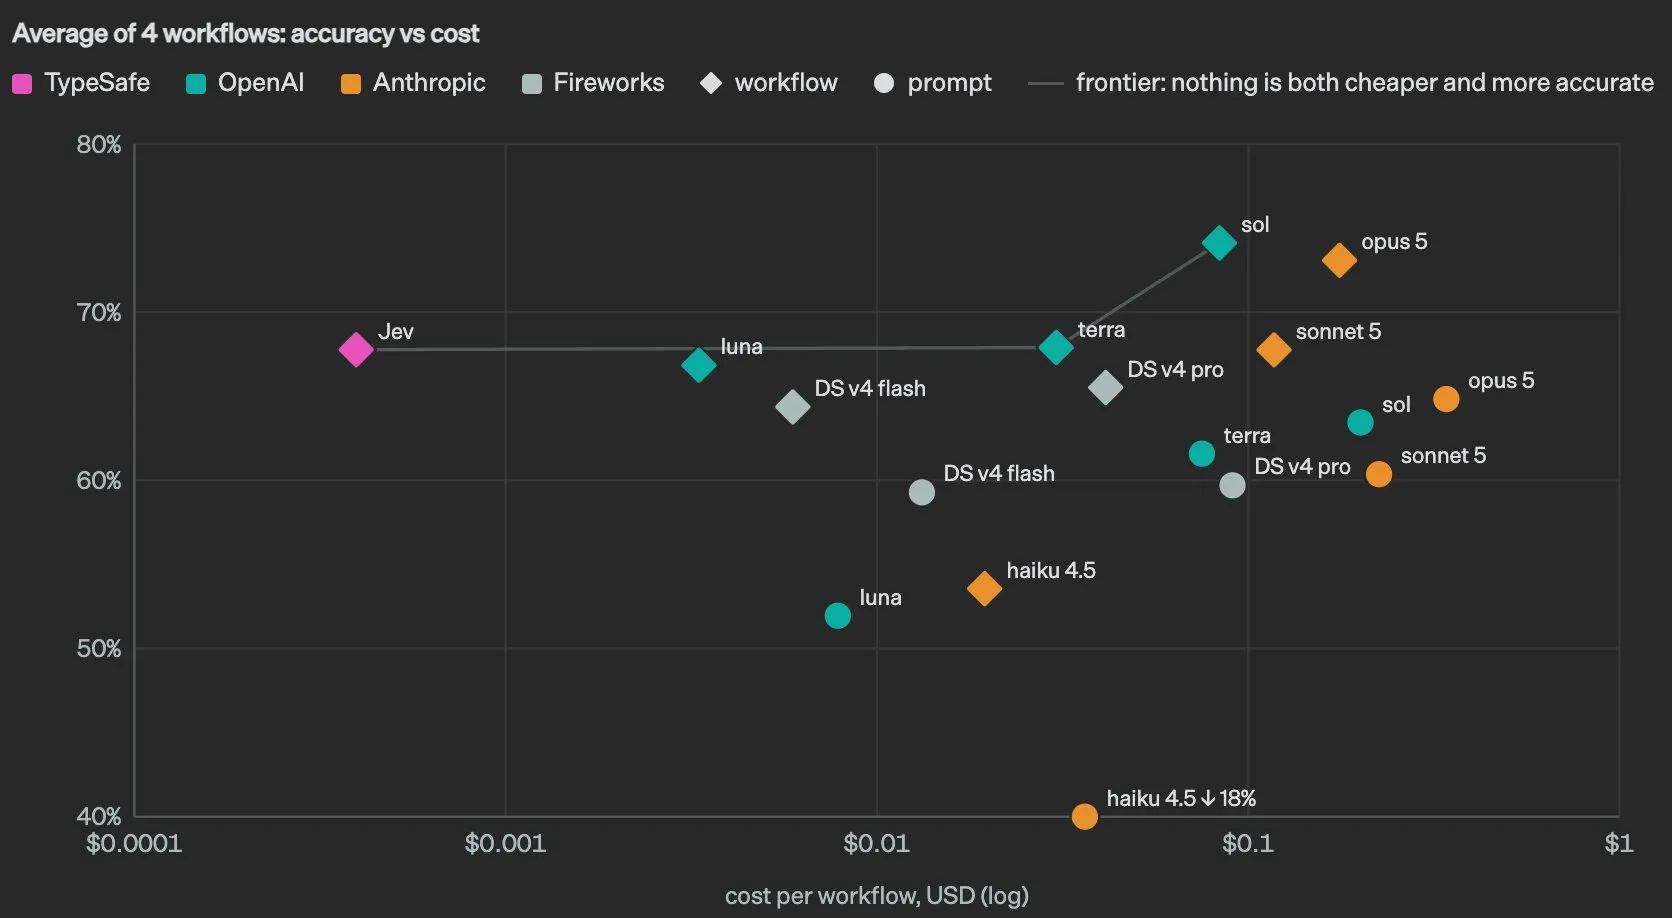
Estos modelos tienden a ser muy pequeños y, como solo generan probabilidades, solo tienes que pagar por los tokens de entrada. Esto significa que Jev cuesta solo 4.2 centavos por millón de tokens de entrada, y no pagas nada por tokens de salida, ya que no hay ninguno.
Esto puede parecer revolucionario (como muchas personas en Twitter creen), pero si has estado siguiendo la IA desde antes de la explosión cámbrica de ChatGPT, sabrás que no es tan revolucionario; ¡hemos estado entrenando estos modelos (conocidos como modelos BERT) desde 2020!
Tenemos una variedad de modelos que ya hacen esto (como Modern Bert Zeroshot) y son muy fáciles de entrenar (¡yo los entrenaba en mi laptop en 2021!). A diferencia de los modelos de IA generativa, estos modelos de ML más tradicionales son mucho más fáciles de entrenar y desplegar; pueden ejecutarse fácilmente en el navegador de tus usuarios, incluso en móvil.
De fábrica, Jev es una mejor versión de lo que tenemos ahora mismo en código abierto y también supera a los LLMs baratos que la gente ha estado usando para tareas de clasificación (como Gemini 3.5 Flash Lite y GPT 5.6 Luna), pero su viralidad ya ha generado varios clones (muchos de ellos de código abierto), así que espero que la brecha se reduzca rápidamente.
También cabe señalar que estos son modelos zero-shot, lo que significa que no han sido entrenados para la tarea de clasificación específica en la que se están usando. Como dije antes, estos modelos son muy fáciles de ajustar mediante finetuning: requieren solo unas pocas docenas de muestras para entrenarse, y se puede hacer en la mayoría del hardware doméstico, sin necesidad de GPU. Estas variantes ajustadas superarán ampliamente a los modelos zeroshot (y a los LLMs), siendo efectivamente gratis de entrenar y ejecutar para ti.
Dicho esto, si tienes un pipeline de clasificación y estás usando LLMs para ello, yo los reemplazaría por Jev, ya que debería ser igual de bueno, si no mejor, que la mayoría de los LLMs, y muchísimo más barato y rápido. Una vez que hayas hecho eso, investigaría cómo ajustar tu propia versión para reducir tus costos a 0.
Investigación
Weird ML V3
Hablando de ajustar modelos mediante finetuning, se ha lanzado un nuevo benchmark de finetuning: Weird ML V3.
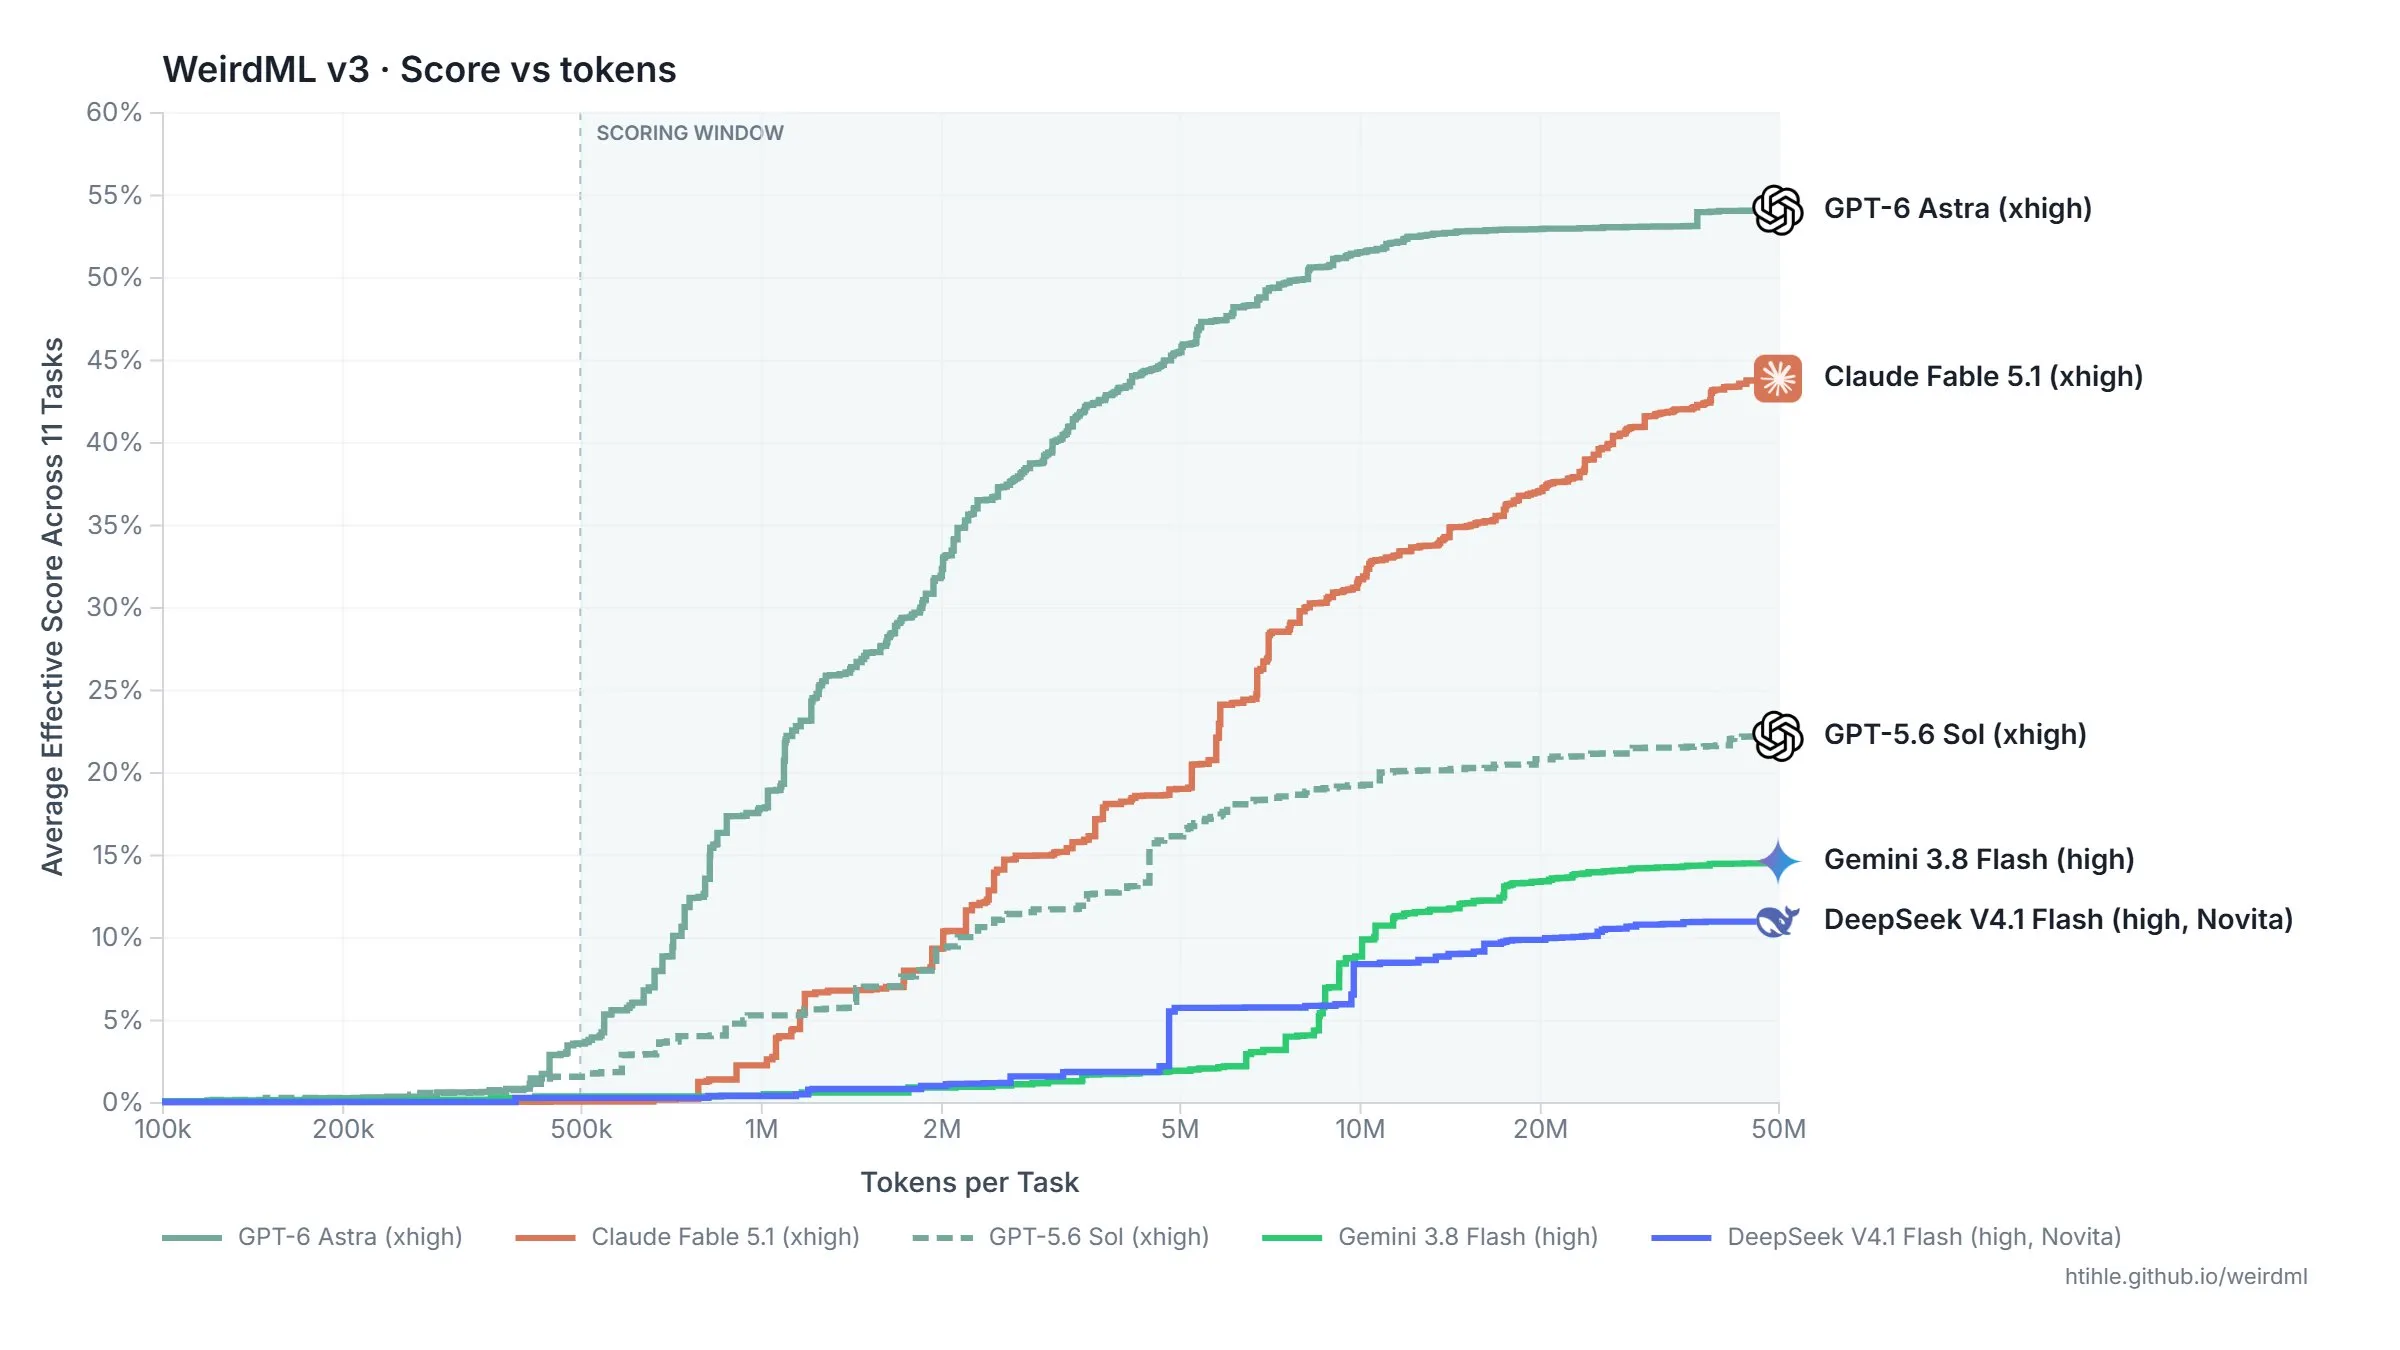
El benchmark mide qué tan bien puede desempeñarse el modelo cuando se lo deja en un entorno de machine learning con poca orientación más allá de su tarea. Depende del modelo examinar los datos, filtrarlos y procesarlos, y luego decidir qué arquitectura usar para el modelo real, para después componer un pipeline que entrene el modelo con éxito (solo tienen 2 minutos de cómputo para entrenar, así que deben asegurarse de que su modelo sea eficiente).
La iteración anterior era un buen benchmark (Epoch AI recientemente benchmarkeó el benchmark, y no encontró problemas con él, algo sorprendentemente raro), pero los modelos más avanzados lo estaban saturando, así que hacía falta un benchmark nuevo.
Los 4 ejemplos publicados (manteniendo privados el resto de los problemas) del benchmark sirven para hacerse una idea de lo que esperan de los modelos. Las tareas incluyen detección y clasificación de formas, detección de barcos, procesamiento de señales de datos de telescopios, y bonanza, que reúne las 17 tareas de Weird ML V2 que el modelo debe resolver en paralelo; la única puntuación que recibe es el promedio de las 17 preguntas, así que tiene que descubrir por sí mismo en cuáles le está yendo bien o mal.
El benchmark hace un buen trabajo diferenciando entre modelos, específicamente entre modelos abiertos y cerrados. Los modelos abiertos tienden a entrenarse alrededor de los principales benchmarks y tareas de ingeniería de software, y suelen carecer de capacidades de programación diversas, algo que la mayoría de los benchmarks pasan por alto. Weird ML no tiene este problema, ya que hay una gran brecha entre la mayoría de los modelos, lo que ofrece una buena medida de generalidad.
En las puntuaciones preliminares vemos esto, ya que Fable y GPT-6 Astra están muy por delante, con GPT-6 a la cabeza gracias a sus capacidades superiores de comprensión de imágenes, dado que muchos de los problemas se benefician de fuertes capacidades multimodales. DeepSeek V4.1 Flash y Gemini 3.8 Flash, que parecen estar cerca de la frontera en muchos benchmarks, quedan notablemente rezagados.
Weird ML V3 se añadirá a la lista de benchmarks que uso para las noticias, lo cual me alegra ver, ya que muchos de los benchmarks en los que he confiado se han contaminado (como DeepSWE), pero esa es una discusión para otro día.
Final
Espero que hayas disfrutado las noticias de esta semana. Si quieres recibir las noticias cada semana, asegúrate de unirte a nuestra lista de correo abajo.